
Инвентаризация
Рецепты промптов для переноса фото в художественный стиль: аниме, манга, граффити, карты Таро
Четыре набора промптов для переноса фото в художественный стиль, которые мы написали сами и реально запустили — кадр из аниме-фильма, панель манги, граффити-мурал и портрет в стиле карты Таро — с реальными изображениями до и после и API-вызовами для воспроизведения.
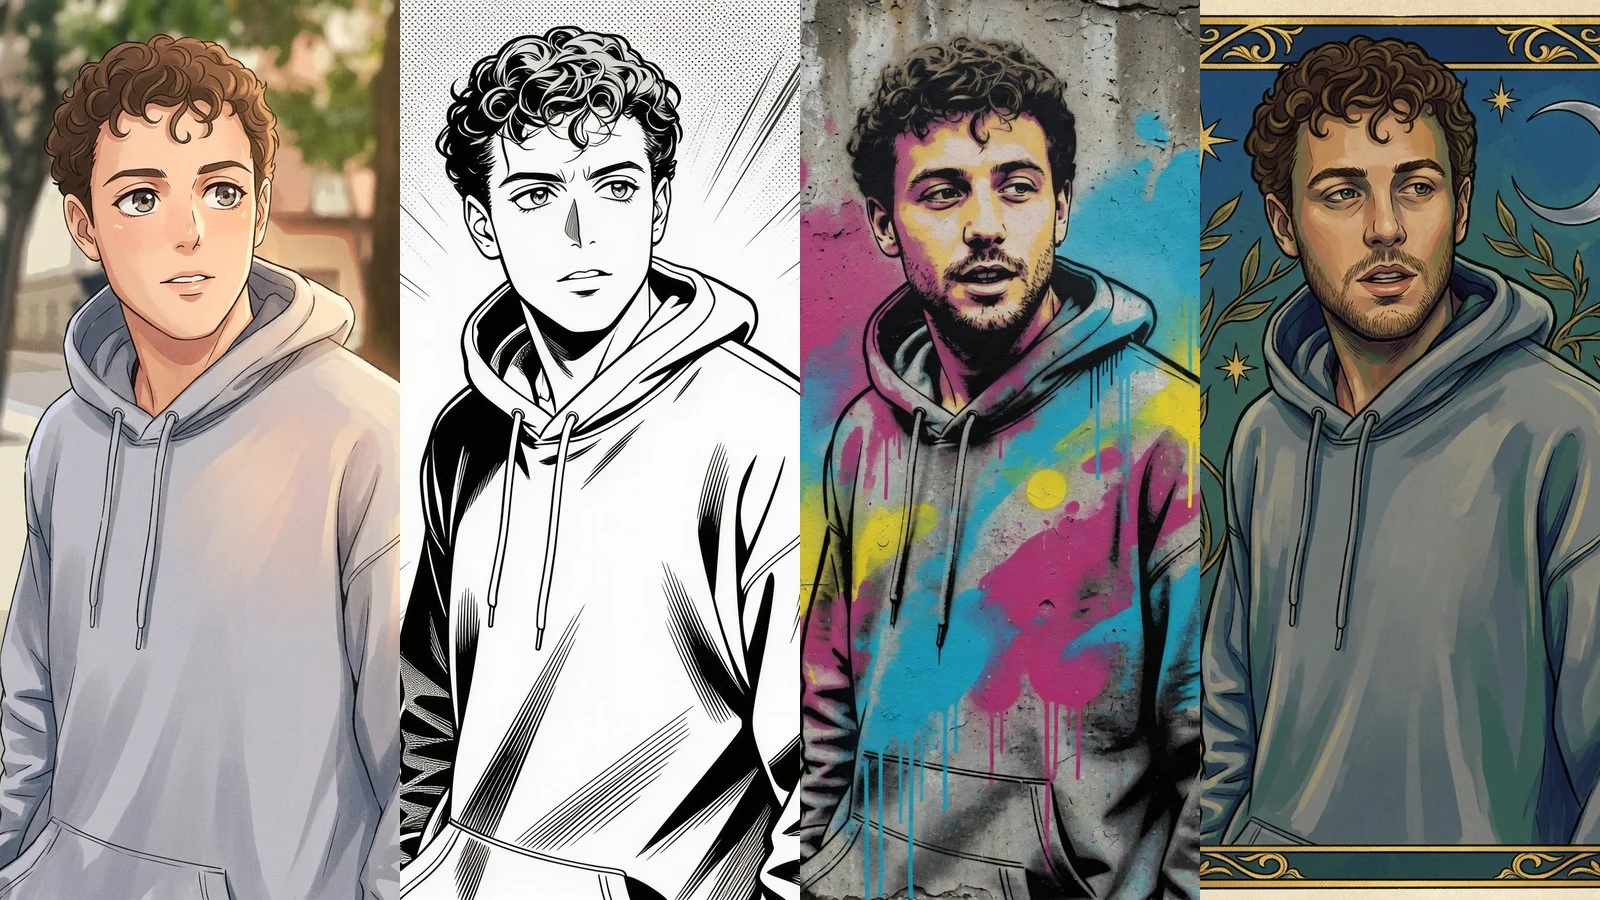
Четыре i2i-модели, одно референсное фото, четыре совершенно разных результата. Ниже — точные промпты, которые мы написали сами и запустили — кадр из аниме-фильма, панель манги, граффити-мурал и портрет в стиле карты Таро — каждый с реально сгенерированным изображением и API-вызовом для его воспроизведения.
Коротко: во всех четырёх стилях поза, причёска и черты лица успешно сохранились, потому что в каждом промпте явно указано, что нужно сохранить («та же поза», «та же причёска», «тот же силуэт худи»), а также что нужно изменить. Если убрать эту половину промпта, каждая протестированная нами модель превратит субъект в заурядное лицо, а не в вашу собственную стилизованную версию.
Краткий справочник: выберите свой стиль
| Стиль | Модель | Разрешение | Цена |
|---|---|---|---|
| 1. Кадр из аниме-фильма | nano-banana-2 |
1K | $0.085/изображение |
| 2. Панель манги | seedream-4.5/image-to-image |
2K | $0.045/изображение |
| 3. Граффити-мурал | grok-imagine-quality/image-to-image |
1k | $0.08/изображение + плата за референсное изображение |
| 4. Портрет в стиле карты Таро | nano-banana-2 |
1K | $0.085/изображение |
Цены рассчитаны за одно выходное изображение в указанном разрешении; данные актуальны на 2026-09 и взяты с эндпоинта цен hiapi — перед планированием бюджета на пакетную обработку проверьте страницу цен hiapi, так как тарифы моделей меняются. Эндпоинт image-to-image Grok Imagine Quality взимает небольшую дополнительную плату за каждое референсное изображение сверх базовой цены; в каждом вызове ниже используется только одно референсное изображение, поэтому общий бюджет по этой статье составит примерно $0.09–$0.10.
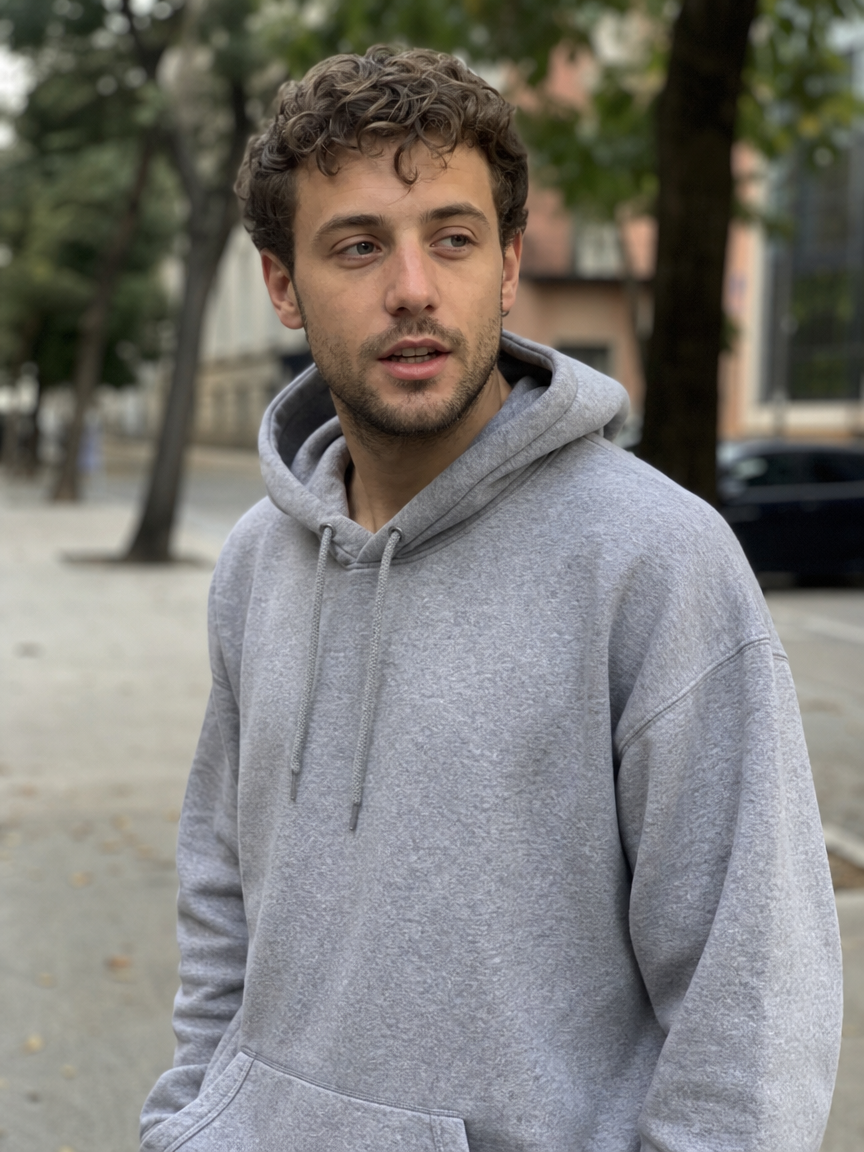
Ниже — референсное фото, использованное в каждом из рецептов:
Рецепт 1: Кадр из аниме-фильма
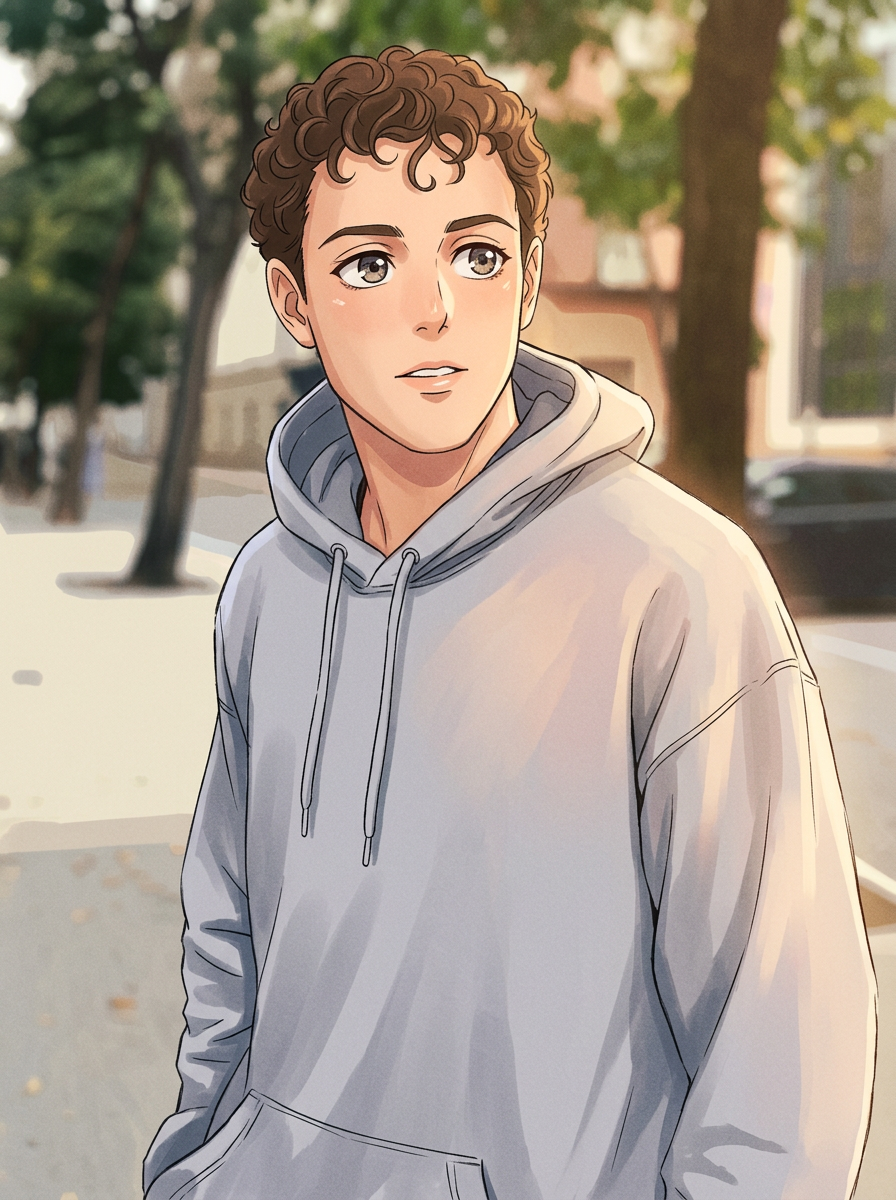
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Почему это работает: большая часть текста этого промпта посвящена текстуре, а не субъекту — «сел-шейдинг», «видимая текстура кисти», «световое свечение» — потому что субъект уже зафиксирован референсным изображением. Перерисовка глаз «в аниме-пропорциях» — единственное место, где мы намеренно позволяем модели отклониться от фото; всё остальное («та же причёска, поза и цвет худи») явно зафиксировано, поэтому результат по-прежнему узнаваем как тот же человек, только иллюстрированный.
Воспроизведите это:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Опрашивайте GET https://api.hiapi.ai/v1/tasks/{taskId}, пока status не станет success, затем скачайте output[0].url — эта ссылка временная, сохраните её в постоянное место хранения сразу же. Замените image_input на собственный портрет, и эта структура промпта подойдёт для любого субъекта с чёткой позой и причёской.
Рецепт 2: Чёрно-белая панель манги
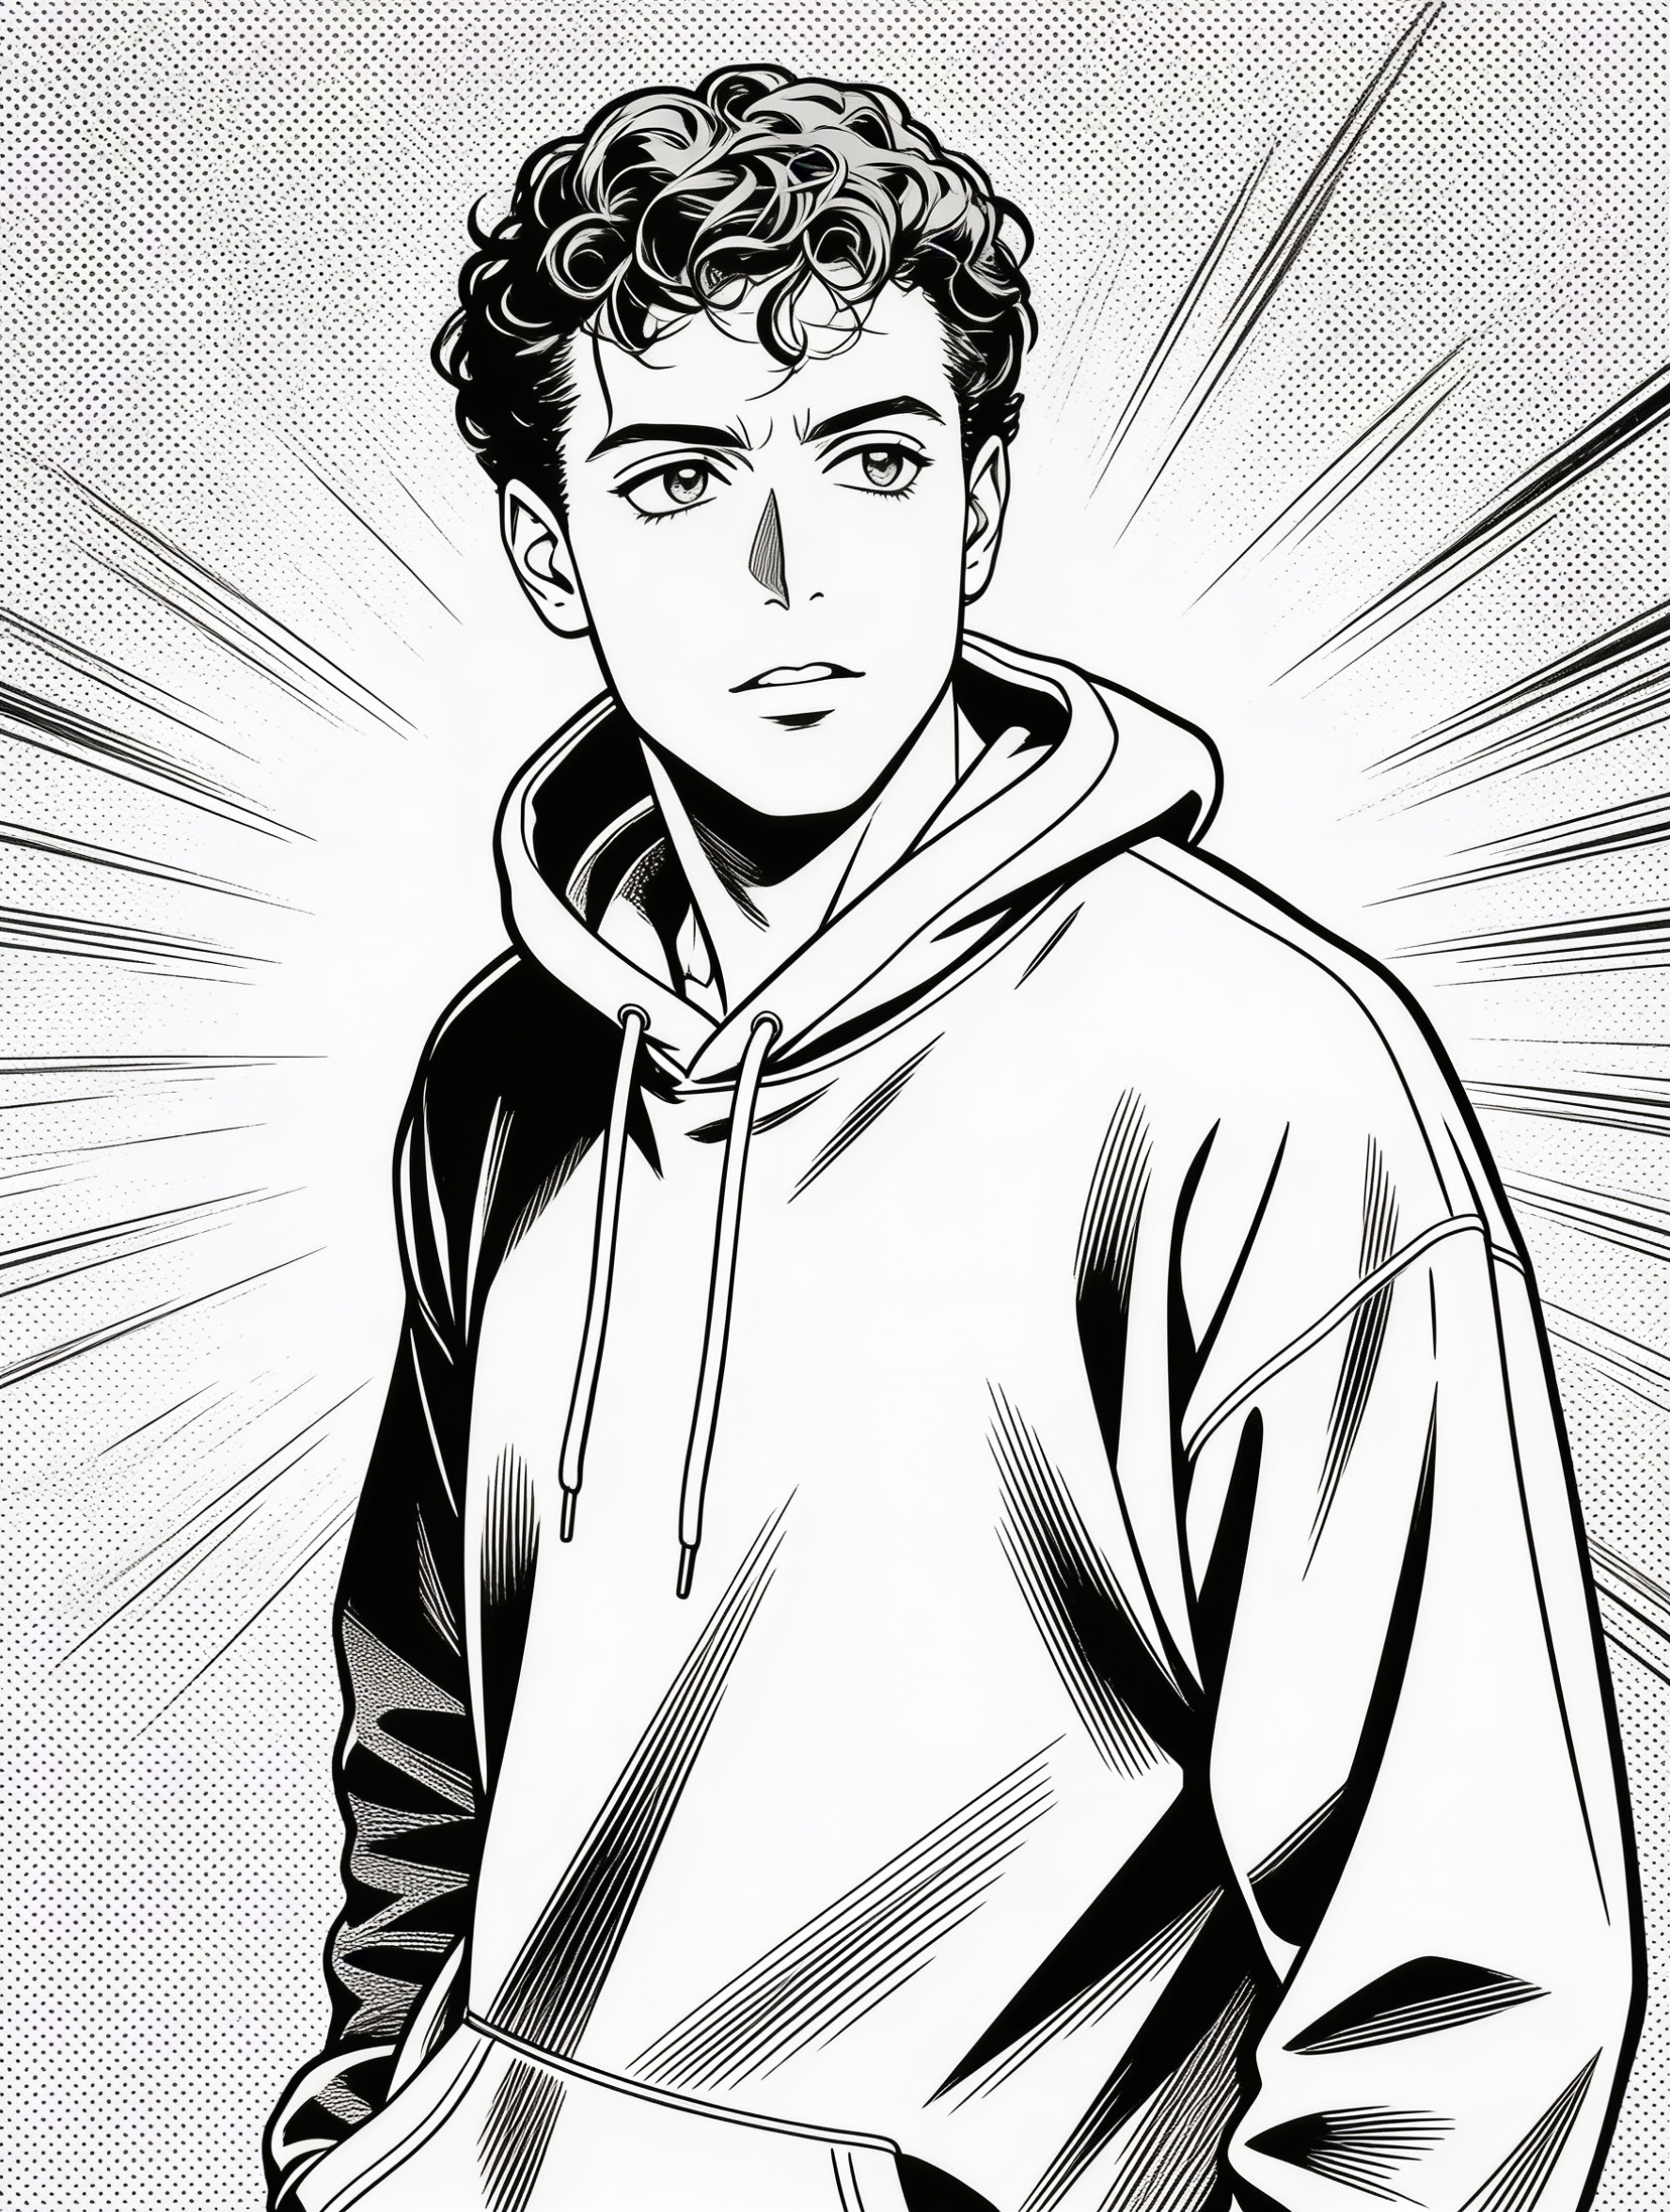
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Почему это работает: успех стиля манги зависит от двух вещей, которые этот промпт называет напрямую — скринтон (точечные тени, которыми настоящая манга заменяет градиенты) и толщина линий («чёткие контурные линии тушью», «резкие… линии лица»). Если явно не указать скринтон, i2i-модели часто по умолчанию используют обобщённое аниме-затенение с плоскими заливками вместо полутонового растрового эффекта, который действительно выглядит как манга. «Без цвета, без текста, без речевых облачков» добавлено потому, что модели, обученные на манге, иногда сами добавляют рамки панелей или текст диалогов, если их явно не исключить.
Воспроизведите это:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
Тот же POST на /v1/tasks и режим опроса, что и в рецепте 1 — seedream-4.5/image-to-image просто помещает референсное изображение в image_urls (множественное число, массив), а не в image_input, и тарифицируется по фиксированной цене $0.045 независимо от уровня разрешения.
Рецепт 3: Граффити-мурал с аэрозольной краской
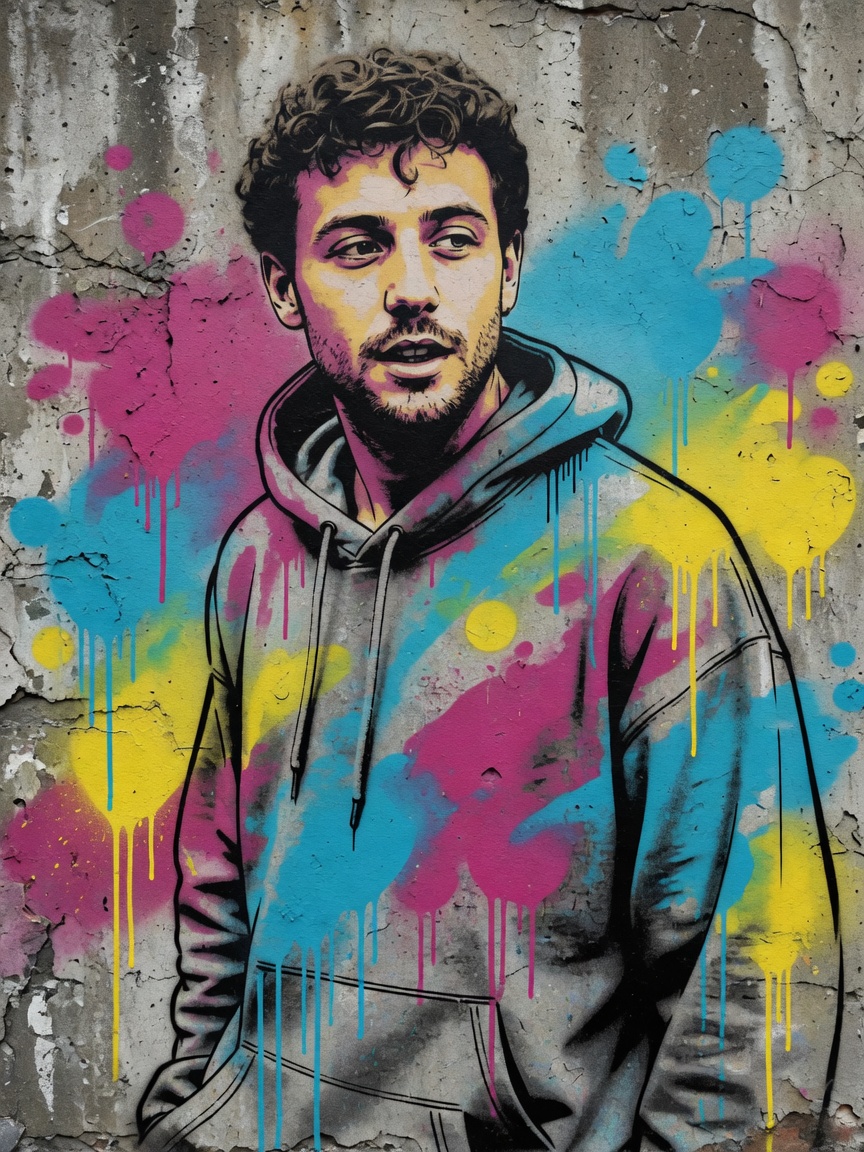
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Почему это работает: граффити — один из немногих стилей, где называть технику (трафаретные блики, потёки краски, жирные контурные линии) важнее, чем называть субъект. Список цветов — «маджента, голубой и жёлтый» — тоже играет практическую роль: если оставить цвета открытыми, большинство i2i-моделей по умолчанию используют мутную, низконасыщенную палитру вместо плоских насыщенных заливок, характерных для настоящих муралов с аэрозольной краской. Как и в трёх других рецептах, «сохранить ту же позу, причёску и силуэт худи» — ключ к тому, чтобы мурал не превратился в заурядное лицо уличного искусства.
Воспроизведите это:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Обратите внимание на строчные "1k" — в отличие от двух других моделей выше, схема Grok Imagine Quality чувствительна к регистру значения разрешения. У этого эндпоинта нет поля aspect_ratio; композиция вывода следует за вашим референсным изображением.
Рецепт 4: Портрет в стиле карты Таро
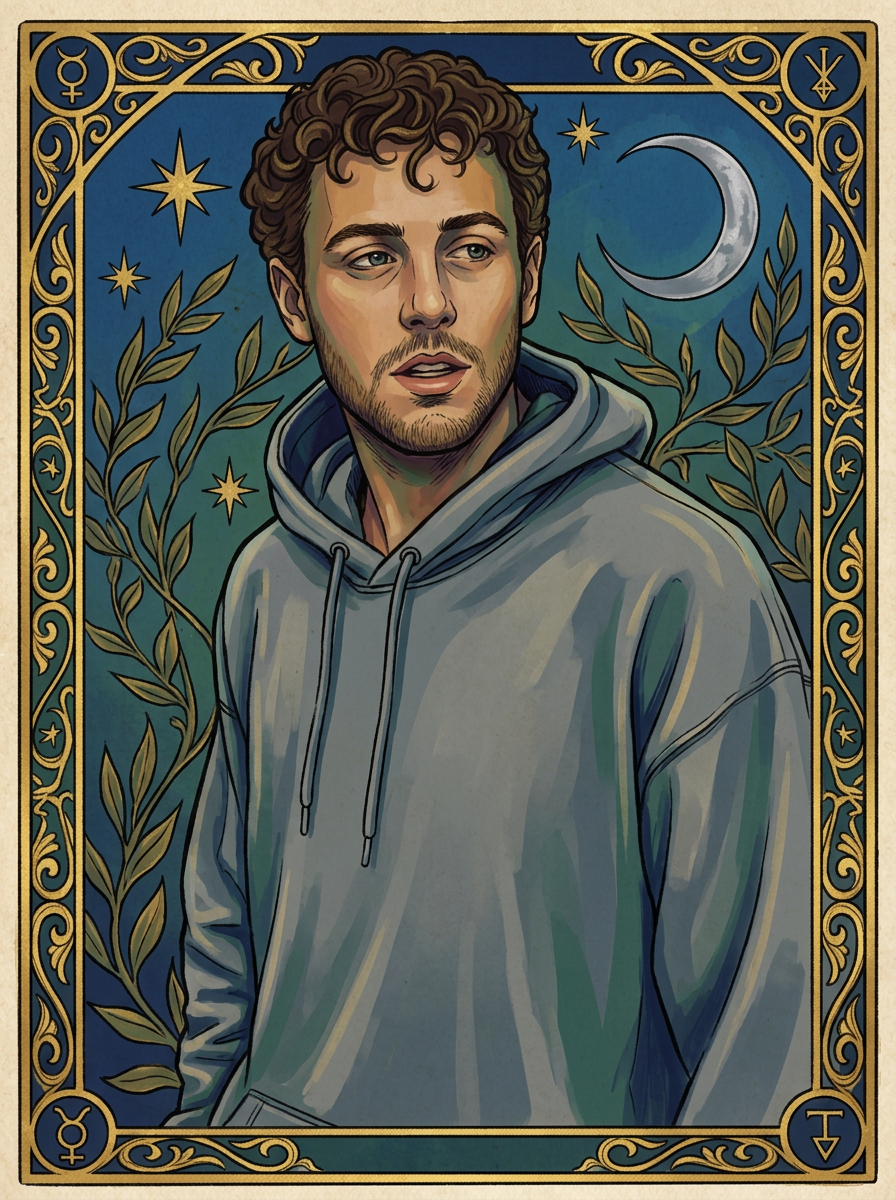
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Почему это работает: внешний вид карты Таро почти полностью определяется элементами рамки, не связанными с субъектом — золотой филигранной рамкой, мистическими фоновыми символами (звёзды, полумесяц, лавровые ветви). Именно явное называние этих элементов превращает «портрет с богатым затенением» в «безошибочно узнаваемую карту Таро». Мы также явно исключили номера и названия карт («без текста, без названия карты, без цифр»), потому что модели, обученные на настоящих картах Таро, добавляют текст-заполнитель с названием карты, если их не исключить.
Воспроизведите это:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Та же модель, что и в рецепте 1 (nano-banana-2), другой промпт — хорошее напоминание о том, что при переносе стиля i2i выбор модели менее важен, чем конкретность промпта относительно того, «что сохранить, а что переосмыслить».
Частые вопросы
Какая модель лучше всего подходит для переноса фото в аниме-стиль?
Из трёх протестированных нами моделей nano-banana-2 наиболее стабильно сохраняла черты личности (позу, причёску, пропорции) при повторных запусках по цене $0.085/изображение (1K). seedream-4.5/image-to-image — более дешёвый вариант по фиксированной цене $0.045/изображение, подходящий для стилей с преобладанием линий, таких как манга; grok-imagine-quality/image-to-image ближе к полной перерисовке и подходит для случаев вроде граффити, где некоторое отклонение субъекта само по себе является частью стиля.
Эти промпты требуют определённых фотографий для работы? Наиболее стабильные результаты даёт чёткий портрет анфас или в три четверти с видимой причёской и одеждой — именно это подразумевают четыре промпта выше, когда говорят «та же поза, причёска и худи». Захламлённый фон или частично закрытое лицо затрудняют модели определение того, что нужно сохранить.
Можно ли комбинировать эти промпты, например, карта Таро в аниме-стиле? Да — замените язык техники (сел-шейдинг vs. скринтон vs. текстура аэрозольной краски), сохранив язык рамки из другого рецепта (золотая рамка и символы карт Таро или текстура стены граффити). Обе половины каждого промпта — сохранение субъекта и стилевая техника — написаны по модульному принципу.
Почему в некоторых промптах указано «без текста» или «без водяного знака»? Модели, обученные на настоящих кадрах аниме, страницах манги и картах Таро, видели множество примеров со встроенным текстом — титрами, звукоподражаниями, названиями карт — и иногда добавляют текст-заполнитель по собственной инициативе. Явное исключение предотвращает это заранее; добавление в промпт ничего не стоит и экономит одну потраченную впустую генерацию.
Влияет ли разрешение на цену этих моделей?
Зависит от модели. Цены nano-banana-2 и seedream-4.5 на некоторых эндпоинтах действительно зависят от уровня разрешения, однако seedream-4.5/image-to-image конкретно тарифицируется по фиксированной цене $0.045 независимо от уровня. Перед планированием бюджета на пакетную обработку обязательно проверьте актуальную страницу цен hiapi — тарифы различаются по моделям и обновляются независимо.
Ключевые выводы
- Каждый промпт выше делится на две половины: что сохранить (поза, причёска, личность) и что изменить (художественный стиль, техника, композиция) — обе половины должны быть прописаны, иначе модель незаметно превратит субъект во что-то заурядное.
- Называние техники, а не только целевого стиля даёт более точные результаты: «точечный растровый узор» лучше, чем «стиль манги», а «трафаретные блики и потёки краски» лучше, чем «стиль граффити».
- Исключайте то, что модели склонны самопроизвольно генерировать в определённом стиле — текст-заполнитель, номера карт, речевые облачка — даже если вам кажется, что это не нужно.
grok-imagine-quality/image-to-imageиспользует строчное значение разрешения ("1k", а не"1K") и не имеет поляaspect_ratio; проверяйте схему каждой модели, а не предполагайте, что она совпадает с той, которую вы использовали раньше.- Все четыре промпта — готовые к копированию отправные точки — замените референсное фото через
image_inputилиimage_urls, и та же структура подойдёт для других субъектов.
Хотите увидеть, как одна i2i-модель справляется с несколькими уровнями разрешения и количеством референсных изображений, прежде чем выбирать модель для пакетных задач? Руководство по API Nano Banana 2 подробнее рассказывает об аутентификации, структуре запросов и обработке ошибок. Или перейдите сразу на страницу модели nano-banana-2 и запустите её со своим референсным фото.
Похожие статьи
Все статьи →-

Инвентаризация
Рекомендации альтернатив Hugging Face Inference API (2026): один API для вызова изображений/видео/аудио/больших моделей
Модели ценообразования, широта охвата моделей, сложность интеграции, совместимость с OpenAI — разберёмся, в каких сценариях стоит перейти от агрегирующего маршрутизатора к унифицированному API генерации
-

Инвентаризация
Как выбрать альтернативу RunPod: сравнение интеграции API для изображений и видео
RunPod — это GPU-облако, а не генеративный API. Сначала разберитесь, какой уровень вам нужен для изображений и видео.
-

Инвентаризация
Как выбрать альтернативу Modal: сравнение интеграции API для изображений и видео