
Inventário
Receitas de prompts para transferência de estilo fotográfico: anime, mangá, grafite, tarô
Quatro conjuntos de prompts de transferência de estilo de foto para arte que escrevemos e executamos de fato — cena de filme de anime, painel de mangá, murais de grafite e retrato de tarô — com imagens reais de antes e depois e as chamadas de API necessárias para reproduzi-los.
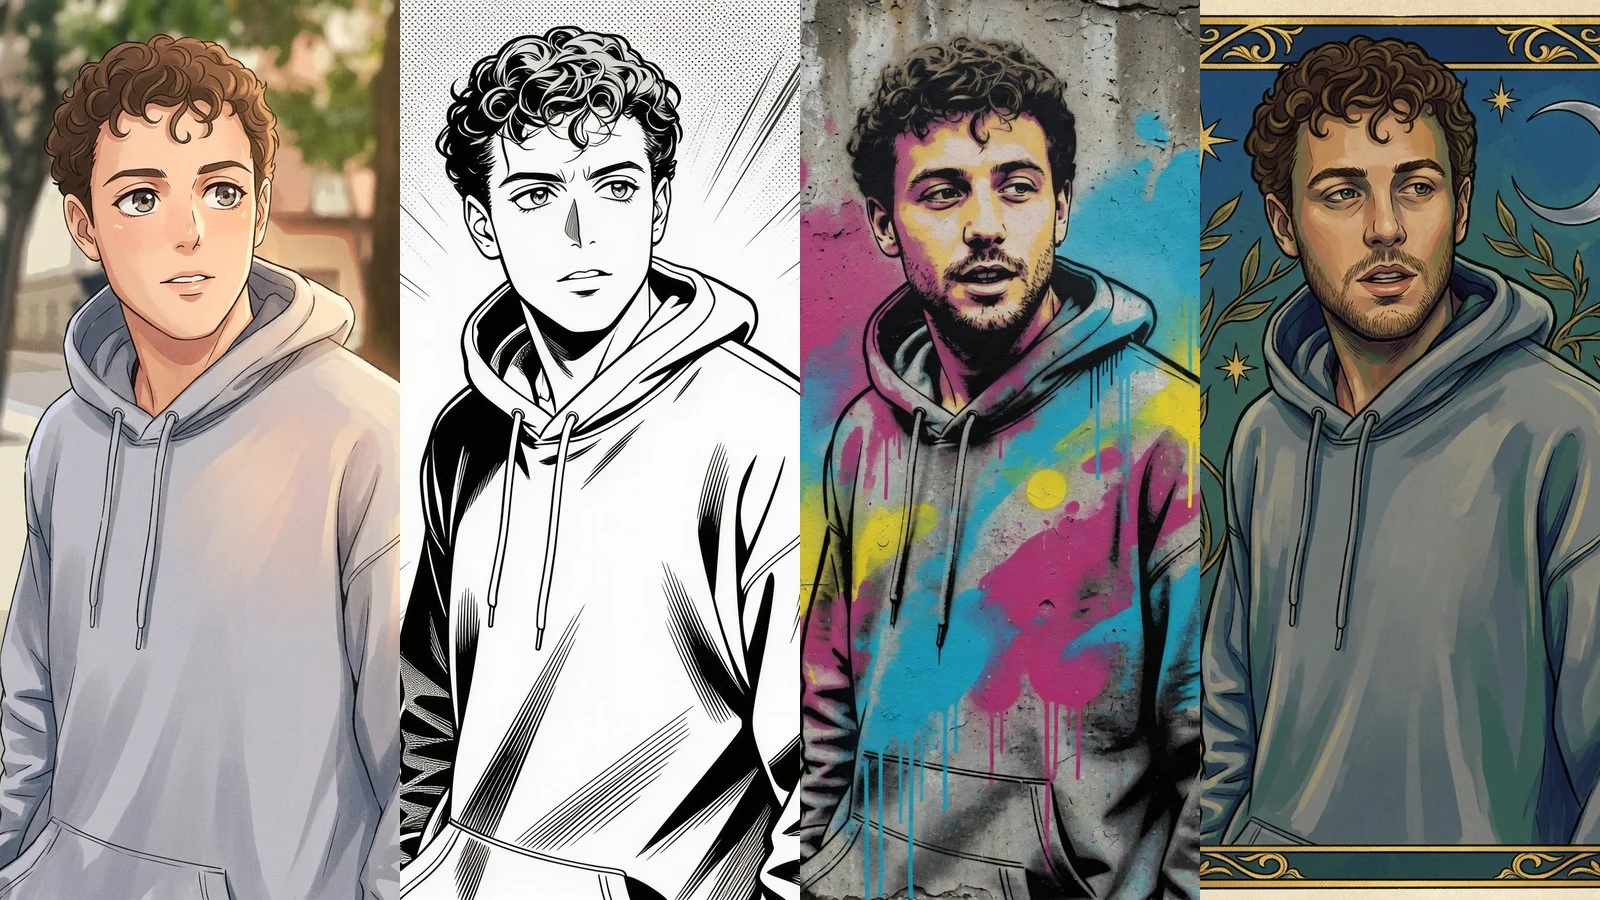
Quatro modelos i2i, uma foto de referência, quatro resultados completamente diferentes. Abaixo estão os prompts exatos que escrevemos e executamos — cena de filme de anime, painel de mangá, mural de grafite e retrato de tarô — cada grupo acompanhado da imagem real gerada e da chamada de API para reproduzi-lo.
Em resumo: nas quatro estilos, a pose, o penteado e as características de identidade foram preservados com sucesso, porque cada prompt deixa explícito o que preservar ("mesma pose", "mesmo penteado", "mesmo contorno do moletom") e, ao mesmo tempo, o que alterar. Se removermos essa metade do prompt, todos os modelos que testamos desviam o sujeito para um rosto genérico, em vez da sua própria versão estilizada.
Referência rápida: escolha seu estilo
| Estilo | Modelo | Resolução | Preço |
|---|---|---|---|
| 1. Cena de filme de anime | nano-banana-2 |
1K | $0,085/imagem |
| 2. Painel de mangá | seedream-4.5/image-to-image |
2K | $0,045/imagem |
| 3. Mural de grafite | grok-imagine-quality/image-to-image |
1k | $0,08/imagem + custo da imagem de referência |
| 4. Retrato de carta de tarô | nano-banana-2 |
1K | $0,085/imagem |
Os preços são calculados por imagem de saída única na resolução indicada, com dados obtidos recentemente do endpoint de preços da hiapi em 2026-09 — antes de orçar em lote, consulte a página de preços da hiapi, pois as tarifas de cada modelo mudam. O endpoint image-to-image do Grok Imagine Quality cobra uma pequena taxa adicional por imagem de referência além do preço base; cada chamada abaixo usa apenas uma imagem de referência, então o orçamento total para esse item fica em torno de $0,09–$0,10.
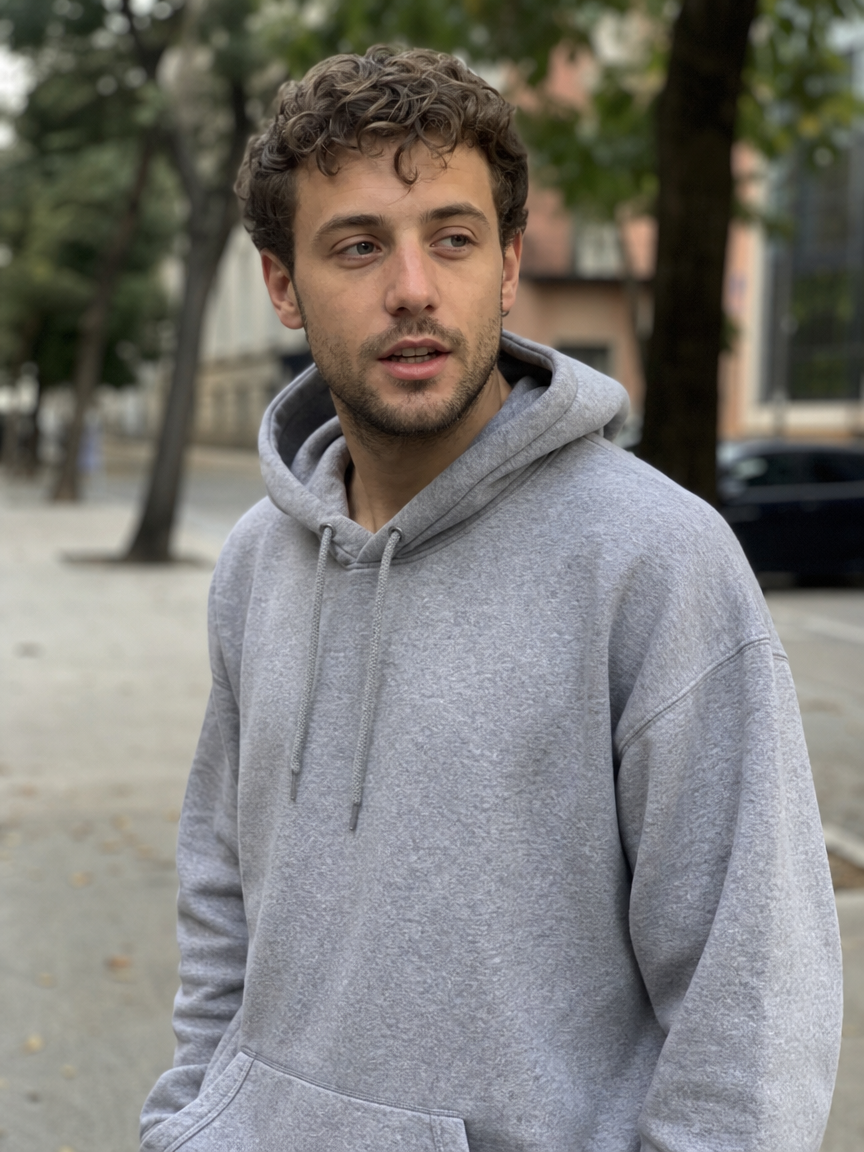
Abaixo está a foto de referência usada em cada receita:
Receita 1: Cena de filme de anime
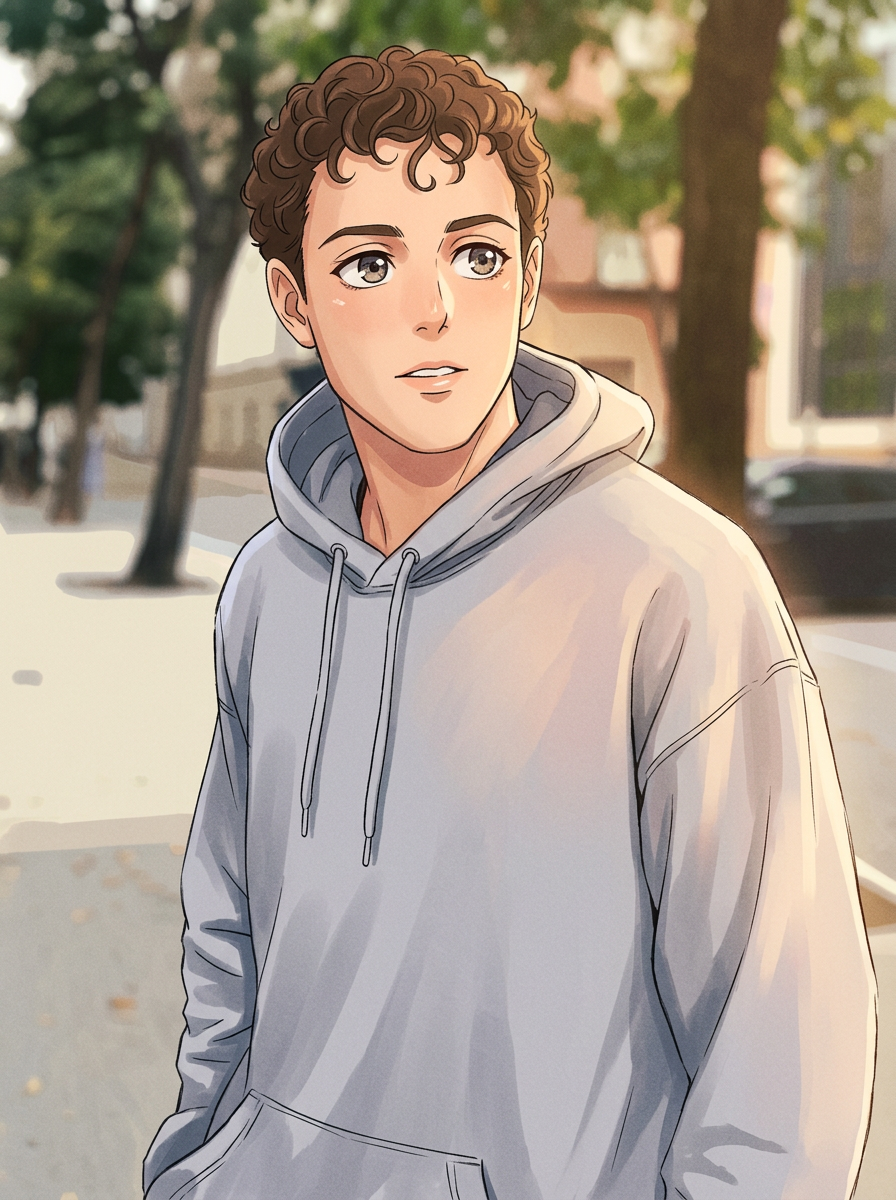
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Por que funciona: a maior parte do texto deste prompt trata de textura, não do sujeito — "cel shading suave", "textura de pincel visível", "brilho de luz" — porque o sujeito já está fixado pela imagem de referência. Redesenhar os olhos "em proporções de anime" é o único ponto em que deixamos intencionalmente o modelo se afastar da foto; todo o resto ("mesmo penteado, pose e cor do moletom") é explicitamente travado, então o resultado continua reconhecível como a mesma pessoa, apenas ilustrada.
Reproduza:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Faça polling em GET https://api.hiapi.ai/v1/tasks/{taskId} até que status seja success, depois baixe output[0].url — esse link expira, então salve-o imediatamente em um local permanente. Substitua image_input pelo seu próprio retrato e a estrutura do prompt se aplica a qualquer sujeito com pose e penteado nítidos.
Receita 2: Painel de mangá em preto e branco
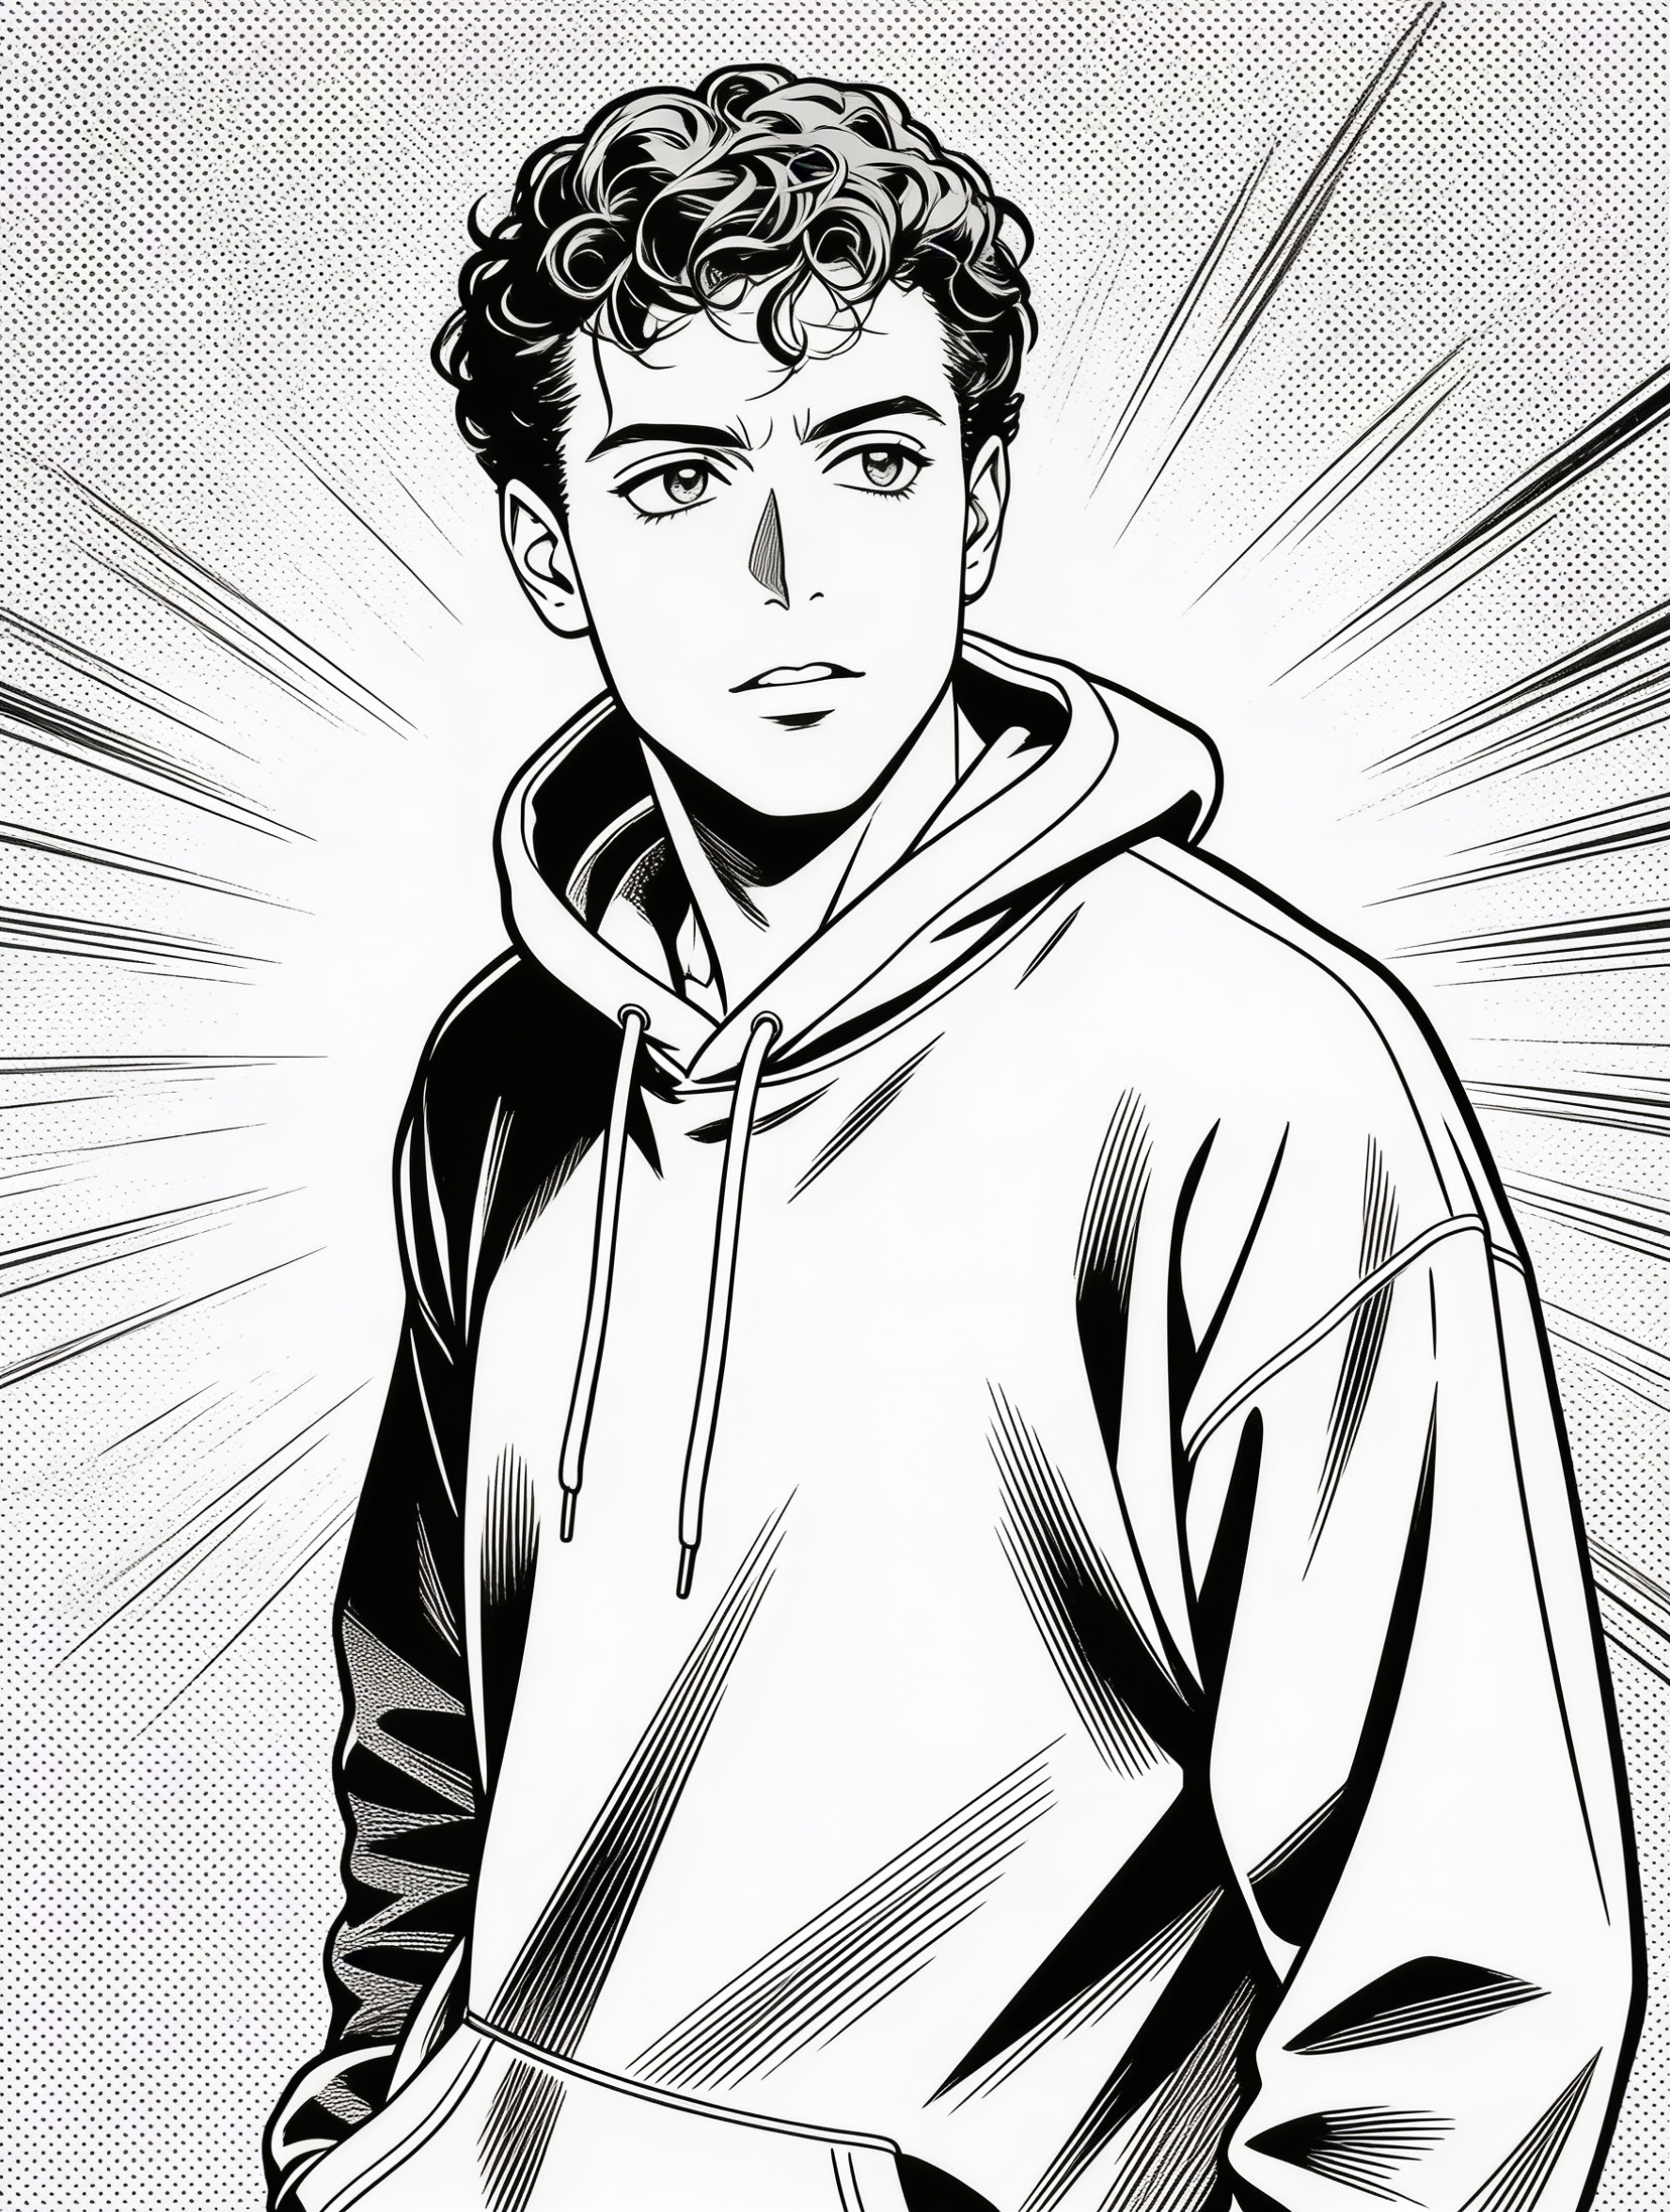
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Por que funciona: o sucesso do estilo mangá depende de duas coisas que este prompt nomeia diretamente — a retícula (o sombreamento pontilhado que o mangá real usa no lugar de gradientes) e a espessura do traço ("traço de tinta nítido", "linhas faciais ... afiadas"). Sem nomear explicitamente a retícula, os modelos i2i tendem a usar sombreamento chapado genérico de anime, em vez do efeito de meio-tom que realmente parece mangá. O "sem cor, sem texto, sem balões de fala" foi incluído porque modelos treinados em mangá às vezes geram bordas de painel ou texto de diálogo do nada se você não os excluir explicitamente.
Reproduza:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
O mesmo padrão de POST /v1/tasks e polling da Receita 1 — seedream-4.5/image-to-image apenas coloca a imagem de referência em image_urls (plural, array) em vez de image_input, e cobra uma taxa fixa de $0,045 independentemente da faixa de resolução.
Receita 3: Mural de grafite com tinta spray
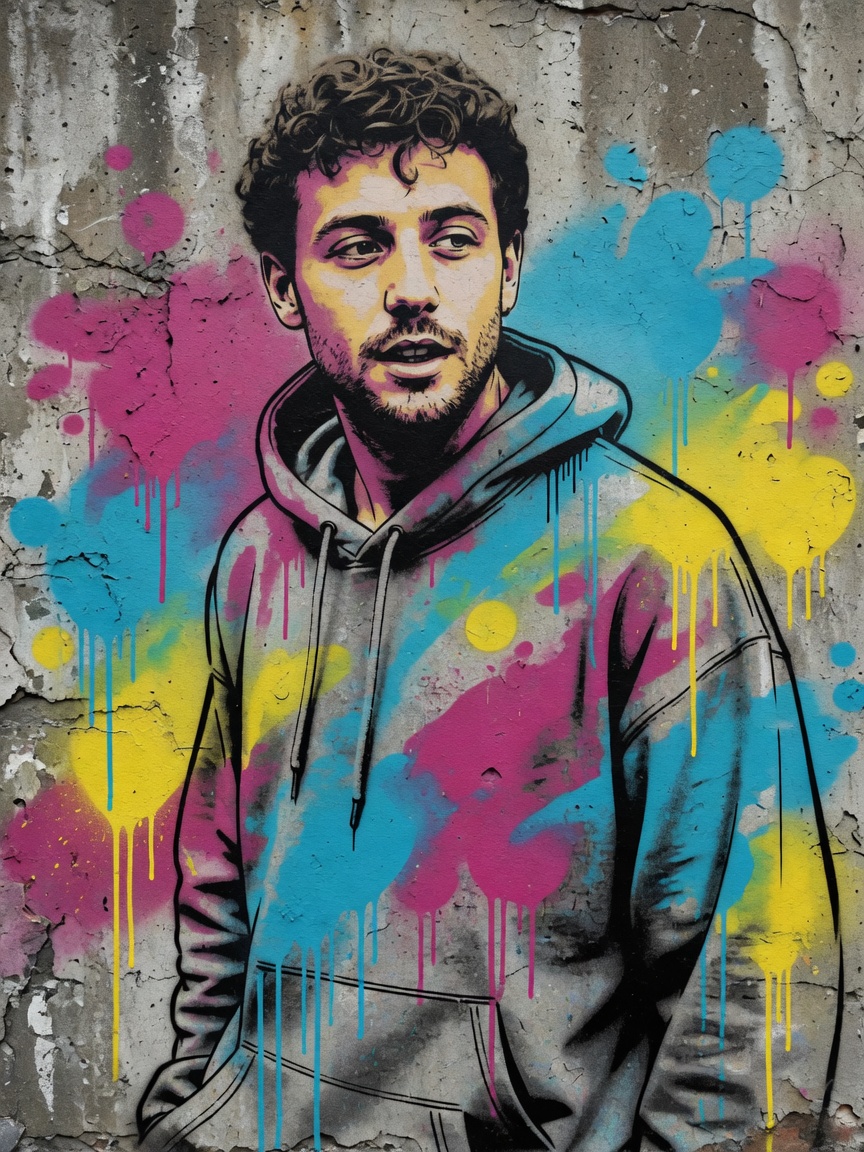
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Por que funciona: o grafite é uma das poucas estilos em que nomear a técnica (estêncil, escorridos de tinta spray, traços de contorno ousados) importa mais do que nomear o sujeito. A lista de cores — "magenta, ciano e amarelo" — também faz diferença prática: deixando as cores em aberto, a maioria dos modelos i2i adota tons lamacentos e dessaturados em vez dos preenchimentos chapados e saturados de um mural real de tinta spray. Como nas outras três receitas, "manter a mesma pose, penteado e formato do moletom" é o que impede o mural de virar um rosto genérico de arte de rua.
Reproduza:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Observe o "1k" em minúsculas aqui — diferente dos outros dois modelos acima, o schema do Grok Imagine Quality diferencia maiúsculas de minúsculas no valor de resolução. Este endpoint não tem campo aspect_ratio; a composição da saída segue sua imagem de referência.
Receita 4: Retrato de carta de tarô
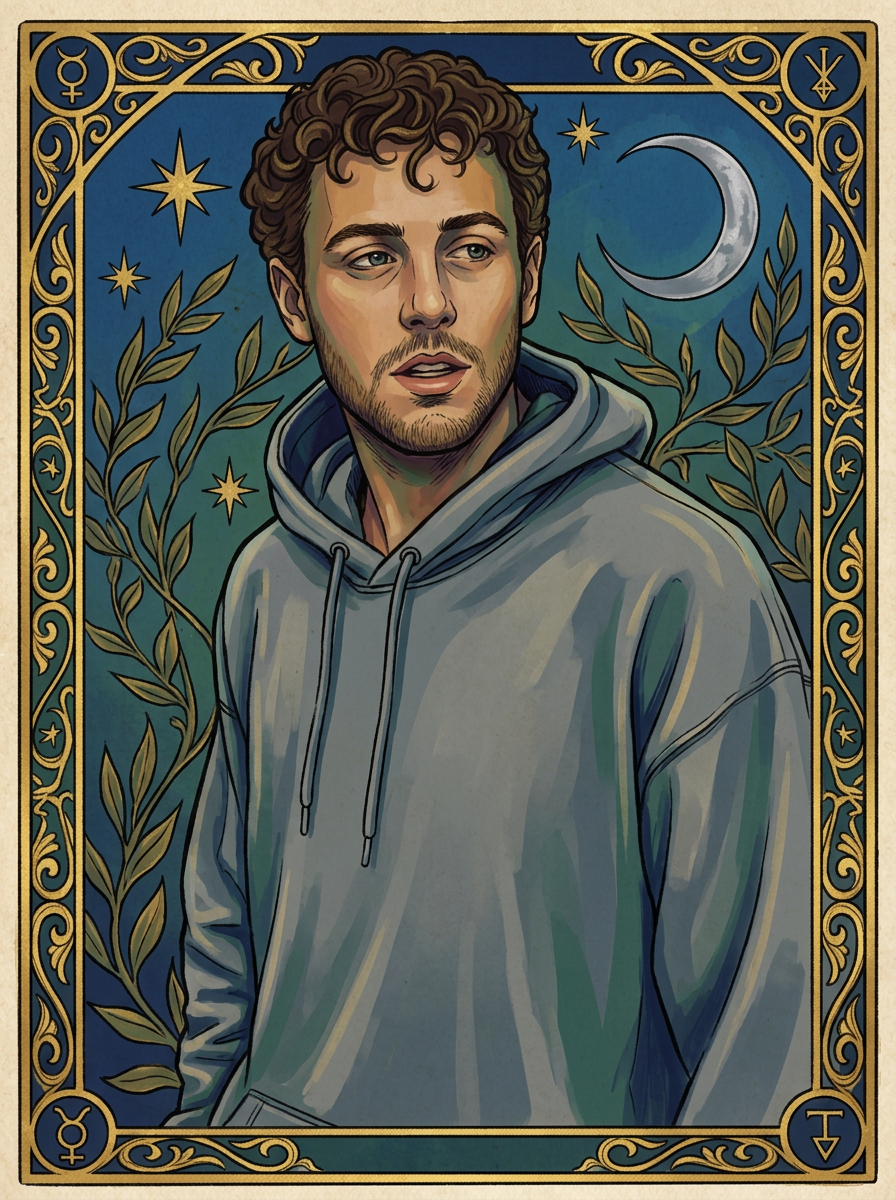
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Por que funciona: a aparência de carta de tarô vem quase inteiramente de elementos de moldura sem relação com o sujeito — a borda de filigrana dourada, os símbolos místicos de fundo (estrelas, lua crescente, ramos de louro). Nomear explicitamente esses elementos é o que transforma um "retrato com sombreamento ornamentado" em uma "carta de tarô reconhecível à primeira vista". Também excluímos explicitamente números e nomes de carta ("sem texto, sem nome de carta, sem numerais"), porque modelos treinados em cartas de tarô reais adicionam texto de nome de carta provisório se não forem explicitamente impedidos.
Reproduza:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Mesmo modelo da Receita 1 (nano-banana-2), prompt diferente — um bom lembrete de que, na transferência de estilo i2i, a escolha do modelo importa menos do que a especificidade do prompt sobre "o que preservar e o que reimaginar".
Perguntas frequentes
Qual modelo é melhor para transferência de estilo de foto para anime?
Entre os três modelos que testamos, nano-banana-2 manteve as características de identidade (pose, penteado, proporções) de forma mais consistente em várias execuções repetidas, ao preço de $0,085/imagem (1K). seedream-4.5/image-to-image é a opção mais barata, com taxa fixa de $0,045/imagem, adequada para estilos baseados em traço como o mangá; grok-imagine-quality/image-to-image se aproxima mais de um redesenho completo, adequado a casos como o grafite em que certo desvio do sujeito já faz parte do estilo.
Esses prompts precisam de uma foto específica para funcionar? Retratos nítidos de frente ou de três quartos, com penteado e roupa visíveis, dão os resultados mais estáveis — é essa a premissa que os quatro prompts acima assumem ao dizer "mesma pose, penteado e moletom". Fundos desordenados ou rostos parcialmente obstruídos dificultam o modelo a decidir o que preservar.
Posso combinar esses prompts, por exemplo, um tarô em estilo anime? Sim — substitua a linguagem relacionada à técnica (cel shading vs. retícula vs. textura de tinta spray) mantendo a linguagem de moldura da outra receita (borda e símbolos dourados do tarô, ou a textura de parede do grafite). As duas metades de cada prompt — preservação do sujeito e técnica de estilo — foram escritas de forma modular.
Por que alguns desses prompts especificam "sem texto" ou "sem marca d'água"? Modelos treinados em cenas reais de anime, páginas de mangá e cartas de tarô viram muitos exemplos que já contêm texto — créditos, onomatopeias, nomes de cartas — e às vezes adicionam texto provisório por conta própria. A exclusão explícita impede isso antecipadamente; não custa nada adicionar ao prompt e economiza uma geração desperdiçada.
A resolução afeta o preço desses modelos?
Depende do modelo. O preço de nano-banana-2 e seedream-4.5 em alguns endpoints realmente varia com a faixa de resolução, embora seedream-4.5/image-to-image especificamente cobre uma taxa fixa de $0,045 independentemente da faixa. Antes de orçar em lote, sempre consulte a página de preços em tempo real da hiapi — as tarifas variam por modelo e são atualizadas de forma independente.
Pontos principais
- Cada prompt acima se divide em duas metades: o que preservar (pose, penteado, identidade) e o que alterar (estilo artístico, técnica, composição) — escreva as duas claramente, ou o modelo desviará silenciosamente o sujeito para algo genérico.
- Nomear a técnica, não apenas o estilo-alvo, gera resultados mais precisos: "padrão de pontos de retícula" supera "estilo mangá"; "destaques de estêncil e escorridos de tinta spray" supera "estilo grafite".
- Exclua o que o modelo tende a gerar do nada em um estilo específico — texto provisório, números de carta, balões de fala — mesmo que você ache que não precisa.
grok-imagine-quality/image-to-imageusa valor de resolução minúsculo ("1k", não"1K") e não tem campoaspect_ratio; verifique o schema de cada modelo em vez de assumir que é igual ao que você usou antes.- Os quatro prompts são pontos de partida prontos para copiar e colar — substitua por sua própria foto de referência via
image_inputouimage_urlse a mesma estrutura se aplica a sujeitos diferentes.
Quer ver como um único modelo i2i lida com várias faixas de resolução e quantidades de imagens de referência antes de escolher um modelo para tarefas em lote? O tutorial da API Nano Banana 2 aprofunda autenticação, estrutura de requisição e tratamento de erros. Ou vá direto para a página do modelo nano-banana-2 e execute com sua própria foto de referência.
Artigos relacionados
Ver todos os artigos →-

Inventário
Alternativas à Hugging Face Inference API recomendadas (2026): uma API para chamar imagem/vídeo/áudio/LLMs
Modelo de preços, amplitude de cobertura de modelos, complexidade de integração, compatibilidade com OpenAI — entenda em que cenário vale trocar o roteamento agregado por uma API de geração unificada
-

Inventário
Como escolher uma alternativa ao RunPod: comparação de integração de APIs de imagem e vídeo
RunPod é nuvem de GPU, não API de geração — primeiro entenda em qual camada você deve usar para imagem e vídeo.
-

Inventário
Como escolher uma alternativa ao Modal: comparação de acesso a APIs de imagem e vídeo