
棚卸し
写真スタイル転送プロンプトレシピ:アニメ、漫画、グラフィティ、タロットカード
私たち自身が作成し実際に実行した4組のAI写真→アートスタイル転送プロンプト——アニメ映画のワンシーン、漫画のコマ、グラフィティ壁画、タロットカードのポートレート——実際のビフォーアフター画像と再現に必要なAPI呼び出し付き。
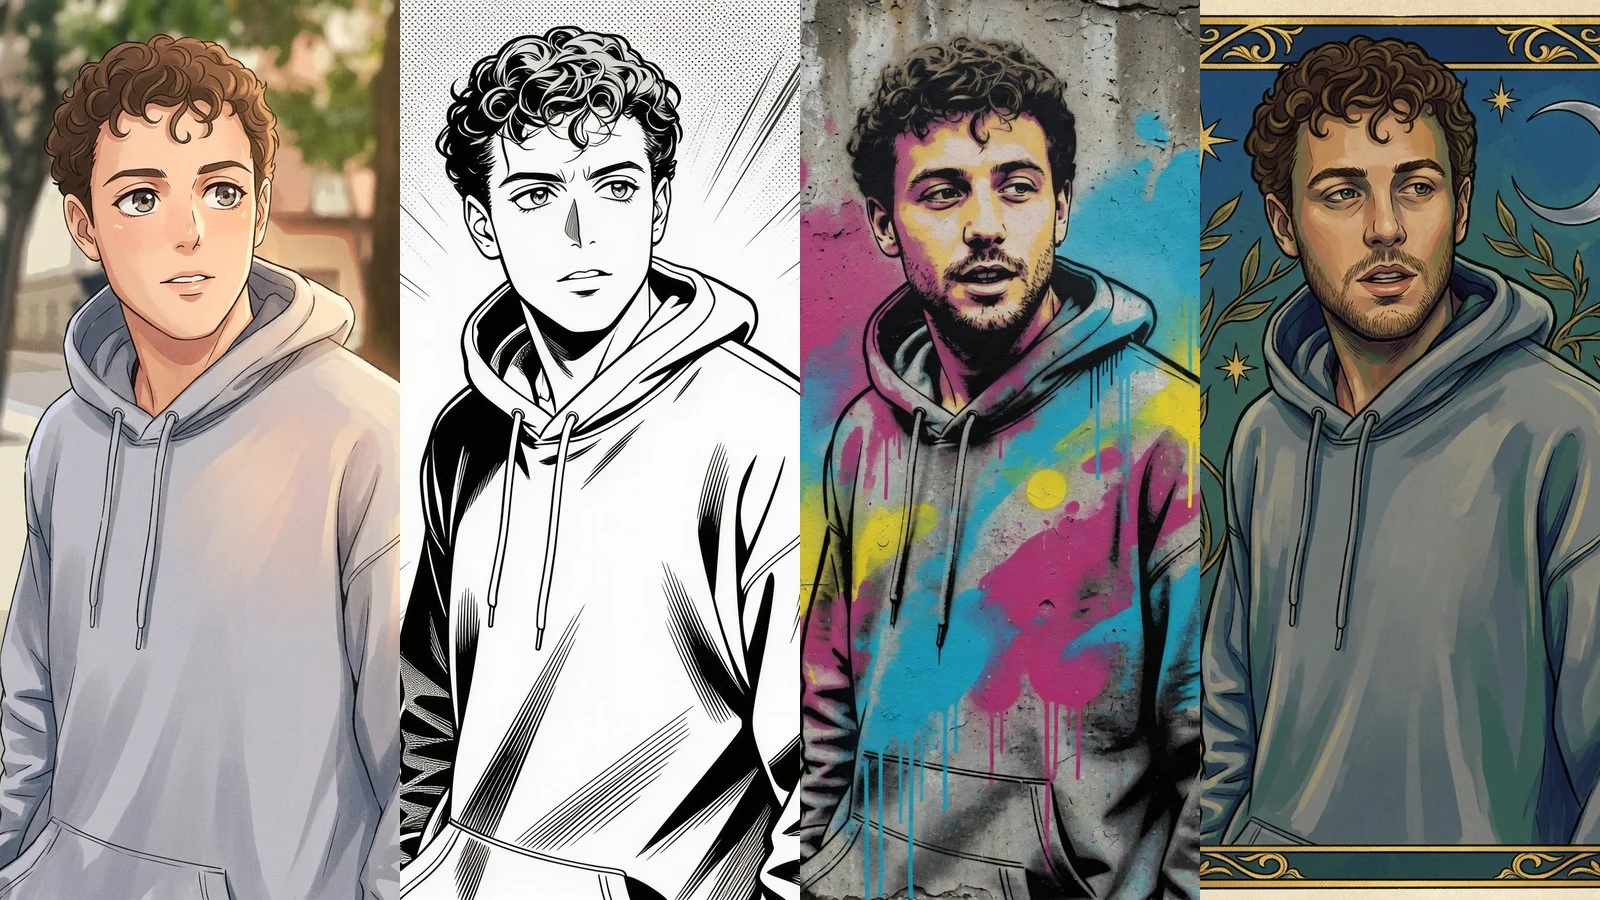
4つのi2iモデル、1枚の参考写真、4つのまったく異なる結果。以下は私たちが自ら作成し実行した正確なプロンプト——アニメ映画のワンシーン、漫画のコマ、グラフィティ壁画、タロットカードのポートレート——で、それぞれに実際に生成された画像とそれを再現するAPI呼び出しを添えています。
要するに:4つのスタイルすべてで、ポーズ、髪型、人物の同一性が首尾よく保たれました。それは各プロンプトが保持すべきもの(「同じポーズ」「同じ髪型」「同じパーカーのシルエット」)を明示すると同時に、変更すべきものも明示しているからです。この後半部分をプロンプトから外すと、私たちがテストしたすべてのモデルは、被写体をあなた自身のスタイル化されたバージョンではなく、ありふれた顔へと漂流させてしまいました。
クイックリファレンス:スタイルを選ぶ
| スタイル | モデル | 解像度 | 価格 |
|---|---|---|---|
| 1. アニメ映画のワンシーン | nano-banana-2 |
1K | $0.085/枚 |
| 2. 漫画のコマ | seedream-4.5/image-to-image |
2K | $0.045/枚 |
| 3. グラフィティ壁画 | grok-imagine-quality/image-to-image |
1k | $0.08/枚 + 参考画像料金 |
| 4. タロットカードのポートレート | nano-banana-2 |
1K | $0.085/枚 |
価格は表示された解像度で1枚の画像を出力する場合の計算で、データは2026-09にhiapiの価格エンドポイントから最新取得したものです——バッチの予算を立てる前にhiapiの価格ページを確認してください。モデルごとに料率が変動するためです。Grok Imagine Qualityの画像→画像エンドポイントは基本価格に加えて、参考画像1枚ごとに少額の追加料金がかかります。以下の各呼び出しは参考画像を1枚だけ使うので、この項目の総予算は約$0.09〜$0.10です。
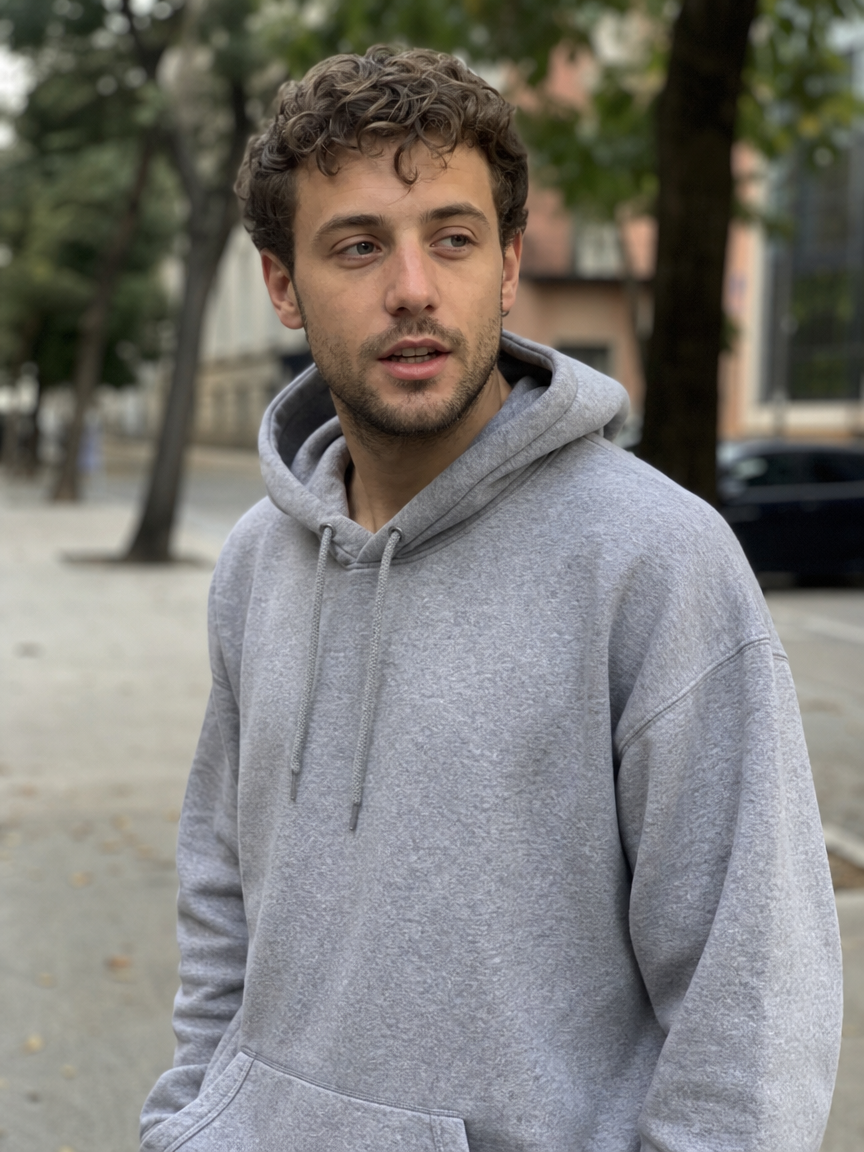
以下は下の各レシピで使用する参考写真です:
レシピ1:アニメ映画のワンシーン
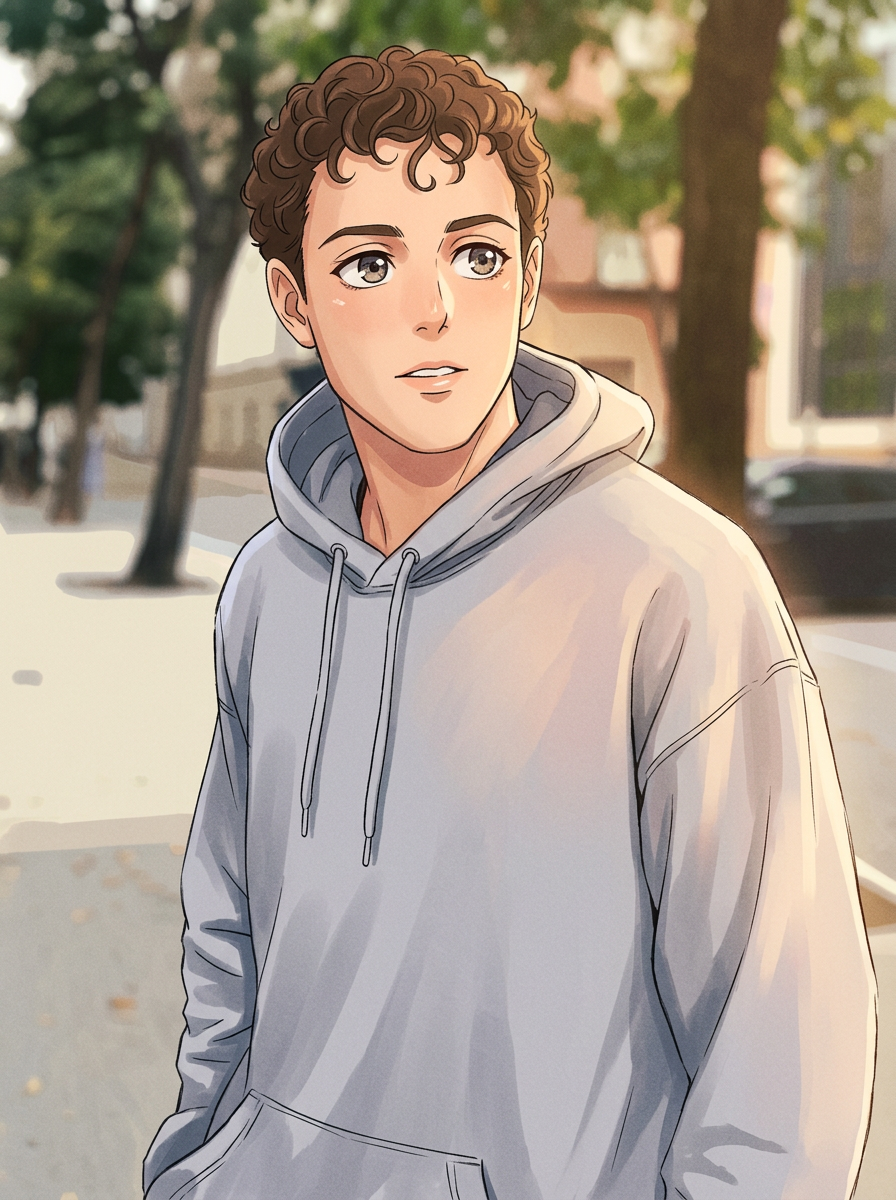
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
なぜ効くのか:このプロンプトの文字の大部分は被写体ではなく質感に割かれています——「セル画調」「目に見える筆のテクスチャ」「光のブルーム」——被写体はすでに参考写真で固定されているからです。目を「アニメの比率で」描き直すのが、私たちが意図的にモデルを写真から逸脱させた唯一の箇所です。それ以外(「同じ髪型、ポーズ、パーカーの色」)はすべて明示的に固定しているので、結果はイラスト化されつつも同じ人物だと認識できます。
再現する:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
GET https://api.hiapi.ai/v1/tasks/{taskId}をstatusがsuccessになるまでポーリングし、output[0].urlをダウンロードします——このリンクには有効期限があるので、すぐに恒久的な場所へ保存してください。image_inputを自分のポートレートに置き換えれば、このプロンプト構造はポーズと髪型がはっきりしたあらゆる被写体に使えます。
レシピ2:白黒漫画のコマ
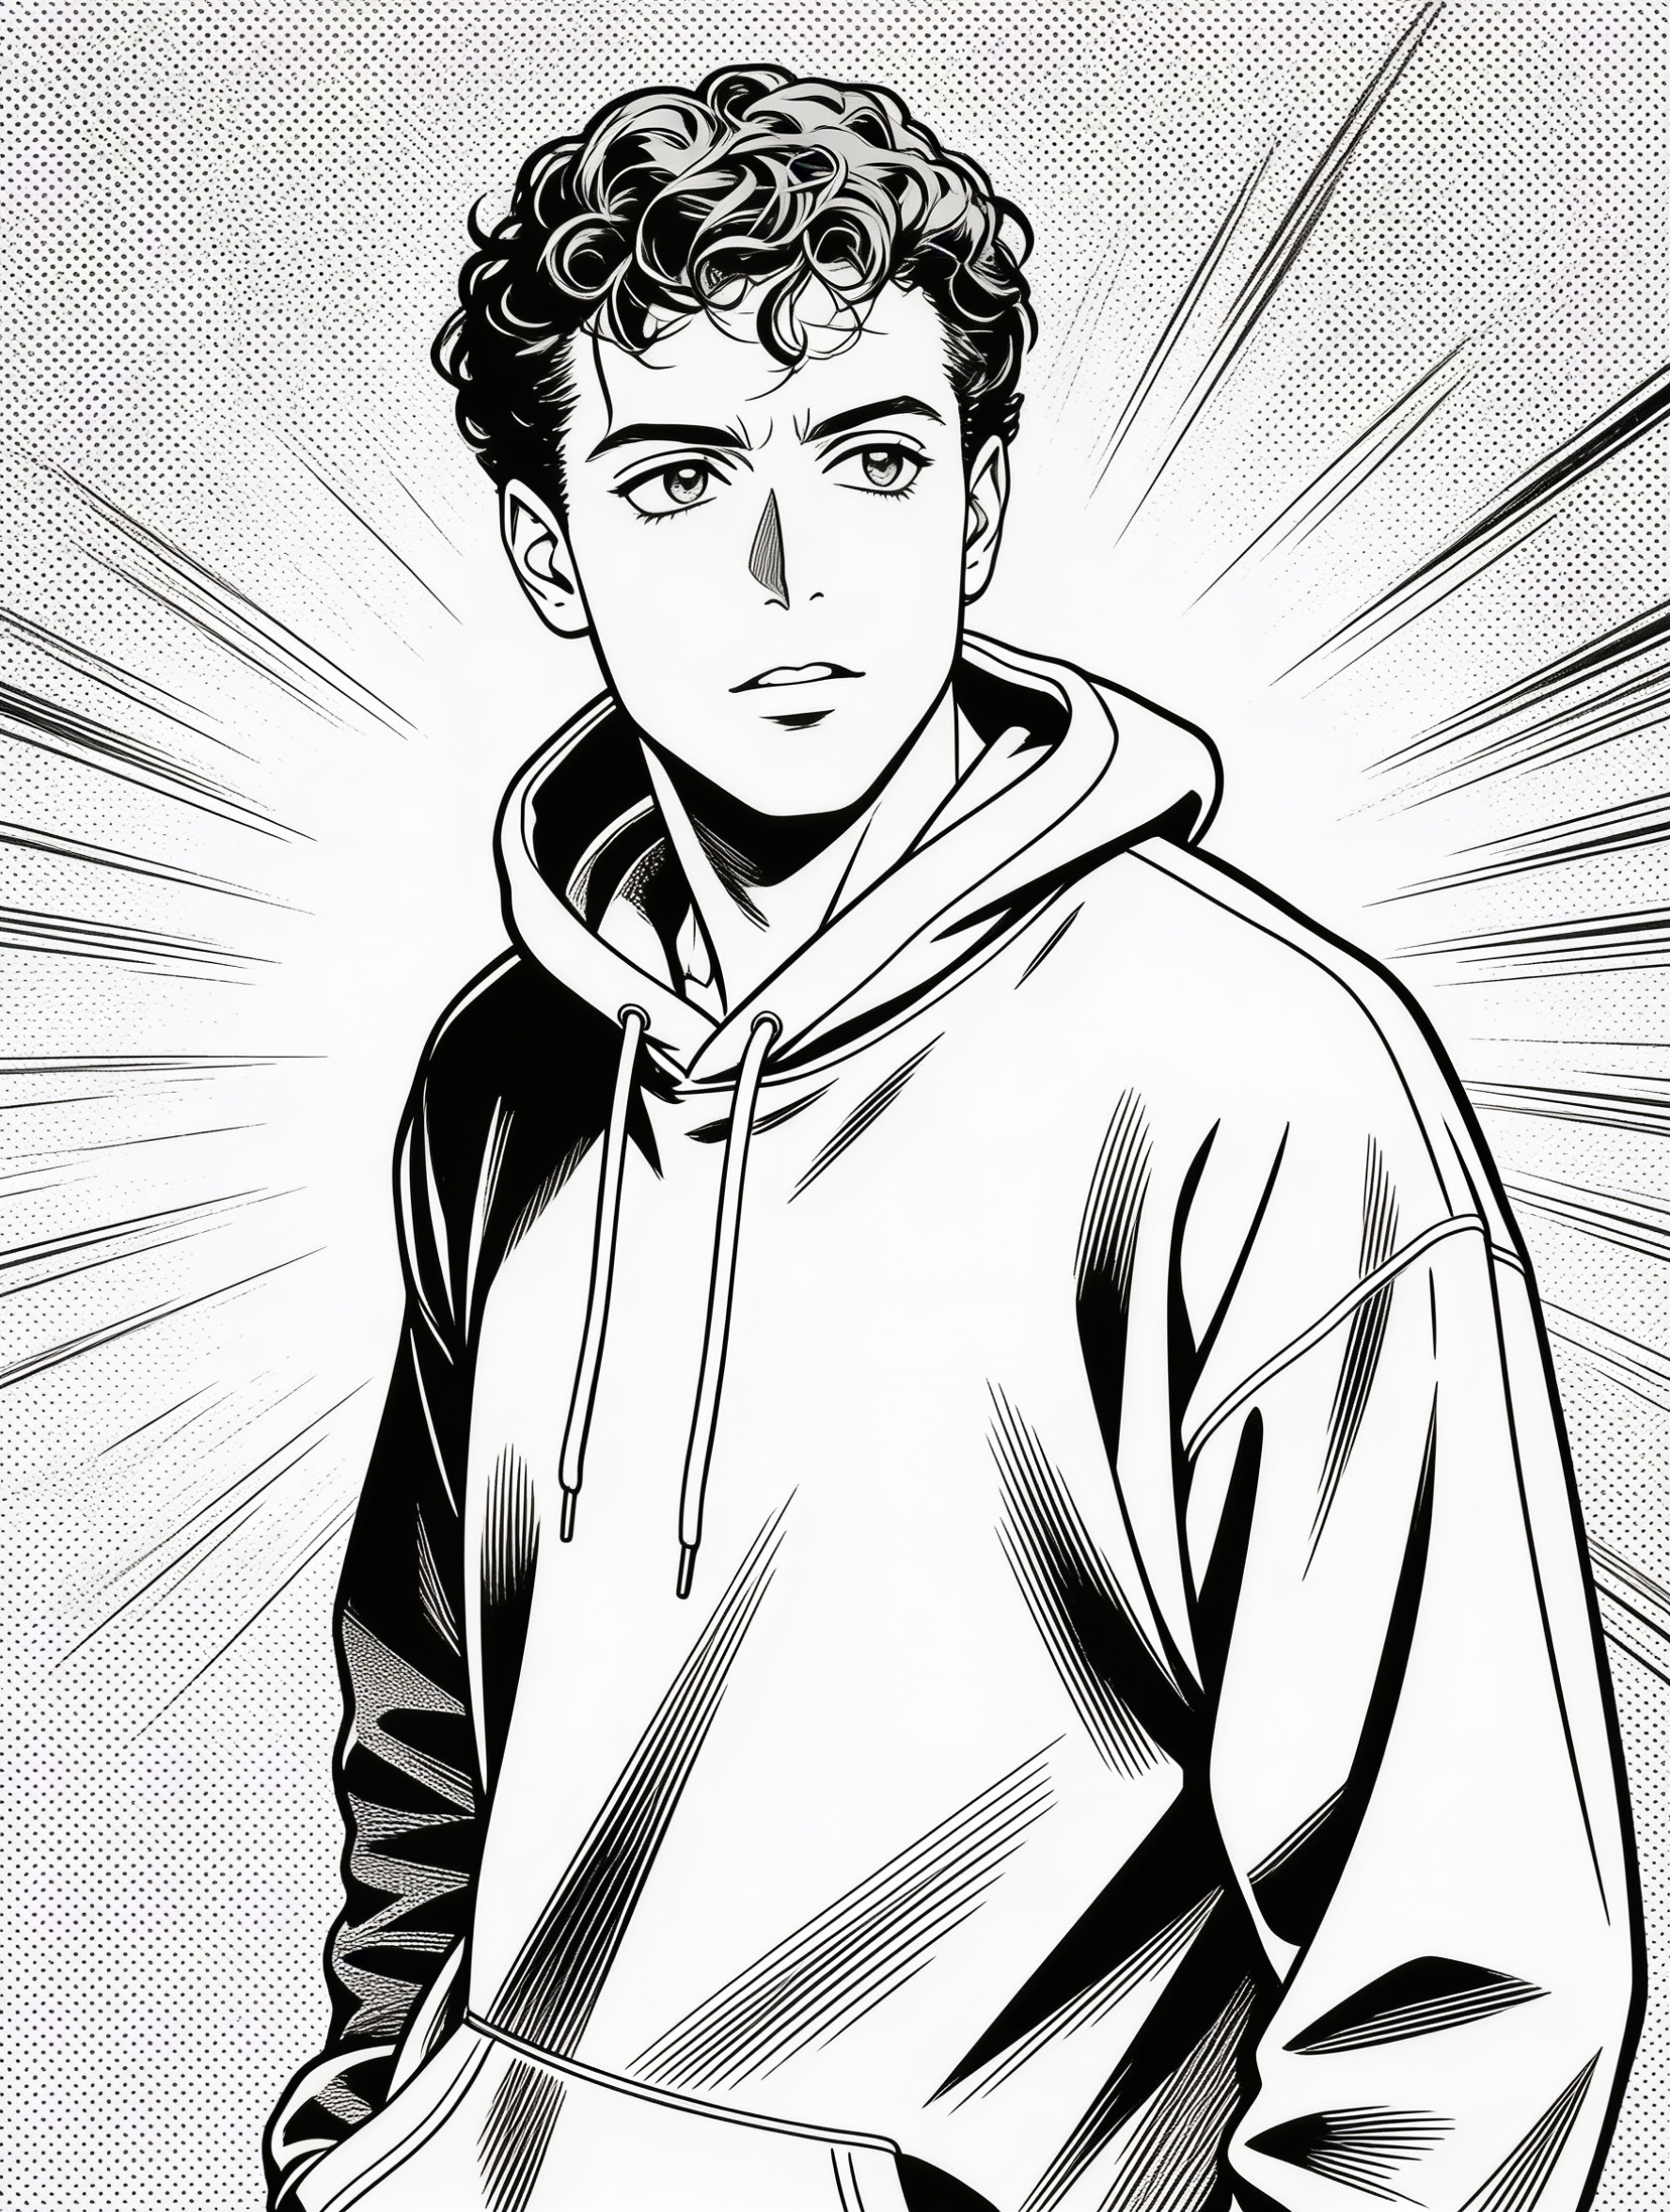
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
なぜ効くのか:漫画スタイルの成否は、このプロンプトが直接名指しする2つの要素にかかっています——スクリーントーン(実際の漫画でグラデーションの代わりに使われる点状の陰影)と線の太さ(「くっきりしたインクの線」「鋭い……顔の線画」)。スクリーントーンを明示しないと、i2iモデルは本物の漫画らしいハーフトーンの網点効果ではなく、汎用的なアニメ風のフラットな陰影をデフォルトで選びがちです。「色なし、文字なし、吹き出しなし」を加えたのは、漫画で学習したモデルは明示的に排除しないとコマ枠やセリフを勝手に生成することがあるためです。
再現する:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
レシピ1と同じ/v1/tasksへのPOSTとポーリングのパターンです——seedream-4.5/image-to-imageは参考画像をimage_inputではなくimage_urls(複数形、配列)に置くだけで、解像度の段階に関係なく固定$0.045で課金されます。
レシピ3:スプレーペイントのグラフィティ壁画
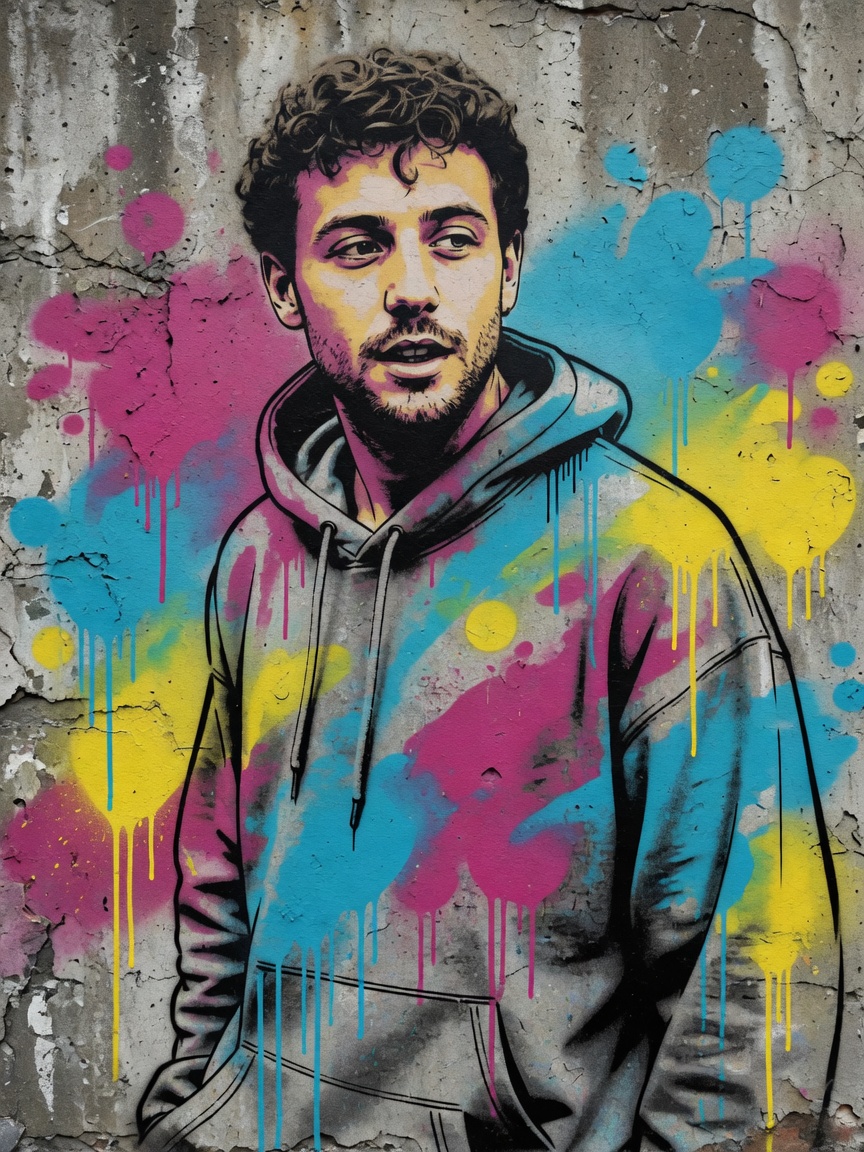
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
なぜ効くのか:グラフィティは、被写体よりも技法(ステンシル、スプレーの垂れ、太い輪郭線)を名指しすることのほうが重要な、数少ないスタイルのひとつです。色のリスト——「マゼンタ、シアン、イエロー」——も実際に効果を発揮します。色をオープンにしておくと、ほとんどのi2iモデルは本物のスプレー壁画のようなフラットで彩度の高い塗りではなく、濁った低彩度の色調をデフォルトで選ぶからです。他の3つのレシピと同様、「同じポーズ、髪型、パーカーの形を保つ」が、壁画が平凡なストリートアートの顔に変わってしまうのを防ぐ鍵です。
再現する:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
ここでは小文字の"1k"であることに注意してください——上記の他の2モデルとは異なり、Grok Imagine Qualityのスキーマは解像度の値で大文字小文字を区別します。このエンドポイントにはaspect_ratioフィールドはなく、出力の構図は参考画像に従います。
レシピ4:タロットカードのポートレート
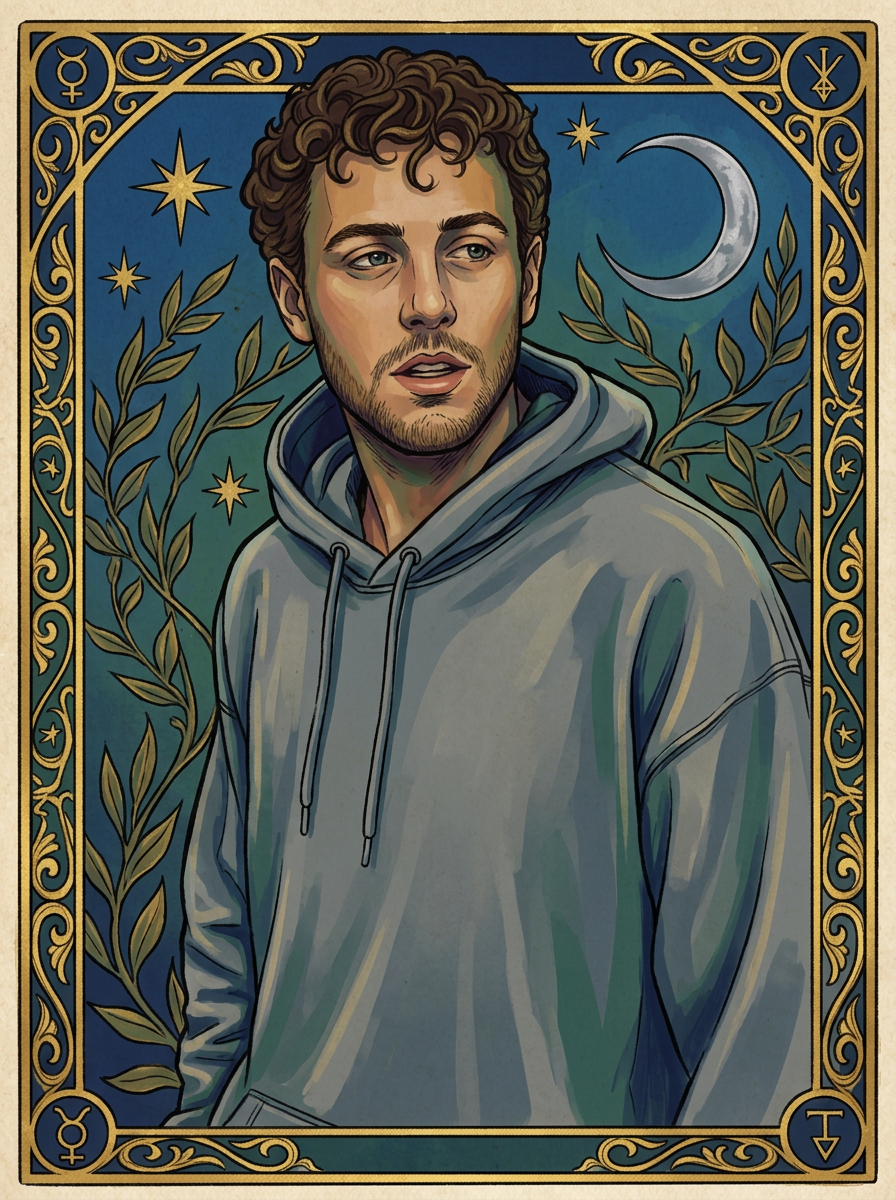
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
なぜ効くのか:タロットカードの見た目は、ほぼ完全に被写体とは無関係な枠の要素から来ています——金色のフィリグリー枠、神秘的な背景のシンボル(星、三日月、月桂樹の枝)。これらを明示的に名指しすることで初めて、「装飾的な陰影のあるポートレート」が「ひと目でタロットカードと分かるもの」になります。また、カードの数字と名前も明示的に排除しました(「文字なし、カード名なし、数字なし」)。本物のタロットカードで学習したモデルは、排除しないとプレースホルダーのカード名文字を加えてしまうからです。
再現する:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
レシピ1と同じモデル(nano-banana-2)で、プロンプトだけが異なります——i2iのスタイル転送では、モデル選択よりも「何を保持し何を再構想するか」をプロンプトでどれだけ具体的に示すかのほうが重要だという、よい例です。
よくある質問
写真をアニメに変換するスタイル転送には、どのモデルが最適ですか?
私たちがテストした3モデルの中では、nano-banana-2が複数回の繰り返し実行で最も安定して人物の同一性(ポーズ、髪型、比率)を保ち、価格は$0.085/枚(1K)でした。seedream-4.5/image-to-imageは固定$0.045/枚のより安価な選択肢で、漫画のような線主体のスタイルに向いています。grok-imagine-quality/image-to-imageはより全面的な描き直しに近く、被写体がある程度逸脱すること自体がスタイルの一部となるグラフィティのようなケースに向いています。
これらのプロンプトは特定の写真でないと効果が出ませんか? 髪型と服装が見える、はっきりした正面向きまたは斜め45度のポートレートが最も安定した結果になります——これは上記4つのプロンプトが「同じポーズ、髪型、パーカー」と言うときに前提としている条件でもあります。背景がごちゃごちゃしていたり、顔が部分的に隠れていると、モデルが何を保持すべきか判断しにくくなります。
これらのプロンプトを組み合わせることはできますか、たとえばアニメ風のタロットカードなど? できます——技法に関する言語(セル画調 vs. スクリーントーン vs. スプレーのテクスチャ)を置き換えつつ、別のレシピの枠の言語(タロットカードの金色の枠とシンボル、またはグラフィティの壁のテクスチャ)を残します。各プロンプトの2つの半分——被写体の保持とスタイル技法——はモジュール式に書かれています。
なぜ一部のプロンプトで「文字なし」や「ウォーターマークなし」を指定するのですか? 本物のアニメ映画のワンシーン、漫画ページ、タロットカードで学習したモデルは、もともと文字を含む例を大量に見ています——スタッフクレジット、擬音、カード名など——そのためプレースホルダーの文字を自発的に加えることがあります。明示的に排除すればそれを未然に防げます。プロンプトに加えるコストはなく、無駄な生成を1回節約できます。
解像度はこれらのモデルの価格に影響しますか?
モデルによります。nano-banana-2とseedream-4.5は一部のエンドポイントで価格が解像度の段階に応じて変わりますが、seedream-4.5/image-to-imageは具体的に、段階に関係なく$0.045の固定です。バッチの予算を立てる前に必ずhiapiのリアルタイム価格ページを確認してください——料率はモデルごとに異なり、独立して更新されます。
要点
- 上記の各プロンプトは2つの半分に分かれています:保持すべきもの(ポーズ、髪型、同一性)と変更すべきもの(アートスタイル、技法、構図)——両方を明確に書かないと、モデルは被写体をこっそりとどこにでもあるようなものへ漂流させてしまいます。
- 目標のスタイルだけでなく技法を名指しすると、より正確な結果が得られます:「スクリーントーンの点状パターン」は「漫画スタイル」に勝り、「ステンシル風のハイライトとスプレーの垂れ」は「グラフィティスタイル」に勝ります。
- モデルが特定のスタイルで勝手に生成しがちなもの——プレースホルダーの文字、カードの数字、吹き出し——は、不要だと思う場合でも排除しましょう。
grok-imagine-quality/image-to-imageは小文字の解像度値("1K"ではなく"1k")を使い、aspect_ratioフィールドがありません。以前使ったモデルと同じだと仮定せず、各モデルのスキーマを確認してください。- 4つのプロンプトはいずれもコピー&ペーストで使える出発点です——
image_inputまたはimage_urlsで自分の参考写真に置き換えれば、同じ構造をさまざまな被写体に流用できます。
バッチタスク用にモデルを選ぶ前に、単一のi2iモデルが複数の解像度段階や参考画像の数にどう対応するか見てみたいですか?Nano Banana 2 APIチュートリアルでは、認証、リクエスト構造、エラー処理をより詳しく解説しています。あるいはnano-banana-2モデルページに直接アクセスして、自分の参考写真で試してみてください。


