
Inventario
Recetas de prompts para transferencia de estilo fotográfico: anime, manga, graffiti, tarot
Cuatro conjuntos de prompts de transferencia de estilo artístico de foto a imagen que escribimos y ejecutamos nosotros mismos —fotograma de película anime, viñeta de manga, mural de graffiti y retrato de carta de tarot— con comparativas reales de antes y después y las llamadas a la API necesarias para reproducirlos.
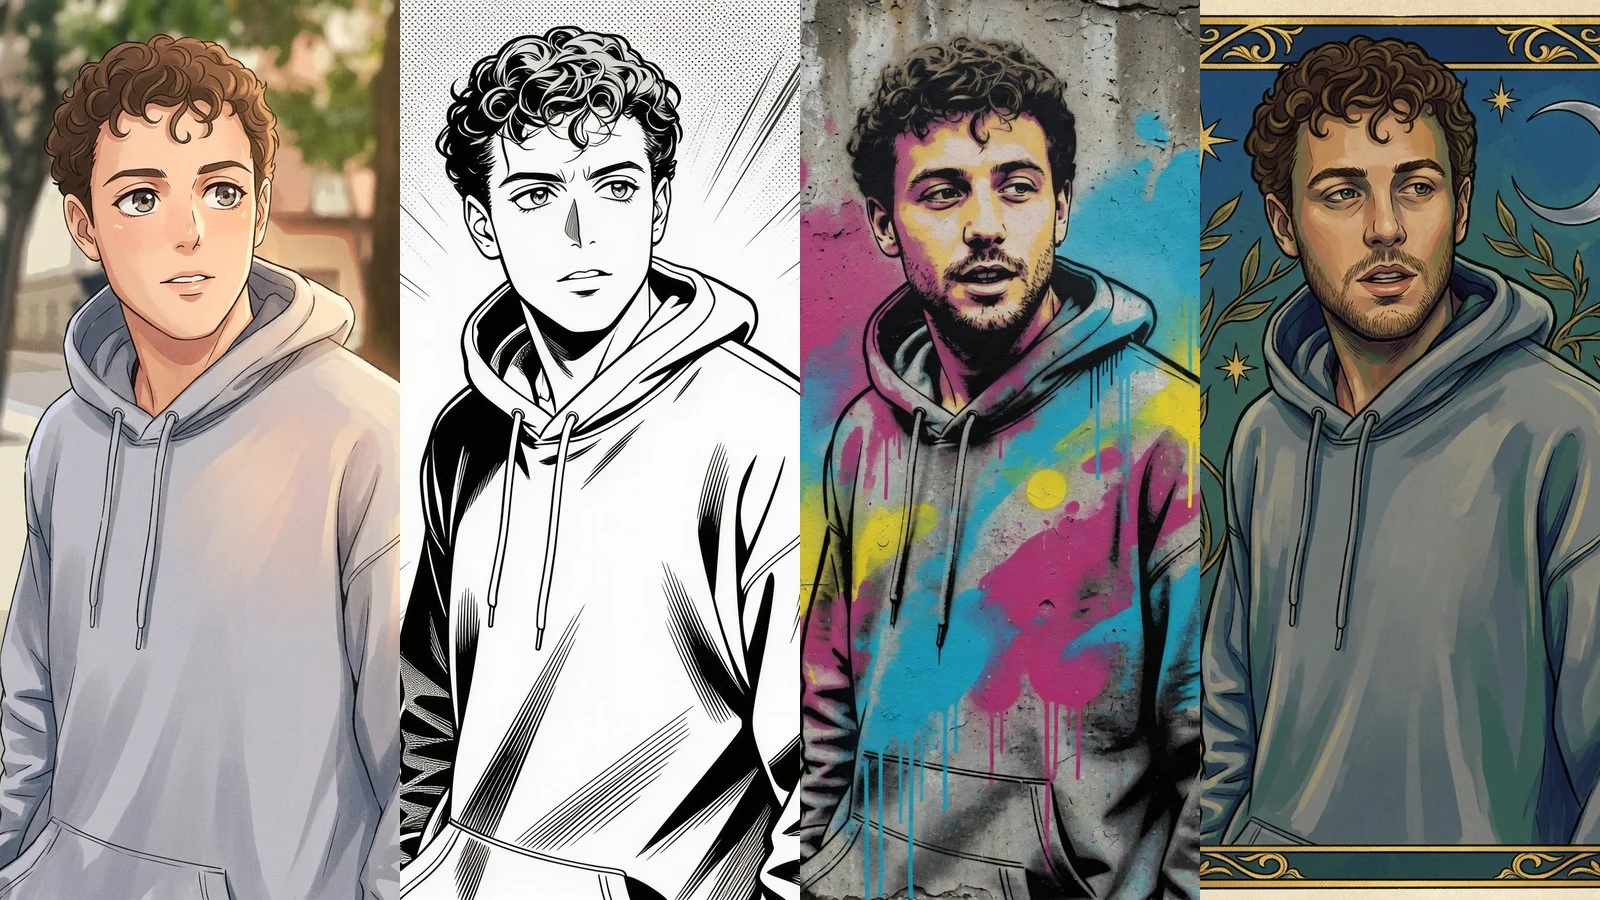
Cuatro modelos i2i, una foto de referencia, cuatro resultados completamente distintos. A continuación están los prompts exactos que escribimos y ejecutamos nosotros mismos —fotograma de película anime, viñeta de manga, mural de graffiti y retrato de carta de tarot—, cada uno acompañado de la imagen realmente generada y de la llamada a la API para reproducirla.
En resumen: en las cuatro estilos se conservaron con éxito la pose, el peinado y los rasgos de identidad, porque cada prompt especifica claramente qué conservar («misma pose», «mismo peinado», «misma silueta de sudadera con capucha») y también qué cambiar. Si se elimina esa mitad del prompt, cada modelo que probamos hace que el sujeto derive hacia una cara genérica en lugar de tu propia versión estilizada.
Referencia rápida: elige tu estilo
| Estilo | Modelo | Resolución | Precio |
|---|---|---|---|
| 1. Fotograma de película anime | nano-banana-2 |
1K | $0.085/imagen |
| 2. Viñeta de manga | seedream-4.5/image-to-image |
2K | $0.045/imagen |
| 3. Mural de graffiti | grok-imagine-quality/image-to-image |
1k | $0.08/imagen + coste de imagen de referencia |
| 4. Retrato de carta de tarot | nano-banana-2 |
1K | $0.085/imagen |
Los precios se calculan por imagen de salida individual a la resolución indicada, con datos obtenidos por última vez del endpoint de precios de hiapi en 2026-09; antes de presupuestar un lote, consulta la página de precios de hiapi, porque las tarifas de cada modelo cambian. El endpoint de imagen a imagen de Grok Imagine Quality cobra un pequeño cargo adicional por cada imagen de referencia sobre el precio base; cada llamada de abajo usa solo una imagen de referencia, así que el presupuesto total para este elemento es de aproximadamente $0.09–$0.10.
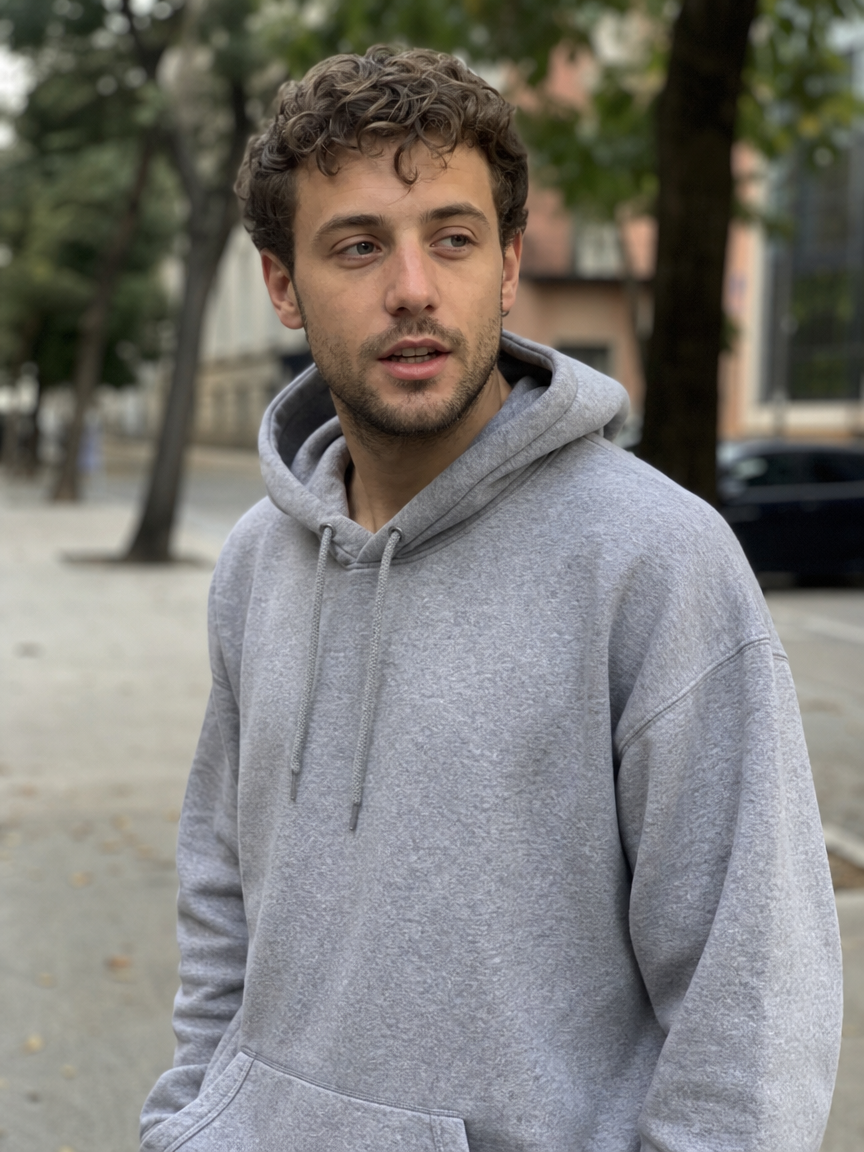
Esta es la foto de referencia usada en cada una de las recetas de abajo:
Receta 1: Fotograma de película anime
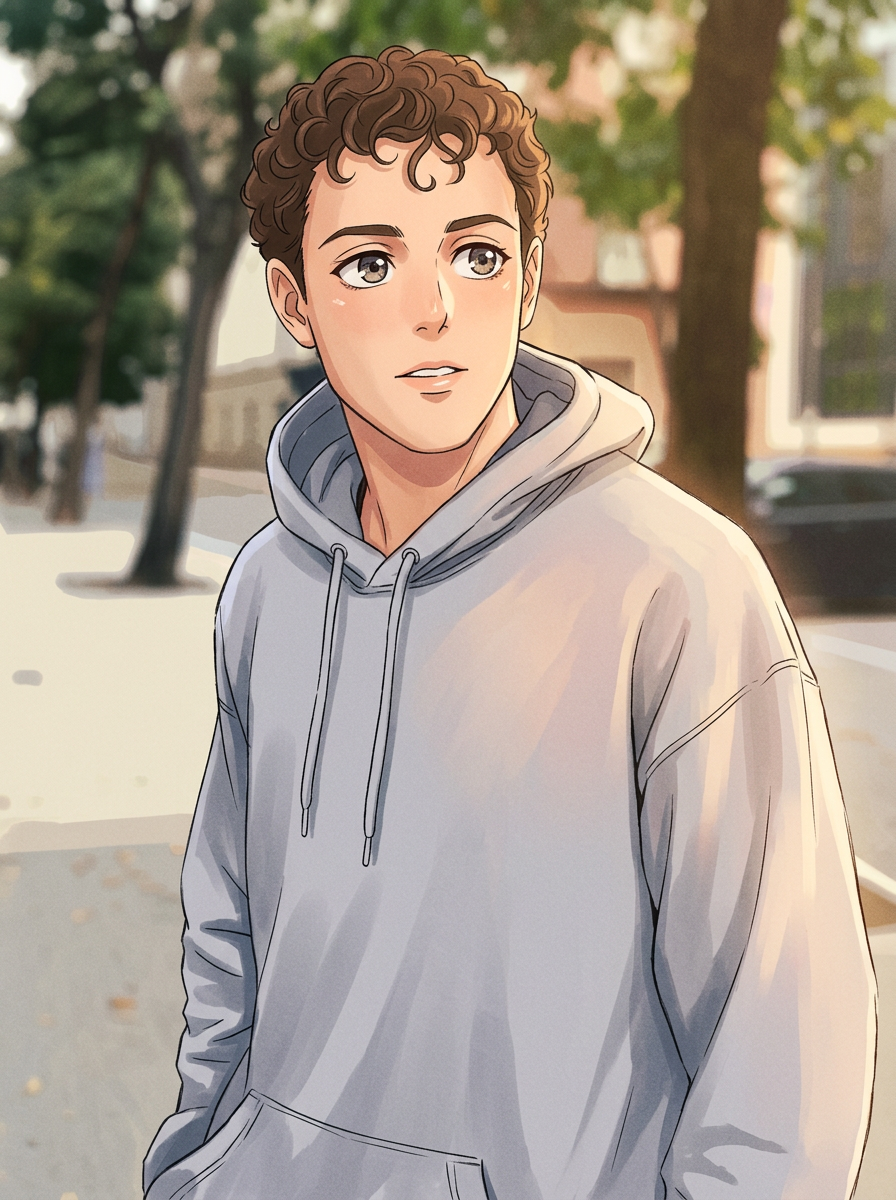
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Por qué funciona: la mayor parte del texto de este prompt se dedica a la textura, no al sujeto —«cel-shading suave», «textura de pincel visible», «bloom de luz»—, porque el sujeto ya lo fija la imagen de referencia. Redibujar los ojos «en proporciones anime» es el único punto donde dejamos intencionadamente que el modelo se desvíe de la foto; todo lo demás («mismo peinado, pose y color de sudadera con capucha») queda explícitamente fijado, para que el resultado siga siendo reconocible como la misma persona, solo que ilustrada.
Reprodúcelo:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Consulta mediante sondeo GET https://api.hiapi.ai/v1/tasks/{taskId} hasta que status sea success, y luego descarga output[0].url: ese enlace caduca, así que guárdalo de inmediato en una ubicación permanente. Sustituye image_input por tu propio retrato y esta estructura de prompt servirá para cualquier sujeto con pose y peinado claros.
Receta 2: Viñeta de manga en blanco y negro
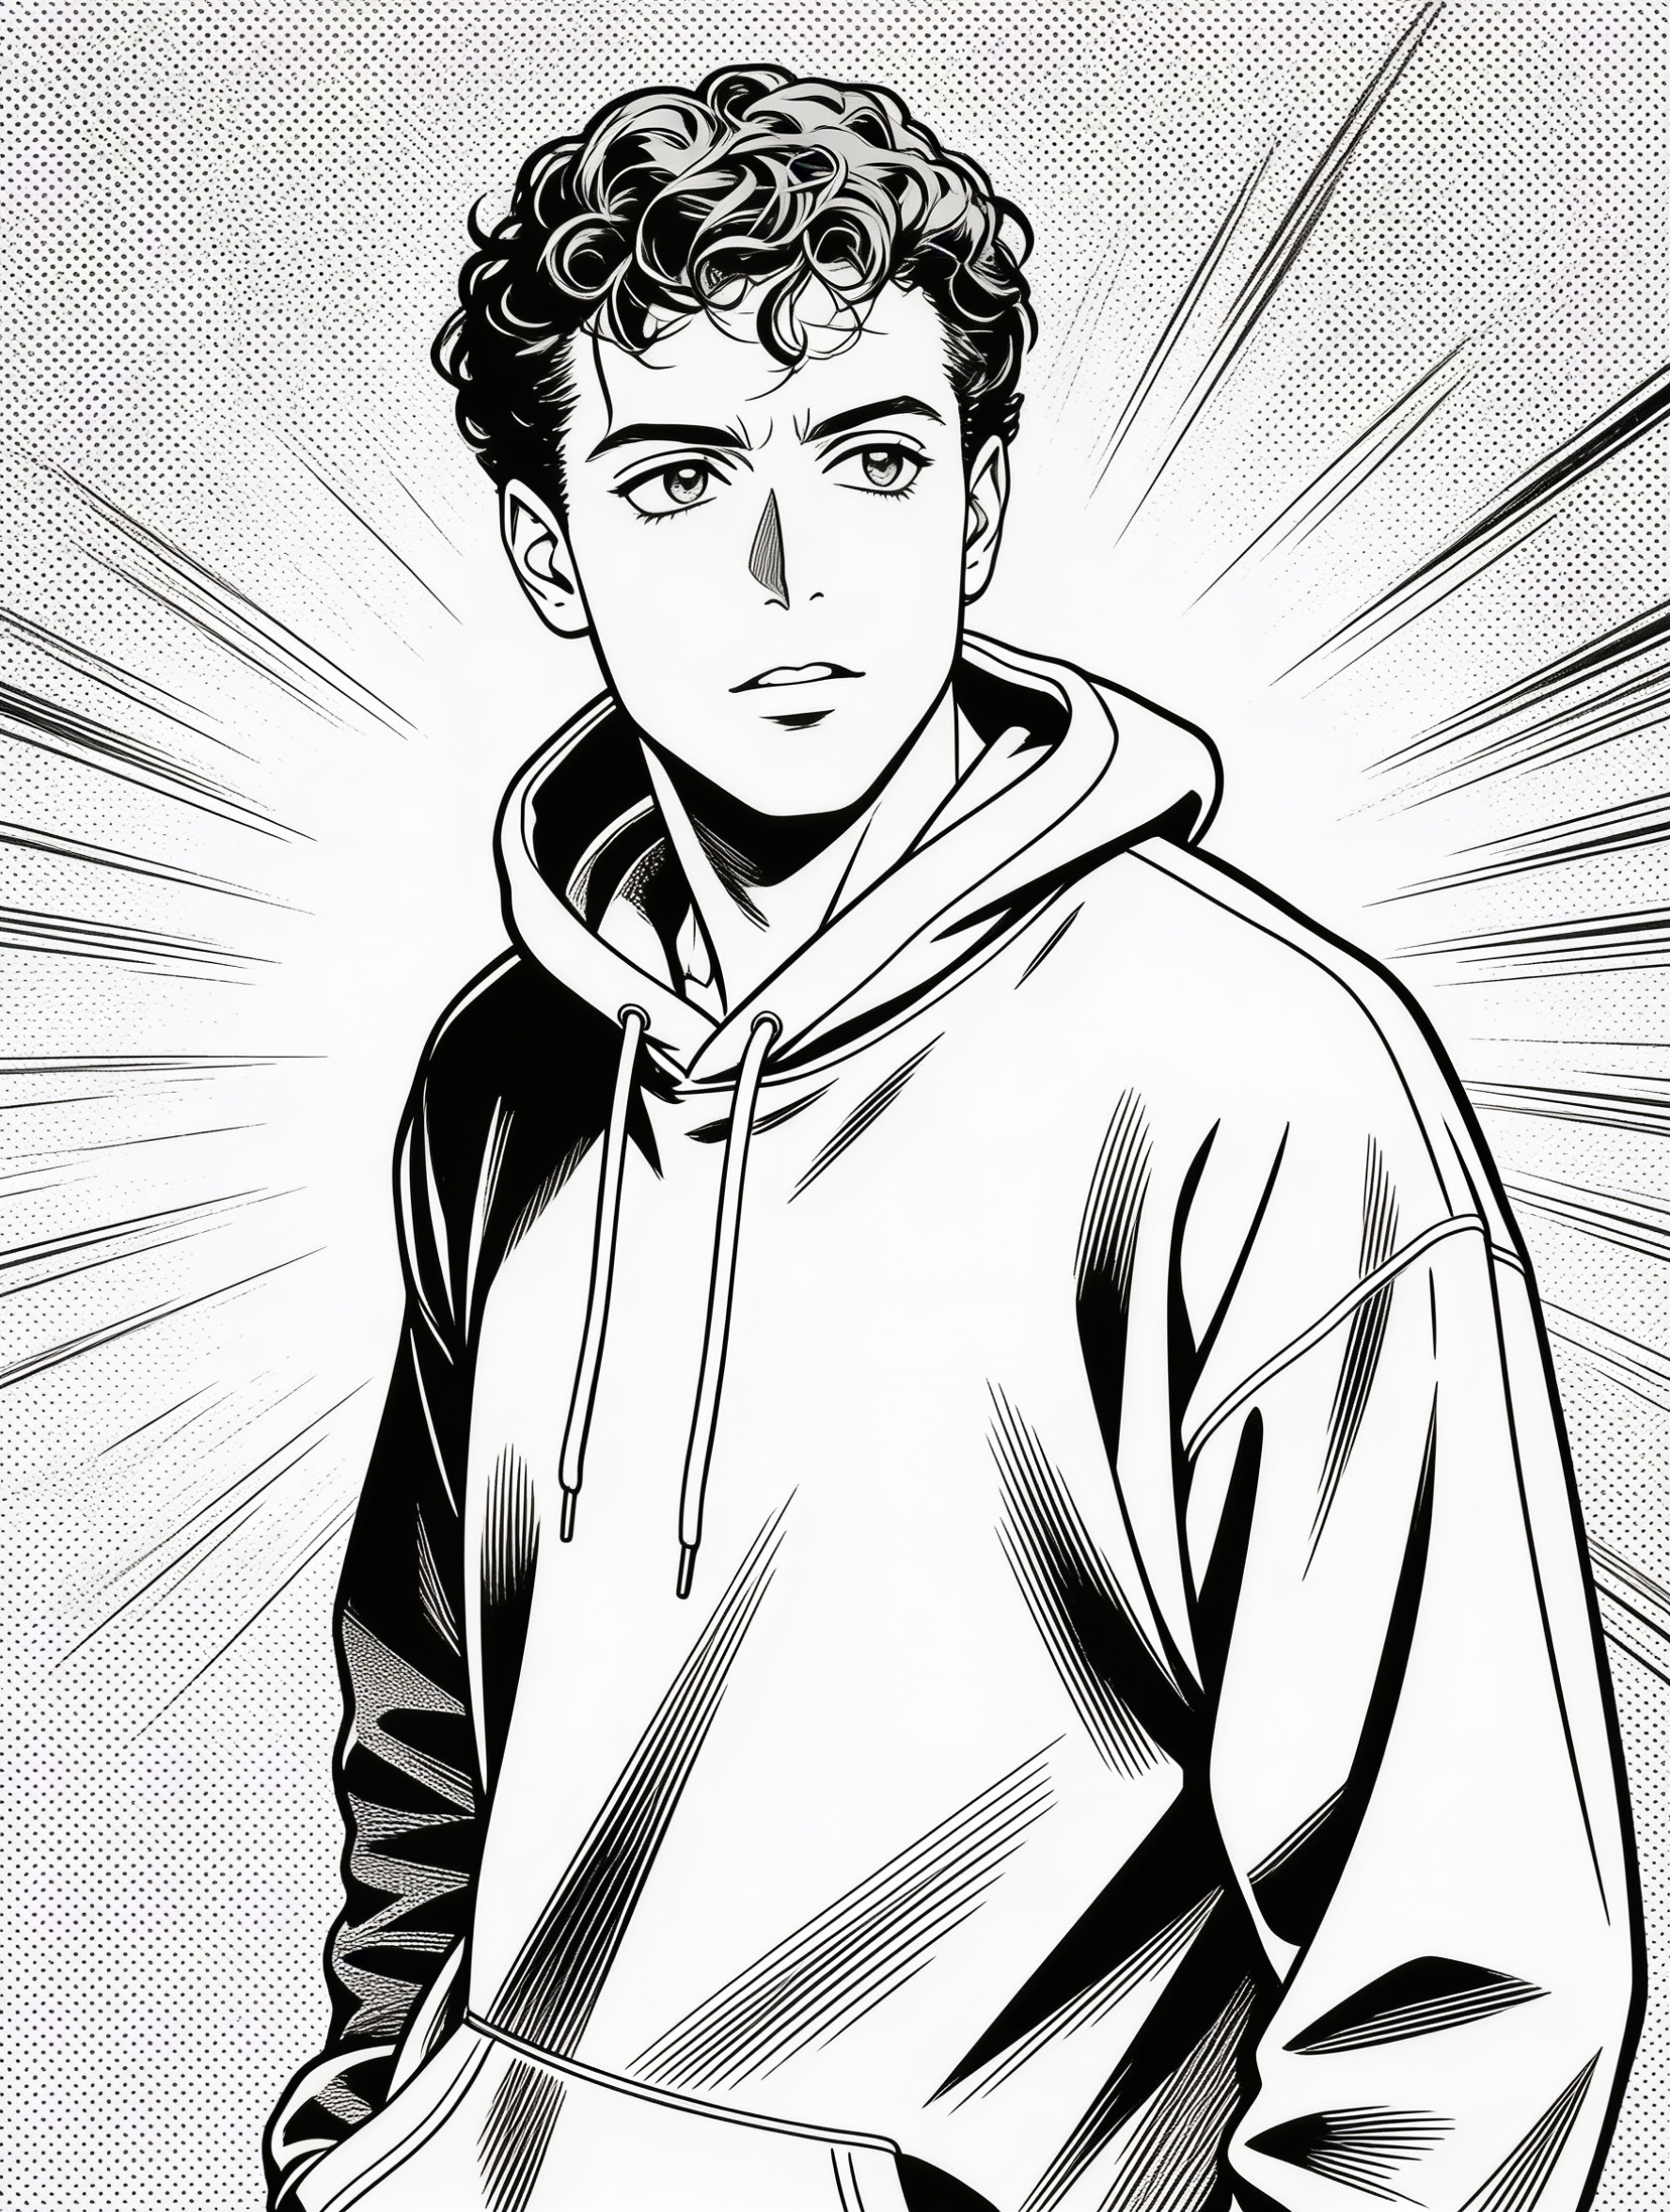
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Por qué funciona: el éxito del estilo manga depende de dos cosas que este prompt nombra directamente: las tramas de puntos (el sombreado de puntos que el manga real usa en lugar de degradados) y el grosor de línea («líneas entintadas nítidas», «líneas faciales... afiladas»). Si no se nombran explícitamente las tramas, los modelos i2i suelen recurrir por defecto a un sombreado plano de estilo anime genérico en lugar de un efecto de semitono que parezca realmente manga. «Sin color, sin texto, sin bocadillos de diálogo» se añadió porque los modelos entrenados con manga a veces generan de la nada bordes de viñeta o texto de diálogo si no se excluyen explícitamente.
Reprodúcelo:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
El mismo patrón de POST a /v1/tasks y de sondeo que en la receta 1: seedream-4.5/image-to-image solo coloca la imagen de referencia bajo image_urls (en plural, un array) en lugar de image_input, y cobra una tarifa fija de $0.045 independientemente del nivel de resolución.
Receta 3: Mural de graffiti con pintura en aerosol
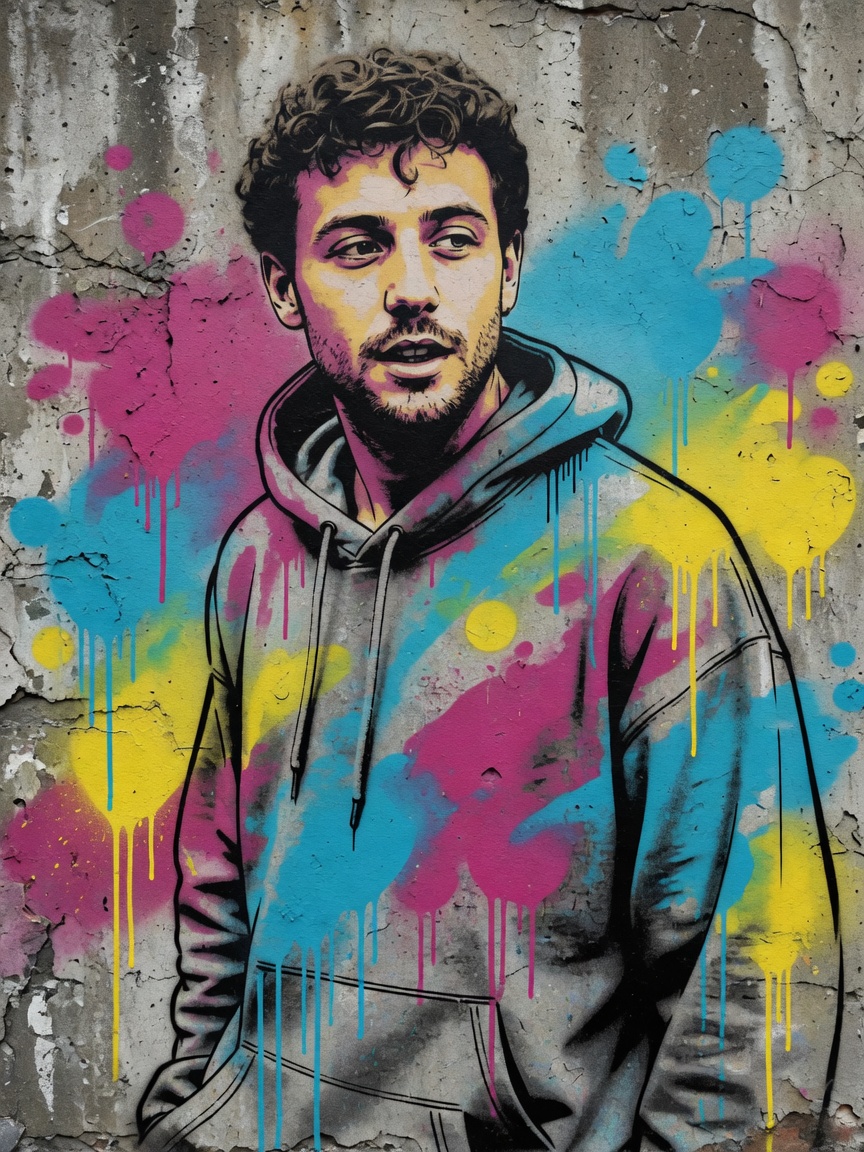
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Por qué funciona: el graffiti es uno de los pocos estilos en los que nombrar la técnica (estarcido, goteos de pintura en aerosol, contornos gruesos) importa más que nombrar el sujeto. La lista de colores —«magenta, cian y amarillo»— también cumple una función práctica: si se dejan los colores abiertos, la mayoría de los modelos i2i recurren por defecto a tonos turbios y poco saturados en lugar de los rellenos planos y saturados de un mural real de pintura en aerosol. Como en las otras tres recetas, «mantener la misma pose, peinado y silueta de sudadera con capucha» es la clave para que el mural no se convierta en una cara genérica de arte urbano.
Reprodúcelo:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Fíjate en que aquí "1k" va en minúsculas: a diferencia de los otros dos modelos de arriba, el esquema de Grok Imagine Quality distingue mayúsculas y minúsculas en el valor de resolución. Este endpoint no tiene campo aspect_ratio; la composición de salida sigue a tu imagen de referencia.
Receta 4: Retrato de carta de tarot
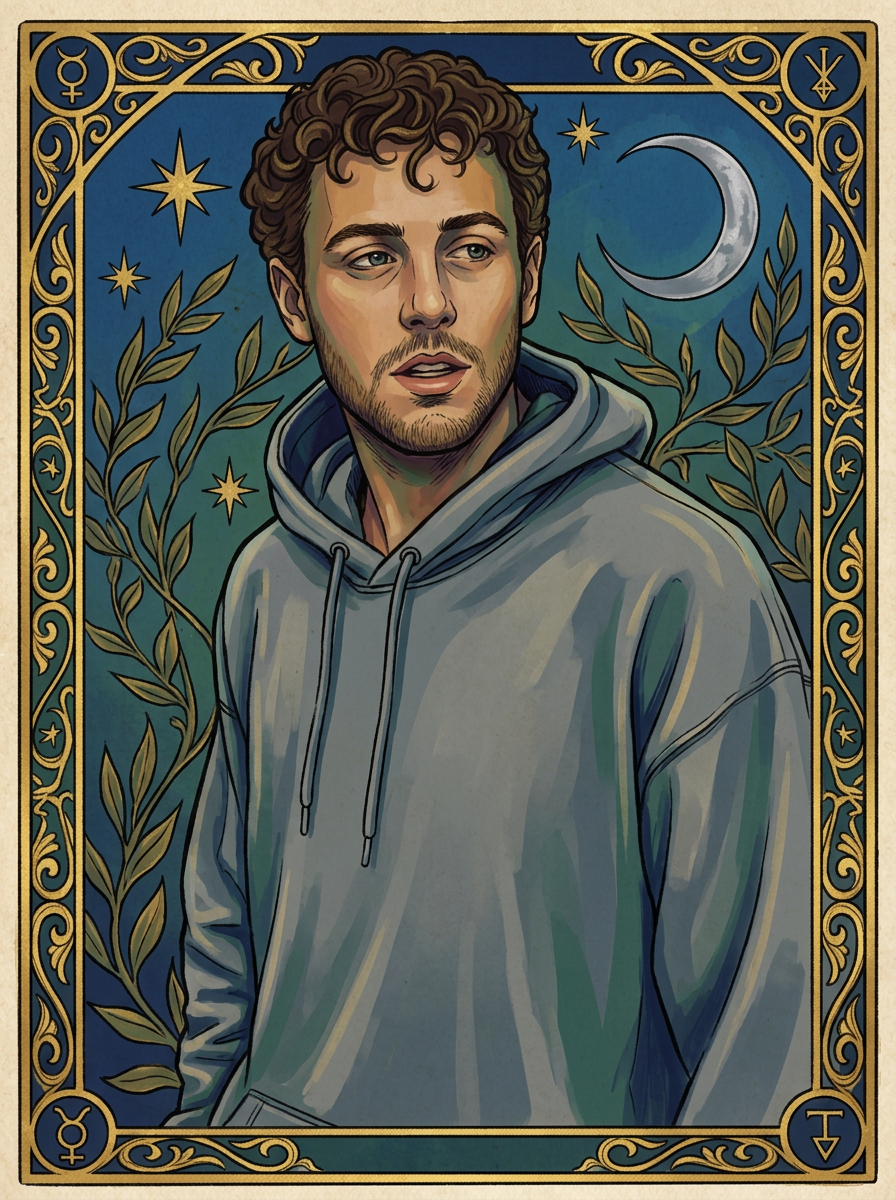
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Por qué funciona: el aspecto de carta de tarot proviene casi por completo de elementos de marco ajenos al sujeto: el borde ornamental de filigrana dorada y los símbolos místicos del fondo (estrellas, luna creciente, ramas de laurel). Nombrar explícitamente estos elementos es lo que convierte un «retrato con sombreado ornamental» en una «carta de tarot reconocible al instante». Además excluimos explícitamente los números y nombres de carta («sin texto, sin nombre de carta, sin números»), porque los modelos entrenados con cartas de tarot reales añaden texto de nombre de carta de relleno si no se excluye.
Reprodúcelo:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
El mismo modelo que en la receta 1 (nano-banana-2), con un prompt distinto: un buen recordatorio de que, en la transferencia de estilo i2i, la elección del modelo importa menos que la concreción del prompt sobre «qué conservar y qué reimaginar».
Preguntas frecuentes
¿Qué modelo es el mejor para la transferencia de estilo de foto a anime?
De los tres modelos que probamos, nano-banana-2 mantuvo los rasgos de identidad (pose, peinado, proporciones) de forma más consistente en ejecuciones repetidas, a $0.085/imagen (1K). seedream-4.5/image-to-image es la opción más económica, a una tarifa fija de $0.045/imagen, adecuada para estilos dominados por la línea como el manga; grok-imagine-quality/image-to-image se acerca más a un redibujado completo, adecuado para casos como el graffiti, en los que una cierta desviación del sujeto forma parte del estilo.
¿Estos prompts necesitan una foto concreta para funcionar? Un retrato claro de frente o de tres cuartos, con peinado y ropa visibles, da los resultados más estables; esa es la premisa que asumen los cuatro prompts de arriba cuando dicen «misma pose, peinado y sudadera con capucha». Un fondo desordenado o una cara parcialmente oculta dificultan que el modelo determine qué conservar.
¿Puedo combinar estos prompts, por ejemplo un tarot de estilo anime? Sí: sustituye el lenguaje relacionado con la técnica (cel-shading frente a tramas de puntos frente a textura de pintura en aerosol) y conserva el lenguaje de marco del otro recetario (el borde dorado y los símbolos de la carta de tarot, o la textura de pared del graffiti). Las dos mitades de cada prompt —conservación del sujeto y técnica de estilo— están escritas pensando en la modularidad.
¿Por qué algunos de estos prompts especifican «sin texto» o «sin marca de agua»? Los modelos entrenados con fotogramas de anime, páginas de manga y cartas de tarot reales han visto abundantes ejemplos con texto propio —créditos, onomatopeyas, nombres de carta— y a veces añaden texto de relleno por iniciativa propia. Una exclusión explícita lo evita de antemano; añadirla al prompt no cuesta nada y ahorra una generación desperdiciada.
¿La resolución afecta al precio de estos modelos?
Depende del modelo. El precio de nano-banana-2 y seedream-4.5 sí varía según el nivel de resolución en algunos endpoints, aunque seedream-4.5/image-to-image concretamente es fijo a $0.045 sea cual sea el nivel. Antes de presupuestar un lote, consulta siempre la página de precios en tiempo real de hiapi: las tarifas varían según el modelo y se actualizan de forma independiente.
Conclusiones
- Cada prompt de arriba se divide en dos mitades: qué conservar (pose, peinado, identidad) y qué cambiar (estilo artístico, técnica, composición); hay que escribir bien ambas, o el modelo hará derivar el sujeto en silencio hacia algo genérico.
- Nombrar la técnica y no solo el estilo objetivo da resultados más precisos: «patrón de puntos de trama» supera a «estilo manga», y «brillos de estarcido y goteos de pintura en aerosol» supera a «estilo graffiti».
- Excluye lo que el modelo tiende a generar de la nada en un estilo concreto —texto de relleno, números de carta, bocadillos de diálogo— incluso si crees que no hace falta.
grok-imagine-quality/image-to-imageusa valores de resolución en minúsculas ("1k", no"1K") y no tiene campoaspect_ratio; revisa el esquema de cada modelo en lugar de suponer que coincide con el que usaste antes.- Los cuatro prompts son puntos de partida listos para copiar y pegar: sustituye la imagen de referencia por la tuya propia mediante
image_inputoimage_urlsy la misma estructura servirá para sujetos distintos.
¿Quieres ver cómo maneja un solo modelo i2i varios niveles de resolución y cantidades de imágenes de referencia antes de elegir un modelo para tareas por lotes? El tutorial de la API de Nano Banana 2 profundiza en la autenticación, la estructura de las solicitudes y el manejo de errores. O ve directamente a la página del modelo nano-banana-2 y pruébalo con tu propia foto de referencia.
Artículos relacionados
Ver todos los artículos →-

Inventario
Alternativas recomendadas a Hugging Face Inference API (2026): una API para llamar a imágenes/vídeo/audio/modelos grandes
Modelos de precios, amplitud de cobertura de modelos, complejidad de integración, compatibilidad con OpenAI: deja claro en qué escenarios conviene pasar del enrutamiento agregado a una API de generación unificada
-

Inventario
Cómo elegir una alternativa a RunPod: comparación de integración de API de imagen y vídeo
RunPod es una nube de GPU, no una API de generación: primero aclara qué capa necesitas para imagen y vídeo.
-

Inventario
Cómo elegir una alternativa a Modal: comparación de integración de API de imagen y vídeo