
Bestandsaufnahme
Prompt-Rezepte für Fotostil-Transfer: Anime, Manga, Graffiti, Tarotkarten
Vier Prompt-Sets für den AI-Foto-zu-Kunststil-Transfer, die wir selbst geschrieben und tatsächlich ausgeführt haben – Anime-Filmstill, Manga-Panel, Graffiti-Wandbild und Tarotkarten-Porträt – mit echten Vorher-Nachher-Bildern und den API-Aufrufen zur Reproduktion.
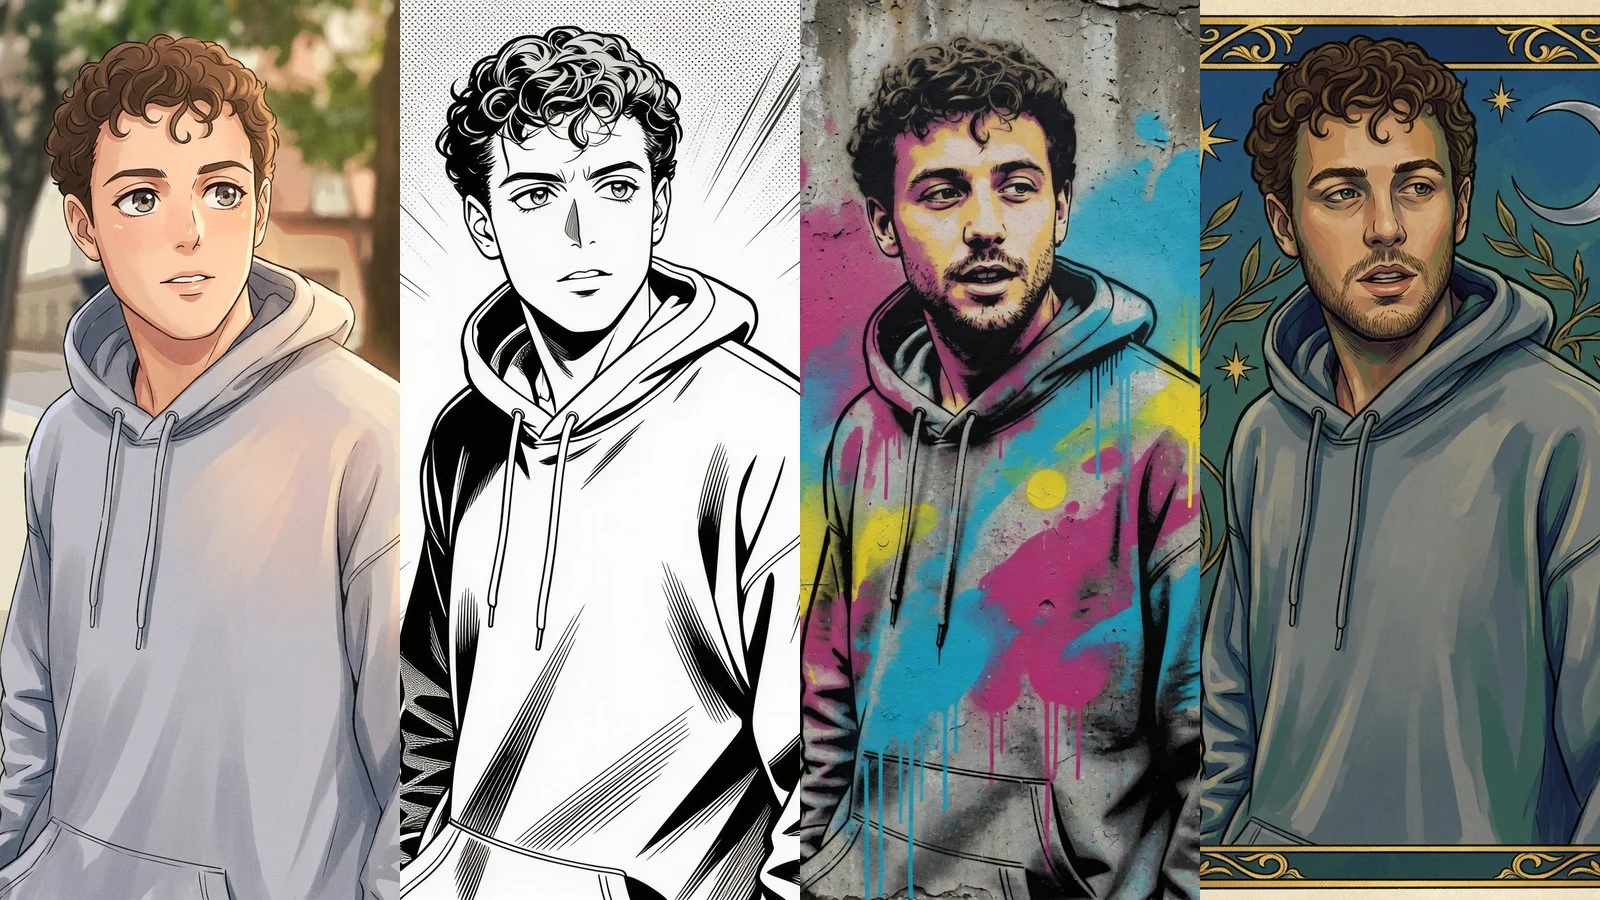
Vier i2i-Modelle, ein Referenzfoto, vier völlig unterschiedliche Ergebnisse. Hier sind die exakten Prompts, die wir selbst geschrieben und ausgeführt haben – Anime-Filmstill, Manga-Panel, Graffiti-Wandbild und Tarotkarten-Porträt – jeweils mit einem tatsächlich generierten Bild und dem API-Aufruf zur Reproduktion.
Kurz gesagt: In allen vier Stilen blieben Pose, Frisur und Identitätsmerkmale erhalten, weil jeder Prompt ausdrücklich angibt, was beibehalten werden soll („gleiche Pose“, „gleiche Frisur“, „gleiche Hoodie-Silhouette“) und zugleich, was geändert werden soll. Lässt man diese Hälfte des Prompts weg, driftet das Motiv bei jedem von uns getesteten Modell zu einem gewöhnlichen Gesicht statt zu deiner eigenen stilisierten Version.
Schnellreferenz: Wähle deinen Stil
| Stil | Modell | Auflösung | Preis |
|---|---|---|---|
| 1. Anime-Filmstill | nano-banana-2 |
1K | $0,085/Bild |
| 2. Manga-Panel | seedream-4.5/image-to-image |
2K | $0,045/Bild |
| 3. Graffiti-Wandbild | grok-imagine-quality/image-to-image |
1k | $0,08/Bild + Referenzbild-Kosten |
| 4. Tarotkarten-Porträt | nano-banana-2 |
1K | $0,085/Bild |
Die Preise gelten pro einzelnem Ausgabebild in der angegebenen Auflösung; die Daten wurden zuletzt im September 2026 vom Preisentpunkt von hiapi abgerufen – schau vor der Budgetierung von Stapelverarbeitungen auf hiapi's Preisseite, da sich die Tarife der einzelnen Modelle ändern. Der Image-to-Image-Endpunkt von Grok Imagine Quality erhebt auf den Grundpreis einen kleinen Zusatzbetrag pro Referenzbild; jeder Aufruf unten verwendet nur ein einziges Referenzbild, sodass das Gesamtbudget für diesen Posten etwa $0,09–$0,10 beträgt.
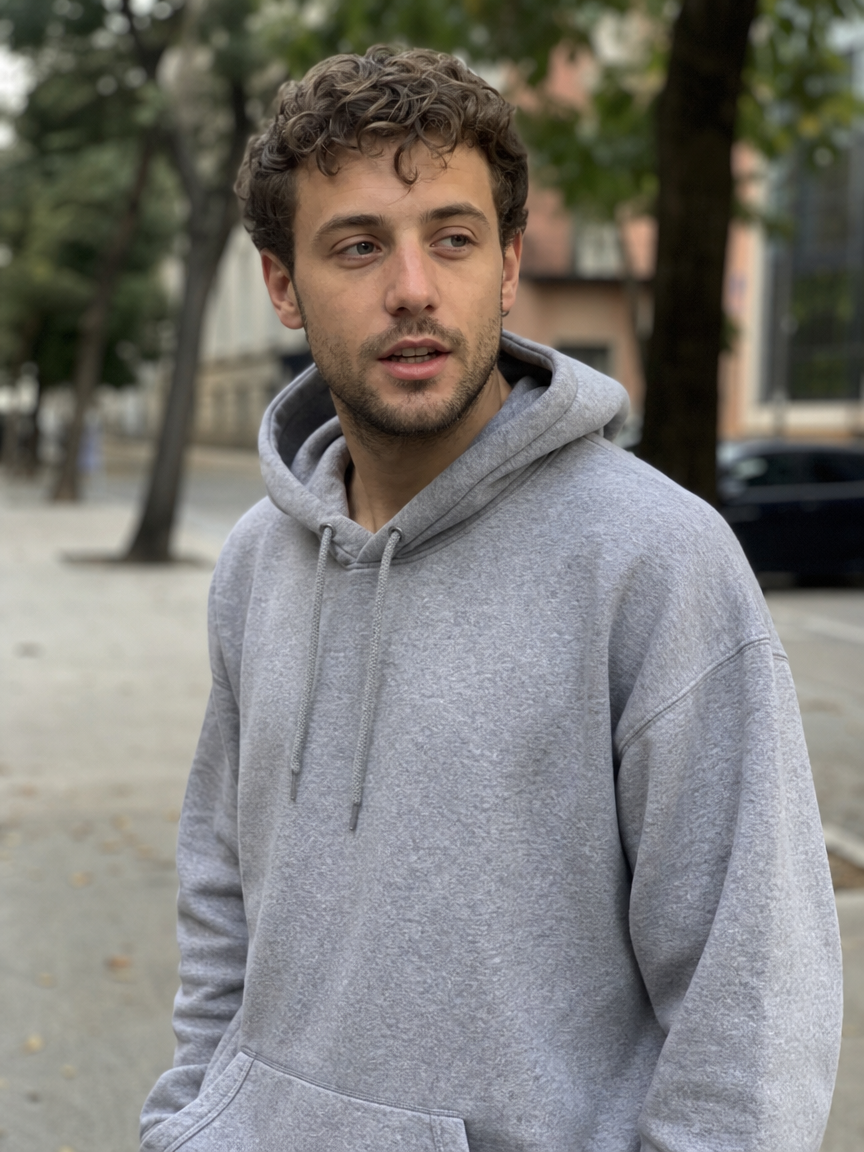
Hier ist das Referenzfoto, das für jedes der folgenden Rezepte verwendet wird:
Rezept 1: Anime-Filmstill
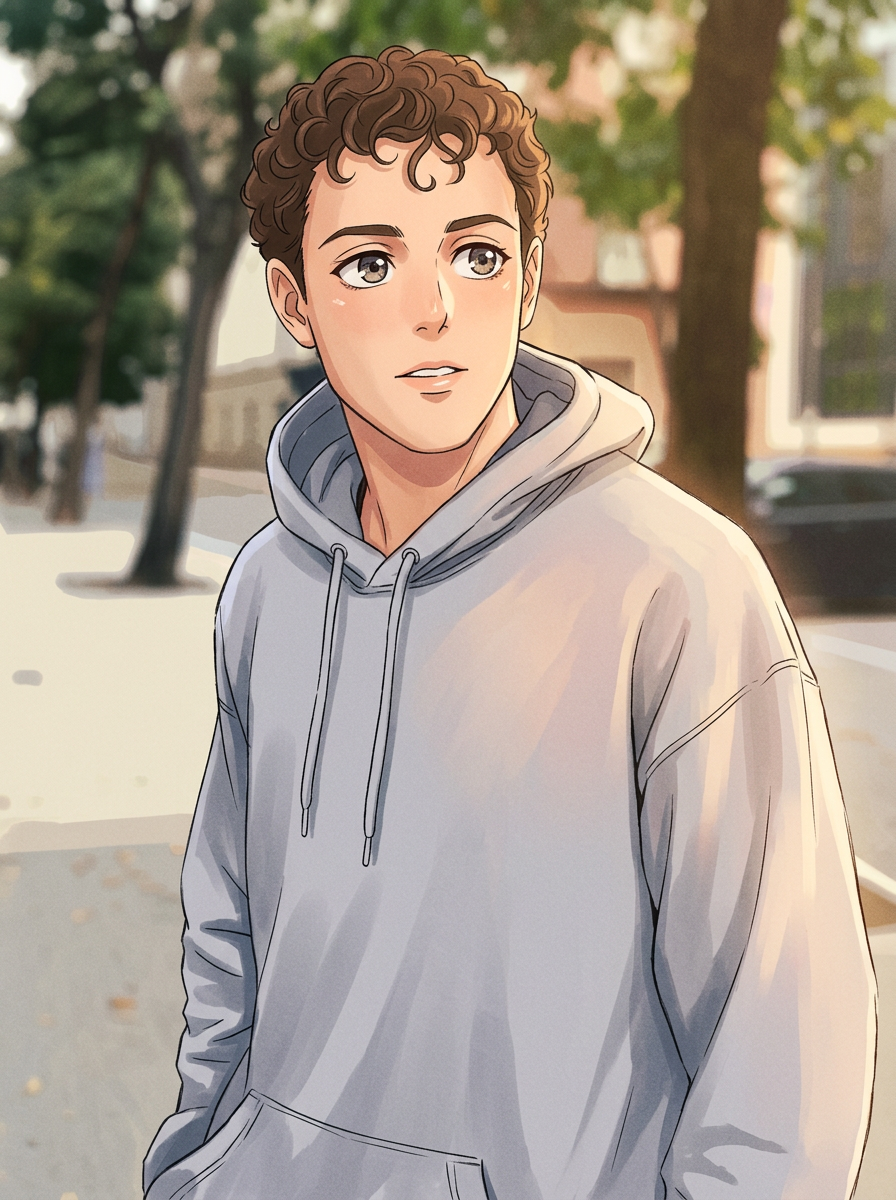
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Warum es funktioniert: Der Großteil dieses Prompts entfällt auf Textur statt auf das Motiv – „Cel-Shading“, „sichtbare Pinseltextur“, „Lichtglühen“ –, weil das Motiv bereits durch das Referenzfoto festgelegt ist. Die Augen „in Anime-Proportionen“ neu zu zeichnen ist die einzige Stelle, an der das Modell bewusst vom Foto abweichen soll; alles andere („gleiche Frisur, Pose und Hoodie-Farbe“) ist ausdrücklich festgeschrieben, damit das Ergebnis noch als dieselbe Person erkennbar bleibt, nur illustriert.
So reproduzierst du es:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Frage GET https://api.hiapi.ai/v1/tasks/{taskId} ab, bis status gleich success ist, und lade dann output[0].url herunter – dieser Link läuft ab, also speichere ihn sofort an einem dauerhaften Ort. Ersetze image_input durch dein eigenes Porträt, und diese Prompt-Struktur funktioniert für jedes Motiv mit klarer Pose und Frisur.
Rezept 2: Schwarzweiß-Manga-Panel
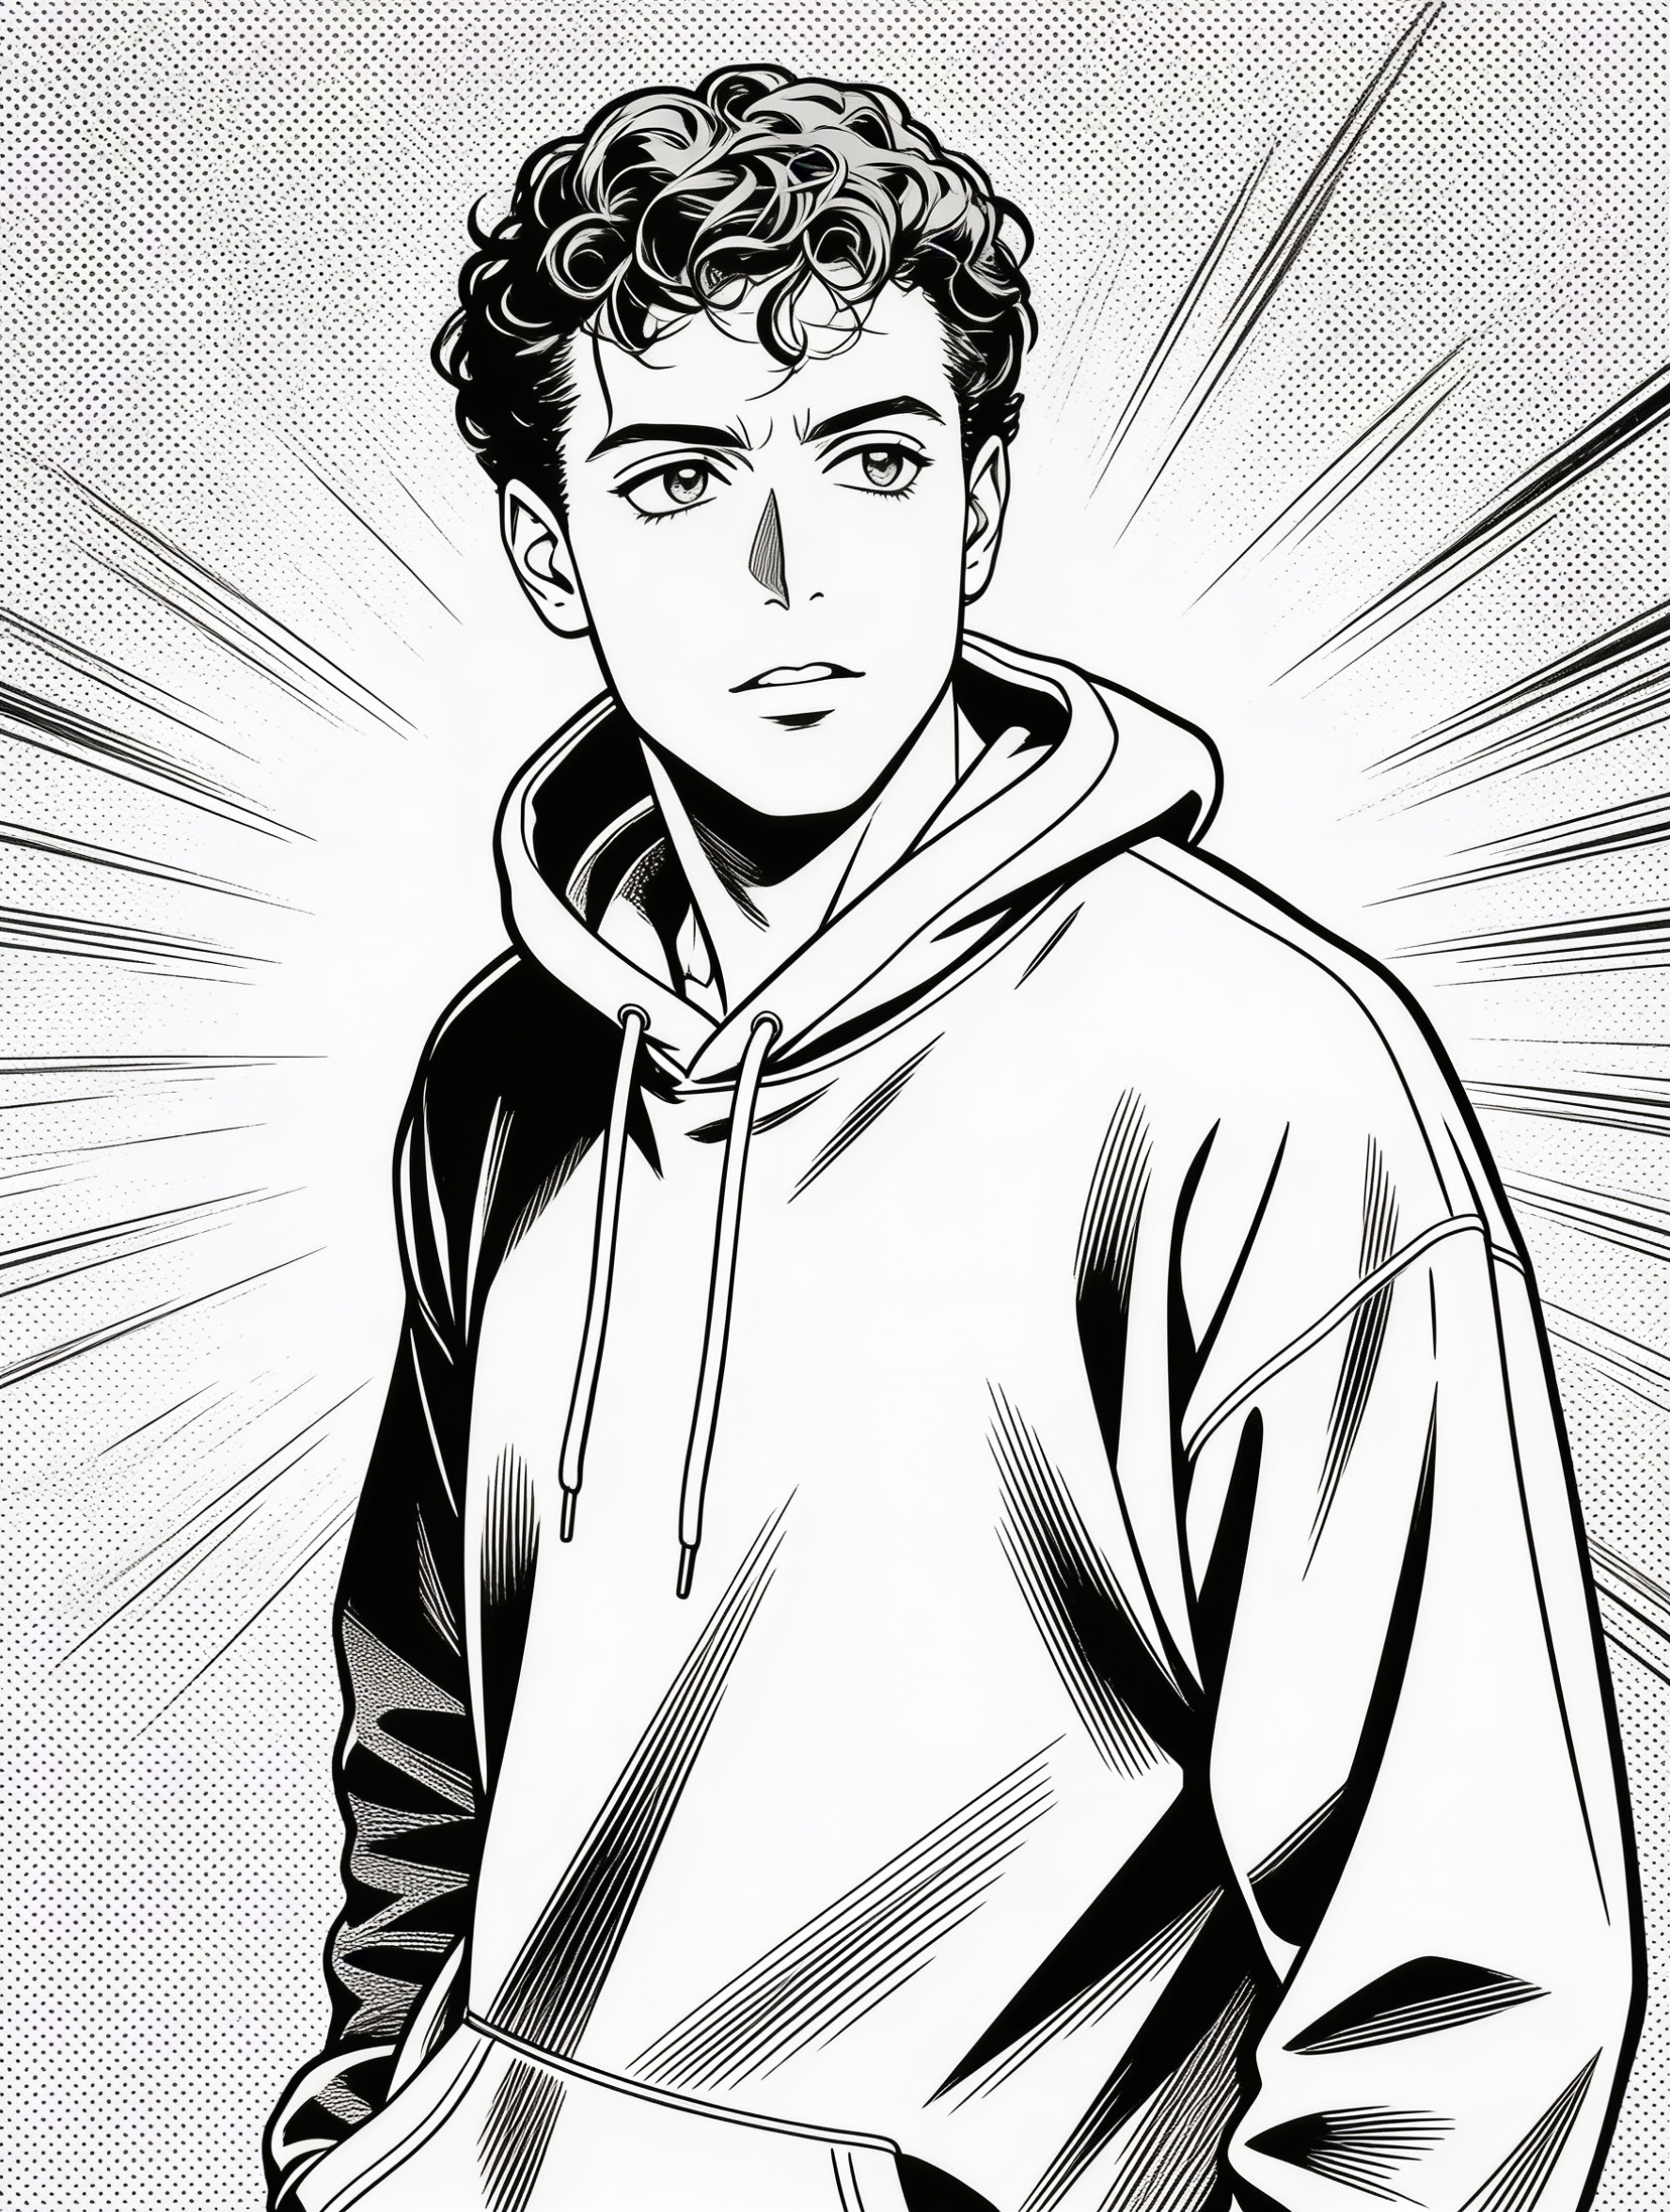
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Warum es funktioniert: Der Manga-Look hängt an zwei Dingen, die dieser Prompt direkt benennt – Rasterfolie (die Punkteschattierung, mit der echte Manga Verläufe ersetzen) und Linienstärke („saubere Tuschelinien“, „scharfe ... Gesichtslinien“). Ohne ausdrückliche Nennung von Rasterfolie greifen i2i-Modelle oft standardmäßig zu generischem Anime-Flatshading statt zu einem Halbton-Rastereffekt, der tatsächlich wie Manga aussieht. „Keine Farbe, kein Text, keine Sprechblasen“ wurde ergänzt, weil auf Manga trainierte Modelle manchmal Panelrahmen oder Dialogtext hinzufügen, wenn man sie nicht ausdrücklich ausschließt.
So reproduzierst du es:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
Dasselbe POST- und Polling-Muster auf /v1/tasks wie bei Rezept 1 – seedream-4.5/image-to-image legt das Referenzbild nur unter image_urls (Plural, Array) statt image_input ab und wird unabhängig von der Auflösungsstufe pauschal mit $0,045 berechnet.
Rezept 3: Sprühfarbe-Graffiti-Wandbild
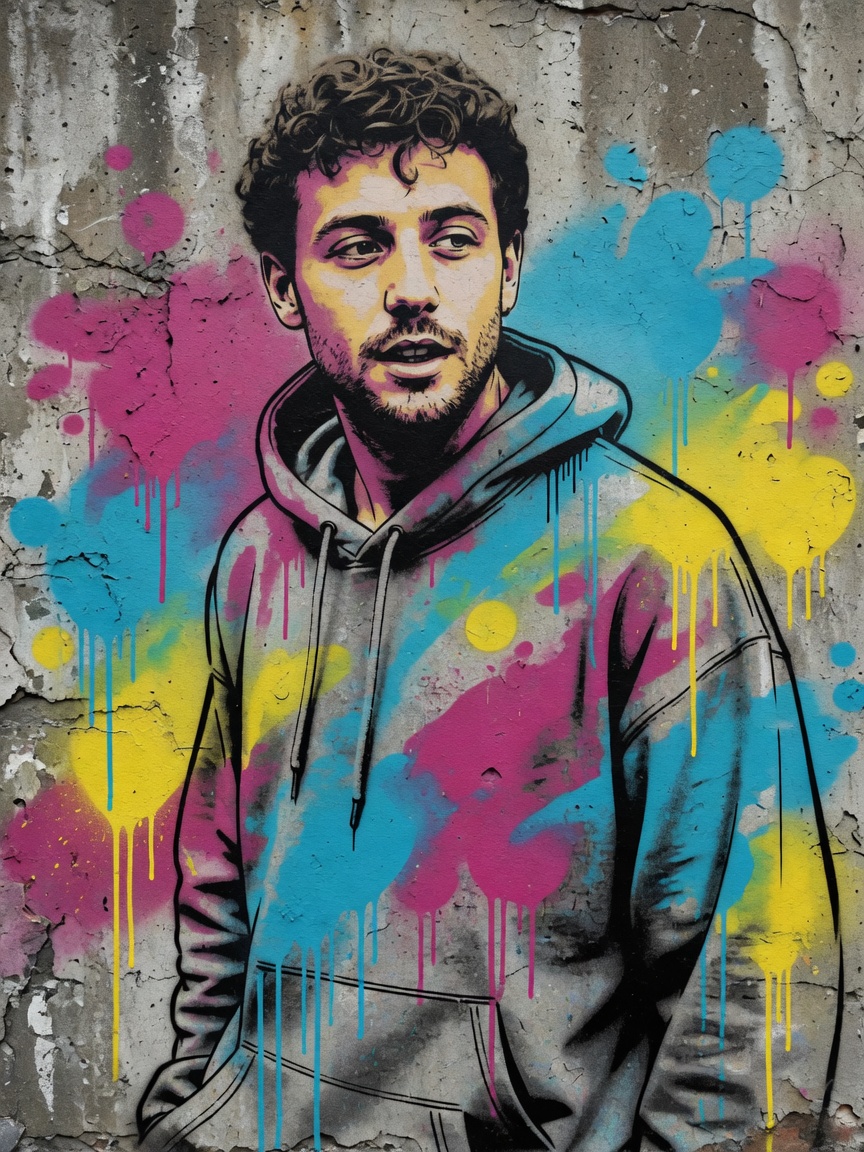
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Warum es funktioniert: Graffiti ist einer der wenigen Stile, bei denen die Nennung der Technik (Schablonen-Akzente, Sprühfarbe-Tropfen, kräftige Konturlinien) wichtiger ist als die Nennung des Motivs. Auch die Farbliste – „Magenta, Cyan und Gelb“ – spielt eine praktische Rolle: Lässt man die Farben offen, greifen die meisten i2i-Modelle standardmäßig zu trüben, entsättigten Tönen statt zu den flachen, satten Füllungen eines echten Sprühfarbe-Wandbilds. Wie bei den anderen drei Rezepten ist „gleiche Pose, Frisur und Hoodie-Silhouette beibehalten“ der Schlüssel dazu, dass aus dem Wandbild kein generisches Street-Art-Gesicht wird.
So reproduzierst du es:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Beachte das kleingeschriebene "1k" – anders als die beiden anderen Modelle oben unterscheidet das Schema von Grok Imagine Quality bei Auflösungswerten zwischen Groß- und Kleinschreibung. Dieser Endpunkt hat kein aspect_ratio-Feld; die Ausgabekomposition folgt deinem Referenzbild.
Rezept 4: Tarotkarten-Porträt
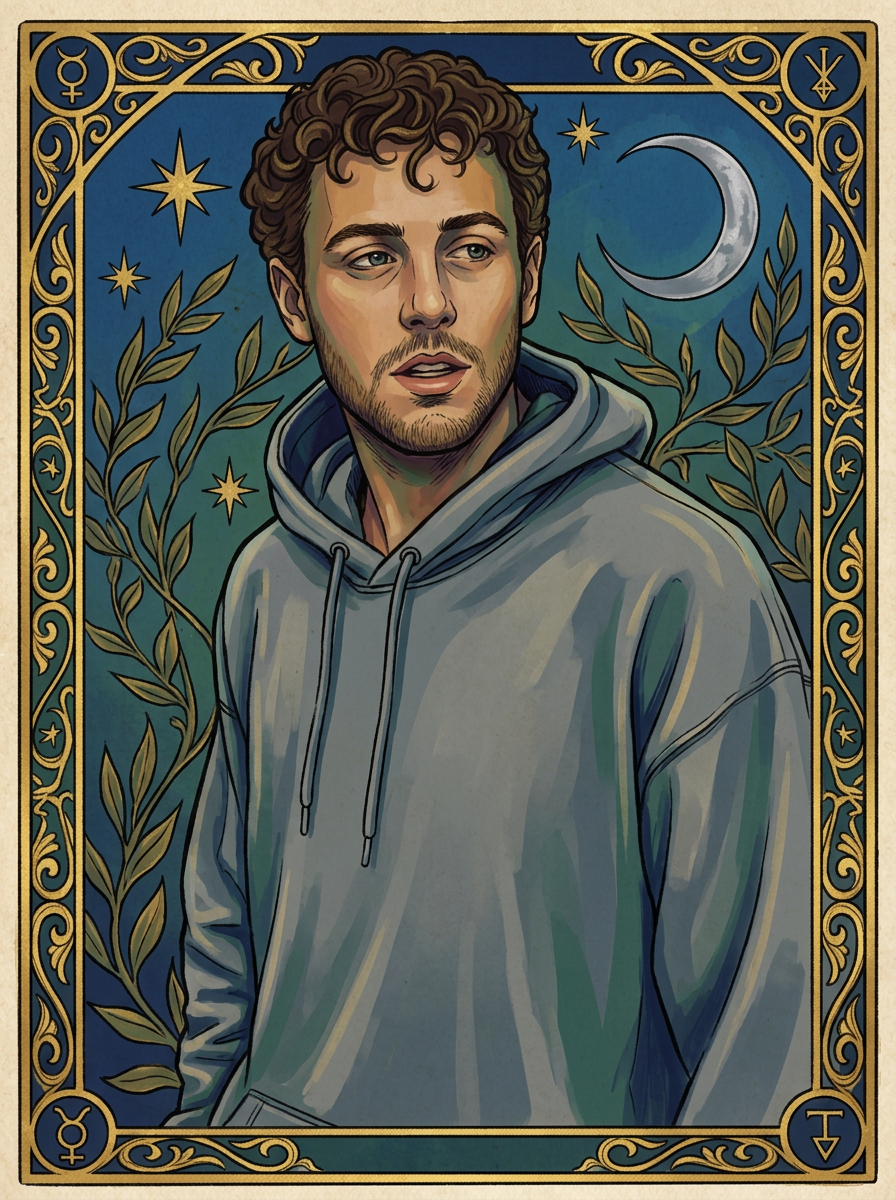
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Warum es funktioniert: Der Tarotkarten-Look entsteht fast vollständig aus Rahmenelementen, die nichts mit dem Motiv zu tun haben – goldene Filigran-Einfassung, mystische Hintergrundsymbole (Sterne, Mondsichel, Lorbeerranken). Diese Elemente ausdrücklich zu benennen ist es, was aus einem „Porträt mit prunkvoller Schattierung“ eine „auf den ersten Blick erkennbare Tarotkarte“ macht. Außerdem haben wir Kartennummern und Kartennamen ausdrücklich ausgeschlossen („kein Text, kein Kartenname, keine Ziffern“), weil auf echten Tarotkarten trainierte Modelle Platzhalter-Kartennamen hinzufügen, wenn man sie nicht ausschließt.
So reproduzierst du es:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Dasselbe Modell wie bei Rezept 1 (nano-banana-2), ein anderer Prompt – eine gute Erinnerung daran, dass bei i2i-Stil-Transfer die Modellwahl weniger wichtig ist als die Frage, wie konkret der Prompt angibt, was beibehalten und was neu interpretiert werden soll.
Häufige Fragen
Welches Modell eignet sich am besten für den Foto-zu-Anime-Stil-Transfer?
Von den drei Modellen, die wir getestet haben, hielt nano-banana-2 über mehrere Wiederholungsläufe hinweg die Identitätsmerkmale (Pose, Frisur, Proportionen) am stabilsten, zum Preis von $0,085/Bild (1K). seedream-4.5/image-to-image ist die günstigere Wahl für pauschal $0,045/Bild und eignet sich für linienbetonte Stile wie Manga; grok-imagine-quality/image-to-image kommt einer vollständigen Neuzeichnung näher und eignet sich für Fälle wie Graffiti, bei denen eine gewisse Abweichung des Motivs selbst Teil des Stils ist.
Brauchen diese Prompts ein bestimmtes Foto, um zu funktionieren? Ein klares Frontal- oder Dreiviertelporträt, bei dem Frisur und Kleidung sichtbar sind, liefert die stabilsten Ergebnisse – genau das setzen die vier Prompts oben voraus, wenn sie „gleiche Pose, Frisur und Hoodie“ sagen. Ein unruhiger Hintergrund oder ein teilweise verdecktes Gesicht machen es dem Modell schwerer zu erkennen, was beibehalten werden soll.
Kann ich diese Prompts kombinieren, zum Beispiel ein Tarotkarten-Porträt im Anime-Stil? Ja – ersetze die technikbezogene Sprache (Cel-Shading vs. Rasterfolie vs. Sprühfarbe-Textur) und behalte die Rahmen-Sprache des anderen Rezepts bei (goldene Einfassung und Symbole der Tarotkarte oder die Wandtextur des Graffiti). Beide Hälften jedes Prompts – Motiv-Beibehaltung und Stil-Technik – sind modular geschrieben.
Warum geben einige dieser Prompts „kein Text“ oder „kein Wasserzeichen“ an? Auf echten Anime-Filmstills, Mangaseiten und Tarotkarten trainierte Modelle haben viele Beispiele mit eigenem Text gesehen – Abspann, Lautmalereien, Kartennamen – und fügen manchmal von sich aus Platzhaltertext hinzu. Ein ausdrücklicher Ausschluss verhindert das im Voraus; er kostet nichts im Prompt und spart eine verschwendete Generierung.
Beeinflusst die Auflösung den Preis dieser Modelle?
Das hängt vom Modell ab. Bei nano-banana-2 und seedream-4.5 variiert der Preis bei manchen Endpunkten tatsächlich je nach Auflösungsstufe, wobei seedream-4.5/image-to-image konkret unabhängig von der Stufe pauschal $0,045 kostet. Prüfe vor der Budgetierung von Stapelverarbeitungen unbedingt hiapi's aktuelle Preisseite – die Tarife unterscheiden sich je nach Modell und werden unabhängig voneinander aktualisiert.
Die wichtigsten Punkte
- Jeder der Prompts oben besteht aus zwei Hälften: was beibehalten werden soll (Pose, Frisur, Identität) und was geändert werden soll (Kunststil, Technik, Komposition) – beide Hälften müssen klar formuliert sein, sonst driftet das Motiv still zu etwas Gewöhnlichem.
- Die Technik zu benennen statt nur den Zielstil liefert genauere Ergebnisse: „Rasterfolien-Punktemuster“ schlägt „Manga-Stil“, „Schablonen-Akzente und Sprühfarbe-Tropfen“ schlägt „Graffiti-Stil“.
- Schließe aus, was Modelle in einem bestimmten Stil leicht von sich aus erzeugen – Platzhaltertext, Kartennummern, Sprechblasen –, auch wenn du glaubst, es sei nicht nötig.
grok-imagine-quality/image-to-imageverwendet kleingeschriebene Auflösungswerte ("1k", nicht"1K") und hat keinaspect_ratio-Feld; prüfe das Schema jedes Modells, statt anzunehmen, es sei mit dem überein, was du zuvor verwendet hast.- Alle vier Prompts sind direkt kopierbare Ausgangspunkte – ersetze sie über
image_inputoderimage_urlsdurch dein eigenes Referenzfoto, und dieselbe Struktur lässt sich auf andere Motive übertragen.
Willst du sehen, wie ein einzelnes i2i-Modell mehrere Auflösungsstufen und Referenzbild-Anzahlen handhabt, bevor du ein Modell für Stapelverarbeitungen auswählst? Das Nano Banana 2 API-Tutorial behandelt Authentifizierung, Anfragestruktur und Fehlerbehandlung ausführlicher. Oder gehe direkt zur nano-banana-2-Modellseite und probiere es mit deinem eigenen Referenzfoto aus.
Ähnliche Artikel
Alle Artikel ansehen →-

Bestandsaufnahme
Hugging Face Inference API Alternativen (2026): Ein API-Aufruf für Bild/Video/Audio/LLMs
Preismodelle, Modellabdeckung, Integrationsaufwand, OpenAI-Kompatibilität – wann Sie von aggregiertem Routing zu einer einheitlichen Generierungs-API wechseln sollten
-

Bestandsaufnahme
RunPod-Alternativen auswählen: Vergleich der Anbindung von Bild- und Video-APIs
RunPod ist eine GPU-Cloud, keine generative API – klären Sie zuerst, welche Ebene Sie für Bilder und Videos nutzen sollten.
-

Bestandsaufnahme
Modal-Alternative auswählen: Vergleich der Anbindung von Bild- und Video-APIs