
Inventario
Ricette di prompt per il trasferimento di stile fotografico: anime, manga, graffiti, tarocchi
Quattro set di prompt per il trasferimento di stile da foto ad arte che abbiamo scritto e testato di persona — fotogramma di film anime, vignetta manga, murale graffiti e ritratto dei tarocchi — con vere immagini prima/dopo e le chiamate API necessarie per riprodurli.
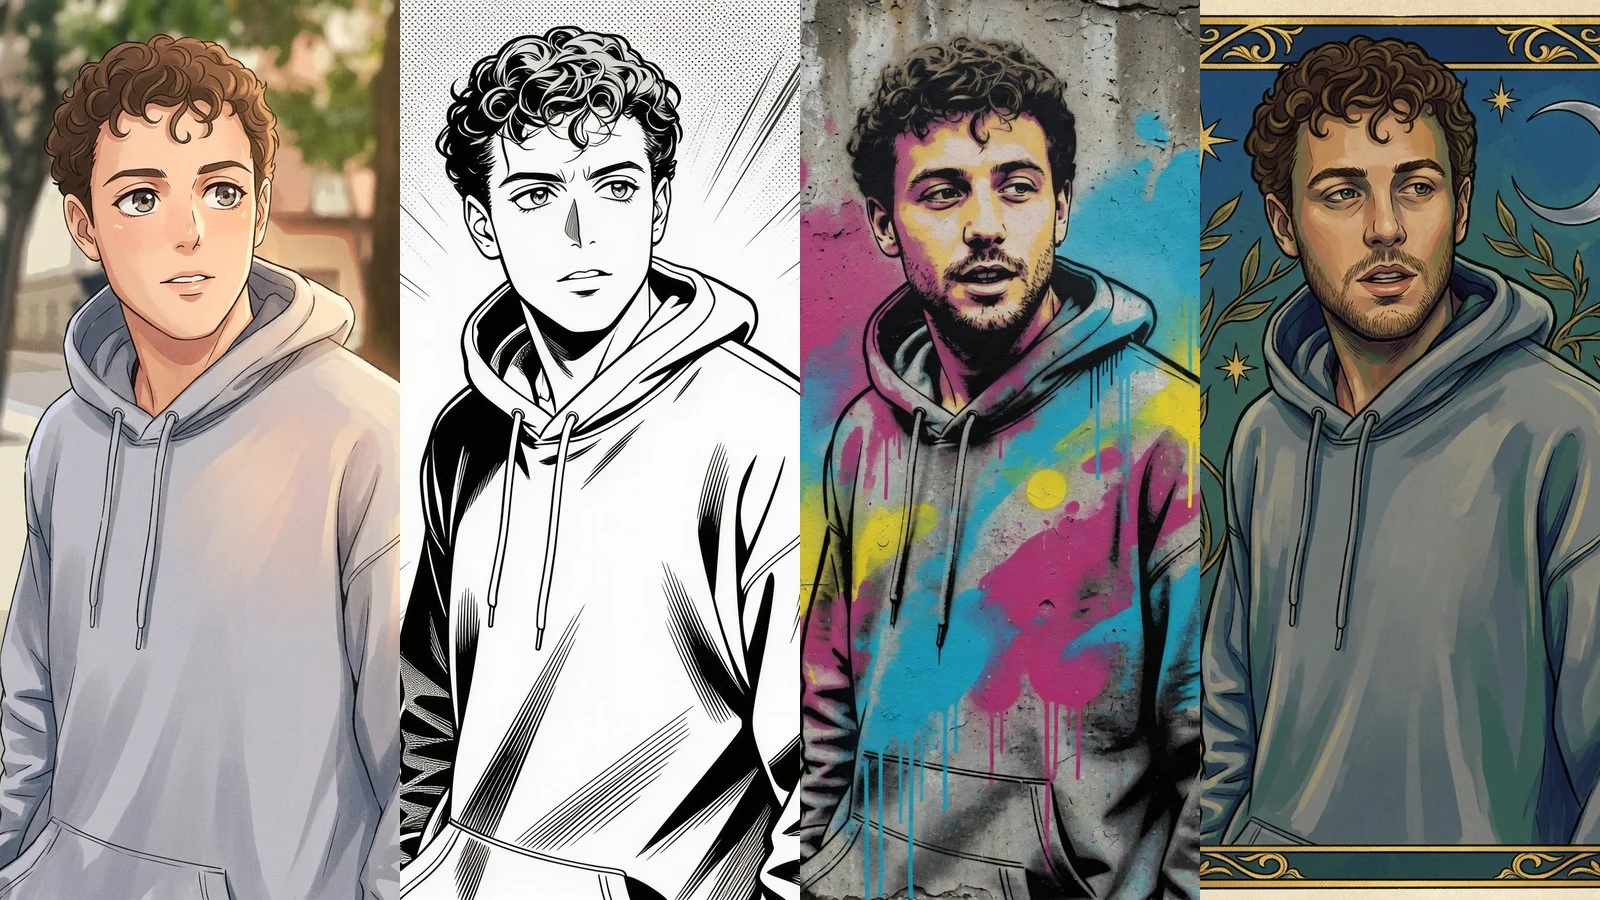
Quattro modelli i2i, una foto di riferimento, quattro risultati completamente diversi. Qui sotto trovi gli esatti prompt che abbiamo scritto ed eseguito di persona — fotogramma di film anime, vignetta manga, murale graffiti e ritratto dei tarocchi — ciascuno con l'immagine realmente generata e la chiamata API per riprodurla.
In breve: in tutti e quattro gli stili, posa, acconciatura e tratti identitari sono stati preservati con successo, perché ogni prompt specifica esplicitamente cosa mantenere («stessa posa», «stessa acconciatura», «stessa silhouette della felpa») e cosa cambiare. Se togli questa metà del prompt, ogni modello che abbiamo testato fa derivare il soggetto verso un volto generico, invece che verso la tua versione stilizzata.
Riferimento rapido: scegli il tuo stile
| Stile | Modello | Risoluzione | Prezzo |
|---|---|---|---|
| 1. Fotogramma di film anime | nano-banana-2 |
1K | $0,085/immagine |
| 2. Vignetta manga | seedream-4.5/image-to-image |
2K | $0,045/immagine |
| 3. Murale graffiti | grok-imagine-quality/image-to-image |
1k | $0,08/immagine + costo dell'immagine di riferimento |
| 4. Ritratto dei tarocchi | nano-banana-2 |
1K | $0,085/immagine |
I prezzi si riferiscono a una singola immagine di output alla risoluzione indicata, con dati recuperati di recente dall'endpoint dei prezzi di hiapi nel 2026-09 — consulta la pagina dei prezzi di hiapi prima di preventivare un batch, perché le tariffe dei modelli cambiano. L'endpoint image-to-image di Grok Imagine Quality addebita un piccolo supplemento per ogni immagine di riferimento oltre al prezzo base; ogni chiamata qui sotto usa una sola immagine di riferimento, quindi il budget totale per questa voce è di circa $0,09–$0,10.
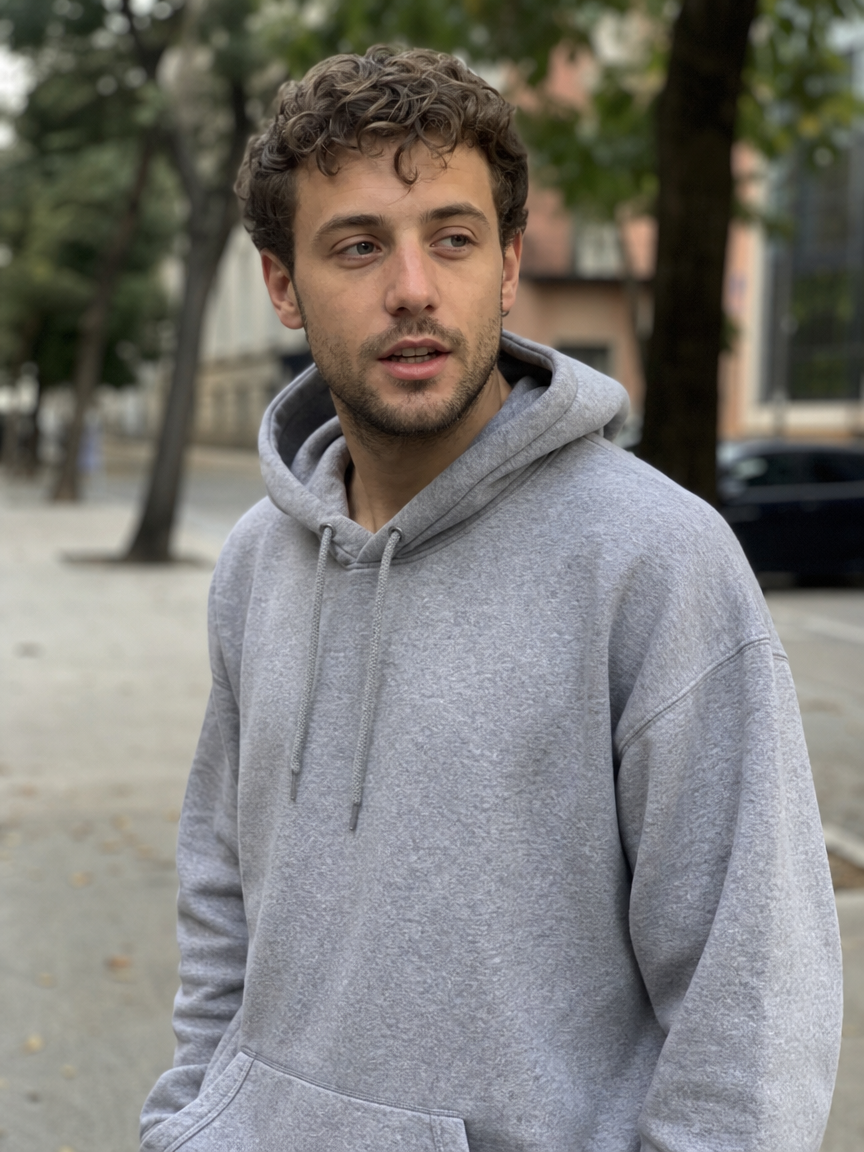
Ecco la foto di riferimento usata in ogni ricetta qui sotto:
Ricetta 1: fotogramma di film anime
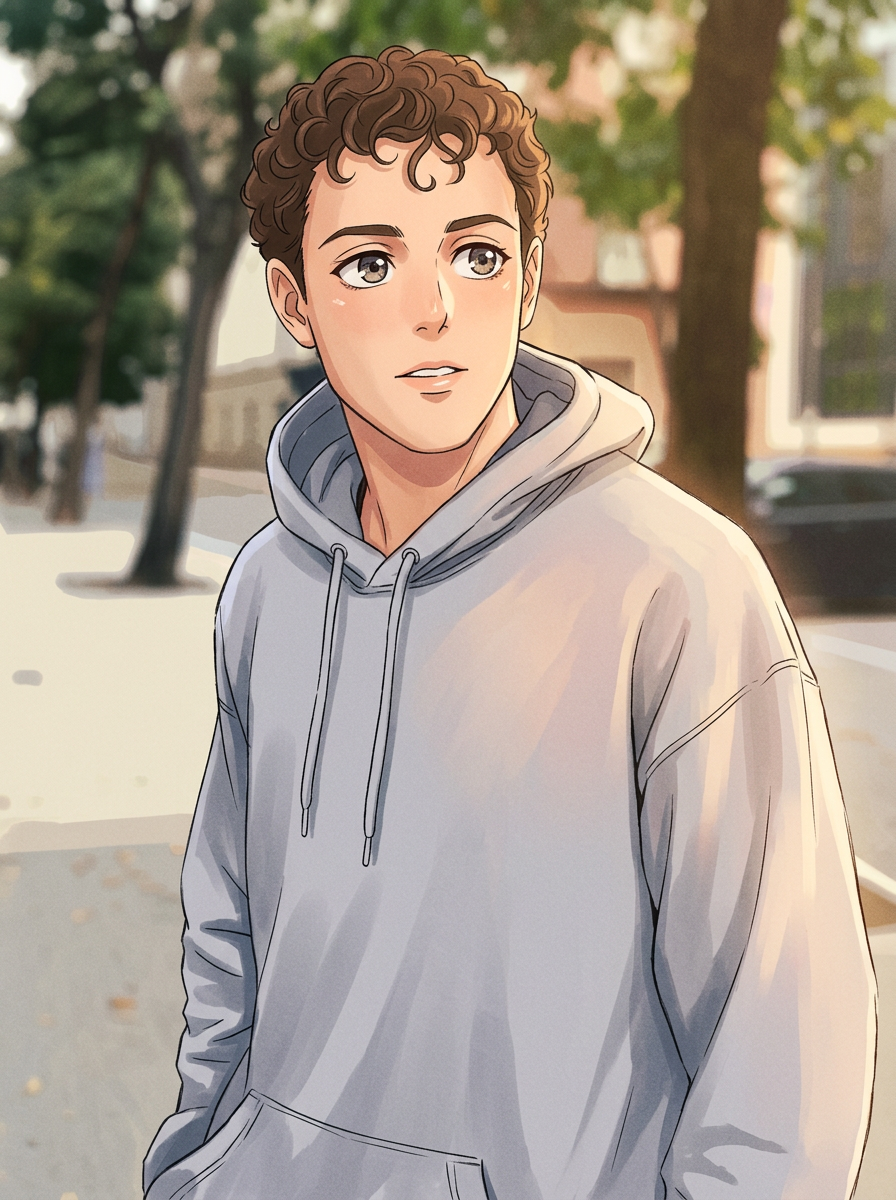
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Perché funziona: la maggior parte del testo di questo prompt riguarda la texture, non il soggetto — «cel-shading», «texture del pennello visibile», «bloom di luce» — perché il soggetto è già fissato dalla foto di riferimento. Ridisegnare gli occhi «in proporzioni anime» è l'unico punto in cui facciamo deliberatamente deviare il modello dalla foto; tutto il resto («stessa acconciatura, posa e colore della felpa») è esplicitamente bloccato, così il risultato resta riconoscibile come la stessa persona, solo illustrata.
Riprodurla:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Esegui il polling su GET https://api.hiapi.ai/v1/tasks/{taskId} finché status non diventa success, poi scarica output[0].url — il link ha una scadenza, salvalo subito in una posizione permanente. Sostituisci image_input con il tuo ritratto e questa struttura di prompt funzionerà con qualsiasi soggetto dalla posa e dall'acconciatura ben definite.
Ricetta 2: vignetta manga in bianco e nero
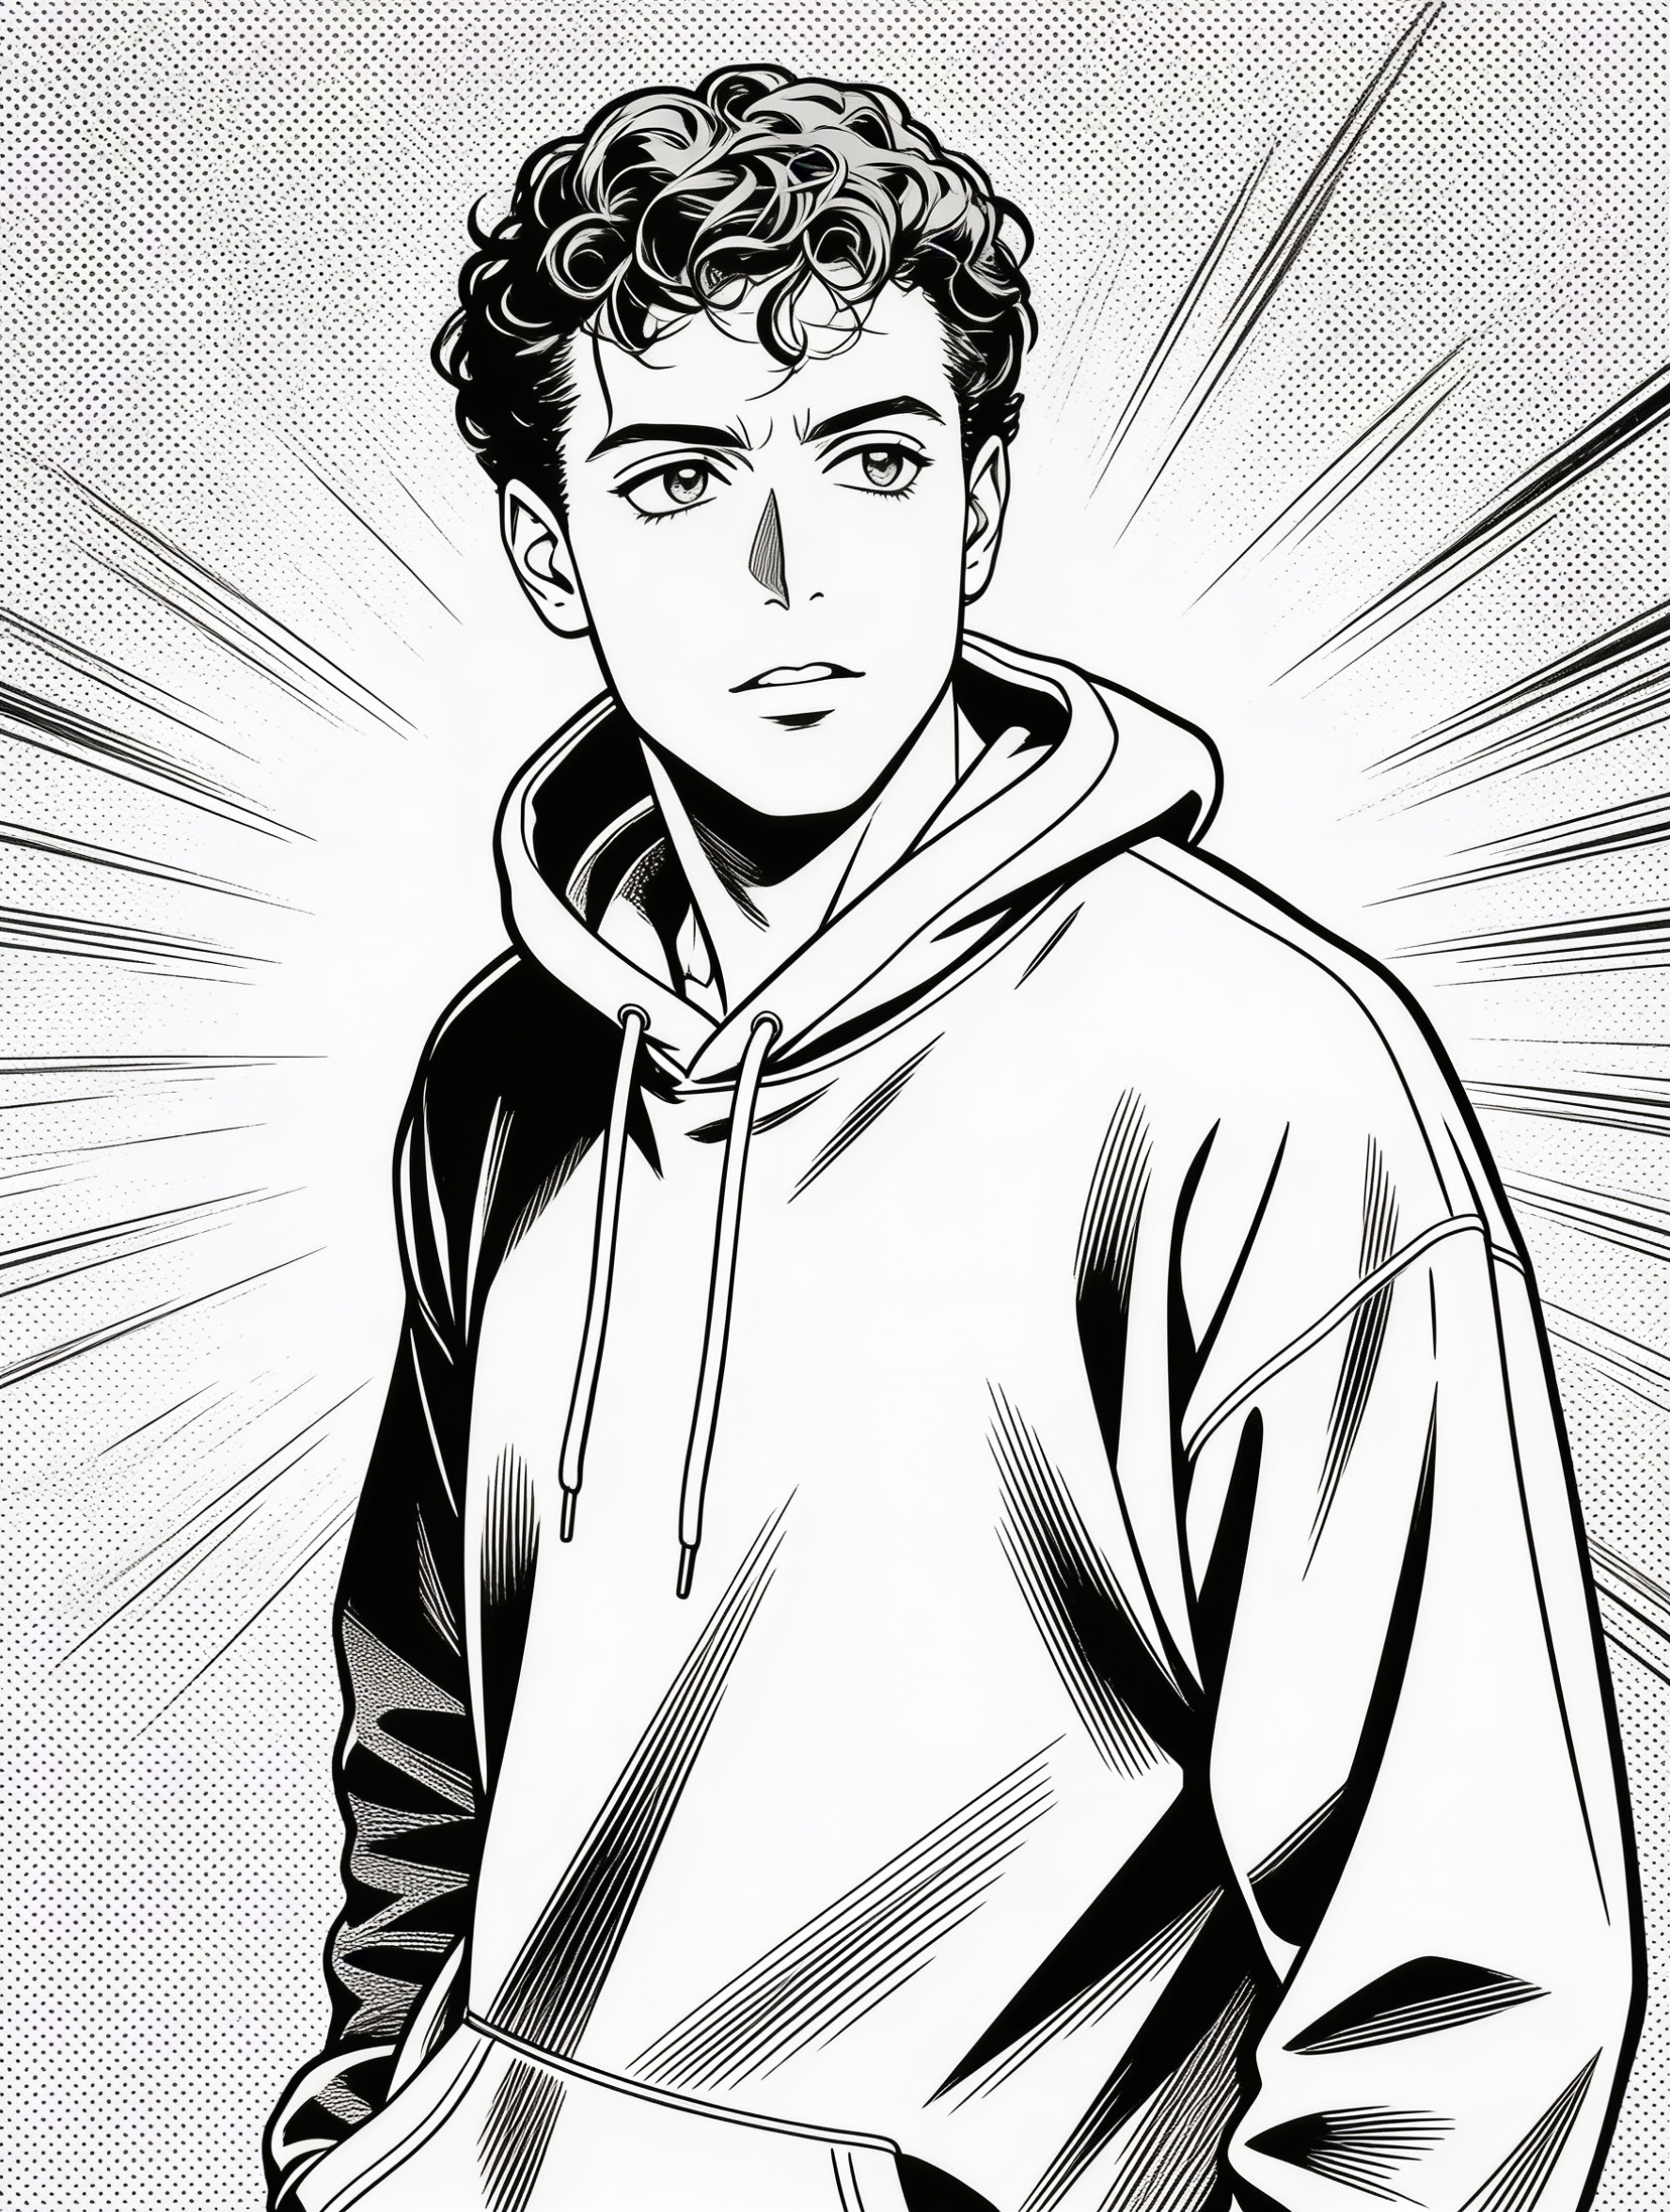
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Perché funziona: il successo dello stile manga dipende da due cose che questo prompt nomina direttamente — il retino (i motivi a punti usati nei manga reali al posto dei gradienti) e lo spessore della linea («linea a inchiostro nitida», «lineamenti del viso... affilati»). Senza nominare esplicitamente il retino, i modelli i2i tendono a ripiegare su un'ombreggiatura piatta in stile anime generico, invece del vero effetto mezzatinta che sembra un manga. Il «nessun colore, nessun testo, nessun fumetto» è stato aggiunto perché i modelli addestrati sui manga a volte inventano bordi delle vignette o testi di dialogo se non li escludi esplicitamente.
Riprodurla:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
Stessa POST su /v1/tasks e stesso schema di polling della Ricetta 1 — seedream-4.5/image-to-image mette solo la foto di riferimento sotto image_urls (plurale, array) invece che sotto image_input, e fattura a un prezzo fisso di $0,045 indipendentemente dal livello di risoluzione.
Ricetta 3: murale graffiti a bomboletta
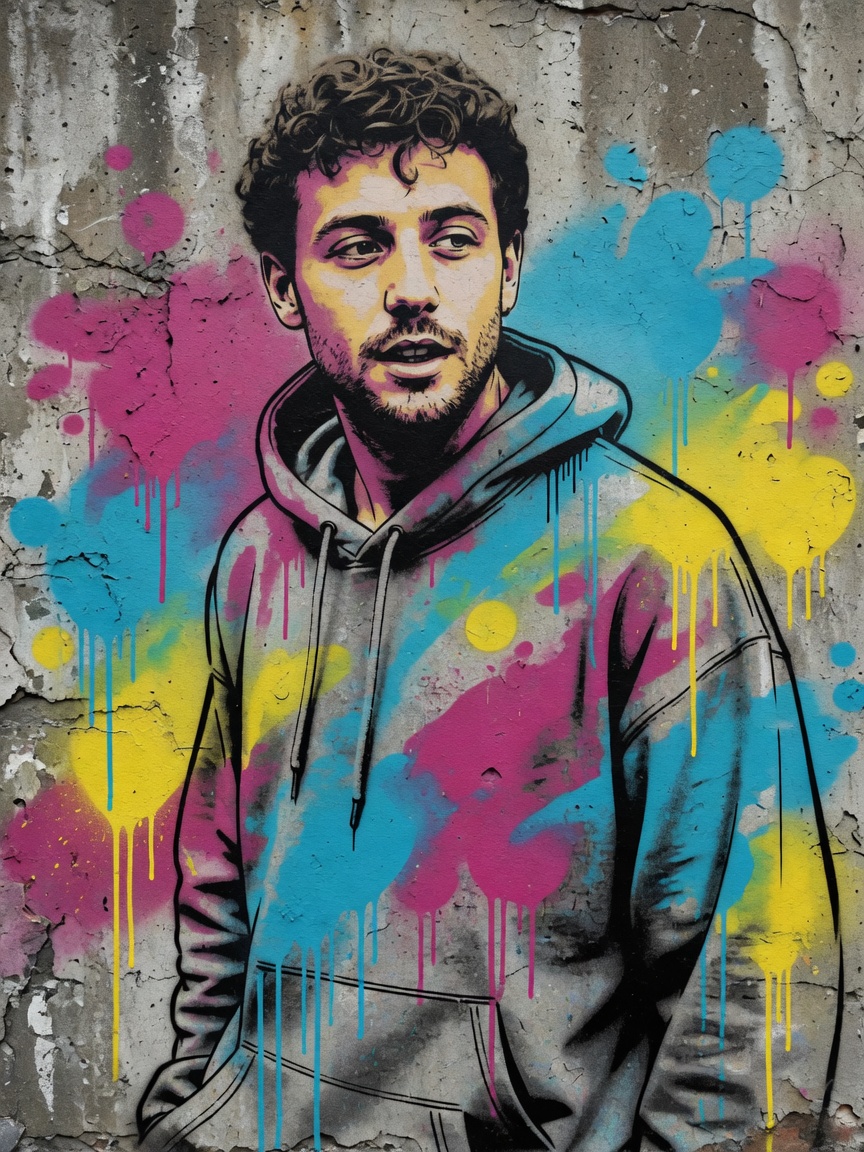
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Perché funziona: il graffiti è uno dei pochi stili in cui nominare la tecnica (stencil, colature di vernice spray, tratti di contorno spessi) conta più che nominare il soggetto. Anche la lista di colori — «magenta, ciano e giallo» — fa la differenza: lasciando i colori aperti, la maggior parte dei modelli i2i ripiega su tonalità torbide e desaturate, invece dei riempimenti piatti e saturi di un vero murale a bomboletta. Come nelle altre tre ricette, «mantieni la stessa posa, acconciatura e forma della felpa» è la chiave per impedire che il murale diventi un generico volto di street art.
Riprodurla:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Nota il "1k" minuscolo — a differenza degli altri due modelli sopra, lo schema di Grok Imagine Quality fa distinzione tra maiuscole e minuscole nel valore della risoluzione. Questo endpoint non ha il campo aspect_ratio; la composizione dell'output segue la tua foto di riferimento.
Ricetta 4: ritratto dei tarocchi
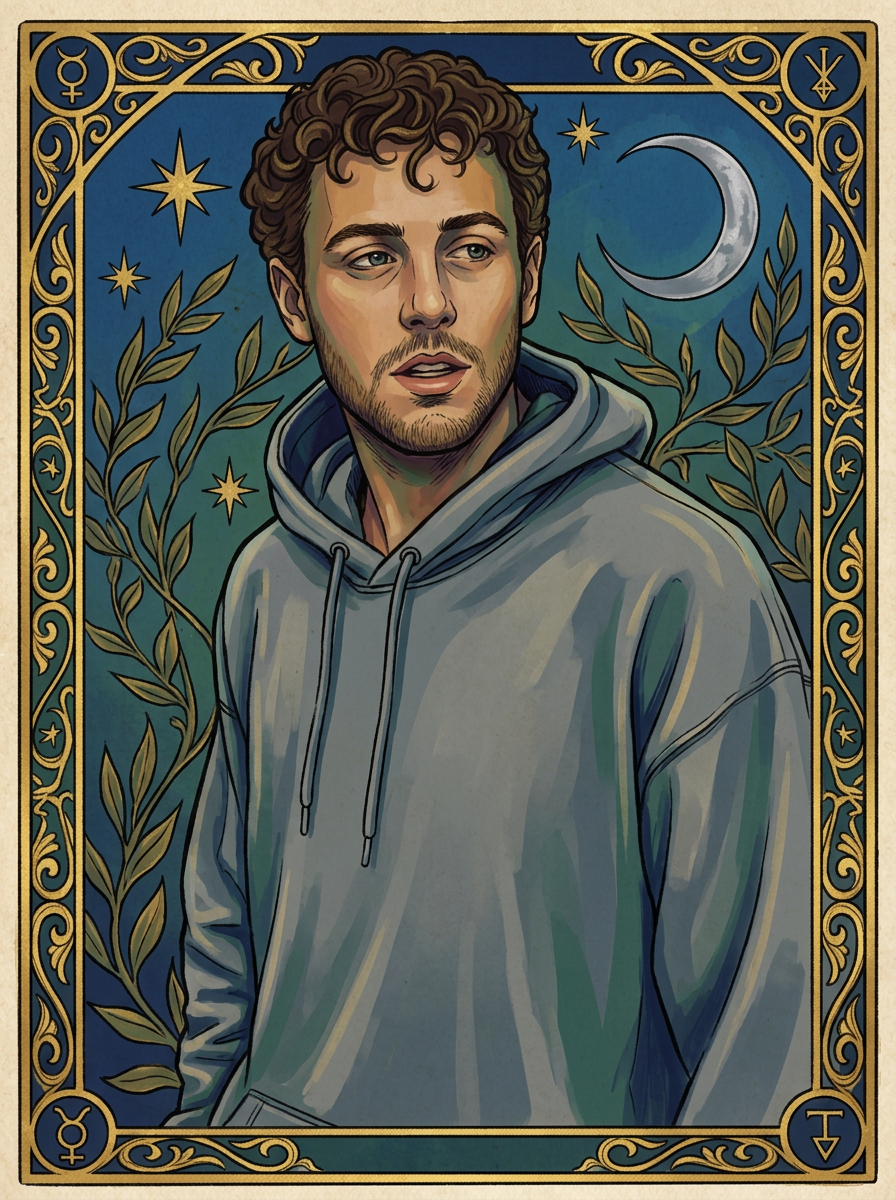
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Perché funziona: l'aspetto di una carta dei tarocchi deriva quasi interamente da elementi della cornice estranei al soggetto — il bordo a filigrana dorata, i simboli mistici di sfondo (stelle, luna crescente, rami di alloro). Nominare esplicitamente questi elementi è ciò che trasforma un «ritratto con ombreggiature ornate» in una «carta dei tarocchi immediatamente riconoscibile». Abbiamo inoltre escluso esplicitamente i numeri e i nomi delle carte («nessun testo, nessun nome della carta, nessun numero»), perché i modelli addestrati su carte dei tarocchi reali aggiungono nomi segnaposto se non li escludi.
Riprodurla:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Stesso modello della Ricetta 1 (nano-banana-2), prompt diverso — un buon promemoria del fatto che, nel trasferimento di stile i2i, la scelta del modello conta meno della specificità del prompt su «cosa mantenere e cosa reimmaginare».
Domande frequenti
Qual è il modello migliore per il trasferimento di stile da foto ad anime?
Tra i tre modelli che abbiamo testato, nano-banana-2 ha mantenuto più costantemente i tratti identitari (posa, acconciatura, proporzioni) su più esecuzioni ripetute, al prezzo di $0,085/immagine (1K). seedream-4.5/image-to-image è l'opzione più economica, a un prezzo fisso di $0,045/immagine, adatta a stili basati sulle linee come il manga; grok-imagine-quality/image-to-image si avvicina di più a un ridisegno completo, adatto a casi come il graffiti in cui una certa deriva del soggetto fa parte dello stile stesso.
Questi prompt richiedono una foto specifica per funzionare? Un ritratto nitido di fronte o di tre quarti, con acconciatura e abbigliamento visibili, dà i risultati più stabili — è anche l'ipotesi su cui si basano i quattro prompt sopra quando dicono «stessa posa, acconciatura e felpa». Uno sfondo disordinato o un volto parzialmente coperto rendono più difficile per il modello capire cosa mantenere.
Posso combinare questi prompt, ad esempio un tarocco in stile anime? Sì — sostituisci il linguaggio relativo alla tecnica (cel-shading vs. retino vs. texture spray) mantenendo il linguaggio della cornice dell'altra ricetta (il bordo dorato e i simboli dei tarocchi, oppure la texture del muro dei graffiti). Le due metà di ogni prompt — conservazione del soggetto e tecnica stilistica — sono scritte in modo modulare.
Perché alcuni di questi prompt specificano «nessun testo» o «nessuna filigrana»? I modelli addestrati su veri fotogrammi di anime, pagine di manga e carte dei tarocchi hanno visto moltissimi esempi con testo incorporato — titoli di coda, onomatopee, nomi delle carte — e a volte aggiungono testo segnaposto di propria iniziativa. Escluderlo esplicitamente lo previene in anticipo; aggiungerlo al prompt non costa nulla e fa risparmiare una generazione sprecata.
La risoluzione influisce sul prezzo di questi modelli?
Dipende dal modello. Il prezzo di nano-banana-2 e seedream-4.5 su alcuni endpoint varia effettivamente con il livello di risoluzione, mentre seedream-4.5/image-to-image nello specifico costa un fisso di $0,045 indipendentemente dal livello. Consulta sempre la pagina dei prezzi aggiornata di hiapi prima di preventivare un batch — le tariffe variano da modello a modello e vengono aggiornate in modo indipendente.
Punti chiave
- Ognuno dei prompt sopra si divide in due metà: cosa mantenere (posa, acconciatura, identità) e cosa cambiare (stile artistico, tecnica, composizione) — scrivi chiaramente entrambe, altrimenti il modello fa silenziosamente derivare il soggetto verso qualcosa di generico.
- Nominare la tecnica e non solo lo stile di destinazione dà risultati più precisi: «motivo a punti di retino» batte «stile manga», «stencil e colature di vernice spray» batte «stile graffiti».
- Escludi ciò che i modelli tendono a inventare in uno stile specifico — testo segnaposto, numeri delle carte, fumetti — anche se pensi di non averne bisogno.
grok-imagine-quality/image-to-imageusa valori di risoluzione minuscoli ("1k", non"1K") e non ha il campoaspect_ratio; controlla lo schema di ogni modello invece di dare per scontato che sia uguale a quello che hai usato prima.- Tutti e quattro i prompt sono punti di partenza pronti da copiare e incollare — sostituisci la tua foto di riferimento tramite
image_inputoimage_urlse la stessa struttura funzionerà su soggetti diversi.
Vuoi vedere come un singolo modello i2i gestisce più livelli di risoluzione e più immagini di riferimento prima di scegliere un modello per un batch? Il tutorial sull'API di Nano Banana 2 approfondisce autenticazione, struttura delle richieste e gestione degli errori. Oppure vai direttamente alla pagina del modello nano-banana-2 e provalo con la tua foto di riferimento.
Articoli correlati
Vedi tutti gli articoli →-

Inventario
Alternative consigliate all'API di inferenza di Hugging Face (2026): una sola API per chiamare immagini/video/audio/LLM
Modello di prezzo, ampiezza della copertura dei modelli, complessità di integrazione, compatibilità OpenAI: capire in quali scenari conviene passare dal routing aggregato a un'API di generazione unificata
-

Inventario
Come scegliere un'alternativa a RunPod: confronto sull'integrazione di API per immagini e video
RunPod è un cloud GPU, non un'API di generazione — prima chiarisci a quale livello devi operare per immagini e video.
-

Inventario
Come scegliere un'alternativa a Modal: confronto per l'integrazione di API di immagini e video