
결산
사진 스타일 전이 프롬프트 레시피: 애니메이션, 만화, 그래피티, 타로 카드
직접 작성하고 실제로 실행해 본 네 가지 AI 사진→아트 스타일 전이 프롬프트—애니메이션 영화 스틸, 만화 분할 컷, 그래피티 벽화, 타로 카드 초상화—와 실제 전후 비교 이미지, 그리고 재현에 필요한 API 호출을 소개합니다.
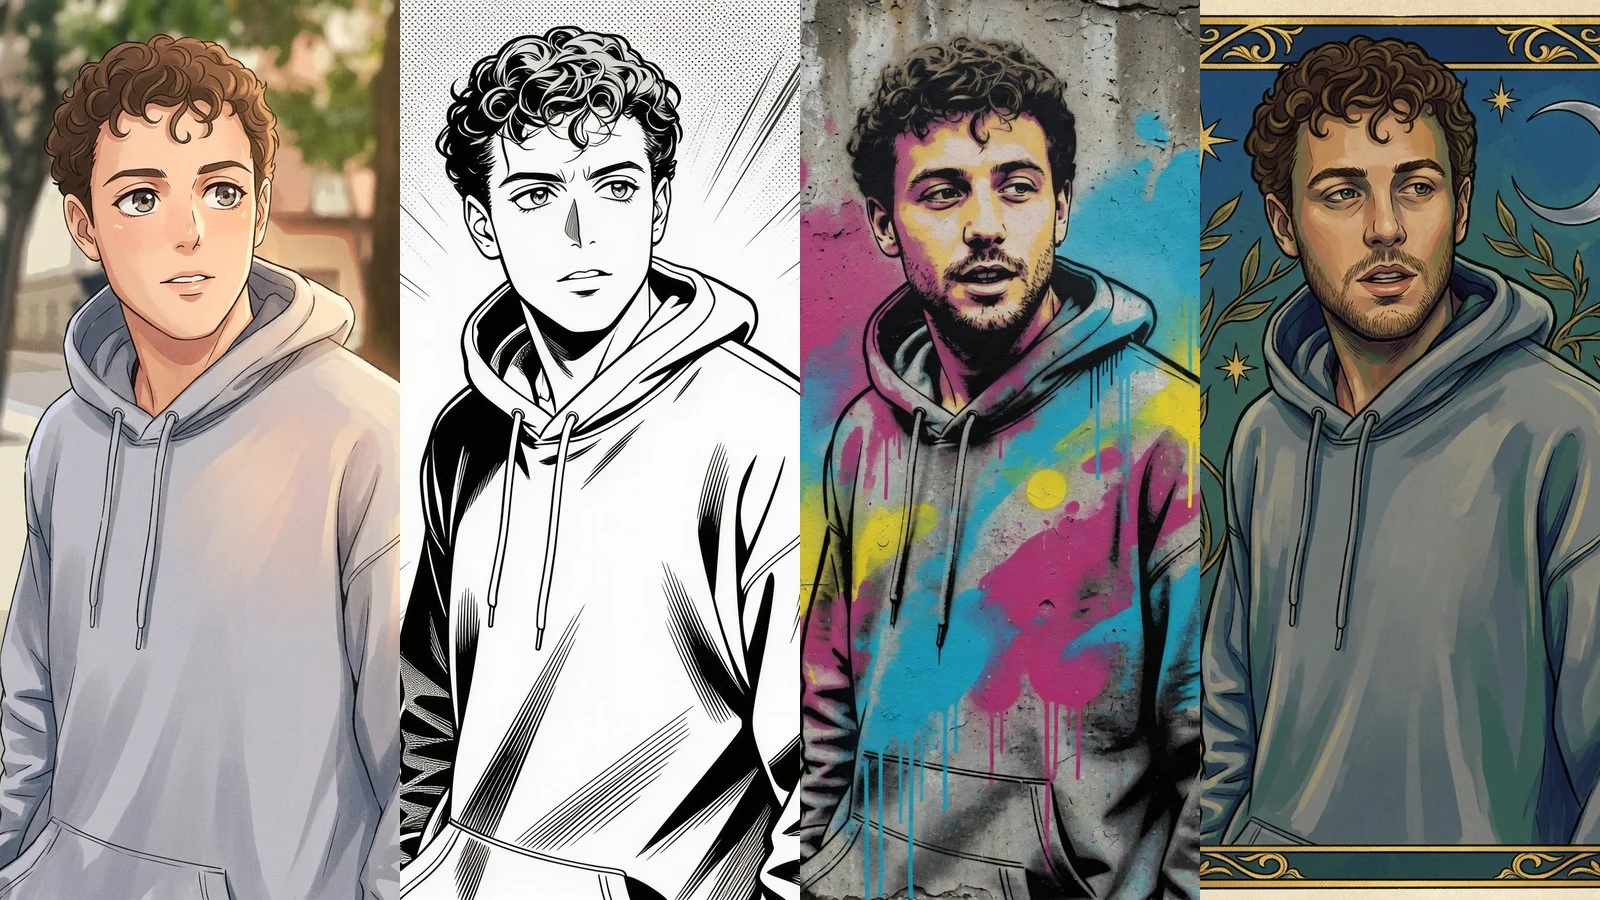
네 개의 i2i 모델, 하나의 참조 사진, 네 개의 전혀 다른 결과. 아래는 우리가 직접 작성하고 실행한 정확한 프롬프트—애니메이션 영화 스틸, 만화 분할 컷, 그래피티 벽화, 타로 카드 초상화—이며, 각각 실제 생성 이미지와 이를 재현하는 API 호출이 함께 제공됩니다.
요약하자면: 네 가지 스타일 모두에서 포즈, 헤어스타일, 정체성 특징이 성공적으로 유지되었습니다. 각 프롬프트가 무엇을 유지할지(“동일한 포즈”, “동일한 헤어스타일”, “동일한 후드 실루엣”)와 무엇을 바꿀지를 명확히 밝히기 때문입니다. 이 절반의 프롬프트를 빼면, 우리가 테스트한 모든 모델이 피사체를 당신의 스타일화된 버전이 아닌 평범한 얼굴로 표류시켰습니다.
빠른 참조: 스타일 선택
| 스타일 | 모델 | 해상도 | 가격 |
|---|---|---|---|
| 1. 애니메이션 영화 스틸 | nano-banana-2 |
1K | $0.085/장 |
| 2. 만화 분할 컷 | seedream-4.5/image-to-image |
2K | $0.045/장 |
| 3. 그래피티 벽화 | grok-imagine-quality/image-to-image |
1k | $0.08/장 + 참조 이미지 비용 |
| 4. 타로 카드 초상화 | nano-banana-2 |
1K | $0.085/장 |
가격은 표시된 해상도에서 단일 출력 이미지 기준이며, 2026-09에 hiapi 가격 엔드포인트에서 최신으로 가져온 데이터입니다—모델별 요율이 변동되므로 배치 예산을 세우기 전에 hiapi 가격 페이지를 확인하세요. Grok Imagine Quality의 image-to-image 엔드포인트는 기본 가격에 더해 참조 이미지당 소액의 추가 비용이 부과됩니다; 아래 각 호출은 참조 이미지를 하나만 사용하므로 이 항목의 총 예산은 약 $0.09–$0.10입니다.
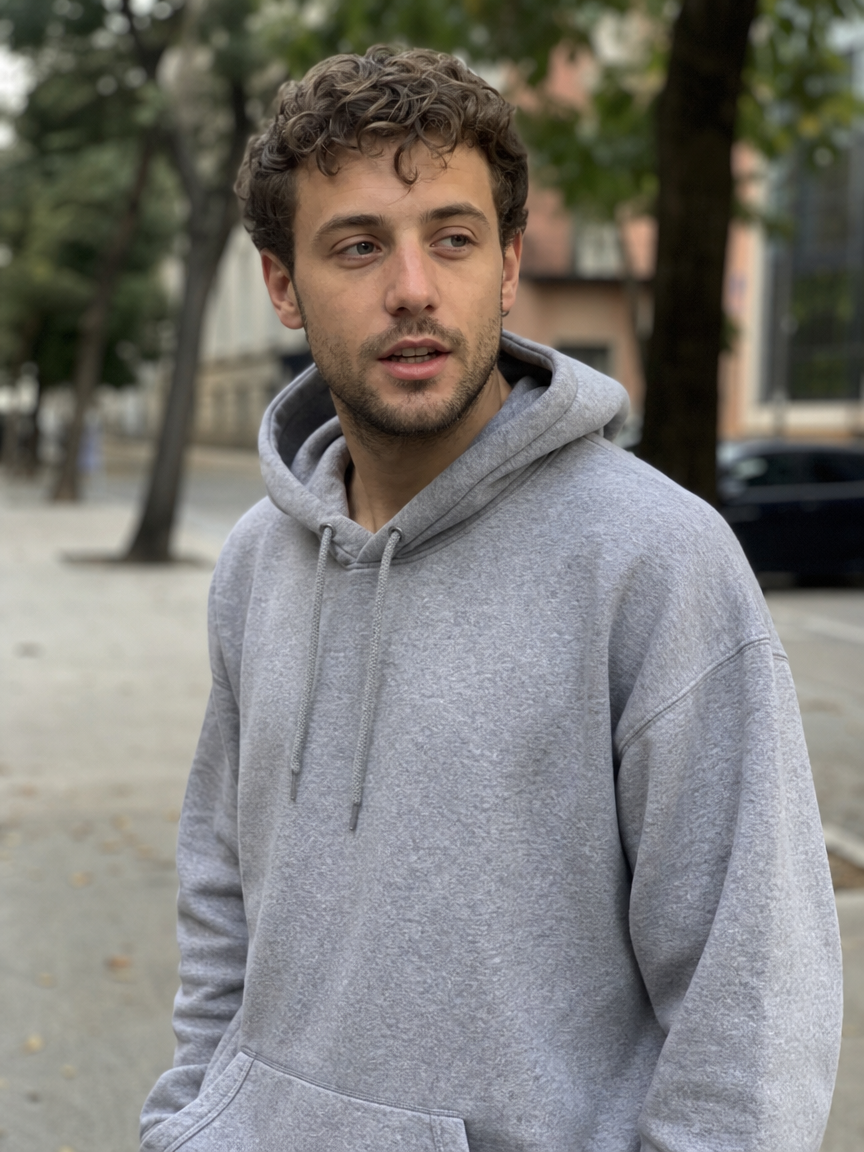
아래는 각 레시피에서 사용한 참조 사진입니다:
레시피 1: 애니메이션 영화 스틸
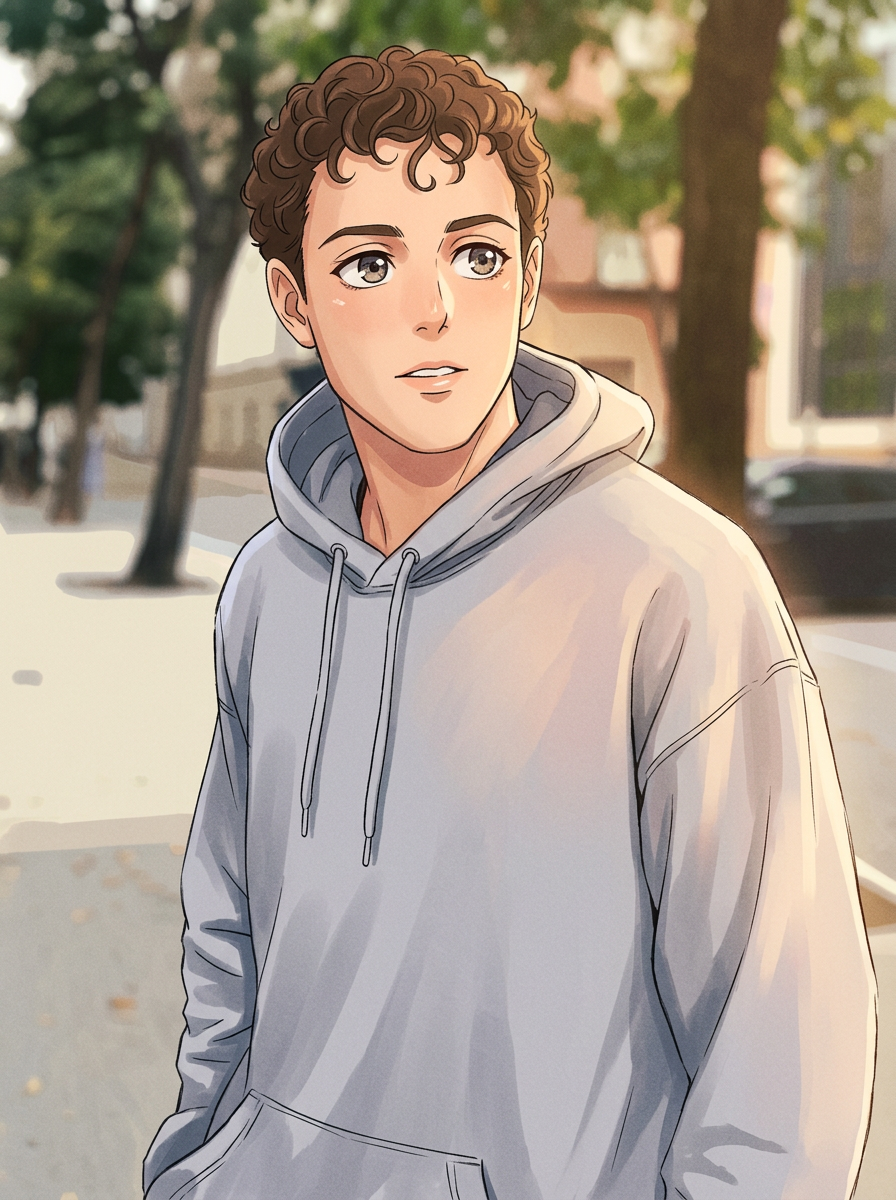
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
효과적인 이유: 이 프롬프트의 대부분의 텍스트는 피사체가 아니라 질감에 할애됩니다—“셀 셰이딩”, “보이는 브러시 질감”, “빛 번짐”—피사체는 이미 참조 사진으로 고정되어 있기 때문입니다. 눈을 “애니메이션 비율”로 다시 그리는 것이 우리가 의도적으로 모델을 사진에서 벗어나게 한 유일한 부분입니다; 나머지 모든 것(“동일한 헤어스타일, 포즈, 후드 색상”)은 명시적으로 고정되어 있어 결과가 같은 사람으로 인식되면서도 일러스트화됩니다.
재현하기:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
GET https://api.hiapi.ai/v1/tasks/{taskId}를 폴링하여 status가 success가 될 때까지 기다린 후 output[0].url을 다운로드하세요—해당 링크는 유효 기간이 있으므로 즉시 영구적인 위치에 저장하세요. image_input을 자신의 초상화로 바꾸면 이 프롬프트 구조는 포즈와 헤어스타일이 명확한 모든 피사체에 적용됩니다.
레시피 2: 흑백 만화 분할 컷
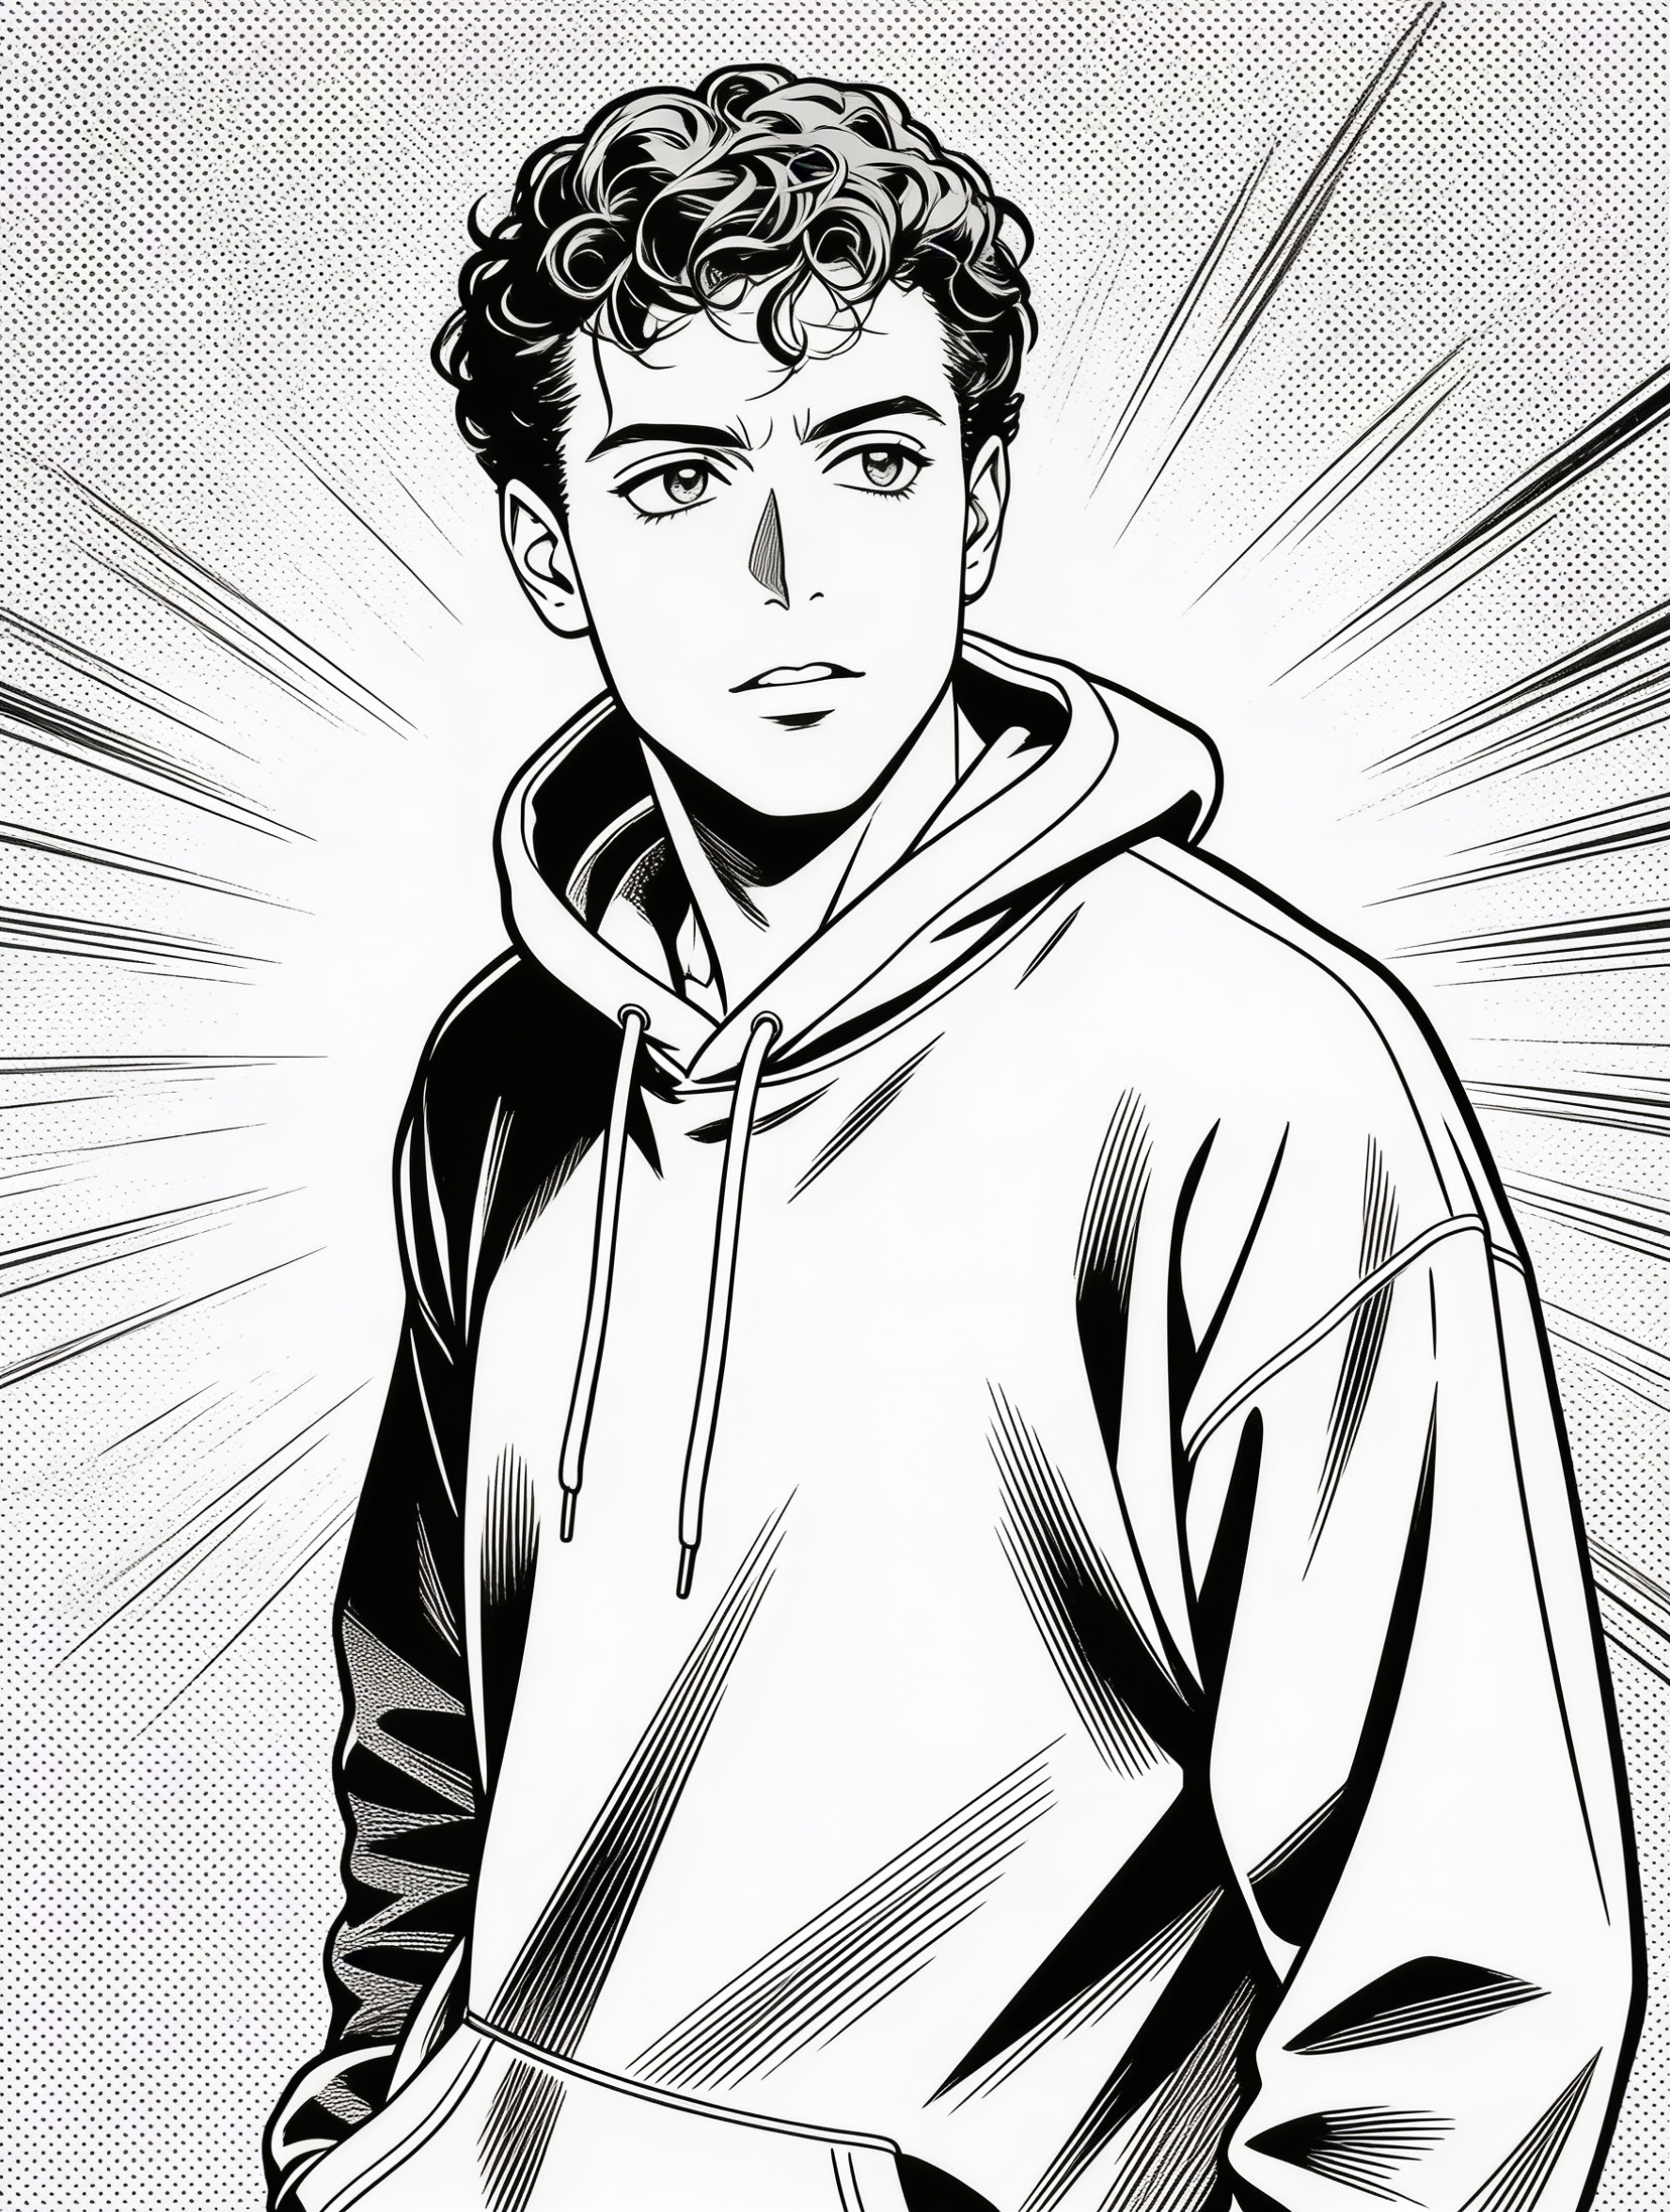
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
효과적인 이유: 만화 스타일은 이 프롬프트가 직접 명시하는 두 가지에 성패가 달려 있습니다—스크린톤(실제 만화에서 그라디언트 대신 사용하는 점 모양 음영)과 선 굵기(“선명한 잉크 선”, “날카로운... 얼굴 선”). 스크린톤을 명시하지 않으면 i2i 모델은 실제 만화처럼 보이는 하프톤 점 효과 대신 일반적인 애니메이션식 평면 음영을 기본으로 사용하는 경향이 있습니다. “색상 없음, 텍스트 없음, 말풍선 없음”을 추가한 이유는 만화로 학습된 모델이 명시적으로 배제하지 않으면 분할 테두리나 대사 텍스트를 종종 만들어내기 때문입니다.
재현하기:
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
레시피 1과 동일한 /v1/tasks POST 및 폴링 패턴—seedream-4.5/image-to-image는 참조 이미지를 image_input 대신 image_urls(복수, 배열) 아래에 두며, 해상도 등급에 관계없이 고정 $0.045로 청구됩니다.
레시피 3: 스프레이 페인트 그래피티 벽화
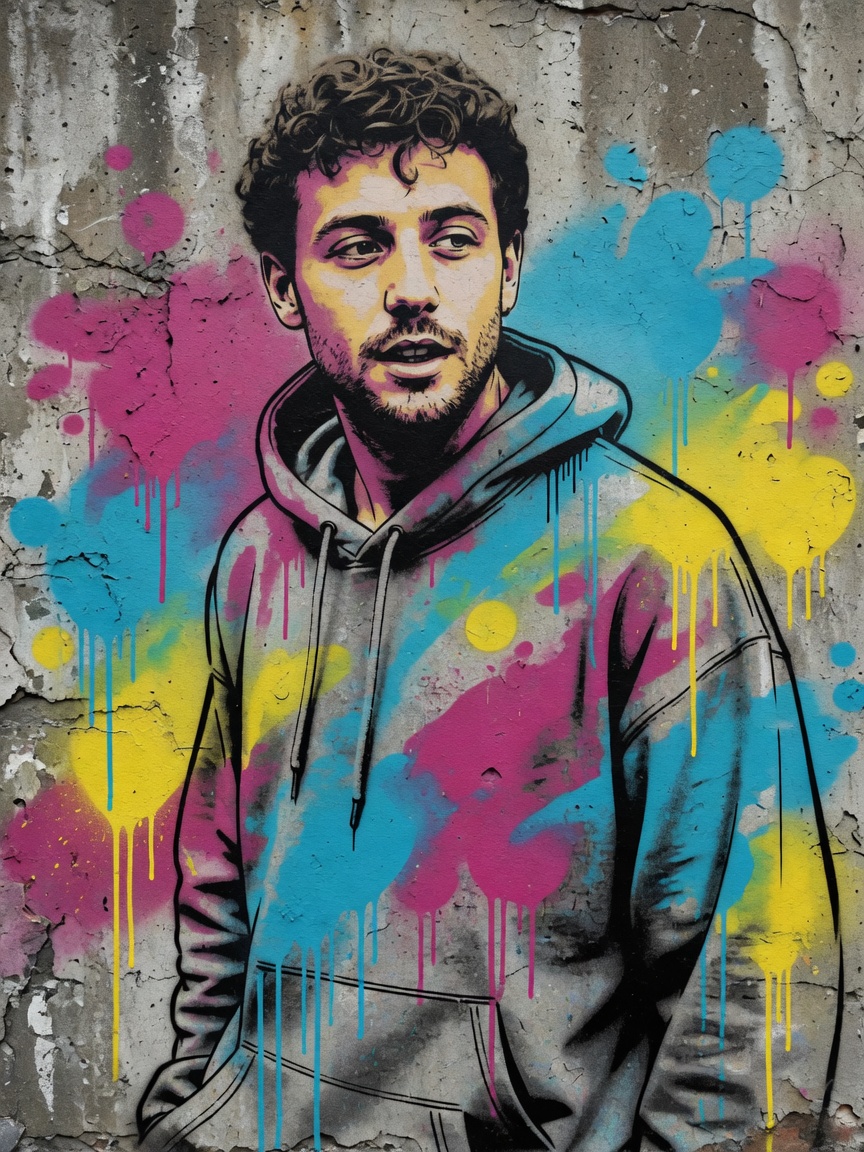
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
효과적인 이유: 그래피티는 기법(스텐실, 스프레이 흘러내림, 굵은 외곽선)을 명시하는 것이 피사체를 명시하는 것보다 더 중요한 몇 안 되는 스타일 중 하나입니다. 색상 목록—“마젠타, 시안, 옐로우”—도 실질적인 역할을 합니다: 색상을 열어두면 대부분의 i2i 모델은 실제 스프레이 벽화의 평면적이고 채도 높은 채우기가 아닌 탁하고 채도 낮은 색조를 기본으로 사용합니다. 다른 세 레시피와 마찬가지로 “동일한 포즈, 헤어스타일, 후드 실루엣 유지”가 벽화가 일반적인 스트리트 아트 얼굴로 변하는 것을 막는 핵심입니다.
재현하기:
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
여기서는 소문자 "1k"에 주목하세요—위의 다른 두 모델과 달리 Grok Imagine Quality의 스키마는 해상도 값에 대소문자를 구분합니다. 이 엔드포인트에는 aspect_ratio 필드가 없습니다; 출력 구도는 참조 이미지를 따릅니다.
레시피 4: 타로 카드 초상화
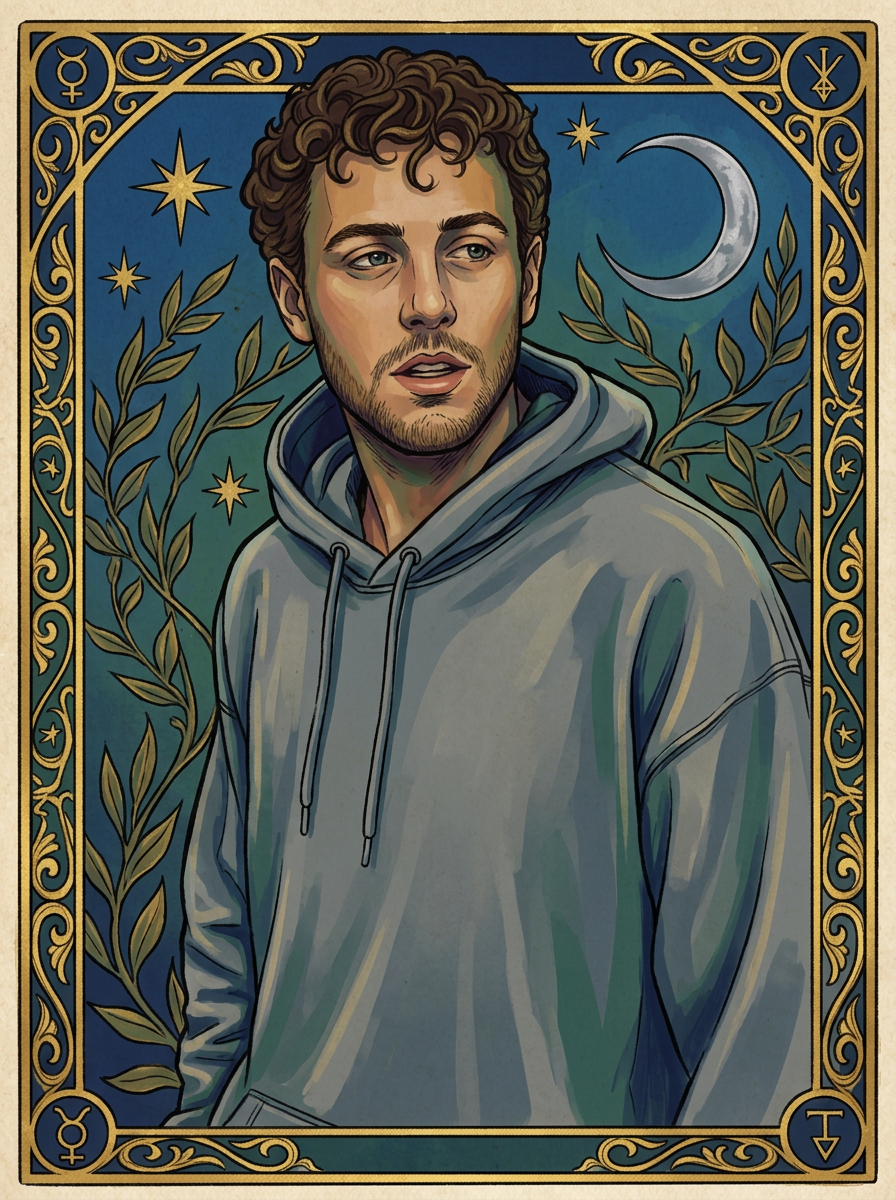
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
효과적인 이유: 타로 카드의 외관은 거의 전적으로 피사체와 무관한 프레임 요소—금색 필리그리 테두리, 신비로운 배경 기호(별, 초승달, 월계수 가지)—에서 비롯됩니다. 이러한 요소를 명시해야 “화려한 음영이 있는 초상화”가 “한눈에 알아볼 수 있는 타로 카드”가 됩니다. 또한 카드 숫자와 카드 이름을 명시적으로 배제했습니다(“텍스트 없음, 카드 이름 없음, 숫자 없음”). 실제 타로 카드로 학습된 모델은 배제하지 않으면 자리표시자 카드 이름 텍스트를 추가하기 때문입니다.
재현하기:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
레시피 1과 동일한 모델(nano-banana-2), 다른 프롬프트—i2i 스타일 전이에서 모델 선택보다 프롬프트가 “무엇을 유지하고 무엇을 재해석할지”를 얼마나 구체적으로 명시하는지가 더 중요하다는 점을 잘 보여줍니다.
자주 묻는 질문
사진을 애니메이션으로 바꾸는 스타일 전이에 가장 좋은 모델은 무엇인가요?
테스트한 세 모델 중 nano-banana-2가 여러 번 반복 실행에서 정체성 특징(포즈, 헤어스타일, 비율)을 가장 안정적으로 유지했으며, 가격은 $0.085/장(1K)입니다. seedream-4.5/image-to-image는 더 저렴한 선택으로 장당 고정 $0.045이며 만화처럼 선 중심의 스타일에 적합합니다; grok-imagine-quality/image-to-image는 보다 전면적인 재그리기에 가까워, 그래피티처럼 피사체의 어느 정도 편차 자체가 스타일의 일부인 경우에 적합합니다.
이 프롬프트가 효과를 내려면 특정 사진이 필요한가요? 헤어스타일과 의상이 보이는 선명한 정면 또는 4분의 3 측면 초상화가 가장 안정적입니다—이는 위의 네 프롬프트가 “동일한 포즈, 헤어스타일, 후드”라고 말할 때 전제하는 조건이기도 합니다. 배경이 어수선하거나 얼굴이 부분적으로 가려지면 모델이 무엇을 유지해야 할지 판단하기 어려워집니다.
이 프롬프트들을 조합할 수 있나요, 예를 들어 애니메이션 스타일의 타로 카드처럼? 가능합니다—기법 관련 언어(셀 셰이딩 vs. 스크린톤 vs. 스프레이 질감)를 교체하면서 다른 레시피의 프레임 언어(타로 카드의 금색 테두리와 기호, 또는 그래피티의 벽 질감)를 유지하세요. 각 프롬프트의 두 절반—피사체 유지와 스타일 기법—은 모듈식으로 작성되었습니다.
일부 프롬프트에서 “텍스트 없음” 또는 “워터마크 없음”을 지정하는 이유는 무엇인가요? 실제 애니메이션 스틸, 만화 페이지, 타로 카드로 학습된 모델은 제작진 크레딧, 의성어, 카드 이름 등 텍스트가 포함된 예시를 많이 보았으며—때때로 자리표시자 텍스트를 스스로 추가하기도 합니다. 명시적으로 배제하면 이를 미리 막을 수 있습니다; 프롬프트에 추가하는 데 비용이 들지 않고, 생성 한 번을 낭비하는 것을 절약할 수 있습니다.
해상도가 이 모델들의 가격에 영향을 미치나요?
모델에 따라 다릅니다. nano-banana-2와 seedream-4.5는 일부 엔드포인트에서 가격이 해상도 등급에 따라 실제로 변동하지만, seedream-4.5/image-to-image는 구체적으로 등급에 관계없이 고정 $0.045입니다. 배치 예산을 세우기 전에 반드시 hiapi의 실시간 가격 페이지를 확인하세요—요율은 모델마다 다르며 독립적으로 업데이트됩니다.
핵심 요점
- 위의 각 프롬프트은 두 절반으로 나뉩니다: 유지할 것(포즈, 헤어스타일, 정체성)과 변경할 것(예술 스타일, 기법, 구도)—두 절반을 모두 명확히 써야 하며, 그렇지 않으면 모델이 피사체를 조용히 평범한 무언가로 표류시킵니다.
- 목표 스타일뿐 아니라 기법을 명시하면 더 정확한 결과를 얻을 수 있습니다: “스크린톤 점 패턴”이 “만화 스타일”보다, “스텐실 하이라이트와 스프레이 흘러내림”이 “그래피티 스타일”보다 낫습니다.
- 특정 스타일에서 모델이 쉽게 만들어내는 것—자리표시자 텍스트, 카드 숫자, 말풍선—을 배제하세요, 필요 없다고 생각하더라도.
grok-imagine-quality/image-to-image는 소문자 해상도 값("1k","1K"아님)을 사용하며aspect_ratio필드가 없습니다; 이전에 사용한 모델과 일치한다고 가정하지 말고 각 모델의 스키마를 확인하세요.- 네 프롬프트 모두 바로 복사해서 붙여넣을 수 있는 출발점입니다—
image_input또는image_urls를 통해 자신의 참조 사진으로 바꾸면 동일한 구조를 다른 피사체에 그대로 적용할 수 있습니다.
배치 작업을 위해 모델을 선택하기 전에 단일 i2i 모델이 여러 해상도 등급과 참조 이미지 수를 어떻게 처리하는지 보고 싶으신가요? Nano Banana 2 API 튜토리얼에서 인증, 요청 구조, 오류 처리를 더 깊이 다룹니다. 아니면 nano-banana-2 모델 페이지로 바로 이동하여 자신의 참조 사진으로 실행해 보세요.
관련 글
모든 아티클 보기 →-

결산
Hugging Face Inference API 대체 솔루션 추천(2026): 하나의 API로 이미지/비디오/오디오/대형 모델 호출
가격 모델, 모델 커버리지 범위, 연동 복잡도, OpenAI 호환성을 살펴보고 어떤 상황에서 집계 라우팅에서 통합 생성 API로 전환해야 하는지 명확히 파악하기
-

결산
RunPod 대안 선택 가이드: 이미지 및 비디오 API 연동 비교
RunPod는 GPU 클라우드이지 생성 API가 아닙니다. 먼저 이미지와 비디오에서 어떤 계층을 써야 하는지 확실히 하세요.
-

결산
Modal 대안 선택 가이드: 이미지 및 비디오 API 연동 비교