
Inventaire
Recettes de prompts pour le transfert de style photographique : anime, manga, graffiti, tarot
Quatre ensembles de prompts de transfert de style photo vers art que nous avons écrits et réellement exécutés nous-mêmes — image de film d'animation, case de manga, fresque de graffiti et portrait de carte de tarot — avec de vraies images avant/après et les appels API nécessaires pour les reproduire.
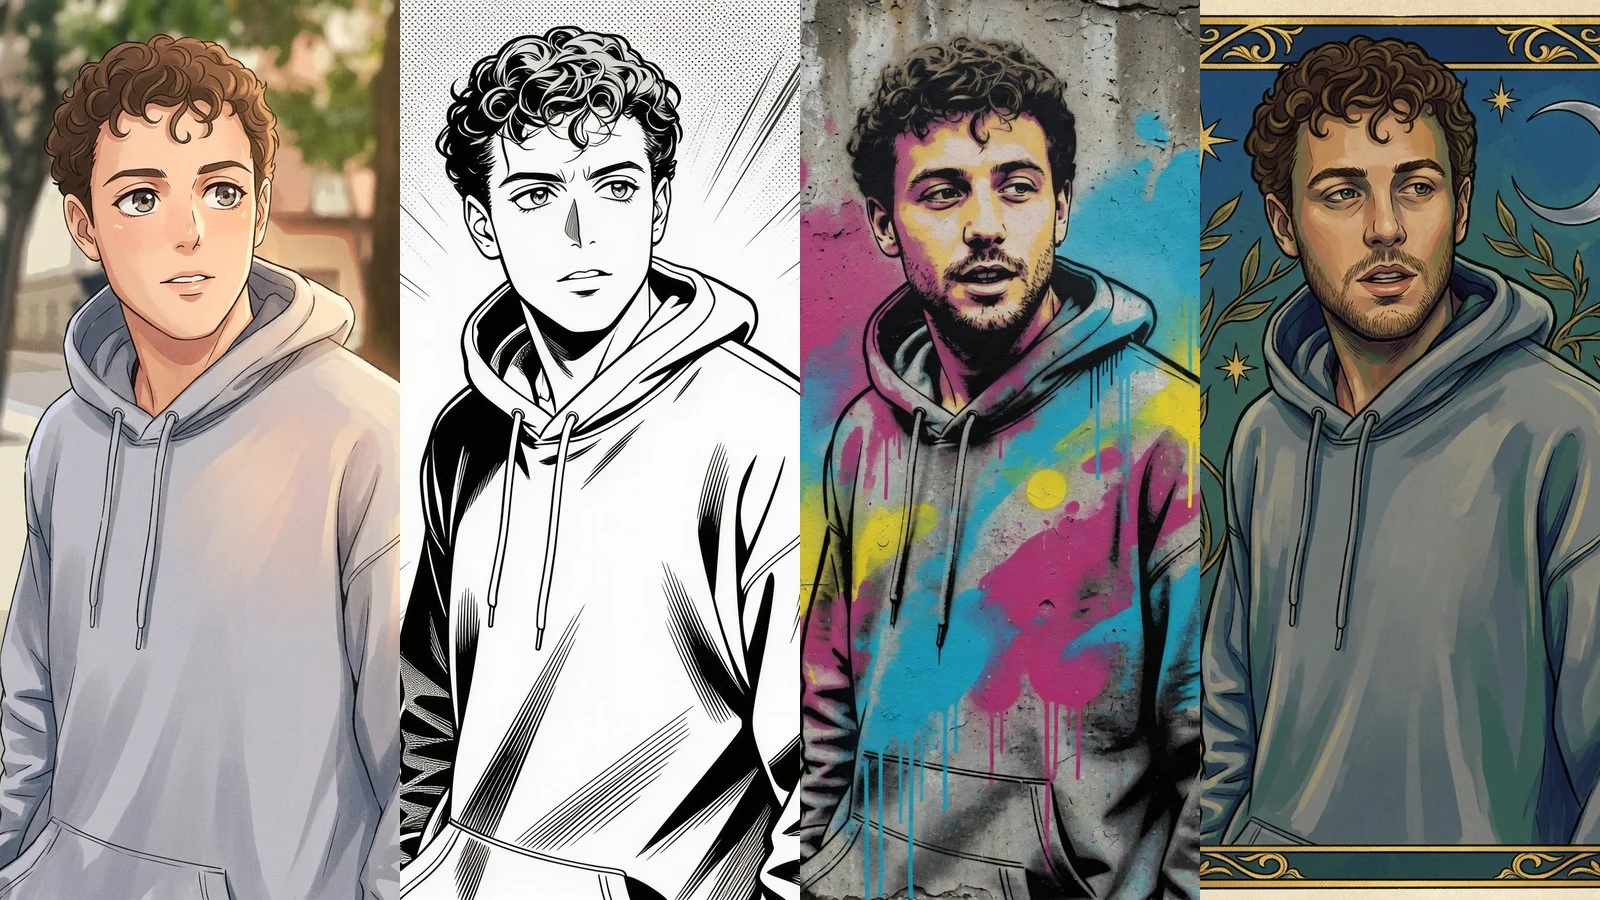
Quatre modèles i2i, une photo de référence, quatre résultats radicalement différents. Voici les prompts exacts que nous avons écrits et exécutés nous-mêmes — image de film d'animation, case de manga, fresque de graffiti et portrait de carte de tarot — chacun accompagné d'une image réellement générée et de l'appel API pour le reproduire.
En bref : dans les quatre styles, la pose, la coiffure et les traits identitaires ont été préservés avec succès, parce que chaque prompt précise explicitement ce qu'il faut conserver (« même pose », « même coiffure », « même silhouette de sweat à capuche ») tout en précisant ce qu'il faut changer. Si l'on retire cette moitié du prompt, chaque modèle que nous avons testé fait dériver le sujet vers un visage générique, au lieu de votre propre version stylisée.
Référence rapide : choisissez votre style
| Style | Modèle | Résolution | Prix |
|---|---|---|---|
| 1. Image de film d'animation | nano-banana-2 |
1K | 0,085 $/image |
| 2. Case de manga | seedream-4.5/image-to-image |
2K | 0,045 $/image |
| 3. Fresque de graffiti | grok-imagine-quality/image-to-image |
1k | 0,08 $/image + frais d'image de référence |
| 4. Portrait de carte de tarot | nano-banana-2 |
1K | 0,085 $/image |
Les prix sont calculés par image de sortie à la résolution indiquée ; les données ont été récupérées le 2026-09 sur le point de terminaison de tarification de hiapi — consultez d'abord la page de tarification de hiapi avant de budgétiser un lot, car les tarifs de chaque modèle changent. Le point de terminaison image-vers-image de Grok Imagine Quality applique, en plus du prix de base, un léger supplément par image de référence ; chaque appel ci-dessous n'utilise qu'une seule image de référence, donc le budget total pour cette option est d'environ 0,09 $–0,10 $.
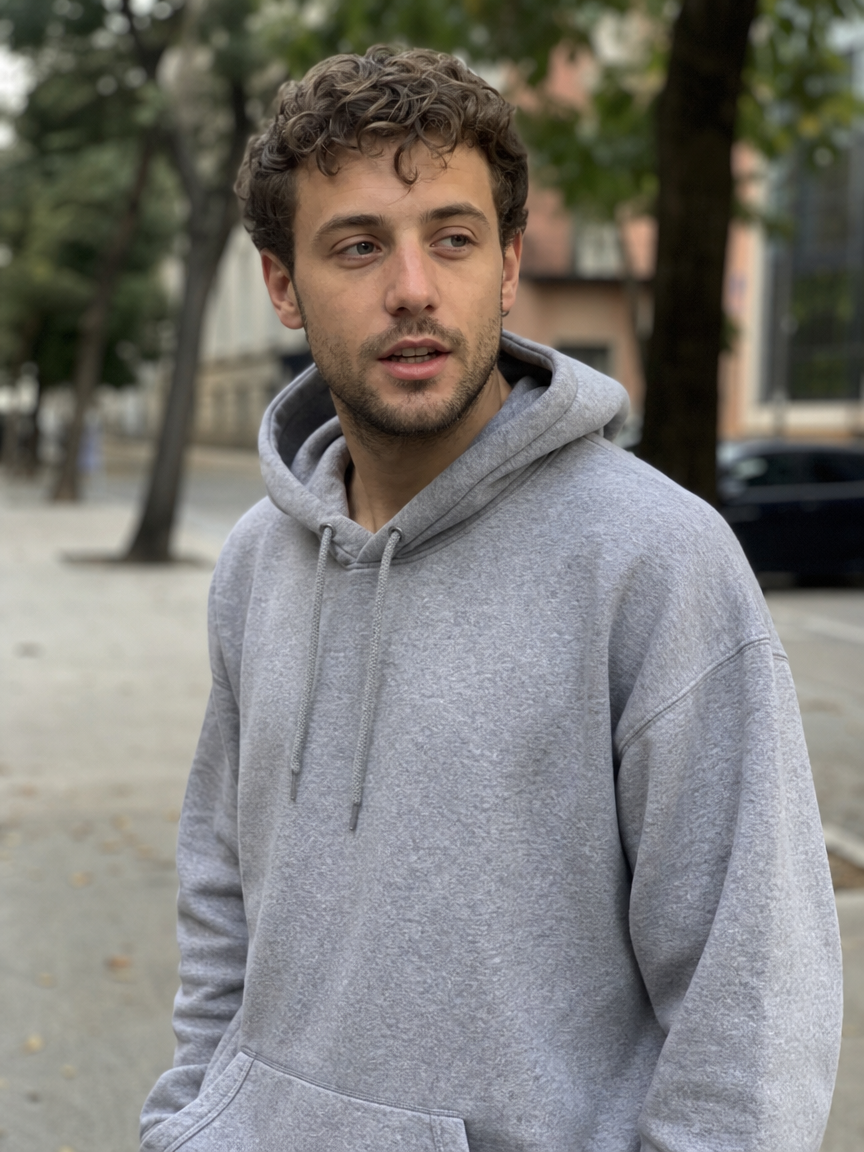
Voici la photo de référence utilisée pour chacune des recettes ci-dessous :
Recette 1 : Image de film d'animation
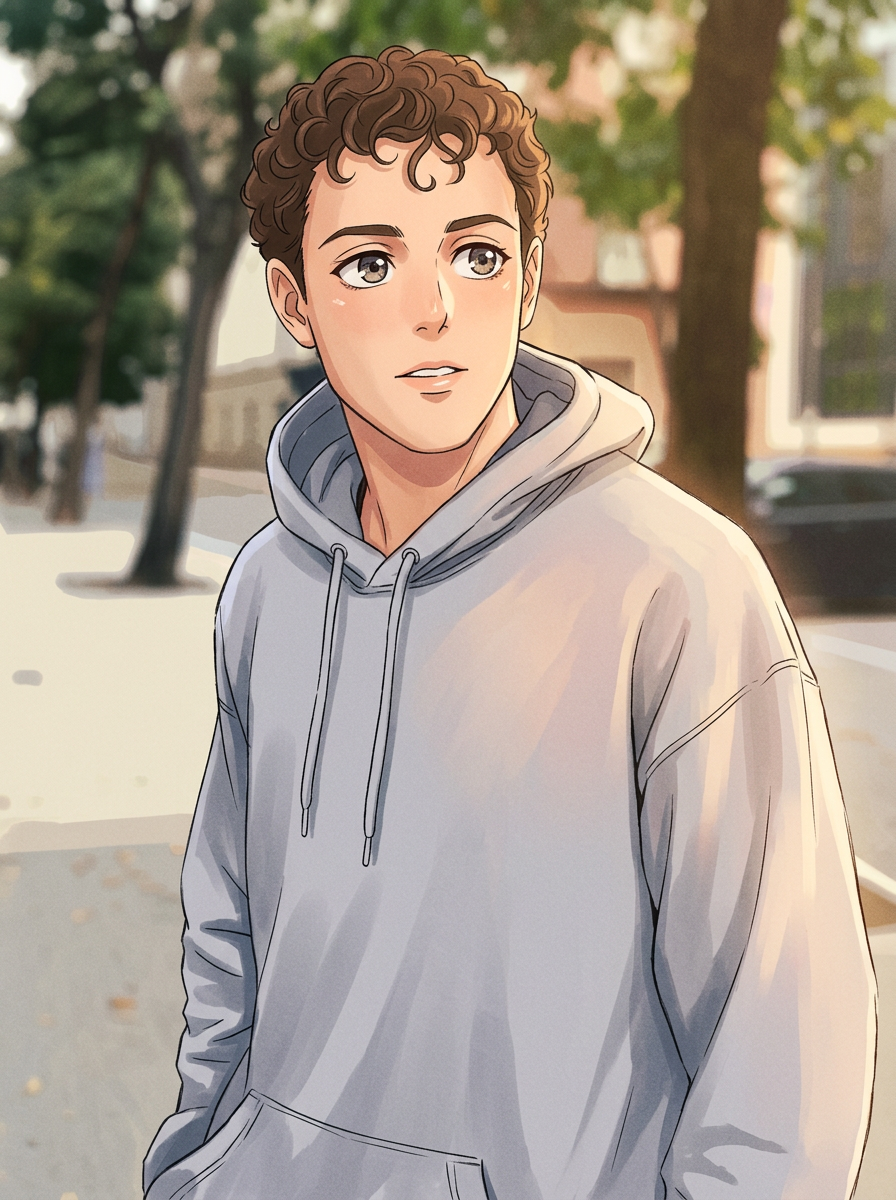
Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark
Pourquoi cela fonctionne : la majeure partie du texte de ce prompt porte sur la texture plutôt que sur le sujet — « cel-shading », « texture de pinceau visible », « halo lumineux » — car le sujet est déjà fixé par l'image de référence. Redessiner les yeux « selon les proportions anime » est le seul endroit où nous laissons volontairement le modèle s'écarter de la photo ; tout le reste (« même coiffure, pose et couleur de sweat à capuche ») est explicitement verrouillé, de sorte que le résultat reste reconnaissable comme la même personne, simplement illustrée.
Pour le reproduire :
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Convert this reference photo into a hand-painted Japanese anime film still: soft cel-shaded skin tones, clean thin ink linework on the face and hoodie folds, warm painterly lighting with visible brush texture, big expressive eyes redrawn in anime proportions while keeping the same hairstyle, pose, and hoodie color, soft blurred background rendered as flat anime-style color blocks with light bloom, subtle film grain, no text or watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Interrogez en boucle GET https://api.hiapi.ai/v1/tasks/{taskId} jusqu'à ce que status soit success, puis téléchargez output[0].url — ce lien est temporaire, enregistrez-le immédiatement à un emplacement permanent. Remplacez image_input par votre propre portrait et cette structure de prompt s'appliquera à tout sujet dont la pose et la coiffure sont nettes.
Recette 2 : Case de manga en noir et blanc
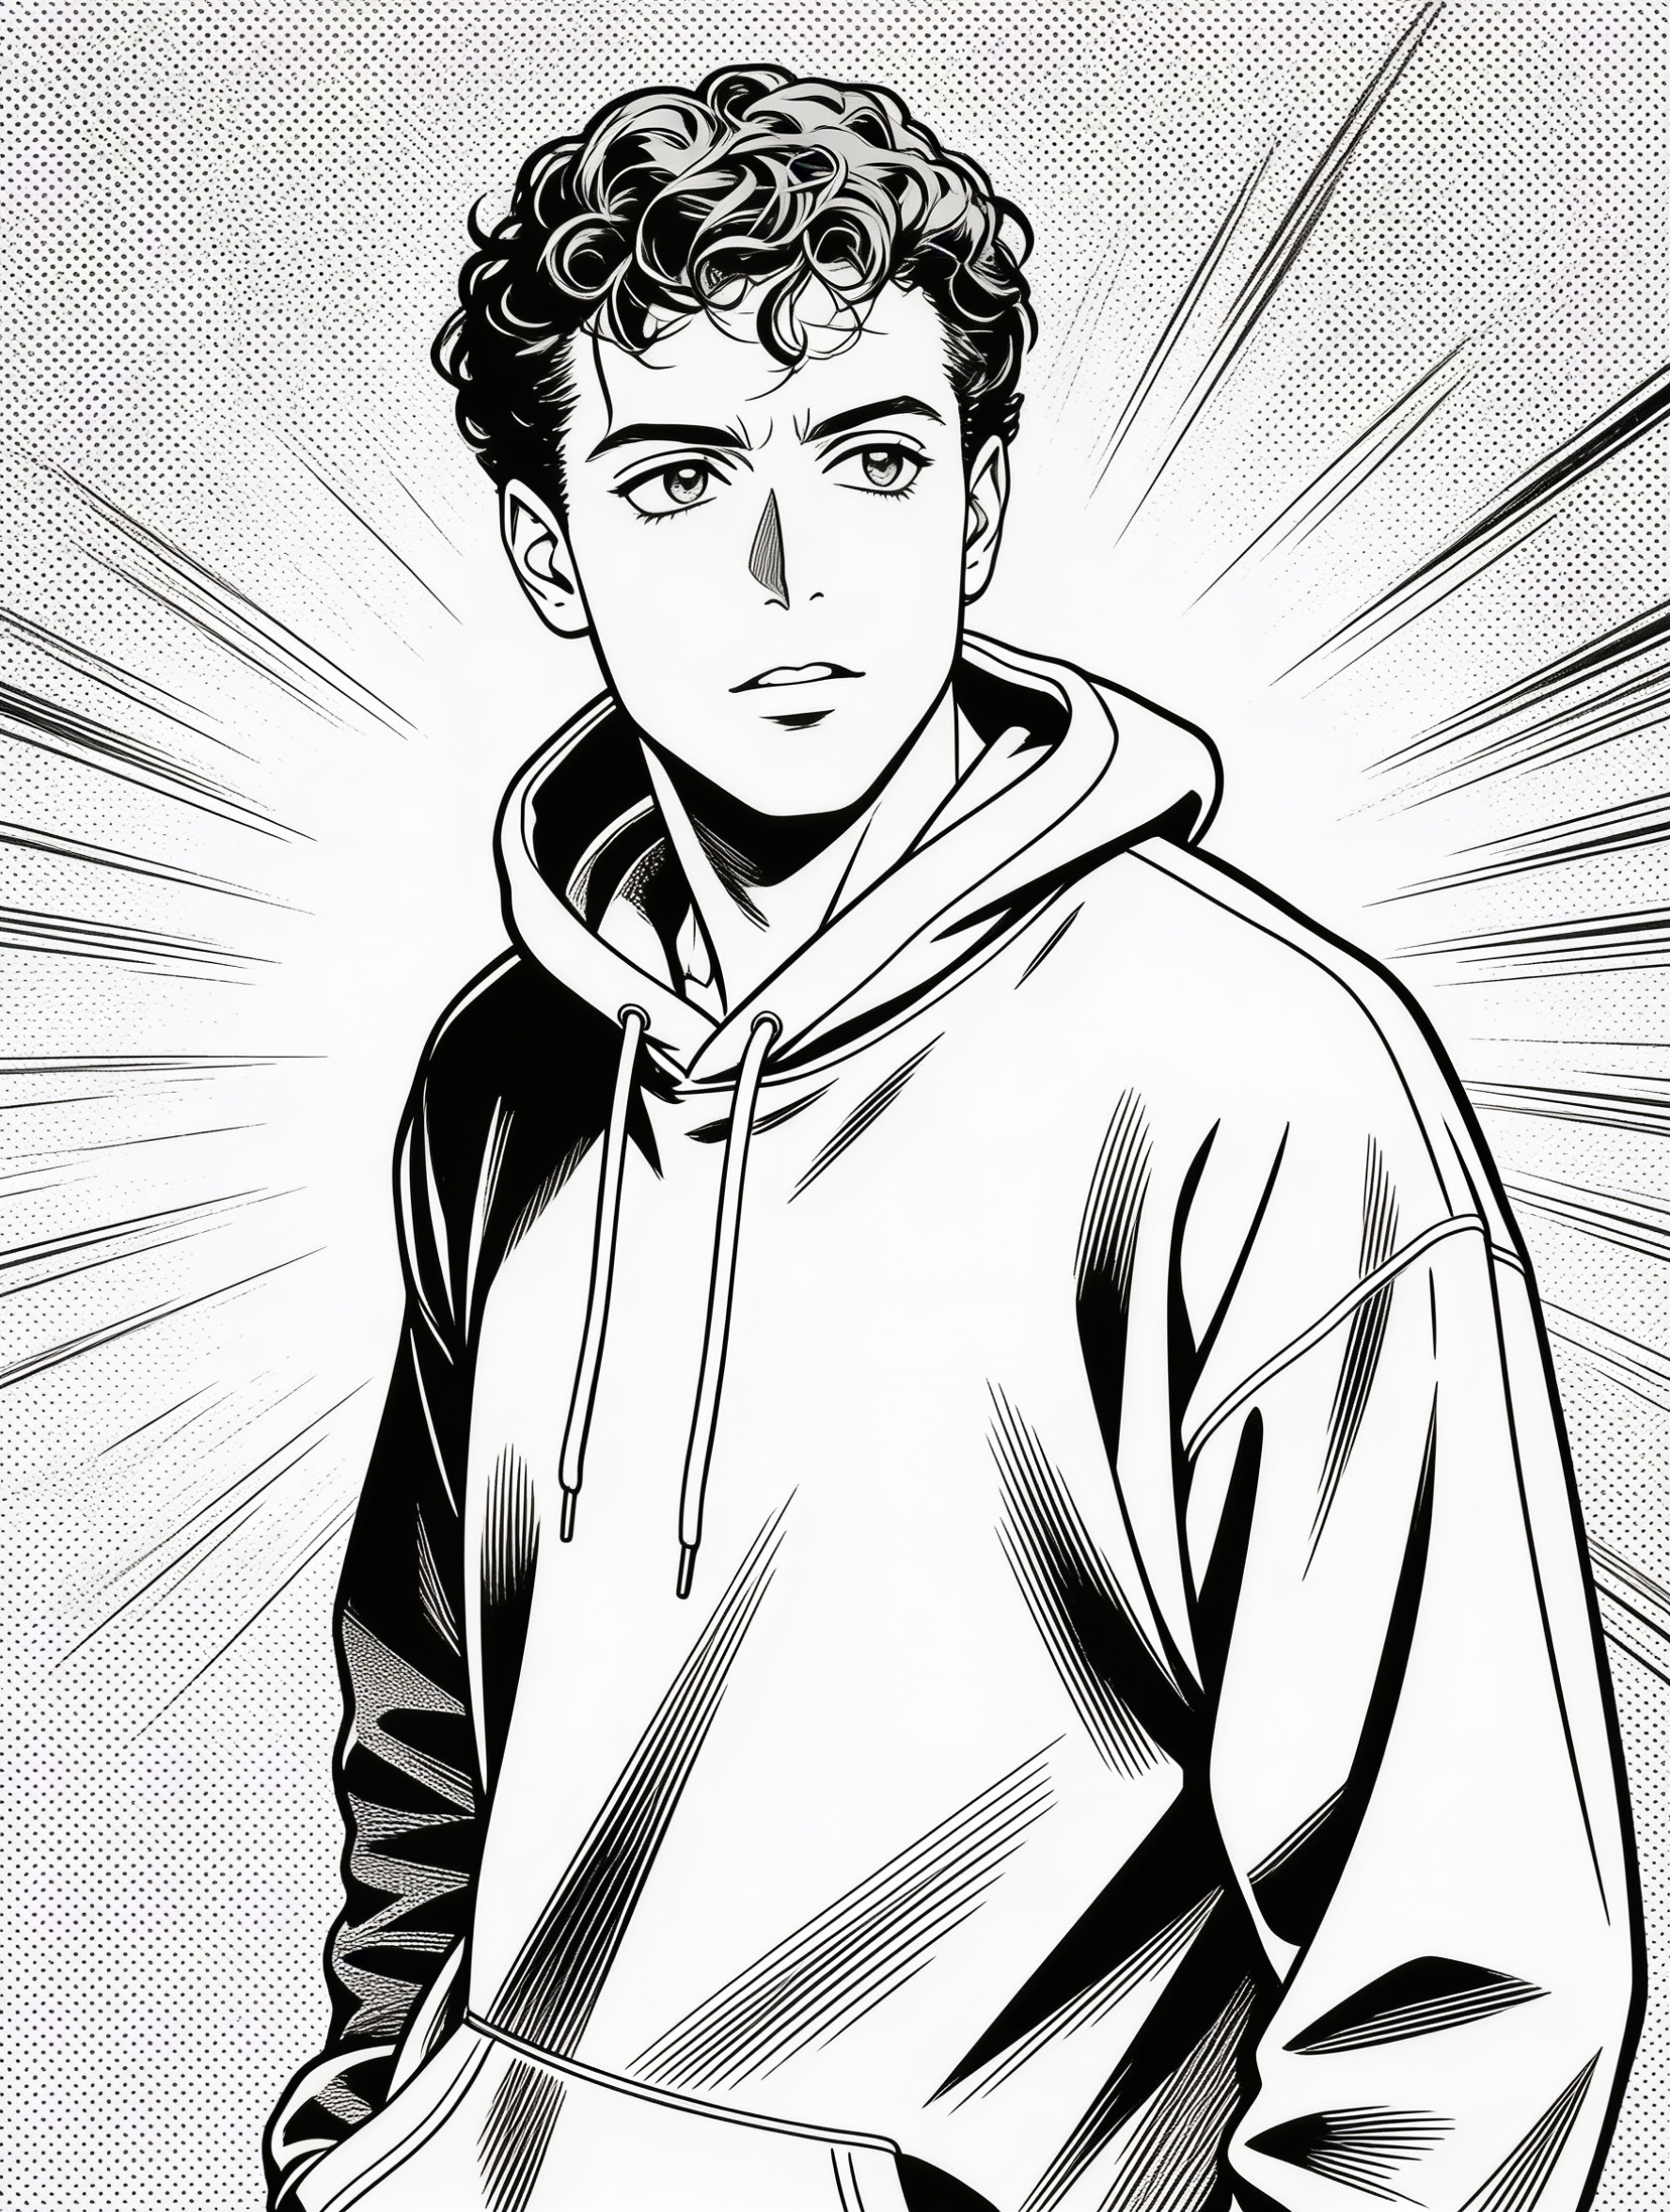
Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles
Pourquoi cela fonctionne : la réussite du style manga dépend de deux choses que ce prompt nomme directement — la trame (les ombrages pointillés que les vrais mangas utilisent à la place des dégradés) et l'épaisseur des traits (« traits à l'encre nets », « lignes faciales […] acérées »). Sans nommer explicitement la trame, les modèles i2i adoptent souvent par défaut un ombrage plat de type anime générique, plutôt qu'un effet de demi-teintes qui ressemble vraiment à du manga. « Pas de couleur, pas de texte, pas de bulles de dialogue » a été ajouté parce que les modèles entraînés sur des mangas génèrent parfois spontanément des cadres de case ou des dialogues si vous ne les excluez pas explicitement.
Pour le reproduire :
{
  "model": "seedream-4.5/image-to-image",
  "input": {
    "prompt": "Redraw this reference photo as a black-and-white manga panel: crisp ink linework, cross-hatched shading and screentone dot patterns for gradients, high-contrast highlights on the hoodie folds and hair, sharp manga-style eyes and facial linework while preserving the same pose, hairstyle, and expression, halftone-pattern background with a faint speed-line burst behind the subject, no color, no text, no speech bubbles",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "aspect_ratio": "3:4",
    "resolution": "2K"
  }
}
Même POST sur /v1/tasks et même mode d'interrogation que la recette 1 — seedream-4.5/image-to-image place simplement l'image de référence sous image_urls (pluriel, tableau) plutôt que image_input, et facture un tarif fixe de 0,045 $ quelle que soit la résolution.
Recette 3 : Fresque de graffiti à la bombe
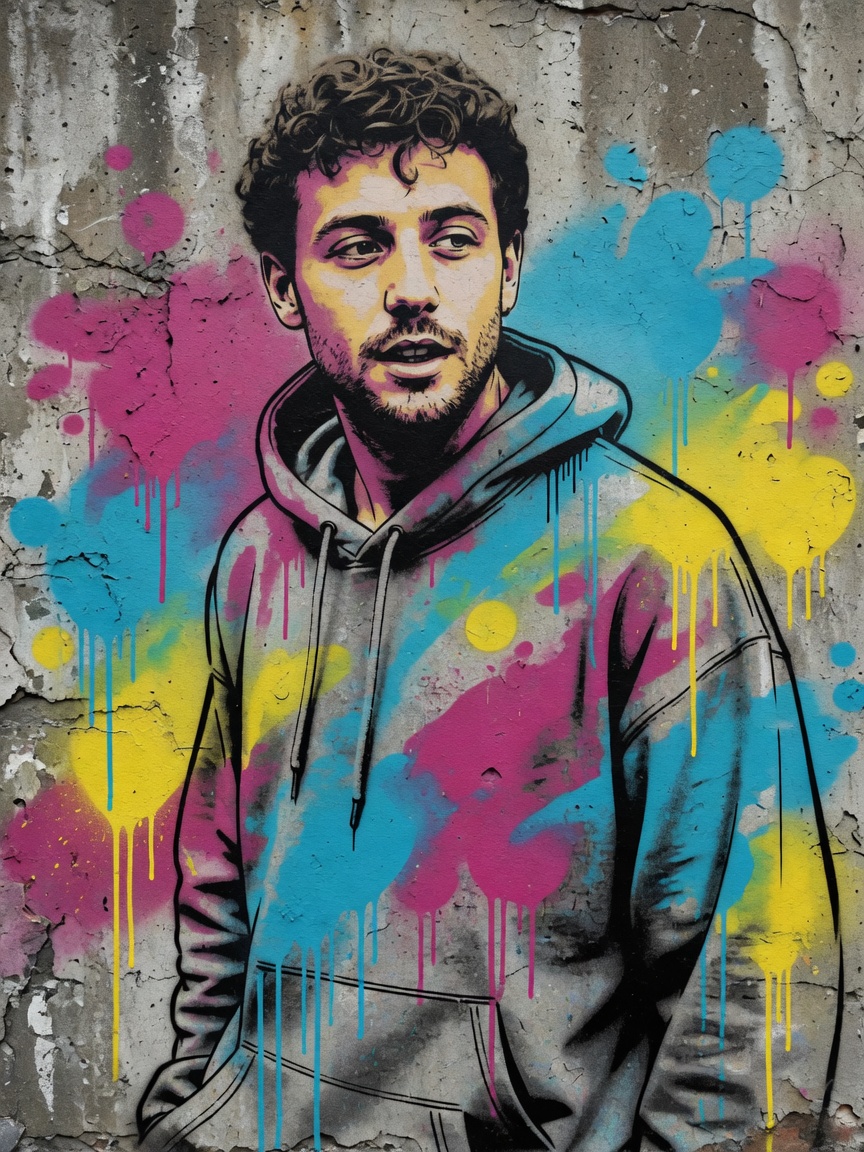
Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark
Pourquoi cela fonctionne : le graffiti est l'un des rares styles où nommer la technique (pochoir, coulures de peinture, contours épais) compte davantage que nommer le sujet. La liste de couleurs — « magenta, cyan et jaune » — joue aussi un rôle concret : si l'on laisse les couleurs libres, la plupart des modèles i2i adoptent par défaut des teintes troubles et désaturées, plutôt que les aplats saturés d'une vraie fresque à la bombe. Comme pour les trois autres recettes, « garder la même pose, coiffure et silhouette de sweat à capuche » est la clé pour empêcher la fresque de devenir un visage de street art générique.
Pour le reproduire :
{
  "model": "grok-imagine-quality/image-to-image",
  "input": {
    "prompt": "Reimagine this reference photo as a spray-painted graffiti mural portrait on a rough concrete wall: bold black outline strokes, flat saturated spray-paint color fills in magenta, cyan and yellow, visible spray texture and paint drips along the outline, subtle stencil-style highlights, keep the same pose, hairstyle, and hoodie shape as the reference, gritty urban wall texture and soft graffiti color splashes in the background, no text, no tags, no watermark",
    "image_urls": ["https://your-cdn.example.com/portrait.jpg"],
    "resolution": "1k"
  }
}
Notez le "1k" en minuscules ici — contrairement aux deux autres modèles ci-dessus, le schéma de Grok Imagine Quality est sensible à la casse pour la valeur de résolution. Ce point de terminaison n'a pas de champ aspect_ratio ; la composition de sortie suit votre image de référence.
Recette 4 : Portrait de carte de tarot
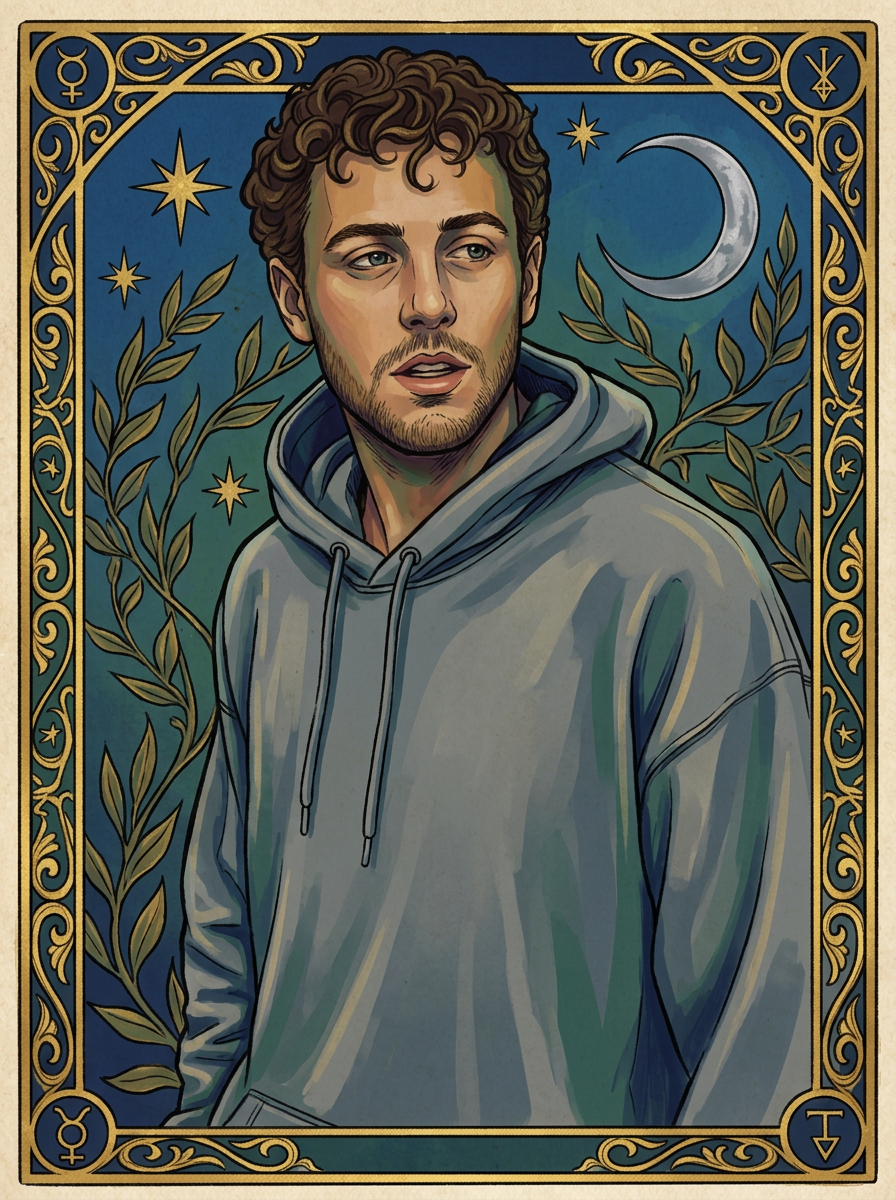
Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark
Pourquoi cela fonctionne : l'apparence d'une carte de tarot provient presque entièrement d'éléments de cadre sans rapport avec le sujet — la bordure en filigrane doré, les symboles mystiques en arrière-plan (étoiles, croissant de lune, branches de laurier). Nommer explicitement ces éléments est ce qui transforme un « portrait avec un ombrage ornemental » en « carte de tarot immédiatement reconnaissable ». Nous avons également exclu explicitement les chiffres et les noms de carte (« pas de texte, pas de nom de carte, pas de chiffres »), car les modèles entraînés sur de vraies cartes de tarot ajoutent des noms de carte factices s'ils ne sont pas exclus.
Pour le reproduire :
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Transform this reference photo into a hand-illustrated tarot card portrait: ornate gold filigree border framing the full image like a traditional tarot card, rich jewel-toned illustration style with flat decorative shading, mystical symbolic elements (stars, crescent moon, laurel vines) worked into the background behind the subject, keep the same pose, hairstyle and hoodie silhouette redrawn in painterly tarot-art linework, subtle aged-paper texture, no text, no card name, no numerals, no watermark",
      "image_input": ["https://your-cdn.example.com/portrait.jpg"],
      "aspect_ratio": "3:4",
      "resolution": "1K"
    }
  }'
Même modèle que la recette 1 (nano-banana-2), prompt différent — un bon rappel que, dans le transfert de style i2i, le choix du modèle importe moins que la précision du prompt sur ce qu'il faut conserver et ce qu'il faut réimaginer.
Questions fréquentes
Quel modèle est le meilleur pour un transfert de style photo vers anime ?
Parmi les trois modèles que nous avons testés, nano-banana-2 a préservé le plus régulièrement les traits identitaires (pose, coiffure, proportions) au fil des exécutions répétées, au prix de 0,085 $/image (1K). seedream-4.5/image-to-image est l'option la moins chère, à 0,045 $/image fixe, adaptée aux styles dominés par le trait comme le manga ; grok-imagine-quality/image-to-image s'apparente davantage à un redessin complet, adapté aux cas comme le graffiti où une certaine dérive du sujet fait partie du style.
Ces prompts nécessitent-ils une photo spécifique pour fonctionner ? Un portrait net de face ou de trois quarts, avec coiffure et vêtements visibles, donne les résultats les plus stables — c'est aussi l'hypothèse sous-jacente des quatre prompts ci-dessus lorsqu'ils parlent de « même pose, coiffure et sweat à capuche ». Un arrière-plan encombré ou un visage partiellement masqué rendent plus difficile pour le modèle de déterminer ce qu'il faut conserver.
Puis-je combiner ces prompts, par exemple un tarot de style anime ? Oui — remplacez le vocabulaire technique (cel-shading vs. trame vs. texture de bombe) tout en conservant le langage de cadre d'une autre recette (la bordure dorée et les symboles du tarot, ou la texture de mur du graffiti). Les deux moitiés de chaque prompt — conservation du sujet et technique de style — sont écrites de façon modulaire.
Pourquoi certains de ces prompts précisent-ils « pas de texte » ou « pas de filigrane » ? Les modèles entraînés sur de vraies images de films d'animation, pages de manga et cartes de tarot ont vu beaucoup d'exemples contenant du texte — génériques, onomatopées, noms de cartes — et en ajoutent parfois spontanément. Une exclusion explicite empêche cela d'emblée ; cela ne coûte rien dans le prompt et évite une génération gâchée.
La résolution influence-t-elle le prix de ces modèles ?
Cela dépend du modèle. Le tarif de nano-banana-2 et de seedream-4.5 varie effectivement selon la résolution sur certains points de terminaison, mais seedream-4.5/image-to-image facture précisément 0,045 $ fixe quelle que soit la résolution. Consultez toujours la page de tarification en temps réel de hiapi avant de budgétiser un lot — les tarifs varient selon le modèle et sont mis à jour indépendamment.
Points clés
- Chaque prompt ci-dessus se divise en deux moitiés : ce qu'il faut conserver (pose, coiffure, identité) et ce qu'il faut changer (style artistique, technique, composition) — écrivez clairement les deux, sinon le modèle fera silencieusement dériver le sujet vers quelque chose de générique.
- Nommer la technique plutôt que seulement le style visé donne des résultats plus précis : « motifs de points de trame » l'emporte sur « style manga », « reflets façon pochoir et coulures de bombe » l'emporte sur « style graffiti ».
- Excluez ce que le modèle a tendance à générer spontanément dans un style donné — texte factice, chiffres de carte, bulles de dialogue — même si vous pensez que ce n'est pas nécessaire.
grok-imagine-quality/image-to-imageutilise une valeur de résolution en minuscules ("1k", pas"1K") et n'a pas de champaspect_ratio; vérifiez le schéma de chaque modèle au lieu de supposer qu'il est identique à celui que vous avez utilisé auparavant.- Les quatre prompts sont des points de départ directement copiables-collables — remplacez l'image de référence via
image_inputouimage_urlset la même structure s'appliquera à différents sujets.
Vous voulez voir comment un seul modèle i2i gère plusieurs résolutions et nombres d'images de référence avant de choisir un modèle pour des tâches en lot ? Le tutoriel sur l'API Nano Banana 2 approfondit l'authentification, la structure des requêtes et la gestion des erreurs. Ou rendez-vous directement sur la page du modèle nano-banana-2 pour l'essayer avec votre propre photo de référence.
Articles similaires
Voir tous les articles →-

Inventaire
Alternatives à Hugging Face Inference API (2026) : une API unique pour appeler image/vidéo/audio/LLM
Modèle de tarification, étendue de la couverture des modèles, complexité d'intégration, compatibilité OpenAI : comprendre dans quels cas remplacer le routage agrégé par une API de génération unifiée
-

Inventaire
Comment choisir une alternative à RunPod : comparatif d'intégration des API d'image et de vidéo
RunPod est un cloud GPU, pas une API de génération — commencez par déterminer à quel niveau vous devez vous situer pour l'image et la vidéo.
-

Inventaire
Comment choisir une alternative à Modal : comparatif d'intégration des API d'image et de vidéo