
使用指南
PixVerse V6 图生视频提示词:4 套配方与真实片段
- 模型
- pixverse-v6
当你从文生视频切换到图生视频时,提示词的任务彻底变了。在文生视频中,你必须描述整个世界——主体、场景、镜头、光线——因为模型是从零开始构建镜头。而在图生视频中,那个世界已经存在:你的静态图就是第一帧。提示词唯一剩下的任务,是说明什么在动,以及摄影机如何运动。
这种转变让很多人栽了跟头。他们把一段丰富的场景描述提示词粘贴到 pixverse-v6/image-to-video,模型试图同时兼顾画面和文字,结果要么几乎不动,要么在对抗画面时发生扭曲。解决办法是写运动,而不是写景物。
以下是 hiapi 上 pixverse-v6/image-to-video 的四套可复制粘贴配方,每套围绕一种不同的运动类型:摄影机运动、主体动作、环境氛围,以及竖屏的、由画幅驱动的镜头。每套配方都展示了我生成的真实第一帧、我发送的确切请求体,以及它在实时 API 上产出的实际片段——没有库存素材,没有模拟图。
当第一帧固定后,什么变了
pixverse-v6/image-to-video 接受你的图像作为 image_url 并使其动起来。由此直接得出几点结论,它们塑造了本页的每一条提示词:
- 构图被锁定。你无法在提示词中重新构图主体或改变场景布置——那已经由图像决定了。要求不同的布局只会导致形变。请改为描述画面内部的运动。
- 没有
aspect_ratio字段。文生视频端点有这个字段;这个端点拒绝它。片段的画幅继承你输入图像的形状,所以如果你想要 9:16 竖屏结果,请在提交之前裁剪或生成竖屏帧(配方 4 正是这样做的)。 - 真正起作用的杠杆在运动侧。
prompt(运动)、duration(1–15 秒)、resolution(360p/540p/720p/1080p)、可选的generate_audio、negative_prompt、seed,以及一个style预设。完整的字段表在图生视频文档中;本页讲的是提示词。
下面的每个请求都是一次 POST /v1/tasks;然后你轮询任务,直到它返回片段 URL。如果你想要管道细节(curl + Python、轮询循环),模型页面里有。这里我们专注于你每次拍摄真正要调的字段:运动提示词。
配方 1 — 在锁定画面上做摄影机运动
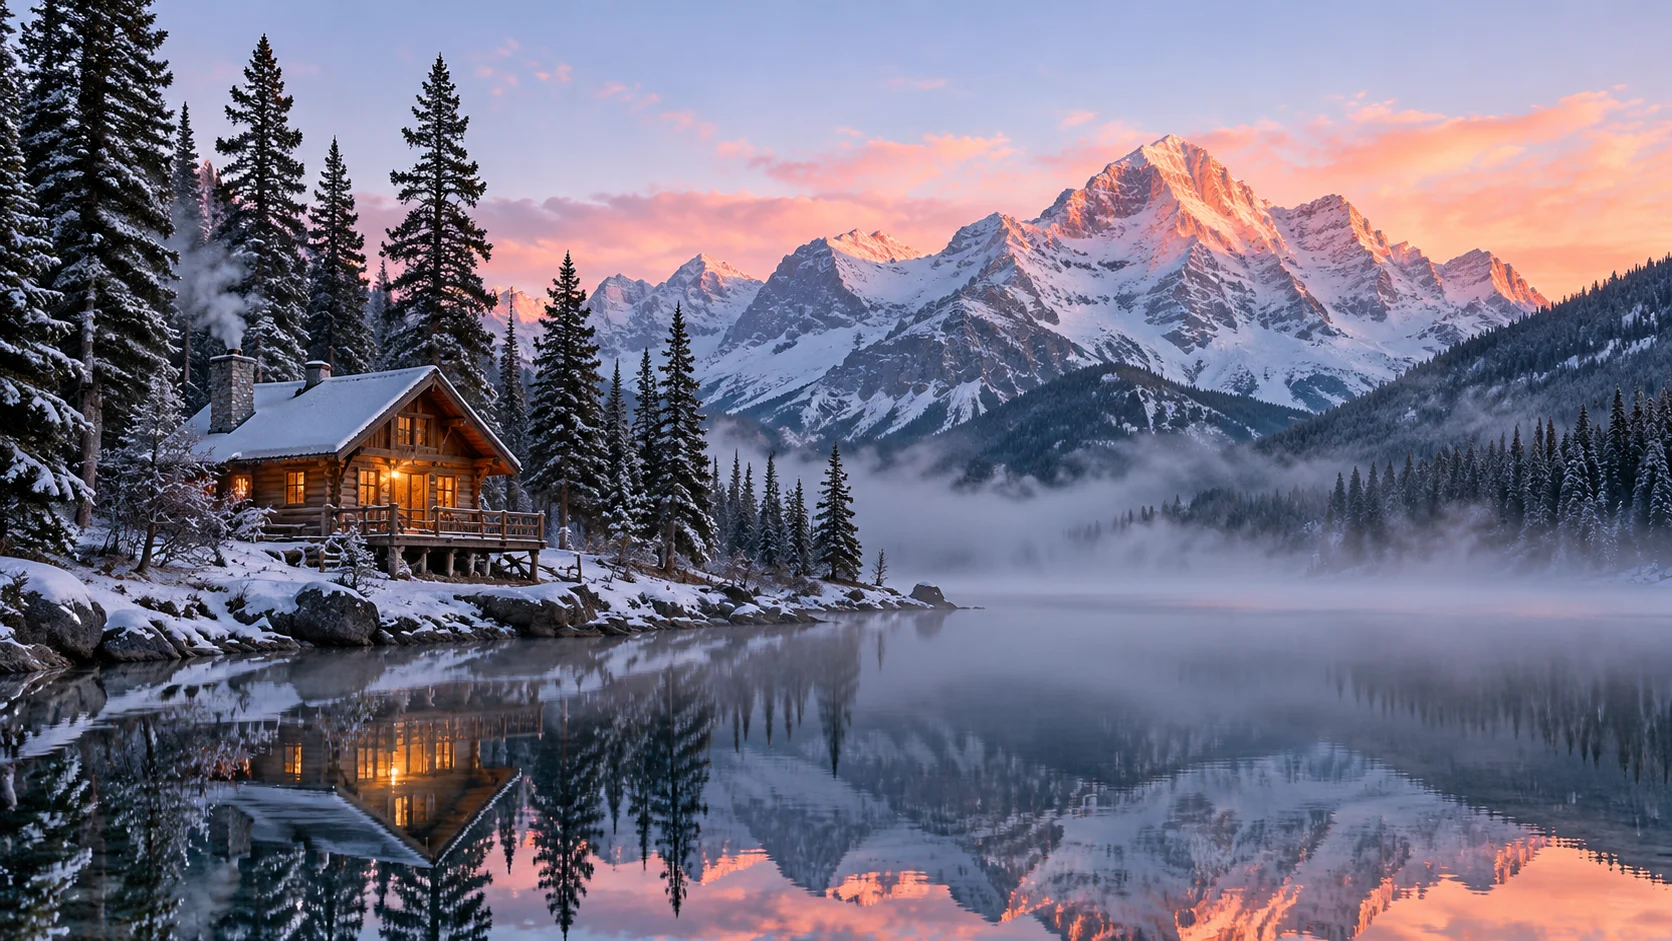
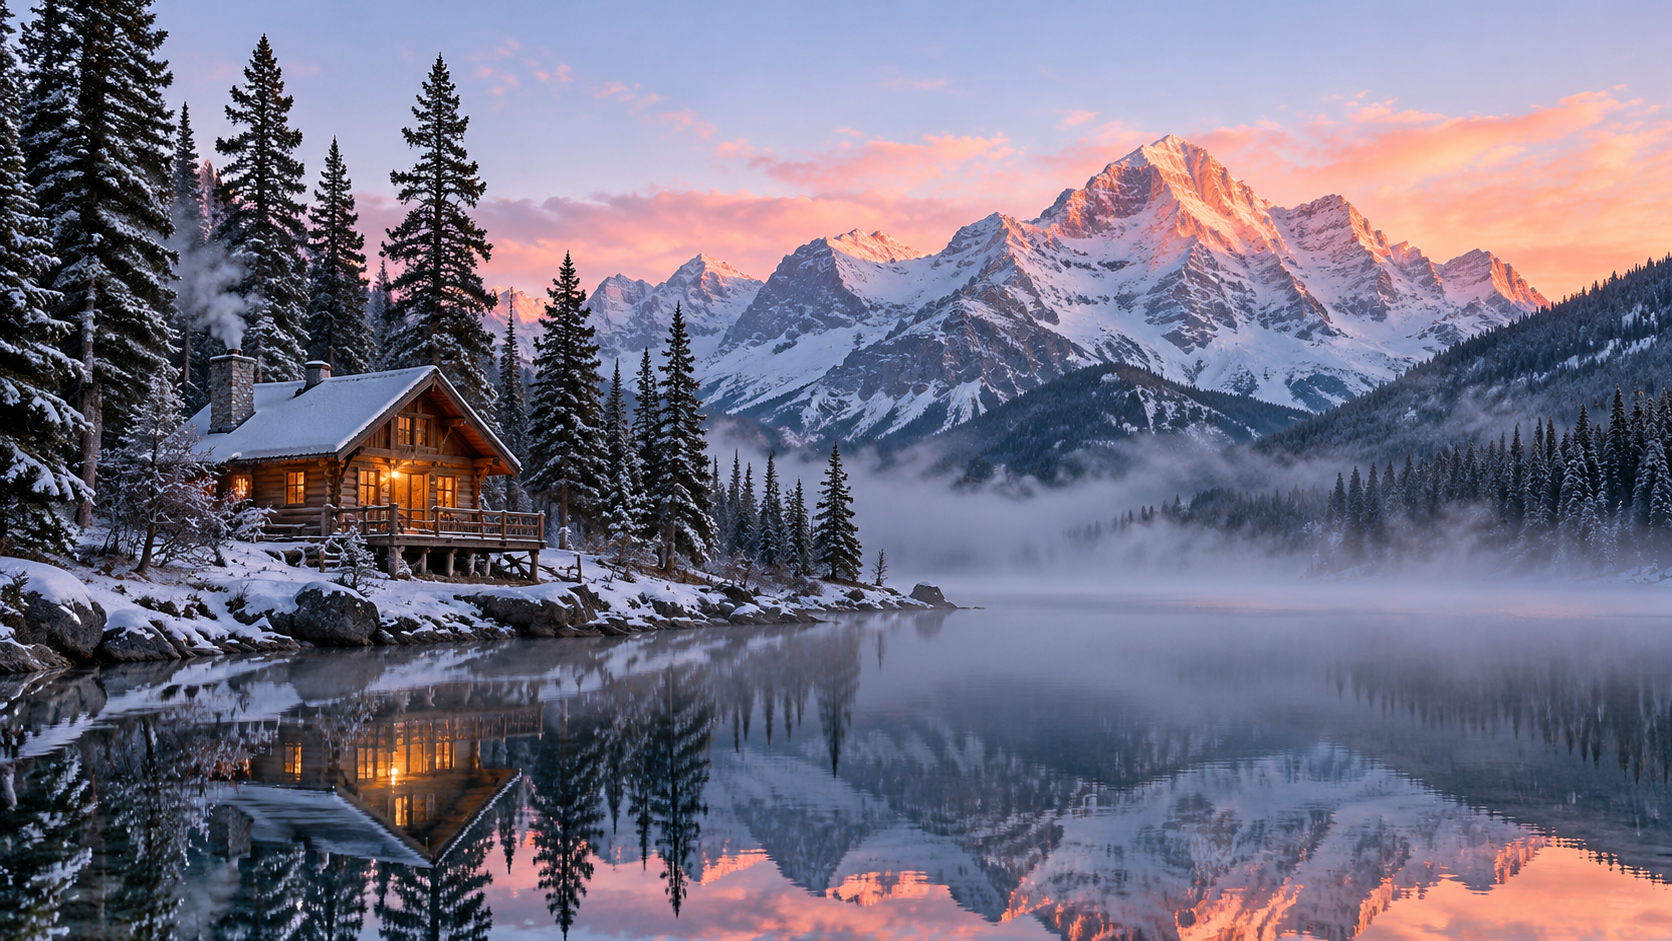
让一张风景静帧活起来最可靠的方式,是移动摄影机,而不是场景。选一个明确的运动——推近、缓慢移动、轻柔上升——平实地写出来,然后加上让它成立的小幅次要运动(飘动的薄雾、荡漾的水面)。在提示词中保持地平线「水平」可以防止模型在编造运动时倾斜画面。
{
  "model": "pixverse-v6/image-to-video",
  "input": {
    "image_url": "https://static.hiapi.ai/blog/pixverse-v6-image-to-video-prompt-recipes/01-cabin-pushin-frame.jpg",
    "prompt": "缓慢、平稳的电影式推近,朝向木屋。薄雾在湖面上低低飘动,水面轻轻荡漾。松树在微风中摇曳。不慌不忙的清晨运动;地平线始终保持水平。",
    "duration": 5,
    "resolution": "720p",
    "generate_audio": true,
    "negative_prompt": "摇镜头, 突然切换, 扭曲, 闪烁, 人"
  }
}
在片段中,摄影机平稳地向前滑行——到结尾时,木屋和雪光山峰在画面中明显变大——同时薄雾滑过水面,倒影保持稳定。地平线从未倾斜,而且因为 generate_audio 开着,文件返回时已经叠加了安静的环境声(你可以用 ffprobe 确认音轨)。
为什么有效:一个主导的摄影机动词(「推近」)、两个安静的环境运动,以及一条稳定性指令。generate_audio: true 在同一次调用中叠加匹配的环境音——无需单独的音频步骤。
配方 2 — 让已经存在的主体动起来
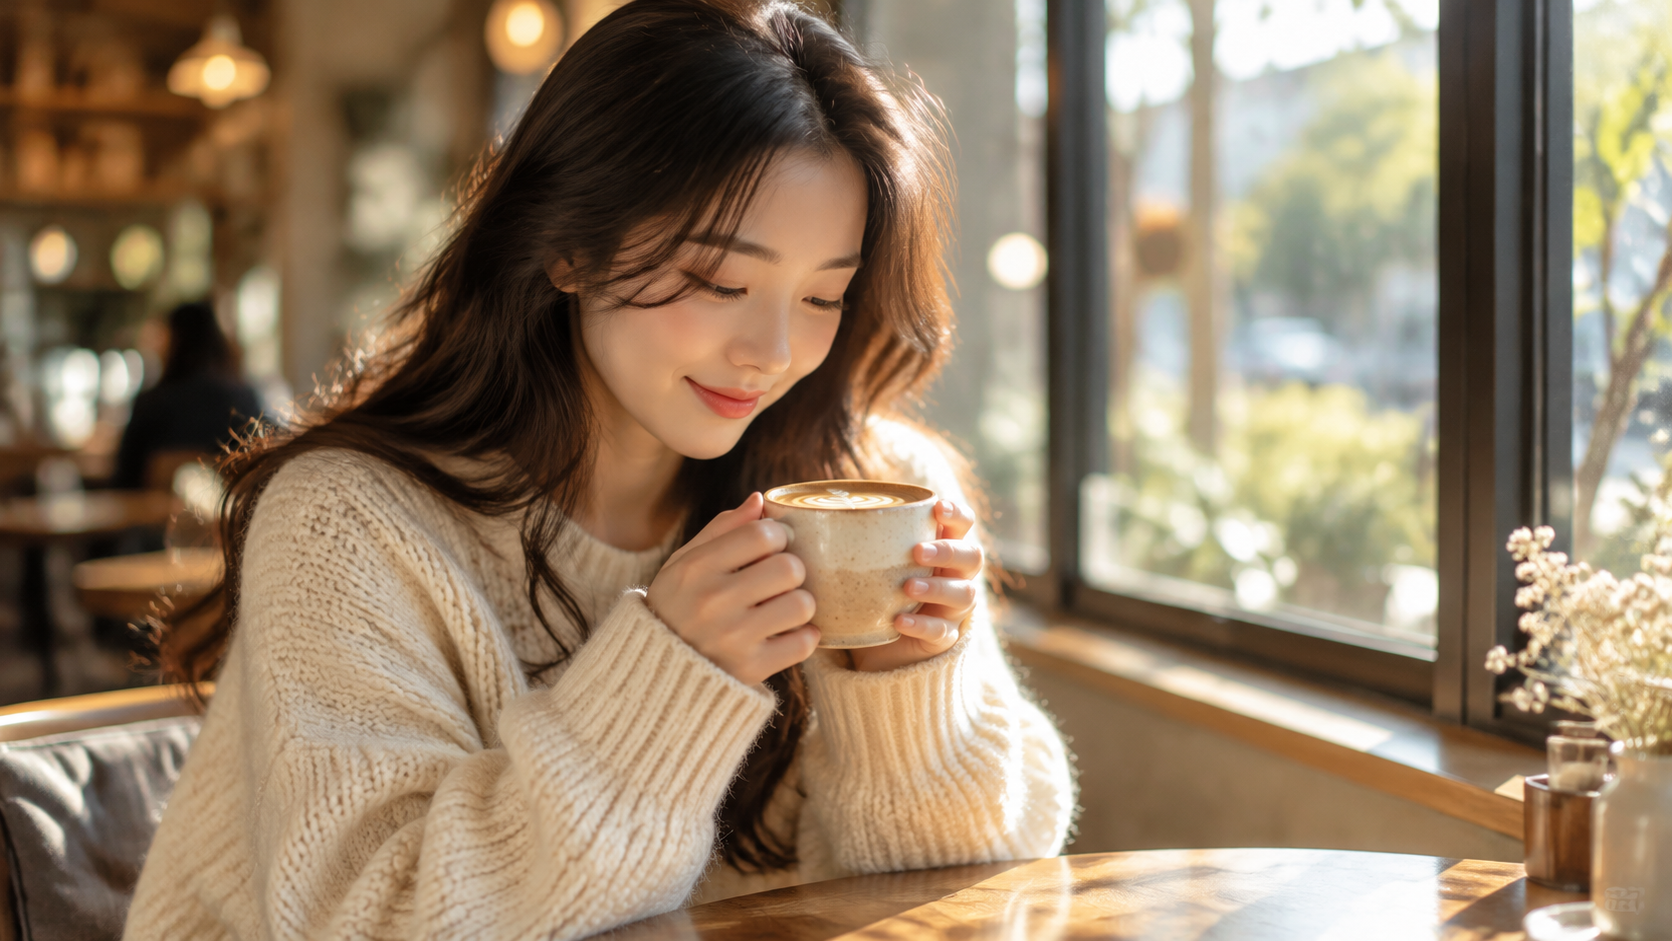
当人物或产品是焦点时,诀窍是只要求当前姿势能合理达到的运动。我们的主体正拿着杯子低头看,所以「举起杯子、抿一口、抬头、微笑」是一个自然的弧线。过度要求(「她站起来走开」)正是产生融脸和多手指的原因——所以这是 negative_prompt 发挥价值的配方。
{
  "model": "pixverse-v6/image-to-video",
  "input": {
    "image_url": "https://static.hiapi.ai/blog/pixverse-v6-image-to-video-prompt-recipes/02-cafe-sip-frame.jpg",
    "prompt": "女人缓慢举起杯子,抿一小口,然后抬起眼睛看向镜头,露出温柔自然的微笑。一个细微的眨眼和头部轻微倾斜;杯子上飘着淡淡的蒸汽。背景保持静止。",
    "duration": 5,
    "resolution": "720p",
    "negative_prompt": "面部扭曲, 手部变形, 多余手指, 五官形变, 扭曲, 闪烁"
  }
}
结果按顺序遵循这些节拍:她举起杯子,到结尾时她的眼睛已经从杯子抬到镜头,并落定为一个轻松的微笑。整个运动过程中面部和手部保持干净——在人物主体上,这正是加载的 negative_prompt 为你换来的。
为什么有效:运动与姿势匹配,节拍有先后(「举起……抿……抬起……微笑」),而且 negative_prompt 加载了人物图生视频的具体失败模式——脸和手。
配方 3 — 固定摄影机的环境运动
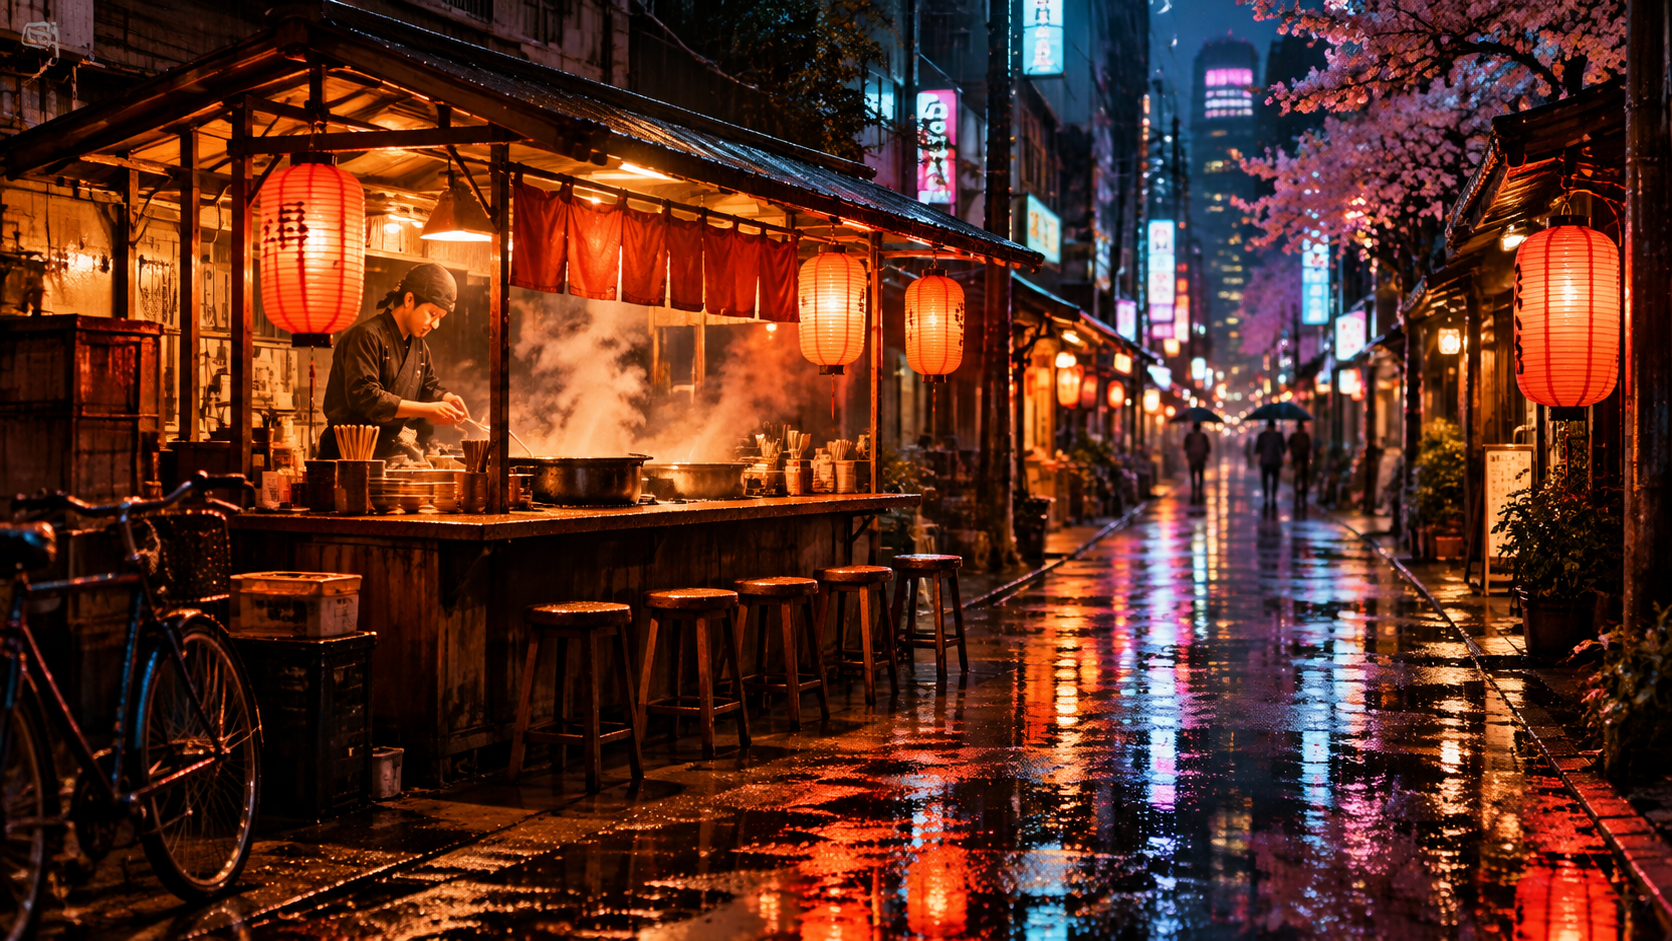
不是每个片段都需要摄影机运动。有时最具电影感的结果是一个保持不动的镜头,只有世界在动:雨、蒸汽、闪烁的霓虹、一个路人。这里的关键短语是明确告诉摄影机原地不动——否则模型常常会加上你没要求的缓慢漂移。
{
  "model": "pixverse-v6/image-to-video",
  "input": {
    "image_url": "https://static.hiapi.ai/blog/pixverse-v6-image-to-video-prompt-recipes/03-ramen-rain-frame.jpg",
    "prompt": "摄影机固定不动,完全没有任何移动。细雨以细密的条纹持续落下;霓虹招牌在湿漉漉的地面上闪烁微光;蒸汽从拉面锅里卷起;一两个行人在远处背景的伞下缓缓走过。",
    "duration": 5,
    "resolution": "720p",
    "generate_audio": true,
    "negative_prompt": "摄影机抖动, 变焦, 摇摄, 移动镜头, 扭曲, 招牌融化"
  }
}
画面从头到尾保持原位——摊位、凳子和延伸的街道都停在原处——同时蒸汽从锅里翻滚而出,湿漉漉的地面闪烁着霓虹倒影,伞下的身影沿着背景移动。没有缓慢的变焦,没有漂移。开着音频时,返回的片段带有匹配的雨街环境音。
为什么有效:「固定不动,完全没有任何移动」加上负向提示词中的 摄影机抖动, 变焦, 摇摄, 移动镜头 钉住了摄影机,所以所有运动预算都投入到了氛围中。开着音频则为你配上雨声和街道环境音。
配方 4 — 从竖屏帧输出竖屏视频
这套配方钉住了图生视频最核心的一条规则:几何形状来自你的图像。因为没有 aspect_ratio 旋钮,获得 9:16 竖屏片段的唯一方式是输入 9:16 的帧——所以这张静帧是按竖屏生成的。我还在这一个上传递了 style: anime,以测试该预设(anime、3d_animation、clay、comic、cyberpunk)是否会重新换肤一张已经照片级写实的帧。答案很有启发性——见下文。
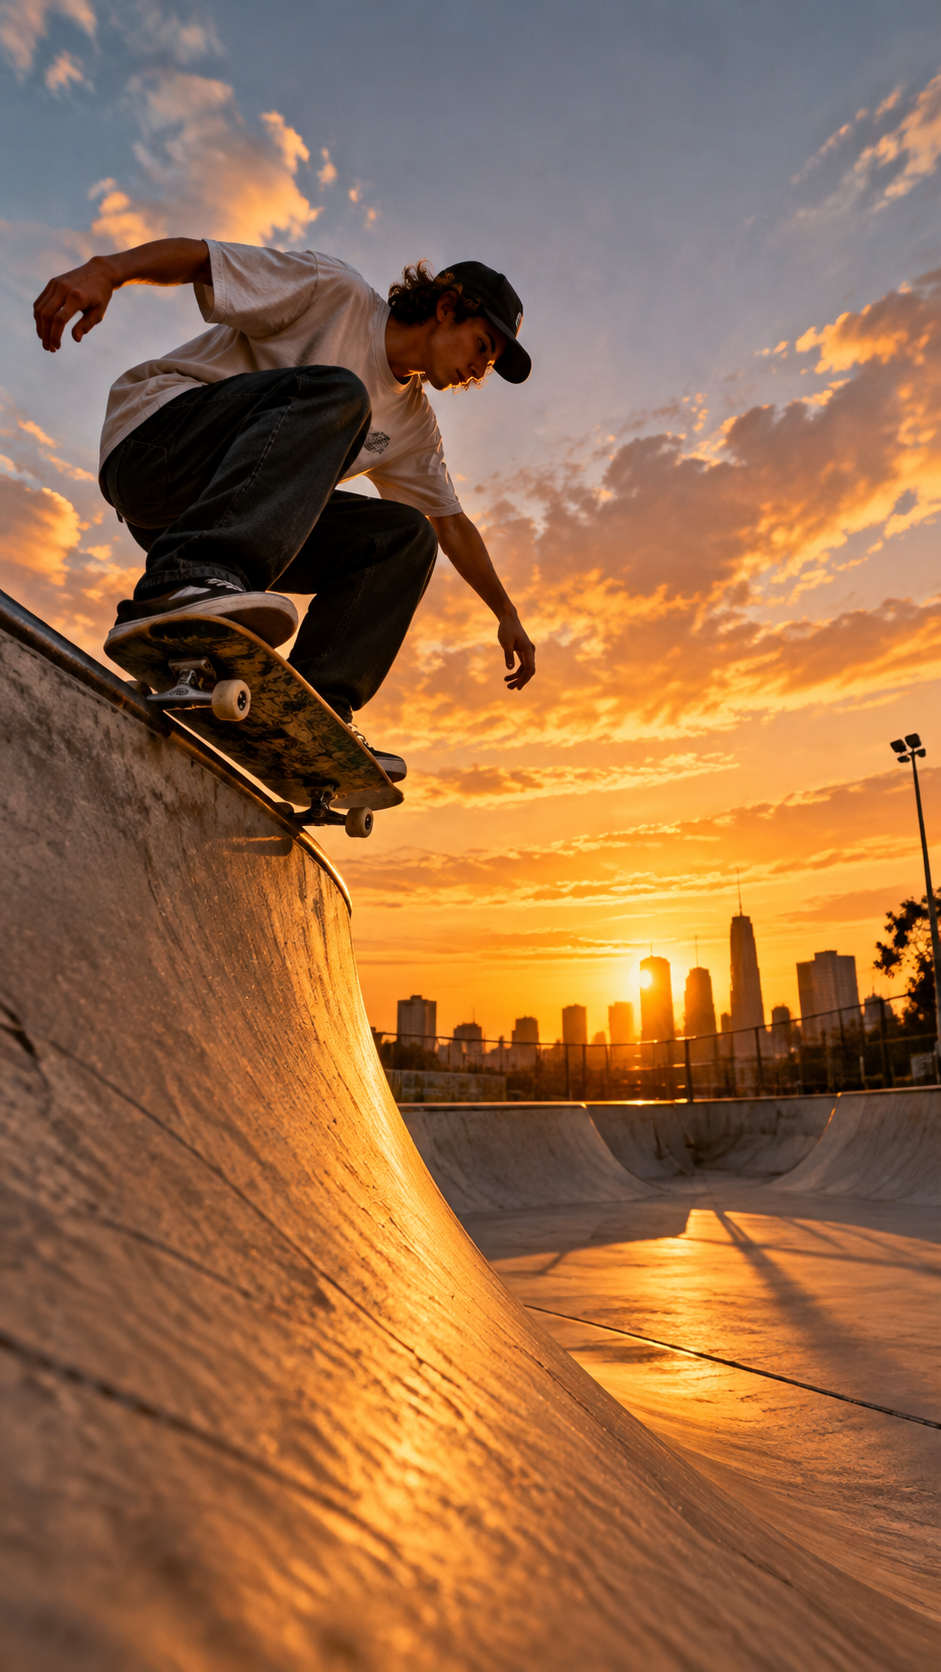
{
  "model": "pixverse-v6/image-to-video",
  "input": {
    "image_url": "https://static.hiapi.ai/blog/pixverse-v6-image-to-video-prompt-recipes/04-skate-vertical-frame.jpg",
    "prompt": "滑板者俯冲而下,以快速自信的动作沿坡道滑行;滑板扬起一点灰尘,夹克和头发在风中翻飞。充满活力、动感十足的动作,保持在稳定的竖屏画面中。",
    "duration": 5,
    "resolution": "720p",
    "style": "anime",
    "negative_prompt": "模糊, 肢体扭曲, 扭曲, 低能量, 信箱黑边"
  }
}
片段返回的是 720×1280——竖屏——直接来自竖屏帧,请求中任何地方都没有 aspect_ratio 字段。俯冲和滑行看起来快速干净,滑板和坡道墙上有自然的运动模糊。不过 style: anime 预设没有可见效果——结果保持完全照片级写实,跟随输入图像的外观,而不是转换为动漫。在图生视频中,第一帧锚定了外观。
从中可以学到:竖屏帧强制产生竖屏片段,完全不需要 aspect_ratio 字段,而「稳定的竖屏画面」加上负向提示词中的 信箱黑边 使它保持满屏铺满,而不是左右留黑边。不要依赖 style 在这里转换照片级写实的帧——如果你想要动漫或黏土动画外观,请在动画化之前先生成那种风格的第一帧。
微调
一旦某套配方接近目标,以下是能推动结果的旋钮:
duration——整数,1–15秒(默认5)。更长的片段成本按比例更高,也给模型更多漂移空间,所以让演示短而紧凑。negative_prompt——你的主要伪影刹车。对于人物,列出脸/手;对于固定镜头,列出摄影机运动;对于风格化镜头,列出信箱黑边。seed——传递一个整数使外观可复现,然后只改提示词来迭代。resolution+generate_audio——这两个决定价格。在 720p 下,片段静音为 $0.0645/秒,带声音为 $0.086/秒;1080p 为 $0.129/秒 / $0.1645/秒。一个 5 秒 720p 带音频的片段约 $0.43。每个档位的当前每秒费率在定价页面上。
常见问题
为什么 pixverse-v6/image-to-video 没有 aspect_ratio 字段?
因为你提供第一帧,输出几何形状跟随那张图像。没有比例可选——片段出来的形状与你的 image_url 相同。要获得竖屏结果,请先将帧裁剪或生成为 9:16(配方 4)。
图生视频片段可以多长?
duration 接受 1 到 15 秒的整数,默认 5。它必须是数字,不是字符串。
我可以在同一次调用中获得声音吗?
可以。设置 generate_audio: true,模型会为片段添加匹配的配乐/环境音——无需单独请求。默认关闭,开启后会进入「带声音」价格档。
我的主体脸部或手部扭曲。怎么修复?
两个杠杆。第一,只要求起始姿势能达到的运动——小而合理的动作动画干净;大的动作(站起、走开)容易形变。第二,在 negative_prompt 中加载具体的失败术语:面部扭曲, 手部变形, 多余手指, 五官形变。
style 预设会重新风格化我的输入图像吗?
在图生视频中别指望它。当我发送一张照片级写实的帧并设置 style: anime 时,片段返回的是照片级写实——输入图像主导了外观,预设没有可见效果。如果你需要特定风格(动漫、黏土、漫画),可靠的做法是在动画化之前先生成或编辑你的第一帧为那种风格。
这与文生视频提示词有什么不同? 在文生视频中你用文字构建整个场景;在图生视频中场景由你的帧固定,你只描述运动和摄影机。如果你想从文字描述而非静帧生成运动,那是 pixverse-v6/text-to-video。
要点
- 写运动,而不是景物——第一帧已经包含场景,所以把提示词花在什么在动以及摄影机如何运动上。
- 没有
aspect_ratio:片段继承你帧的形状,所以通过选择输入图像来设定竖屏/横屏。 - 让运动匹配姿势,并利用
negative_prompt——这是干净的主体动画与扭曲脸之间的区别。 generate_audio和resolution是决定你价格的两个字段;一个 5 秒 720p 片段远低于一美元。
选择最接近你镜头的配方,换上你自己的 image_url,然后发送到 pixverse-v6/image-to-video。如果你是从文字想法而非静帧开始,请从模型目录开始并选择文生视频线。


