
教程
Seedance 2.0 Ext 首帧视频提示词:锚定与插值
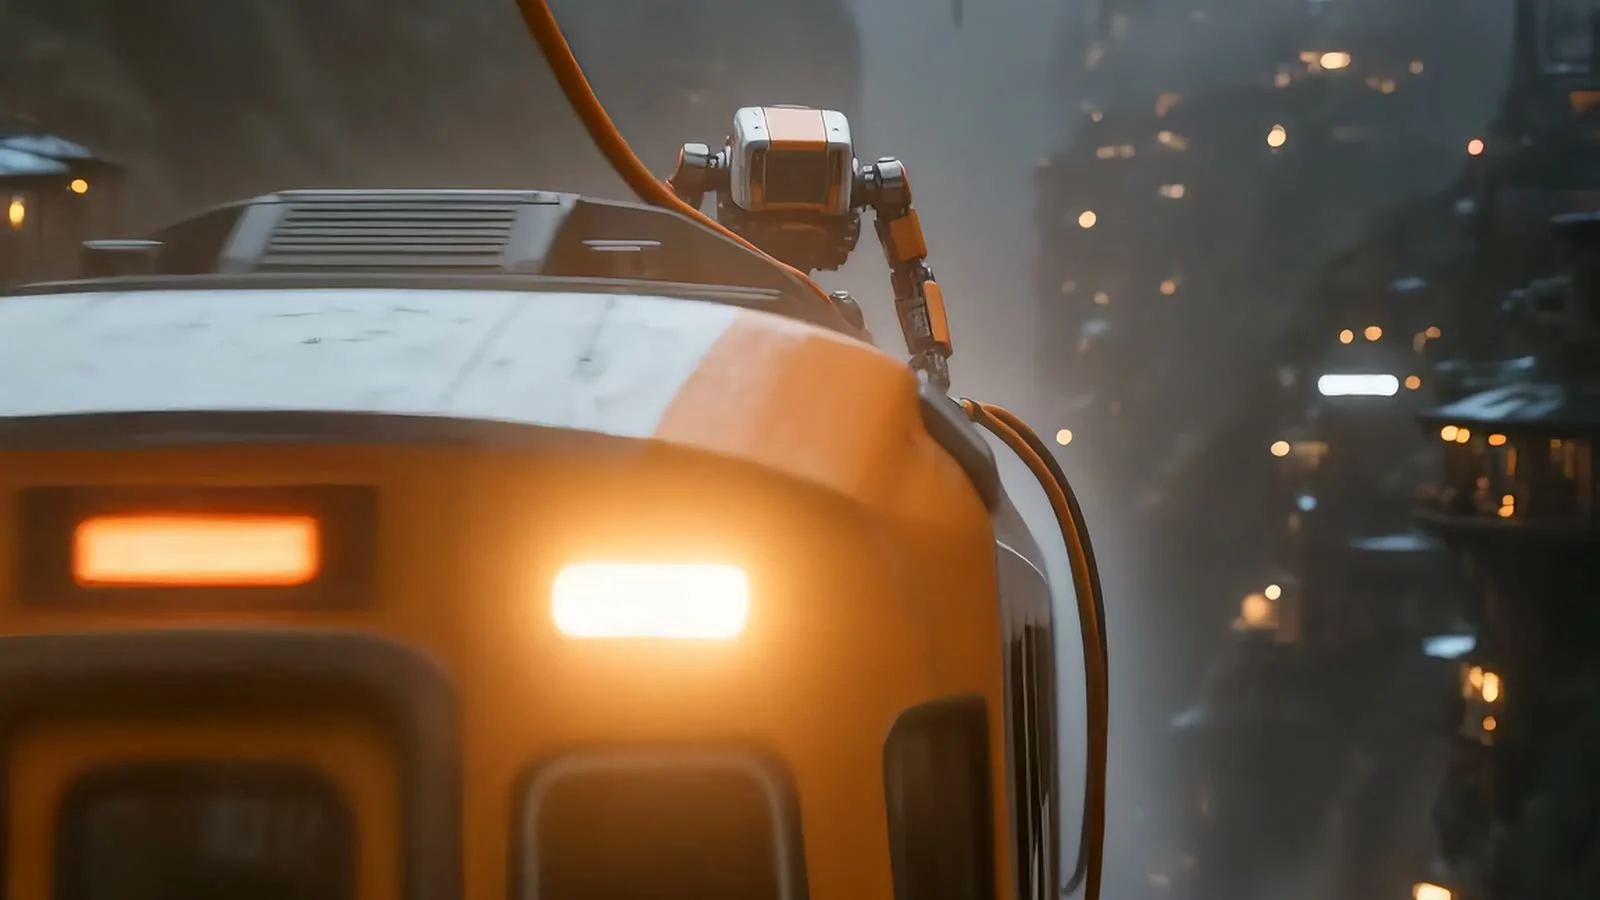
大多数人在为一段连续叙事视频片段编写提示词时,都会遇到同一种失败模式:开场帧符合预期,但到第 8 秒时模型已经跑偏——机器人的比例变了、雾气颜色变了、镜头运动没有落到故事需要的位置。Seedance 2.0 Ext 用两种不同的锚定策略解决了这个问题,而为你的用例选错策略,就是一段干净的 12 秒镜头和三次白费的重新生成之间的差别。
下面两种技术都来自同一个叙事世界——一座被雨水浸透的山城、一列橙白相间的单轨列车,以及一台正在修复受损车顶连接器的小型维护机器人——并且运行在完全相同的模型 seedance-2.0@ext 上。唯一变化的是你锚定哪些帧。
同一个故事,两种不同的提示词策略
首帧锚定给模型一个固定的起点(一张参考图),让它即兴发挥之后的一切——镜头运动、节奏,以及镜头最终落在哪里。首尾帧插值给它两个固定点,起点和终点,由模型在两者之间填充一条连续路径。下面两个片段中的提示词、声音设计和主体连续性几乎完全相同;不同的只是控制机制。
技术 1:首帧硬锚定
这个片段只锚定开场帧,然后让镜头自由地完成一个不间断的跟踪镜头——从轨道高度,到车顶高度,再到拉远揭示整座城市。
将提供的图像作为精确的首帧和硬性视觉锚点:保留同一台原有的橙白相间维护机器人、同一座雨中山城、同样的单轨几何结构、湿润的轨道材质、琥珀色列车灯光和蓝色雾气。12 秒竖屏电影感动作短片,一个不间断的连续跟踪镜头,无剪切。0-3 秒:从提供的精确帧开始;镜头位于被雨水浸透的铁轨上方几英寸处,然后向前并略微向上加速冲向车顶。水坑因轨道振动而泛起涟漪,雨水自然地打在镜头上。3-7 秒:沿移动的单轨车顶旁跟拍;小型维护机器人迎风站稳,将松脱的沉重橙色高压电缆拉向受损的车顶连接器。展现真实的电缆重量、张力、金属摩擦、车轮振动和水花。7-10 秒:一道短暂的蓝色电弧噼啪闪过间隙;机器人将电缆锁定到位。列车灯光闪烁一次,然后重新亮起,在积水的轨道上投下温暖的反光。10-12 秒:镜头升起并拉远,修复后的单轨列车穿过雨雾驶过高架桥,展现层叠的山城;结尾是机器人逆着恢复的灯光形成的剪影,以及远处一道闪电。声音:近处雨滴撞击声、湿润轨道振动声、低沉的电流嗡鸣、清脆的电缆锁定咔哒声、一次受控的电力涌流、远处雷声。无对白、无屏幕文字、无标志、无动漫风格、无扭曲的列车几何结构、无额外机器人、无多余肢体、无跳切。
这段提示词靠三件事支撑:
- “硬性视觉锚点”加上明确的主体清单。 在任何动作开始之前就点名机器人、城市、单轨几何结构、轨道材质和灯光颜色,迫使模型从第零帧起就锁定这些特征,而不是等镜头开始运动后任由它们漂移。
- 带时间戳的节拍(0-3 秒、3-7 秒、7-10 秒、10-12 秒)。 每个节拍描述一个机位和一个物理动作——加速、跟拍、电弧并锁定、拉远。Seedance 2.0 Ext 遵循带时间的节拍,比遵循一整段未分段的动作描述要可靠得多。
- 针对该模型实际失败模式的负面清单,而不是泛泛而谈:扭曲的列车几何结构和多余肢体,正是“机器人站在移动车辆上”这类镜头出错时出现的特定伪影,所以直接点名可以抑制它们。
技术 2:首尾帧插值
这个片段讲述的故事几乎相同,但它也锁定了结尾构图——当最终帧需要匹配某个特定内容时很有用,比如过渡到下一个镜头,或者一个精确的主体构图。
创建一段连续的 12 秒竖屏电影感镜头,严格在提供的首帧和提供的尾帧之间进行插值。第一张图像是精确的开场状态;第二张图像是精确的最终状态。全程保留同一列橙白相间的单轨列车、原有的橙色维护机器人、修复后的橙色车顶电缆、雨中山城、湿润的轨道材质、琥珀色灯光和蓝色雾气。0-3 秒:从首帧的轨道高度视角开始,沿湿润的轨道向前加速冲向车顶。3-7 秒:在车顶旁跟拍,机器人迎风站稳,将沉重的橙色电缆拉向受损的车顶连接器;展现自然的电缆张力、金属摩擦、雨水和水花。7-9 秒:短暂的蓝色电弧,电缆锁定到位,列车灯光闪烁后稳定下来。9-12 秒:镜头平稳地移动到列车后方和上方,直到精确达到提供的尾帧构图:列车完整的后部正在远去,两条平行的湿润钢轨从前景中列车下方清晰可见地连续延伸,穿过铁路高架桥并在桥后汇聚。最后一段绝不要展示列车前部。保持铁路几何结构在物理上连贯,并且每一刻轨道连续性都清晰可见。声音:雨滴撞击声、湿润轨道振动声、低沉的电流嗡鸣、电缆锁定咔哒声、受控的电力涌流、远处雷声。无对白、无文字、无标志、无动漫、无公路桥、无无轨站台、无缺失轨道、无额外机器人、无多余肢体、无跳切。
与技巧 1 相比,变化之处在于:
- “严格在提供的首帧和提供的尾帧之间进行插值”在开头第一句就说明。这是告诉模型它有一个固定终点的指令,而不只是固定起点——提示词的其余部分描述连接两者的路径。
- 结尾被刻意过度指定:“列车完整的后部正在远去”“两条平行的湿润钢轨清晰连续”“最后一段绝不要展示列车前部”。当你钉住一个结束帧时,对最终构图的模糊措辞正是插值漂移的地方——解决办法是用与开场节拍同样多的几何细节来描述最后 2-3 秒。
- 针对结尾镜头的新负面词——“无公路桥、无无轨站台、无缺失轨道”——因为镜头朝后四分之三视角移动,正是这个模型容易丢失轨道连续性的地方。
你应该使用哪种技术?
当与现有图像的连续性比精确的结尾更重要时,选择首帧锚定——需要从静态照片“活起来”的产品镜头,或者任何你希望模型即兴发挥运镜和时机的场景。
当最终构图是关键承重时,选择首尾帧插值——该帧需要匹配一个剪切点、循环回循环起始帧,或者落在某个特定角度用于缩略图或序列中的下一个镜头。代价是即兴自由度更少,换来的是有保证的落点。
用 /v1/tasks 复现两种技术
两种技术使用相同的模型 id seedance-2.0@ext——而不是裸的 seedance-2.0 id,后者是另一条不支持图像锚定的路由。请求体的唯一区别在于你是否提供 last_frame_url。
首帧锚定(仅 first_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "将提供的图像作为精确的首帧和硬性视觉锚点……(上方完整提示词)",
    "first_frame_url": "https://your-storage.example.com/anchor-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
首尾帧插值(first_frame_url + last_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "创建一段连续的 12 秒竖屏电影感镜头,严格进行插值……(上方完整提示词)",
    "first_frame_url": "https://your-storage.example.com/first-frame.jpg",
    "last_frame_url": "https://your-storage.example.com/last-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
将任一请求体 POST 到 /v1/tasks,然后轮询 GET /v1/tasks/{taskId} 直到状态为 success,并立即下载 output[0].url——这些链接会过期。
@ext 路由的定价仅由分辨率和时长决定,已与实时定价端点确认:
| 分辨率 | 每秒价格 | 12 秒片段 |
|---|---|---|
| 720p | $0.149 | $1.79 |
| 1080p | $0.373 | $4.48 |
| 4K | $0.467 | $5.60 |
锚定一帧还是两帧花费相同——你不会因为 last_frame_url 而被额外收费。
常见问题
seedance-2.0@ext 支持图生视频,还是仅支持文本?
两者都支持。仅 first_frame_url 即可实现自由运镜的图生视频;添加 last_frame_url 即可在两张固定图像之间进行首尾帧插值。
我可以在没有 first_frame_url 的情况下使用 last_frame_url 吗?
不可以——只要存在 last_frame_url,API 就要求提供 first_frame_url。你不能只锚定结尾。
为什么使用 seedance-2.0@ext 而不是基础 seedance-2.0 模型 id?
@ext 路由才带有图像锚定支持(first_frame_url/last_frame_url)和参考生视频输入,并且有自己的定价层级。基础路由是另一条更受限的产品线。
像这样的叙事镜头应该选什么分辨率? 1080p 是任何要发布的内容的实用默认值——720p 在电缆和雨水纹理等精细细节上明显更软,而 4K 的成本大约是 720p 的三倍,对于一个观众很少以原生分辨率观看的叙事片段来说并不划算。
自己动手试试
上面两个片段都是通过 hiapi 的 Seedance 2.0 Ext 模型页面生成的,你可以在那里查看完整的参数 schema,并直接在 playground 中测试提示词。如果你想要更多针对该模型的可复制起点,Seedance 2.0 Ext 提示词配方收录了更多,而这篇一镜到底 POV 穿越解析则在同一模型上讲解了第三种运镜控制技术。


