
Tutorial
Prompts de video con primer fotograma de Seedance 2.0 Ext: anclaje e interpolación
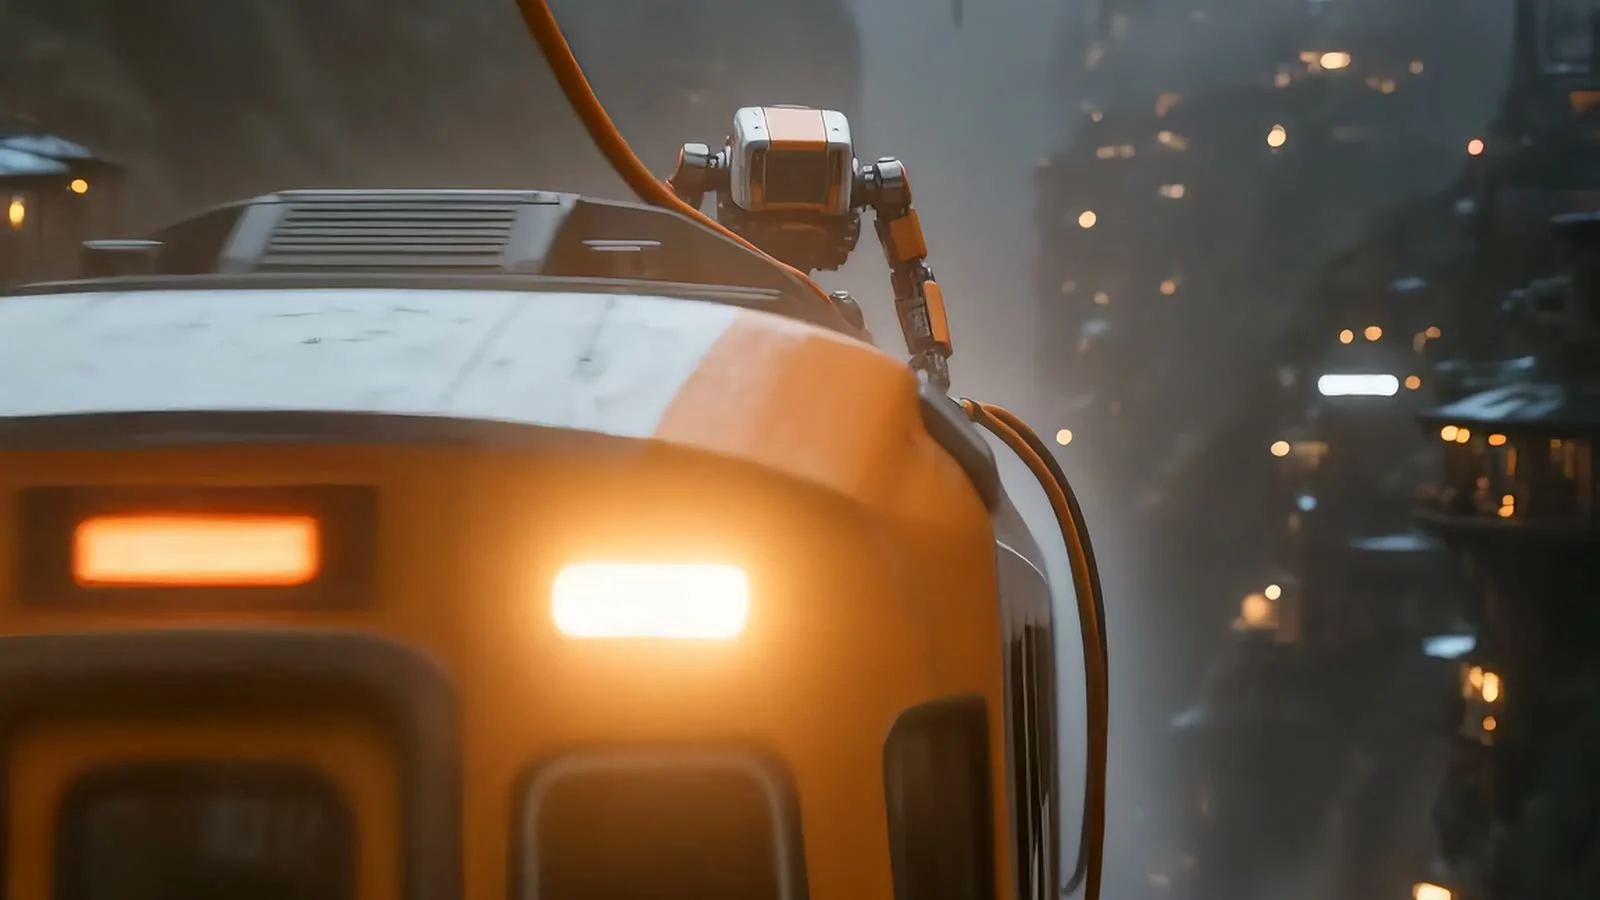
La mayoría de las personas, cuando redactan un prompt para un clip narrativo continuo, se topan con el mismo patrón de fallo: el fotograma inicial es el esperado, pero para el segundo 8 el modelo ya se ha desviado: las proporciones del robot han cambiado, el color de la niebla ha cambiado y el movimiento de cámara no ha llegado donde la historia lo necesita. Seedance 2.0 Ext resuelve este problema con dos estrategias de anclaje distintas, y elegir la estrategia equivocada para tu caso de uso es la diferencia entre una toma limpia de 12 segundos y tres regeneraciones desperdiciadas.
Las dos técnicas siguientes provienen del mismo universo narrativo —una ciudad montañosa empapada por la lluvia, un monorriel naranja y blanco, y un pequeño robot de mantenimiento que está reparando un conector de techo dañado— y se ejecutan sobre exactamente el mismo modelo seedance-2.0@ext. Lo único que cambia es qué fotogramas anclas.
La misma historia, dos estrategias de prompt distintas
Anclaje al primer fotograma le da al modelo un punto de partida fijo (una imagen de referencia) y le deja improvisar todo lo demás: el movimiento de cámara, el ritmo y dónde acaba posándose la toma. La interpolación entre primer y último fotograma le da dos puntos fijos, inicio y final, y el modelo rellena entre ambos una trayectoria continua. Los prompts, el diseño de sonido y la continuidad del sujeto en los dos clips siguientes son casi idénticos; lo único que difiere es el mecanismo de control.
Técnica 1: anclaje duro al primer fotograma
Este clip solo ancla el fotograma de apertura y luego deja que la cámara complete libremente una toma de seguimiento ininterrumpida: desde la altura de la vía, hasta la altura del techo, y luego un alejamiento que revela toda la ciudad.
Usa la imagen proporcionada como fotograma inicial exacto y ancla visual rígida: conserva el mismo robot de mantenimiento naranja y blanco original, la misma ciudad montañosa bajo la lluvia, la misma geometría del monorriel, el material de la vía mojada, la luz ámbar del tren y la niebla azul. Cortometraje de acción cinematográfico vertical de 12 segundos, una toma de seguimiento continua e ininterrumpida, sin cortes. 0-3 s: comienza desde el fotograma exacto proporcionado; la cámara está a pocas pulgadas por encima de las vías empapadas por la lluvia, y luego acelera hacia delante y ligeramente hacia arriba en dirección al techo. Los charcos se ondulan por la vibración de la vía y la lluvia golpea la lente de forma natural. 3-7 s: seguimiento lateral a lo largo del techo del monorriel en movimiento; el pequeño robot de mantenimiento se mantiene firme contra el viento y tira del pesado cable naranja de alta tensión que se ha soltado hacia el conector de techo dañado. Muestra el peso real del cable, la tensión, la fricción metálica, la vibración de las ruedas y las salpicaduras. 7-10 s: un breve arco eléctrico azul crepita a través del hueco; el robot encaja el cable en su sitio. Las luces del tren parpadean una vez y vuelven a encenderse, proyectando un reflejo cálido sobre las vías inundadas. 10-12 s: la cámara se eleva y se aleja; el monorriel reparado atraviesa la niebla de lluvia sobre el viaducto y revela la ciudad montañosa escalonada; termina con el robot en silueta contra las luces restablecidas y un relámpago a lo lejos. Sonido: golpeteo de lluvia cercana, vibración de la vía mojada, zumbido eléctrico grave, chasquido nítido del encaje del cable, una oleada de energía controlada, trueno lejano. Sin diálogos, sin texto en pantalla, sin logotipos, sin estilo anime, sin geometría distorsionada del tren, sin robots adicionales, sin extremidades extra, sin saltos de corte.
Este prompt se sostiene sobre tres cosas:
- «ancla visual rígida» más una lista explícita de sujetos. Nombrar el robot, la ciudad, la geometría del monorriel, el material de la vía y el color de la luz antes de que empiece cualquier acción obliga al modelo a fijar esos rasgos desde el fotograma cero, en lugar de dejar que se desvíen una vez que la cámara empieza a moverse.
- Pulsos con marcas de tiempo (0-3 s, 3-7 s, 7-10 s, 10-12 s). Cada pulso describe un encuadre y una acción física: acelerar, seguir, arco eléctrico y encaje, alejamiento. Seedance 2.0 Ext sigue los pulsos con tiempo de forma mucho más fiable que una descripción de acción única y sin segmentar.
- Una lista negativa dirigida a los modos de fallo reales de este modelo, no a generalidades: la geometría distorsionada del tren y las extremidades extra son precisamente los artefactos que aparecen cuando fallan tomas del tipo «robot de pie sobre un vehículo en movimiento», así que nombrarlos directamente los suprime.
Técnica 2: interpolación entre primer y último fotograma
Este clip cuenta prácticamente la misma historia, pero además bloquea la composición del final: resulta útil cuando el fotograma final tiene que coincidir con algo concreto, como una transición al siguiente plano o una composición precisa del sujeto.
Crea una toma cinematográfica vertical continua de 12 segundos que interpole estrictamente entre el primer fotograma proporcionado y el último fotograma proporcionado. La primera imagen es el estado inicial exacto; la segunda imagen es el estado final exacto. Conserva durante todo el metraje el mismo monorriel naranja y blanco, el robot de mantenimiento naranja original, el cable naranja reparado del techo, la ciudad montañosa bajo la lluvia, el material de la vía mojada, la luz ámbar y la niebla azul. 0-3 s: comienza desde la vista a la altura de la vía del primer fotograma y acelera hacia delante a lo largo de la vía mojada en dirección al techo. 3-7 s: seguimiento lateral junto al techo, el robot se mantiene firme contra el viento y tira del pesado cable naranja hacia el conector de techo dañado; muestra la tensión natural del cable, la fricción metálica, la lluvia y las salpicaduras. 7-9 s: un breve arco eléctrico azul, el cable encaja en su sitio, las luces del tren parpadean y se estabilizan. 9-12 s: la cámara se desplaza con suavidad hacia detrás y por encima del tren hasta alcanzar exactamente la composición del último fotograma proporcionado: la parte trasera completa del tren se aleja, y dos raíles mojados paralelos se ven con claridad extendiéndose de forma continua desde debajo del tren en primer plano, atravesando el viaducto ferroviario y convergiendo tras el puente. En el tramo final no muestres nunca la parte delantera del tren. Mantén la geometría ferroviaria físicamente coherente y la continuidad de la vía claramente visible en todo momento. Sonido: golpeteo de lluvia, vibración de la vía mojada, zumbido eléctrico grave, chasquido del encaje del cable, oleada de energía controlada, trueno lejano. Sin diálogos, sin texto, sin logotipos, sin anime, sin puente de carretera, sin andén sin vías, sin vías faltantes, sin robots adicionales, sin extremidades extra, sin saltos de corte.
En comparación con la técnica 1, los cambios son:
- «que interpole estrictamente entre el primer fotograma proporcionado y el último fotograma proporcionado» se indica en la primera frase. Es la instrucción que le dice al modelo que tiene un punto final fijo, no solo un punto de partida fijo; el resto del prompt describe la trayectoria que conecta ambos.
- El final se especifica deliberadamente en exceso: «la parte trasera completa del tren se aleja», «dos raíles mojados paralelos claramente continuos», «en el tramo final no muestres nunca la parte delantera del tren». Cuando fijas un fotograma final, la vaguedad sobre la composición final es justo donde se desvía la interpolación; la solución es describir los últimos 2-3 segundos con tanto detalle geométrico como el pulso de apertura.
- Nuevos términos negativos para el plano final —«sin puente de carretera, sin andén sin vías, sin vías faltantes»— porque el movimiento de cámara hacia la vista trasera de tres cuartos es precisamente donde este modelo tiende a perder la continuidad de la vía.
¿Qué técnica deberías usar?
Elige el anclaje al primer fotograma cuando la continuidad con una imagen existente importe más que un final exacto: tomas de producto que necesitan «cobrar vida» a partir de una foto estática, o cualquier escenario en el que quieras que el modelo improvise el movimiento de cámara y el timing.
Elige la interpolación entre primer y último fotograma cuando la composición final sea un elemento crítico: ese fotograma tiene que coincidir con un punto de corte, volver al fotograma inicial de un bucle, o posarse en un ángulo concreto para una miniatura o para el siguiente plano de la secuencia. El precio es menos libertad de improvisación, a cambio de un punto de llegada garantizado.
Reproduce ambas técnicas con /v1/tasks
Las dos técnicas usan el mismo id de modelo seedance-2.0@ext, y no el id desnudo seedance-2.0, que es otra ruta que no admite anclaje por imagen. La única diferencia en el cuerpo de la solicitud es si proporcionas last_frame_url.
Anclaje al primer fotograma (solo first_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Usa la imagen proporcionada como fotograma inicial exacto y ancla visual rígida… (prompt completo arriba)",
    "first_frame_url": "https://your-storage.example.com/anchor-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
Interpolación entre primer y último fotograma (first_frame_url + last_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Crea una toma cinematográfica vertical continua de 12 segundos que interpole estrictamente… (prompt completo arriba)",
    "first_frame_url": "https://your-storage.example.com/first-frame.jpg",
    "last_frame_url": "https://your-storage.example.com/last-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
Envía cualquiera de los dos cuerpos de solicitud con POST a /v1/tasks y luego consulta periódicamente GET /v1/tasks/{taskId} hasta que el estado sea success, y descarga inmediatamente output[0].url: esos enlaces caducan.
El precio de la ruta @ext depende únicamente de la resolución y la duración, confirmado con el endpoint de precios en tiempo real:
| Resolución | Precio por segundo | Clip de 12 segundos |
|---|---|---|
| 720p | $0.149 | $1.79 |
| 1080p | $0.373 | $4.48 |
| 4K | $0.467 | $5.60 |
Anclar uno o dos fotogramas cuesta lo mismo: no se te cobra extra por last_frame_url.
Preguntas frecuentes
¿seedance-2.0@ext admite imagen a video o solo texto?
Ambos. Solo con first_frame_url ya consigues imagen a video con movimiento de cámara libre; añade last_frame_url para interpolar entre dos imágenes fijas.
¿Puedo usar last_frame_url sin first_frame_url?
No: siempre que exista last_frame_url, la API exige proporcionar first_frame_url. No puedes anclar solo el final.
¿Por qué usar seedance-2.0@ext en lugar del id de modelo base seedance-2.0?
La ruta @ext es la que incluye compatibilidad con anclaje por imagen (first_frame_url/last_frame_url) y entradas de referencia de imagen a video, y tiene su propia escala de precios. La ruta base es otra línea de producto más limitada.
¿Qué resolución elegir para una toma narrativa como esta? 1080p es el valor predeterminado práctico para cualquier contenido que vayas a publicar: 720p se ve claramente más blando en detalles finos como los cables y las texturas de la lluvia, mientras que 4K cuesta aproximadamente el triple que 720p, lo que no compensa para un clip narrativo que el público rara vez ve a resolución nativa.
Pruébalo tú mismo
Los dos clips anteriores se generaron a través de la página del modelo Seedance 2.0 Ext de hiapi, donde puedes consultar el esquema completo de parámetros y probar los prompts directamente en el playground. Si quieres más puntos de partida copiables para este modelo, Recetas de prompts para Seedance 2.0 Ext reúne más, y este análisis de un plano secuencia POV explica una tercera técnica de control de cámara sobre el mismo modelo.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado