
Tutorial
Seedance 2.0 Ext Video-Prompts mit erstem Frame: Verankerung und Interpolation
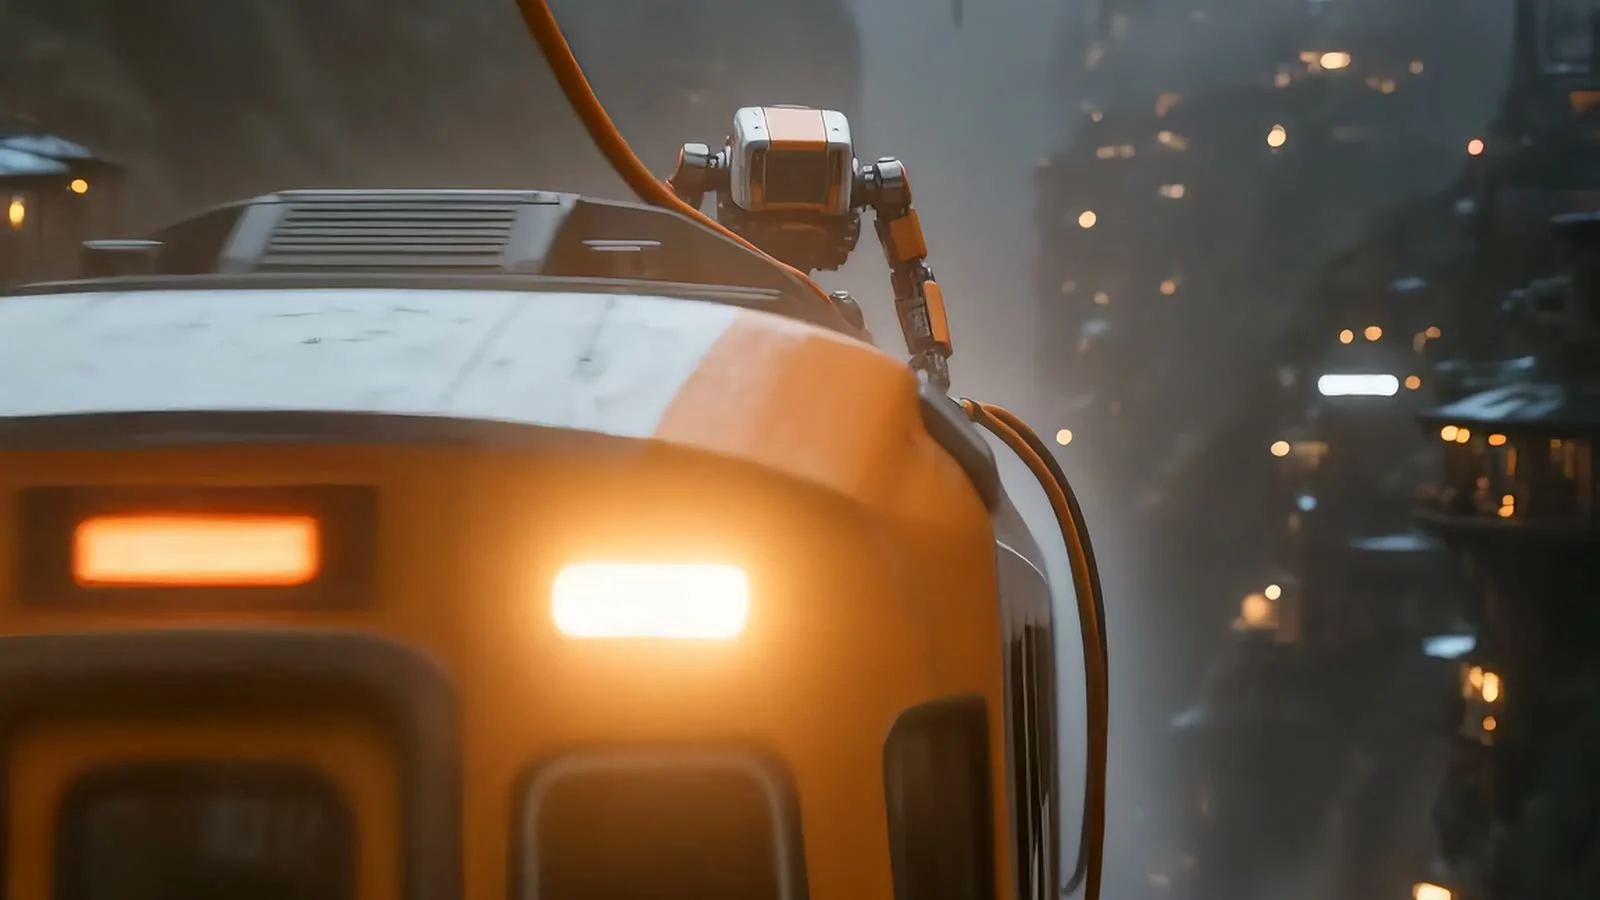
Die meisten Menschen stoßen beim Schreiben von Prompts für einen durchgehenden narrativen Videoclip auf dasselbe Fehlermuster: Das Eröffnungsbild entspricht den Erwartungen, doch bei Sekunde 8 ist das Modell bereits abgedriftet – die Proportionen des Roboters haben sich verändert, die Farbe des Nebels hat sich verändert, und die Kamerabewegung landet nicht dort, wo die Geschichte sie braucht. Seedance 2.0 Ext löst dieses Problem mit zwei unterschiedlichen Verankerungsstrategien, und die falsche Strategie für Ihren Anwendungsfall zu wählen, ist der Unterschied zwischen einer sauberen 12-Sekunden-Aufnahme und drei verschwendeten Neugenerierungen.
Die beiden folgenden Techniken stammen aus derselben narrativen Welt – einer regennassen Bergstadt, einem orange-weißen Einschienenbahnzug und einem kleinen Wartungsroboter, der einen beschädigten Dachverbinder repariert – und laufen auf exakt demselben Modell seedance-2.0@ext. Einzige Änderung: welche Frames Sie verankern.
Dieselbe Geschichte, zwei unterschiedliche Prompt-Strategien
Verankerung am ersten Frame gibt dem Modell einen festen Startpunkt (ein Referenzbild) und lässt es alles Weitere improvisieren – Kamerabewegung, Tempo und wo die Aufnahme schließlich landet. Interpolation zwischen erstem und letztem Frame gibt ihm zwei feste Punkte, Start und Ende, und das Modell füllt dazwischen einen kontinuierlichen Pfad. Die Prompts, das Sounddesign und die Kontinuität des Motivs in den beiden folgenden Clips sind nahezu identisch; unterschiedlich ist nur der Kontrollmechanismus.
Technik 1: Harte Verankerung am ersten Frame
Dieser Clip verankert nur das Eröffnungsbild und lässt die Kamera dann frei eine ununterbrochene Tracking-Aufnahme ausführen – von Schienenhöhe über Dachhöhe bis hin zu einem Herauszoomen, das die ganze Stadt enthüllt.
Verwenden Sie das bereitgestellte Bild als exakten ersten Frame und als harte visuelle Verankerung: Behalten Sie denselben ursprünglichen orange-weißen Wartungsroboter, dieselbe regennasse Bergstadt, dieselbe Einschienenbahn-Geometrie, das nasse Schienenmaterial, das bernsteinfarbene Zuglicht und den blauen Nebel bei. 12-sekündiger vertikaler filmischer Action-Kurzfilm, eine ununterbrochene durchgehende Tracking-Aufnahme, kein Schnitt. 0-3 Sek.: Beginnen Sie mit dem exakt bereitgestellten Frame; die Kamera befindet sich wenige Zentimeter über den regennassen Schienen und beschleunigt dann nach vorne und leicht nach oben in Richtung Dach. Pfützen kräuseln sich durch die Schienenerschütterung, Regen fällt natürlich auf die Linse. 3-7 Sek.: Mitführen entlang des fahrenden Einschienenbahn-Dachs; der kleine Wartungsroboter steht fest im Wind und zieht das lose schwere orangefarbene Hochspannungskabel zum beschädigten Dachverbinder. Zeigen Sie reales Kabelgewicht, Spannung, Metallreibung, Radvibration und Spritzwasser. 7-10 Sek.: Ein kurzer blauer Lichtbogen knistert über die Lücke; der Roboter rastet das Kabel ein. Das Zuglicht flackert einmal und leuchtet dann wieder auf, wobei es warme Reflexe auf den wasserbedeckten Schienen wirft. 10-12 Sek.: Die Kamera steigt an und zieht heraus, während die reparierte Einschienenbahn durch den Regennebel über die Hochbrücke fährt und die terrassierte Bergstadt zeigt; am Ende die Silhouette des Roboters gegen das wiederhergestellte Licht und ein fernes Blitzlicht. Ton: nahes Aufprallen von Regentropfen, Vibration der nassen Schienen, tiefes elektrisches Brummen, scharfes Klicken beim Einrasten des Kabels, ein kontrollierter Stromstoß, fernes Donnern. Kein Dialog, kein Bildschirmtext, keine Logos, kein Anime-Stil, keine verzerrte Zungeometrie, keine zusätzlichen Roboter, keine überzähligen Gliedmaßen, keine Sprünge im Schnitt.
Dieser Prompt stützt sich auf drei Dinge:
- „Harte visuelle Verankerung“ plus eine explizite Liste der Motive. Roboter, Stadt, Einschienenbahn-Geometrie, Schienenmaterial und Lichtfarbe werden vor Beginn jeder Aktion benannt, wodurch das Modell diese Merkmale ab dem nullten Frame festschreibt, statt sie erst nach Beginn der Kamerabewegung driften zu lassen.
- Zeitgestempelte Beats (0-3 Sek., 3-7 Sek., 7-10 Sek., 10-12 Sek.). Jeder Beat beschreibt eine Kameraposition und eine physische Aktion – beschleunigen, mitführen, Lichtbogen und Einrasten, herausziehen. Seedance 2.0 Ext folgt zeitgestempelten Beats deutlich zuverlässiger als einer einzigen unsegmentierten Aktionsbeschreibung.
- Eine Negativliste, die auf die tatsächlichen Fehlermuster dieses Modells abzielt, statt allgemein zu bleiben: verzerrte Zungeometrie und überzählige Gliedmaßen sind genau die spezifischen Artefakte, die bei Aufnahmen wie „Roboter steht auf einem fahrenden Fahrzeug“ auftreten, daher unterdrückt ihre direkte Nennung sie.
Technik 2: Interpolation zwischen erstem und letztem Frame
Dieser Clip erzählt nahezu dieselbe Geschichte, verankert aber auch die Endkomposition – nützlich, wenn der letzte Frame zu einem bestimmten Inhalt passen muss, etwa für den Übergang zur nächsten Aufnahme oder für eine exakte Motivkomposition.
Erstellen Sie eine durchgehende 12-sekündige vertikale filmische Aufnahme, die streng zwischen dem bereitgestellten ersten Frame und dem bereitgestellten letzten Frame interpoliert. Das erste Bild ist der exakte Ausgangszustand; das zweite Bild ist der exakte Endzustand. Behalten Sie durchgehend denselben orange-weißen Einschienenbahnzug, denselben orangefarbenen Wartungsroboter, das reparierte orangefarbene Dachkabel, die regennasse Bergstadt, das nasse Schienenmaterial, das bernsteinfarbene Licht und den blauen Nebel bei. 0-3 Sek.: Beginnen Sie mit der Ansicht auf Schienenhöhe aus dem ersten Frame und beschleunigen Sie entlang der nassen Schienen nach vorne in Richtung Dach. 3-7 Sek.: Mitführen neben dem Dach, der Roboter steht fest im Wind und zieht das schwere orangefarbene Kabel zum beschädigten Dachverbinder; zeigen Sie natürliche Kabelspannung, Metallreibung, Regen und Spritzwasser. 7-9 Sek.: Ein kurzer blauer Lichtbogen, das Kabel rastet ein, das Zuglicht flackert und stabilisiert sich. 9-12 Sek.: Die Kamera bewegt sich gleichmäßig hinter und über den Zug, bis sie exakt die bereitgestellte Endkomposition erreicht: das vollständige Heck des Zuges entfernt sich, und zwei parallele nasse Stahlschienen sind klar und durchgehend vom Vordergrund unter dem Zug aus sichtbar, verlaufen über die Eisenbahn-Hochbrücke und konvergieren hinter der Brücke. Zeigen Sie im letzten Abschnitt niemals die Zugfront. Halten Sie die Eisenbahn-Geometrie physikalisch kohärent und die Schienenkontinuität in jedem Moment klar sichtbar. Ton: Aufprallen von Regentropfen, Vibration der nassen Schienen, tiefes elektrisches Brummen, Klicken beim Einrasten des Kabels, kontrollierter Stromstoß, fernes Donnern. Kein Dialog, kein Text, keine Logos, kein Anime, keine Straßenbrücke, kein schienenloser Bahnsteig, keine fehlenden Schienen, keine zusätzlichen Roboter, keine überzähligen Gliedmaßen, keine Sprünge im Schnitt.
Im Vergleich zu Technik 1 liegen die Unterschiede in:
- „Streng zwischen dem bereitgestellten ersten Frame und dem bereitgestellten letzten Frame interpolieren“ steht gleich im ersten Satz. Dies ist die Anweisung, die dem Modell sagt, dass es einen festen Endpunkt hat, nicht nur einen festen Startpunkt – der Rest des Prompts beschreibt den Pfad, der beide verbindet.
- Das Ende wird bewusst überbestimmt: „das vollständige Heck des Zuges entfernt sich“, „zwei parallele nasse Stahlschienen klar und durchgehend“, „im letzten Abschnitt niemals die Zugfront zeigen“. Wenn Sie einen Endframe festnageln, driftet die Interpolation genau dort, wo die Formulierung zur endgültigen Komposition vage bleibt – die Lösung besteht darin, die letzten 2-3 Sekunden mit ebenso vielen geometrischen Details zu beschreiben wie den Eröffnungs-Beat.
- Neue Negativbegriffe für die Schlussaufnahme – „keine Straßenbrücke, kein schienenloser Bahnsteig, keine fehlenden Schienen“ – denn wenn die Kamera in die hintere Dreiviertelansicht schwenkt, verliert dieses Modell genau dort leicht die Schienenkontinuität.
Welche Technik sollten Sie verwenden?
Wählen Sie die Verankerung am ersten Frame, wenn die Kontinuität mit einem vorhandenen Bild wichtiger ist als ein exaktes Ende – etwa bei Produktaufnahmen, die aus einem Standfoto „zum Leben erweckt“ werden sollen, oder in jedem Szenario, in dem das Modell Kamerabewegung und Timing improvisieren soll.
Wählen Sie die Interpolation zwischen erstem und letztem Frame, wenn die endgültige Komposition tragend ist – wenn dieser Frame zu einem Schnittpunkt passen, zum Startframe einer Schleife zurückführen oder in einem bestimmten Winkel für ein Thumbnail oder die nächste Aufnahme einer Sequenz landen muss. Der Preis ist weniger Improvisationsfreiheit, dafür ein garantierter Endpunkt.
Beide Techniken mit /v1/tasks reproduzieren
Beide Techniken verwenden dieselbe Modell-ID seedance-2.0@ext – nicht die nackte ID seedance-2.0, die eine andere Route ohne Bildverankerung ist. Der einzige Unterschied im Request-Body besteht darin, ob Sie last_frame_url angeben.
Verankerung am ersten Frame (nur first_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Verwenden Sie das bereitgestellte Bild als exakten ersten Frame und harte visuelle Verankerung … (vollständiger Prompt oben)",
    "first_frame_url": "https://your-storage.example.com/anchor-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
Interpolation zwischen erstem und letztem Frame (first_frame_url + last_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Erstellen Sie eine durchgehende 12-sekündige vertikale filmische Aufnahme, die streng interpoliert … (vollständiger Prompt oben)",
    "first_frame_url": "https://your-storage.example.com/first-frame.jpg",
    "last_frame_url": "https://your-storage.example.com/last-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
POSTen Sie einen der beiden Request-Bodies an /v1/tasks, fragen Sie dann GET /v1/tasks/{taskId} ab, bis der Status success lautet, und laden Sie sofort output[0].url herunter – diese Links laufen ab.
Die Preisgestaltung der @ext-Route richtet sich ausschließlich nach Auflösung und Dauer und wurde mit dem Echtzeit-Preis-Endpunkt bestätigt:
| Auflösung | Preis pro Sekunde | 12-Sekunden-Clip |
|---|---|---|
| 720p | $0.149 | $1.79 |
| 1080p | $0.373 | $4.48 |
| 4K | $0.467 | $5.60 |
Die Verankerung eines Frames oder zweier Frames kostet gleich viel – für last_frame_url wird kein Aufpreis berechnet.
Häufig gestellte Fragen
Unterstützt seedance-2.0@ext Image-to-Video oder nur Text?
Beides. Allein mit first_frame_url erhalten Sie Image-to-Video mit freier Kamerabewegung; fügen Sie last_frame_url hinzu, um zwischen zwei festen Bildern zu interpolieren.
Kann ich last_frame_url ohne first_frame_url verwenden?
Nein – sobald last_frame_url vorhanden ist, verlangt die API first_frame_url. Sie können nicht nur das Ende verankern.
Warum seedance-2.0@ext statt der Basis-Modell-ID seedance-2.0 verwenden?
Nur die @ext-Route bietet Unterstützung für Bildverankerung (first_frame_url/last_frame_url) und Referenz-zu-Video-Eingaben und hat eine eigene Preisstufe. Die Basis-Route ist eine andere, eingeschränktere Produktlinie.
Welche Auflösung sollte ich für eine narrative Aufnahme wie diese wählen? 1080p ist der praktische Standard für alles, was veröffentlicht wird – 720p ist bei feinen Details wie Kabeln und Regenstrukturen deutlich weicher, während 4K etwa dreimal so viel wie 720p kostet, was sich für einen narrativen Clip, den Zuschauer selten in nativer Auflösung ansehen, nicht lohnt.
Probieren Sie es selbst aus
Beide oben gezeigten Clips wurden über die Seedance 2.0 Ext Modellseite von hiapi generiert, wo Sie das vollständige Parameter-Schema einsehen und Prompts direkt im Playground testen können. Wenn Sie weitere kopierbare Ausgangspunkte für dieses Modell wünschen, enthält Seedance 2.0 Ext Prompt-Rezepte mehr davon, und diese Analyse eines One-Shot-POV-Durchlaufs erklärt eine dritte Kamerakontrolltechnik am selben Modell.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses