
Tutoriale
Prompt video primo frame Seedance 2.0 Ext: ancoraggio e interpolazione
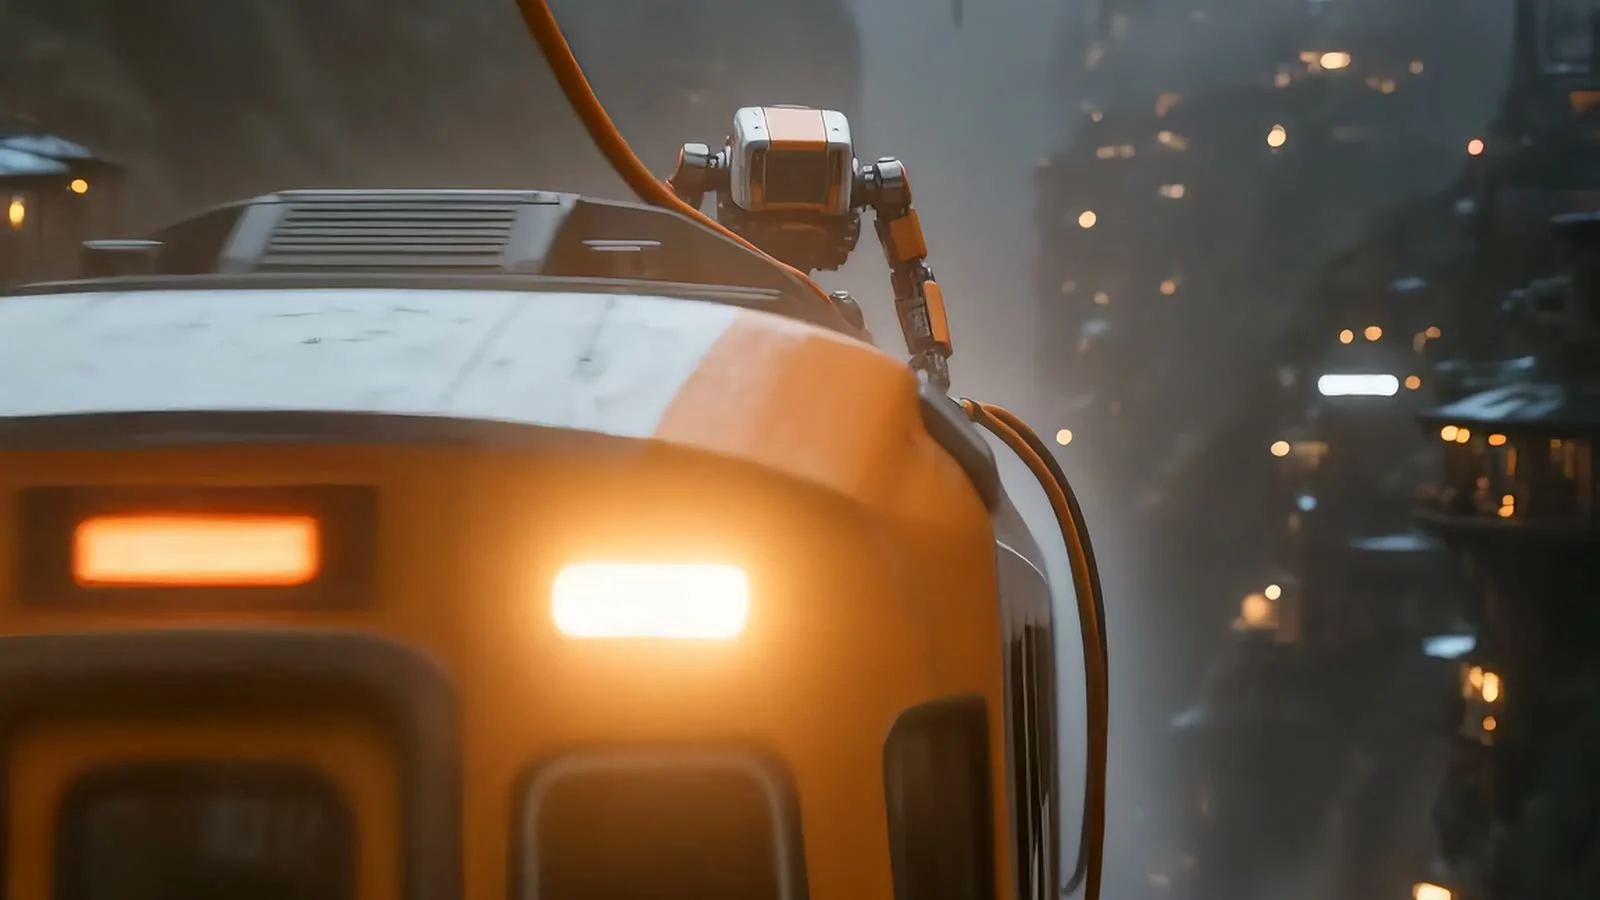
La maggior parte delle persone, quando scrive il prompt per una sequenza video narrativa continua, incontra lo stesso tipo di fallimento: il frame iniziale è quello previsto, ma all'ottavo secondo il modello è già andato fuori strada — le proporzioni del robot sono cambiate, il colore della nebbia è cambiato, il movimento di camera non è arrivato dove la storia lo richiede. Seedance 2.0 Ext risolve questo problema con due diverse strategie di ancoraggio, e scegliere quella sbagliata per il proprio caso d'uso è la differenza tra una ripresa pulita di 12 secondi e tre rigenerazioni sprecate.
Entrambe le tecniche qui sotto provengono dallo stesso mondo narrativo — una città montana inzuppata di pioggia, un treno monorotaia arancione e bianco e un piccolo robot di manutenzione che ripara un connettore danneggiato sul tetto — e girano esattamente sullo stesso modello seedance-2.0@ext. L'unica cosa che cambia è quali frame si ancorano.
La stessa storia, due diverse strategie di prompt
L'ancoraggio al primo frame dà al modello un punto di partenza fisso (un'immagine di riferimento) e lo lascia improvvisare tutto il resto — movimento di camera, ritmo e dove il piano finisce.L'interpolazione primo-ultimo frame gli dà due punti fissi, inizio e fine, e il modello riempie un percorso continuo tra i due. I prompt, il sound design e la continuità del soggetto nei due clip qui sotto sono quasi identici; cambia solo il meccanismo di controllo.
Tecnica 1: ancoraggio rigido al primo frame
Questo clip ancora solo il frame di apertura e poi lascia che la camera completi liberamente un piano sequenza ininterrotto — dall'altezza dei binari all'altezza del tetto, fino a un allontanamento che rivela l'intera città.
Usa l'immagine fornita come primo frame esatto e ancoraggio visivo rigido: mantieni lo stesso robot di manutenzione arancione e bianco originale, la stessa città montana sotto la pioggia, la stessa geometria della monorotaia, il materiale bagnato dei binari, le luci ambrate del treno e la nebbia blu. Cortometraggio d'azione cinematografico verticale di 12 secondi, un unico piano sequenza continuo e ininterrotto, senza tagli. 0-3 secondi: inizia dal frame esatto fornito; la camera è a pochi centimetri sopra i binari inzuppati di pioggia, poi accelera in avanti e leggermente verso l'alto in direzione del tetto. Le pozzanghere si increspano per la vibrazione dei binari, la pioggia colpisce naturalmente l'obiettivo. 3-7 secondi: carrellata laterale lungo il tetto del treno monorotaia in movimento; il piccolo robot di manutenzione resiste al vento, tirando il pesante cavo ad alta tensione arancione allentato verso il connettore danneggiato sul tetto. Mostra il peso reale del cavo, la tensione, l'attrito metallico, la vibrazione delle ruote e gli schizzi d'acqua. 7-10 secondi: un breve arco elettrico blu crepita attraverso lo spazio; il robot blocca il cavo in posizione. Le luci del treno lampeggiano una volta, poi si riaccendono, proiettando riflessi caldi sui binari allagati. 10-12 secondi: la camera sale e si allontana, il treno monorotaia riparato attraversa la nebbia di pioggia sul viadotto, mostrando la città montana stratificata; si chiude con la silhouette del robot contro le luci ripristinate e un lampo in lontananza. Audio: impatto ravvicinato delle gocce di pioggia, vibrazione dei binari bagnati, basso ronzio elettrico, nitido clic di bloccaggio del cavo, un'ondata elettrica controllata, tuono in lontananza. Nessun dialogo, nessun testo a schermo, nessun logo, nessuno stile anime, nessuna geometria del treno distorta, nessun robot aggiuntivo, nessun arto in più, nessun taglio netto.
Questo prompt si regge su tre cose:
- "Ancoraggio visivo rigido" più un elenco esplicito dei soggetti. Nominare robot, città, geometria della monorotaia, materiale dei binari e colore delle luci prima che inizi qualsiasi azione costringe il modello a bloccare queste caratteristiche dal frame zero, invece di lasciarle andare alla deriva una volta che la camera si muove.
- Battute con timestamp (0-3 s, 3-7 s, 7-10 s, 10-12 s). Ogni battuta descrive una posizione di camera e un'azione fisica — accelerare, carrellare, arco elettrico e bloccaggio, allontanamento. Seedance 2.0 Ext segue le battute temporizzate in modo molto più affidabile di un'unica descrizione d'azione non segmentata.
- Un elenco negativo mirato ai modi di fallimento reali di questo modello, non generico: geometria del treno distorta e arti in più sono precisamente gli artefatti che emergono quando scene come "un robot in piedi su un veicolo in movimento" vanno storte, quindi nominarli direttamente li sopprime.
Tecnica 2: interpolazione primo-ultimo frame
Questo clip racconta quasi la stessa storia, ma blocca anche la composizione finale — utile quando il frame finale deve corrispondere a qualcosa di specifico, come una transizione al piano successivo o una composizione precisa del soggetto.
Crea una ripresa cinematografica verticale continua di 12 secondi, interpolando rigorosamente tra il primo frame fornito e l'ultimo frame fornito. La prima immagine è lo stato di apertura esatto; la seconda immagine è lo stato finale esatto. Mantieni per tutta la durata lo stesso treno monorotaia arancione e bianco, il robot di manutenzione arancione originale, il cavo arancione riparato sul tetto, la città montana sotto la pioggia, il materiale bagnato dei binari, le luci ambrate e la nebbia blu. 0-3 secondi: inizia dalla vista all'altezza dei binari del primo frame, accelera in avanti lungo i binari bagnati verso il tetto. 3-7 secondi: carrellata laterale lungo il tetto, il robot resiste al vento, tirando il pesante cavo arancione verso il connettore danneggiato sul tetto; mostra la tensione naturale del cavo, l'attrito metallico, la pioggia e gli schizzi. 7-9 secondi: un breve arco elettrico blu, il cavo si blocca in posizione, le luci del treno lampeggiano e poi si stabilizzano. 9-12 secondi: la camera si sposta fluidamente dietro e sopra il treno, fino a raggiungere esattamente la composizione dell'ultimo frame fornito: la parte posteriore completa del treno che si allontana, due binari bagnati paralleli chiaramente visibili e continui che si estendono dal sotto il treno in primo piano, attraversando il viadotto ferroviario e convergendo oltre il ponte. Nell'ultimo tratto non mostrare mai la parte anteriore del treno. Mantieni la geometria ferroviaria fisicamente coerente e la continuità dei binari chiaramente visibile in ogni istante. Audio: impatto delle gocce di pioggia, vibrazione dei binari bagnati, basso ronzio elettrico, clic di bloccaggio del cavo, ondata elettrica controllata, tuono in lontananza. Nessun dialogo, nessun testo, nessun logo, nessuno stile anime, nessun ponte stradale, nessuna banchina senza binari, nessun binario mancante, nessun robot aggiuntivo, nessun arto in più, nessun taglio netto.
Rispetto alla tecnica 1, le differenze sono:
- "Interpolando rigorosamente tra il primo frame fornito e l'ultimo frame fornito" è dichiarato nella primissima frase. È l'istruzione che dice al modello di avere un punto finale fisso, non solo un punto iniziale fisso — il resto del prompt descrive il percorso che li collega.
- Il finale è deliberatamente iper-specificato: "la parte posteriore completa del treno che si allontana", "due binari bagnati paralleli chiaramente continui", "nell'ultimo tratto non mostrare mai la parte anteriore del treno". Quando si fissa un frame finale, è proprio la formulazione vaga della composizione finale a far derivare l'interpolazione — la soluzione è descrivere gli ultimi 2-3 secondi con la stessa quantità di dettaglio geometrico delle battute di apertura.
- Nuovi termini negativi per il piano finale — "nessun ponte stradale, nessuna banchina senza binari, nessun binario mancante" — perché il movimento della camera verso la vista posteriore a tre quarti è proprio il punto in cui questo modello tende a perdere la continuità dei binari.
Quale tecnica dovresti usare?
Scegli l'ancoraggio al primo frame quando la continuità con un'immagine esistente conta più del finale esatto — riprese di prodotto che devono "prendere vita" da una foto statica, o qualsiasi scena in cui vuoi che il modello improvvisi movimento di camera e tempistica.
Scegli l'interpolazione primo-ultimo frame quando la composizione finale è il punto portante — quel frame deve corrispondere a un punto di taglio, chiudere un ciclo tornando al frame iniziale, o cadere su un'angolazione specifica per una miniatura o per il piano successivo della sequenza. Il prezzo è meno libertà di improvvisazione, in cambio di un punto di arrivo garantito.
Riprodurre entrambe le tecniche con /v1/tasks
Entrambe le tecniche usano lo stesso id modello seedance-2.0@ext — non l'id nudo seedance-2.0, che è un'altra rotta e non supporta l'ancoraggio alle immagini. L'unica differenza nel corpo della richiesta è se fornisci last_frame_url.
Ancoraggio al primo frame (solo first_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Usa l'immagine fornita come primo frame esatto e ancoraggio visivo rigido…… (prompt completo sopra)",
    "first_frame_url": "https://your-storage.example.com/anchor-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
Interpolazione primo-ultimo frame (first_frame_url + last_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "Crea una ripresa cinematografica verticale continua di 12 secondi, interpolando rigorosamente…… (prompt completo sopra)",
    "first_frame_url": "https://your-storage.example.com/first-frame.jpg",
    "last_frame_url": "https://your-storage.example.com/last-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
Invia uno dei due corpi con POST a /v1/tasks, poi esegui il polling di GET /v1/tasks/{taskId} finché lo stato non è success, e scarica subito output[0].url — questi link scadono.
Il prezzo della rotta @ext dipende solo da risoluzione e durata, confermato con l'endpoint dei prezzi in tempo reale:
| Risoluzione | Prezzo al secondo | Clip di 12 secondi |
|---|---|---|
| 720p | $0.149 | $1.79 |
| 1080p | $0.373 | $4.48 |
| 4K | $0.467 | $5.60 |
Ancorare un frame o due costa lo stesso — non paghi un supplemento per last_frame_url.
Domande frequenti
seedance-2.0@ext supporta il video da immagine o solo il testo?
Entrambi. Con il solo first_frame_url ottieni un video da immagine con camera libera; aggiungendo last_frame_url ottieni l'interpolazione primo-ultimo frame tra due immagini fisse.
Posso usare last_frame_url senza first_frame_url?
No — ogni volta che è presente last_frame_url, l'API richiede first_frame_url. Non puoi ancorare solo il finale.
Perché usare seedance-2.0@ext invece dell'id modello base seedance-2.0?
Solo la rotta @ext offre il supporto all'ancoraggio alle immagini (first_frame_url/last_frame_url) e gli input video di riferimento, e ha un proprio livello di prezzo. La rotta base è un'altra linea di prodotto, più limitata.
Quale risoluzione scegliere per una ripresa narrativa come questa? 1080p è il default pratico per qualsiasi contenuto da pubblicare — il 720p è visibilmente più morbido sui dettagli fini come cavi e texture della pioggia, mentre il 4K costa circa il triplo del 720p, poco conveniente per un clip narrativo che gli spettatori raramente guardano alla risoluzione nativa.
Provalo tu stesso
Entrambi i clip sopra sono stati generati tramite la pagina del modello Seedance 2.0 Ext di hiapi, dove puoi consultare lo schema completo dei parametri e testare i prompt direttamente nel playground. Se vuoi altri punti di partenza copiabili per questo modello, le ricette di prompt Seedance 2.0 Ext ne raccolgono altri, mentre questa analisi del POV in piano sequenza illustra una terza tecnica di controllo della camera sullo stesso modello.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato