
チュートリアル
Seedance 2.0 Ext の先頭フレーム動画プロンプト:アンカリングと補間
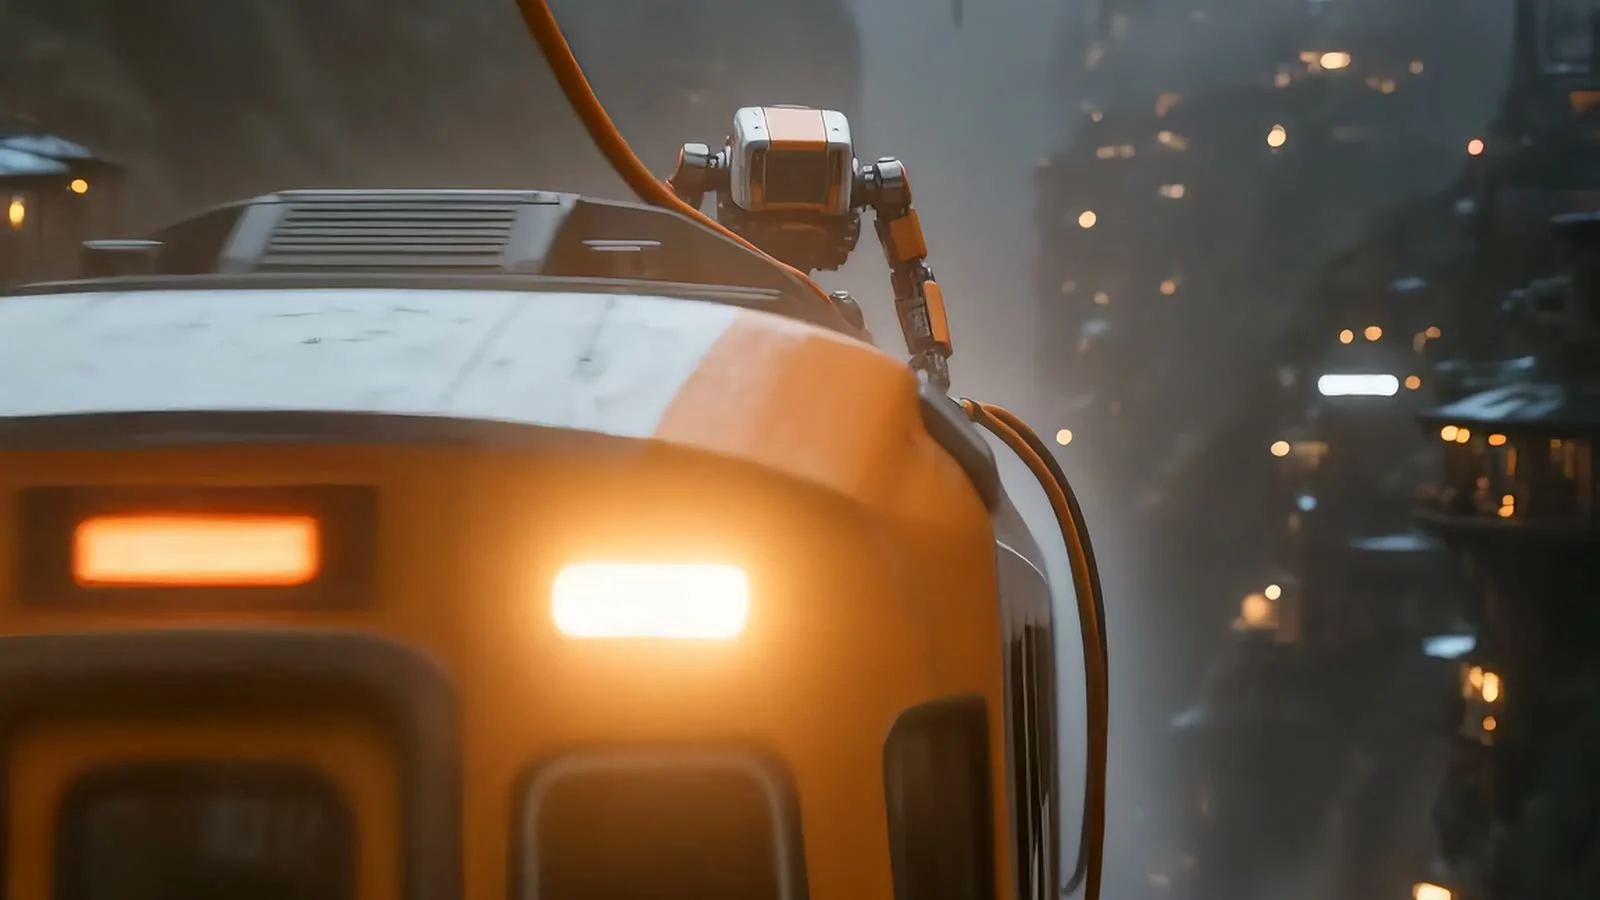
連続するナラティブな動画クリップのプロンプトを書くとき、ほとんどの人が同じ失敗パターンに遭遇します。冒頭フレームは期待通りなのに、8秒目にはモデルが逸脱してしまうのです。ロボットの比率が変わり、霧の色が変わり、カメラワークが物語の求める位置に収まらない——。Seedance 2.0 Ext は、この問題を2つの異なるアンカリング戦略で解決します。そして、あなたのユースケースに合わない戦略を選ぶことは、クリーンな12秒のショットと3回の無駄な再生成との差になります。
以下の2つの技術は、同じナラティブ世界——雨に濡れた山間の都市、オレンジと白のモノレール、そして損傷した屋根のコネクタを修復する小型メンテナンスロボット——に由来し、まったく同じモデル seedance-2.0@ext 上で動作します。変わるのは、どのフレームをアンカリングするかだけです。
同じ物語、2つの異なるプロンプト戦略
先頭フレームアンカリングは、モデルに固定された出発点(参照画像1枚)を与え、それ以降のすべて——カメラワーク、テンポ、そしてカメラが最終的にどこに収まるか——を即興で決めさせます。先頭・末尾フレーム補間は、開始点と終了点という2つの固定点を与え、その間の連続的な経路をモデルが埋めます。以下の2つのクリップは、プロンプト、サウンドデザイン、被写体の連続性がほぼ完全に同じです。異なるのは制御メカニズムだけです。
技術 1:先頭フレームのハードアンカリング
このクリップは冒頭フレームだけをアンカリングし、その後はカメラを自由に、途切れない1つのトラッキングショットとして完走させます——線路の高さから、屋根の高さへ、そして引きの画で都市全体を明らかにするまで。
提供された画像を正確な先頭フレームかつハードな視覚アンカーとして使用する:同じ既存のオレンジと白のメンテナンスロボット、同じ雨の山間都市、同じモノレールの幾何学構造、濡れた線路の質感、琥珀色の列車灯、青い霧を保持すること。12秒の縦型シネマティック・アクション短編。1つの途切れない連続トラッキングショットで、カットなし。0〜3秒:提供された正確なフレームから開始する。カメラは雨に濡れた線路の数インチ上にあり、その後前方かつやや上方へ加速して屋根へ向かう。水たまりは線路の振動で波紋を広げ、雨は自然にレンズに当たる。3〜7秒:走行するモノレールの屋根の横を並走して追う。小型メンテナンスロボットは向かい風の中に踏ん張り、外れかけた重いオレンジ色の高圧ケーブルを損傷した屋根のコネクタへ引き寄せる。ケーブルの実際の重み、張力、金属の摩擦、車輪の振動、水しぶきを表現する。7〜10秒:短い青いアーク放電が隙間をパチパチと走る。ロボットはケーブルを所定の位置にロックする。列車の灯が一度瞬き、その後再び点灯し、水浸しの線路に暖かな反射を落とす。10〜12秒:カメラは上昇して引きの画になり、修復されたモノレールが雨霧の中を高架橋へと走り抜け、重なり合う山間都市を明らかにする。最後は回復した灯を背にしたロボットのシルエットと、遠方の稲妻。サウンド:近くで弾ける雨音、濡れた線路の振動音、低いうなる電流のハム音、ケーブルがロックされる鋭いカチッという音、制御された電力のサージ、遠くの雷鳴。セリフなし、画面テキストなし、ロゴなし、アニメ調なし、歪んだ列車の幾何学構造なし、余分なロボットなし、余分な手足なし、ジャンプカットなし。
このプロンプトは3つの要素で支えられています:
- 「ハードな視覚アンカー」と明示的な被写体リスト。 アクションが始まる前にロボット、都市、モノレールの幾何学構造、線路の質感、照明の色を名指しすることで、モデルは第0フレームからそれらの特徴を固定せざるを得なくなり、カメラが動き出してから漂うに任せることはありません。
- タイムスタンプ付きのビート(0〜3秒、3〜7秒、7〜10秒、10〜12秒)。 各ビートは1つのカメラ位置と1つの物理的アクション——加速、並走、アーク放電とロック、引きの画——を描写します。Seedance 2.0 Ext は、区切りのない一続きのアクション記述よりも、時間付きのビートにはるかに確実に従います。
- このモデルの実際の失敗パターンに狙いを定めたネガティブリストであり、一般論ではありません:歪んだ列車の幾何学構造や余分な手足は、「移動する乗り物の上に立つロボット」のショットが崩れるときに現れる特有のアーティファクトであり、名指しで指定することでそれらを抑制できます。
技術 2:先頭・末尾フレーム補間
このクリップはほぼ同じ物語を語りますが、結末の構図も固定します——最終フレームを特定の内容に一致させる必要がある場合、たとえば次のショットへのトランジションや、正確な被写体の構図に有用です。
提供された先頭フレームと提供された末尾フレームの間で厳密に補間する、連続した12秒の縦型シネマティックショットを作成する。1枚目の画像が正確な開始状態であり、2枚目の画像が正確な最終状態である。全編を通じて、同じオレンジと白のモノレール、既存のオレンジ色のメンテナンスロボット、修復されたオレンジ色の屋根ケーブル、雨の山間都市、濡れた線路の質感、琥珀色の照明、青い霧を保持すること。0〜3秒:先頭フレームの線路の高さの視点から開始し、濡れた線路に沿って前方へ加速して屋根へ向かう。3〜7秒:屋根の横を並走し、ロボットは向かい風の中に踏ん張り、重いオレンジ色のケーブルを損傷した屋根のコネクタへ引き寄せる。自然なケーブルの張力、金属の摩擦、雨、水しぶきを表現する。7〜9秒:短い青いアーク放電、ケーブルが所定の位置にロックされ、列車の灯が瞬いてから安定する。9〜12秒:カメラは滑らかに列車の後方かつ上方へ移動し、提供された末尾フレームの構図に正確に到達する:列車の完全な後部が遠ざかっており、2本の平行な濡れたレールが前景の列車の下から明瞭かつ連続的に伸び、鉄道の高架橋を抜けて橋の先で収束する。最後の区間で列車の前部を決して見せないこと。鉄道の幾何学構造を物理的に一貫させ、あらゆる瞬間に線路の連続性が明瞭に見えるようにすること。サウンド:雨の当たる音、濡れた線路の振動音、低いうなる電流のハム音、ケーブルがロックされるカチッという音、制御された電力のサージ、遠くの雷鳴。セリフなし、テキストなし、ロゴなし、アニメ調なし、道路橋なし、線路のないホームなし、欠けた線路なし、余分なロボットなし、余分な手足なし、ジャンプカットなし。
技術 1 と比べて、変化しているのは以下の点です:
- 「提供された先頭フレームと提供された末尾フレームの間で厳密に補間する」と冒頭の一文で宣言します。これは、固定された終点があることをモデルに伝える指令であり、固定された出発点だけではありません。プロンプトの残りの部分は両者をつなぐ経路を描写します。
- 結末は意図的に過剰に指定されています:「列車の完全な後部が遠ざかっている」「2本の平行な濡れたレールが明瞭かつ連続している」「最後の区間で列車の前部を決して見せない」。終了フレームを固定するとき、最終構図に関する曖昧な表現こそが補間の漂流を招く箇所です。解決策は、冒頭のビートと同じくらい多くの幾何学的情報で最後の2〜3秒を描写することです。
- 結末のショット向けの新しいネガティブワード——「道路橋なし、線路のないホームなし、欠けた線路なし」——なぜなら、カメラが後方四分の三視点へ動くまさにその場所で、このモデルは線路の連続性を失いやすいからです。
どちらの技術を使うべきか?
既存の画像との連続性が正確な結末よりも重要な場合は先頭フレームアンカリングを選びましょう——静止画から「動き出す」プロダクトショットや、カメラワークとタイミングをモデルに即興で決めてほしいあらゆるシーンに適しています。
最終構図が決定的に重要な場合は先頭・末尾フレーム補間を選びましょう——そのフレームをカットポイントに一致させる必要がある場合、ループの開始フレームに戻す場合、あるいはサムネイルやシーケンス内の次のショット用に特定のアングルで着地させる場合です。代償は即興の自由度が減ることですが、その代わりに着地点が保証されます。
/v1/tasks で2つの技術を再現する
どちらの技術も同じモデル id seedance-2.0@ext を使用します——画像アンカリングに対応していない別ルートである、裸の seedance-2.0 id ではありません。リクエストボディの唯一の違いは、last_frame_url を提供するかどうかです。
先頭フレームアンカリング(first_frame_url のみ):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "提供された画像を正確な先頭フレームかつハードな視覚アンカーとして使用する……(上記の完全なプロンプト)",
    "first_frame_url": "https://your-storage.example.com/anchor-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
先頭・末尾フレーム補間(first_frame_url + last_frame_url):
{
  "model": "seedance-2.0@ext",
  "input": {
    "prompt": "提供された先頭フレームと末尾フレームの間で厳密に補間する、連続した12秒の縦型シネマティックショットを作成する……(上記の完全なプロンプト)",
    "first_frame_url": "https://your-storage.example.com/first-frame.jpg",
    "last_frame_url": "https://your-storage.example.com/last-frame.jpg",
    "aspect_ratio": "9:16",
    "duration": 12,
    "resolution": "1080p",
    "generate_audio": true
  }
}
いずれかのリクエストボディを /v1/tasks に POST し、その後 GET /v1/tasks/{taskId} をステータスが success になるまでポーリングし、output[0].url をすぐにダウンロードしてください——これらのリンクは期限切れになります。
@ext ルートの料金は解像度と尺だけで決まり、リアルタイム料金エンドポイントで確認済みです:
| 解像度 | 1秒あたりの料金 | 12秒クリップ |
|---|---|---|
| 720p | $0.149 | $1.79 |
| 1080p | $0.373 | $4.48 |
| 4K | $0.467 | $5.60 |
1フレームをアンカリングしても2フレームをアンカリングしても料金は同じです——last_frame_url によって追加料金が発生することはありません。
よくある質問
seedance-2.0@ext は画像から動画を生成できますか、それともテキストのみですか?
両方に対応しています。first_frame_url だけなら自由なカメラワークの画像から動画を生成できます。last_frame_url を追加すれば、2枚の固定画像の間で先頭・末尾フレーム補間ができます。
first_frame_url なしで last_frame_url を使えますか?
いいえ——last_frame_url が存在する場合、API は first_frame_url の提供を必須とします。末尾だけをアンカリングすることはできません。
なぜ基礎の seedance-2.0 モデル id ではなく seedance-2.0@ext を使うのですか?
画像アンカリングのサポート(first_frame_url/last_frame_url)と参照画像からの動画生成入力を持ち、独自の料金体系を持つのは @ext ルートです。基礎ルートは別のより制限された製品ラインです。
このようなナラティブショットにはどの解像度を選ぶべきですか? 1080p は公開するあらゆるコンテンツの実用的なデフォルトです——720p はケーブルや雨のテクスチャなどの細かいディテールが明らかに甘くなり、4K はコストが720pの約3倍で、視聴者がネイティブ解像度で見ることはほとんどないナラティブクリップとしては割に合いません。
自分で試してみる
上記の2つのクリップはどちらも hiapi の Seedance 2.0 Ext モデルページで生成されたもので、そこでは完全なパラメータ schema を確認し、プレイグラウンドで直接プロンプトをテストできます。このモデル向けのコピー可能な出発点をもっと探しているなら、Seedance 2.0 Ext プロンプトレシピにさらに多くが収録されており、このワンカット POV トラバース解説では同じモデル上で3つ目のカメラワーク制御技術を解説しています。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする