MiniMax
MiniMax H3 Image
minimax-h3-image/text-to-image
Modello di immagini MiniMax: generazione da testo e modifica con 1–16 immagini di riferimento condividono lo stesso set di capacità, output fino a 4K, supporto per dieci formati e proporzioni automatiche, ideale per concept design, visual commerciali e creazione multi-stile
Prova minimax-h3-image/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image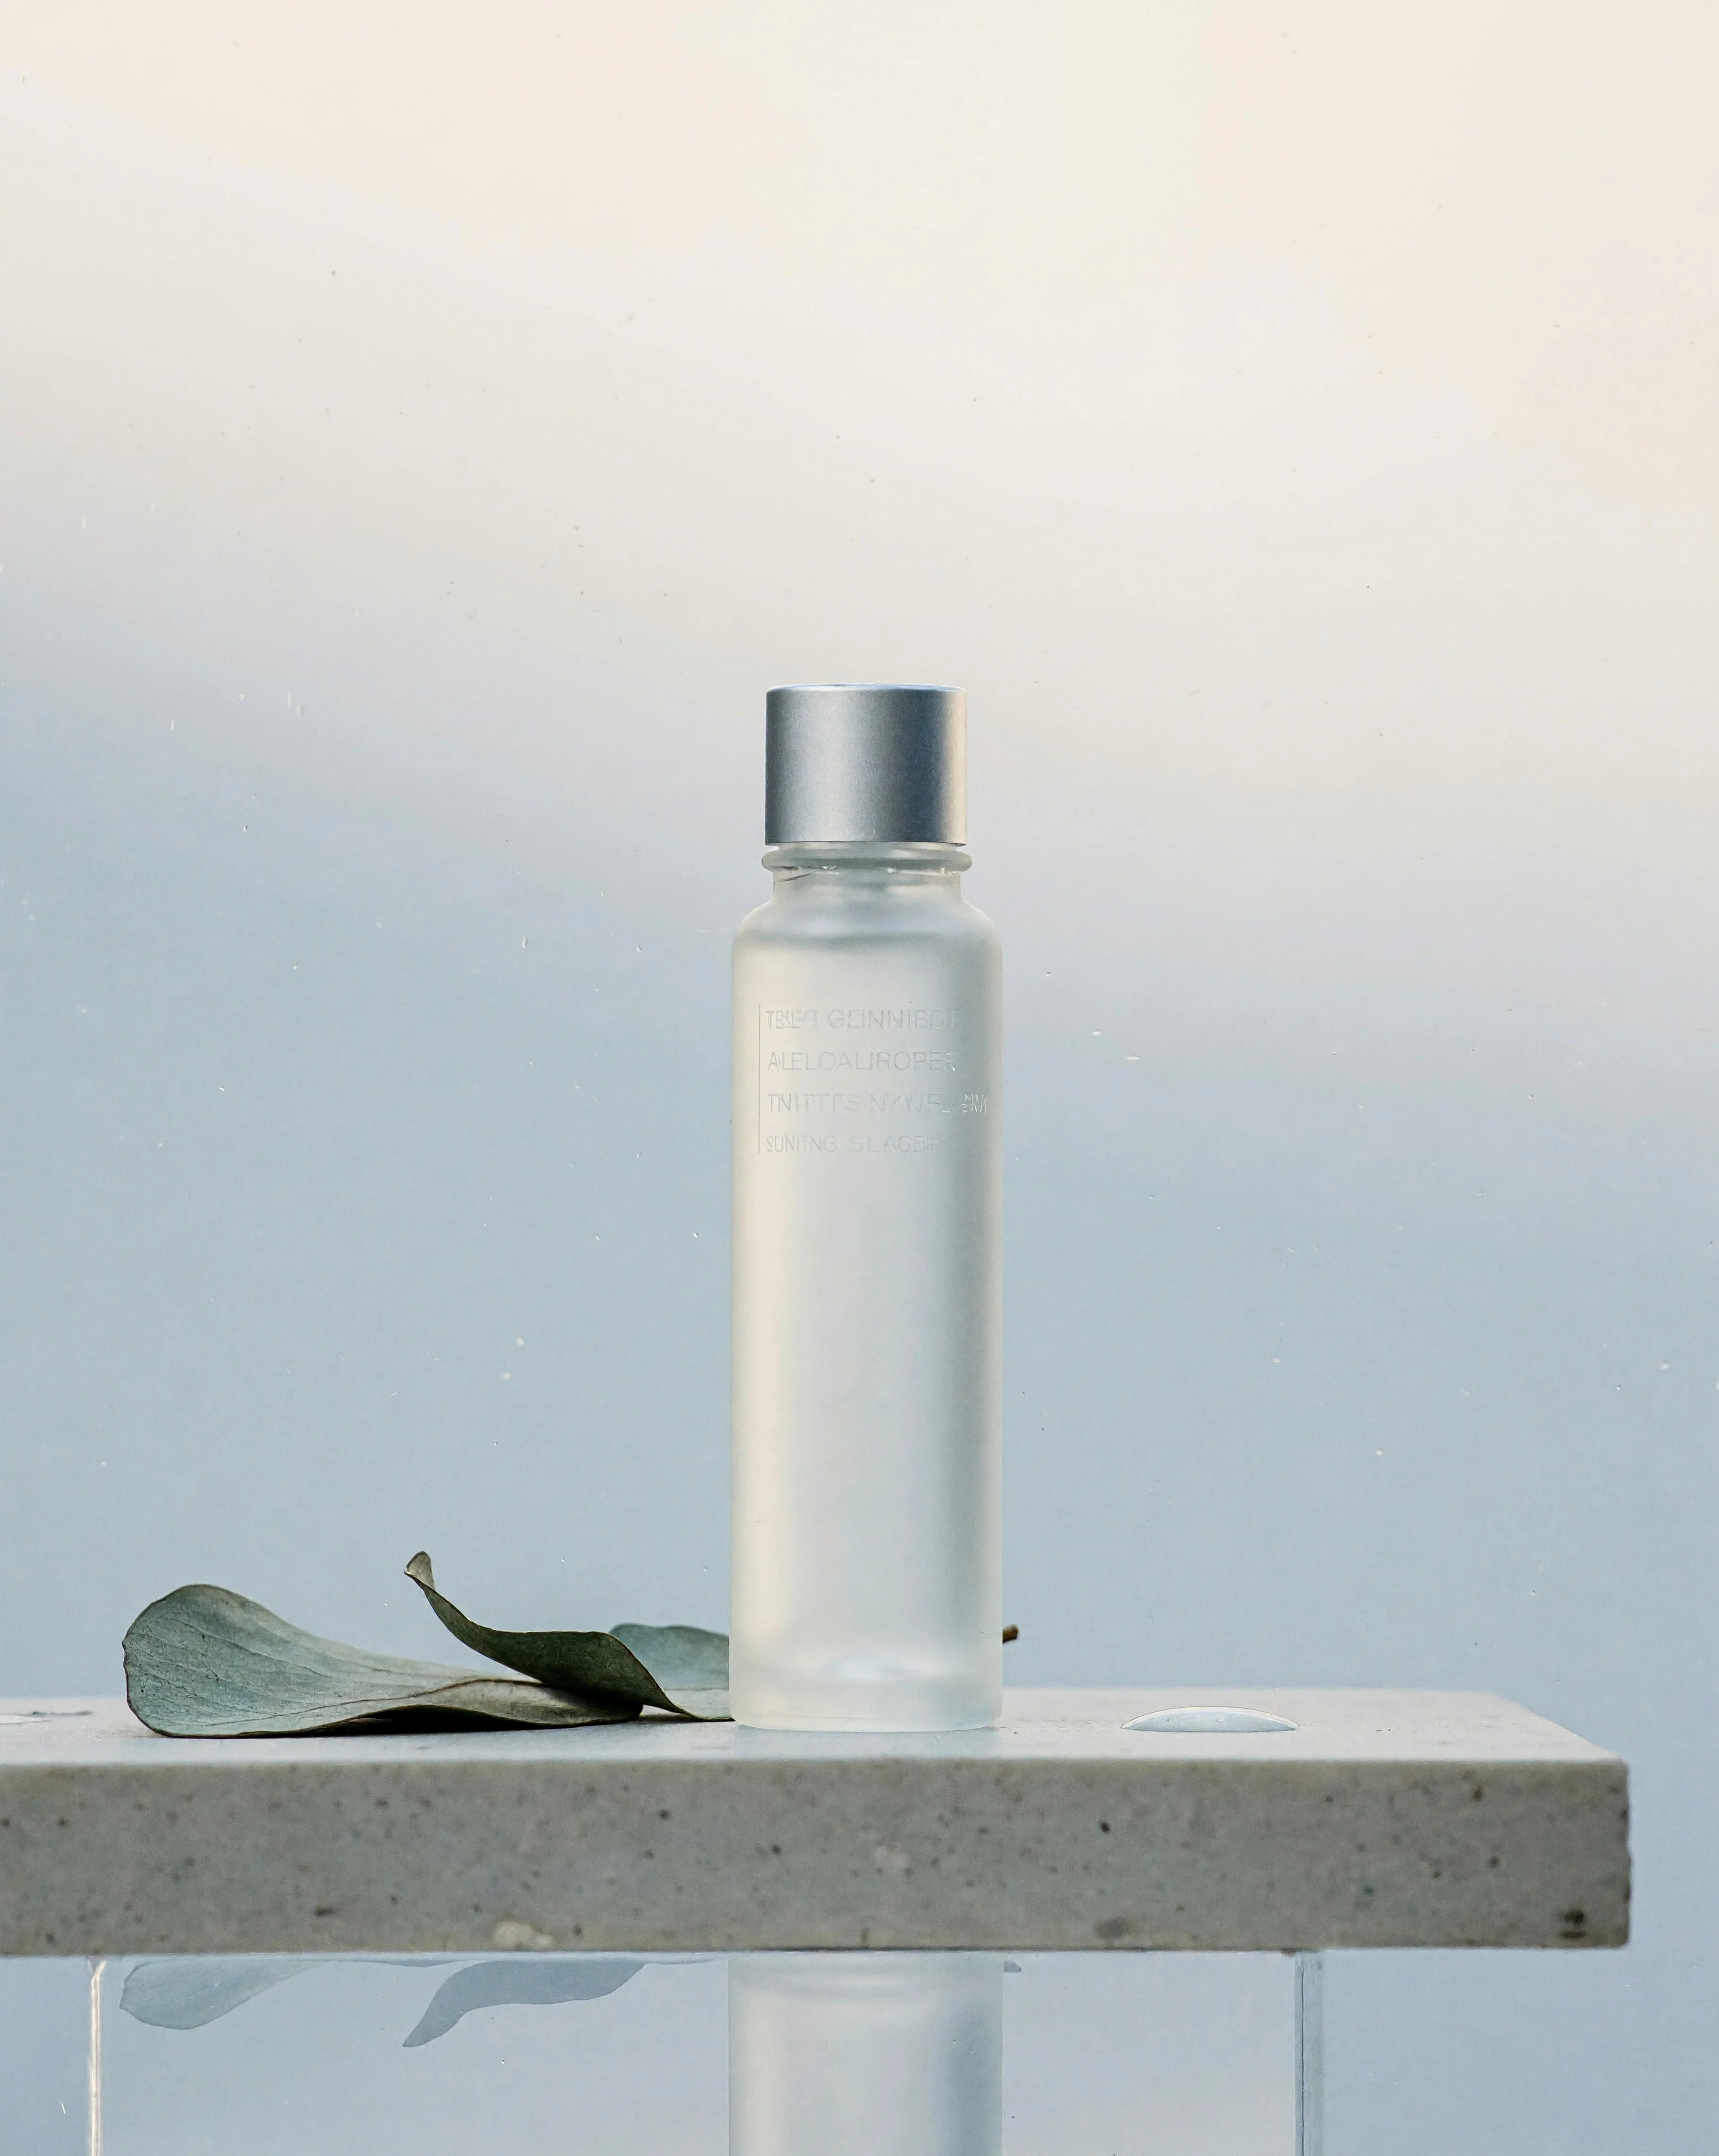
Flacone di siero opaco · Natura morta su pietra per fotografia commerciale
Stile Immagine del prodotto · Natura morta · Illuminazione da studio
Prompt
Un flacone di siero per la cura della pelle in vetro smerigliato, in posizione verticale su una base in microcemento grigio chiaro. La superficie opaca appare morbida grazie alla texture del vetro; sul fronte è presente una piccola etichetta incisa con lettere minuscole e illeggibili. Accanto al flacone sono appoggiate due foglie di eucalipto essiccate e una goccia d'acqua limpida. Un grande softbox è posizionato dietro e di lato, delineando lungo il bordo del flacone un sottile riflesso allungato, mentre una luce di riempimento discreta schiarisce il lato in ombra. Una base bassa in acrilico riflette una tenue sagoma sfocata del flacone. Lo sfondo passa da un grigio chiaro dai toni freddi in basso a un bianco avorio dai toni caldi verso l'alto, con particelle di polvere finissime sospese nell'aria. Profondità di campo ridotta, messa a fuoco nitida sulla spalla e sul tappo del flacone, spazio negativo silenzioso sopra e intorno al soggetto, raffinata composizione di natura morta commerciale, texture realistiche di vetro e pietra, color grading naturale.
Copia il prompt completo e adattalo alla tua generazione.
Tag
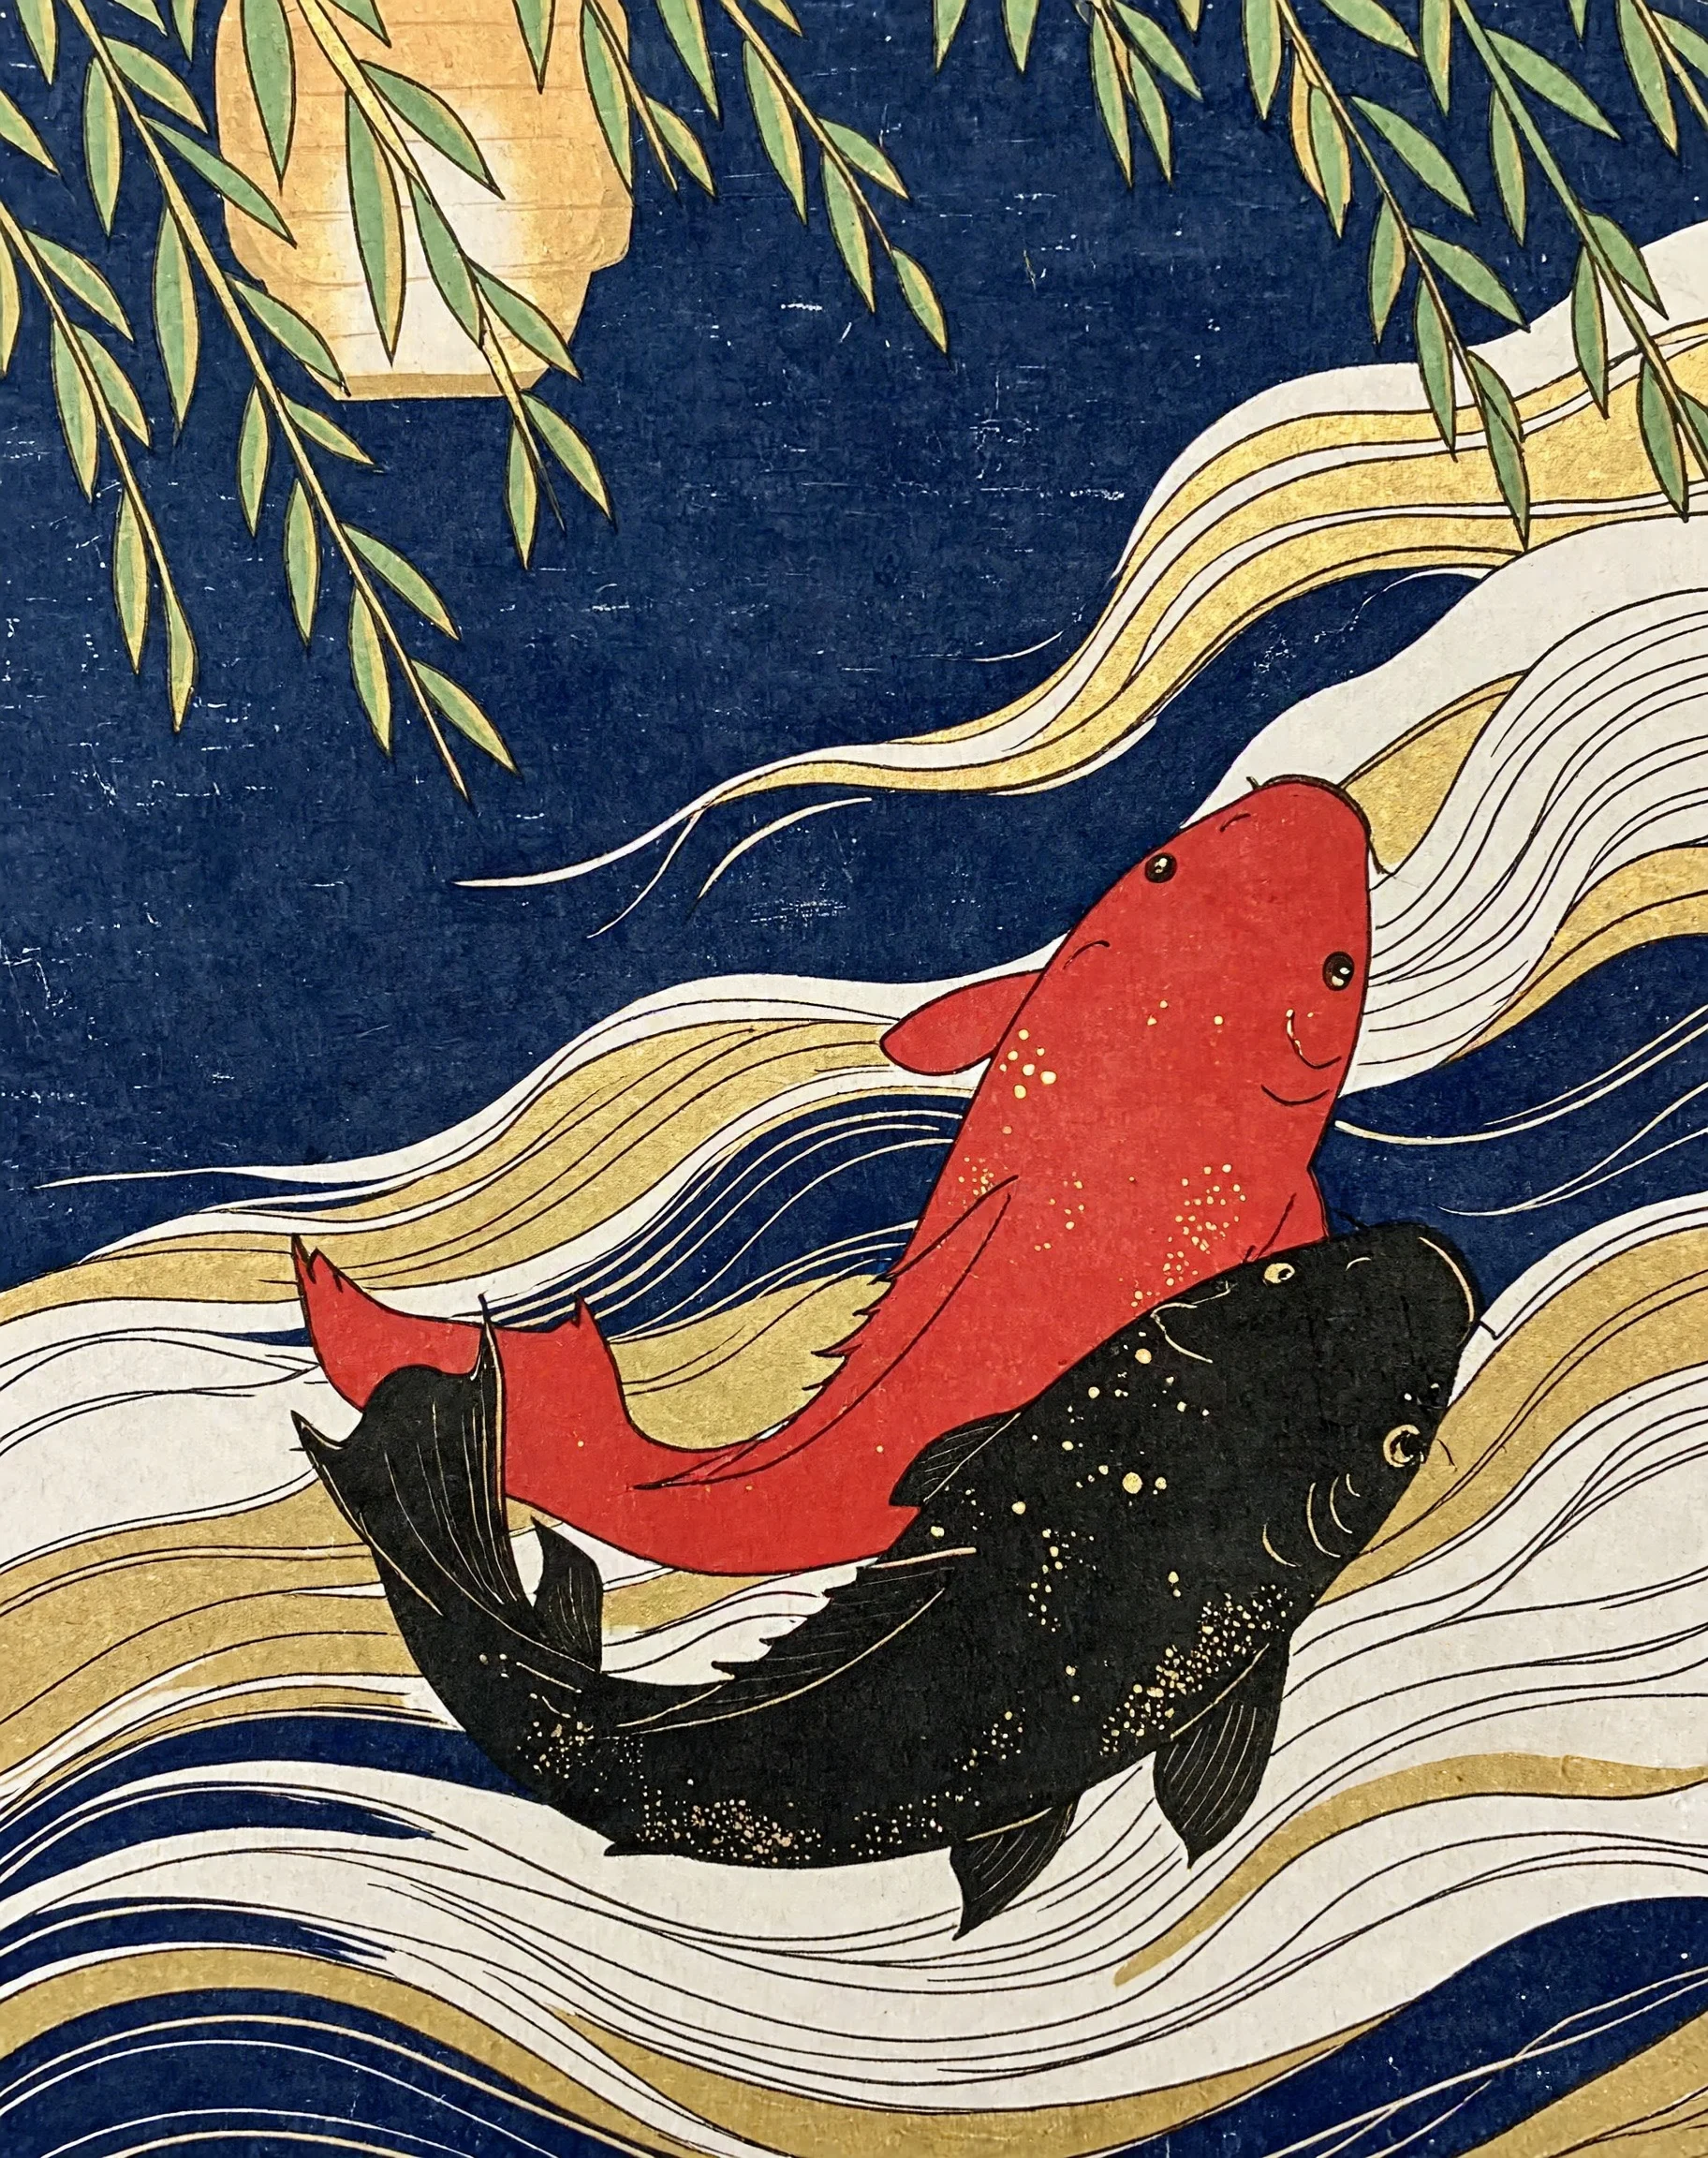
Koi Ukiyo-e · Scaglie d'oro nella traversata notturna
Stile Ukiyo-e · japanese-print · Illustrazione artistica
Prompt
Illustrazione in stile ukiyo-e, due koi nuotano in un'acqua blu indaco profondo, una vermiglia e una nero inchiostro, con le scaglie punteggiate di frammenti di foglia d'oro; motivi ondulati sovrapposti incisi in fasce di colore piatte, contorni nitidi e taglienti, mentre il corpo dei pesci mantiene una volumetria morbida e umida con sottili riflessi luminosi. Rami di salice piangente e il bagliore caldo di lanterne di carta in lontananza compongono la parte superiore, lasciando ampio spazio alla superficie d'acqua; granulosità della xilografia e texture visibile della carta, palette contenuta dominata da indaco, vermiglio, oro e bianco avorio, con il flusso dell'acqua in una morbida direzione diagonale.
Copia il prompt completo e adattalo alla tua generazione.
Tag
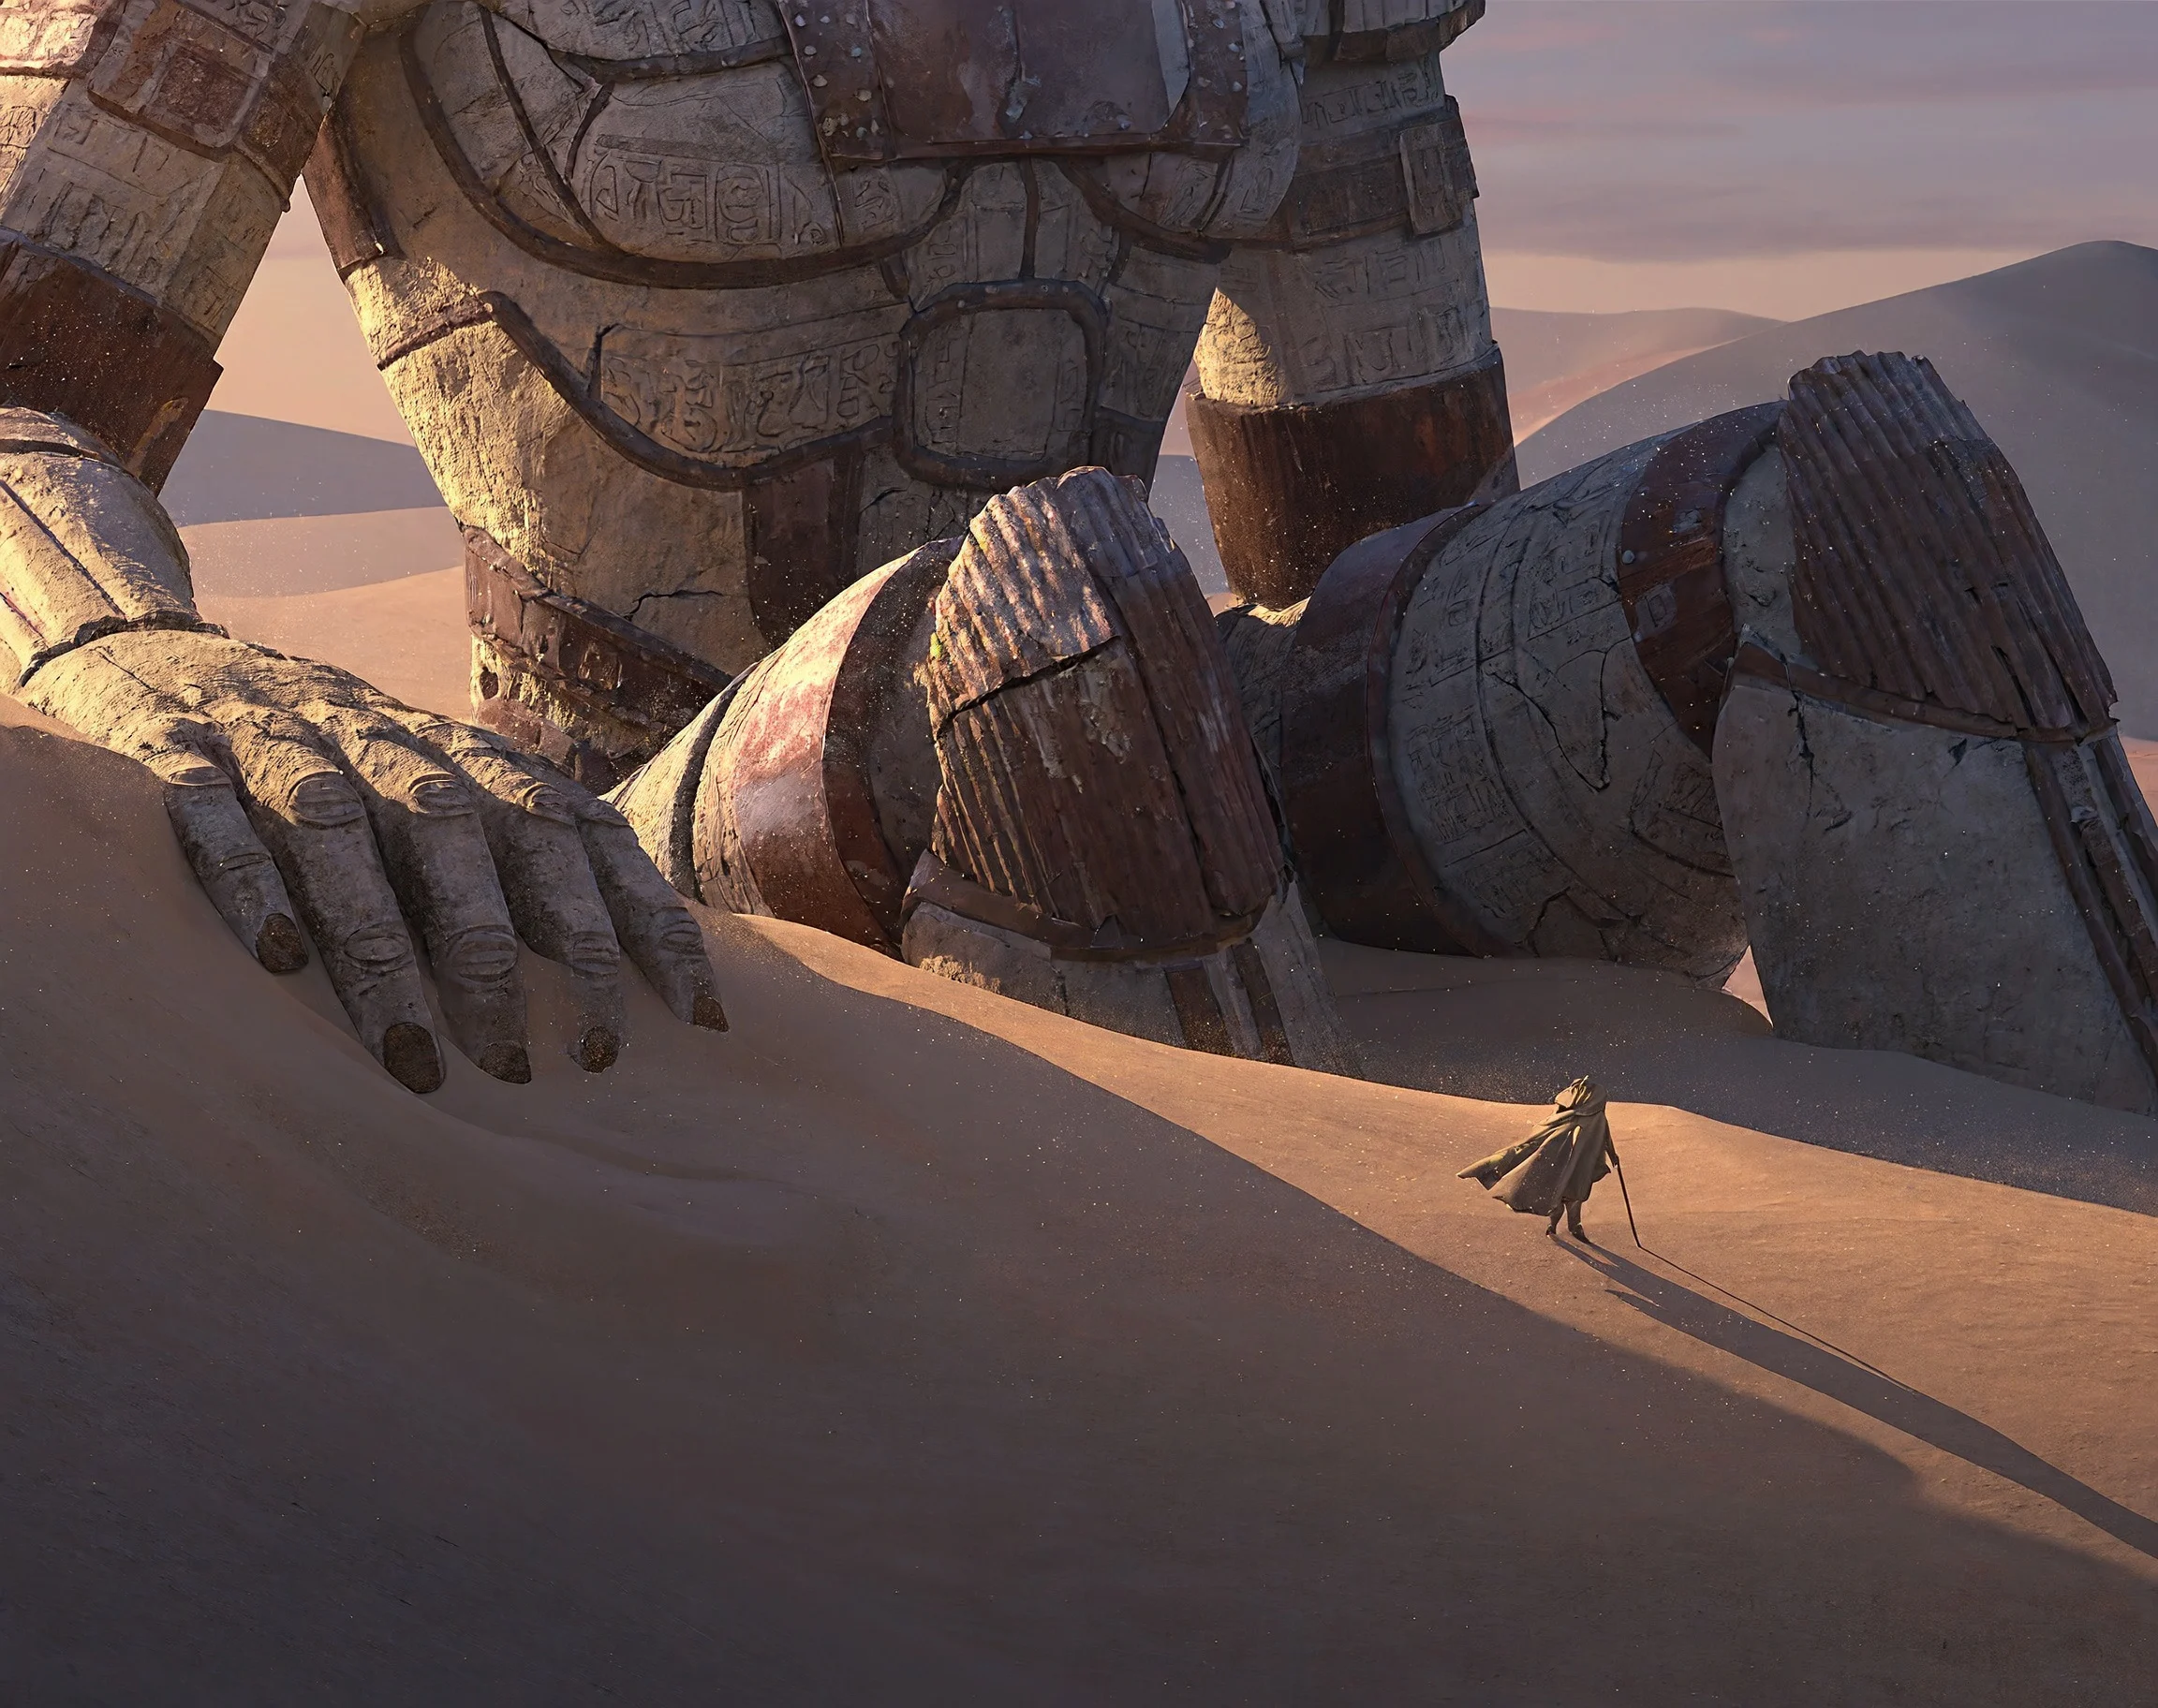
Colosso nel mare di sabbia · Scenario concettuale delle rovine al crepuscolo
Stile Costruzione del mondo · Fantascienza · Atmosfera
Prompt
Un enorme colosso antico è semi-sepolto in un deserto di sabbie mobili senza fine; la pietra erosa e il guscio metallico corroso sono coperti da strati sovrapposti di sculture consumate, e una mano gigantesca emerge dalla sabbia. Un piccolo viaggiatore solitario avvolto in un lungo mantello percorre il crinale di una duna vicina, proiettando un'ombra allungata e apparendo insignificante davanti al colosso. La luce del tramonto dell'ora d'oro arriva obliqua di lato, dorando i bordi della statua con una calda luce di contorno ambrata, mentre le dune in lontananza svaniscono gradualmente in una morbida foschia polverosa; nell'aria, minuscoli granelli di sabbia scintillano nella luce. Rendering di concept art in stile pittorico, con dettagli materiali realistici, morbide tonalità ocra e grigio-violacee, profonda profondità atmosferica, scala epica, atmosfera silenziosa e misteriosa.
Copia il prompt completo e adattalo alla tua generazione.
Tag
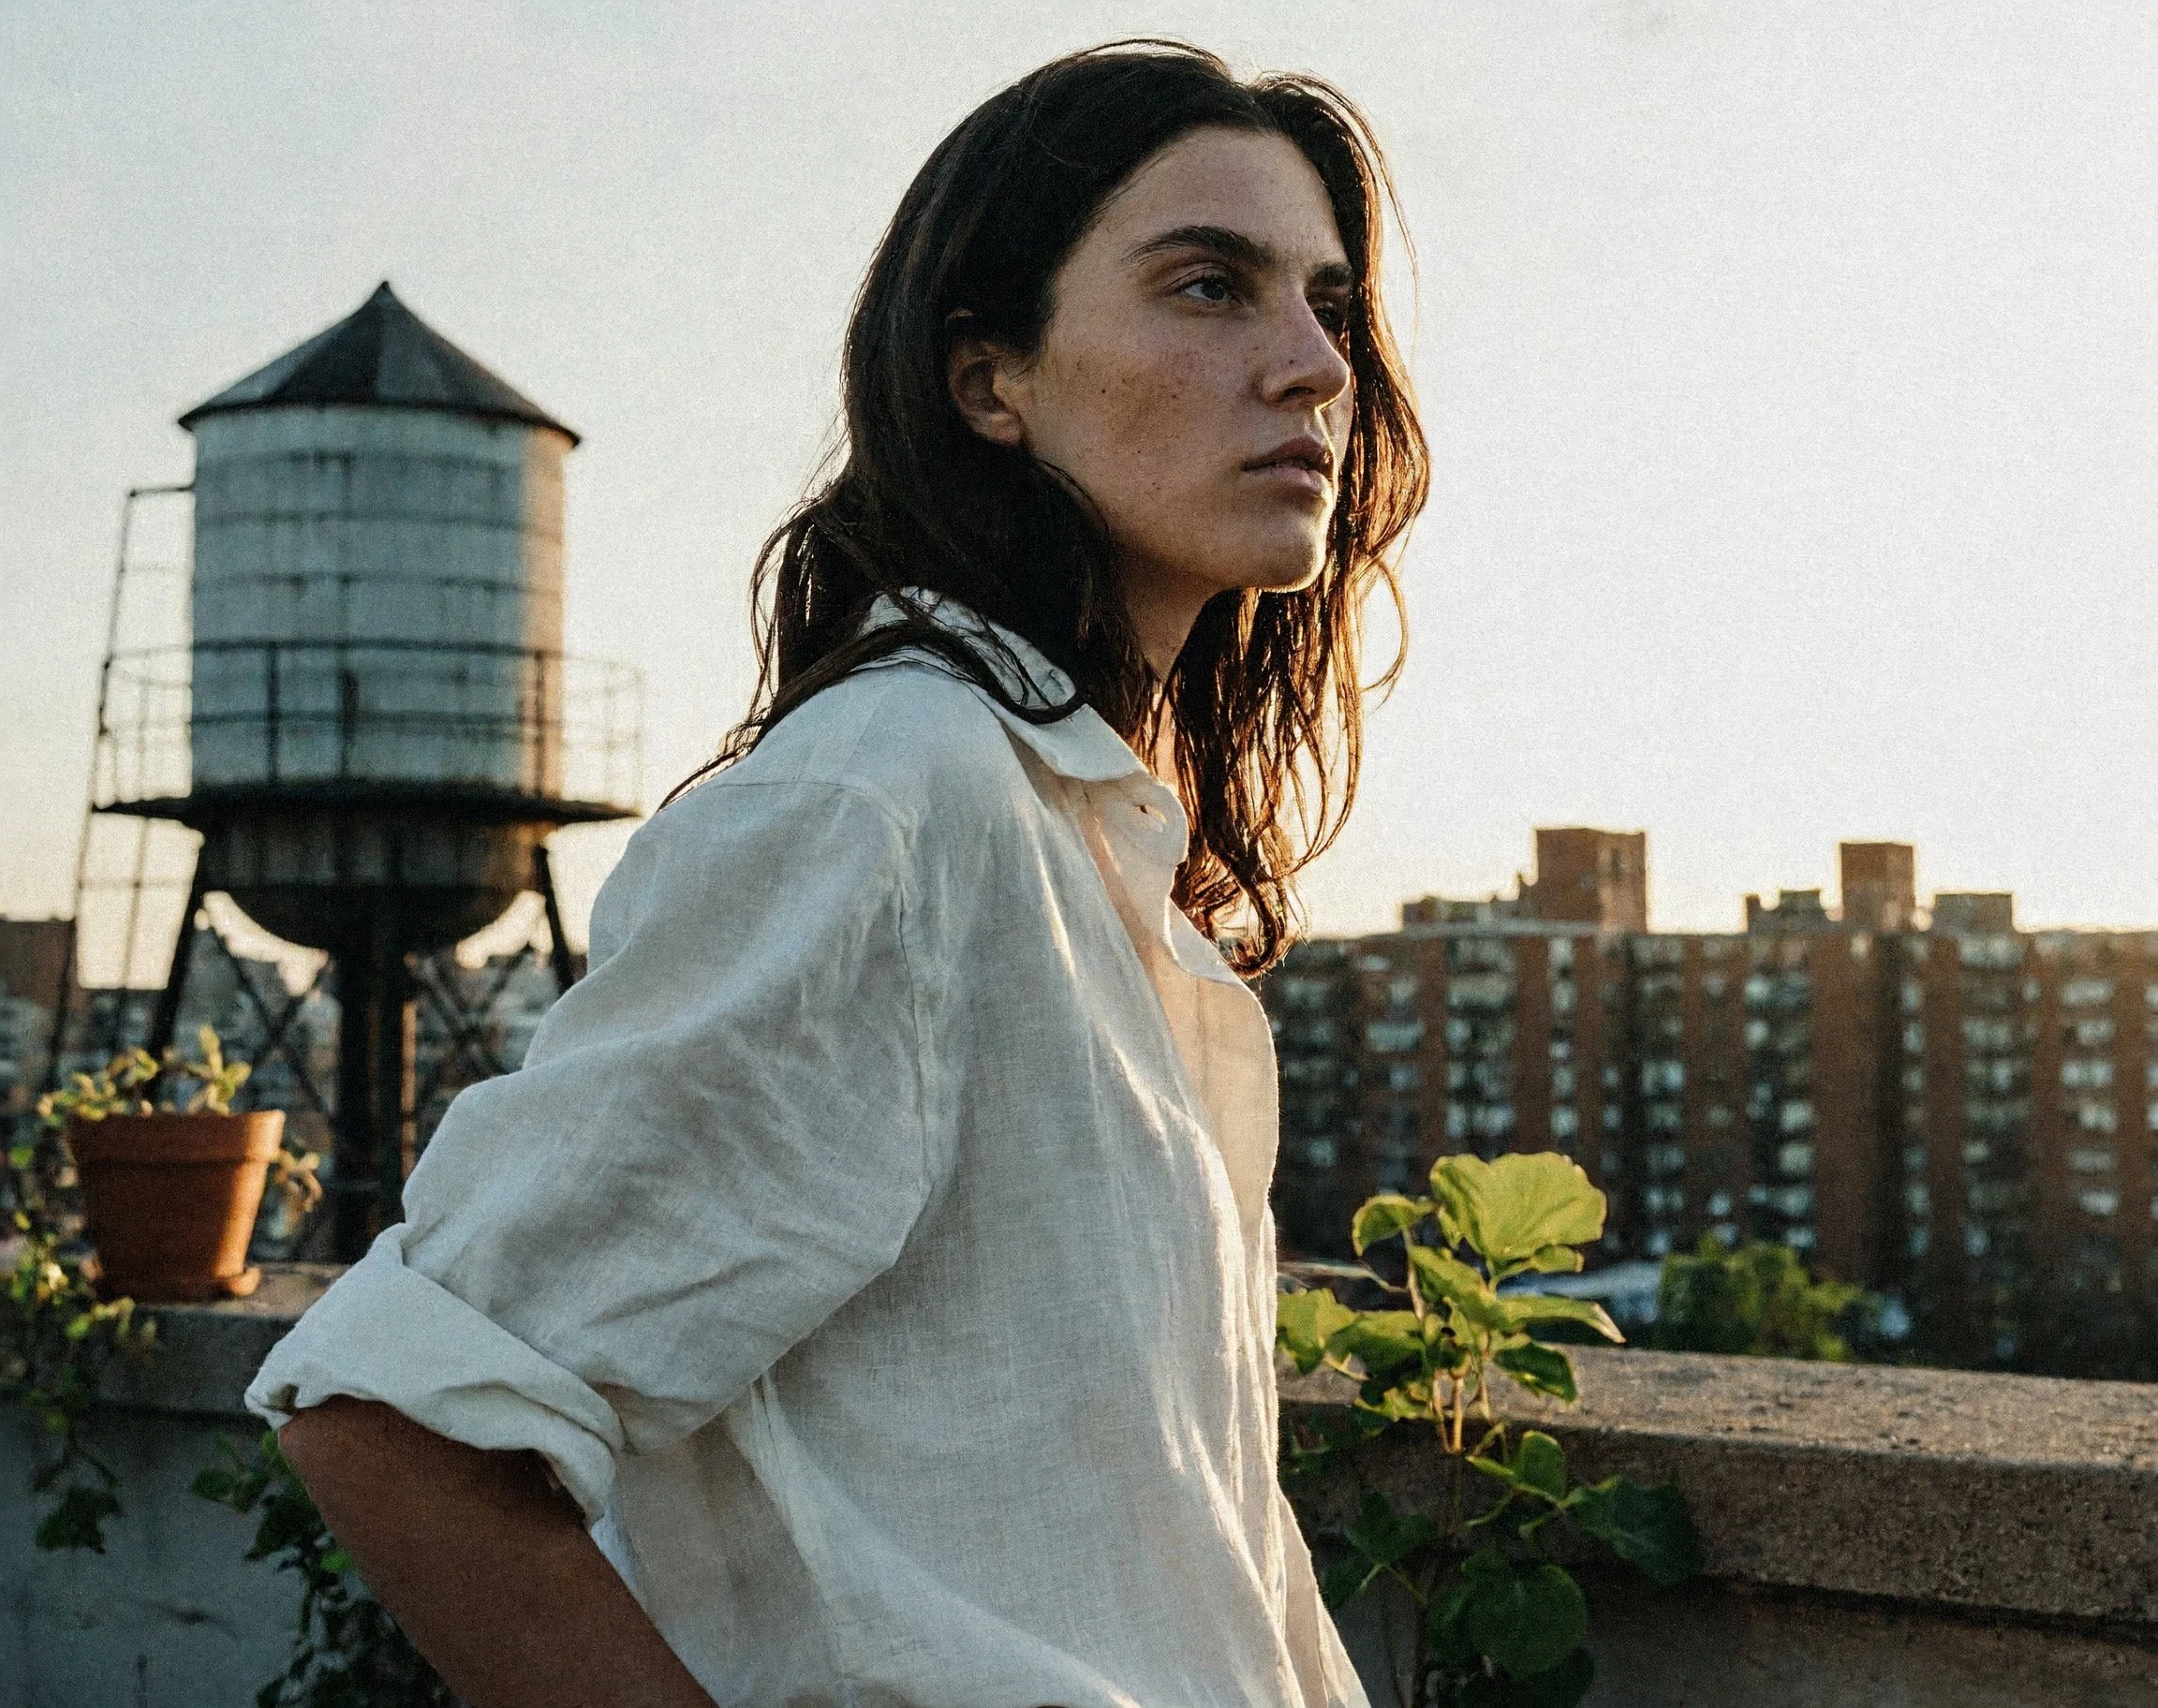
Tetto nel pomeriggio · Ritratto con luce laterale in stile pellicola
Stile Ritratto e fotografia · Qualità cinematografica · Ora d'oro
Prompt
Ritratto di una giovane donna che indossa una camicia ampia in lino color bianco sporco, in piedi sul bordo di un tetto urbano al tramonto. Il viso è leggermente voltato verso il sole basso; la luce del tramonto le disegna un caldo contorno dorato sui capelli scuri sciolti e avvolge il lato in ombra del viso in un morbido e delicato chiaroscuro. Dietro di lei, una torre dell'acqua e un gruppo di condomini in lontananza si dissolvono in una sfocatura leggera; un basso parapetto in cemento e alcuni vasi di piante verdi compongono il primo piano. Texture naturale della pelle, pori sottili e lentiggini leggere visibili, grana simile a quella della pellicola, palette calda a bassa saturazione abbinata a ombre fredde, profondità di campo ridotta, qualità da servizio fotografico di una rivista di moda.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
minimax-h3-image/text-to-image per image
| Specifiche | Prezzo unitario |
|---|---|
| 1K | $0.0129 |
| 2K | $0.0129 |
| 4K | $0.0393 |
Panoramica
Questo è un modello che genera immagini statiche a partire da una descrizione testuale. Basta inserire un prompt per ottenere un'immagine conforme alla descrizione, con la possibilità di controllare il livello di risoluzione, le proporzioni e il formato di output. Se necessario, puoi anche fissare un seed casuale per rendere riproducibile il risultato con lo stesso prompt e le stesse impostazioni. È pensato per designer, creator di contenuti e sviluppatori che hanno bisogno di concretizzare rapidamente le proprie idee, ed è adatto alla creazione di concept art, immagini di atmosfera e vari tipi di materiale visivo.
Punti distintivi
- Espansione automatica del prompt: il prompt inviato viene automaticamente ampliato con ulteriori dettagli, favorendo una resa visiva più ricca.
- Più livelli di risoluzione selezionabili: la risoluzione di output può essere scelta tra 1K, 2K e 4K, corrispondenti a circa 1, 4 e 16 megapixel.
- Supporto di diverse proporzioni: sono integrate numerose proporzioni da 1:1 a 21:9, oltre alla selezione automatica, per adattarsi a diverse esigenze di impaginazione.
- Seed fisso per la riproducibilità: impostando un seed intero tra 0 e 2147483647 è possibile riprodurre il risultato ottenuto con lo stesso prompt e gli stessi parametri.
Descrizione delle capacità
Generazione di immagini da testo: inserendo un prompt che descrive l'immagine, il modello genera un'immagine statica. Il prompt deve contenere da 1 a 5000 caratteri.
Controllo del livello di risoluzione: è possibile scegliere la risoluzione di output tra 1K, 2K e 4K, corrispondenti a circa 1, 4 e 16 megapixel; il valore predefinito è 2K.
Controllo delle proporzioni: sono supportate le proporzioni 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9 e la proporzione automatica; il valore predefinito è 1:1.
Scelta del formato di output: è possibile scegliere il formato JPEG o PNG; i file PNG sono più voluminosi, circa 12 MB a 2K e circa 30 MB a 4K.
Seed casuale fisso: è disponibile un seed intero da 0 a 2147483647 per riprodurre il risultato con lo stesso prompt e gli stessi parametri; se non impostato, viene generato casualmente.
Scenari d'uso
- Concept designer per personaggi e scene: inserendo una descrizione testuale di un personaggio o di una scena si genera una concept image stilizzata, utile per proposte preliminari e sviluppo visivo.
- Creator di contenuti per la realizzazione di illustrazioni: scrivendo un prompt basato sul tema di un articolo o di un video si genera un'immagine adatta all'impaginazione, utilizzabile direttamente per la pubblicazione dei contenuti.
- Produzione di materiale visivo commerciale: scegliendo il livello 4K e proporzioni elevate si generano materiali ad alta risoluzione per pubblicità o materiali espositivi.
- Generazione massiva di immagini per sviluppatori: mediante combinazioni di seed fissi e parametri è possibile generare in blocco asset grafici riproducibili, da integrare nelle pipeline di design o di contenuto.
Limiti e consigli per la scelta
Il prompt è obbligatorio, può contenere al massimo 5000 caratteri e non può essere composto solo da spazi. Il livello di risoluzione, le proporzioni e il formato di output vanno scelti tra i valori ammessi, senza possibilità di personalizzare i valori numerici. Il seed è limitato a un numero intero da 0 a 2147483647. Il risultato è un'immagine statica: ogni richiesta produce un'immagine.
Novità
Vedi il changelog →- Nuovo modello MiniMax H3 Image è disponibile: generazione di immagini da testo e modifica con riferimenti multipli
Domande frequenti
Vedi tutte le domande →-
Quante immagini di riferimento si possono fornire al massimo?
L'immagine in ingresso accetta al massimo 16 immagini di riferimento alla volta, minimo 1, in formato JPG, PNG o WEBP, con un lato compreso tra 128 e 8192 px e un peso massimo di 20 MB per immagine. Ogni immagine di riferimento costa altri $0.0036, ad esempio 2K con 3 immagini di riferimento costa in totale $0.0129 + 3 × $0.0036 = $0.0237. Quando scrivi il prompt, fai riferimento a ciascuna immagine con numerazioni come Picture 1, Picture 2 seguendo l'ordine di invio, così il modello può associare correttamente gli oggetti che vuoi modificare o combinare.
-
Come si determinano le dimensioni di output e quanto possono essere grandi?
La risoluzione è disponibile in tre livelli: 1K, 2K e 4K, pari rispettivamente a circa 1 MP, 4 MP e 16 MP; il valore predefinito è 2K. Il rapporto può essere auto oppure 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9; scegliendo auto, è il modello a decidere in base al prompt e all'immagine di riferimento, mentre per una composizione fissa occorre specificarlo esplicitamente.
-
Come si deve scrivere il prompt per preservare l'aspetto del personaggio?
Organizza il testo in quest'ordine: «descrivi prima il soggetto da mantenere, poi scrivi la parte da modificare, infine indica le immagini con un numero»: ① inizia con una o due frasi che fissano i tratti esteriori del soggetto, come acconciatura, abbigliamento, combinazione di colori e dettagli distintivi; ② poi specifica la scena desiderata, la posa, l'inquadratura e l'illuminazione; ③ quando devi fare riferimento a un'immagine di riferimento, scrivi «la persona in Picture 1», numerando più immagini nell'ordine in cui vengono fornite. Il prompt ha un limite massimo di 5000 caratteri; inserire i dettagli nel corpo del testo è più efficace che accumulare aggettivi.
-
Come si crea una serie di immagini di ambientazione multiangolazione dello stesso personaggio?
Inizia usando un'immagine di riferimento chiara e senza occlusioni del soggetto come Picture 1, fissa la descrizione delle caratteristiche del personaggio nel prompt, poi genera un'immagine alla volta cambiando solo la descrizione dell'angolazione o della posa, ad esempio frontale, laterale, posteriore, mezzobusto e figura intera, con proporzioni fisse 3:4 o 1:1. Mantenere lo stesso seed per ogni immagine aiuta a ridurre le differenze casuali; la coerenza stilistica della serie si mantiene principalmente grazie all'immagine di riferimento e alla descrizione fissa del soggetto.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: minimax-h3-image/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per minimax-h3-image/text-to-image e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionalemin 0max 2147483647Seme casuale fisso, utilizzato per rendere i risultati riproducibili; usare un numero intero, se omesso viene utilizzato un seme casuale.
promptstringObbligatoriominLength 1maxLength 5000pattern \SPrompt di descrizione dell'immagine, lunghezza 1–5000 caratteri; il prompt viene espanso automaticamente per mostrare dettagli più ricchi.
resolutionstringOpzionalePredefinito: "2K"Livello di risoluzione dell'output, 1K circa 1 MP, 2K circa 4 MP, 4K circa 16 MP; predefinito 2K.
1K2K4Kaspect_ratiostringOpzionalePredefinito: "1:1"Proporzioni dell'output; se impostato su auto il modello sceglie autonomamente, predefinito 1:1.
auto1:15:44:54:33:43:22:3Mostra tutto (3)Mostra meno
16:99:1621:9output_formatstringOpzionalePredefinito: "jpeg"Formato dell'immagine di output, predefinito jpeg; i file PNG sono notevolmente più grandi (2K circa 12 MB, 4K circa 30 MB).
jpegpngcallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "minimax-h3-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "minimax-h3-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "minimax-h3-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 GPT Image 2.5 OpenAI $0.017 /immagine
-
 MiniMax H3 Image MiniMax $0.013 /immagine
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
-
 FLUX.2 Black Forest Labs $0.035 /immagine
-
 BRIA Product Shot Bria $0.058 /immagine
-
 Krea 3 Krea $0.036 /immagine
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Seedream 5.0 ByteDance $0.025 /immagine
-
 FASHN Tryon v1.6 FASHN $0.107 /immagine
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /immagine
-
 GPT Image 2 OpenAI $0.007 /immagine
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /immagine