
比較レビュー
FLUX.1 Fill Pro vs Kontext Max:マスク再描画か画像全体の編集か
同じリビング、同じ目標で、片方はマスクを使い、片方はプロンプトだけを使う。2 組の出力を並べて見比べます。
一箇所だけを変え、それ以外はそのままにしたいなら FLUX.1 Fill Pro を選びます。元画像、同サイズの白黒マスク、プロンプトを渡すと、白い領域が再描画され、黒い領域はそのまま残ります。画像全体のスタイルを作り直したい、マスクを描きたくないなら FLUX.1 Kontext Max を選びます。元画像とプロンプトを渡すだけで、境界はテキストの記述に任せます。
FLUX.1 Fill Pro は HiAPI に公開済みです。モデルページを開く とそのまま生成でき、新規ユーザー登録で 200 ポイントが付与されます。Kontext Max のモデルページはこちらです。両モデルの単価は同じで、いずれも 1 枚あたり $0.0715 です。
1 つの表で違いを把握
| FLUX.1 Fill Pro | FLUX.1 Kontext Max | |
|---|---|---|
| 入力 | 元画像 + 白黒マスク + プロンプト | 元画像 1 枚 + プロンプト |
| マスクが必要か | 必要。サイズは元画像と一致させる | 不要 |
| 変更範囲は何で決まるか | マスクの白い領域 | プロンプトの記述 |
| 出力比率 | 元画像に従う。画角パラメータなし(比較サンプルは 1440 × 810) | 比較サンプルは元画像の比率(1328 × 752) |
| パラメータ | steps 15–50(デフォルト 50)、guidance 1.5–100(デフォルト 60)、seed、output_format | 元画像とプロンプトによって決まる |
| 単価 | $0.0715 / 枚 | $0.0715 / 枚 |
| 適したタスク | 部分置換、商品のレタッチ、背景の置換、服の色替え | 画像全体の再描画、スタイルの作り直し |
単価は同じです。本当の違いは「誰が変更境界を決めるか」です。Fill Pro は白黒マスクで決め、Kontext Max は一文のプロンプトで決めます。
同じ画像・同じ目標で、両者の出力はどう見えるか?
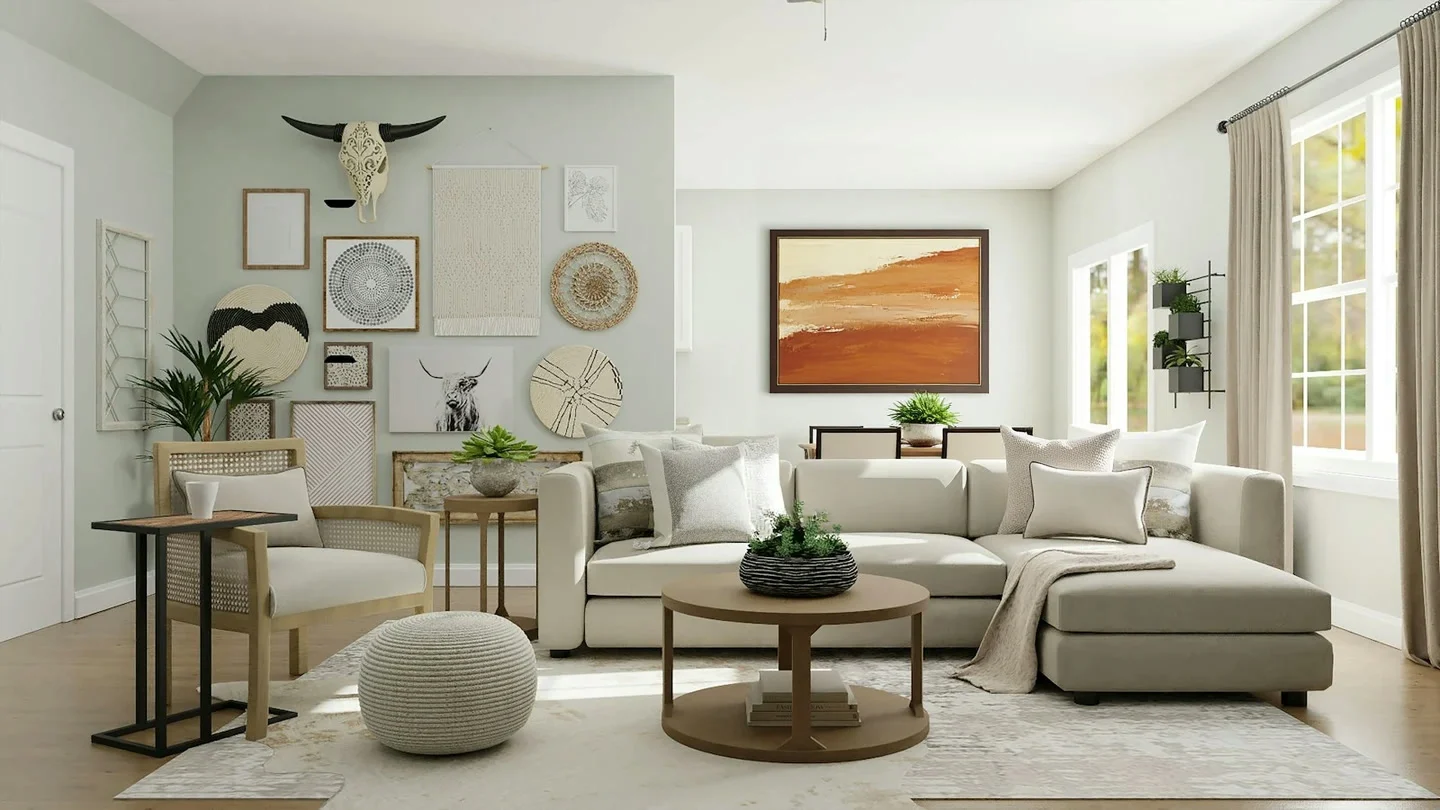
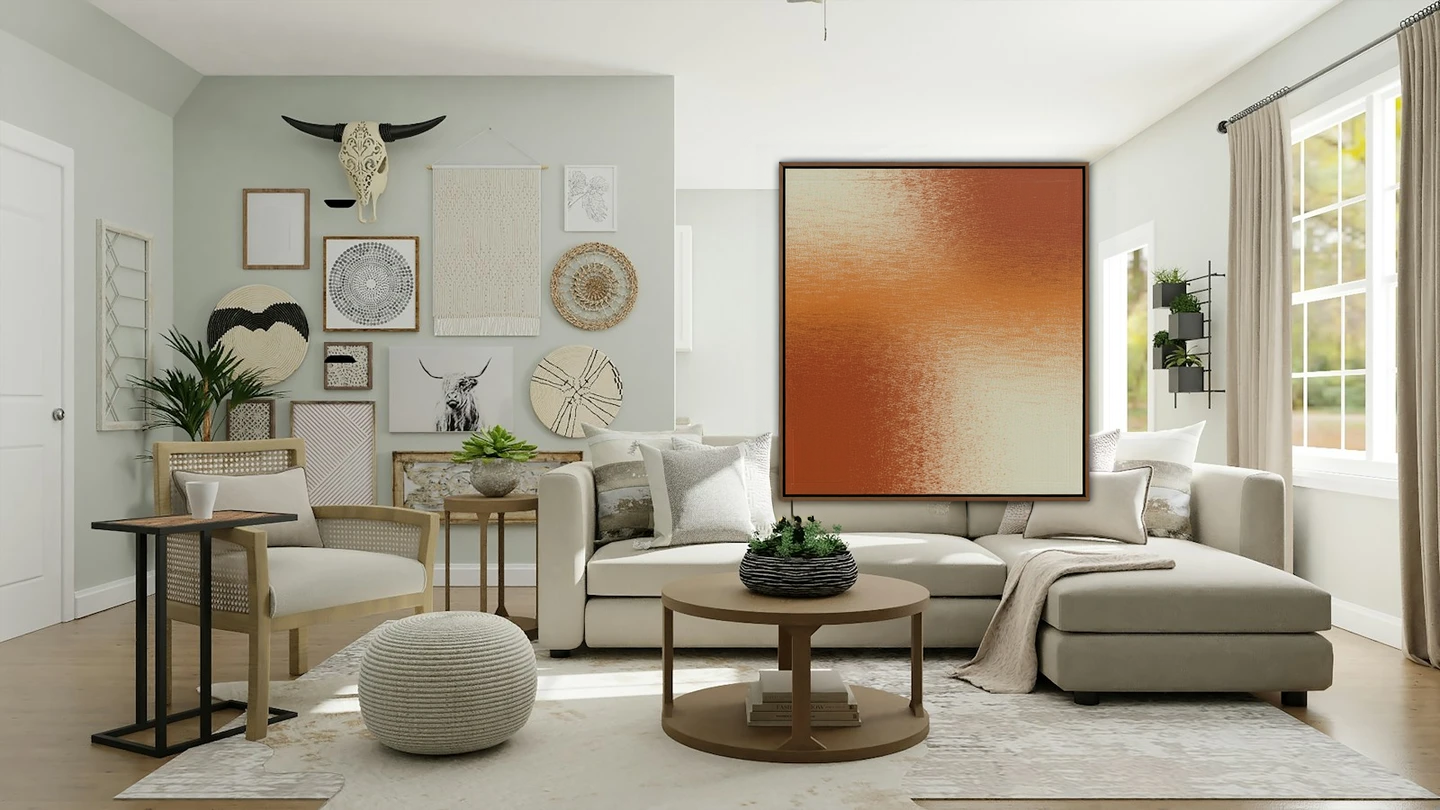
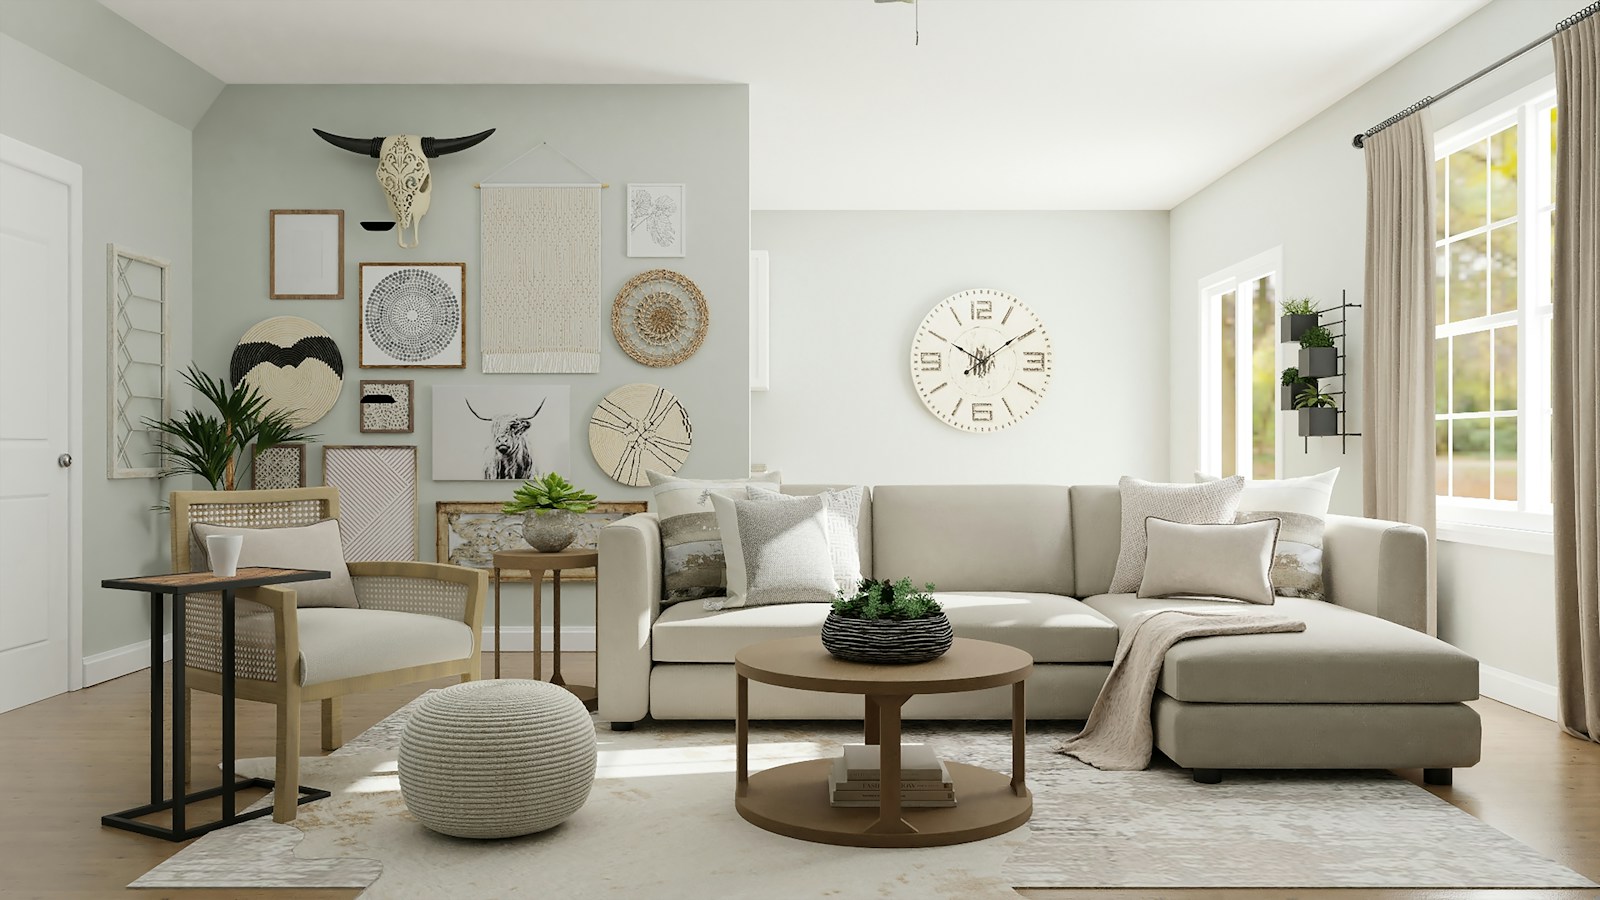
元画像はリビングで、白い壁に丸い掛け時計が掛かっています。左の壁にはタペストリー、編み皿、バイソンの頭骨、観葉植物があり、右側は大きな窓とコーナーソファです。目標は「掛け時計の部分の壁を大きな抽象画に替える」ことです。
| FLUX.1 Fill Pro | FLUX.1 Kontext Max |
|---|---|
 |
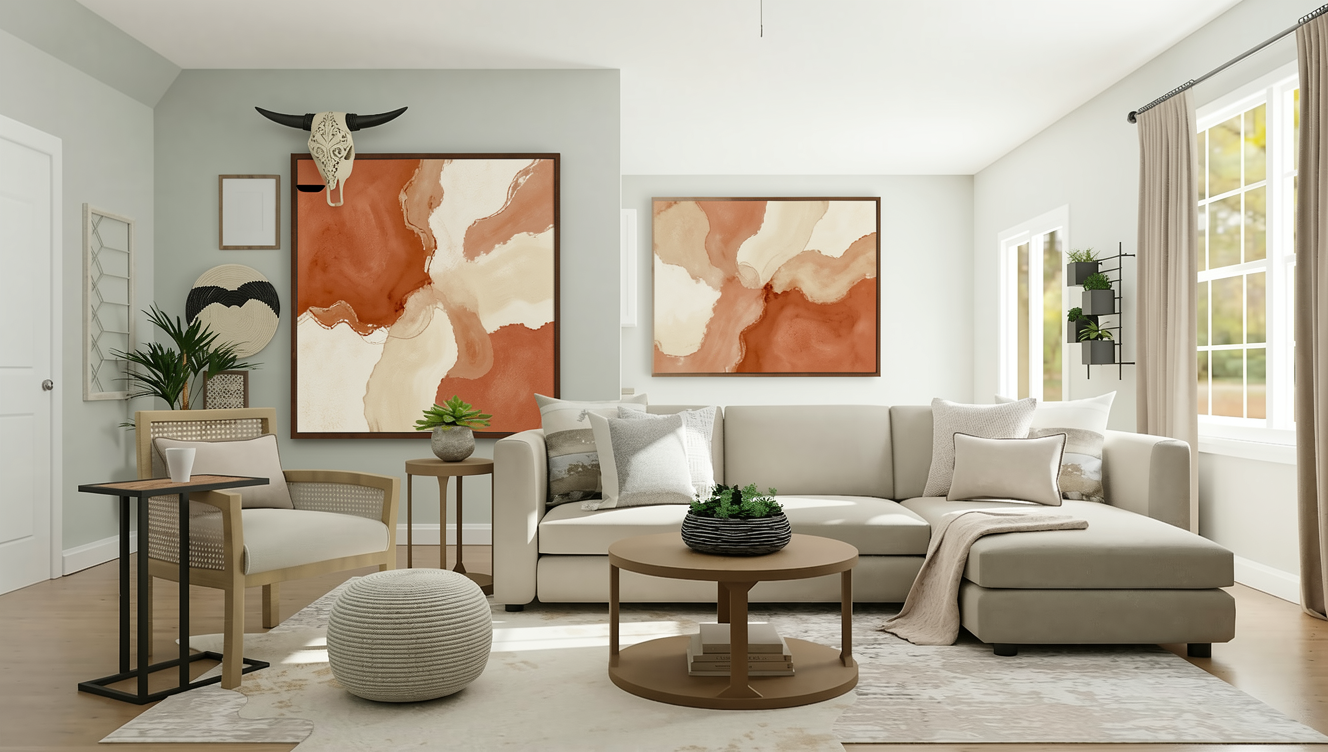 |
| 元画像 + 白枠マスク + プロンプト、出力 1440 × 810 | 元画像 + プロンプト(マスクなし)、出力 1328 × 752 |
同じ元画像、同じ目標で、それぞれ 1 回ずつ生成しました。両者の入力は異なります。Fill Pro は元画像 + 同サイズの白枠マスク + プロンプトが必要で、変更範囲はマスクで決まります。Kontext Max は元画像 + プロンプトだけで、マスクのフィールドはなく、境界はすべてテキスト次第です。2 枚の差を「マスクの有無」という 1 つの変数だけにするため、両方とも同じプロンプトを使いました。
日常的に Kontext Max を使う場合は、プロンプトで領域を自分で書き出す必要があります。たとえば replace the area on the wall where the clock hangs with … のように。今回の比較ではそう書かなかったため、壁一面の装飾すべてを描き直しました。これはまさに違いを示しています。マスクがなければ境界は言い回し次第であり、言い回しを限定しなければ結果の範囲は広がってしまいます。
A large framed abstract painting in warm terracotta, sand and cream tones, hanging on the wall, with a thin dark wood frame; keep the room, sofa, furniture and lighting unchanged.
このプロンプトで生成 → プロンプトは自動で入力されます。元画像の欄は空で、マスク欄にはデフォルトでサンプルマスクが入っているので、元画像と同サイズの白黒マスク(黒を保持、白を再描画)に差し替えてから実行してください。
上の元画像は 1600 × 900 で、マスクも 1600 × 900 です。白い四角は掛け時計の部分の壁だけを囲んでいます。
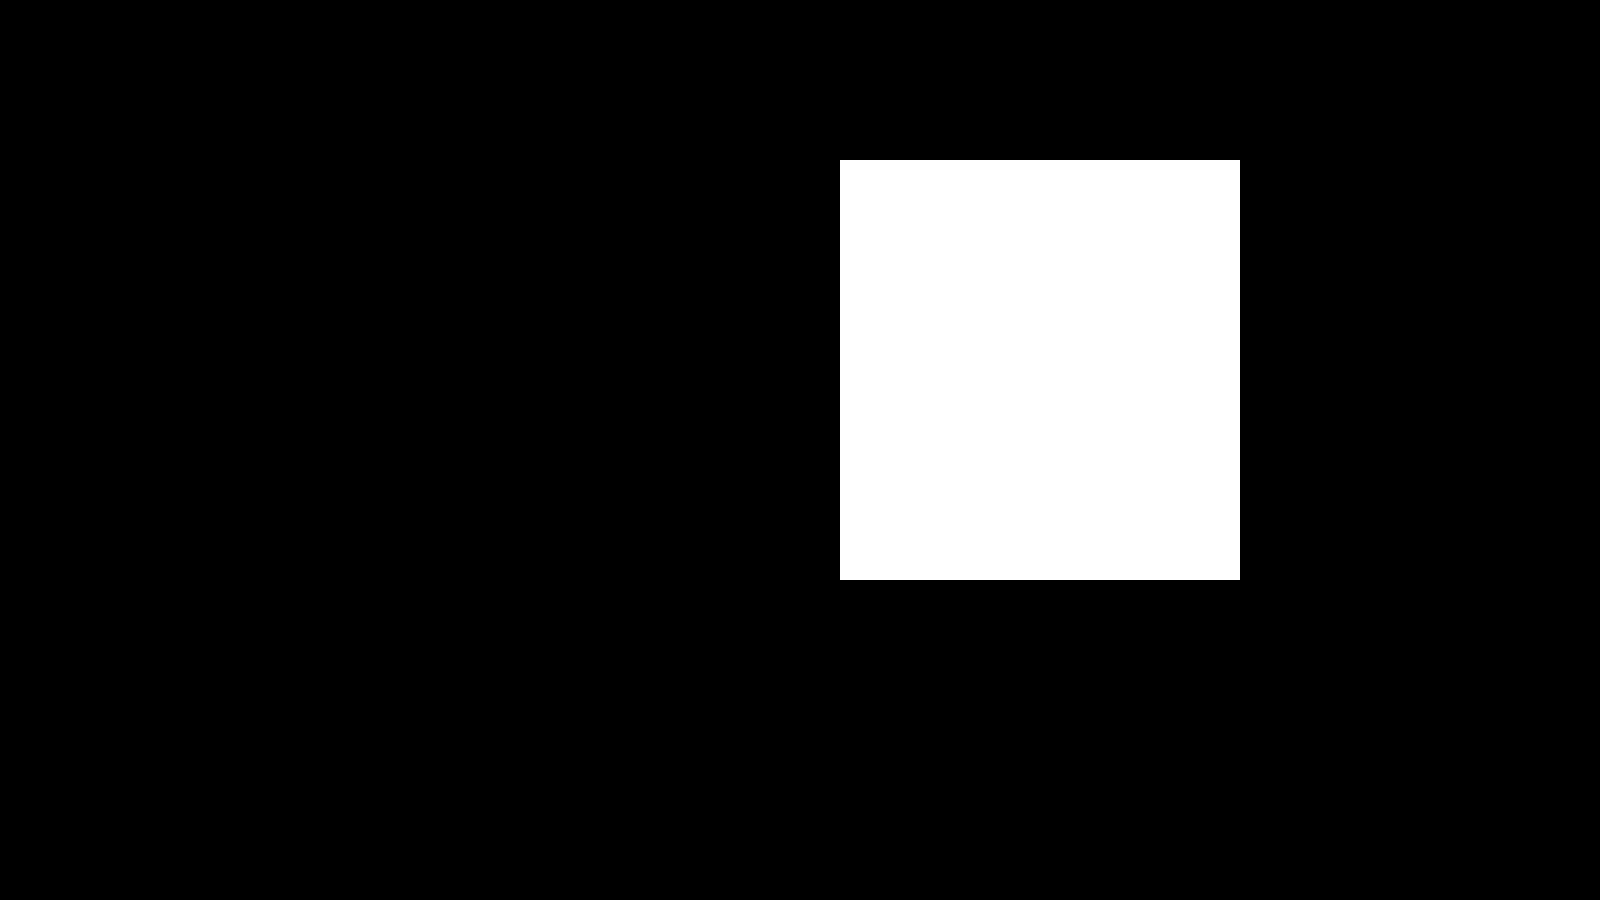
黒は保持、白は再描画します。四角の外はすべて黒なので、四角の外の画面は再描画されません。
目に見える違いはどこか?
- 変更範囲。 Fill Pro はマスクの四角の中だけを変えました。Kontext Max はマスクがなく、画像全体を描き直しました。左側の壁の丸皿、バイソンの頭骨、編み掛け飾り、壁の小さな絵が、すべて新しい波紋模様の抽象画に置き換わりました。
- 画面のその他の部分。 Fill Pro の出力では、四角の外にある左側の壁のタペストリー、編み皿、バイソンの頭骨、観葉植物、ソファ、光の当たり方はすべてそのままです。四角の中には濃い色の細い額縁も追加されています。Kontext Max は右側の窓とソファのレイアウトを保っていますが、画面の内容は全体的に変わっています。
- 出力サイズ。 Fill Pro は 1440 × 810、Kontext Max は 1328 × 752 を返します。どちらも元画像の比率に合わせて 32 の倍数に微調整されており、比率は一致しますがピクセル数は異なります。元画像に重ねる場合は、まずサイズを統一してください。
シーン別の選び方
- EC 画像で傷を 1 本消し、商品全体を保持したい → Fill Pro
- 背景を替えたいが、カップ、影、カメラ位置は動かせない → Fill Pro
- 服の色だけを変え、しわや腕はそのままにしたい → Fill Pro
- 間取り図で家具 1 点、ドア 1 枚のスタイルを替えたい → Fill Pro
- 画像全体のスタイル、色調、画風を変えたい → Kontext Max
- 手元にマスクツールがなく、描きたくもない → Kontext Max
- 変更対象の境界が不規則だが、一文で説明できる(「空を夕暮れに替える」) → Kontext Max
- Kontext Max を試したら境界がずれて修正できない → Fill Pro でマスクを 1 枚追加
一方から他方への切り替えは面倒か?
面倒ではありません。両モデルは同じ非同期インターフェース POST https://api.hiapi.ai/v1/tasks を使い、同じ API Key で、どちらも taskId を返します。ポーリングまたは callback.url で結果を取得でき、単価はどちらも 1 枚あたり $0.0715 です。切り替えで変わるのは 2 点だけです。
model:flux-1-fill-proをflux-1-kontext-maxに変えます。input.mask:Fill Pro から Kontext Max に切り替えるときは削除します。不要になるためです。逆方向に切り替えるときは、元画像と同サイズの白黒マスクを追加します。input.prompt:Fill Pro から Kontext Max に切り替えた後は、プロンプトに「どこを変えるか」を一文追加します。たとえばreplace only the wall area where the clock hangsのように。マスクが境界を引いてくれなくなるためです。
input.image は両モデルで書き方は同じです。完全なリクエスト例とパラメータの意味は FLUX.1 Fill Pro API の使い方 を参照してください。
よくある質問
2 つのモデルの価格は同じですか? 同じです。どちらも 1 枚あたり $0.0715 で、成功した生成に対して課金され、失敗時は事前に確保した分が自動で返還されます。
Fill Pro はマスクを渡さなくても使えますか?
使えません。input.image、input.mask、input.prompt の 3 つがすべて必須で、マスクは元画像と同サイズの白黒画像でなければなりません。
Kontext Max はマスクを描けますか? マスクのフィールドは受け付けず、変更範囲はすべてプロンプトの記述に依存します。プロンプトに「どこを変えるか」と「何を保持するか」を明確に書くと、境界が安定しやすくなります。
一箇所だけ変えたいがマスクが描けない場合は? Kontext Max でまず画像全体を再描画するか、セグメンテーションツールで元サイズの PNG マスクを書き出してから Fill Pro に戻ります。どちらのルートも単価は同じなので、それぞれ 1 枚ずつ試して比較できます。
すぐに違いを見たい場合は、上のプロンプトをコピーして Fill Pro で 1 枚生成 してください。元画像とマスクは自分のものに差し替えるのを忘れずに。次に model を Kontext Max に変えて同じプロンプトで生成し、2 枚を並べて見比べてください。
FLUX.1 Fill Pro シリーズ記事
関連記事
すべての記事を見る →-

比較レビュー
Wan 2.6 Flash vs Wan 2.7:アップグレードすべきか?
720Pの予算と1080Pのキツネ・自動車完成品。組ごとに音声条件と実際のグレードを明記。
-

比較レビュー
Vidu Q4 Preview vs Kling 3.0:image-to-videoはどう選ぶ?
デフォルトで音声あり、16秒、5段階の解像度ならVidu Q4 Preview。開始・終了フレームで画面を固定するならKling 3.0。水上飛行機とバリスタの2組、同一プロンプトでの比較付き。
-

比較レビュー
Replicate の代替案:hiapi と Replicate の画像・動画生成比較(2026年)
Replicate から hiapi へ移行する際、予測呼び出し、webhook、課金をそれぞれどう変更するか、10 ステップの移行チェックリスト付き。