
使用ガイド
gemini-4-neon 導入ガイド:テキスト能力の境界、接続パラメータとコスト管理
開発者向けの接続判断と実践のポイント
このページの内容
gemini-4-neon とは何か、誰に適しているか
gemini-4-neon は Google が提供するテキスト出力モデルです。名前の情報は分解して見ることができます。提供元は Google、出力モダリティはテキストであり、文字を返し、画像・音声・動画は生成しません。この点がシステム内での位置づけを決めます。すなわち、入力の理解とテキスト生成を担当し、マルチモーダルなレンダリングの役割は担いません。
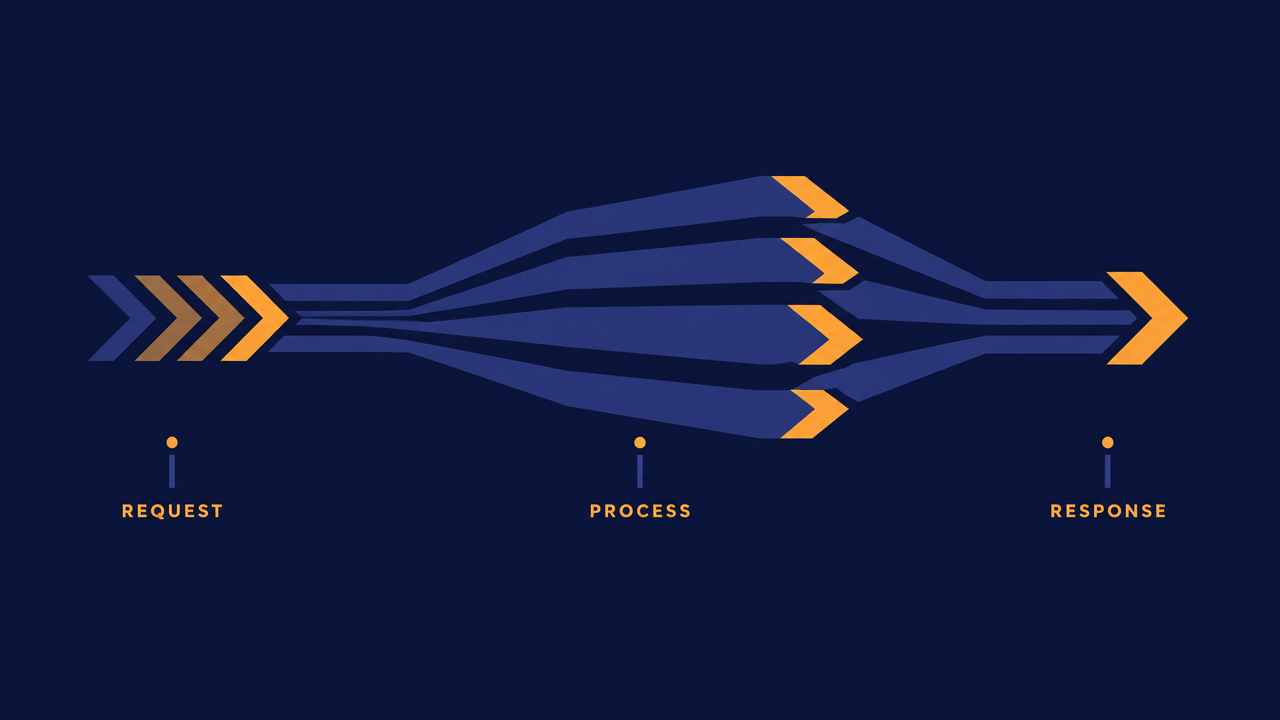
アーキテクチャ上、この種のモデルは通常、アプリケーション層とモデル提供元の間にある単方向のテキストストリーム上に位置します。業務コードが入力を組み立て、モデルがテキストを返し、その後の解析・表示・永続化はコード側で決めます。この単方向の経路を理解することが重要です。その後のすべてのパラメータ設計、エラー処理、コスト見積もりの境界を決めるからです。
本記事の対象読者は、モデル選定と接続判断を行おうとするエンジニアリングチームです。バックエンドやプラットフォームのエンジニア、API ゲートウェイとクォータ管理を担当する担当者、そしてリリースに向けたコスト予算を策定する技術責任者です。三つの点を中心に展開します。何を担わせるのに適しているか、統一インターフェース経由で呼び出す際にどのパラメータに注目すべきか、そしてトークン課金の前提でコストをどう抑えるかです。
すでに純テキストモデルで生成系の要件を解決することが決まっており、「モデルを替える」ことによる業務コードへの影響を最小限にしたいなら、読み進めるほど的を射た内容になります。モデルの詳細ページは gemini-4-neon を参照してください。
主要パラメータ一覧
- 呼び出し方式:Chat Completions インターフェース
/v1/chat/completions、モデル名gemini-4-neon。レイテンシに敏感でないバッチ処理にはgemini-4-neon@flexを利用できます。 - コンテキストと出力:コンテキストウィンドウ 1,048,576 トークン、1 回の最大出力 65,536 トークン。
- 思考レベル:
reasoning_effortはlow/medium/highを選択可能。レベルが高いほど推論が深くなり、所要時間とトークン消費も増えます。 - 調整可能なパラメータ:
temperature(0–2)、top_p(0–1)、max_tokens/max_completion_tokens、stream。現在ツール呼び出し(function calling)は公開されていません。 - 価格(100 万トークンあたり):標準ラインは入力 $4.54、出力 $22.68、キャッシュヒット時の入力 $0.227。@flex ラインは入力 $2.27、出力 $11.34、キャッシュヒット時の入力 $0.113。@flex はレイテンシが高く、上流の容量が逼迫すると先に拒否される可能性があるため、リアルタイム対話には不向きです。
能力の境界:純テキスト出力にできること・できないこと
モデルを誤った場所で使うことは、パラメータを間違えるよりも大きな代償になることがよくあります。「純テキスト出力」という事実に基づき、タスクを二種類に分けて考えられます。
安心して任せられるタスク
- テキスト生成と書き換え:要約、拡張、推敲、トーンの調整、形式変換(自然言語の記述を構造化テキスト断片に変換するなど)。
- 理解と分類:既存テキストの意図認識、タグ分類、感情やトピックの判定を行い、文字による結論や列挙値として出力。
- 抽出と変換:長文からのフィールド抽出、半構造化テキストを JSON 風の文字列出力に整理。
- 対話型インタラクション:カスタマーサポートの Q&A、社内ナレッジアシスタントなど、文字による一問一答を中心とするシーン。
- コードや設定に関わる文字出力:コメント生成、変更説明、ドキュメントの下書き。
これらのタスクの共通点は、入力がテキストで、期待する出力もテキストであり、途中にピクセルや波形が一切不要であることです。
別の方案が必要な要件
- 画像・音声・動画の生成や編集。出力モダリティが一致せず、プロンプトをどう書いてもメディアファイルは得られません。
- 強いリアルタイム性が求められる音声・動画ストリーム処理や音声文字起こしなどは、専用のモダリティモデルや独立したサービスが必要です。
- 出力形式に極めて厳格なバイナリやファイルレベルの要件があるシーンでは、「テキスト内容の生成」と位置づけ、ファイルのカプセル化は下流のコードに任せます。
実用的な判断方法:要件の記述に「画像を生成する」「この音声を認識する」「動画を出力する」が現れるなら、それはこの経路の範囲外です。逆に、「文章を読み、文章を書く」で要約できる要件なら、ほぼ適切です。
接続経路:集約 API 経由で Google のテキストモデルを呼び出す
集約プラットフォーム上で Google のテキストモデルを呼び出す全体的な流れは、四つのステップにまとめられます。アクセス認証情報の申請と設定、モデル識別子の選定、統一されたリクエスト構造での入力送信、返却されたテキスト結果の解析です。各提供元に直接接続する場合と比べ、集約インターフェースの価値はリクエストとレスポンスの形式が一貫していることにあり、業務コードは提供元ごとに複数のアダプテーション層を書く必要がありません。
注目すべきパラメータの次元
具体的なフィールド名と値の範囲はプラットフォームのドキュメントに従います。ここでは接続時に項目ごとに確認すべき次元のみを挙げます。
- モデル識別子:リクエストで gemini-4-neon を指定するフィールドで、通常は文字列 ID です。業務ロジックにハードコードせず、設定項目に置くことを推奨します。
- 入力内容の構成:単一ターンの入力とマルチターン対話では保持方法が異なり、マルチターンは通常メッセージ配列で表現し、各メッセージにロールと内容を持たせます。
- 生成長の上限:1 回の出力長を制御するパラメータです。コストに直接影響し、切り捨ても発生しうるため、デフォルト値に依存せず明示的に設定することを推奨します。
- ランダム性と安定性:温度系のパラメータは出力の発散度を決めます。抽出や分類など安定した結果が必要なシーンでは低くし、創造的な書き換えでは高くできます。
- 思考レベル:
reasoning_effortは low / medium / high を取ります。抽出や分類などの単純なタスクは low で速度とコストを優先し、ファイル横断のデバッグや多段階分析では high を有効にします。 - タイムアウトとリトライ:ネットワーク層のパラメータで、モデルとは無関係ですが安定性と強く関連します。クライアント側で統一的にラップすることを推奨します。
呼び出し形態に関する二つの提案
第一に、「モデル識別子 + パラメータのデフォルト値 + リトライ戦略」を内部のラッパーに集約し、業務側は業務的な意味(プロンプトと変数)だけを渡すようにします。そうすれば、後のモデル変更やパラメータ調整で複数箇所を修正する必要がありません。第二に、リクエストとレスポンスの両方を構造化ログに記録し、特に所要時間とトークン使用量のフィールドを残します。これが後のコスト計算とデバッグの基礎データになります。
認証情報の管理では、フロントエンドやクライアントから集約インターフェースへ直接接続させず、必ず自社のバックエンドゲートウェイを経由させ、クォータ、監査、レート制限を行いやすくします。
トークン課金:コスト構造と見積もり方法
gemini-4-neon はトークン単位で課金されます。この意味は、費用が「入出力のテキスト量」に関係し、リクエスト回数に単純に比例するわけではないということです。標準ラインは 100 万トークンあたり入力 $4.54、出力 $22.68、キャッシュヒット時の入力 $0.227。同じタスクを @flex ラインで実行すると価格は半額になります。思考レベルを高くするほど推論過程で消費するトークンが増え、コストも上がります。
コストを決めるもの
1 回の呼び出しは通常二種類の使用量を伴います。入力トークン(プロンプト、コンテキスト、検索した参考資料)と出力トークン(モデルが生成したテキスト)です。マルチターン対話では履歴メッセージが一緒に持ち込まれることが多く、ターンが増え、コンテキストが長くなるほど 1 回の呼び出しの入力量が大きくなります。これが多くのチームでリリース後に請求額が想定を超える最大の原因です。
見積もりの考え方
- まず計測してから計算:段階的リリース中に各呼び出しの入力と出力の使用量を記録し、業務側の実際の分布から中央値と高パーセンタイル値を取り、短いプロンプト一つで見積もらないようにします。
- シーン別に分割:呼び出しを業務シーン(要約、抽出、対話など)でグループ化し、平均使用量と 1 日あたりの呼び出し量をそれぞれ集計して、各シーンの規模を求めます。
- 増幅係数を加える:ロングテール入力、リトライ、ユーザーの誤操作に余裕を確保し、日次・月次の予算に換算します。
- 上限を設定:1 回の呼び出しに出力長の上限を設け、テナントやユーザーに日次クォータを設定し、単一の異常が全体の請求額に拡大するのを防ぎます。
コストを抑える四つの実践
- コンテキストを簡潔に:必要な履歴ターンと参考断片だけを持ち、長い文書は先にチャンク分割と選別を行います。
- 出力上限を明確に:生成長パラメータを明示的に設定し、抽出系タスクはできるだけ短い出力を要求します。
- 再利用可能な結果をキャッシュ:同じ入力の決定論的タスクはキャッシュし、重複呼び出しを減らします。
- 段階的処理:単純なタスクはより小さな出力予算で、複雑なタスクのみ長さを開放し、一律に最大設定にしないようにします。
これらを人が覚えておくのではなくデフォルト設定にすることで、コスト管理は持続可能になります。
典型的な使い方とプロンプト構成の提案
最初のシーンを動かす鍵はモデルではなく、プロンプトの構造にあります。プロンプトはコードのように書くことを推奨します。固定の骨格があり、明確な入力区と出力区があります。
推奨するプロンプトの骨格
- 役割と目標:この呼び出しでモデルが何を担い、何を完了するかを一文で説明します。
- 入力区:処理するテキストを明確な区切り記号で囲み、指示と区別して、ユーザー内容に指示が上書きされるのを防ぎます。
- 制約:出力言語、長さの上限、必ず含める内容や必ず避ける内容。
- 出力形式:期待するフィールドと構造。具体的であるほど安定します。
以下は一つの示意構造です(擬似コードであり、実際のリクエストではありません):
あなたは<役割>です。<目標>を完了してください。

<処理対象テキスト>
{{user_input}}
</処理対象テキスト>

要件:
- 出力言語:日本語
- 長さは N 文字以内
- JSON のみを出力し、フィールドは summary, tags
よくある利用パターン
- 単一ターン抽出:テキストを入力し、固定フィールドを出力。安定性を優先し、温度を低く設定します。
- マルチターン対話:メッセージ配列を維持し、履歴の保持ターンを制御し、必要に応じて初期の対話を要約圧縮します。
- 二段階生成:先にアウトラインを生成してから展開し、途中で方向性を検証でき、一度に長文を生成することによる切り捨ても避けられます。
- レビュー式書き換え:モデルにまず問題点を指摘させてから修正稿を出させると、通常は一度の書き換えより品質が安定します。
プロンプト長とトークンの関係
プロンプト内の各説明、各例、各ターンの履歴はすべて入力使用量に算入されます。例(few-shot)は安定性を大幅に向上させますが、最も篇幅を占めます。代表的な少数の例だけを残し、積み上げないことを推奨します。出力形式が自由なほど、モデルは冗長な内容を生成しがちです。明確なフィールド制約でより短い出力を得ることは、品質とコストの両方を改善することがよくあります。
プロンプトをバージョン管理に含め、変更ごとに対応する効果と使用量の変化を記録し、ロールバックしやすくすることを推奨します。
よくある問題とトラブルシューティングの方向性
接続初期の問題は主に四種類に集中します。以下の順序で切り分け、誤った方向で時間を浪費するのを避けることを推奨します。
呼び出し失敗や異常な返却
まずエラーコードの階層を見ます。認証の問題(認証情報の欠落、期限切れ、権限不足)、リクエスト形式の問題(フィールドの欠落、型の不一致、メッセージ配列構造の不正)、パラメータの範囲外(長さの上限、温度の値が範囲外)、そしてレート制限とタイムアウトです。失敗のほとんどはリクエスト構築段階にあるため、1 回の完全なリクエストとレスポンスの原文をログに記録し、ドキュメントと照らしてフィールドごとに確認することを推奨します。
出力が不安定、または形式が違う
同じ入力で結果が何度も大きく異なる場合は、まず温度系パラメータが高すぎないか確認します。形式の解析に失敗する場合は、出力制約が指示の目立つ位置に書かれているか、フィールドレベルの例があるかを確認します。長い入力では、重要な指示を入力区の後にもう一度繰り返すと、遵守度が明らかに改善することがよくあります。また、生成が切り捨てられると「形式が不完全」として現れるため、長さの上限不足なのかモデルが逸脱したのかを区別する必要があります。
コストが想定を超える
切り分けの順序:まず 1 回の呼び出しの入力が想定を大きく超えていないか(多くは履歴メッセージや参考文書が長すぎる)、次に出力長に上限がないか、さらにリトライの嵐やループ呼び出しがないかを見ます。マルチターンのシーンでは、履歴の圧縮を行っていないことが最もよくある原因です。
レイテンシが高い
長い入力と長い出力はどちらも所要時間を引き延ばします。コンテキストを短縮する、出力上限を低く設定する、重要でないステップを並列呼び出しに分割するなどを試せます。クライアント側では適切なタイムアウトを設定し、バックオフ付きリトライを組み合わせ、タイムアウト直後にすぐ再送して負荷を増幅させないようにします。
トラブルシューティング時には三種類のログを残します。リクエストパラメータの要約、レスポンスの使用量フィールド、エンドツーエンドの所要時間です。この三項目で上記のすべての分岐をほぼカバーできます。
リリース前のチェックリスト
正式にトラフィックを流す前に、以下の事項を項目ごとに確認することを推奨します。
接続と設定
- モデル識別子とパラメータのデフォルト値が設定層に集約され、業務コードに散在していない。
- アクセス認証情報はサーバー側にのみ存在し、クライアントは集約インターフェースに直接接続しない。
- 1 回の呼び出しの出力長の上限が明示的に設定されている。
- タイムアウト、リトライ、バックオフ戦略が統一ラッパーに実装されている。
段階的リリースと観測
- 小流量の段階的リリースを採用し、まず単一シーンをカバーしてから徐々に拡大する。
- 各呼び出しの入力/出力使用量と所要時間を記録し、シーン別に集計して確認できる。
- 重要シーンには結果品質の抜き取り検査の仕組みがあり、成功率だけを見ていない。
- 明確なロールバック経路がある。プロンプトのバージョンとモデル識別子をどちらも素早く切り戻せる。
コストとクォータ
- 実際の分布に基づく使用量から日次・月次の予算見積もりを行っており、当て推量ではない。
- テナントやユーザーごとに呼び出しクォータと出力上限を設定している。
- コストアラートのしきい値を設定し、異常な増加をいち早く発見できる。
- 再利用可能な結果をキャッシュし、決定論的タスクで二重課金しない。
境界の確認
- 要件一覧の中に、画像・音声・動画系の出力要求が誤ってこのモデルに割り当てられていない。
- 視覚や音声に関わる部分は別の専門方案が引き受けている。
- チームがこのモデルのトークン課金を認識しており、単価はプラットフォームの価格パネルに従う。
このチェックリストをリリースレビューのプロセスに定着させれば、後続の他のモデルの接続にも再利用できます。モデルの詳細とパラメータの説明は gemini-4-neon を参照してください。小さなシーンから動かし始め、その後で規模化を検討することを推奨します。


