
使用ガイド
gpt-6.2-sol 入門ガイド:能力の境界、API 接続、token 課金の注意点
エンジニアリングチーム向けの接続判断と実践の要点

このページの内容
gpt-6.2-sol とは何か、誰に適しているか
gpt-6.2-sol は OpenAI が提供するテキストモデルで、HiAPI.ai の統一インターフェース上で利用可能になっています。GPT-6 シリーズの日常利用の主力モデルであり、OpenAI はコーディングから大規模な agent の駆動まで幅広く使える汎用モデルと位置づけています。出力タイプは純粋なテキストであり、これがあなたに適しているかを判断する最初のふるいになります。「何でもできる」汎用のブラックボックスとして扱うべきではありません。
最も快適に使えるのは、知識を問う質問応答や検索結果の整理・統合、コンテンツの初稿作成と書き換え、構造化データの抽出と分類、マルチターン対話における意味判断、そしてフローの一環としてテキストによる判断(トリアージ、ラベリング、要約、意図認識)を行う場面です。こうしたタスクに共通するのは、入力がテキストで期待される出力もテキストであるという点で、モデルを既存サービスに組み込んで 1 つの関数呼び出しとして使えます。
対象読者はエンジニアリングチームです。新しいテキストモデルの導入を評価している、あるいは既存の呼び出しを新しいモデルへ一括で切り替えようとしているチームを想定しています。画像や音声の生成が必要な場合はこのモデルの範囲外であり、選定段階で除外すべきです。
実務的な判断基準として、まず解決したいタスクを一文で書き、「このタスクの入力と出力はどちらもテキストか」と自問してください。答えが否であれば、このモデルはせいぜいフローの中のテキスト部分だけを担えます。
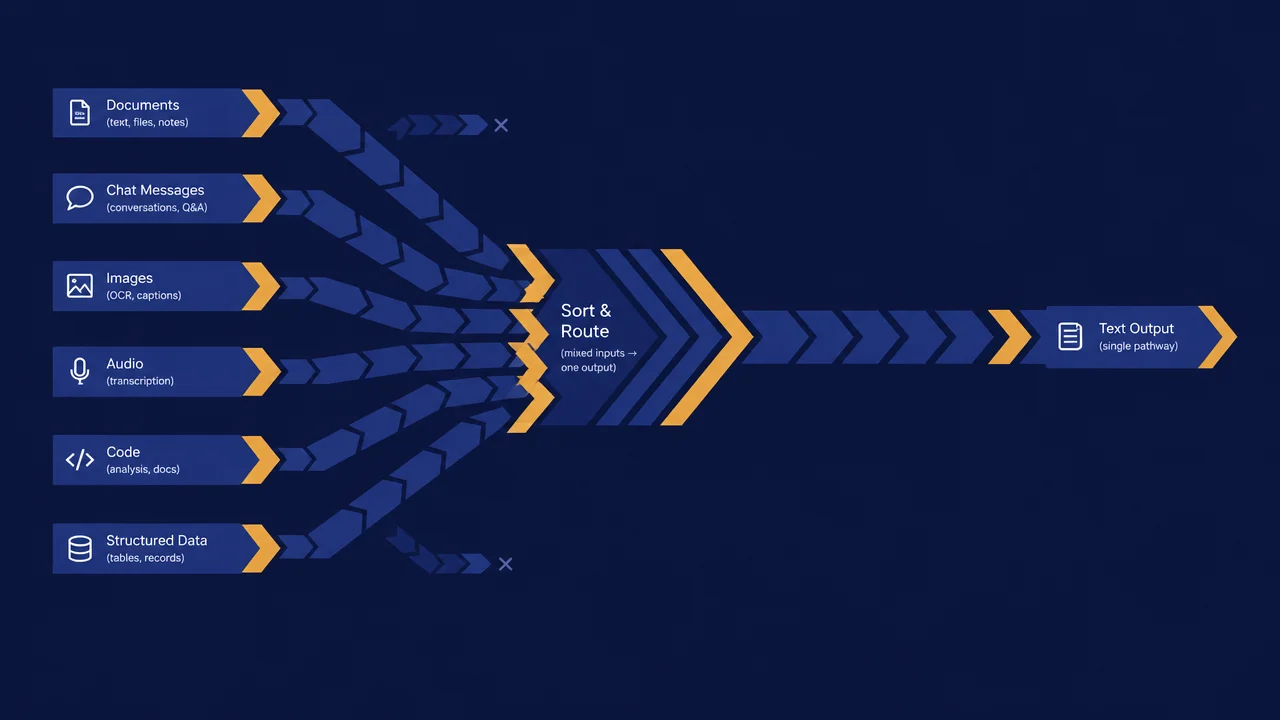
能力の境界:テキスト出力にできること・できないこと
gpt-6.2-sol はテキストを入力しテキストを出力するパイプラインと捉えてください。パイプラインにできることは明確で、テキストの文脈を与えられるとテキストの結果を生成します。これを軸に、分類ラベリング、要約と書き換え、情報抽出、質問応答生成、フォーマット変換(自由テキストから取り決めた構造化テキストへの変換など)、複数候補の並べ替えと説明などをそのまま担えます。
追加の仕組みで補う必要がある部分も事前に認識しておきましょう:
- 厳密な構造化出力が必要な場合:Responses API で呼び出す際は
text.formatに JSON Schema を渡して strict を有効にすると、戻り値がフィールド定義どおりに直接生成されます。Chat Completions ではこのオプションがなく、プロンプトによる制約に頼るしかありません。Chat Completions ではプロンプト制約に加えてサーバー側の検証と再試行が必要で、初回の戻り値が必ず解析可能と仮定してはいけません。 - 時点性のある事実が必要な場合:モデルの出力は事実の情報源ではありません。データ、時刻、外部状態に関わる内容は検索層やデータベースから提供し、それをモデルに文章化させるべきです。
- 非テキストの成果物が必要な場合:画像や音声の生成などはこのモデルの出力タイプに含まれず、別途専用の仕組みを接続する必要があります。
- 決定論的な挙動が必要な場合:同じリクエストが逐語的に再現される保証はありません。強い一貫性を要するロジックはコード側に置き、モデルの判断に委ねないでください。
境界を設計ドキュメントに書き込むことは、後から本番環境で場当たり的に修正するよりはるかに安価です。テキスト能力を超える部分はすべて「外部コンポーネントが必要」と明示しておけば、レビュー時に期待のずれが生じません。
gpt-6.2-sol の主要パラメータと価格
以下は HiAPI 経由で gpt-6.2-sol を呼び出す際に確定している情報であり、後述の接続とコスト見積もりはこれを基準とします。
- 位置づけ:GPT-6 シリーズの日常利用の主力モデル。OpenAI はコーディングから大規模な agent の駆動まで幅広く使える汎用モデルと位置づけており、GPT-6.1 Sol より賢く、token を節約できます。
- コンテキストと出力:コンテキストウィンドウは 1,050,000 token、1 回の出力は最大 128,000 token。
- 知識のカットオフ:2026-06-01。
- 出力と機能:テキスト出力、ストリーミング出力とツール呼び出し(
tools)に対応。 - 呼び出し方式:Responses API(
https://api.hiapi.ai/v1/responses)と Chat Completions(https://api.hiapi.ai/v1/chat/completions)に対応。思考レベルreasoning.effort(low / medium / high / xhigh / max、デフォルトは medium)と JSON 構造化出力text.formatは Responses API でのみ利用可能です。 - 価格:モデルページの現在の表示価格(100 万 token あたり)は入力 $0.500、キャッシュ入力 $0.025、出力 $2.500、キャッシュ書き込み(5 分)$0.625。課金は gpt-6.2-sol モデルページ のリアルタイム表示を基準とします。
gpt-6.2-astra との選び分け
同シリーズの gpt-6.2-astra はフラッグシップモデルで、最も難しく期間の長いプロジェクト向けであり、単価はより高くなります。多くのタスクではまず Sol を使うことを推奨します。Sol でうまく処理できない難題、たとえば複雑なモジュール横断のリファクタリングや要求の高い専門ドキュメントに直面したときに Astra へ切り替えてください。両者は呼び出し方式が同じで、切り替えはモデル名を変えるだけです。
接続前に確認すべきインターフェース情報
HiAPI.ai で接続する際、モデルページ /models/gpt-6.2-sol が情報の入口です。以下のチェックリストは、最初の呼び出しコードを書く前に項目ごとに確認することをおすすめします。また公式およびプラットフォームのドキュメントを基準とし、コミュニティの投稿や古いプロジェクトの設定から推測しないでください:
- 認証情報と認証方式:キーがどこから来るのか、どこに置くのか、サーバー側でいかに安全に注入するのか。決してブラウザに配信してはいけません。
- リクエストフィールドと必須項目:モデル識別子、メッセージ構造、生成長の上限などのフィールドの正確な名称と値の制約。
- コンテキストと出力長の制約:gpt-6.2-sol のコンテキストウィンドウは 1,050,000 token、1 回の出力は最大 128,000 token であり、出力上限がどう適用されるかがチャンク分割戦略を直接左右します。
- レート制限とクォータの基準:レート制限がどの次元で計られるのか(リクエスト数か token 量か)、トリガー後のレスポンス形態は何か。
- エラーコードの意味:再試行に値するエラーと、パラメータの問題で再試行しても無駄なエラーを区別する必要があります。
- 課金基準:本モデルは token 課金であり、モデルページに入力、キャッシュ入力、出力、キャッシュ書き込みの単価がそれぞれ表示されています。
これらの結論をチーム内部の接続説明書に蓄積しておけば、後で担当者が変わったりモデルを変えたりする際にこのチェックリストをそのまま再利用できます。いずれかの項目が未確認のうちは、本番ブランチに書き込まないでください。
API 呼び出しとパラメータ構成の要点
呼び出し側の中心的な作業は 1 回リクエストを送ることではなく、リクエストを再利用可能・可観測・フォールバック可能なラッパーに構成することです。まず最小限の例を見てみましょう。Responses API で構造化 JSON を取得します。OpenAI 公式 SDK を使う場合、base_url を HiAPI に向けるだけです:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="チケットからフィールドを抽出し、欠落しているフィールドには null を入れる。",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
既存の Chat Completions クライアントがある場合は、モデル名を gpt-6.2-sol に変えれば呼び出せますが、思考レベルと JSON 構造化出力は Chat Completions では利用できません。以下を順に実装してください:
リクエスト構造
メッセージをシステム制約とユーザーコンテンツの 2 層に分け、システム層には役割、出力形式の要件、禁止事項を置き、ユーザー層には業務データを置きます。業務データを指示文と混ぜて 1 つの文に連結してはいけません。そうすると問題が起きたときにデータの問題か指示の問題かを特定できなくなります。
出力契約
期待する出力形態(フィールド名、説明的な文章を許容するかなど)を明確に書き出します。書いたとしても、サーバー側で一度解析検証を行い、解析に失敗したら 1 回の失敗呼び出しとみなして再試行やフォールバックに回し、中途半端な結果をそのままフロントエンドに渡さないようにします。
例外と再試行
再試行は回復可能なエラー、たとえば一時的なネットワーク障害やレート制限でのみ行うべきです。パラメータ不正やコンテンツ長超過といったエラーは再試行しても意味がないため、直接報告すべきです。再試行には回数上限とバックオフ間隔を設け、1 回の障害を雪崩に拡大させないようにします。
可観測性の最小セット
各呼び出しで少なくとも記録すべきは、所要時間、入力と出力の token 量、再試行に該当したか、最終的に成功かフォールバックかです。これらが後でコストを算出し問題を特定できるかを左右します。ログのない接続は、接続していないのと同じです。
token 課金下でのコスト構造
gpt-6.2-sol は token 課金であるため、1 回のコストは固定値ではなく、入力と出力の量に比例して線形に積み上がります。エンジニアリング上で構築すべきはコストモデルであり、特定の数字を覚えることではありません:
- 入力側:システムプロンプト、履歴対話、検索されたコンテキストがすべて計上されます。マルチターン対話でトリミングを行わないと、入力はターンを重ねるごとに膨張し続けます。
- 出力側:生成が長いほど課金が増えます。モデルに長々と説明させる要求はコストを制御不能に押し上げます。
- 総コスト:1 回のリクエストのコストは入力と出力の両方から構成されるため、最適化は両端を見る必要があります。
対応する制御手段としては、システムプロンプトを簡素化して再利用する、履歴対話をスライディングウィンドウや要約で圧縮する、長いドキュメントはまず分割して必要に応じて送る、出力に合理的な上限を設ける、バッチタスクは重複排除とキャッシュを行い同じ入力に二重に支払わない、などがあります。
予算見積もりの正しい方法は、実際のサンプルで一度実行し、平均的な入力と出力の token 量を統計してから呼び出し量の規模を掛け、桁感の判断を得ることです。現在の表示価格は前述の「主要パラメータと価格」を参照してください。価格は変更される可能性があり、課金はモデルページのリアルタイム表示を基準とします。
横並び比較で切り替え可否を判断する
選定は 1 回の評価や単一の指標だけで行うべきではありません。より確実な方法は、gpt-6.2-sol と現在の候補モデルを同じ実業務サンプルの束に入れて比較することです:
- サンプリング:本番ログやアノテーションデータから代表的なリクエストを抽出し、一般的なタスクとロングテールのタスクをカバーします。
- 入力の統一:同じプロンプト、同じデータの束で、モデル識別子だけを変え、プロンプトの差異によるノイズを排除します。
- 多面的な採点:スコアだけでなく、フォーマット準拠率、失敗率、平均 token 消費量、平均所要時間も見ます。
- 人手による抽出検査:機械指標では見えない表現品質や事実誤認は、人が確認する必要があります。
- 意思決定:切り替えの合格ラインを明確にし、たとえばフォーマット準拠率と失敗率がどの水準に達したらリリースするかを定めます。
比較の目的は新しいモデルの方が優れていることを証明することではなく、「現行タスクにおいて、切り替えによる利益が移行と運用のコストを賄えるか」に答えることです。差が有意でなければ、現状を維持することも正しい判断です。同シリーズの中で、最も難しく期間の長いタスクでは gpt-6.2-astra も比較対象に加えてよいでしょう。多くのタスクではまず Sol を使うことを推奨します。
よくある問題とトラブルシューティングの道筋
接続初期の頻出問題は、以下の順で調べると通常は最速です:
- タイムアウト:まず入力が長すぎて処理時間が伸びていないかを見て、次にネットワークかサーバー側のレート制限かを確認します。フォールバック手段は障害より先に用意しておきます。
- 出力の打ち切り:生成長の上限が小さすぎる設定になっていないか、システムプロンプトが長すぎる出力を要求していないかを確認します。打ち切りは多くの場合モデルの問題ではなく、パラメータの問題です。
- 出力形式の不一致:プロンプト内の形式要件が十分に具体的か確認し、サーバー側で検証と再試行を加えているか確認します。連続で失敗する場合はより明確な例による制約への変更を検討します。
- 認証失敗:キーが正しく注入されているか、サーバー側のキーを誤ってフロントエンドに露出していないか、環境変数が欠落していないかを確認します。
- レート制限エラー:レート制限の次元としきい値を確認し、バックオフとキューを導入して瞬間的な同時実行で一杯にならないようにします。
トラブルシューティングの基本規律は、リクエスト構築の問題か、サーバー側の制約の問題か、業務コードの解析の問題かをまず特定してから手を入れることです。パラメータを調整して運任せにしてはいけません。
リリース後の監視と改善
リリースは終点ではありません。接続を継続的に稼働する一連のパイプラインとして捉え、少なくとも以下の指標を注視してください:呼び出し量と成功率、フォーマット準拠率、平均入力・出力 token 量、平均所要時間、フォールバックと再試行の割合。これらはそれぞれ容量、品質、コスト、安定性の 4 つの次元に対応します。
改善のリズムとしては、一定の周期で失敗サンプルとユーザーからのフィードバックを振り返り、典型的な誤りを新しい評価ケースとして蓄積し、それに基づいてプロンプト、チャンク分割戦略、出力上限を調整することをおすすめします。モデルやプラットフォームの設定が変わったときは、同じ評価サンプルの束で回帰テストを行ってから拡大可否を判断してください。
実用的なリリース原則として、まず小流量のカナリアリリースで実際の効果を検証し、その後段階的に拡大し、どの時点でも旧モデルへ戻せるスイッチを残しておきます。まずモデルの詳細と接続情報を見たい場合は、/models/gpt-6.2-sol から始めてください。能力の境界、コストモデル、監視の 3 つを同時にしっかり作り込むことで、gpt-6.2-sol はあなたのシステムの中で安定して信頼できるテキストの一環となれます。


