
Guia de uso
Guia prático de imagem para imagem com GPT-image-2.6-sunburst: limites de capacidade, cobrança e práticas de engenharia
Roteiro prático para desenvolvedores, da integração ao lançamento: capacidade, parâmetros, custos e boas práticas
Nesta página
O que ele faz e o que não faz
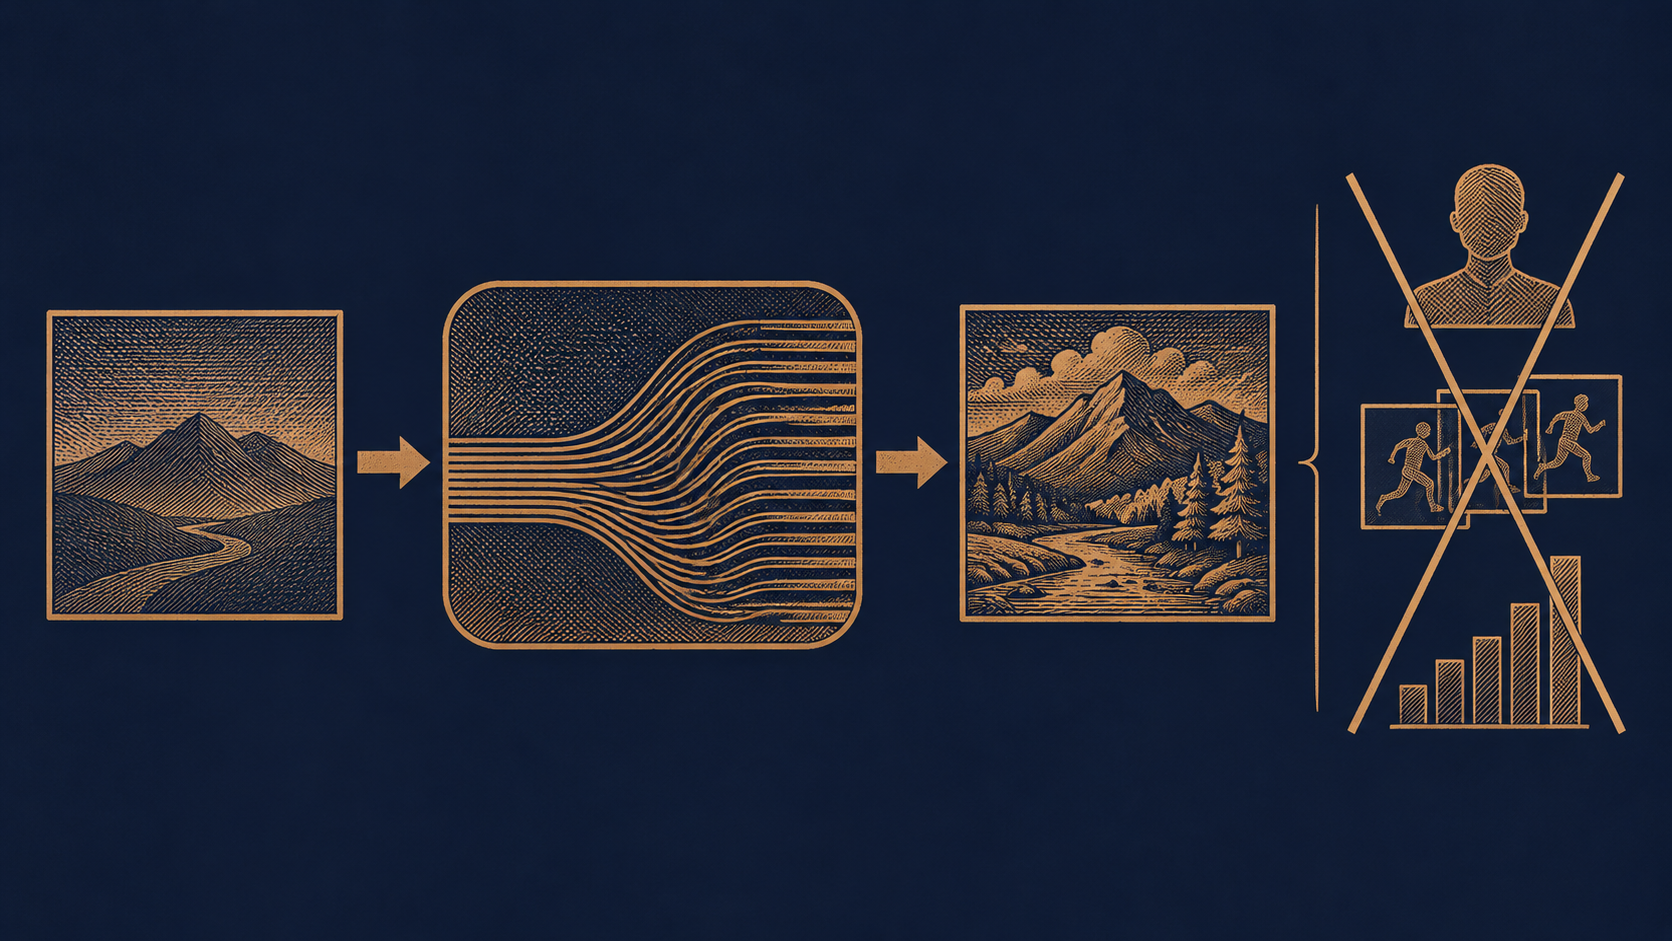
gpt-image-2.6-sunburst/image-to-image é um modelo de imagem fornecido pela OpenAI, e o próprio identificador revela seu posicionamento: a entrada é imagem e a saída é imagem, com o rótulo de capacidade image-to-image. Não é uma ferramenta de imagem que faz tudo, mas um transformador com responsabilidade bem definida — você fornece uma imagem de referência e ele produz uma nova imagem conforme suas instruções em texto.
Tarefas adequadas para ele
- Transferência de estilo e repintura: converter fotos reais em estilos-alvo como ilustração, aquarela ou cyberpunk, preservando o contorno do sujeito.
- Alteração local ou global: trocar o fundo, ajustar a atmosfera de iluminação, unificar a tonalidade da imagem, remover elementos indesejados do quadro.
- Produção de variantes de material: usar uma imagem principal já aprovada como base para gerar em lote variantes de composição semelhante e detalhes diferentes, para testes A/B ou ampliação do acervo de materiais.
- Do esboço ao produto final: colorir e refinar esboços de linha, blocos de cor e esboços de baixa completude, acelerando a etapa inicial do design.
O critério é simples: se a sua necessidade pode ser explicada como «uma imagem existente + uma descrição de alteração», ela está dentro da faixa de capacidade do modelo.
O que ele não cobre
- Geração apenas a partir de texto. Criar do zero apenas com prompt, sem imagem de entrada, pertence ao domínio dos modelos de texto para imagem; não conte com ele para substituir isso.
- Composição tipográfica precisa. Quando for necessário renderizar um texto especificado exatamente igual no quadro (títulos de pôster, textos de embalagem), o resultado gerado geralmente exige conferência manual adicional.
- Reprodução em nível de pixel. image-to-image é «referência e repintura», não «edição sem perdas»; a saída não será idêntica pixel a pixel à entrada.
- Vídeo, 3D, áudio. O único tipo de saída é imagem.
- Garantia factual. Ele não compreende se o conteúdo da imagem é verdadeiro ou está em conformidade; a revisão de conteúdo sensível do lado do negócio deve ser assumida pelo seu próprio processo.
Ao escolher, pergunte primeiro: há imagem na minha entrada? O que quero na saída é imagem? Se ambas as respostas forem «sim», continue lendo; caso contrário, trocar de modelo economiza mais tempo do que ajustar parâmetros.
Caminho de integração: da API agregadora à primeira geração de imagem
Para chamar esse modelo não é necessário integrar fornecedores upstream um a um; basta usar a interface unificada do HiAPI.ai: o cliente envia uma requisição HTTP à API agregadora, a plataforma realiza autenticação, roteamento e chamada upstream, e então devolve a imagem gerada. Toda a cadeia expõe ao desenvolvedor apenas um endpoint, um conjunto de credenciais e um identificador de modelo.
O que preparar antes de começar
- API Key: criar no console do HiAPI.ai, colocá-la em variáveis de ambiente do servidor e nunca escrevê-la no código frontend nem enviá-la ao repositório.
- Identificador do modelo: especificar explicitamente
gpt-image-2.6-sunburst/image-to-imagena requisição, atentando ao sufixoimage-to-image— variantes de capacidades diferentes na mesma série são modelos independentes entre si; escrever o sufixo errado causa diretamente modelo não encontrado ou comportamento diferente do esperado. - Forma acessível da imagem de entrada: confirmar os modos de envio suportados pela plataforma (URL ou base64) e garantir que o endereço da imagem esteja acessível durante a chamada.
- Cota e limites: confirmar o saldo da conta e o limite de taxa, para evitar esbarrar em erro de cota já na primeira integração.
Caminho mínimo de validação
Não execute o fluxo completo de negócio logo de início. Avance nesta ordem:
- Primeiro, usar a requisição de exemplo da documentação da plataforma para executar uma chamada que «retorne imagem», validando a Key, o identificador do modelo e a conectividade de rede;
- Depois, substituir pela sua própria imagem de entrada real e observar se a saída atende ao esperado;
- Por fim, encapsular essa chamada em uma função interna com timeout, retry e logs, de modo que o código de negócio dependa apenas dessa função.
O valor dessa etapa é isolar variáveis: na primeira falha, você só precisa investigar autenticação e parâmetros, em vez de suspeitar ao mesmo tempo da imagem, do prompt e da lógica de negócio. Os nomes exatos dos campos de requisição, cabeçalhos de autenticação e estrutura de resposta devem seguir a documentação oficial da interface do HiAPI.ai; não aplique formatos de outros fornecedores de memória.
Parâmetros de chamada e preparação da imagem de entrada
A superfície de parâmetros desse modelo é mais estreita que a de texto para imagem, mas justamente por ser estreita, aplicar hábitos antigos é o que mais causa erros. A seguir, são explicados os pontos de atenção por categoria; os nomes exatos dos campos, faixas de valores e valores padrão devem seguir a documentação oficial, e este artigo não os garante em nome da plataforma.
Categorias de parâmetros que merecem atenção
- Identificador do modelo: fixo em
gpt-image-2.6-sunburst/image-to-image; este é o único parâmetro que precisa estar correto. - Prompt: descreva «como deve ficar», não «o que é».
- Campo da imagem de entrada: URL ou dados inline; geralmente apenas um deles é suportado, ou é preciso diferenciar o uso conforme a documentação.
- Especificação de saída: tamanho, proporção, formato de retorno etc. Observe que a saída de imagem para imagem costuma ser afetada pela proporção da imagem de entrada; forçar uma proporção incompatível pode causar corte ou deformação.
- Quantidade: quantas imagens gerar por requisição. Isso afeta diretamente a cobrança; confirme claramente o valor padrão e não presuma que «só gera uma».
- Aleatoriedade e seed: se a documentação oferecer parâmetros de seed ou controle de aleatoriedade, eles são a chave para reproduzir problemas; caso contrário, é preciso aceitar que a mesma entrada e o mesmo prompt também podem produzir resultados diferentes.
Quatro regras rígidas para a imagem de entrada
- Resolução suficiente basta. Resolução muito baixa faz a repintura perder detalhes; muito alta apenas aumenta o custo de transmissão e pré-processamento. Escolha um tamanho com sujeito claro e identificável, sem ser pesado, e mantenha o mesmo tamanho para tarefas do mesmo tipo, facilitando a comparação lateral dos resultados.
- Formato unificado. Defina internamente na equipe um formato mainstream, evitando diferenças de canal transparente e artefatos de compressão causadas pela mistura de PNG, JPEG e WebP. Se for necessário preservar transparência, confirme antes se o modelo suporta.
- Sujeito claro e espaço em branco razoável. Se o quadro estiver cheio de elementos, fica difícil para o modelo julgar qual parte você quer alterar; recortar primeiro para a área de interesse é mais eficaz do que longas explicações no prompt.
- Conformidade e autorização. A imagem de entrada sairá do seu sistema; confirme direitos autorais, direitos de imagem e conformidade de negócio antes de enviar.
Há ainda um ponto facilmente ignorado: não transporte diretamente todo o hábito de parâmetros dos modelos de texto para imagem. Imagem para imagem não tem o conceito de «compor do zero»; muitos parâmetros usados para ajustar estilo em texto para imagem têm semântica diferente ou nem existem aqui, e copiar às cegas só cria requisições inválidas — e cada requisição inválida é cobrada.
Detalhamento de preços: o que significa US$ 0,023 por imagem
A base de cobrança desse modelo é direta: cobrança por imagem, com preço unitário de US$ 0,023 / imagem. Não há faixas por token, nem consideração do tamanho da imagem de entrada, comprimento do prompt ou tempo de geração; desde que uma imagem seja gerada com sucesso, cobra-se uma vez. Essa estrutura de preços é bastante amigável para desenvolvedores, pois transforma a estimativa de custo em multiplicação.
Construa seu próprio modelo de custo
Estimar o total exige apenas duas variáveis:
- Quantidade de imagens por requisição: se o parâmetro permitir retornar várias imagens de uma vez, então uma chamada acumula pela quantidade de imagens. Na fase de integração, confirme obrigatoriamente o valor padrão desse parâmetro; caso contrário, você pensa que está testando uma, mas a fatura mostra várias.
- Número de requisições válidas: observe que é o número de «gerações bem-sucedidas», não de «quantas vezes você clicou em executar» — mas, por outro lado, chamadas desperdiçadas por parâmetros errados, desde que tenham gerado imagem, não são reembolsadas.
Multiplique esses dois fatores e depois pelo volume diário/mensal estimado do lado do negócio para obter a linha de base do orçamento. Recomenda-se registrar essa fórmula na documentação já no início do projeto e reaplicá-la a qualquer alteração futura de fluxo (aumentar número de variantes, elevar tentativas de retry, ampliar lote), evitando que o custo dobre sem que ninguém perceba.
Três itens de custo facilmente subestimados
- Custo de tentativa e erro. Cada geração durante a fase de ajuste de prompt é cobrada. Em vez de testar repetidamente em produção, concentre o ajuste em poucas imagens de teste fixas.
- Custo de retry. Repetir cegamente após timeout de rede pode ocorrer quando o upstream já gerou com sucesso, e você paga por duas imagens.
- Variantes redundantes. Gerar várias imagens de uma vez para «dar mais opções ao usuário» não necessariamente aumenta a conversão, mas certamente eleva o gasto.
Os números de cobrança e os preços mais recentes devem seguir o painel de preços do site do HiAPI.ai; este artigo apenas explica a base de cálculo, sem prometer valores.
Boas práticas de prompt e fluxo de trabalho
O prompt de imagem para imagem e o de texto para imagem são duas formas de escrita diferentes. Texto para imagem exige que você descreva todo o quadro; imagem para imagem já tem uma imagem como base factual, e o que você deve fazer é descrever «a mudança», não a «reconstrução».
Estrutura em quatro partes do prompt
Um prompt estável e utilizável geralmente contém quatro blocos; a ordem pode ser ajustada, mas a falta de um bloco facilita desvios:
- O que preservar: primeiro trave a parte que não pode mudar. «Manter a pose e os traços faciais da pessoa inalterados», «preservar a composição e a posição do sujeito da imagem original». Essa frase reduz significativamente a deriva do sujeito.
- O que alterar: use verbos para definir o escopo da transformação. «Substituir o fundo por uma rua em noite de chuva», «mudar a tonalidade geral para laranja quente».
- Estilo e textura: indique o estilo-alvo e a textura visual, por exemplo «estilo ilustração flat, iluminação suave, sensação de filme de baixa saturação».
- Exclusões: escreva o que você não quer. «Não adicionar personagens extras», «não incluir texto». Restrições negativas em tarefas de imagem costumam ser mais eficazes que descrições positivas.
Três regras práticas
- Altere apenas uma categoria de coisa por vez. Alterar simultaneamente fundo, iluminação e estilo torna o resultado não atribuível; se houver problema, você não saberá qual frase do prompt o causou.
- O prompt deve ser curto e específico. Acumular adjetivos não melhora a qualidade e dilui o foco. Explicar claramente uma alteração em menos de vinte palavras costuma ser mais estável do que duzentas palavras.
- Versione os prompts bem-sucedidos. O mesmo prompt pode produzir resultados diferentes no lado do modelo devido à aleatoriedade; manter o registro da combinação «prompt + imagem de entrada + parâmetros» permite, em uma regressão, julgar se o modelo mudou ou se você alterou a entrada.
Como organizar o fluxo de trabalho
Recomenda-se o processo em duas etapas «primeiro travar, depois iterar»: na primeira rodada, use o prompt mais simples apenas para verificar se o sujeito foi preservado; após confirmar que a fidelidade está adequada, na segunda rodada sobreponha alterações de estilo e fundo. Transforme configuração de parâmetros e pré-processamento da imagem de entrada (recorte, redimensionamento, unificação de formato) em funções utilitárias internas fixas, deixando o código de negócio apenas com a montagem do prompt e o disparo da chamada. Assim, na colaboração em equipe, fica evidente qual etapa de quem apresentou problema.
Controle de custos e estratégia de retry
Cobrança por imagem significa que cada «testada» tem um preço explícito. Controle de custos não é truque de economia, mas disciplina de engenharia.
Retry precisa ter limites
- Diferencie o tipo de erro antes de decidir repetir. Problemas 4xx como falha de autenticação, parâmetro inválido e identificador de modelo errado têm o mesmo resultado depois de cem tentativas, apenas consomem tempo; somente timeout, rate limit e falha temporária do upstream merecem retry.
- Limite o número de tentativas e o backoff. Um limite fixo de tentativas (por exemplo, no máximo duas) combinado com backoff exponencial evita amplificar requisições em picos de tráfego durante falhas.
- Atenção ao timeout de «sucesso incerto». Timeout de requisição não significa que nada foi gerado. Se o negócio permitir, verifique primeiro o resultado no lado da plataforma por ID de requisição ou logs, em vez de reenviar imediatamente.
O que o cache economiza é dinheiro real
A mesma imagem de entrada, o mesmo prompt e o mesmo conjunto de parâmetros costumam ser solicitados repetidamente no negócio — usuário atualiza a página, operação reexecuta tarefa, serviço downstream reenvia mensagem. Use «hash da imagem de entrada + prompt + parâmetros» como chave de cache; em caso de acerto, reutilize diretamente a imagem já gerada. O ganho dessa camada costuma ser mais direto que qualquer otimização de prompt.
A forma correta de processar em lote
- Agrupe itens semelhantes: reúna tarefas com parâmetros completamente idênticos em um lote, compartilhando um único fluxo de ajuste e revisão.
- Primeiro amostra pequena, depois volume: confirme o efeito com poucas amostras e depois expanda para o volume total, evitando que todo o lote fique inutilizável.
- Controle a quantidade de imagens por chamada: retornar várias imagens multiplica o custo de uma única chamada; defina conforme a necessidade real do negócio e não deixe no máximo por padrão.
- Defina guarda-corpos de orçamento: contabilize no nível de negócio o total acumulado de imagens geradas e alerte ou faça degradação quando ultrapassar o limite diário de orçamento, em vez de esperar a fatura do fim do mês.
Falhas precisam de degradação
Quando as tentativas se esgotam ou a qualidade continua abaixo do esperado, o fluxo precisa de um caminho claro de fallback: retornar imagem placeholder, reutilizar a última versão de material já revisado, encaminhar para tratamento manual ou avisar o usuário para tentar mais tarde. Um pipeline de imagem sem plano de degradação sempre acaba pagando a conta com «retry infinito».
Perguntas frequentes e checklist de solução de problemas
Fixar a ordem de investigação reduz significativamente o tempo de localização de falhas. Recomenda-se verificar item por item de cima para baixo.
A requisição falha diretamente
- Problema de autenticação: a Key é válida, está no cabeçalho correto, não foi sobrescrita por variável de ambiente com valor vazio.
- Identificador do modelo digitado errado:
gpt-image-2.6-sunburst/image-to-imageé longo; omitir o sufixo ou escrever outra variante de capacidade causa modelo não encontrado. Este é o erro básico mais frequente. - Parâmetro inválido: grafia do nome do campo, tipo incompatível (mistura de string e número), envio de campo inexistente na documentação.
- Imagem de entrada inacessível: URL expirada, requer autenticação, inacessível por CORS ou rede privada. Mudar para dados inline costuma permitir validação rápida.
- Cota e rate limit: quando o saldo é insuficiente ou o limite de taxa é atingido, a mensagem de erro costuma ser clara, mas é fácil tratá-la como «falha ocasional» e repetir cegamente.
A requisição tem sucesso, mas o resultado está errado
- O prompt descreve «reconstrução» em vez de «transformação»: ao transportar a escrita de texto para imagem para imagem para imagem, o modelo tende a recompor o quadro e o sujeito se perde. Mude para a estrutura «preservar X, alterar Y».
- A própria imagem de entrada tem informação insuficiente: sujeito muito pequeno, desfocado ou cortado; o modelo não tem estrutura para se basear. Tente uma imagem de referência mais nítida.
- Tamanho/proporção incompatíveis: a especificação de saída conflita com a proporção da imagem de entrada, causando corte ou esticamento. Unifique a proporção primeiro.
- Muitos itens contaminantes: sobrepor várias alterações de uma vez torna o resultado não atribuível. Divida em variável única e valide passo a passo.
- Instabilidade causada por aleatoriedade: execute várias vezes com a mesma entrada; se o resultado variar muito, o prompt é sensível demais à aleatoriedade e precisa ser mais específico, com restrições de preservação mais fortes.
Método básico de solução de problemas
Altere apenas uma variável por vez. Fixe a imagem de entrada e os parâmetros e mude apenas o prompt; ou fixe o prompt e mude apenas a imagem de entrada. Combinações «prompt + parâmetros» que já funcionaram no passado devem ser arquivadas; em caso de problema, primeiro faça rollback para a combinação validada e depois avance gradualmente rumo à nova necessidade. Além disso, lembre-se de verificar a cota da conta antes de qualquer depuração — diagnosticar um problema de saldo como problema de modelo é a situação que mais desperdiça tempo.
Quando trocar de modelo ou combinar usos
gpt-image-2.6-sunburst/image-to-image é uma ferramenta especializada, com limites claros, o que também significa que nem toda necessidade de imagem deve ser entregue a ele.
Sinais de que é hora de mudar para texto para imagem
- A necessidade é «desenhar uma imagem do zero», sem nenhuma referência, ou a referência é apenas uma descrição atmosférica opcional;
- O usuário sempre começa do vazio e não há ativo de imagem reutilizável no lado da entrada;
- Você percebe que está descrevendo longamente a composição no prompt, quando isso deveria ser responsabilidade da imagem de entrada.
O critério pode ser resumido em um ponto: quão forte é a dependência da tarefa em relação à imagem de entrada. Dependência forte, com transformação controlável sobre uma imagem existente, use imagem para imagem; dependência fraca, com foco em divergência criativa, use texto para imagem.
Cenários em que vale considerar combinação
- Texto para imagem como base, imagem para imagem para convergir: primeiro gerar rapidamente várias imagens conceituais com texto para imagem; depois de escolher a direção, usar imagem para imagem para unificar estilo e corrigir detalhes. Isso é mais eficiente do que ajustar repetidamente em um único modelo.
- Imagem para imagem + revisão manual: em cenários que envolvem materiais de marca e publicação externa, coloque o modelo no meio do pipeline, conectando revisão e conferência antes e depois, em vez de deixá-lo entregar diretamente ao usuário final.
- Imagem para imagem + pré-processamento por regras: trabalhos determinísticos como recorte, unificação de tamanho e conversão de formato devem ser feitos por código, deixando o modelo apenas com a parte criativa em que realmente é bom.
Quando parar
Se, após repetidos ajustes, o gargalo de qualidade vier de «esta tarefa em si excede a capacidade do modelo» — por exemplo, exigir tipografia precisa dentro da imagem, reprodução pixel a pixel, ou quadros contínuos com consistência entre frames — continuar adicionando prompts e retries não é econômico. Nesse momento, a atitude mais racional é trocar de modelo ou mudar essa etapa para processamento manual e por templates.
Na interface unificada do HiAPI.ai, trocar de modelo é apenas alterar um identificador de modelo, com custo de tentativa e erro muito baixo — esse é justamente o valor de abstrair a camada de integração. Pensar primeiro na essência da tarefa e depois decidir qual modelo usar economiza muito mais do que o contrário.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de integração do Gemini Omni 1.2 Flash: modos de entrada, parâmetros e cobrança por especificação
Caminho mínimo de integração do modelo público gemini-omni-1.2-flash: modos de entrada, restrições de parâmetros, requisições copiáveis e cobrança por resolução
-
Guia de uso
Troque o Claude Code pelo DeepSeek gratuito: configure agora e comece a usar direto em 24 de novembro
Três formas de conectar: Claude Code, Python e curl; valide a configuração gratuitamente agora
-
Guia de uso
Na Black Friday, quanto recarregar compensa mais: $100 rende 18% a mais, $500 rende 30% a mais
Quatro faixas de orçamento, de $50 a $500, convertidas em segundos de vídeo e quantidade de imagens