
Guida all'uso
Guida pratica a GPT-image-2.6-sunburst per image-to-image: limiti di capacità, fatturazione e pratiche ingegneristiche
Percorso pratico per sviluppatori dall'integrazione al go-live: capacità, parametri, costi e migliori pratiche
In questa pagina
Cosa può fare e cosa non può fare
gpt-image-2.6-sunburst/image-to-image è un modello di immagine fornito da OpenAI; già dall'identificatore del modello si legge il suo posizionamento: l'input è un'immagine, l'output è un'immagine, con tag di capacità image-to-image. Non è uno strumento di immagine tuttofare, ma un convertitore con responsabilità ben definite: gli si fornisce un'immagine di riferimento e, seguendo le tue istruzioni testuali, produce una nuova immagine.
Attività adatte a questo modello
- Trasferimento di stile e ridisegno: convertire fotografie reali in stili desiderati come illustrazione, acquerello, cyberpunk, preservando al contempo il profilo del soggetto.
- Modifica parziale o complessiva: cambiare lo sfondo, regolare l'atmosfera luminosa, uniformare la tonalità dell'immagine, ripulire gli elementi di disturbo.
- Produzione di varianti del materiale: partendo da un'immagine principale già approvata come base, generare in batch varianti con composizione simile ma dettagli diversi, per test A/B o per ampliare il pool di materiali.
- Dallo schizzo al lavoro finito: colorare e rifinire bozzetti a linee, bozzetti a blocchi di colore, schizzi a basso livello di completamento, accelerando il flusso di progettazione iniziale.
Il criterio di valutazione è semplice: se la tua esigenza può essere espressa con «un'immagine esistente + una descrizione delle modifiche», rientra nel campo di capacità del modello.
Cosa non è di sua competenza
- Generazione da puro testo. Creare da zero solo con un prompt, senza immagine di input, è dominio dei modelli text-to-image; non aspettarti che questo li sostituisca.
- Impaginazione precisa del testo. Quando è necessario renderizzare nel'immagine un testo specifico senza alcuna variazione (titoli di poster, testi su confezioni), il risultato generato richiede di solito una seconda revisione manuale.
- Riproduzione a livello di pixel. image-to-image è «riferimento e ridisegno», non «modifica senza perdite»; l'output non sarà identico pixel per pixel all'input.
- Video, 3D, audio. Il tipo di output è solo immagine.
- Garanzia di veridicità. Il modello non comprende se il contenuto dell'immagine sia reale o conforme; la revisione dei contenuti sensibili lato business deve essere gestita dal tuo processo.
Quando scegli, chiediti prima: nell'input c'è un'immagine? Nell'output serve un'immagine? Se entrambe le risposte sono «sì», continua a leggere; altrimenti cambiare modello fa risparmiare più tempo che ritoccare parametri.
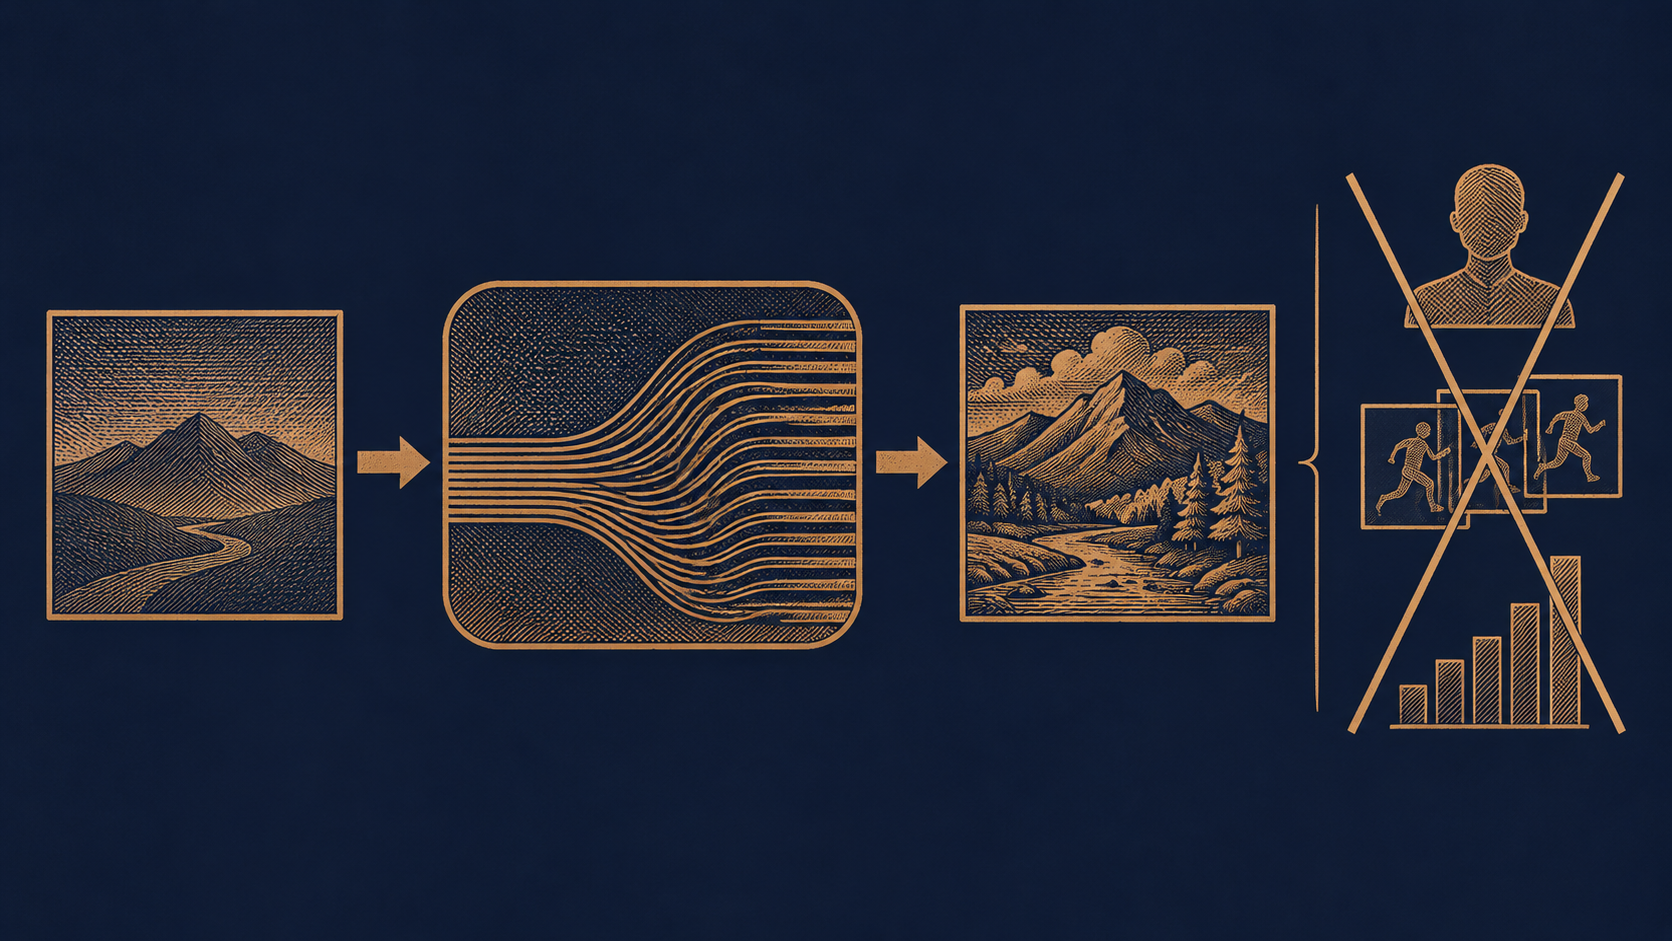
Percorso di integrazione: dall'API aggregata alla prima immagine generata
Per chiamare questo modello non serve integrarsi singolarmente con i fornitori upstream: basta passare dall'interfaccia unificata di HiAPI.ai. Il client invia una richiesta HTTP all'API aggregata, la piattaforma esegue autenticazione, routing e chiamata upstream, quindi restituisce l'immagine generata. L'intera catena espone allo sviluppatore un solo endpoint, un solo set di credenziali e un solo identificatore di modello.
Cosa preparare prima di iniziare
- API Key: creala nella console di HiAPI.ai, inseriscila nelle variabili d'ambiente lato server e non scriverla mai nel codice frontend né commitarla nel repository.
- Identificatore del modello: specifica esplicitamente
gpt-image-2.6-sunburst/image-to-imagenella richiesta, facendo attenzione al suffissoimage-to-image: le varianti con capacità diverse della stessa serie sono modelli indipendenti tra loro, e un suffisso errato porta direttamente a modello non trovato o a comportamenti diversi dalle aspettative. - Forma accessibile dell'immagine di input: verifica i metodi di trasmissione supportati dalla piattaforma (URL o base64) e assicurati che l'indirizzo dell'immagine sia raggiungibile durante la chiamata.
- Credito e quota: verifica il saldo dell'account e i limiti di frequenza, per evitare di incappare in un errore di quota già alla prima integrazione.
Percorso di verifica minimo
Non lanciare subito l'intero flusso di business. Procedi in questo ordine:
- Esegui prima una chiamata di esempio presa dalla documentazione della piattaforma per verificare «se restituisce un'immagine», controllando Key, identificatore del modello e connettività di rete;
- Poi sostituisci con la tua immagine di input reale e osserva se l'output è conforme alle aspettative;
- Infine incapsula questa chiamata in una funzione interna con timeout, retry e logging, e fai dipendere il codice di business solo da questa funzione.
Il valore di questo passo sta nell'isolare le variabili: al primo fallimento dovrai solo controllare autenticazione e parametri, invece di sospettare contemporaneamente immagine, prompt e logica di business. Per i nomi esatti dei campi della richiesta, le intestazioni di autenticazione e la struttura della risposta, fai riferimento alla documentazione ufficiale dell'interfaccia di HiAPI.ai e non applicare a memoria i formati di altri fornitori.
Parametri di chiamata e preparazione dell'immagine di input
La superficie dei parametri di questo modello è più ristretta rispetto al text-to-image, ma proprio perché è ristretta, applicare vecchie abitudini è il modo più facile di sbagliare. Di seguito illustriamo per categoria i punti di attenzione; per i nomi esatti dei campi, gli intervalli di valori e i valori predefiniti, fai riferimento alla documentazione ufficiale: questo articolo non li garantisce.
Categorie di parametri da tenere d'occhio
- Identificatore del modello: fisso a
gpt-image-2.6-sunburst/image-to-image; è l'unico parametro che deve essere corretto. - Prompt: descrive «in cosa va trasformato», non «cos'è».
- Campo immagine di input: URL o dati inline; di solito se ne supporta solo uno, oppure vanno usati in modo distinto secondo la documentazione.
- Specifiche di output: dimensioni, rapporto d'aspetto, formato di ritorno, ecc. Nota che l'output di image-to-image è spesso influenzato dal rapporto dell'immagine di input: forzare un rapporto non corrispondente può causare ritaglio o deformazione.
- Quantità: quante immagini generare per richiesta. Questo influisce direttamente sulla fatturazione; verifica con chiarezza il valore predefinito e non dare per scontato che «ne generi solo una».
- Casualità e seed: se la documentazione fornisce parametri di seed o di controllo della casualità, sono la chiave per riprodurre i problemi; in caso contrario, devi accettare che lo stesso input con lo stesso prompt possa produrre risultati diversi.
Quattro regole ferree per l'immagine di input
- Risoluzione sufficiente. Troppo bassa fa perdere dettagli al ridisegno, troppo alta aumenta solo il carico di trasmissione e preprocessing. Scegli una dimensione in cui il soggetto sia chiaramente riconoscibile senza essere pesante, e mantieni dimensioni uniformi per attività dello stesso tipo, così da poter confrontare i risultati.
- Formato uniforme. Concorda internamente un formato mainstream, evitando le differenze di canali alfa e artefatti di compressione derivanti dall'uso misto di PNG, JPEG e WebP. Se devi preservare la trasparenza, verifica in anticipo se il modello la supporta.
- Soggetto chiaro, spazi vuoti ragionevoli. Se l'immagine è piena di elementi, il modello farà fatica a capire quale parte vuoi modificare; ritagliare prima sull'area di interesse è più efficace di lunghe spiegazioni nel prompt.
- Conformità e autorizzazioni. L'immagine di input lascia il tuo sistema: verifica copyright, diritti d'immagine e conformità business prima di caricarla.
C'è un altro punto facilmente trascurato: non trasferire direttamente l'intero set di abitudini sui parametri dei modelli text-to-image. L'image-to-image non ha il concetto di «comporre da zero»; molti parametri che nel text-to-image regolano lo stile qui hanno semantica diversa o non esistono affatto, e copiarli ciecamente genera solo richieste inefficaci — e ogni richiesta inefficace viene fatturata.
Analisi del prezzo: cosa significa $0.023/immagine
Il criterio di fatturazione del modello è molto diretto: fatturazione a immagine, prezzo unitario $0.023 / immagine. Non ci sono scaglioni basati sui token, né si considera la dimensione dell'immagine di input, la lunghezza del prompt o il tempo di generazione: basta produrre con successo un'immagine per addebitare una volta. È una struttura di prezzo molto favorevole per gli sviluppatori, perché rende la stima dei costi una semplice moltiplicazione.
Costruisci il tuo modello di costo
Per stimare il totale bastano due variabili:
- Numero di immagini per richiesta: se il parametro consente di restituire più immagini in una volta, una chiamata viene conteggiata per il numero di immagini. In fase di integrazione verifica assolutamente il valore predefinito di questo parametro, altrimenti pensi di testare una sola immagine e in fattura ne trovi diverse.
- Numero di richieste valide: attenzione, è il numero di «generazioni riuscite», non di «quante volte hai premuto esegui» — ma d'altra parte, le chiamate sprecate per parametri errati, se hanno prodotto un'immagine, non vengono rimborsate.
Moltiplica questi due valori e poi per il volume giornaliero/mensile stimato lato business per ottenere la baseline di budget. Si consiglia di scrivere questa formula nella documentazione già all'avvio del progetto e di applicarla di nuovo a ogni modifica del flusso (aumento del numero di varianti, incremento dei tentativi, ampliamento dei batch), per evitare che i costi raddoppino senza che nessuno se ne accorga.
Tre voci di costo facilmente sottovalutate
- Costo di tentativi ed errori. Ogni generazione durante la messa a punto del prompt viene fatturata. Invece di provare ripetutamente in produzione, concentra il debug su un piccolo set fisso di immagini di test.
- Costo dei retry. Ripetere ciecamente la richiesta dopo un timeout di rete può significare che l'upstream ha già generato con successo, e tu hai pagato due immagini.
- Varianti ridondanti. Generare più immagini in una volta «per dare più scelta all'utente» non aumenta necessariamente la conversione, ma la spesa cresce di sicuro.
Per i numeri di fatturazione e i prezzi più recenti, fai riferimento al pannello prezzi del sito HiAPI.ai; questo articolo spiega solo il criterio, senza impegnarsi in una quotazione.
Migliori pratiche per prompt e workflow
Il prompt per image-to-image e quello per text-to-image sono due modi di scrivere diversi. Il text-to-image richiede di descrivere l'intera scena; l'image-to-image ha già un'immagine come base fattuale, e ciò che devi fare è descrivere il «cambiamento», non la «ricostruzione».
Struttura in quattro parti del prompt
Un prompt stabile e utilizzabile contiene di solito quattro blocchi; l'ordine può essere adattato, ma se ne manca uno è facile andare fuori strada:
- Cosa preservare: blocca prima le parti che non devono cambiare. «Mantieni invariati la posa e i tratti del volto della persona», «preserva la composizione e la posizione del soggetto dell'immagine originale». Questa frase riduce significativamente la deriva del soggetto.
- Cosa cambiare: specifica con verbi l'ambito della modifica. «Sostituisci lo sfondo con una strada in una notte di pioggia», «cambia la tonalità complessiva in arancione caldo».
- Stile e texture: indica lo stile e la qualità visiva desiderati, ad esempio «stile illustrazione flat, luce morbida, effetto pellicola a bassa saturazione».
- Esclusioni: scrivi ciò che non vuoi. «Non aggiungere personaggi extra», «non inserire testo». I vincoli negativi nei task di immagine sono spesso più efficaci delle descrizioni positive.
Tre regole empiriche
- Modifica una sola categoria di elementi per volta. Cambiare contemporaneamente sfondo, luce e stile rende il risultato non attribuibile, e in caso di problema non saprai quale frase del prompt lo ha causato.
- Il prompt deve essere breve e specifico. Accumulare aggettivi non migliora la qualità, anzi diluisce il punto focale. Spiegare chiaramente una modifica entro venti parole è di solito più stabile che con duecento parole.
- Versionare i prompt di successo. Lo stesso prompt può produrre risultati diversi lato modello per via della casualità; conservare la combinazione «prompt + immagine di input + parametri» è l'unico modo per capire, in fase di regressione, se è cambiato il modello o sei tu ad aver modificato l'input.
Come organizzare il workflow
Si consiglia un flusso in due fasi «prima blocca, poi itera»: al primo round usa il prompt più semplice per verificare solo se il soggetto è preservato; dopo aver confermato che la fedeltà è accettabile, al secondo round sovrapponi modifiche di stile e sfondo. Rendi la configurazione dei parametri e il preprocessing dell'immagine di input (ritaglio, ridimensionamento, uniformazione del formato) funzioni interne fisse, e lascia che il codice di business si occupi solo di comporre il prompt e avviare la chiamata. Così, quando il team collabora, è immediatamente chiaro quale anello ha causato il problema.
Controllo dei costi e strategia di retry
Fatturazione a immagine significa che ogni «prova e vediamo» ha un cartellino del prezzo esplicito. Il controllo dei costi non è una tecnica per risparmiare, ma disciplina ingegneristica.
I retry devono avere confini
- Distinguere il tipo di errore prima di decidere se riprovare. Problemi 4xx come autenticazione fallita, parametri non validi, identificatore di modello errato danno lo stesso risultato anche con cento retry, consumando solo tempo; solo timeout, rate limiting e guasti temporanei upstream meritano un retry.
- Limitare numero di retry e backoff. Un limite massimo fisso (ad esempio massimo due tentativi) combinato con backoff esponenziale evita che durante un guasto le richieste si trasformino in un picco di traffico.
- Attenzione ai timeout «a esito incerto». Un timeout della richiesta non significa che non sia stata generata. Se il business lo consente, verifica prima il risultato lato piattaforma tramite ID di richiesta o log, invece di reinviare immediatamente.
Ciò che la cache fa risparmiare è denaro reale
La stessa immagine di input, lo stesso prompt e lo stesso set di parametri vengono spesso richiesti ripetutamente lato business — l'utente ricarica la pagina, l'operatore riesegue il task, il servizio downstream ripete il messaggio. Usa «hash dell'immagine di input + prompt + parametri» come chiave di cache e, in caso di hit, riutilizza direttamente l'immagine già generata. Il beneficio di questo livello è di solito più diretto di qualsiasi ottimizzazione del prompt.
Il modo corretto di gestire i batch
- Raggruppa elementi simili: raggruppa i task con parametri identici in un batch, condividendo debug e revisione.
- Prima piccoli campioni, poi scalabilità: conferma l'effetto con pochi campioni, poi estendi all'intero volume, evitando di produrre batch interi inutilizzabili.
- Controlla il numero di immagini per chiamata: la restituzione di più immagini moltiplica il costo di una singola chiamata; impostalo secondo le necessità effettive del business e non portarlo al massimo per impostazione predefinita.
- Imposta barriere di budget: conta lato business il numero cumulativo di immagini generate e avvisa o degrada quando superi la soglia di budget giornaliero, invece di guardare la fattura a fine mese.
I fallimenti devono avere una degradazione
Quando i retry sono esauriti o la qualità non è costantemente all'altezza, il flusso ha bisogno di un percorso di fallback esplicito: restituire un'immagine segnaposto, riutilizzare la versione precedente del materiale approvato, passare alla gestione manuale, oppure invitare l'utente a riprovare più tardi. Una catena di elaborazione immagini senza piano di degradazione finisce sempre per pagare con «retry infiniti».
Domande frequenti e checklist di risoluzione dei problemi
Fissare l'ordine di risoluzione dei problemi riduce significativamente il tempo di localizzazione dei guasti. Si consiglia di verificare voce per voce dall'alto verso il basso.
La richiesta fallisce direttamente
- Problemi di autenticazione: la Key è valida, è nell'intestazione corretta, non è stata sovrascritta a vuoto da una variabile d'ambiente.
- Identificatore del modello scritto male:
gpt-image-2.6-sunburst/image-to-imageè lungo; dimenticare il suffisso o scrivere un'altra variante di capacità porta a modello non trovato. È l'errore banale più frequente. - Parametri non validi: refusi nei nomi dei campi, tipi non corrispondenti (stringhe e numeri mescolati), campi inesistenti nella documentazione.
- Immagine di input non raggiungibile: URL scaduto, autenticazione richiesta, cross-domain o rete privata non accessibile. Passare ai dati inline spesso consente di verificare rapidamente.
- Quota e rate limiting: con saldo insufficiente o limite di frequenza attivato, il messaggio di errore è di solito chiaro, ma viene facilmente scambiato per «fallimento sporadico» e ritentato ciecamente.
La richiesta riesce ma il risultato non è corretto
- Il prompt descrive «ricostruzione» invece di «modifica»: trasferendo lo stile di scrittura del text-to-image nell'image-to-image, il modello tende a ricomporre, e il soggetto si perde. Passa alla struttura «preserva X, modifica Y».
- L'immagine di input stessa è carente di informazioni: soggetto troppo piccolo, sfocato, ritagliato; il modello non ha strutture su cui basarsi. Prova con un'immagine di riferimento più nitida.
- Dimensioni/rapporto non corrispondenti: le specifiche di output confliggono con il rapporto dell'immagine di input, causando ritaglio o allungamento. Uniforma prima il rapporto.
- Troppi elementi di disturbo: sovrapporre più modifiche in una volta rende il risultato non attribuibile. Suddividi in singole variabili da verificare passo passo.
- Instabilità dovuta alla casualità: esegui più volte con lo stesso input; se il risultato oscilla in modo evidente, significa che il prompt è troppo sensibile alla casualità e va scritto in modo più specifico, con vincoli di preservazione più forti.
Metodo di base per la risoluzione dei problemi
Modifica una sola variabile per volta. Fissa immagine di input e parametri e cambia solo il prompt; oppure fissa il prompt e cambia solo l'immagine di input. Le combinazioni «prompt + parametri» che hanno funzionato in passato vanno archiviate; in caso di problema, prima esegui il rollback alla combinazione verificata, poi procedi gradualmente verso le nuove esigenze. Inoltre, ricorda di dare un'occhiata al credito dell'account prima di qualsiasi debug — scambiare un problema di saldo per un problema del modello è la situazione che fa perdere più tempo.
Quando cambiare modello o usarli in combinazione
gpt-image-2.6-sunburst/image-to-image è uno strumento specializzato, con confini chiari, il che significa anche che non tutte le esigenze di immagine vanno affidate a lui.
Segnali per passare al text-to-image
- L'esigenza è «disegnare da zero», senza alcuna immagine di riferimento, o con un riferimento solo opzionale per l'atmosfera;
- L'utente parte ogni volta da un foglio bianco e lato input non esistono asset immagine riutilizzabili;
- Ti accorgi di descrivere nel prompt lunghe composizioni che dovrebbero essere veicolate dall'immagine di input.
Il criterio di valutazione si può riassumere in una frase: quanto il task dipende dall'immagine di input. Dipendenza forte, con modifica controllabile su una scena esistente, usa image-to-image; dipendenza debole, con prevalenza di esplorazione creativa, usa text-to-image.
Scenari in cui considerare la combinazione
- Text-to-image come base, image-to-image per convergere: prima genera rapidamente con text-to-image alcune immagini concettuali, poi, scelta la direzione, usa image-to-image per uniformare lo stile e correggere i dettagli. È più efficiente che ritoccare a lungo sullo stesso modello.
- Image-to-image + revisione manuale: per materiali di brand e pubblicazioni esterne, colloca il modello a metà della pipeline, con revisione e correzione sia prima che dopo, invece di farlo produrre direttamente verso l'utente finale.
- Image-to-image + preprocessing a regole: attività deterministiche come ritaglio, uniformazione delle dimensioni e conversione di formato vanno affidate al codice; il modello si occupa solo della parte creativa in cui eccelle davvero.
Quando fermarsi
Se dopo ripetuti debug scopri che il collo di bottiglia della qualità deriva dal fatto che «questo task supera le capacità del modello» — ad esempio richiede impaginazione precisa di testo nell'immagine, riproduzione pixel per pixel, o sequenze continue con coerenza tra fotogrammi — allora continuare ad aggiungere prompt e retry non è economico. In questo caso l'approccio più razionale è cambiare modello, oppure spostare quel passaggio su gestione manuale e template.
Con l'interfaccia unificata di HiAPI.ai, cambiare modello significa solo cambiare un identificatore di modello, e il costo dei tentativi è basso — è anche questo il valore di astrarre il livello di integrazione. Prima chiarisci la natura del task, poi decidi quale modello usare: è molto più economico del contrario.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida all'integrazione di Gemini Omni 1.2 Flash: modalità di input, parametri e fatturazione per specifica
Percorso di integrazione minimo per il modello pubblico gemini-omni-1.2-flash: modalità di input, vincoli dei parametri, richieste copiabili e fatturazione per risoluzione
-
Guida all'uso
Claude Code passa a DeepSeek gratuito: configura ora e lancia il 24 novembre
Tre modi per collegarlo: Claude Code, Python e curl; puoi verificare la configurazione gratuitamente già ora
-
Guida all'uso
Quanto conviene ricaricare per il Black Friday: con $100 ottieni il 18% in più, con $500 il 30% in più
Quattro budget da $50 a $500, convertiti in secondi di video e numero di immagini