
使用ガイド
GPT-image-2.6-sunburst 画像変換ガイド:能力の境界、課金、エンジニアリング実践
接続からリリースまでの開発者実践ロードマップ:能力、パラメータ、コスト、ベストプラクティス
このページの内容
できること・できないこと
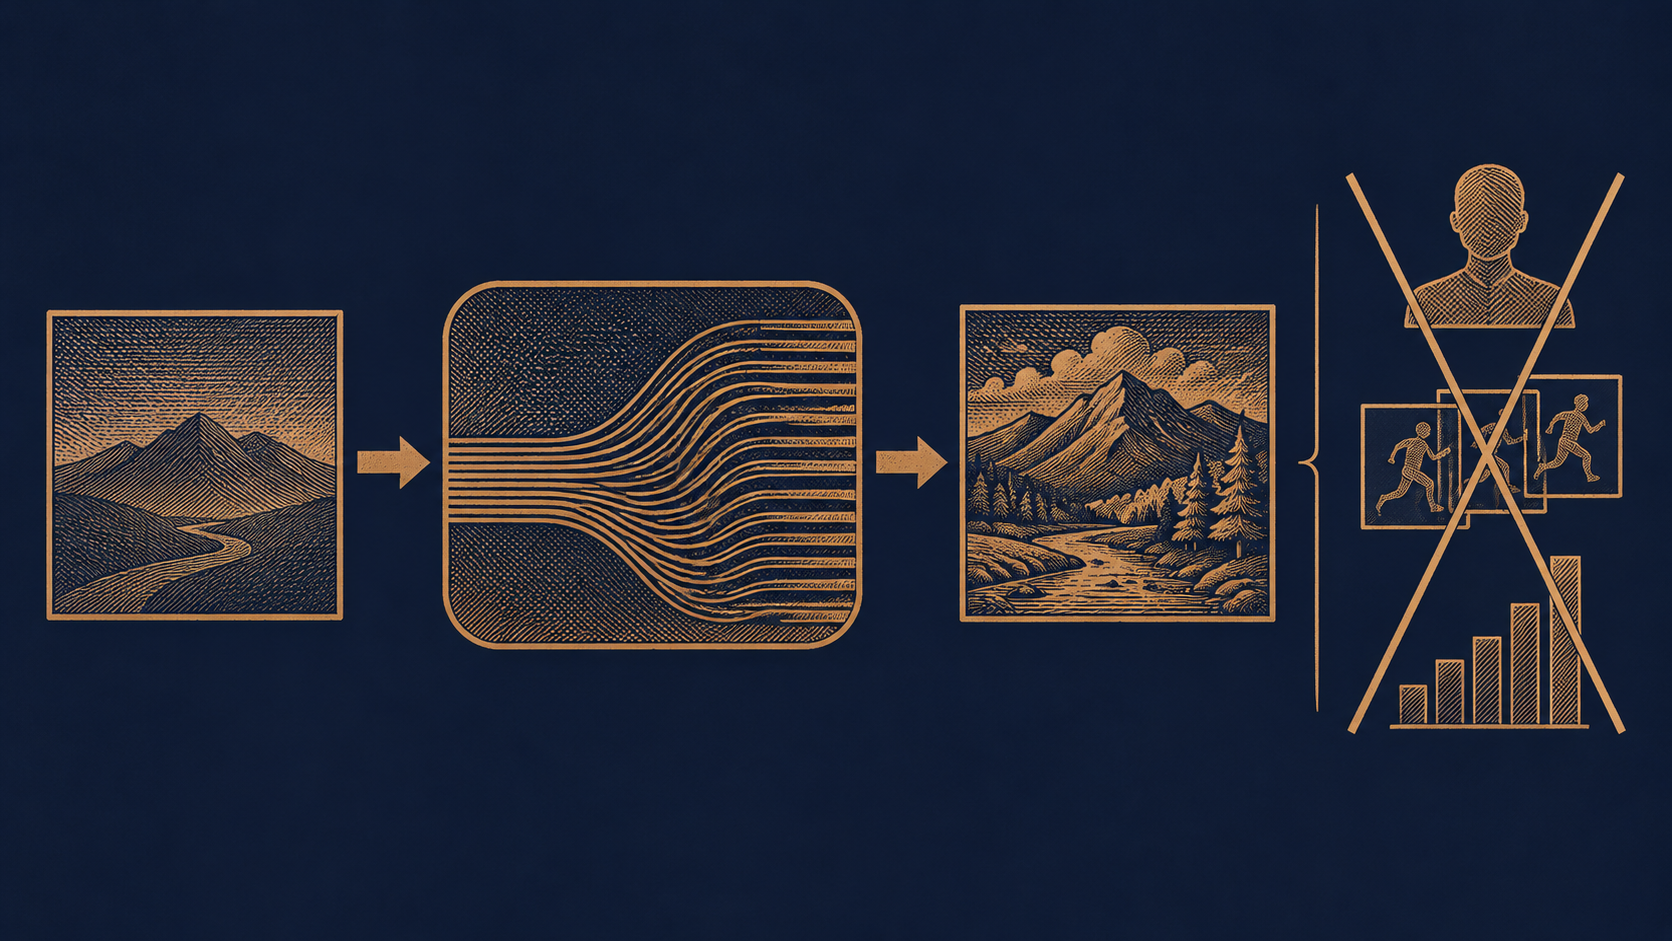
gpt-image-2.6-sunburst/image-to-image は OpenAI が提供する画像モデルで、モデル識別子からその位置づけが読み取れます:入力は画像、出力は画像であり、能力タグは image-to-image です。万能な画像ツールではなく、役割が明確な変換器です——参考画像を渡すと、あなたのテキスト指示に従って新しい画像を生成します。
任せるのに適したタスク
- スタイル変換と再描画:実写写真をイラスト、水彩、サイバーパンクなどの目標スタイルに変換しつつ、被写体の輪郭を保持します。
- 部分または全体の改変:背景の差し替え、光の雰囲気の調整、画面全体の色調の統一、不要物の除去。
- 素材バリエーションの生成:確定済みのメイン画像を基準に、構図が近く細部が異なるバリエーションを一括で派生させ、A/B テストや素材プールの拡充に利用します。
- スケッチから完成稿へ:線画、色ブロック稿、完成度の低いスケッチに色を塗り細部を描き込み、デザインの前工程を加速します。
判断基準はシンプルです:あなたの要件が「既存の画像1枚 + 修正内容の記述」で説明できるなら、それはモデルの能力範囲内にあります。
担当しない部分
- 純粋なテキストからの画像生成。入力画像がなく、プロンプトだけでゼロから創作するのはテキスト画像生成モデルの領域であり、これで代替しようと期待してはいけません。
- 正確な文字組み。指定した文言を一字一句違わず画面に描画する必要がある場合(ポスターのタイトル、パッケージの文字)、生成結果は通常人手による二次校正が必要です。
- ピクセル単位の複製。image-to-image は「参考と再描画」であり「ロスレス編集」ではなく、出力と入力画像がピクセル単位で一致することはありません。
- 動画、3D、音声。出力タイプは画像のみです。
- 事実性の保証。画面内容が現実的・法令遵守的かどうかを理解するわけではないため、業務側のセンシティブコンテンツ審査は自前のフローで担う必要があります。
モデル選定の際はまず自問してください:入力に画像はあるか?出力に求めるのは画像か?両方とも「はい」なら読み進めてください。そうでなければ、パラメータを調整するよりもモデルを変える方が時間の節約になります。
接続経路:集約 API から最初の画像生成まで
このモデルを呼び出すのに上流ベンダーごとに個別接続する必要はなく、HiAPI.ai の統一インターフェースを経由すれば済みます:クライアントは集約 API に HTTP リクエストを1回送信し、プラットフォームが認証、ルーティング、上流呼び出しを完了して、生成された画像を返します。開発者に対しては、エンドポイント1つ、認証情報1セット、モデル識別子1つだけが公開されます。
作業前に準備するもの
- API Key:HiAPI.ai のコンソールで作成し、サーバー側の環境変数に格納してください。フロントエンドコードに書いたりリポジトリにコミットしたりしてはいけません。
- モデル識別子:リクエストで
gpt-image-2.6-sunburst/image-to-imageを明示的に指定します。image-to-imageサフィックスを忘れずに——同じシリーズ内の異なる能力のバリエーションは互いに独立したモデルであり、サフィックスを誤るとモデルが見つからない、または想定と異なる動作に直結します。 - 入力画像のアクセス可能な形式:プラットフォームがサポートする渡し方(URL か base64 か)を確認し、画像アドレスが呼び出し期間中にアクセス可能であることを保証します。
- クレジットとクォータ:アカウント残高とレート制限を確認し、初回の結合テストでクォータエラーに当たらないようにします。
最小検証パス
いきなり完全な業務フローを実行しないでください。この順序で進めます:
- まずプラットフォームのドキュメントにあるサンプルリクエストで「画像を返せる」呼び出しを1回通し、Key、モデル識別子、ネットワーク接続性を検証する;
- 次に自分の実際の入力画像に差し替えて、出力が期待どおりか観察する;
- 最後にこの呼び出しをタイムアウト、リトライ、ログを備えた内部関数としてカプセル化し、業務コードはこの関数にのみ依存させる。
このステップの価値は変数の切り分けにあります:最初の失敗時に認証とパラメータだけを調査すればよく、画像、プロンプト、業務ロジックを同時に疑う必要がありません。具体的なリクエストフィールド名、認証ヘッダー、レスポンス構造は HiAPI.ai の公式インターフェースドキュメントに準拠し、記憶を頼りに他ベンダーの形式を流用しないでください。
呼び出しパラメータと入力画像の準備
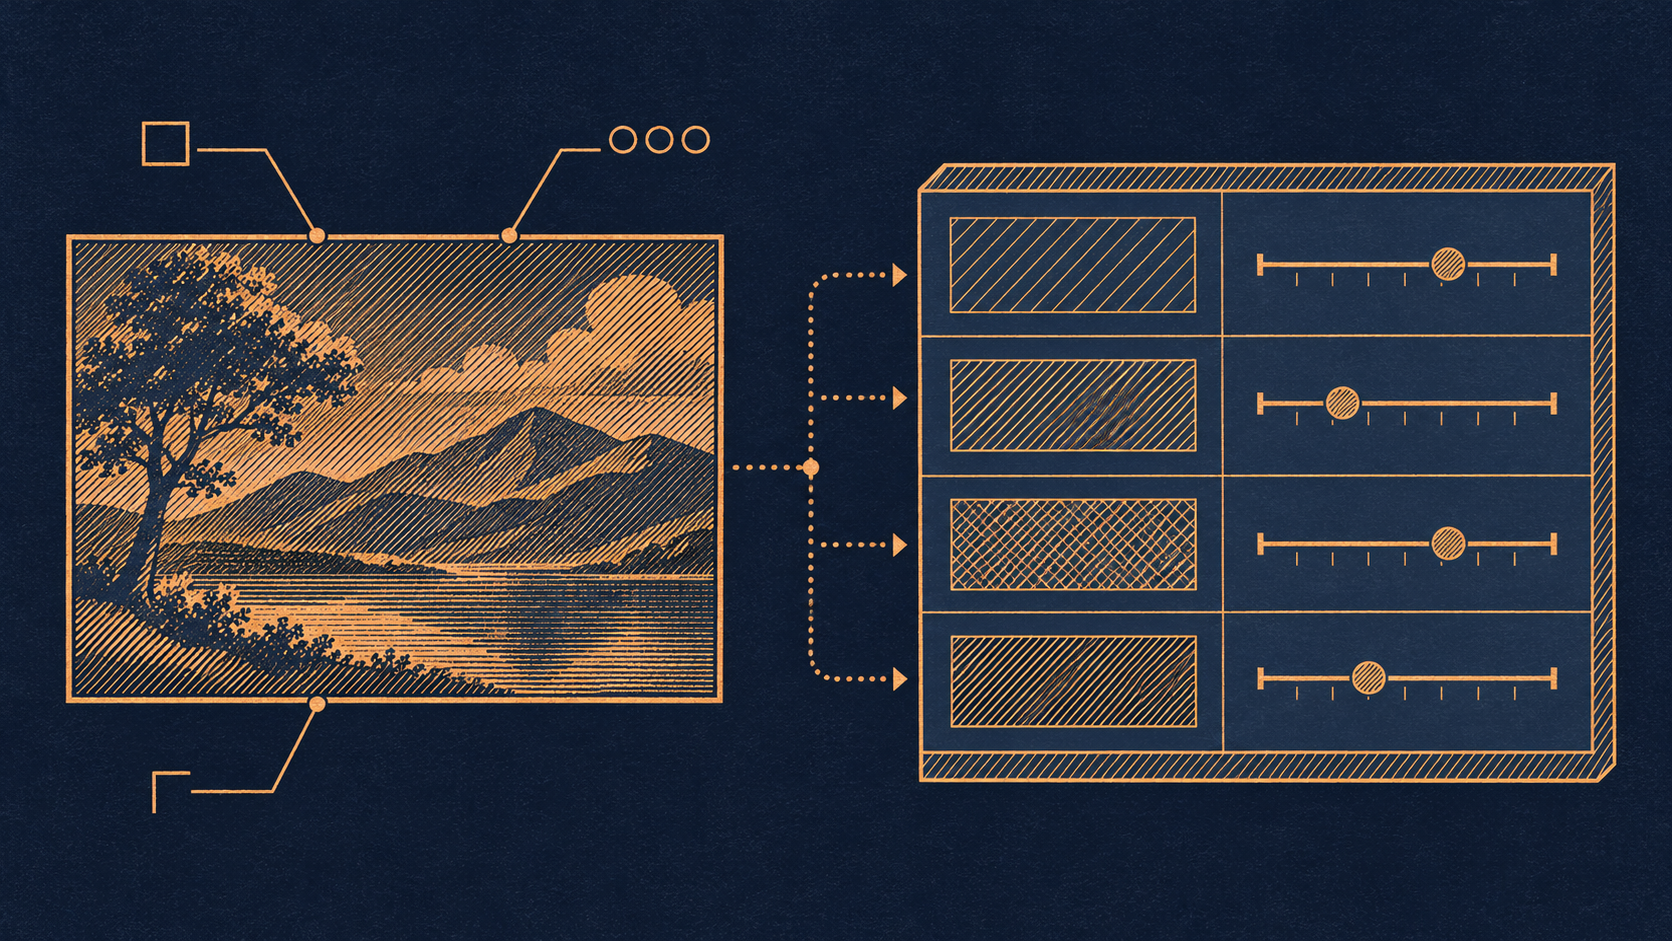
このモデルのパラメータ面はテキスト画像生成より狭いですが、狭いからこそ従来の習慣を流用すると最も間違えやすいです。以下カテゴリ別に注目点を説明します;フィールドの正確な名称、値の範囲、デフォルト値は公式ドキュメントに準拠してください。本文では約束しません。
注目すべきパラメータのカテゴリ
- モデル識別子:
gpt-image-2.6-sunburst/image-to-imageに固定。これが唯一必ず正しくなければならないパラメータです。 - プロンプト:「これが何か」ではなく「どう変えるか」を記述します。
- 入力画像フィールド:URL かインラインデータか。通常はどちらか一方のみサポート、またはドキュメントに従って使い分けます。
- 出力仕様:サイズ、アスペクト比、返却形式など。画像変換の出力は入力画像の比率に影響されることが多いため、不一致の比率を無理に指定するとトリミングや変形を引き起こす可能性があります。
- 数量:1回のリクエストで何枚生成するか。課金に直結するため、デフォルト値を明確に確認し、「1枚だけ」と思い込まないでください。
- ランダム性とシード:ドキュメントがシードやランダム制御パラメータを提供する場合、それは問題再現の鍵です;なければ、同じ入力・同じプロンプトでも異なる結果が得られることを受け入れる必要があります。
入力画像の4つの厳守事項
- 解像度は十分であればよい。低すぎると再描画で細部が失われ、高すぎると転送と前処理の負担が増えるだけです。被写体が明確に判別でき、かつ肥大でないサイズを選び、同種タスクで統一サイズを使うことで横比較が容易になります。
- 形式を統一。チーム内で主流の形式を1つ取り決め、PNG、JPEG、WebP の混用による透過チャネルや圧縮アーティファクトの差異を避けます。透明度を保持する必要がある場合は、モデルがサポートするか事前に確認してください。
- 被写体が明確で、余白が適切。画面に要素が詰まりすぎていると、モデルはどこを変えたいのか判断しにくくなります;関心領域に先にトリミングする方が、プロンプトで長々と説明するより効果的です。
- コンプライアンスとライセンス。入力画像はあなたのシステムの外に出るため、著作権、肖像権、業務コンプライアンスを確認してからアップロードしてください。
もう一つ見落としがちな点:テキスト画像生成モデルのパラメータ習慣を一式そのまま持ち込まないでください。画像変換には「ゼロからの構図」という概念がなく、テキスト画像生成でスタイルを調整する多くのパラメータはここでは意味が異なるか存在しません。盲目的に流用すると無効なリクエストを生むだけであり——しかも無効なリクエストはすべて課金対象です。
価格の分解:$0.023/枚 が意味するもの
このモデルの課金基準は非常に直接的です:枚数課金、単価は $0.023 / 枚。トークンによる段階はなく、入力画像のサイズ、プロンプトの長さ、生成時間にも依存しません。1枚の画像が正常に生成されれば1回分の料金が発生します。これは開発者にとって非常に優しい価格構造で、コスト見積もりを掛け算に変えてくれます。
独自のコストモデルを構築する
総額の見積もりに必要な変数は2つだけです:
- 1回のリクエストでの生成枚数:パラメータが1回で複数枚を返せる場合、1回の呼び出しは枚数分累積されます。結合テスト段階ではこのパラメータのデフォルト値を必ず確認してください。そうしないと1枚をテストしているつもりが、請求書には数枚分が載ります。
- 有効リクエスト回数:「成功した画像生成」の回数であり、「何回実行ボタンを押したか」ではないことに注意——ただし逆に言えば、パラメータ設定ミスで無駄になった呼び出しでも、画像が生成された以上返金はありません。
この2つを掛け合わせ、さらに業務側で見積もった日次/月次呼び出し量を掛ければ予算のベースラインが得られます。プロジェクト開始時にこの式をドキュメントに書き込んでおき、その後のあらゆるフロー変更(バリエーション数の増加、リトライ回数の増加、バッチの拡大)のたびに当てはめ直すことで、誰も気づかないうちにコストが倍増するのを避けられます。
過小評価しがちな3つのコスト項目
- 試行錯誤コスト。プロンプト調整段階の生成は毎回課金されます。オンラインで何度も試すより、少数の固定テスト画像にデバッグを集中させましょう。
- リトライコスト。ネットワークタイムアウト後に考えなしにリトライすると、上流では実は生成成功している可能性があり、2枚分の料金を払うことになります。
- 冗長なバリエーション。「ユーザーに選択肢を多く」と1回で複数枚生成しても、コンバージョン率が上がるとは限らず、支出は確実に増えます。
課金数値と最新価格は HiAPI.ai サイトの価格パネルに準拠してください。本文は基準を説明するのみで、価格の約束は行いません。
プロンプトとワークフローのベストプラクティス
画像変換のプロンプトとテキスト画像生成は別の書き方です。テキスト画像生成では画面全体を描写する必要があります;画像変換ではすでに事実の基礎となる画像があるため、あなたがすべきは「再構築」ではなく「変更」を記述することです。
プロンプトの4段構成
安定して使えるプロンプトは通常4つのブロックを含みます。順序は調整できますが、1つ欠けるとズレやすくなります:
- 何を保持するか:まず動かせない部分を固定します。「人物のポーズと顔の特徴を変えない」「元画像の構図と被写体位置を保持する」。この一文で被写体のドリフトを大幅に減らせます。
- 何を変えるか:動詞で改変範囲を明確にします。「背景を雨夜の街並みに置き換える」「全体の色調を暖かいオレンジに変える」。
- スタイルと質感:目標スタイルと画面の質感を説明します。例えば「フラットイラスト風、柔らかな光と影、低彩度のフィルム感」。
- 除外項目:欲しくないものを書きます。「追加の人物を入れない」「文字を出さない」。画像タスクではネガティブ制約がポジティブ描写より効くことがよくあります。
3つの経験則
- 一度に変えるのは1種類だけ。背景、光、スタイルを同時に変えると結果の原因が特定できず、問題が起きてもどのプロンプトが原因か分かりません。
- プロンプトは短く具体的に。形容詞を積み重ねても品質は上がらず、重点が薄まるだけです。20語以内で1つの変更を説明する方が、200語より安定することが多いです。
- 成功したプロンプトをバージョン管理する。同じプロンプトでもモデル側のランダム性で異なる結果が出る可能性があるため、「プロンプト + 入力画像 + パラメータ」の組み合わせ記録を残すことで、回帰時にモデルが変わったのか入力が変わったのか判断できます。
ワークフローの組み方
「まず固定、次に反復」の2段階フローを推奨します:第1ラウンドは最もシンプルなプロンプトで被写体が保持されるかだけを検証;保真度が合格と確認できたら、第2ラウンドでスタイルと背景の改変を重ねます。パラメータ設定、入力画像の前処理(トリミング、リサイズ、形式統一)を固定の内部ツール関数にし、業務コードはプロンプトの組み立てと呼び出しの開始だけを担当します。こうすればチーム協働時に、誰の工程で問題が起きたかが一目で分かります。
コスト管理とリトライ戦略
枚数課金はすべての「ちょっと試す」に明確な価格タグがあることを意味します。コスト管理は節約テクニックではなく、エンジニアリングの規律です。
リトライには境界を設ける
- エラー種別を区別してからリトライを決める。認証失敗、パラメータ不正、モデル識別子エラーといった 4xx 問題は、100回リトライしても結果は同じで、時間を無駄にするだけです;リトライに値するのはタイムアウト、レート制限、上流の一時的障害のみです。
- リトライ回数とバックオフを制限する。固定回数の上限(例えば最大2回)と指数バックオフを組み合わせ、障害期間中にリクエストがトラフィックの奔流に増幅されるのを避けます。
- 「成功が不確かな」タイムアウトに注意。リクエストタイムアウトは生成されなかったことを意味しません。業務が許すなら、すぐに再送するのではなく、リクエスト ID やログを通じてプラットフォーム側に結果を確認することを優先してください。
キャッシュで節約できるのはすべて実費
同じ入力画像、同じプロンプト、同じパラメータの組み合わせは、業務上しばしば重複リクエストされます——ユーザーがページを更新する、運用がタスクを再実行する、下流サービスがメッセージを再生する。 「入力画像ハッシュ + プロンプト + パラメータ」をキャッシュキーとし、ヒットすれば生成済みの画像をそのまま再利用します。この層の收益は通常、どんなプロンプト最適化よりも直接的です。
バッチ処理の正しい作法
- 同類項をまとめる:パラメータが完全に一致するタスクを1バッチにまとめ、デバッグと審査のフローを共有します。
- まず少量、その後拡大:少量のサンプルで効果を確認してから全体に拡大し、バッチ全体が使えない事態を避けます。
- 1回の生成枚数を制御する:複数枚返却は1回の呼び出しコストを倍増させるため、業務の実際の必要に応じて設定し、デフォルトで最大にしないでください。
- 予算のガードレールを設ける:業務層で累計生成枚数を集計し、日次予算の閾値を超えたらアラートまたは降級する。月末に請求書を見てからでは遅いです。
失敗には降級を用意する
リトライを使い果たした、または品質が継続的に基準を満たさない場合、フローには明確なフォールバックパスが必要です:プレースホルダー画像を返す、前版の審査済み素材を使う、人手処理に切り替える、またはユーザーに後で再試行するよう促す。降級方案のない画像パイプラインは、最終的に「無限リトライ」でツケを払うことになります。
よくある問題とトラブルシューティングチェックリスト
トラブルシューティングの順序を固定すると、故障の特定時間を大幅に短縮できます。上から下へ項目ごとに確認することをお勧めします。
リクエストが直接失敗する
- 認証問題:Key は有効か、正しいリクエストヘッダーに置かれているか、環境変数で空値に上書きされていないか。
- モデル識別子の誤記:
gpt-image-2.6-sunburst/image-to-imageは長く、サフィックスの漏れや別の能力バリエーションへの誤記はモデルが見つからない原因になります。これが最も頻度の高い初歩的ミスです。 - パラメータ不正:フィールド名の誤記、型の不一致(文字列と数値の混用)、ドキュメントに存在しないフィールドの送信。
- 入力画像に到達できない:URL の期限切れ、認証が必要、クロスドメインまたはプライベートネットワークでアクセス不可。インラインデータに変えると素早く検証できることが多いです。
- クォータとレート制限:残高不足やレート制限に達した場合、エラーメッセージは通常明確ですが、「偶発的な失敗」と誤解して考えなしにリトライしがちです。
リクエストは成功するが結果が違う
- プロンプトが「改変」ではなく「再構築」を記述している:テキスト画像生成の書き方を画像変換に持ち込むと、モデルは構図を作り直す傾向があり、被写体がズレます。「X を保持し、Y を変更する」という文型に変えてください。
- 入力画像自体の情報が不足:被写体が小さすぎる、ぼやけている、トリミングされていると、モデルが依拠すべき構造を持てません。より鮮明な参考画像に変えて試してください。
- サイズ/比率の不一致:出力仕様と入力画像の比率が衝突し、トリミングや引き伸ばしが発生。まず比率を統一してください。
- 汚染項目が多すぎる:一度に複数の変更を重ねると結果の原因が特定できません。単一変数に分解して段階的に検証してください。
- ランダム性による不安定さ:同じ入力で何度か実行し、結果の変動が明らかな場合、そのプロンプトがランダム性に敏感すぎることを示します。より具体的に書き、保持制約を強める必要があります。
トラブルシューティングの基本方法
一度に1つの変数だけ変える。入力画像とパラメータを固定しプロンプトだけ変える;またはプロンプトを固定し入力画像だけ変える。過去に成功した「プロンプト + パラメータ」の組み合わせは保管し、問題が起きたらまず検証済みの組み合わせにロールバックし、そこから段階的に新要件へ進めてください。また、デバッグ前に必ずアカウントのクレジットを確認することを忘れないでください——残高問題をモデル問題と誤認するのは、最も時間を浪費するケースです。
いつモデルを変えるべきか、組み合わせて使うべきか
gpt-image-2.6-sunburst/image-to-image は専精ツールであり、その境界は明確です。それはすべての画像ニーズをこれに任せるべきではないことも意味します。
テキスト画像生成に切り替えるべきシグナル
- 要件が「ゼロから1枚描く」で、参考画像がまったくない、または参考画像がなくてもよい雰囲気説明程度;
- ユーザーが毎回空白から始め、入力側に再利用可能な画像資産が存在しない;
- プロンプトで長々と構図を説明していることに気づいたが、それは本来入力画像が担うべきもの。
判断根拠は1つに集約できます:タスクが入力画像にどれだけ依存するか。依存が強く、既存画面に対して制御可能な改変を行いたいなら画像変換;依存が弱く、創造的発散が主体ならテキスト画像生成。
組み合わせを検討すべきシーン
- テキスト画像生成で下地、画像変換で収束:まずテキスト画像生成で概念図をいくつか素早く生成し、方向性を選定してから画像変換でスタイル統一と細部修正を行う。1つのモデルで繰り返し無理に調整するより効率的です。
- 画像変換 + 人手審査:ブランド素材や対外公開が絡むシーンでは、モデルをパイプラインの中段に置き、前後に審査と校正の工程を接続し、エンドユーザーに直接出力させないようにします。
- 画像変換 + ルール化された前処理:トリミング、サイズ統一、形式変換といった決定論的な作業はコードに任せ、モデルは本当に得意な創作部分だけを担当します。
いつ止めるべきか
繰り返し調整した末に、品質のボトルネックが「このタスク自体がモデルの能力を超えている」ことに由来すると分かった場合、例えば画面内の正確な文字組み、ピクセル単位の復元、フレーム間の一貫性を要する連続画面などを要求する場合、プロンプトを足しリトライを重ねるのは経済的ではありません。この時はモデルを変えるか、その工程を人手やテンプレート処理に変える方が理性的です。
HiAPI.ai の統一インターフェース下では、モデル変更は識別子を1つ変えるだけであり、試行錯誤コストは非常に低い——これこそが接続層を抽象化する価値の所在です。まずタスクの本質を考え、それからどのモデルを使うかを決める方が、逆よりずっと節約になります。
関連記事
すべての記事を見る →-

使用ガイド
Gemini Omni 1.2 Flash 接続ガイド:入力モード、パラメータ、スペック別課金
公開モデル gemini-omni-1.2-flash の最小接続パス:入力モード、パラメータ制約、コピー可能なリクエスト、解像度別課金
-
使用ガイド
Claude Code を無料の DeepSeek に切り替え:今設定しておけば、11 月 24 日にそのまま走り出す
Claude Code、Python、curl の 3 通りの接続方法。今すぐ無料で設定を検証できます
-
使用ガイド
ブラックフライデーはいくらチャージするのが一番お得:$100で18%増量、$500で30%増量
$50から$500までの4段階の予算を、それぞれ動画何秒分・画像何枚分に換算