
Benutzerhandbuch
GPT-image-2.6-sunburst Bild-zu-Bild-Praxisleitfaden: Grenzen der Fähigkeiten, Abrechnung und Engineering-Praxis
Der praktische Entwicklerpfad von der Anbindung bis zum Livegang: Fähigkeiten, Parameter, Kosten und Best Practices
Auf dieser Seite
Was es kann und was nicht
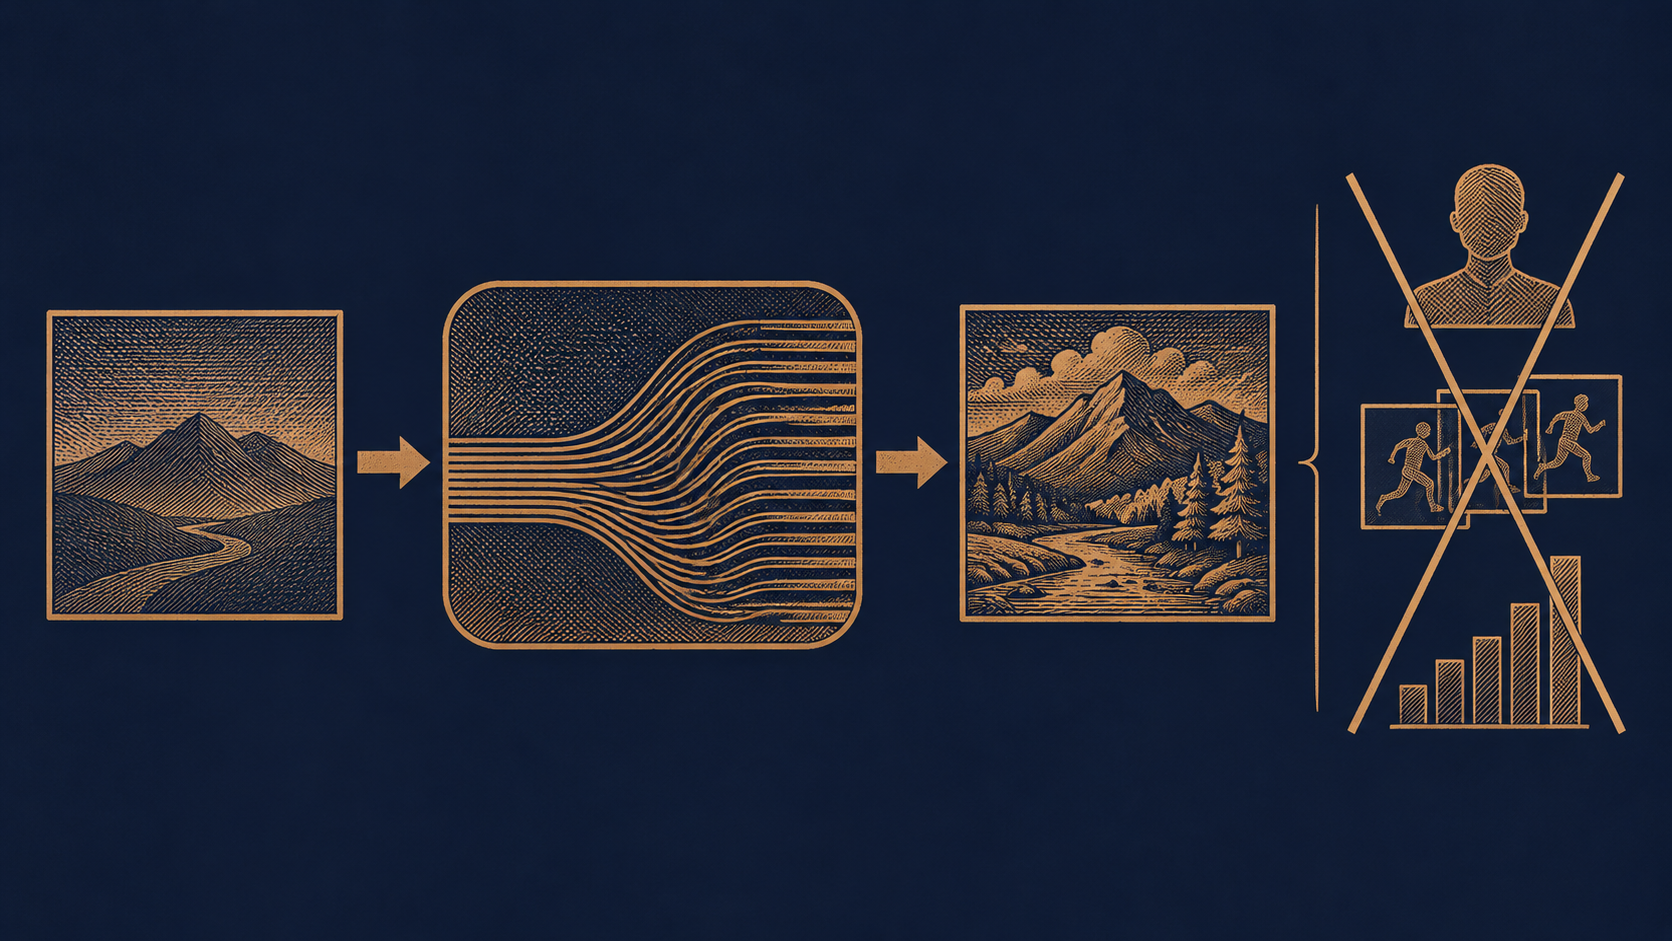
gpt-image-2.6-sunburst/image-to-image ist ein Bildmodell von OpenAI, dessen Positionierung sich bereits aus der Modellkennung ablesen lässt: Eingabe ist ein Bild, Ausgabe ist ein Bild, das Fähigkeitslabel lautet image-to-image. Es ist kein Alleskönner-Werkzeug für Bilder, sondern ein klar umrissener Konverter – man gibt ihm ein Referenzbild, und es erzeugt nach der Textanweisung ein neues Bild.
Aufgaben, die man ihm gut überlassen kann
- Stilübertragung und Neuzeichnung: Reale Fotos in Zielstile wie Illustration, Aquarell oder Cyberpunk umwandeln und dabei die Konturen des Motivs erhalten.
- Teilweise oder vollständige Umgestaltung: Hintergrund austauschen, Lichtstimmung anpassen, Bildfarbton vereinheitlichen, störende Elemente entfernen.
- Produktion von Asset-Varianten: Auf Basis eines bereits abgenommenen Hauptbildes massenhaft Varianten mit ähnlicher Komposition, aber unterschiedlichen Details ableiten – für A/B-Tests oder zur Erweiterung des Asset-Pools.
- Von der Skizze zum fertigen Entwurf: Lineart, Farbblockentwürfe oder unfertige Skizzen kolorieren und verfeinern, um den vorgelagerten Designprozess zu beschleunigen.
Die Entscheidungsregel ist einfach: Lässt sich der Bedarf mit „ein vorhandenes Bild + eine Änderungsbeschreibung“ klar formulieren, liegt er im Fähigkeitsbereich des Modells.
Wofür es nicht zuständig ist
- Reine Text-zu-Bild-Generierung. Ohne Eingabebild nur per Prompt von null an kreieren ist das Feld der Text-zu-Bild-Modelle; darauf sollte man nicht setzen.
- Präzises Text-Layout. Wenn vorgegebene Texte buchstabengenau ins Bild gerendert werden müssen (Poster-Titel, Verpackungstexte), braucht das Ergebnis in der Regel eine manuelle Nachkontrolle.
- Pixelgenaue Reproduktion. Image-to-Image ist „Referenz und Neuzeichnung“, keine „verlustfreie Bearbeitung“; Ausgabe und Eingabebild sind nicht pixelgleich.
- Video, 3D, Audio. Der Ausgabetyp ist ausschließlich Bild.
- Fakten garantieren. Es versteht nicht, ob Bildinhalte real und regelkonform sind; die Prüfung sensibler Inhalte auf der Geschäftsseite muss der eigene Prozess übernehmen.
Bei der Modellauswahl stelle zuerst eine Frage: Enthält meine Eingabe ein Bild? Ist die Ausgabe ein Bild? Wenn beides „ja“ ist, weiterlesen; andernfalls spart ein Modellwechsel mehr Zeit als Parameter-Tuning.
Anbindung: Von der Aggregations-API zum ersten Bild
Für den Aufruf dieses Modells muss man nicht jeden Upstream-Anbieter einzeln anbinden; der einheitliche Endpunkt von HiAPI.ai genügt: Der Client sendet eine HTTP-Anfrage an die Aggregations-API, die Plattform übernimmt Authentifizierung, Routing und Upstream-Aufruf und gibt das erzeugte Bild zurück. Die gesamte Kette exponiert gegenüber dem Entwickler nur einen Endpunkt, einen Satz Zugangsdaten und eine Modellkennung.
Was vor dem Start vorbereitet sein muss
- API-Key: In der HiAPI.ai-Konsole erstellen, in eine Server-Umgebungsvariable legen, niemals in Frontend-Code schreiben oder ins Repository committen.
- Modellkennung: In der Anfrage explizit
gpt-image-2.6-sunburst/image-to-imageangeben und auf das Suffiximage-to-imageachten – Varianten mit unterschiedlichen Fähigkeiten derselben Serie sind eigenständige Modelle; ein falsches Suffix führt direkt dazu, dass das Modell nicht gefunden wird oder das Verhalten nicht den Erwartungen entspricht. - Zugängliche Form des Eingabebildes: Die von der Plattform unterstützte Übergabeform klären (URL oder base64) und sicherstellen, dass die Bildadresse während des Aufrufs erreichbar ist.
- Guthaben und Quoten: Kontostand und Rate-Limits prüfen, damit die erste Integration nicht sofort an einem Quotenfehler scheitert.
Der minimale Verifikationspfad
Nicht gleich den kompletten Geschäftsvorgang durchlaufen lassen. In dieser Reihenfolge vorgehen:
- Zuerst mit der Beispielanfrage aus der Plattformdokumentation einen Aufruf durchführen, der „ein Bild zurückgibt“, und Key, Modellkennung und Netzwerkkonnektivität verifizieren;
- dann durch das eigene reale Eingabebild ersetzen und beobachten, ob die Ausgabe den Erwartungen entspricht;
- zuletzt diesen Aufruf in eine interne Funktion mit Timeout, Retry und Logging kapseln; der Geschäftscode hängt nur von dieser Funktion ab.
Der Wert dieses Schritts liegt in der Isolierung der Variablen: Beim ersten Fehlschlag muss man nur Authentifizierung und Parameter prüfen, statt gleichzeitig Bild, Prompt und Geschäftslogik zu verdächtigen. Die konkreten Feldnamen der Anfrage, Auth-Header und Antwortstrukturen richten sich nach der offiziellen Schnittstellendokumentation von HiAPI.ai; nicht aus dem Gedächtnis Formate anderer Anbieter übernehmen.
Aufrufparameter und Vorbereitung des Eingabebildes
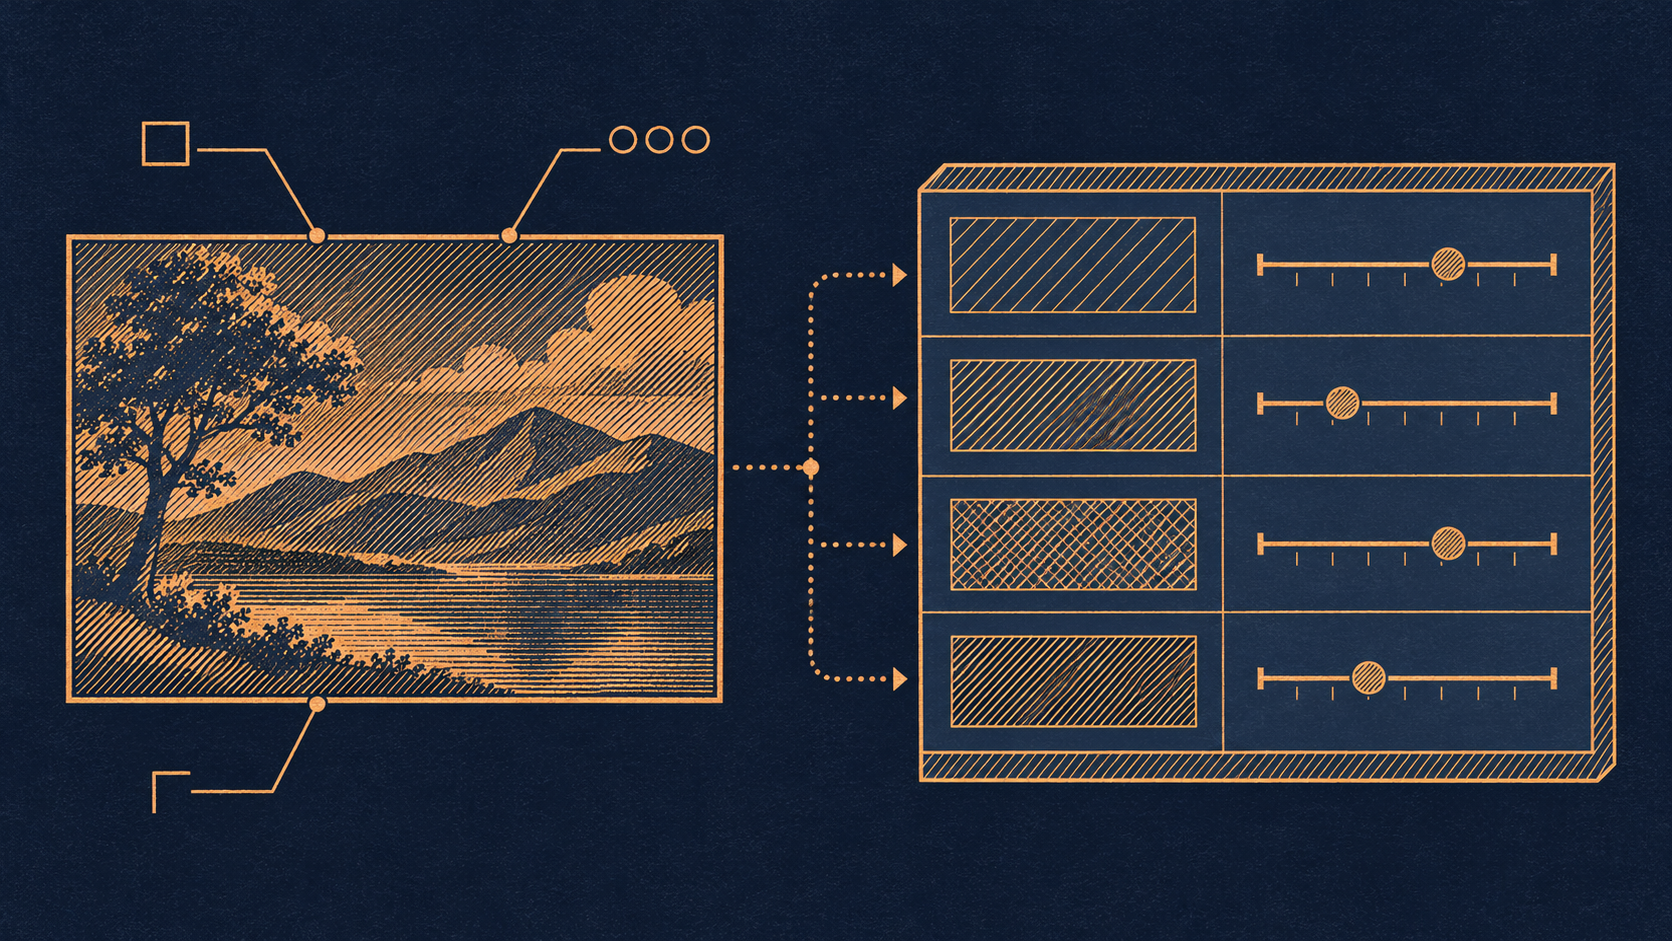
Die Parameterfläche dieses Modells ist schmaler als bei Text-zu-Bild, aber gerade deshalb führt das Übernehmen alter Gewohnheiten am leichtesten zu Fehlern. Im Folgenden werden die Aspekte nach Kategorien erläutert; die genauen Feldnamen, Wertebereiche und Standardwerte richten sich nach der offiziellen Dokumentation, hier werden keine Zusagen gemacht.
Beachtenswerte Parameterkategorien
- Modellkennung: Fest auf
gpt-image-2.6-sunburst/image-to-image; dies ist der einzige Parameter, der zwingend korrekt sein muss. - Prompt: Beschreibt „wie es aussehen soll“, nicht „was es ist“.
- Eingabebild-Feld: URL oder Inline-Daten; meist wird nur eines von beiden unterstützt oder muss laut Dokumentation unterschieden werden.
- Ausgabespezifikation: Größe, Seitenverhältnis, Rückgabeformat usw. Beachten: Die Ausgabe von Image-to-Image wird oft vom Seitenverhältnis des Eingabebildes beeinflusst; ein erzwungenes abweichendes Verhältnis kann Zuschneiden oder Verzerren auslösen.
- Anzahl: Wie viele Bilder pro Anfrage generiert werden. Das wirkt sich direkt auf die Abrechnung aus; Standardwerte konkret prüfen und nicht annehmen, „es kommt nur eines“.
- Zufälligkeit und Seed: Bietet die Dokumentation Seed- oder Zufallssteuerungsparameter, sind sie der Schlüssel zur Reproduktion von Problemen; andernfalls muss man akzeptieren, dass gleiche Eingabe und gleicher Prompt zu unterschiedlichen Ergebnissen führen können.
Vier harte Regeln für das Eingabebild
- Auflösung ausreichend, nicht mehr. Zu niedrig lässt die Neuzeichnung Details verlieren, zu hoch erhöht nur den Aufwand für Übertragung und Vorverarbeitung. Eine Größe wählen, die das Motiv klar erkennbar und nicht überdimensioniert macht, und für gleichartige Aufgaben eine einheitliche Größe beibehalten, um Ergebnisse vergleichbar zu machen.
- Format vereinheitlichen. Im Team ein gängiges Format vereinbaren, um Unterschiede bei Transparenzkanälen und Kompressionsartefakten durch gemischte PNG-, JPEG- und WebP-Nutzung zu vermeiden. Soll Transparenz erhalten bleiben, vorab klären, ob das Modell dies unterstützt.
- Klares Motiv, sinnvolle Freiräume. Ist das Bild mit Elementen überfüllt, kann das Modell kaum erkennen, welchen Teil man ändern möchte; zuerst auf den relevanten Bereich zuschneiden ist wirksamer als lange Erklärungen im Prompt.
- Compliance und Lizenzierung. Das Eingabebild verlässt das eigene System; vor dem Upload Urheberrecht, Persönlichkeitsrechte und geschäftliche Compliance klären.
Ein leicht übersehener Punkt: Nicht die gesamte Parametergewohnheit von Text-zu-Bild einfach übertragen. Image-to-Image kennt kein „Komponieren von null“; viele Parameter, mit denen man bei Text-zu-Bild den Stil steuert, haben hier eine andere Semantik oder existieren gar nicht – blindes Kopieren erzeugt nur ungültige Anfragen, und jede ungültige Anfrage kostet Geld.
Preisaufschlüsselung: Was bedeuten $0,023/Bild
Die Abrechnungslogik dieses Modells ist direkt: Abrechnung pro Bild, Stückpreis $0,023/Bild. Es gibt keine Token-Staffel, und Eingabebildgröße, Prompt-Länge oder Generierungsdauer spielen keine Rolle – sobald erfolgreich ein Bild erzeugt wird, wird einmal abgerechnet. Das ist eine für Entwickler sehr freundliche Kostenstruktur, weil sie die Kostenschätzung zu einer Multiplikation macht.
Ein eigenes Kostenmodell aufbauen
Für die Gesamtschätzung braucht man nur zwei Variablen:
- Bildanzahl pro Anfrage: Erlaubt der Parameter mehrere Bilder pro Aufruf, summiert sich ein Aufruf entsprechend der Bildanzahl. In der Integrationsphase unbedingt den Standardwert dieses Parameters prüfen, sonst testet man vermeintlich ein Bild und auf der Rechnung stehen mehrere.
- Anzahl effektiver Anfragen: Gemeint ist die Zahl der „erfolgreich erzeugten Bilder“, nicht „wie oft man auf Ausführen geklickt hat“ – umgekehrt werden durch falsche Parameter verschwendete Aufrufe, sofern ein Bild entstanden ist, nicht erstattet.
Multipliziert man beide Werte und dann mit dem geschätzten Tages-/Monatsvolumen der Geschäftsseite, erhält man die Budgetbasis. Empfehlung: Diese Formel bei Projektstart in die Dokumentation schreiben und bei jeder späteren Prozessänderung (mehr Varianten, höhere Retry-Zahl, größere Batches) erneut anwenden, damit die Kosten nicht unbemerkt explodieren.
Drei oft unterschätzte Kostenposten
- Kosten für Trial-and-Error. Jede Generierung in der Prompt-Debug-Phase wird abgerechnet. Statt online wiederholt zu experimentieren, das Debugging auf wenige feste Testbilder konzentrieren.
- Kosten für Retries. Nach einem Netzwerk-Timeout blind erneut senden kann bedeuten, dass upstream bereits erfolgreich generiert wurde und man zwei Bilder bezahlt hat.
- Redundante Varianten. Um „dem Nutzer mehr Auswahl zu geben“, mehrere Bilder auf einmal zu generieren, steigert die Conversion nicht unbedingt, erhöht aber sicher die Ausgaben.
Die Abrechnungszahlen und aktuellen Preise richten sich nach dem Preispaneel auf der HiAPI.ai-Website; dieser Artikel erläutert nur die Logik und gibt keine Preisgarantie ab.
Best Practices für Prompts und Workflows
Prompts für Image-to-Image und Text-zu-Bild sind zwei verschiedene Schreibweisen. Bei Text-zu-Bild muss man das gesamte Bild beschreiben; bei Image-to-Image existiert bereits ein Bild als faktische Grundlage, und man beschreibt die „Änderung“, nicht den „Neuaufbau“.
Die Vier-Abschnitt-Struktur des Prompts
Ein stabil nutzbarer Prompt enthält in der Regel vier Blöcke; die Reihenfolge ist anpassbar, aber fehlt ein Block, kommt es leicht zu Abweichungen:
- Was erhalten bleibt: Zuerst den unveränderlichen Teil festlegen. „Haltung und Gesichtsmerkmale der Person unverändert lassen“, „Komposition und Position des Motivs aus dem Originalbild beibehalten“. Dieser Satz reduziert das Abdriften des Motivs deutlich.
- Was geändert wird: Mit Verben den Umfang der Umgestaltung klar benennen. „Den Hintergrund durch eine regnerische Straße bei Nacht ersetzen“, „Den Gesamtfarbton auf warmes Orange ändern“.
- Stil und Textur: Zielstil und Bildwirkung benennen, z. B. „flacher Illustrationsstil, weiches Licht, entsättigte Film-Anmutung“.
- Ausschlüsse: Aufschreiben, was man nicht will. „Keine zusätzlichen Personen hinzufügen“, „Keinen Text erscheinen lassen“. Negative Einschränkungen wirken bei Bildaufgaben oft besser als positive Beschreibungen.
Drei Erfahrungsregeln
- Pro Durchlauf nur eine Art von Änderung. Hintergrund, Licht und Stil gleichzeitig zu ändern macht das Ergebnis nicht zuordenbar; bei Problemen weiß man nicht, welcher Satz im Prompt es verursacht hat.
- Prompts kurz und konkret halten. Anhäufungen von Adjektiven erhöhen die Qualität nicht, sondern verwässern den Schwerpunkt. Eine Änderung in unter zwanzig Wörtern klar zu beschreiben ist meist stabiler als zweihundert Wörter.
- Erfolgreiche Prompts versionieren. Derselbe Prompt kann modellseitig durch Zufälligkeit unterschiedliche Ergebnisse liefern; nur mit einer Aufzeichnung der Kombination „Prompt + Eingabebild + Parameter“ lässt sich bei der Regression beurteilen, ob sich das Modell geändert hat oder man die Eingabe angepasst hat.
Wie der Workflow organisiert wird
Empfohlen wird ein zweistufiger Ablauf „erst fixieren, dann iterieren“: In der ersten Runde mit dem einfachsten Prompt nur prüfen, ob das Motiv erhalten bleibt; ist die Treue zufriedenstellend, in der zweiten Runde Stil und Hintergrundumgestaltung ergänzen. Parameterkonfiguration und Vorverarbeitung des Eingabebildes (Zuschneiden, Skalieren, Formatvereinheitlichung) als feste interne Hilfsfunktionen umsetzen; der Geschäftscode kümmert sich nur um Prompt-Zusammensetzung und Aufruf. So ist bei Teamarbeit sofort erkennbar, an welcher Stelle ein Problem liegt.
Kostenkontrolle und Retry-Strategie
Abrechnung pro Bild bedeutet: Jedes „kurz ausprobieren“ hat ein klares Preisschild. Kostenkontrolle ist keine Spar-Trickkiste, sondern Engineering-Disziplin.
Retries brauchen Grenzen
- Fehlertyp unterscheiden, bevor man neu versucht. 4xx-Probleme wie Authentifizierungsfehler, ungültige Parameter oder falsche Modellkennung liefern nach hundert Retries dasselbe Ergebnis und kosten nur Zeit; nur Timeouts, Rate-Limits und temporäre Upstream-Störungen lohnen einen Retry.
- Retry-Zahl und Backoff begrenzen. Ein festes Limit (z. B. maximal zwei Versuche) kombiniert mit exponentiellem Backoff verhindert, dass Anfragen während einer Störung zu einem Traffic-Berg werden.
- Timeouts mit „unklarem Erfolg“ beachten. Ein Timeout heißt nicht, dass nichts generiert wurde. Erlaubt es das Geschäft, lieber per Request-ID oder Logs das Ergebnis plattformseitig verifizieren, statt sofort erneut zu senden.
Was der Cache einspart, ist bares Geld
Dasselbe Eingabebild, derselbe Prompt, dieselben Parameter werden im Geschäft oft wiederholt angefragt – Nutzer lädt die Seite neu, Operations startet den Task erneut, nachgelagerte Dienste spielen Nachrichten ab. Als Cache-Schlüssel „Hash des Eingabebildes + Prompt + Parameter“ verwenden und bei Treffer das bereits generierte Bild wiederverwenden. Der Nutzen dieser Schicht ist in der Regel direkter als jede Prompt-Optimierung.
Die richtige Haltung bei Batches
- Gleiches zusammenfassen: Aufgaben mit identischen Parametern zu einem Batch bündeln und Debugging- sowie Review-Prozess gemeinsam nutzen.
- Erst kleine Stichprobe, dann Skalierung: Mit wenigen Samples die Wirkung bestätigen, dann auf den vollen Umfang ausweiten, damit nicht der gesamte Batch unbrauchbar ist.
- Bildanzahl pro Aufruf begrenzen: Mehrbild-Rückgaben vervielfachen die Kosten eines Aufrufs; nach tatsächlichem Bedarf einstellen, nicht standardmäßig auf Maximum drehen.
- Budget-Leitplanken einziehen: Auf Geschäftsebene die kumulierte Bildanzahl mitzählen, bei Überschreitung des Tagesbudgets alarmieren oder degradieren, statt am Monatsende auf die Rechnung zu schauen.
Fehler brauchen Degradation
Wenn Retries aufgebraucht sind oder die Qualität dauerhaft nicht genügt, braucht der Prozess einen klaren Fallback-Pfad: Platzhalterbild zurückgeben, zuletzt geprüftes Material weiterverwenden, manuelle Bearbeitung einschalten oder den Nutzer auf später vertrösten. Eine Bildkette ohne Degradationsplan zahlt am Ende immer mit „unendlichen Retries“.
Häufige Probleme und Fehlerbehebungs-Checkliste
Eine feste Reihenfolge bei der Fehlersuche verkürzt die Lokalisierungszeit deutlich. Empfohlen wird, von oben nach unten Punkt für Punkt zu prüfen.
Anfrage schlägt direkt fehl
- Authentifizierungsproblem: Ist der Key gültig, im richtigen Request-Header, wurde er durch eine Umgebungsvariable auf einen leeren Wert überschrieben?
- Modellkennung falsch geschrieben:
gpt-image-2.6-sunburst/image-to-imageist lang; fehlendes Suffix oder eine andere Fähigkeitsvariante führt dazu, dass das Modell nicht gefunden wird. Das ist der häufigste Anfängerfehler. - Ungültige Parameter: Feldnamen-Schreibweise, Typabweichungen (String und Zahl verwechselt), Übergabe von Feldern, die in der Dokumentation nicht existieren.
- Eingabebild nicht erreichbar: URL abgelaufen, Authentifizierung erforderlich, Cross-Origin oder privates Netz nicht zugänglich. Der Wechsel auf Inline-Daten ist oft ein schneller Verifikationsweg.
- Quoten und Rate-Limits: Bei unzureichendem Guthaben oder ausgelöstem Rate-Limit ist die Fehlermeldung meist klar, wird aber leicht als „sporadischer Fehler“ missverstanden und blind wiederholt.
Anfrage erfolgreich, Ergebnis aber falsch
- Der Prompt beschreibt „Neuaufbau“ statt „Umgestaltung“: Überträgt man die Text-zu-Bild-Schreibweise auf Image-to-Image, neigt das Modell zum Neukomponieren und das Motiv driftet ab. Auf die Satzform „X erhalten, Y ändern“ umstellen.
- Eingabebild selbst informationsarm: Motiv zu klein, unscharf, abgeschnitten – das Modell hat keine Struktur, an der es sich orientieren kann. Ein klareres Referenzbild versuchen.
- Größe/Verhältnis passt nicht: Ausgabespezifikation und Seitenverhältnis des Eingabebildes kollidieren und führen zu Zuschneiden oder Streckung. Zuerst das Verhältnis vereinheitlichen.
- Zu viele Störfaktoren: Mehrere Änderungen auf einmal überlagert machen das Ergebnis nicht zuordenbar. In Einzelvariablen aufteilen und schrittweise verifizieren.
- Instabilität durch Zufälligkeit: Mehrfaches Ausführen mit gleicher Eingabe – schwankt das Ergebnis deutlich, reagiert der Prompt zu empfindlich auf Zufälligkeit; konkreter formulieren und stärkere Erhaltungsbedingungen ergänzen.
Grundmethode der Fehlersuche
Pro Durchlauf nur eine Variable ändern. Eingabebild und Parameter fixieren und nur den Prompt austauschen; oder den Prompt fixieren und nur das Eingabebild austauschen. Historisch erfolgreiche Kombinationen aus „Prompt + Parametern“ archivieren; bei Problemen zuerst auf die verifizierte Kombination zurückrollen und dann schrittweise auf die neue Anforderung hinarbeiten. Außerdem vor jedem Debugging kurz das Kontoguthaben prüfen – ein Guthabenproblem als Modellproblem zu verkennen ist die zeitaufwendigste aller Situationen.
Wann das Modell gewechselt oder kombiniert werden sollte
gpt-image-2.6-sunburst/image-to-image ist ein Spezialwerkzeug mit klaren Grenzen – was bedeutet, dass nicht alle Bildbedarfe ihm überlassen werden sollten.
Signale für den Wechsel zu Text-zu-Bild
- Der Bedarf lautet „von null ein Bild malen“, es gibt kein Referenzbild oder das Referenzbild ist nur eine unverbindliche Stimmungsangabe;
- Nutzer starten jedes Mal von einer leeren Fläche, auf der Eingabeseite existiert kein wiederverwendbares Bild-Asset;
- Man ertappt sich dabei, im Prompt die Komposition lang und breit zu beschreiben, was eigentlich das Eingabebild leisten sollte.
Das Kriterium lässt sich auf eines zurückführen: Wie stark hängt die Aufgabe vom Eingabebild ab. Starke Abhängigkeit, kontrollierte Umgestaltung eines bestehenden Bildes: Image-to-Image. Schwache Abhängigkeit, überwiegend kreative Exploration: Text-zu-Bild.
Szenarien, in denen Kombination sinnvoll ist
- Text-zu-Bild als Grundlage, Image-to-Image zur Konvergenz: Zuerst per Text-zu-Bild schnell mehrere Konzeptbilder erzeugen, nach der Richtungsentscheidung per Image-to-Image Stil vereinheitlichen und Details korrigieren. Das ist effizienter, als an einem einzigen Modell wiederholt hart zu tunen.
- Image-to-Image + manuelle Prüfung: Bei Brand-Assets und öffentlich publizierten Inhalten das Modell in die Mitte der Pipeline setzen und davor sowie danach Prüf- und Korrekturschritte einbauen, statt es direkt an Endnutzer ausgeben zu lassen.
- Image-to-Image + regelbasierte Vorverarbeitung: Deterministische Arbeiten wie Zuschneiden, Größenvereinheitlichung und Formatkonvertierung dem Code überlassen; das Modell übernimmt nur den kreativen Teil, in dem es wirklich stark ist.
Wann man aufhören sollte
Zeigt sich nach wiederholtem Debugging, dass der Qualitätsengpass aus „diese Aufgabe übersteigt die Fähigkeiten des Modells“ stammt – etwa präzises Text-Layout im Bild, pixelgenaue Reproduktion oder konsistente Bildfolgen über Frames hinweg –, sind weitere Prompts und Retries unwirtschaftlich. Rationaler ist dann ein Modellwechsel oder die Verlagerung dieses Schritts auf manuelle und templatebasierte Verarbeitung.
Unter der einheitlichen Schnittstelle von HiAPI.ai ist ein Modellwechsel nur eine Änderung der Modellkennung, die Kosten für Trial-and-Error sind gering – genau darin liegt der Wert einer abstrahierten Anbindungsschicht. Erst das Wesen der Aufgabe klären, dann das Modell wählen; das ist deutlich sparsamer als umgekehrt.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Gemini Omni 1.2 Flash Integrationsleitfaden: Eingabemodi, Parameter und Abrechnung nach Spezifikation
Der minimale Integrationspfad für das öffentliche Modell gemini-omni-1.2-flash: Eingabemodi, Parameterbeschränkungen, kopierbare Requests und Abrechnung nach Auflösung
-
Benutzerhandbuch
Claude Code auf kostenloses DeepSeek umstellen: jetzt konfigurieren, am 24. November direkt loslegen
Drei Anbindungswege – Claude Code, Python, curl –, die du jetzt kostenlos testen kannst
-
Benutzerhandbuch
Black Friday: So viel Aufladen lohnt sich am meisten – 18 % extra bei $100, 30 % extra bei $500
Vier Budgets von $50 bis $500 – wie viele Videosekunden und Bilder jeweils daraus werden