
Guía de uso
Guía práctica de GPT-image-2.6-sunburst para imagen a imagen: límites de capacidad, facturación y prácticas de ingeniería
Ruta práctica para desarrolladores, de la integración al lanzamiento: capacidad, parámetros, costes y mejores prácticas
En esta página
Qué puede hacer y qué no
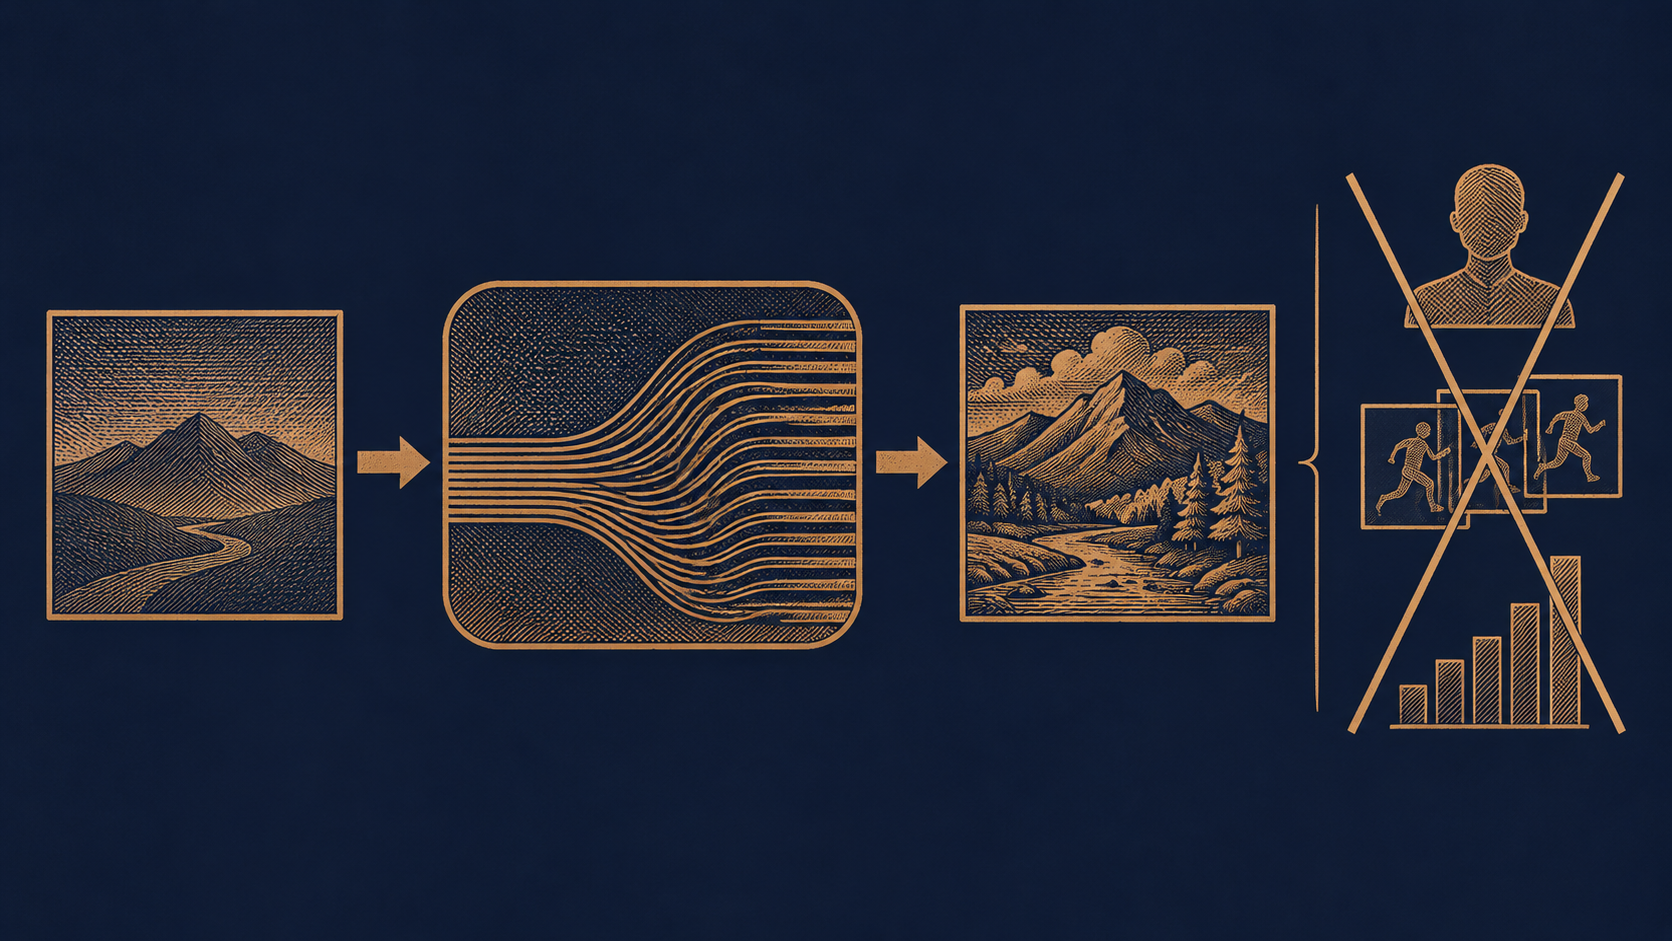
gpt-image-2.6-sunburst/image-to-image es un modelo de imagen ofrecido por OpenAI; su propio identificador ya revela su posicionamiento: la entrada es una imagen y la salida es una imagen, con la etiqueta de capacidad image-to-image. No es una herramienta de imagen todoterreno, sino un conversor con una responsabilidad bien definida: le das una imagen de referencia y produce una nueva imagen siguiendo tus instrucciones de texto.
Tareas adecuadas para él
- Transferencia de estilo y repintado: convertir fotos reales en ilustraciones, acuarelas, ciberpunk u otros estilos objetivo, conservando al mismo tiempo el contorno del sujeto.
- Modificación local o global: cambiar el fondo, ajustar la iluminación y la atmósfera, unificar la tonalidad de la imagen, limpiar elementos superfluos.
- Producción de variantes de material: tomando como base una imagen principal ya aprobada, derivar por lotes variantes de composición similar y detalles distintos para pruebas A/B o para ampliar el banco de recursos.
- Del boceto al resultado final: colorear y detallar lineart, bocetos de manchas de color o bocetos de baja definición, acelerando el proceso previo de diseño.
El criterio es sencillo: si tu necesidad se puede expresar con «una imagen existente + una descripción de modificación», entonces cae dentro del rango de capacidad del modelo.
Lo que no cubre
- Generación de imágenes solo con texto. Crear desde cero únicamente con un prompt, sin imagen de entrada, es terreno de los modelos de texto a imagen; no esperes que lo sustituya.
- Composición tipográfica precisa. Cuando hay que renderizar en la imagen un texto concreto palabra por palabra (títulos de carteles, texto de envases), el resultado generado suele requerir una revisión manual posterior.
- Réplica a nivel de píxel. Imagen a imagen es «referencia y repintado», no «edición sin pérdidas»; la salida no será idéntica píxel a píxel a la entrada.
- Vídeo, 3D y audio. El único tipo de salida es la imagen.
- Garantía de veracidad. No entiende si el contenido de la imagen es real o cumple las normas; la revisión de contenido sensible del lado del negocio debe recaer en tus propios procesos.
Antes de elegir modelo, pregúntate: ¿hay una imagen en mi entrada? ¿lo que quiero como salida es una imagen? Si ambas respuestas son «sí», sigue leyendo; de lo contrario, cambiar de modelo ahorra más tiempo que ajustar parámetros.
Ruta de integración: de la API agregada a la primera imagen generada
Para llamar a este modelo no hace falta integrar cada proveedor por separado; basta con la interfaz unificada de HiAPI.ai: el cliente envía una petición HTTP a la API agregada, la plataforma realiza la autenticación, el enrutado y la llamada al proveedor, y devuelve la imagen generada. Toda la cadena expone al desarrollador un solo endpoint, un solo juego de credenciales y un solo identificador de modelo.
Qué necesitas antes de empezar
- API Key: créala en la consola de HiAPI.ai, colócala en las variables de entorno del servidor y nunca la escribas en el código de frontend ni la subas al repositorio.
- Identificador de modelo: especifica explícitamente
gpt-image-2.6-sunburst/image-to-imageen la petición; no olvides el sufijoimage-to-image, ya que las variantes de distintas capacidades dentro de la misma serie son modelos independientes, y un sufijo incorrecto provoca directamente que no se encuentre el modelo o que el comportamiento no sea el esperado. - Forma accesible de la imagen de entrada: confirma los métodos de envío admitidos por la plataforma (URL o base64) y asegúrate de que la dirección de la imagen sea accesible durante la llamada.
- Cuota y límites de uso: comprueba el saldo de la cuenta y los límites de velocidad para no chocar con un error de cuota en la primera prueba de integración.
Ruta mínima de validación
No ejecutes el flujo completo de negocio de entrada. Avanza en este orden:
- Primero ejecuta una llamada con la petición de ejemplo de la documentación de la plataforma que «devuelva una imagen», para validar la Key, el identificador de modelo y la conectividad de red;
- Después sustituye por tu propia imagen de entrada real y observa si la salida cumple lo esperado;
- Por último, encapsula esa llamada en una función interna con timeout, reintentos y logs, y haz que el código de negocio dependa solo de esa función.
El valor de este paso está en aislar variables: cuando falla la primera vez, solo tienes que revisar autenticación y parámetros, en lugar de dudar a la vez de la imagen, del prompt y de la lógica de negocio. Los nombres exactos de los campos de la petición, las cabeceras de autenticación y la estructura de respuesta se rigen por la documentación oficial de la API de HiAPI.ai; no apliques de memoria el formato de otros proveedores.
Parámetros de llamada y preparación de la imagen de entrada
El conjunto de parámetros de este modelo es más reducido que el de texto a imagen, pero precisamente por ser reducido, aplicar viejas costumbres es lo que más errores provoca. A continuación se explican los puntos de atención por categorías; los nombres exactos de los campos, los rangos de valores y los valores por defecto deben consultarse en la documentación oficial; este artículo no los garantiza.
Categorías de parámetros a tener en cuenta
- Identificador de modelo: fijo a
gpt-image-2.6-sunburst/image-to-image; es el único parámetro que debe ser correcto obligatoriamente. - Prompt: describe «en qué se quiere convertir», no «qué es».
- Campo de imagen de entrada: URL o datos en línea; normalmente solo se admite uno de los dos o deben usarse según lo indique la documentación.
- Especificaciones de salida: tamaño, relación de aspecto, formato de retorno, etc. Ten en cuenta que la salida de imagen a imagen suele verse afectada por la proporción de la imagen de entrada; forzar una proporción que no coincida puede provocar recortes o deformaciones.
- Cantidad: cuántas imágenes se generan por petición. Esto afecta directamente a la facturación; confirma bien el valor por defecto y no des por hecho que «solo genera una».
- Aleatoriedad y semilla: si la documentación ofrece semilla o parámetros de control de aleatoriedad, es la clave para reproducir problemas; si no los ofrece, hay que aceptar que la misma entrada y el mismo prompt también pueden dar resultados distintos.
Cuatro reglas estrictas para la imagen de entrada
- Resolución suficiente, sin excesos. Una resolución demasiado baja hace que el repintado pierda detalle; una demasiado alta solo añade carga de transmisión y preprocesamiento. Elige un tamaño en el que el sujeto sea claro y reconocible sin resultar pesado, y mantén un tamaño uniforme para tareas del mismo tipo, de modo que los resultados se puedan comparar horizontalmente.
- Formato unificado. Acuerda internamente en el equipo un formato主流 y evita las diferencias de canal alfa y artefactos de compresión que provoca mezclar PNG, JPEG y WebP. Si necesitas conservar transparencia, confirma de antemano si el modelo la admite.
- Sujeto claro y espacio en blanco razonable. Si la imagen está repleta de elementos, al modelo le cuesta determinar qué parte quieres cambiar; recortar primero a la zona de interés es más eficaz que explicarlo con un prompt largo.
- Cumplimiento y autorización. La imagen de entrada sale de tu sistema; confirma los derechos de autor, la imagen de las personas y el cumplimiento del negocio antes de subirla.
Hay otro punto que se pasa por alto con facilidad: no traslades directamente toda la costumbre de parámetros de los modelos de texto a imagen. Imagen a imagen no tiene el concepto de «componer desde cero»; muchos parámetros que en texto a imagen ajustan el estilo aquí tienen una semántica distinta o ni siquiera existen, y copiarlos a ciegas solo genera peticiones inválidas, y cada petición inválida se factura.
Desglose de precios: qué significa $0.023 por imagen
El criterio de facturación de este modelo es muy directo: se factura por imagen, con un precio unitario de $0.023 por imagen. No hay tramos por tokens, ni se tiene en cuenta el tamaño de la imagen de entrada, la longitud del prompt o el tiempo de generación; basta con que se produzca correctamente una imagen para que se cobre una vez. Es una estructura de precios muy favorable para los desarrolladores, porque convierte la estimación de costes en una multiplicación.
Construye tu propio modelo de costes
Para estimar el total solo necesitas dos variables:
- Cantidad de imágenes por petición: si el parámetro permite devolver varias imágenes en una sola llamada, se acumula por número de imágenes. Durante la integración, confirma obligatoriamente el valor por defecto de este parámetro; de lo contrario, creerás que estás probando una y en la factura aparecerán varias.
- Número de peticiones válidas: fíjate en que son las veces que «se generó la imagen correctamente», no las veces que «pulsaste ejecutar»; dicho de otro modo, las llamadas desperdiciadas por configurar mal los parámetros, siempre que hayan producido una imagen, tampoco se reembolsan.
Multiplica ambos factores y luego por el volumen de llamadas diario o mensual estimado por el negocio para obtener la línea base del presupuesto. Se recomienda dejar esta fórmula escrita en la documentación al iniciar el proyecto y volver a aplicarla cada vez que cambie algún proceso (aumentar el número de variantes, elevar los reintentos, ampliar el lote) para evitar que el coste se duplique sin que nadie lo note.
Tres costes que se suelen subestimar
- Coste de prueba y error. Cada generación durante la depuración de prompts se factura. En lugar de probar repetidamente en producción, concentra la depuración en unas pocas imágenes de prueba fijas.
- Coste de reintentos. Reintentar sin criterio tras un timeout de red puede ocurrir que el proveedor ya haya generado correctamente y tú pagues dos imágenes.
- Variantes redundantes. Generar varias imágenes a la vez «para dar más opciones al usuario» no garantiza mejorar la conversión, pero el gasto sí aumenta con seguridad.
Las cifras de facturación y los precios más recientes se rigen por el panel de precios del sitio de HiAPI.ai; este artículo solo explica el criterio y no constituye una promesa de precio.
Mejores prácticas de prompts y flujos de trabajo
El prompt de imagen a imagen y el de texto a imagen son dos formas distintas de escribirlo. En texto a imagen hay que describir toda la escena; en imagen a imagen ya hay una imagen como base fáctica, y lo que tienes que describir es el «cambio», no la «reconstrucción».
Estructura de cuatro partes del prompt
Un prompt estable y utilizable suele contener cuatro bloques; el orden puede ajustarse, pero si falta uno es fácil que se desvíe:
- Qué conservar: fija primero la parte que no puede cambiar. «Mantén la pose y los rasgos faciales de la persona sin cambios», «conserva la composición y la posición del sujeto de la imagen original». Esta frase reduce notablemente la deriva del sujeto.
- Qué cambiar: delimita el alcance de la modificación con verbos. «Sustituye el fondo por una calle en una noche de lluvia», «cambia la tonalidad general a naranja cálido».
- Estilo y textura: indica el estilo objetivo y la textura de la imagen, por ejemplo «estilo de ilustración plana, iluminación suave, sensación de película de baja saturación».
- Exclusiones: escribe lo que no quieres. «No añadas personajes adicionales», «no incluyas texto». Las restricciones negativas suelen ser más eficaces que las descripciones positivas en tareas de imagen.
Tres reglas empíricas
- Cambia solo un tipo de cosa a la vez. Cambiar a la vez el fondo, la iluminación y el estilo hace que el resultado no sea atribuible y, si surge un problema, no sabrás qué frase del prompt lo causó.
- El prompt debe ser corto y concreto. Acumular adjetivos no mejora la calidad, sino que diluye lo importante. Expresar un cambio con menos de veinte palabras suele ser más estable que con doscientas.
- Versiona los prompts que funcionan. Un mismo prompt puede dar resultados distintos en el modelo por aleatoriedad; conserva el registro de la combinación «prompt + imagen de entrada + parámetros» para poder determinar, en una regresión, si cambió el modelo o si cambiaste tú la entrada.
Cómo organizar el flujo de trabajo
Se recomienda un flujo de dos fases: «primero fijar, luego iterar». En la primera ronda, usa el prompt más simple para validar únicamente si se conserva el sujeto; una vez confirmado que la fidelidad es aceptable, en la segunda ronda añade el estilo y la modificación del fondo. Convierte la configuración de parámetros y el preprocesamiento de la imagen de entrada (recorte, escalado, unificación de formato) en funciones internas fijas; el código de negocio solo se encarga de componer el prompt y lanzar la llamada. Así, cuando el equipo colabora, se ve de inmediato de qué parte viene el problema.
Control de costes y estrategia de reintentos
La facturación por imagen implica que cada «probar un momento» tiene una etiqueta de precio clara. El control de costes no es un truco para ahorrar, sino disciplina de ingeniería.
Los reintentos deben tener límites
- Distingue el tipo de error antes de decidir reintentar. Problemas 4xx como fallo de autenticación, parámetros inválidos o identificador de modelo incorrecto darán el mismo resultado cien veces y solo consumirán tiempo; solo merece la pena reintentar ante timeouts, limitación de velocidad o fallos temporales del proveedor.
- Limita el número de reintentos y aplica retroceso. Un límite fijo de reintentos (por ejemplo, dos como máximo) junto con retroceso exponencial evita que, durante un fallo, las peticiones se amplifiquen hasta convertirse en una avalancha de tráfico.
- Ojo con los timeouts de «éxito incierto». Un timeout de la petición no equivale a que no se haya generado. Si el negocio lo permite, verifica primero el resultado con la plataforma mediante el ID de petición o los logs, en lugar de reenviar de inmediato.
Todo lo que ahorra la caché es dinero real
La misma imagen de entrada, el mismo prompt y el mismo conjunto de parámetros suelen recibir peticiones repetidas en el negocio: el usuario actualiza la página, operaciones vuelve a ejecutar la tarea, un servicio posterior reenvía el mensaje. Usa «hash de la imagen de entrada + prompt + parámetros» como clave de caché y, si hay acierto, reutiliza directamente la imagen ya generada. El beneficio de esta capa suele ser más directo que cualquier optimización de prompt.
La forma correcta de procesar por lotes
- Agrupa elementos similares: reúne en un lote las tareas con parámetros idénticos para compartir un único proceso de depuración y revisión.
- Primero una muestra pequeña, luego el volumen: confirma el efecto con pocas muestras antes de ampliar a todo el lote, evitando producir lotes completos inservibles.
- Controla la cantidad de imágenes por llamada: devolver varias imágenes multiplica el coste de cada llamada; ajústalo a la necesidad real del negocio y no lo dejes al máximo por defecto.
- Establece barreras de presupuesto: contabiliza en la capa de negocio el número acumulado de imágenes generadas y alerta o degrada cuando se supere el umbral de presupuesto diario, en lugar de esperar a ver la factura a fin de mes.
Debe haber degradación ante fallos
Cuando se agotan los reintentos o la calidad no alcanza de forma persistente, el flujo necesita una ruta de contingencia clara: devolver una imagen de marcador de posición, reutilizar la última versión de material ya revisada, pasar a tratamiento manual o pedir al usuario que lo intente más tarde. Toda cadena de imagen sin plan de degradación termina pagándolo con «reintentos infinitos».
Preguntas frecuentes y lista de comprobación para la resolución de problemas
Fijar el orden de resolución de problemas acorta notablemente el tiempo de localización de fallos. Se recomienda comprobar punto por punto de arriba abajo.
La petición falla directamente
- Problema de autenticación: si la Key es válida, si está en la cabecera correcta, si una variable de entorno la ha sobrescrito con un valor vacío.
- Identificador de modelo mal escrito:
gpt-image-2.6-sunburst/image-to-imagees largo; omitir el sufijo o escribir otra variante de capacidad provoca que no se encuentre el modelo. Es el error de nivel básico más frecuente. - Parámetros inválidos: ortografía del nombre del campo, tipo incorrecto (mezclar cadenas y números), enviar campos que no existen en la documentación.
- Imagen de entrada inaccesible: URL caducada, requiere autenticación, inaccesible por dominio cruzado o red privada. Cambiar a datos en línea suele permitir validarlo rápidamente.
- Cuota y limitación de velocidad: cuando falta saldo o se activa el límite de velocidad, el mensaje de error suele ser claro, pero es fácil tomarlo por un «fallo ocasional» y reintentar sin criterio.
La petición tiene éxito pero el resultado no es correcto
- El prompt describe una «reconstrucción» en lugar de una «modificación»: si trasladas la forma de escribir de texto a imagen a imagen a imagen, el modelo tenderá a recomponer y el sujeto se desviará. Cambia a la estructura «conserva X, modifica Y».
- La imagen de entrada no tiene información suficiente: sujeto demasiado pequeño, borroso o recortado; el modelo no tiene una estructura en la que basarse. Prueba con una imagen de referencia más nítida.
- Tamaño o proporción que no coinciden: las especificaciones de salida entran en conflicto con la proporción de la imagen de entrada y provocan recorte o estiramiento. Unifica primero la proporción.
- Demasiados elementos contaminantes: acumular varias modificaciones a la vez hace que el resultado no sea atribuible. Sepáralas en variables únicas y valida paso a paso.
- Inestabilidad por aleatoriedad: ejecuta varias veces con la misma entrada; si el resultado fluctúa de forma evidente, el prompt es demasiado sensible a la aleatoriedad y debe escribirse de forma más concreta y con restricciones de conservación más fuertes.
Método básico de resolución de problemas
Cambia solo una variable a la vez. Fija la imagen de entrada y los parámetros y cambia solo el prompt; o fija el prompt y cambia solo la imagen de entrada. Archiva las combinaciones «prompt + parámetros» que hayan funcionado históricamente; cuando surja un problema, vuelve primero a la combinación ya validada y avanza después poco a poco hacia la nueva necesidad. Además, recuerda mirar la cuota de la cuenta antes de cualquier depuración: confundir un problema de saldo con un problema del modelo es la situación que más tiempo hace perder.
Cuándo cambiar de modelo o combinarlos
gpt-image-2.6-sunburst/image-to-image es una herramienta especializada; sus límites son claros, lo que también implica que no todas las necesidades de imagen deben confiarse a él.
Señales de que deberías cambiar a texto a imagen
- La necesidad es «dibujar una imagen desde cero», sin ninguna imagen de referencia, o con una referencia meramente opcional para indicar el ambiente;
- El usuario parte siempre de un lienzo en blanco y no hay activos de imagen reutilizables en la entrada;
- Descubres que estás describiendo la composición con un prompt largo, cuando eso debería asumirlo la imagen de entrada.
El criterio puede resumirse en uno: cuánto depende la tarea de la imagen de entrada. Si la dependencia es fuerte y hay que hacer modificaciones controlables sobre una imagen existente, usa imagen a imagen; si es débil y predomina la divergencia creativa, usa texto a imagen.
Escenarios en los que conviene combinarlos
- Texto a imagen como base, imagen a imagen para converger: primero genera rápidamente varias imágenes conceptuales con texto a imagen; tras elegir la dirección, usa imagen a imagen para unificar el estilo y corregir detalles. Es más eficiente que forzar ajustes repetidos en un solo modelo.
- Imagen a imagen + revisión humana: en escenarios con material de marca o publicación externa, coloca el modelo en la parte intermedia del flujo, con revisión y corrección antes y después, en lugar de dejar que se enfrente directamente a los usuarios finales.
- Imagen a imagen + preprocesamiento reglado: tareas deterministas como recorte, unificación de tamaño y conversión de formato se dejan al código; el modelo solo se encarga de la parte creativa que realmente domina.
Cuándo hay que parar
Si tras depuraciones repetidas descubres que el cuello de botella de calidad proviene de que «la tarea en sí supera la capacidad del modelo», por ejemplo exigir composición tipográfica precisa dentro de la imagen, restauración píxel a píxel o continuidad entre fotogramas, seguir añadiendo prompts y reintentos no es económico. En ese momento lo más racional es cambiar de modelo o convertir ese paso en tratamiento manual y con plantillas.
Con la interfaz unificada de HiAPI.ai, cambiar de modelo es solo cambiar un identificador de modelo, y el coste de prueba y error es muy bajo; en eso consiste precisamente el valor de abstraer la capa de integración. Pensar primero en la esencia de la tarea y luego decidir qué modelo usar ahorra mucho más que hacerlo al revés.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de integración de Gemini Omni 1.2 Flash: modos de entrada, parámetros y facturación por especificación
Ruta de integración mínima del modelo público gemini-omni-1.2-flash: modos de entrada, restricciones de parámetros, solicitudes copiables y facturación por resolución
-
Guía de uso
Cambia Claude Code a DeepSeek gratis: configúralo ahora y el 24 de noviembre arranca directamente
Tres formas de conexión con Claude Code, Python y curl; puedes verificar la configuración gratis ahora mismo
-
Guía de uso
Cuánto conviene recargar en el Black Friday: con $100 obtienes un 18% extra, con $500 un 30% extra
Cuatro presupuestos de $50 a $500, convertidos en cuántos segundos de vídeo y cuántas imágenes