
Руководство по использованию
Генератор AI-моделей для Instagram: создание консистентного виртуального инфлюенсера на hiapi
Зафиксируйте одно и то же лицо с помощью референсного изображения, генерируйте разные сцены пакетно и превращайте их в Reels — всё через /v1/tasks на hiapi.
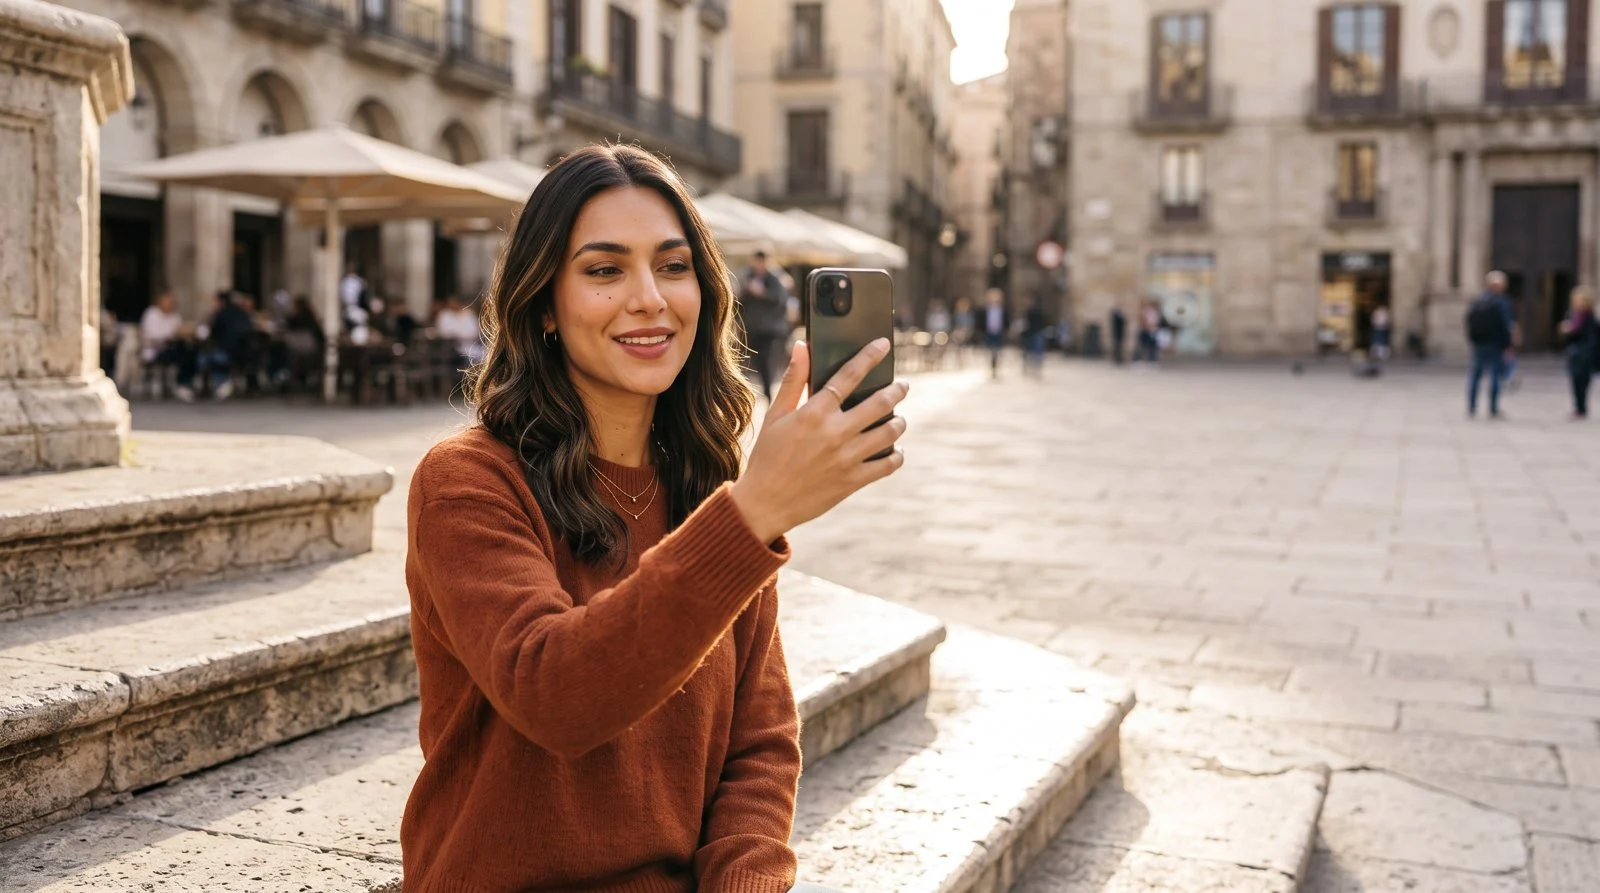
TL;DR
- Генератор AI-моделей для Instagram по сути представляет собой трёхэтапный конвейер: создайте персонажа, зафиксируйте это лицо, чтобы оно воспроизводилось в каждом кадре, а затем превратите лучшие статичные кадры в короткие видео. hiapi выполняет все три этапа через один асинхронный интерфейс
POST /v1/tasks. - В этом руководстве используется подход с референсным изображением для фиксации идентичности — вы передаёте базовый портрет как
image_inputи меняете только сцену. Это отличается от метода чисто текстового «набора персонажа», описанного в Consistent Characters with Nano-Banana; тот метод используйте, когда у вас ещё нет исходного изображения, а этот — когда вы хотите зафиксировать конкретное лицо. - В статье проведено тестирование на nano-banana-2: один базовый портрет закрепил три совершенно разные сцены — парижское кафе, городской пешеходный переход и спортзал на крыше — лицо, причёска, тон кожи, золотые серьги и многослойное ожерелье остались неизменными во всех сценах.
- Видеоэтап реален, а не имитация: приведённый ниже статичный кадр из кафе был превращён в 5-секундный ролик с помощью
grok-imagine-1.5/image-to-video. Она поднимает чашку и делает глоток; идентичность сохраняется в движении. - Бюджет всей статьи в блоге: около $0.30 — генерация четырёх 2K-изображений на nano-banana-2 по $0.057 за штуку ($0.228), плюс один Reel в 480p/5s по тарифу $0.015/s ($0.075).
Что вы на самом деле создаёте
«Виртуальный инфлюенсер», «AI-модель для UGC», «генератор AI-моделей для Instagram» — маркетинговые названия разные, но инженерная реализация всегда состоит из трёх этапов:
- Персонаж — сгенерируйте (или выберите) базовый портрет, который станет каноничным лицом вашей модели.
- Фиксация идентичности — добейтесь того, чтобы один и тот же человек появлялся в разной одежде, позах и локациях, чтобы лента выглядела как творчество одного создателя, а не сорока разных людей.
- Анимирование — превратите самые эффектные статичные кадры в короткие Reels / Shorts, которые заставляют остановить прокрутку.
Сложность заключается в этапе 2. Всё нижестоящее — правдоподобная сетка ленты, примерка товаров, брендовые посты — рушится в тот момент, когда лицо начинает дрейфовать. На hiapi есть два способа стабилизировать его.
Два способа зафиксировать лицо (и почему в этом руководстве выбран подход с референсным изображением)
| Метод | Как фиксируется идентичность | Когда использовать |
|---|---|---|
| Набор персонажа (текст) | Плотный, многоразовый префикс промпта с описанием лица, причёски и гардероба, добавляемый к каждому рендеру. Без исходного изображения. | Вы создаёте персонажа с нуля и хотите определять его с помощью текста, поддающегося контролю версий. |
| Референсное изображение (это руководство) | Передаёте базовый портрет как image_input; промпт меняет только сцену. |
У вас уже есть одобренное лицо (ключевой рендер, маскот бренда), и вы хотите, чтобы это лицо появлялось везде. |
Метод набора персонажа полностью описан в Consistent Characters with Nano-Banana — включая раскадровки и примеры лукбуков для электронной коммерции. Это руководство идёт другим путём: фиксирует конкретный портрет с помощью референсного изображения, а затем масштабирует его на несколько сцен и превращает в видео. Эти подходы дополняют друг друга; многие команды сначала один раз пишут набор персонажа, генерируют ключевой портрет, а затем переключаются в режим референсного изображения для остальной съёмки.
Шаг 1 — Сгенерируйте базового персонажа
Начните с чистого, хорошо освещённого портрета. Здесь детали — ваши друзья: чем конкретнее неизменные черты (родинка, пробор, украшение), тем легче их сохранить.
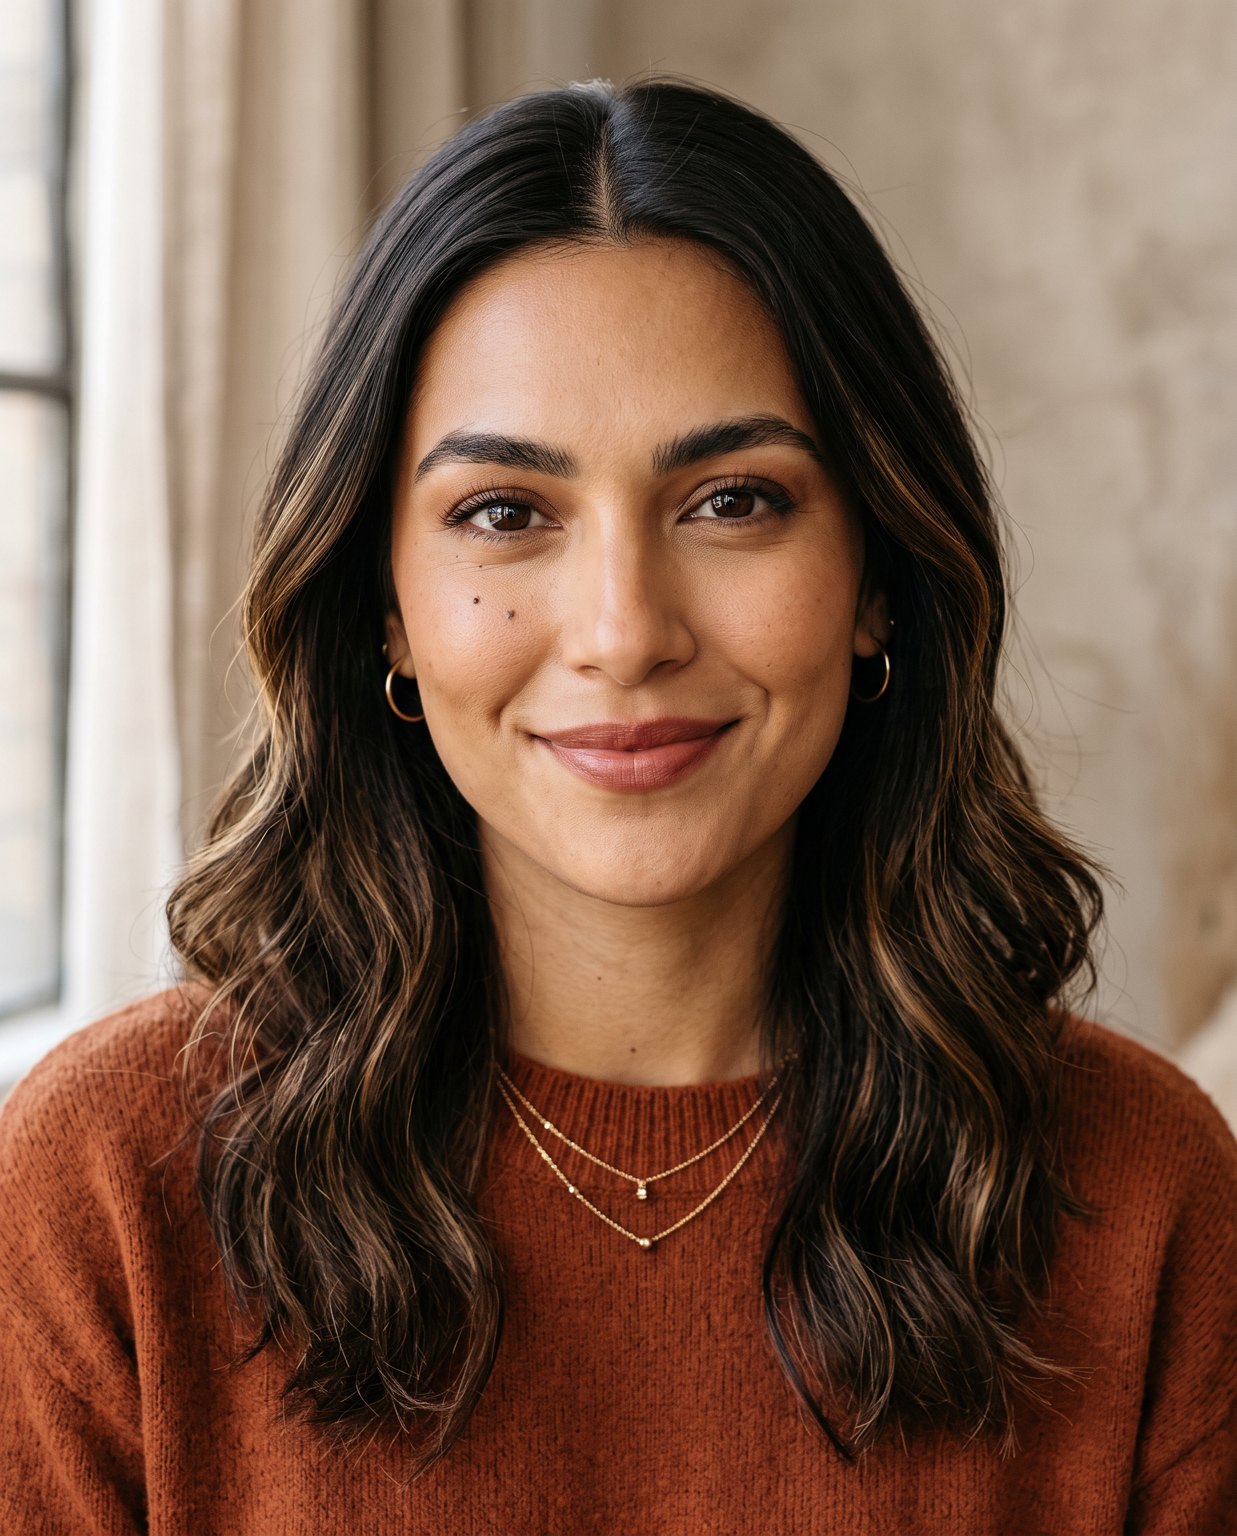
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks возвращает taskId; опрашивайте GET /v1/tasks/{taskId}, пока status не станет success, затем скачайте output[0].url. Этот URL временный (содержит expireAt), поэтому сразу сохраните байты — не делайте горячую ссылку на него. Загрузите портрет в доступное место (ваш собственный CDN), так как на следующем шаге он понадобится как входной URL. nano-banana-2 стоит $0.036 / $0.057 / $0.086 для 1K / 2K / 4K соответственно; в этой съёмке использовался 2K.
Шаг 2 — Зафиксируйте идентичность в разных сценах
Это ключевой шаг, который делает её инфлюенсером, а не галереей незнакомцев. Передайте базовый портрет как image_input, затем напишите промпт, который явно требует сохранить этого человека и описывает только новую сцену.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
Ключевое поле — image_input, массив URL-адресов референсов. Ниже один и тот же базовый портрет помещён в три несвязанных окружения, каждый рендер привязан к этому одному портрету:
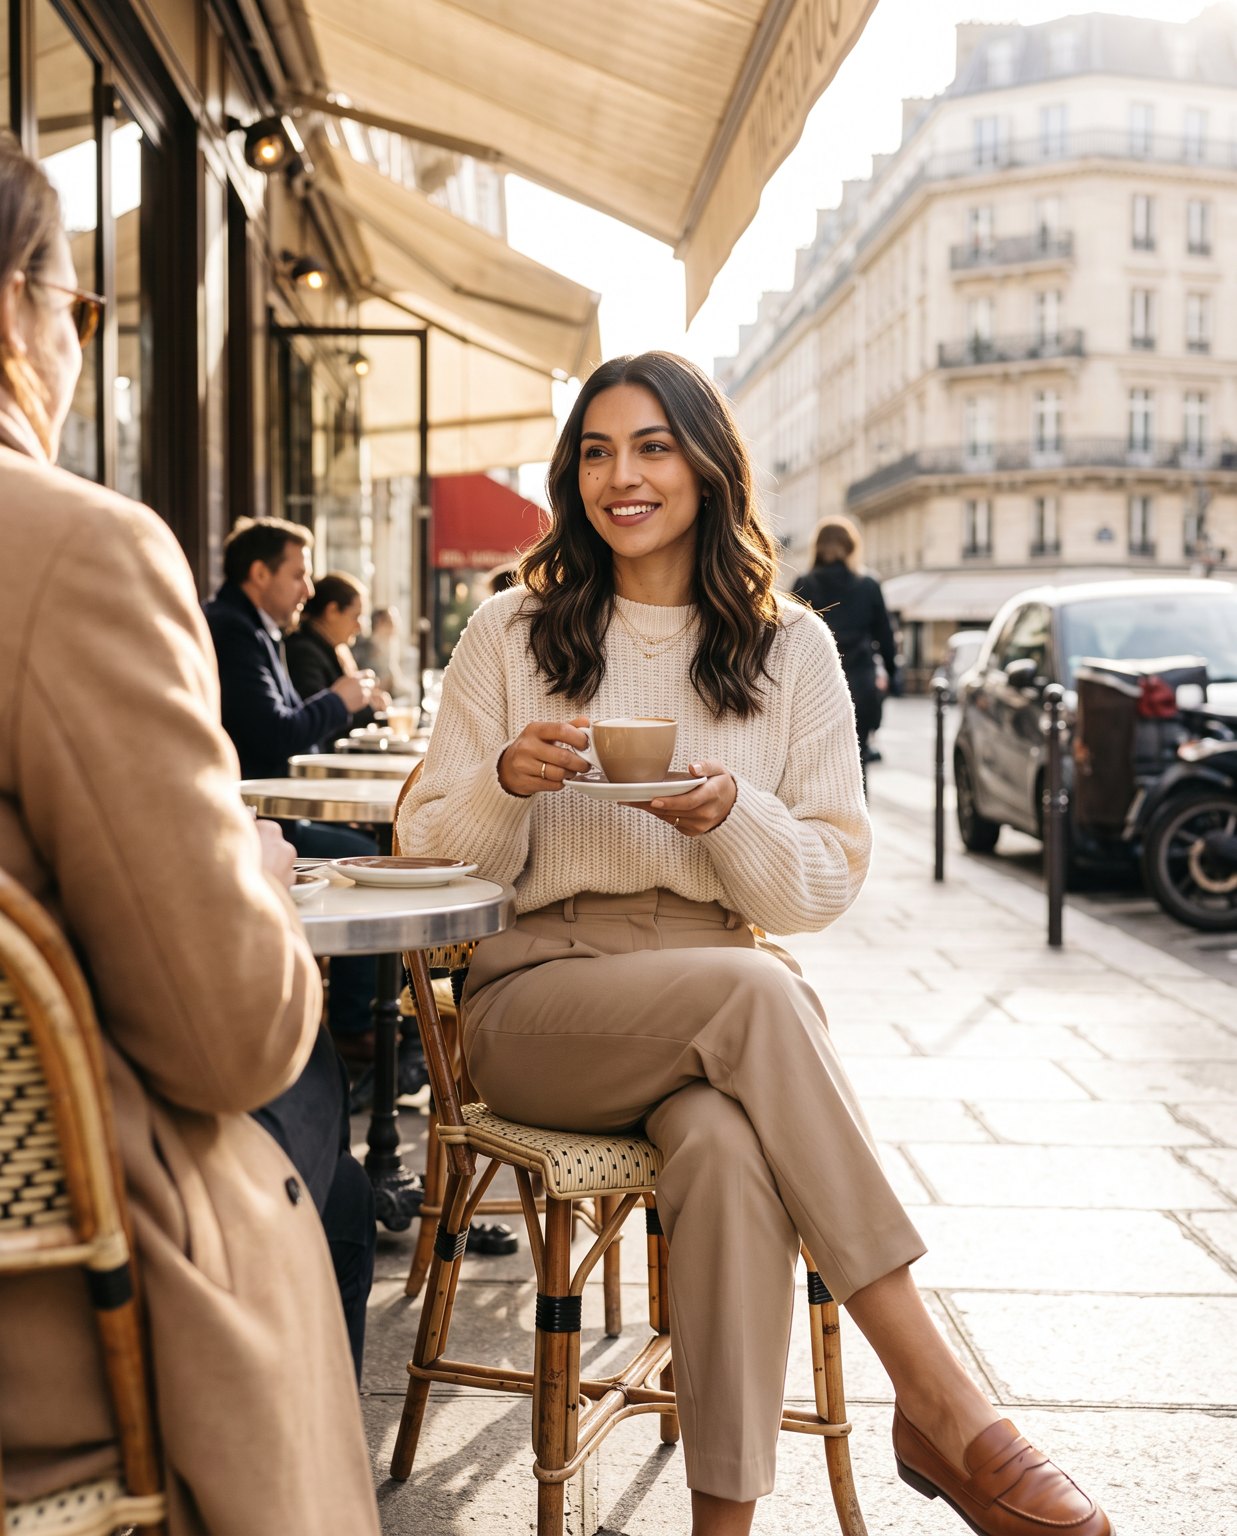
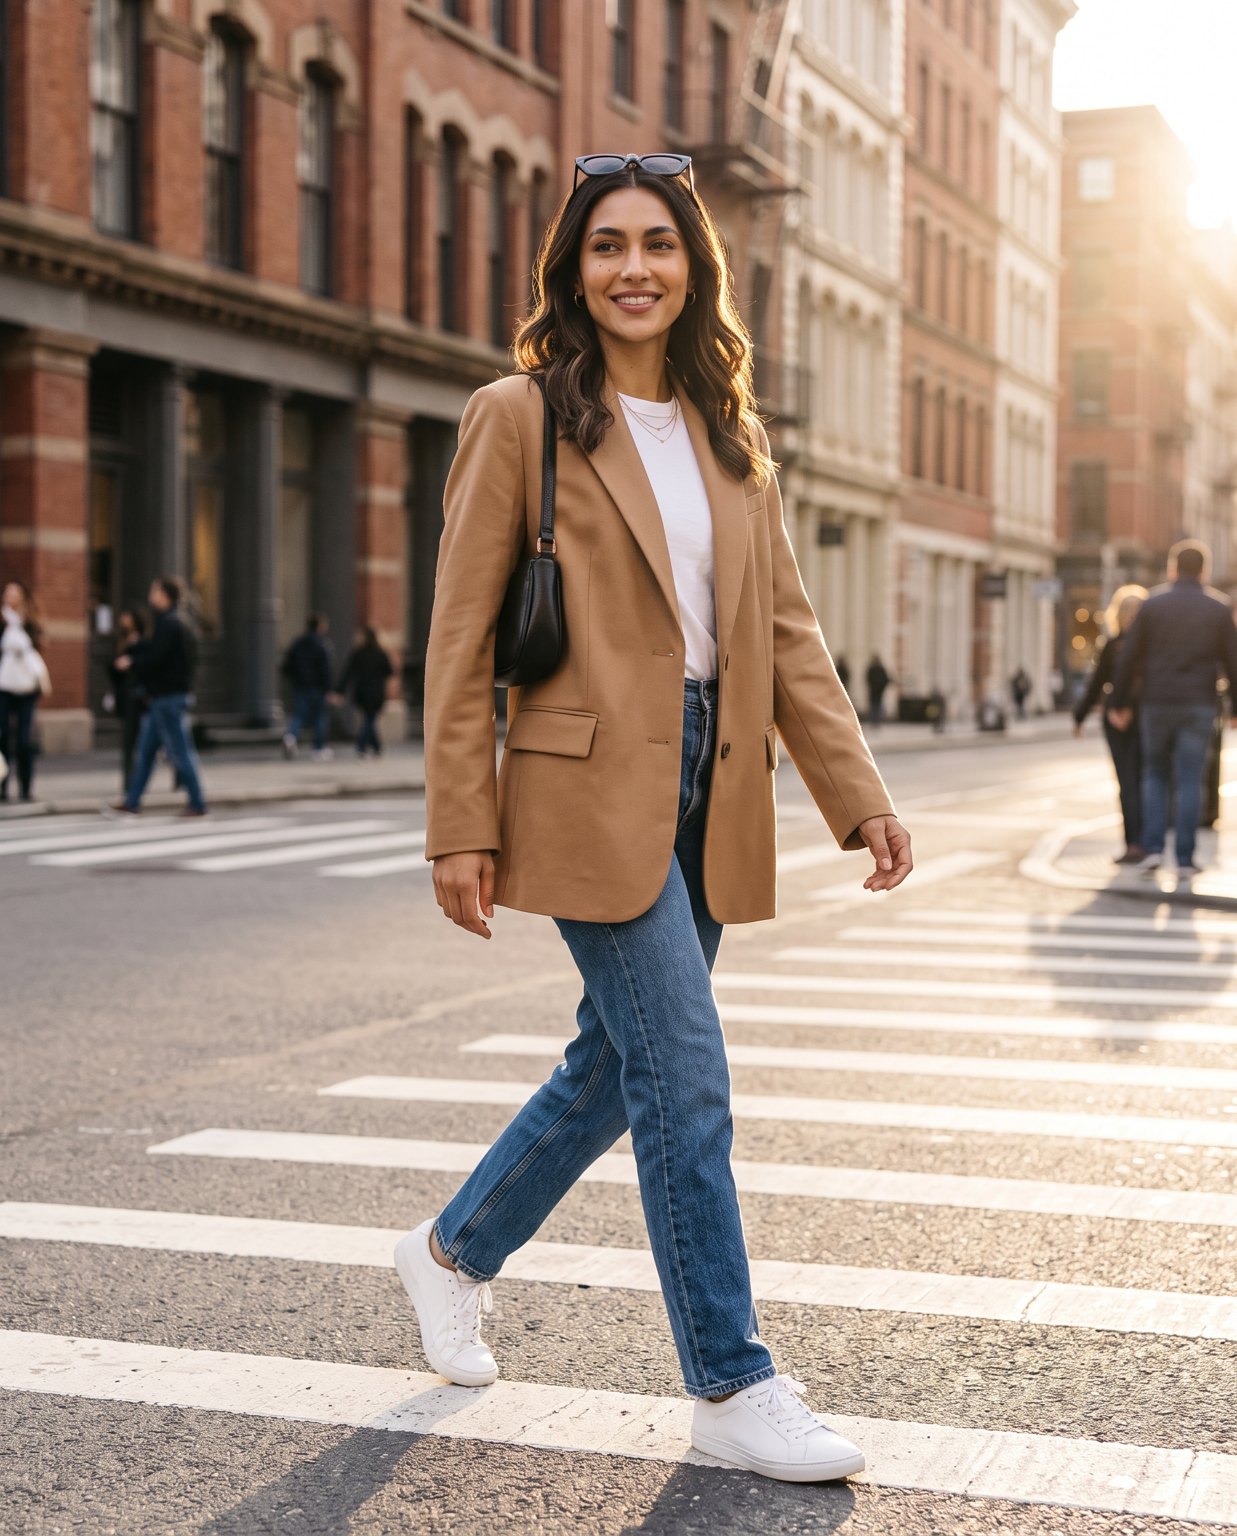
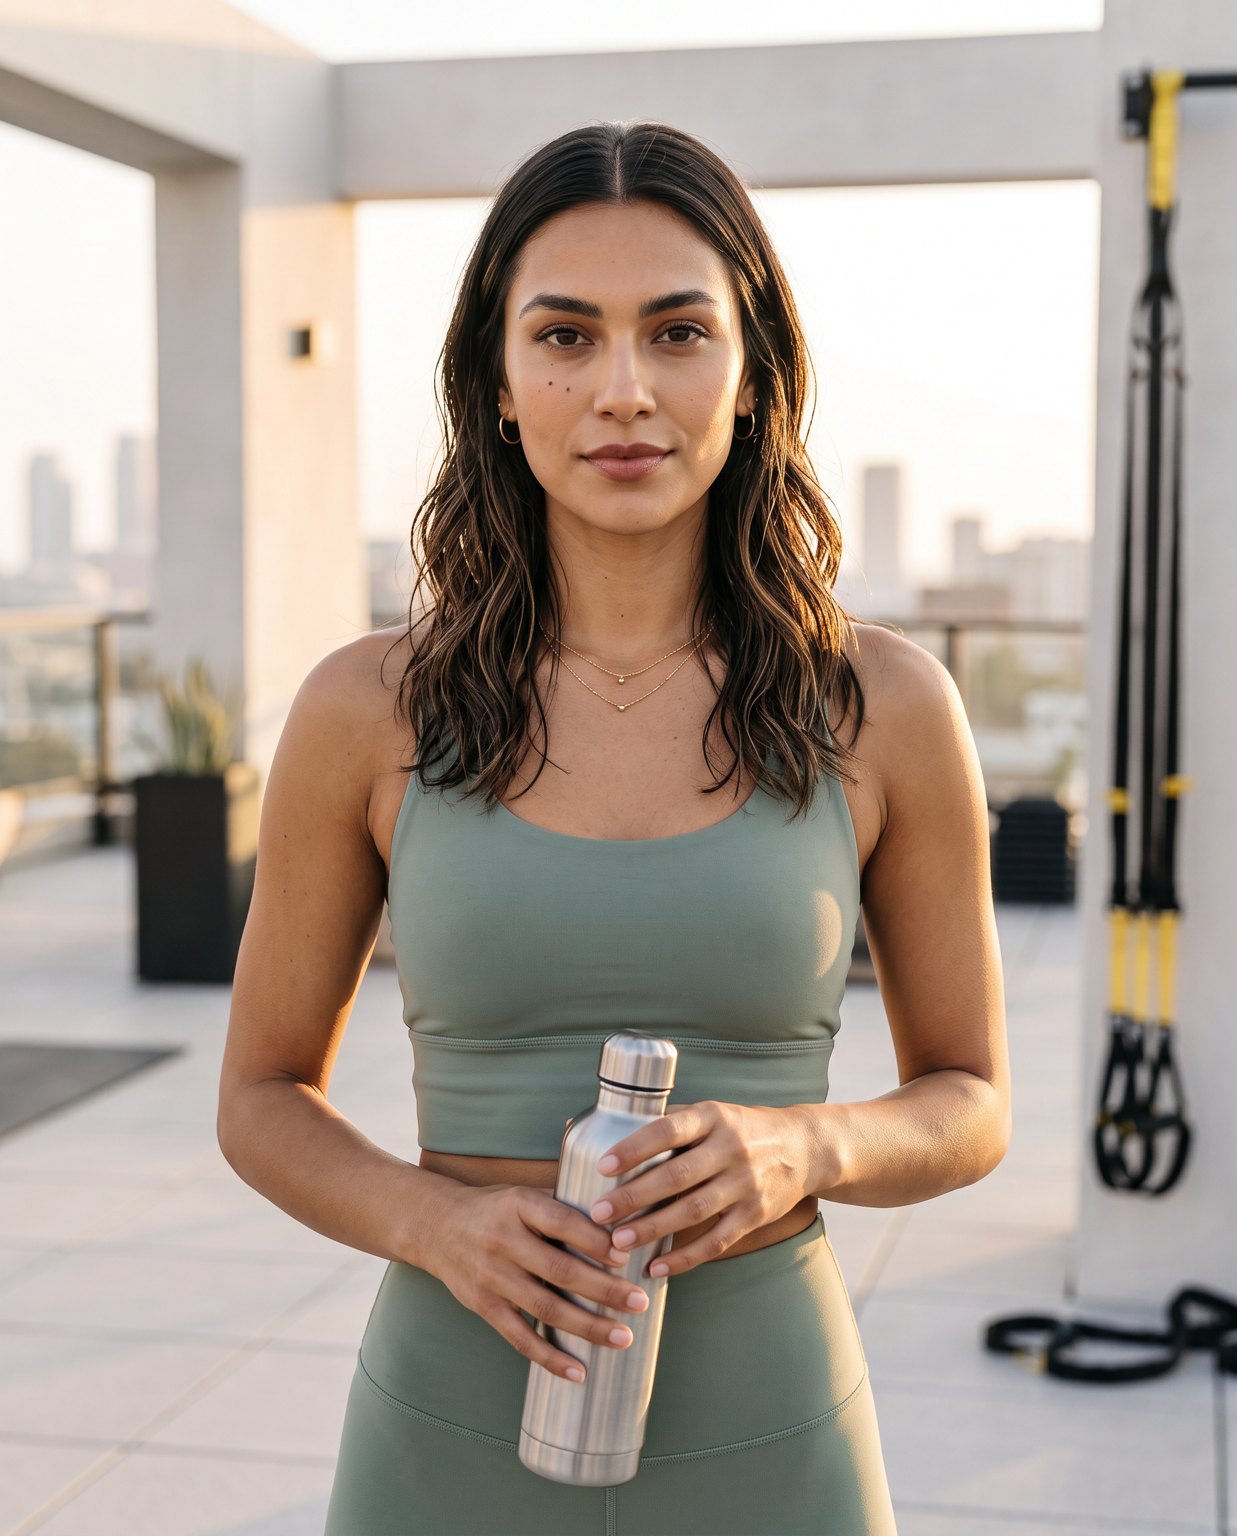
Что фактически сохранилось в этом запуске: на всех трёх рендерах — в кафе, на улице и в спортзале — геометрия лица, тон кожи, волнистые волосы с карамельными бликами, золотые серьги и тонкое многослойное ожерелье остались узнаваемо одним человеком. Единственный нюанс — микродетали: точное положение родинки или выбившейся пряди дрейфует в первую очередь. Эффективное исправление — привязывать каждый рендер к этому одному исходному портрету, а не передавать цепочкой (использовать вывод сцены A как вход для сцены B). Цепочная передача накапливает небольшие дрейфы; единый фиксированный якорь — нет.
Шаг 3 — Превратите статичный кадр в Reel
Ленте нужна динамика. Возьмите любой зафиксированный статичный кадр и отправьте его в модель «изображение в видео». Ролик ниже — это реально анимированная фотография из кафе выше, созданная с помощью grok-imagine-1.5/image-to-video:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Обратите внимание, что здесь входное поле другое: видеомодели используют image_urls (плюс duration в секундах), а не image_input. Тестовый фрагмент вернулся в 480p, вертикальный, 5 секунд — она поднимает чашку и делает глоток, как указано в промпте, и лицо в движении остаётся тем же человеком. При $0.015/s этот Reel стоит около $0.075. Если вам нужен более чёткий результат, тот же статичный кадр можно напрямую отправить в veo-3.1-lite, kling-3.0 или hailuo-2.3 — см. таблицу ниже.
Пакетная обработка: один референс, множество сцен
Весь смысл виртуальной модели — в объёме. Держите список промптов для сцен и запускайте цикл для одного базового портрета:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Замените строку модели — и вы сможете запустить тот же цикл на любой модели изображений с поддержкой референсов, или отправить готовые статичные кадры в цикл видео.
Опциональные модели для этапа фиксации идентичности
Цены — текущая стоимость за изображение из /api/pricing на момент написания; обязательно перепроверьте перед крупными пакетами.
| Модель | Референсный ввод | Цена (USD) | Примечания |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086 (1K/2K/4K) | Используется в статье; сильная преемственность лица, поддержка 4K |
| nano-banana-pro | image_input |
$0.057 (1K и 2K) / $0.10 (4K) | Продвинутая версия той же серии |
gpt-image-2 /image-to-image@ext |
До 16 референсных изображений | От $0.007 (низкое качество, 1K) | Самый дешёвый мультиреференсный путь, вывод в 4K |
flux-2 /image-to-image |
Мультиреференс | $0.035 (1K) / $0.05 (2K) | Высокоточное мультиреференсное редактирование |
seedream-5.0-pro /image-to-image |
Мультиреференс | $0.06 (1K) / $0.10 (2K) | Мультиреференс флагманского качества |
Ознакомьтесь с полным ассортиментом в маркетплейсе моделей. Для одного фиксированного лица достаточно одного референсного изображения; путь с 16 референсами в gpt-image-2 отлично работает, когда вы хотите объединить лицо, одежду и продукт в одном рендере.
Опциональные модели для видеоэтапа
Модели тарификации различаются — большинство берёт плату за секунду, но hailuo взимает фиксированную ставку за длину фрагмента. Учитывайте эту разницу при планировании пакетного бюджета.
| Модель | Способ оплаты | Пример стоимости | Примечания |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
За секунду | $0.015/s (480p), $0.0282/s (720p) | Используется в статье; самый дешёвый, 1–15 секунд |
veo-3.1-lite /image-to-video |
За секунду | $0.06/s (720p, без звука) → $0.14/s (1080p) | Хороший баланс качества и стоимости |
kling-3.0 /image-to-video |
За секунду | $0.10/s (720p) → $0.129/s (1080p); со звуком дороже | Нативный звук, до 4K |
hailuo-2.3-fast /image-to-video |
За фрагмент | $0.27 (6s) / $0.46 (10s) | Фиксированная ставка по тарифным ступеням длительности |
wan2.7-video /image-to-video |
За секунду | $0.10/s (720P) / $0.167/s (1080P) | Управление по первому кадру |
veo-3.1 /image-to-video |
За секунду | Со звуком $0.57/s → $0.86/s (4K) | Кинематографический уровень; 5-секундный фрагмент около $2.85, поэтому ограничивайте длительность |
Таким образом, 5-секундный Reel стоит от около $0.075 на grok-imagine-1.5 до примерно $2.85 на полном veo-3.1 — разница в 38 раз. Сначала прототипируйте на дешёвых тарифах и повышайте уровень только для тех фрагментов, которые действительно будете публиковать.
Приёмы консистентности, которые действительно работают
- Привязывайте, а не передавайте цепочкой. Отправляйте исходный базовый портрет в каждый рендер. Использование предыдущего вывода как входа для следующего накапливает микродрейфы, пока лицо не станет двоюродным братом, а не тем же человеком.
- Прописывайте неизменные черты в промпте. «Та же родинка под левым глазом, те же золотые серьги» полезнее, чем «та же женщина». Вы сообщаете модели, что ей запрещено менять.
- Сохраняйте одно соотношение сторон для каждого канала. 4:5 для сетки ленты, 9:16 для Reels. Переключение в середине съёмки вынуждает делать неудобную перекройку, которая может обрезать лицо.
- Фиксируйте разрешение на уровне модели.
nano-banana-2принимает1K/2K/4K; задавайте его явно, чтобы пакетная обработка не смешивала размеры незаметно. - Сохраняйте самый сильный портрет как постоянный актив. Это ваш «кастинг» — используйте его повторно в течение нескольких месяцев, а не генерируйте новое лицо для каждой кампании.
Затраты на эту статью
| Позиция | Модель | Количество | Цена за единицу | Подытог |
|---|---|---|---|---|
| Базовый портрет + 3 рендера сцен | nano-banana-2 (2K) | 4 | $0.057 | $0.228 |
| Reel из кафе | grok-imagine-1.5 (480p, 5s) | 1 | $0.015/s | $0.075 |
| Итого | около $0.30 |
Полная сетка из 30 постов плюс несколько Reels обходится всего в несколько долларов — вот настоящая причина, по которой команды выбирают генераторы вместо съёмок.
FAQ
Гарантируется ли абсолютно одинаковое лицо каждый раз? Ни одна модель не гарантирует пиксельно идентичное лицо, но в этом тесте привязка к референсному изображению на nano-banana-2 сохранила узнаваемо одного человека в трёх очень разных сценах. Считайте случайные отклонения поводом сгенерировать несколько вариантов и отобрать лучший, а не поводом переснимать.
Можно ли зафиксировать лицо реального человека? Только лицо человека, на которое у вас есть права — ваше собственное, модели с согласием или подписанного бренд-амбассадора. Не клонируйте незнакомцев или знаменитостей.
Нужны ли мне дообучение или LoRA? Нет. Весь процесс работает без обучения — одно референсное изображение плюс промпт. Именно поэтому стоимость каждого изображения остаётся в пределах нескольких центов.
С какой модели начать? Начните с nano-banana-2 для фиксации идентичности и с grok-imagine-1.5 для видеоэтапа. Обе достаточно дешёвые, чтобы свободно итерировать; повышайте уровень только после того, как определитесь со стилем.
Начните создавать
Сгенерируйте портрет на nano-banana-2, передайте его как image_input для каждой сцены и анимируйте любимый кадр с помощью модели «изображение в видео» — всё через один ключ через POST /v1/tasks. Документация быстрого старта описывает аутентификацию и опрос статуса; прежде чем масштабировать пакеты, сравните каждую модель изображений и видео на странице цен.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков