
使用指南
AI Instagram 模特生成器:在 hiapi 上打造形象一致的虚拟网红
用参考图锁定同一张脸,批量生成不同场景,再将其制作成 Reels——全程通过 hiapi 的 /v1/tasks 完成。
TL;DR
- AI Instagram 模特生成器本质上是一条三段式流水线:创建一个角色,锁定那张脸让它在每个镜头中重现,再把最好的静帧转成短视频。hiapi 通过一个异步接口
POST /v1/tasks运行全部三个阶段。 - 本指南使用参考图路线来锁定身份——你把一张基础人像作为
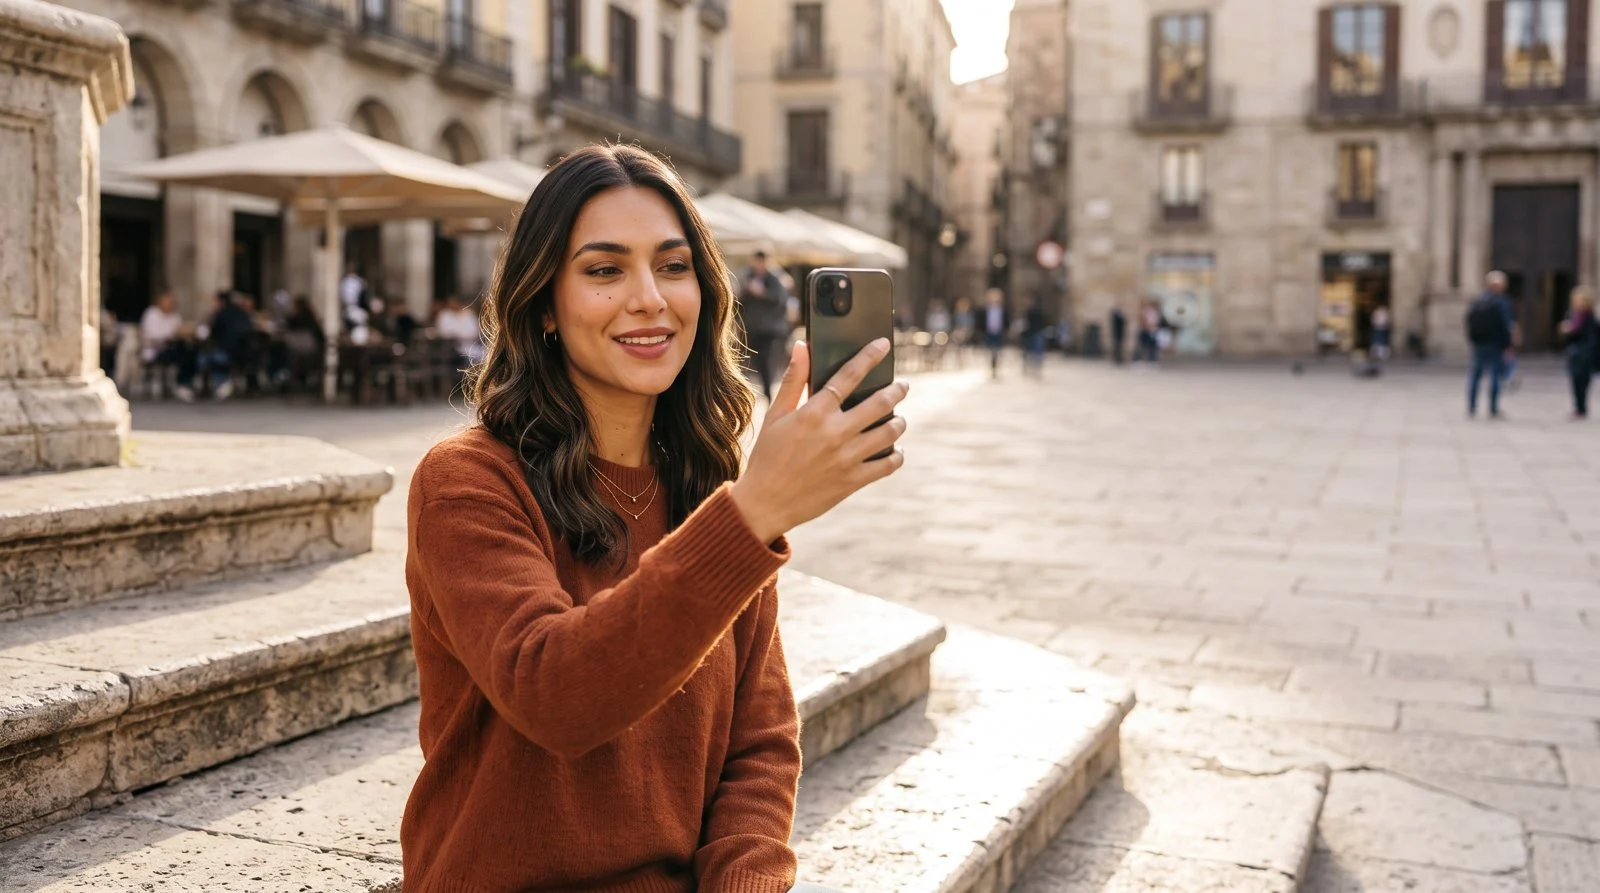
image_input回传,只改变场景。这与 Consistent Characters with Nano-Banana 中介绍的纯文本「角色设定集」方法不同;当你还没有种子图时用那个,当你想要固定一张脸时用这个。 - 本文在 nano-banana-2 上实测:一张基础人像锚定了三个完全不同的场景——巴黎咖啡馆、城市人行横道和屋顶健身房——脸、发型、肤色、金色耳环和叠戴项链在所有场景中都保持一致。
- 视频阶段是真实的,不是模拟图:下面的咖啡馆静帧用
grok-imagine-1.5/image-to-video制作成了 5 秒短片。她举起杯子喝了一口;身份在运动中依然保持。 - 整篇博文的预算:约 $0.30——在 nano-banana-2 上生成四张 2K 图片,每张 $0.057($0.228),再加上一条 480p/5s 的 Reel,按 $0.015/s 计费($0.075)。
你实际在构建什么
「虚拟网红」「AI UGC 模特」「AI Instagram 模特生成器」——营销名称各不相同,但工程实现都是同样的三个阶段:
- 角色——生成(或挑选)一张基础人像,作为你模特的经典面孔。
- 身份锁定——让同一个人出现在各种服装、姿势和地点中,使信息流看起来像同一个创作者,而不是四十个不同的人。
- 动效——把最有冲击力的静帧制作成简短、令人停下滑动的 Reels / Shorts 短片。
难点在第 2 阶段。所有下游环节——可信的信息流网格、产品试穿、品牌帖子——都会在脸发生漂移的那一刻崩塌。在 hiapi 上有两种方法可以稳住它。
锁定一张脸的两种方法(以及为什么本指南选择参考图路线)
| 方法 | 身份如何锚定 | 适用场景 |
|---|---|---|
| 角色设定集(文本) | 一段密集、可复用的提示词前缀,描述脸、发型和衣橱,拼接到每次渲染中。没有种子图。 | 你从零开始发明一个角色,并希望用可版本控制的文本定义它。 |
| 参考图(本指南) | 把一张基础人像作为 image_input 回传;提示词只改变场景。 |
你已经有了一张认可的脸(主视觉渲染图、品牌吉祥物),并希望那张脸出现在所有地方。 |
角色设定集方法在 Consistent Characters with Nano-Banana 中有完整介绍——包括分镜和电商造型手册示例。本指南走另一条路:用参考图锁定一张特定人像,然后把它扩展到多个场景并制作成视频。两者互补;许多团队会先写一次设定集,生成一张主视觉人像,然后在拍摄的其余部分切换到参考图模式。
第 1 步——生成基础角色
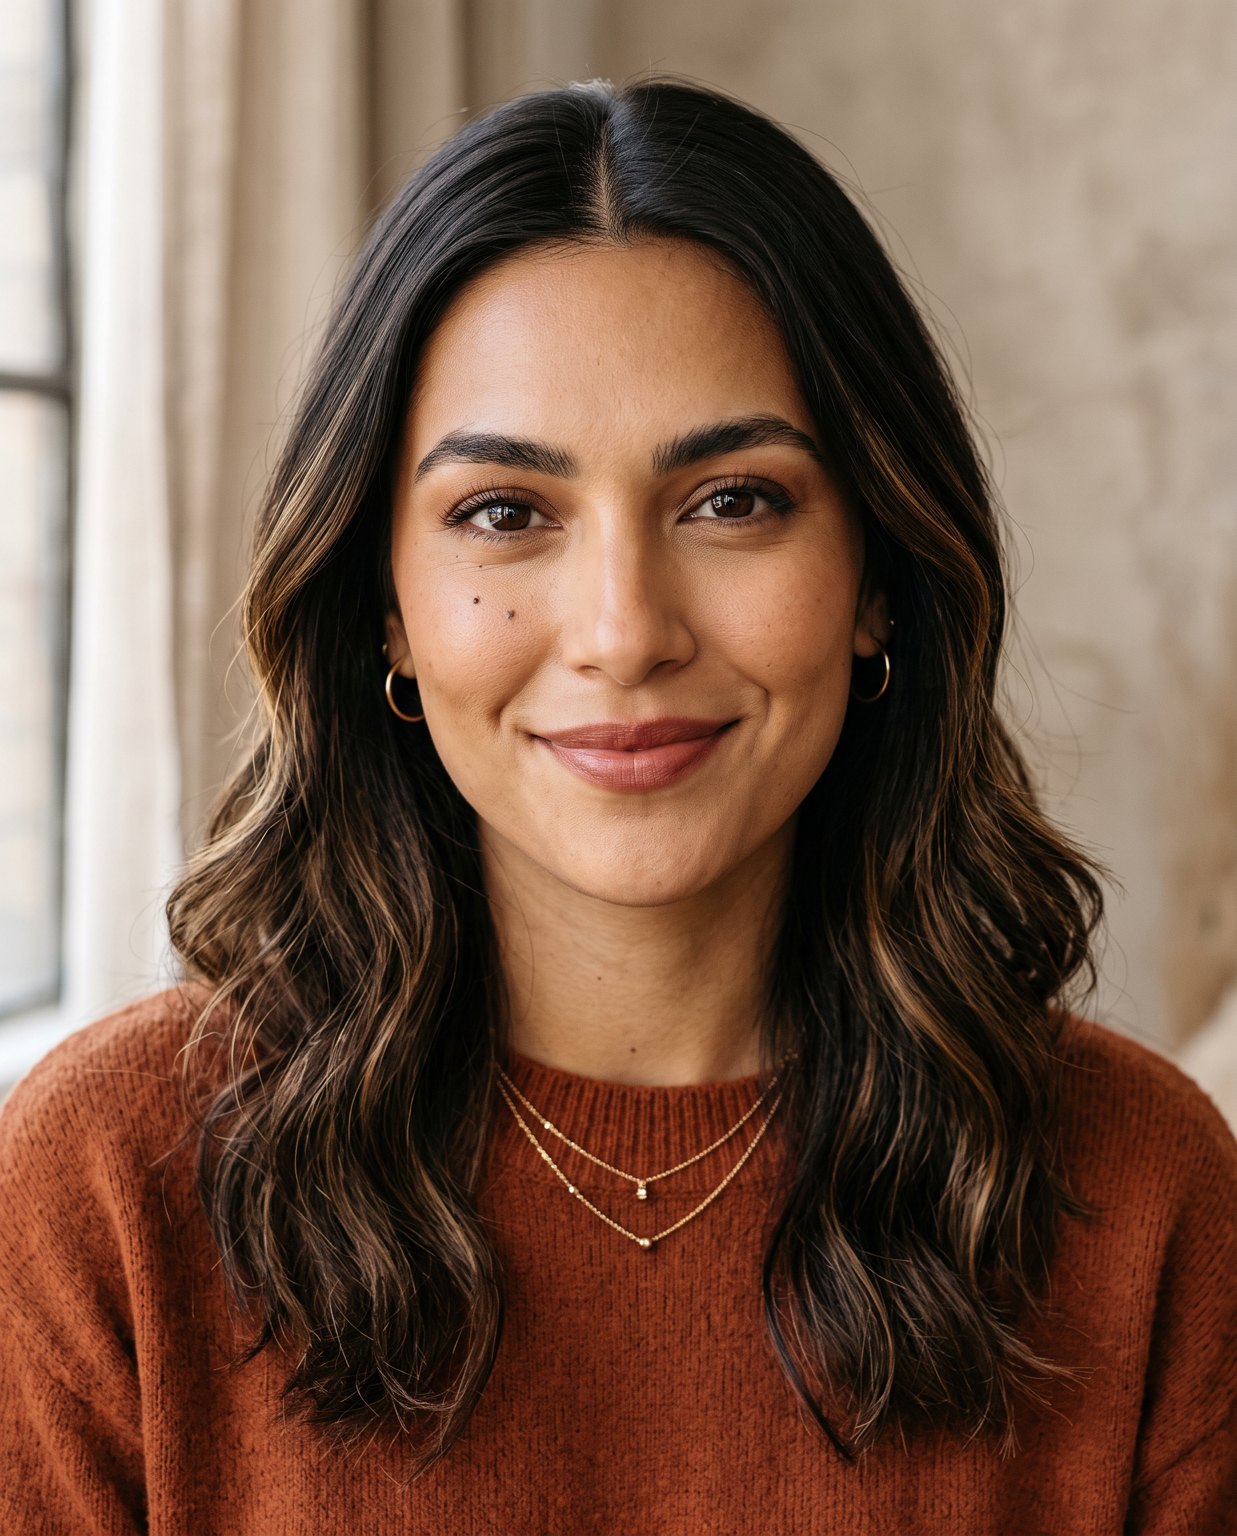
从一张干净、光线充足的人像开始。细节在这里是你的朋友:不变特征越具体(一颗美人痣、一个发缝、一件珠宝),就越容易延续下去。
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks 返回一个 taskId;轮询 GET /v1/tasks/{taskId} 直到 status 为 success,然后下载 output[0].url。该 URL 是临时的(带有 expireAt),所以立即保存字节——不要热链接它。把人像上传到可访问的位置(你自己的 CDN),因为下一步需要它作为输入 URL。nano-banana-2 在 1K / 2K / 4K 下分别定价为 $0.036 / $0.057 / $0.086;这里的拍摄使用了 2K。
第 2 步——跨场景锁定身份
这是让它成为网红而不是陌生人画廊的关键一步。把基础人像作为 image_input 回传,然后写一段明确表示保留这个人并只描述新场景的提示词。
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
关键字段是 image_input——一个参考 URL 数组。下面是同一张基础人像被放入三个不相关的环境,每一次渲染都锚定到那一张人像:
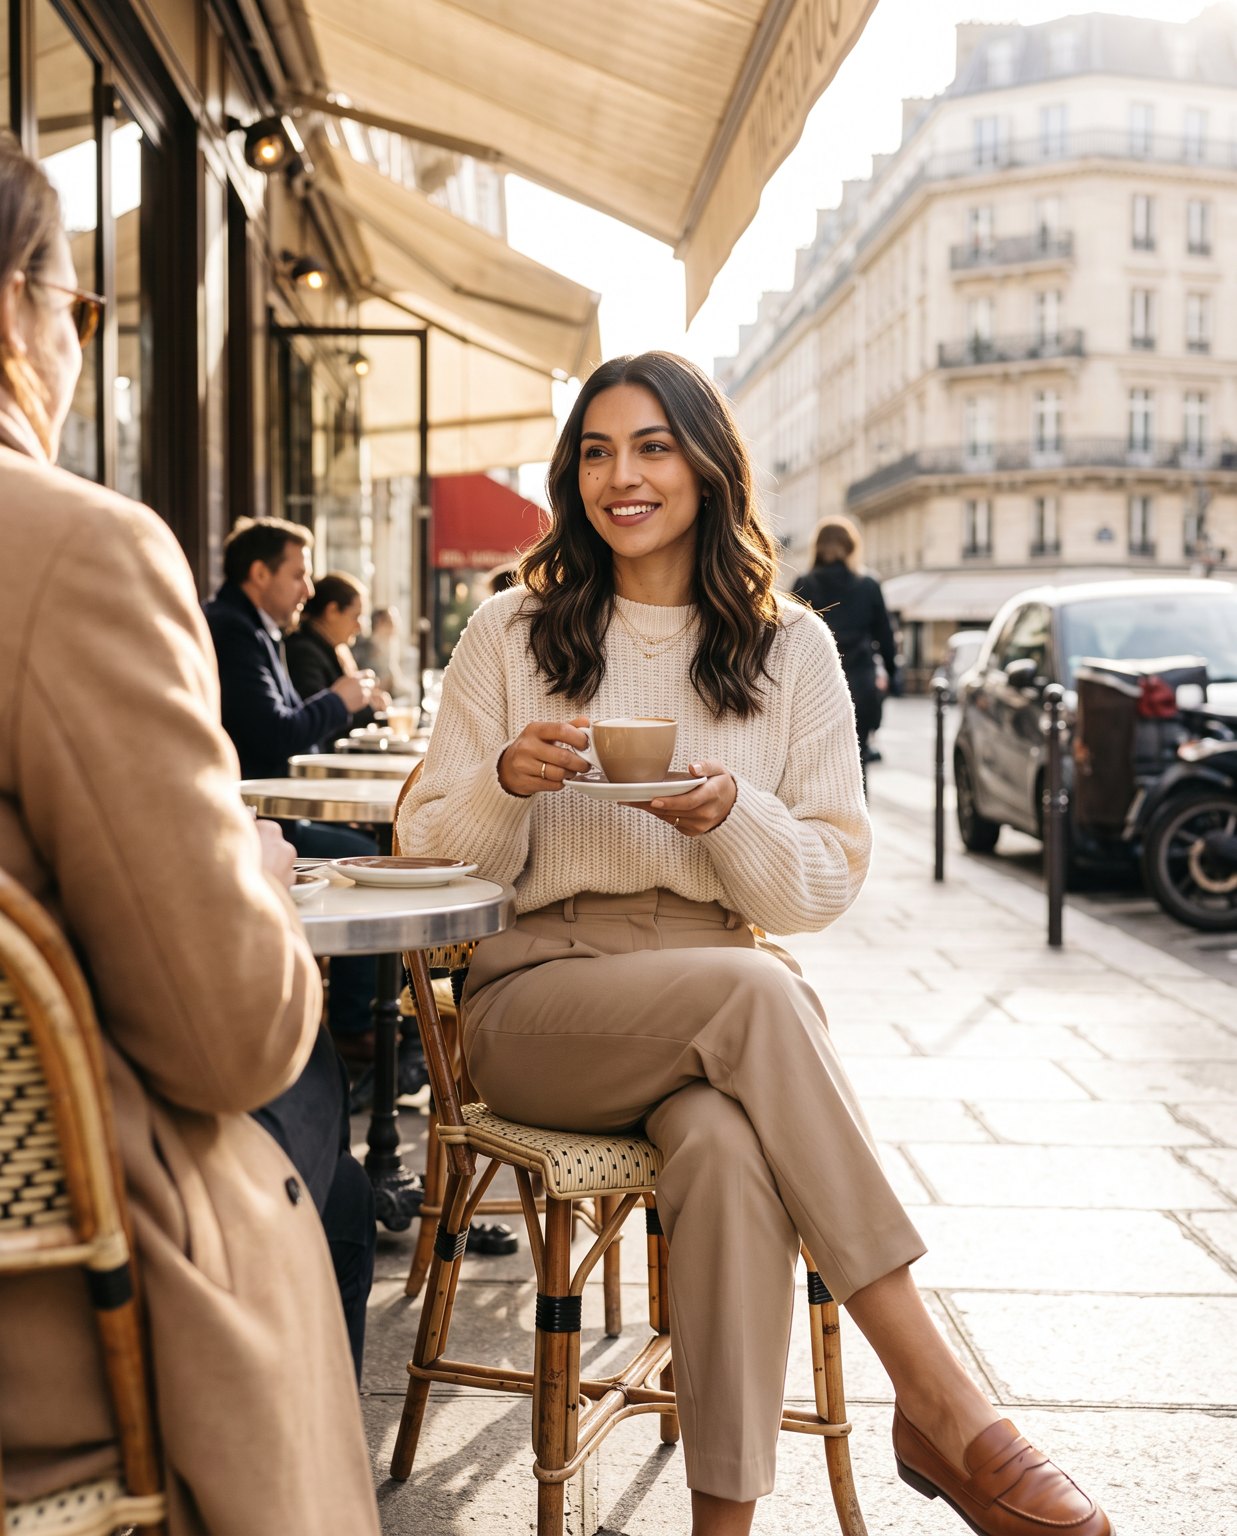
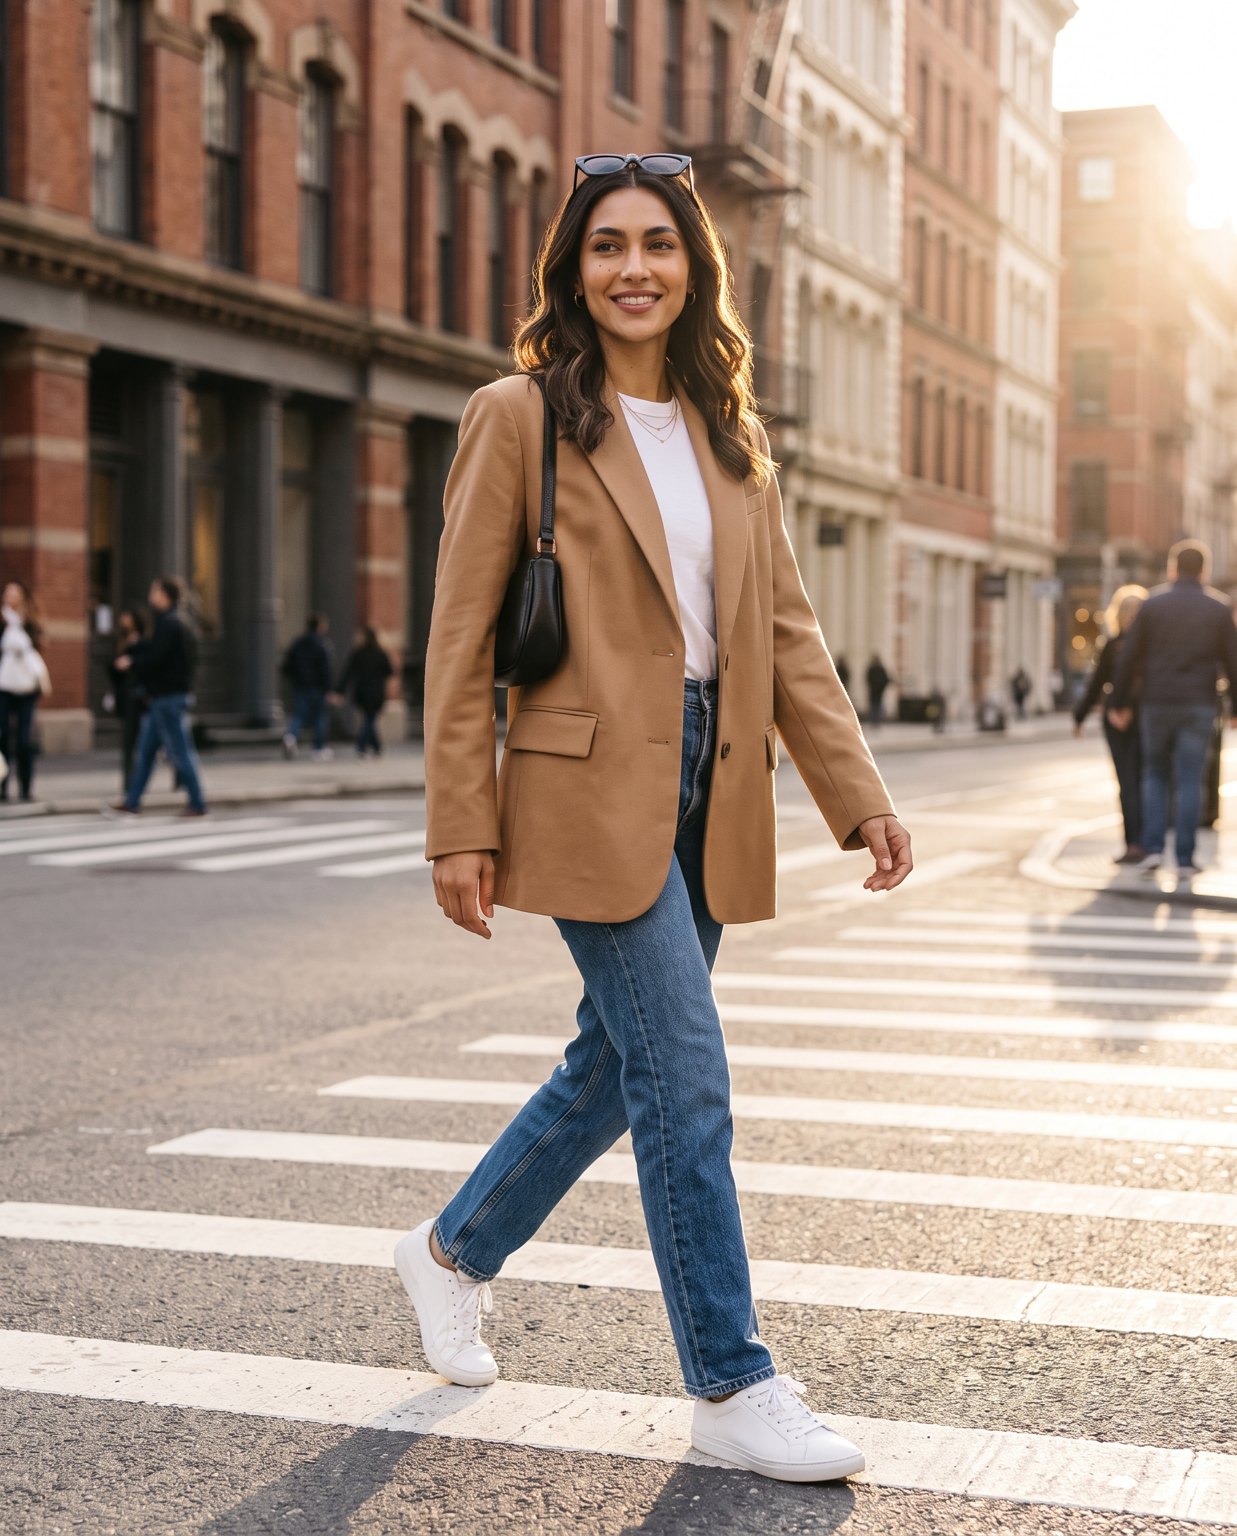
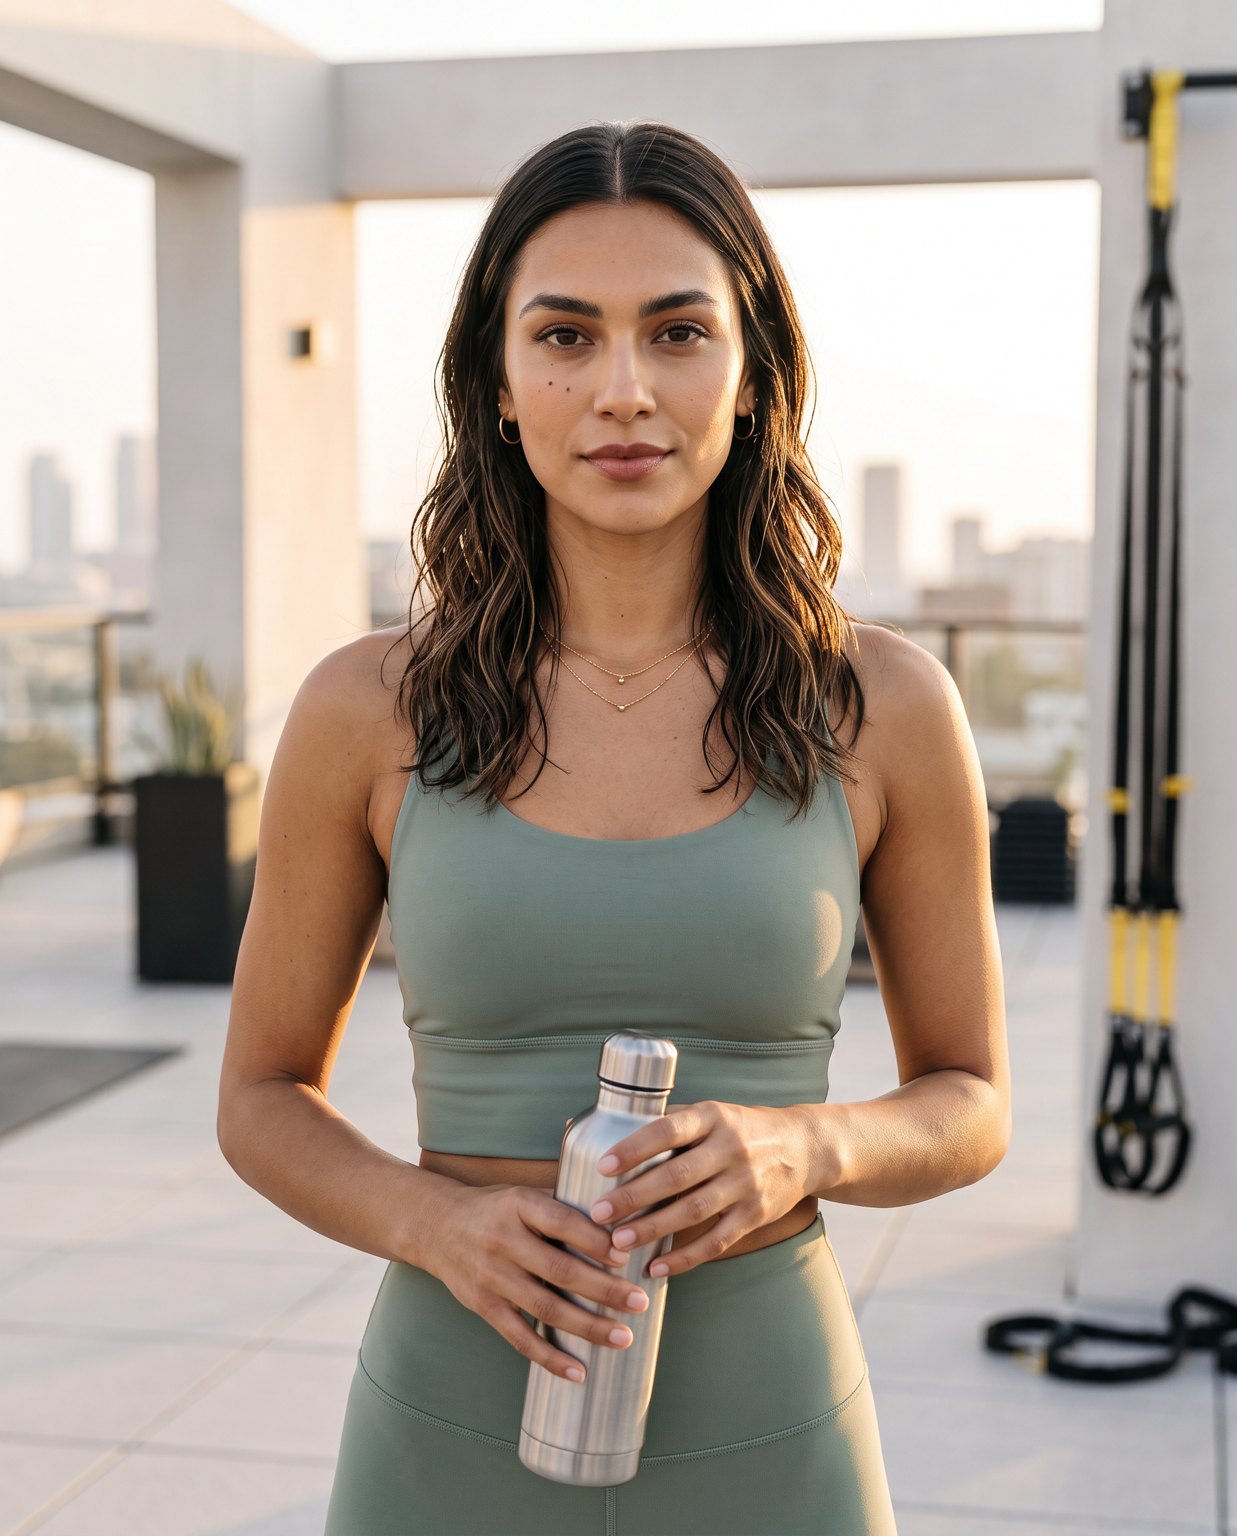
本次运行中实际保持的内容:在咖啡馆、街道和健身房三张渲染图中,面部几何结构、肤色、带焦糖挑染的波浪发、金色耳环和细叠戴项链都保持同一个可辨认的人。唯一需要注意的是微观细节——美人痣或一根散发的确切位置是最先漂移的。有效的修正方法是把每一次渲染都锚定到那一张原始人像,而不是链式传递(用场景 A 的输出作为场景 B 的输入)。链式传递会让小漂移累积;单一固定锚点不会。
第 3 步——把静帧变成 Reel
信息流需要动感。取任意锁定后的静帧,发送给图生视频模型。下面的短片就是上面的咖啡馆照片,用 grok-imagine-1.5/image-to-video 真实制作成动画:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
注意这里输入字段不同:视频模型使用 image_urls(加上以秒为单位的 duration),而不是 image_input。测试片段返回的是 480p、竖屏、5 秒——她按提示举起杯子喝了一口,脸在运动中仍是同一个人。按 $0.015/s 计算,这条 Reel 花费约 $0.075。如果你想要更清晰的输出,同一张静帧可以直接送入 veo-3.1-lite、kling-3.0 或 hailuo-2.3——见下表。
批量处理:一个参考,多个场景
虚拟模特的全部意义在于数量。保留一个场景提示词列表,并针对单张基础人像循环运行:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
替换模型字符串,你就可以在任何支持参考图的图像模型上运行同样的循环,或者把完成的静帧送入视频循环。
身份锁定阶段可选模型
价格为撰写时 /api/pricing 的当前每图像价格;大批量前务必重新核对。
| 模型 | 参考输入 | 价格(USD) | 备注 |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086(1K/2K/4K) | 本文所用;面部延续性强,支持 4K |
| nano-banana-pro | image_input |
$0.057(1K 与 2K)/ $0.10(4K) | 同系列的高级版本 |
gpt-image-2 /image-to-image@ext |
最多 16 张参考图 | 低至 $0.007(低质量,1K) | 最便宜的多参考路线,4K 输出 |
flux-2 /image-to-image |
多参考 | $0.035(1K)/ $0.05(2K) | 高保真多参考编辑 |
seedream-5.0-pro /image-to-image |
多参考 | $0.06(1K)/ $0.10(2K) | 旗舰级质量的多参考 |
在 模型市场 浏览完整阵容。对于单张固定脸,一张参考图就足够了;gpt-image-2 的 16 参考图路线在你想要在一次渲染中融合脸、服装和产品时大放异彩。
视频阶段可选模型
计价模式不同——大多数按每秒计费,但 hailuo 按固定片段长度的统一费率计费。批量预算时要注意这一差异。
| 模型 | 计费方式 | 示例成本 | 备注 |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
按秒 | $0.015/s(480p),$0.0282/s(720p) | 本文所用;最便宜,1–15 秒 |
veo-3.1-lite /image-to-video |
按秒 | $0.06/s(720p,无音频)→ $0.14/s(1080p) | 质量与成本平衡良好 |
kling-3.0 /image-to-video |
按秒 | $0.10/s(720p)→ $0.129/s(1080p);+音频费用更高 | 原生音频,最高 4K |
hailuo-2.3-fast /image-to-video |
按片段 | $0.27(6s)/ $0.46(10s) | 按固定时长档位统一收费 |
wan2.7-video /image-to-video |
按秒 | $0.10/s(720P)/ $0.167/s(1080P) | 首帧驱动 |
veo-3.1 /image-to-video |
按秒 | 含音频 $0.57/s → $0.86/s(4K) | 电影级档次;5 秒片段约 $2.85,因此要限制时长 |
因此,5 秒的 Reel 成本从 grok-imagine-1.5 的约 $0.075 到完整 veo-3.1 的约 $2.85 不等——相差 38 倍。先在便宜档位做原型,只升级你真正会发布的片段。
真正起作用的连贯性技巧
- 锚定,不要链式传递。把原始基础人像送入每一次渲染。用上一次输出作为下一次输入会让微小漂移累积,直到脸变成表亲,而不是同一个人。
- 在提示词中写出不变特征。「左眼下方同样的美人痣,同样的金色耳环」比「同一个女人」更有用。你是在告诉模型它不允许改变什么。
- 每个渠道保持一个宽高比。信息流网格用 4:5,Reels 用 9:16。拍摄中途切换会强制进行尴尬的重新裁剪,可能裁掉脸。
- 将分辨率锁定到模型的档位。
nano-banana-2接受1K/2K/4K;明确设置它,这样批量处理不会悄悄混合尺寸。 - 把最强的人像保留为永久资产。这是你的「选角」——在数月内重复使用它,而不是每次活动都重新生成一张新脸。
本文花费
| 项目 | 模型 | 数量 | 单价 | 小计 |
|---|---|---|---|---|
| 基础人像 + 3 个场景渲染 | nano-banana-2(2K) | 4 | $0.057 | $0.228 |
| 咖啡馆 Reel | grok-imagine-1.5(480p,5s) | 1 | $0.015/s | $0.075 |
| 总计 | 约 $0.30 |
一个完整的 30 帖发布网格加上几条 Reel,总花费只有个位数美元的低位——这才是团队选择生成器而不是拍摄的真正原因。
FAQ
每次都能保证脸完全相同吗? 没有模型能保证像素级相同的脸,但在本次测试中,nano-banana-2 上的参考图锚定在三个非常不同的场景中保持了同一个可辨认的人。把偶发的异常视为多生成几张再筛选的理由,而不是重新拍摄的理由。
我可以锁定真实人物的脸吗? 只能锁定你拥有权利的人——你自己、同意的模特,或签约的品牌大使。不要克隆陌生人或名人。
我需要微调或 LoRA 吗? 不需要。整个工作流是零训练的——一张参考图加一段提示词。这正是每张图片成本保持在几美分的原因。
我应该从哪个模型开始? 身份锁定从 nano-banana-2 开始,视频阶段从 grok-imagine-1.5 开始。两者都足够便宜,可以自由迭代;只在风格确定后再升级。
开始构建
在 nano-banana-2 上生成一张人像,将其作为 image_input 回传给每个场景,并用图生视频模型为你最喜欢的帧制作动画——全部通过一个密钥经 POST /v1/tasks 完成。快速入门文档 介绍了认证和轮询,你可以在扩展批量之前,在 定价页 比较每个图像和视频模型。


