
Guida all'uso
Generatore di modelle Instagram AI: creare influencer virtuali coerenti su hiapi
Blocca lo stesso volto con un'immagine di riferimento, genera in batch scene diverse e trasformale in Reels — il tutto tramite /v1/tasks di hiapi.
TL;DR
- Il generatore di modelle Instagram AI è essenzialmente una pipeline in tre fasi: crea un personaggio, blocca quel volto in modo che si ripeta in ogni scatto, poi trasforma i migliori fotogrammi fissi in brevi video. hiapi esegue tutte e tre le fasi tramite un'unica interfaccia asincrona
POST /v1/tasks. - Questa guida usa il percorso immagine di riferimento per bloccare l'identità: rimandi un ritratto base come
image_inpute cambi solo la scena. È diverso dal metodo testuale del «set di personaggio» presentato in Consistent Characters with Nano-Banana; usa quello quando non hai ancora un'immagine seme, usa questo quando vuoi fissare un volto. - Questo articolo è testato su nano-banana-2: un ritratto base ha ancorato tre scene completamente diverse — un caffè parigino, un attraversamento pedonale urbano e una palestra sul tetto — con volto, acconciatura, carnagione, orecchini dorati e collane sovrapposte coerenti in tutte le scene.
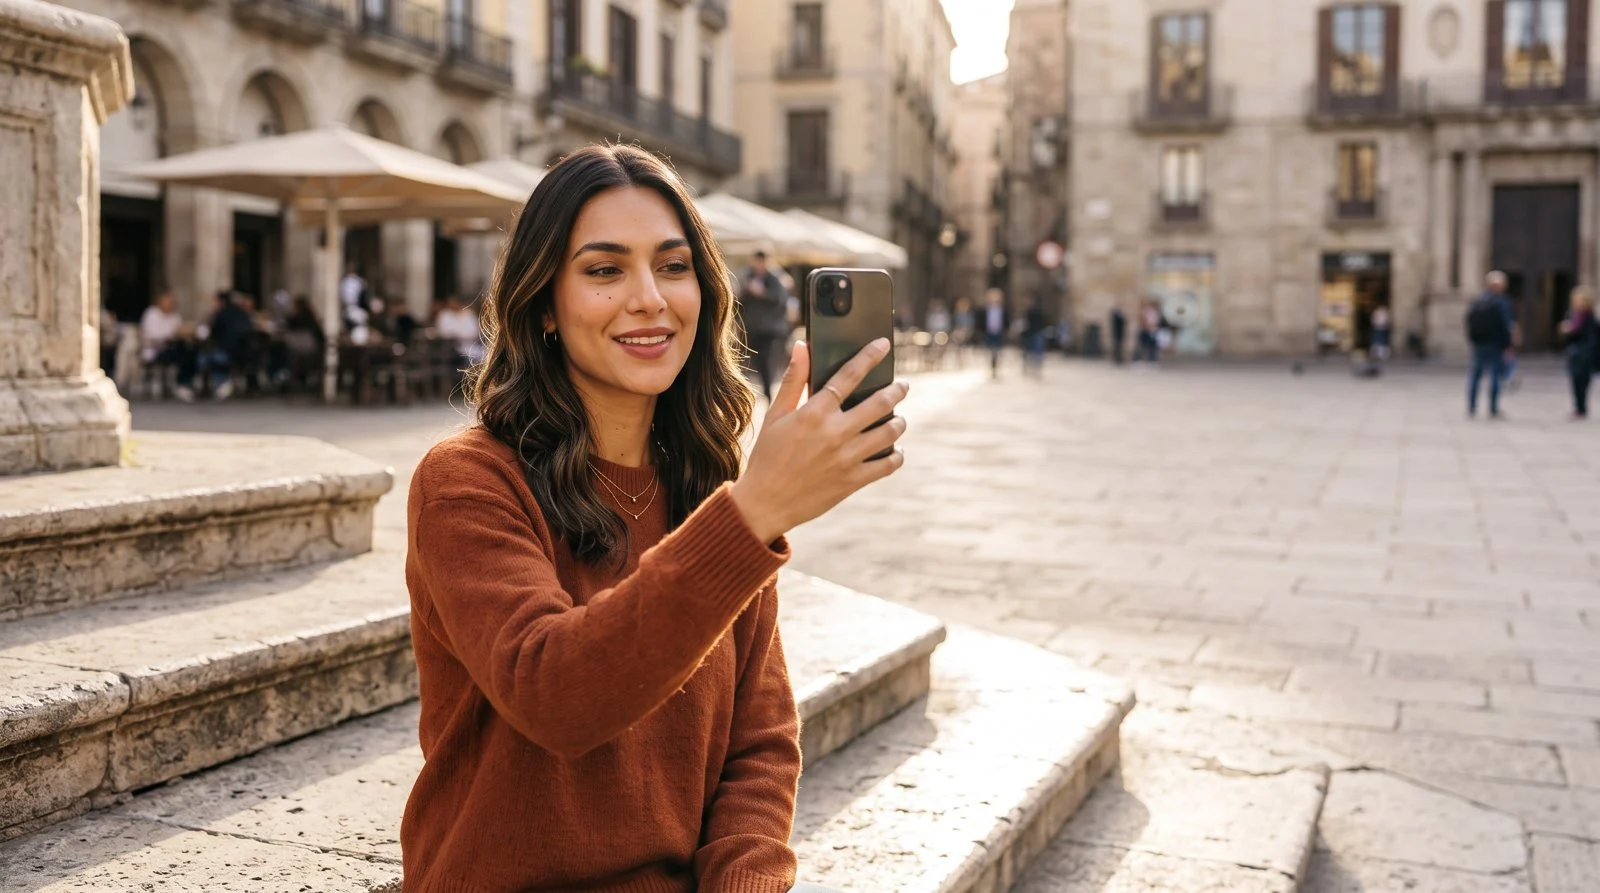
- La fase video è reale, non un mockup: il fotogramma del caffè qui sotto è stato trasformato in un cortometraggio di 5 secondi con
grok-imagine-1.5/image-to-video. Lei solleva la tazza e ne beve un sorso; l'identità si mantiene anche in movimento. - Budget dell'intero post del blog: circa $0.30 — quattro immagini 2K su nano-banana-2 a $0.057 ciascuna ($0.228), più un Reel 480p/5s fatturato a $0.015/s ($0.075).
Cosa stai effettivamente costruendo
«Influencer virtuale», «modella UGC AI», «generatore di modelle Instagram AI» — i nomi di marketing variano, ma l'implementazione ingegneristica è sempre la stessa in tre fasi:
- Personaggio — genera (o scegli) un ritratto base che funga da volto canonico della tua modella.
- Blocco dell'identità — fai apparire la stessa persona in vari abiti, pose e luoghi, così il feed sembra di un unico creator e non di quaranta persone diverse.
- Animazione — trasforma i fotogrammi fissi più d'impatto in brevi Reels / Shorts che fermano lo scroll.
La difficoltà è nella fase 2. Tutto ciò che segue — una griglia di feed credibile, prove prodotto, post brandizzati — crolla nel momento in cui il volto deriva. Su hiapi ci sono due modi per tenerlo stabile.
Due modi per bloccare un volto (e perché questa guida sceglie il percorso con immagine di riferimento)
| Metodo | Come viene ancorata l'identità | Quando usarlo |
|---|---|---|
| Set di personaggio (testo) | Un prefisso di prompt denso e riutilizzabile che descrive volto, capelli e guardaroba, concatenato a ogni rendering. Nessuna immagine seme. | Stai inventando un personaggio da zero e vuoi definirlo con un testo versionabile. |
| Immagine di riferimento (questa guida) | Rimandi un ritratto base come image_input; il prompt cambia solo la scena. |
Hai già un volto approvato (un rendering hero, la mascotte del brand) e vuoi che quel volto appaia ovunque. |
Il metodo del set di personaggio è descritto in modo completo in Consistent Characters with Nano-Banana — con esempi di storyboard e lookbook e-commerce. Questa guida prende l'altra strada: blocca un ritratto specifico con un'immagine di riferimento, poi lo estende a più scene e lo trasforma in video. I due approcci sono complementari; molti team scrivono una volta il set di personaggio, generano un ritratto hero, poi passano alla modalità immagine di riferimento per il resto dello shooting.
Fase 1 — Genera il personaggio base
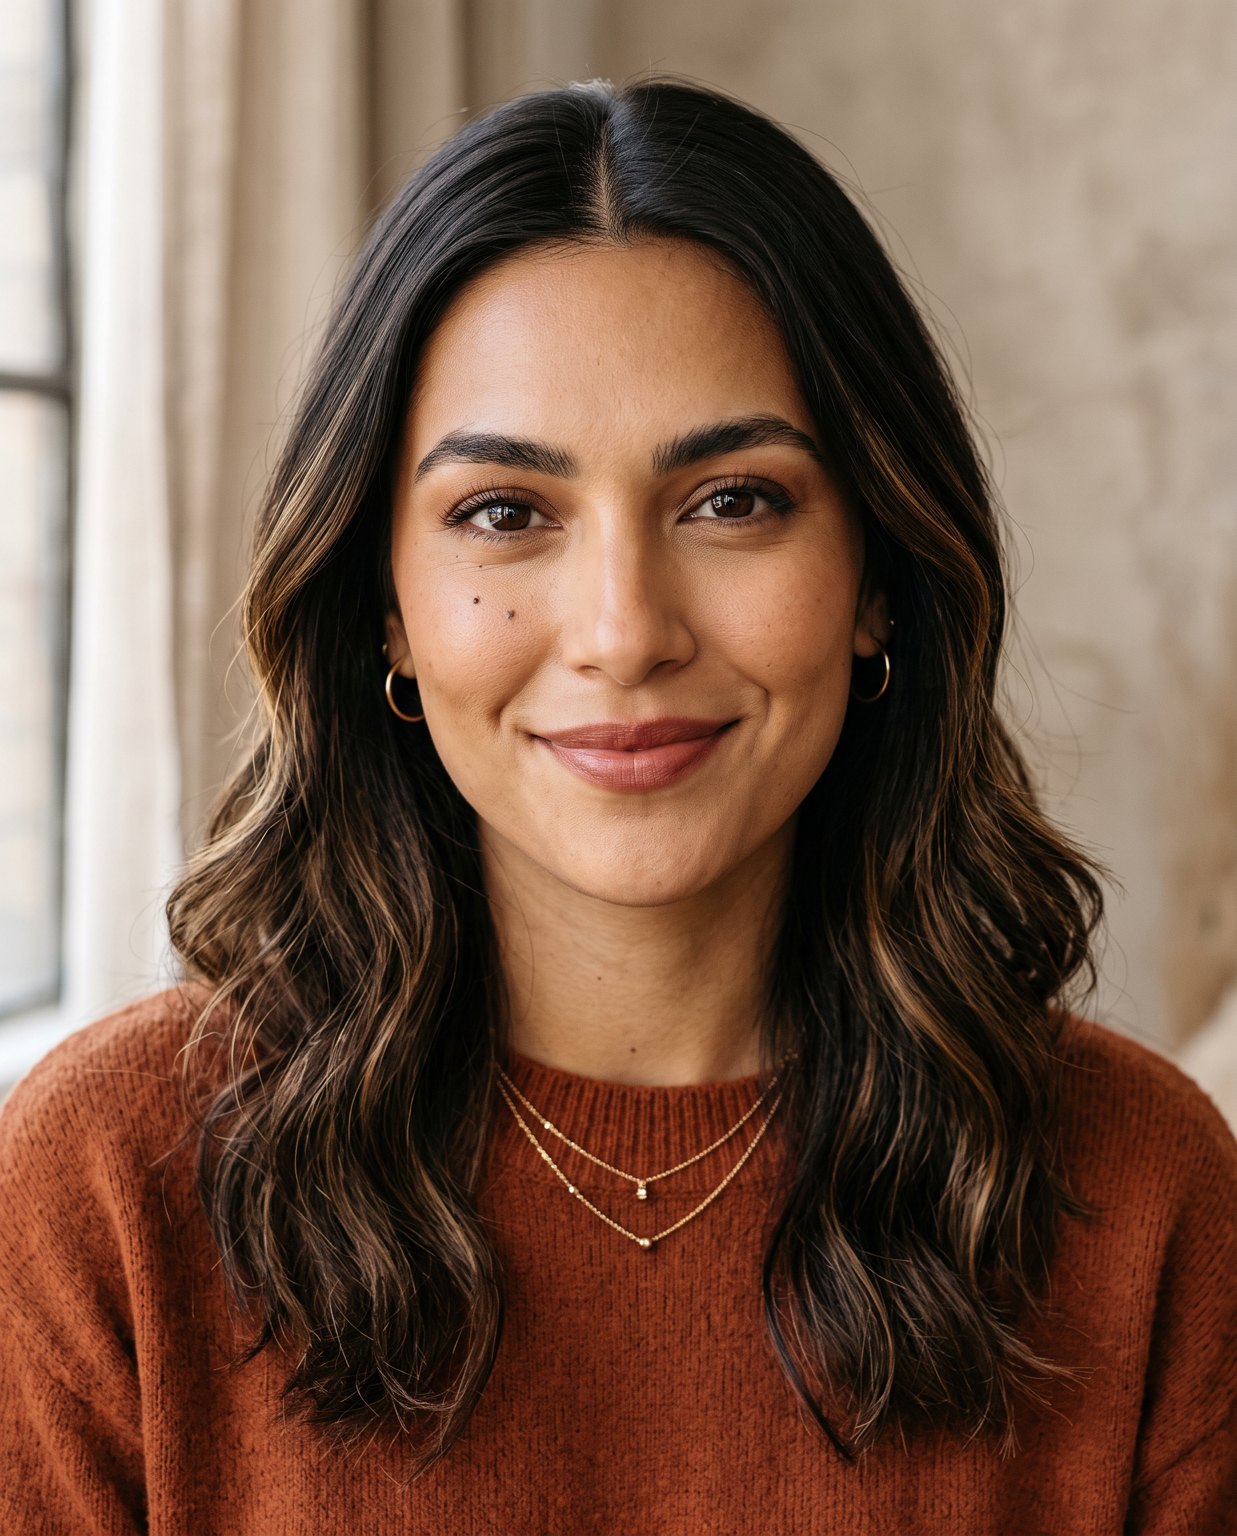
Parti da un ritratto pulito e ben illuminato. Qui i dettagli sono tuoi alleati: più specifiche sono le caratteristiche invarianti (un neo, una riga dei capelli, un gioiello), più facile sarà portarle avanti.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks restituisce un taskId; interroga GET /v1/tasks/{taskId} finché status non è success, poi scarica output[0].url. Quell'URL è temporaneo (con expireAt), quindi salva subito i byte — non fare hotlink. Carica il ritratto in una posizione accessibile (il tuo CDN), perché il passo successivo lo richiede come URL di input. nano-banana-2 costa $0.036 / $0.057 / $0.086 rispettivamente a 1K / 2K / 4K; questo shooting ha usato il 2K.
Fase 2 — Blocca l'identità tra le scene
Questo è il passo decisivo che la rende un'influencer e non una galleria di sconosciuti. Rimanda il ritratto base come image_input, poi scrivi un prompt che dica esplicitamente di mantenere questa persona e descriva solo la nuova scena.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
Il campo chiave è image_input — un array di URL di riferimento. Qui sotto lo stesso ritratto base è collocato in tre ambienti non correlati, con ogni rendering ancorato a quell'unico ritratto:
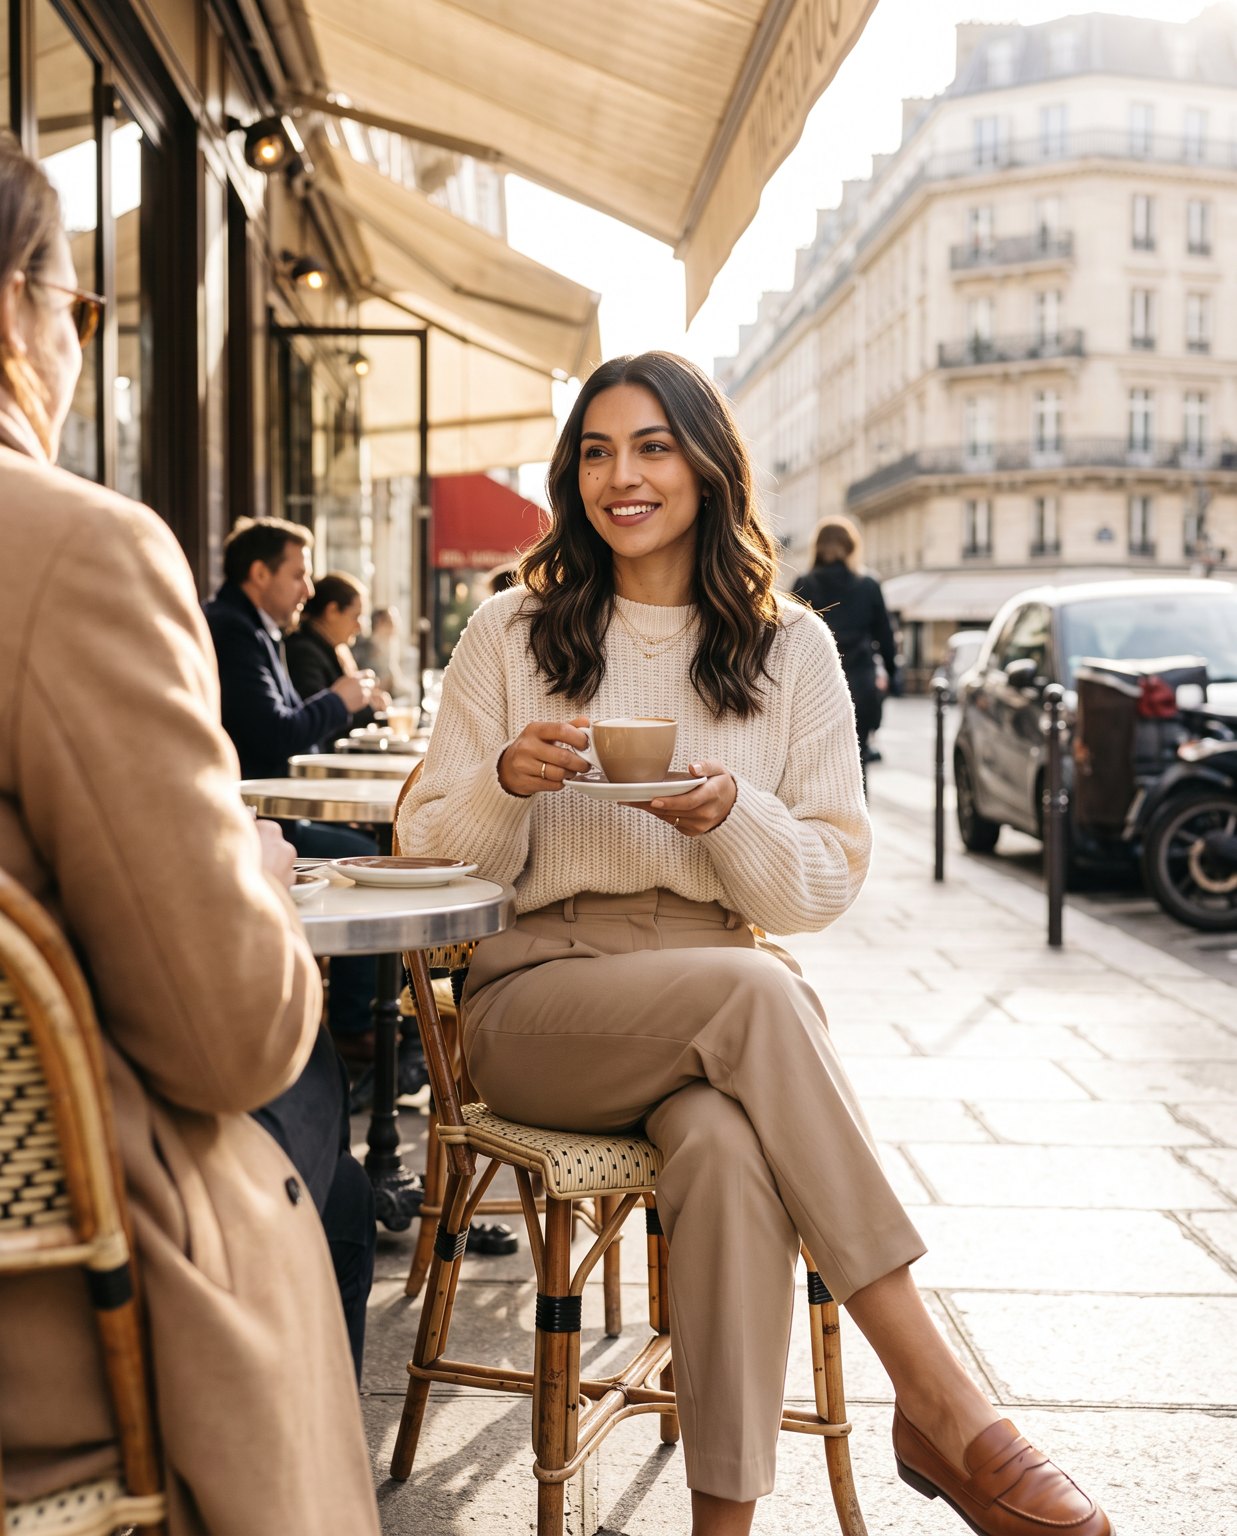
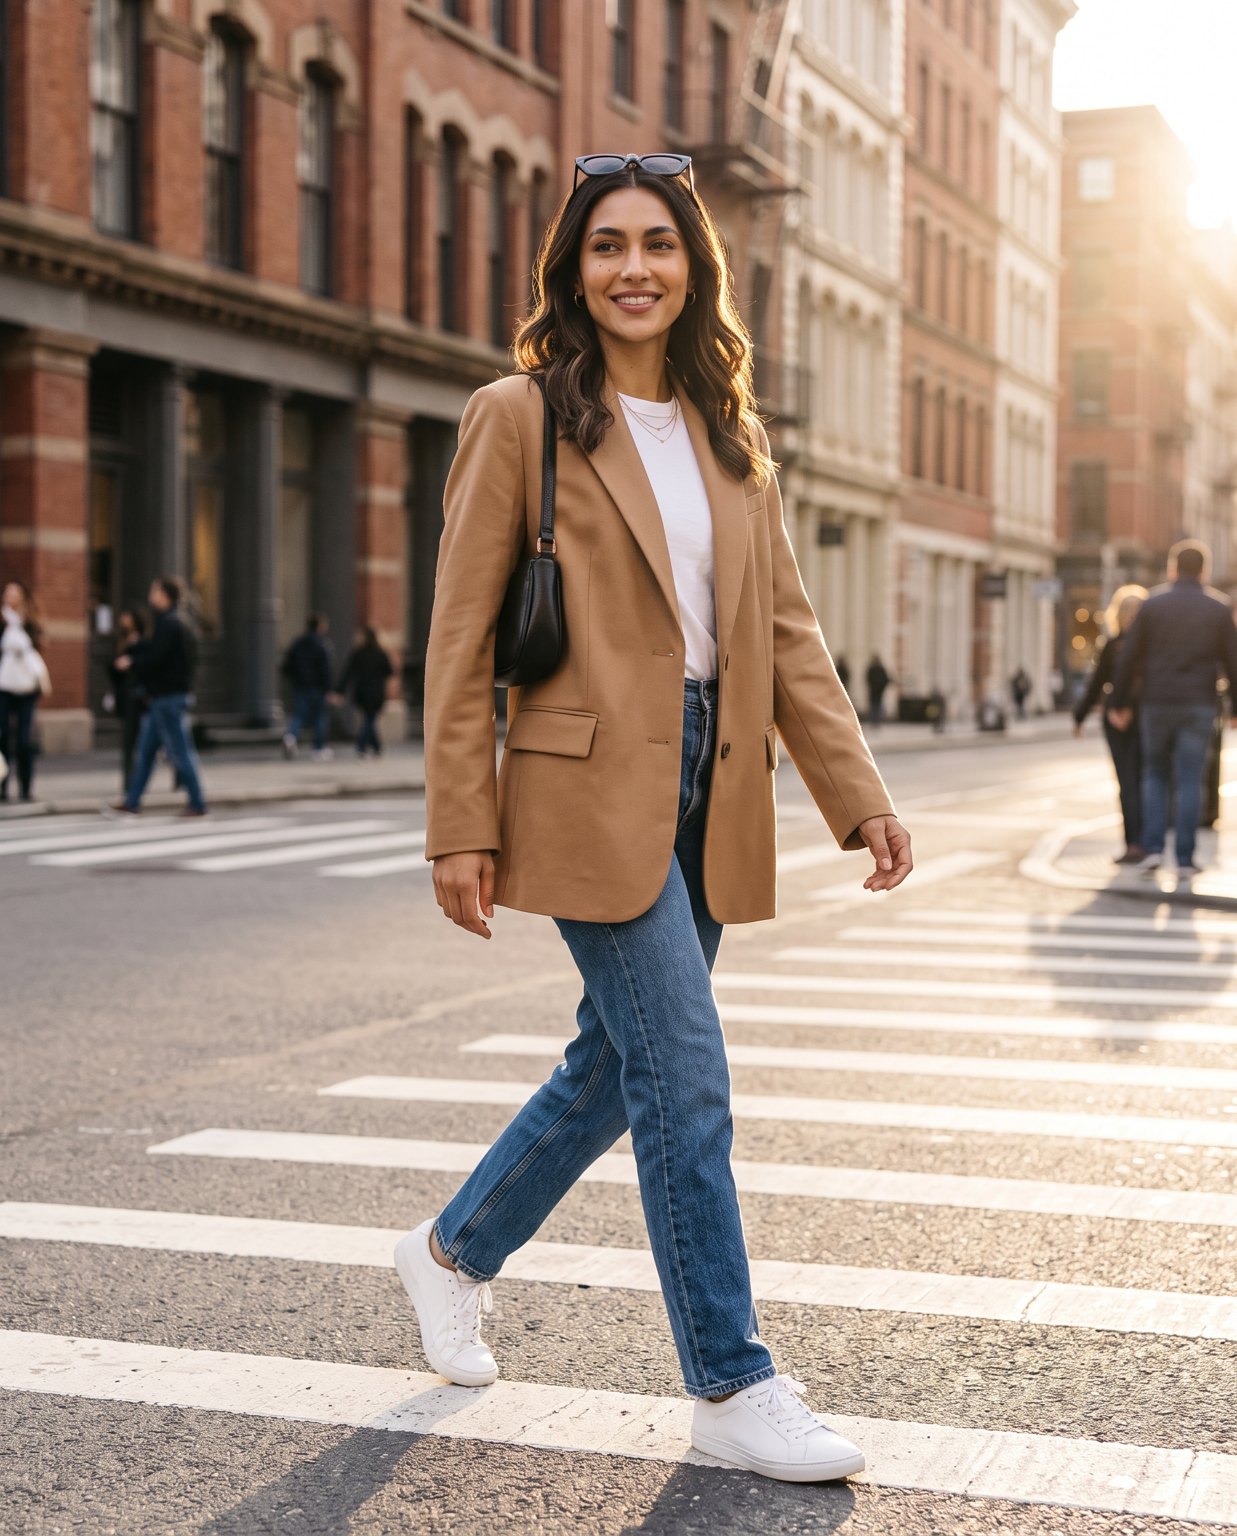
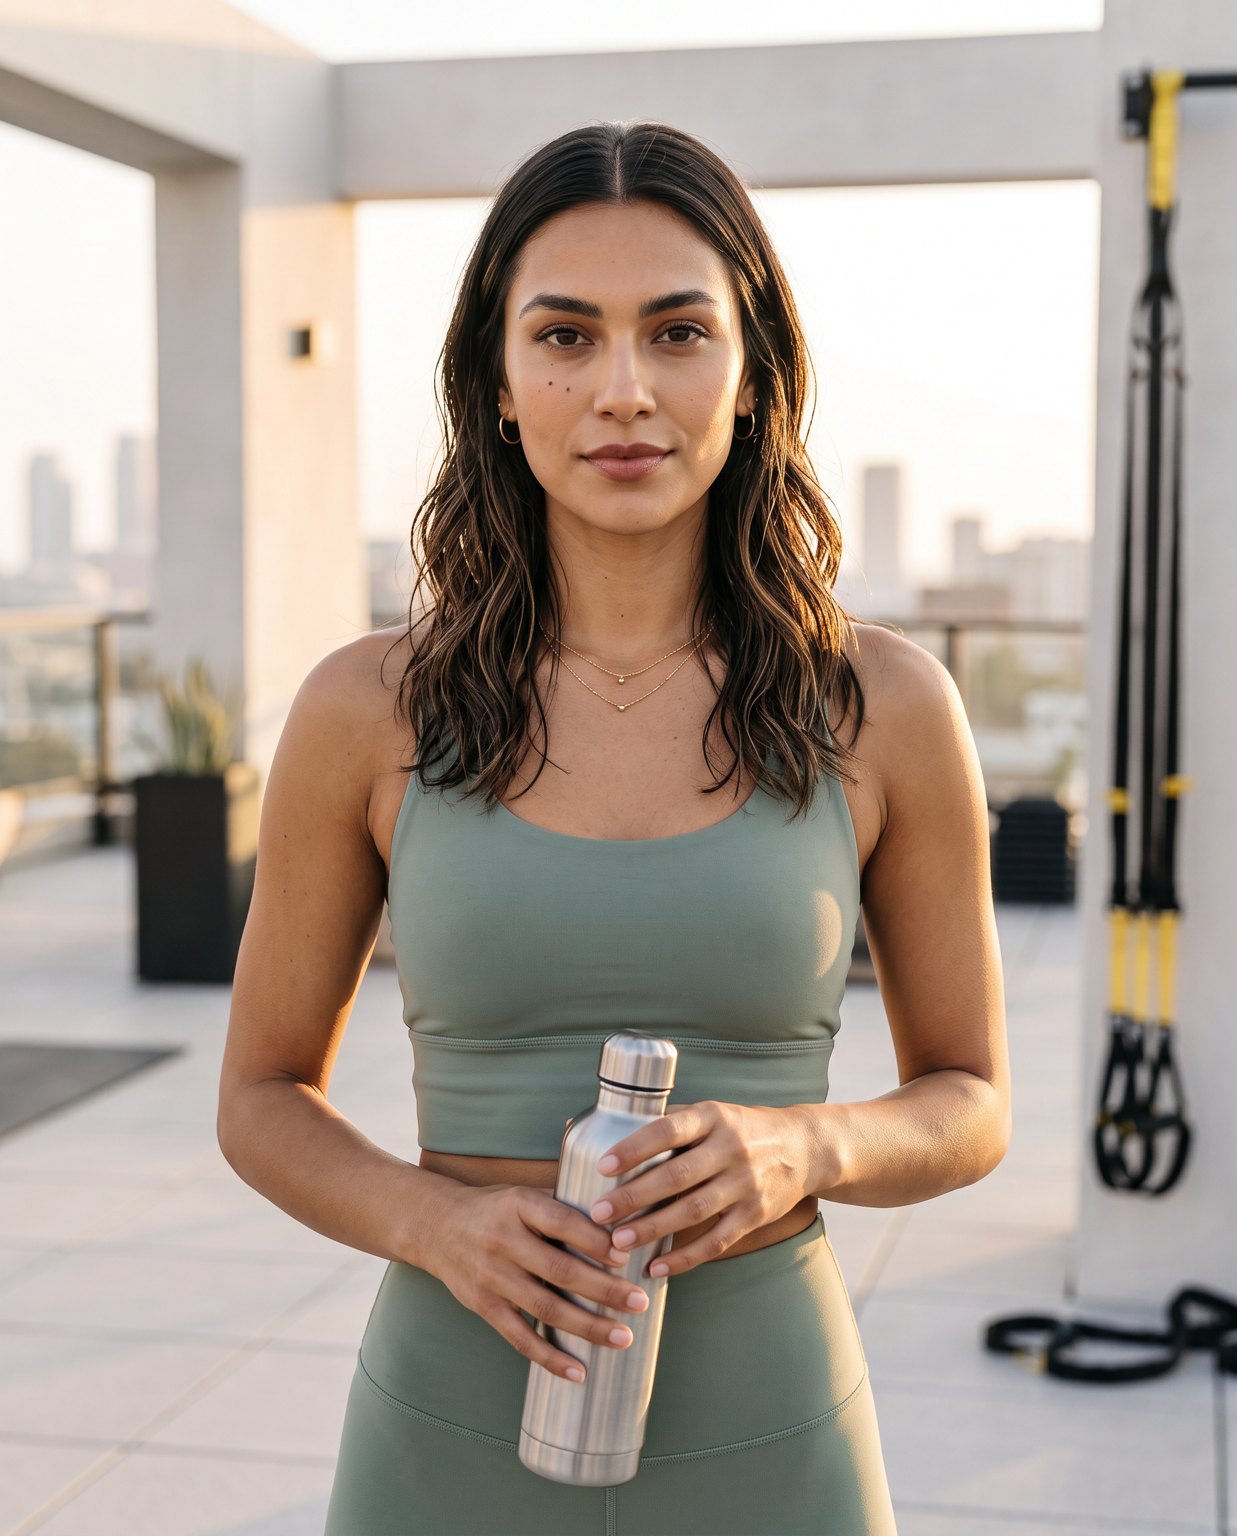
Cosa è rimasto effettivamente coerente in questa esecuzione: nei tre rendering al caffè, in strada e in palestra, geometria del volto, carnagione, capelli mossi con balayage caramello, orecchini dorati e la sottile collana sovrapposta restano la stessa persona riconoscibile. L'unica avvertenza sono i dettagli microscopici — la posizione esatta del neo o di un ciuffo ribelle è la prima cosa a derivare. La correzione efficace è ancorare ogni rendering a quell'unico ritratto originale, invece di concatenare (usare l'output della scena A come input della scena B). La concatenazione accumula piccole derive; un unico punto di ancoraggio fisso no.
Fase 3 — Trasforma il fotogramma fisso in un Reel
Il feed ha bisogno di movimento. Prendi un qualsiasi fotogramma bloccato e invialo a un modello image-to-video. Il cortometraggio qui sotto è proprio la foto del caffè, animata realmente con grok-imagine-1.5/image-to-video:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Nota i campi di input diversi: i modelli video usano image_urls (più duration in secondi), non image_input. La clip di test restituisce 480p, verticale, 5 secondi — solleva la tazza e beve come richiesto, e il volto resta la stessa persona in movimento. A $0.015/s, questo Reel costa circa $0.075. Se vuoi un output più nitido, lo stesso fotogramma fisso può essere inviato direttamente a veo-3.1-lite, kling-3.0 o hailuo-2.3 — vedi la tabella sotto.
Elaborazione in batch: un riferimento, più scene
Il senso di una modella virtuale è il volume. Tieni una lista di prompt di scena ed eseguila in ciclo su un unico ritratto base:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Sostituisci la stringa del modello e puoi eseguire lo stesso ciclo su qualsiasi modello immagine che supporti immagini di riferimento, oppure inviare i fotogrammi completati al ciclo video.
Modelli opzionali per la fase di blocco dell'identità
I prezzi sono quelli per immagine correnti su /api/pricing al momento della scrittura; ricontrolla sempre prima di grandi batch.
| Modello | Input di riferimento | Prezzo (USD) | Note |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086 (1K/2K/4K) | Usato in questo articolo; forte continuità del volto, supporta 4K |
| nano-banana-pro | image_input |
$0.057 (1K e 2K) / $0.10 (4K) | Versione premium della stessa serie |
gpt-image-2 /image-to-image@ext |
Fino a 16 immagini di riferimento | Da $0.007 (bassa qualità, 1K) | Il percorso multi-riferimento più economico, output 4K |
flux-2 /image-to-image |
Multi-riferimento | $0.035 (1K) / $0.05 (2K) | Editing multi-riferimento ad alta fedeltà |
seedream-5.0-pro /image-to-image |
Multi-riferimento | $0.06 (1K) / $0.10 (2K) | Qualità multi-riferimento di livello flagship |
Esplora la gamma completa nel marketplace dei modelli. Per un singolo volto fisso, un'immagine di riferimento è sufficiente; il percorso a 16 riferimenti di gpt-image-2 brilla quando vuoi fondere volto, abbigliamento e prodotto in un unico rendering.
Modelli opzionali per la fase video
I modelli di prezzo sono diversi — la maggior parte fattura al secondo, ma hailuo fattura a tariffa fissa per lunghezza del clip. Tieni conto di questa differenza nel budget dei batch.
| Modello | Modalità di fatturazione | Costo di esempio | Note |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
Al secondo | $0.015/s (480p), $0.0282/s (720p) | Usato in questo articolo; il più economico, 1–15 secondi |
veo-3.1-lite /image-to-video |
Al secondo | $0.06/s (720p, senza audio) → $0.14/s (1080p) | Buon equilibrio qualità/costo |
kling-3.0 /image-to-video |
Al secondo | $0.10/s (720p) → $0.129/s (1080p); con audio costa di più | Audio nativo, fino a 4K |
hailuo-2.3-fast /image-to-video |
Per clip | $0.27 (6s) / $0.46 (10s) | Tariffa fissa per fascia di durata |
wan2.7-video /image-to-video |
Al secondo | $0.10/s (720P) / $0.167/s (1080P) | Guidato dal primo fotogramma |
veo-3.1 /image-to-video |
Al secondo | Con audio $0.57/s → $0.86/s (4K) | Fascia cinematografica; un clip di 5 secondi costa circa $2.85, quindi limita la durata |
Quindi un Reel di 5 secondi va da circa $0.075 con grok-imagine-1.5 a circa $2.85 con veo-3.1 completo — un fattore 38 di differenza. Prototipa prima sulle fasce economiche e potenzia solo i clip che pubblicherai davvero.
Trucchi di coerenza che funzionano davvero
- Ancora, non concatenare. Invia il ritratto base originale a ogni rendering. Usare l'output precedente come input successivo accumula piccole derive, finché il volto diventa un cugino, non la stessa persona.
- Scrivi le caratteristiche invarianti nel prompt. «Lo stesso neo sotto l'occhio sinistro, gli stessi orecchini dorati» è più utile di «la stessa donna». Stai dicendo al modello cosa non può cambiare.
- Mantieni un solo rapporto d'aspetto per canale. 4:5 per la griglia del feed, 9:16 per i Reels. Cambiarlo a metà shooting forza un ritaglio sgraziato che può tagliare il volto.
- Blocca la risoluzione alla fascia del modello.
nano-banana-2accetta1K/2K/4K; impostala esplicitamente così il batch non mescola silenziosamente le dimensioni. - Conserva il ritratto migliore come asset permanente. È il tuo «casting» — riutilizzalo per mesi, invece di rigenerare un nuovo volto per ogni campagna.
Costi di questo articolo
| Voce | Modello | Quantità | Prezzo unitario | Subtotale |
|---|---|---|---|---|
| Ritratto base + 3 rendering di scena | nano-banana-2 (2K) | 4 | $0.057 | $0.228 |
| Reel del caffè | grok-imagine-1.5 (480p, 5s) | 1 | $0.015/s | $0.075 |
| Totale | circa $0.30 |
Una griglia di pubblicazione completa di 30 post più alcuni Reels costa solo una cifra a una sola cifra in dollari — questo è il vero motivo per cui i team scelgono un generatore invece di uno shooting.
FAQ
Il volto è garantito identico ogni volta? Nessun modello garantisce un volto identico a livello di pixel, ma in questo test l'ancoraggio tramite immagine di riferimento su nano-banana-2 ha mantenuto la stessa persona riconoscibile in tre scene molto diverse. Considera le anomalie occasionali come motivo per generare qualche immagine in più e poi selezionare, non per rifare lo shooting.
Posso bloccare il volto di una persona reale? Solo di persone di cui hai i diritti — te stesso, una modella consenziente o un ambassador del brand sotto contratto. Non clonare sconosciuti o celebrità.
Ho bisogno di fine-tuning o LoRA? No. L'intero workflow è a training zero — un'immagine di riferimento più un prompt. È proprio questo che mantiene il costo per immagine a pochi centesimi.
Da quale modello dovrei partire? Inizia con nano-banana-2 per il blocco dell'identità e con grok-imagine-1.5 per la fase video. Entrambi sono abbastanza economici per iterare liberamente; potenzia solo dopo aver definito lo stile.
Inizia a costruire
Genera un ritratto su nano-banana-2, rimandalo come image_input a ogni scena e anima il fotogramma che preferisci con un modello image-to-video — il tutto tramite una sola chiave su POST /v1/tasks. La documentazione di quick start copre autenticazione e polling, e puoi confrontare ogni modello immagine e video nella pagina dei prezzi prima di scalare i batch.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a seedream-5.0-pro/image-to-image: capacità, prezzi e punti chiave di integrazione
Limiti di capacità, modalità di fatturazione e pratiche di integrazione ingegneristica del modello di editing immagini di ByteDance
-

Guida all'uso
Guida pratica al text-to-image con seedream-5.0-pro: limiti di capacità, integrazione API e controllo dei costi
Prospettiva operativa per sviluppatori: dai punti chiave sui parametri alla stima di costo di $0,05 per immagine
-

Guida all'uso
Guida introduttiva a Hailuo 2.3 Fast image-to-video: limiti delle capacità, prezzi e pratiche di integrazione
Selezione e integrazione del modello MiniMax image-to-video per sviluppatori