
Benutzerhandbuch
KI-Instagram-Model-Generator: Konsistente virtuelle Influencer auf hiapi erstellen
Fixiere mit einem Referenzbild dasselbe Gesicht, generiere verschiedene Szenen im Batch und verwandle sie in Reels – alles über /v1/tasks von hiapi.
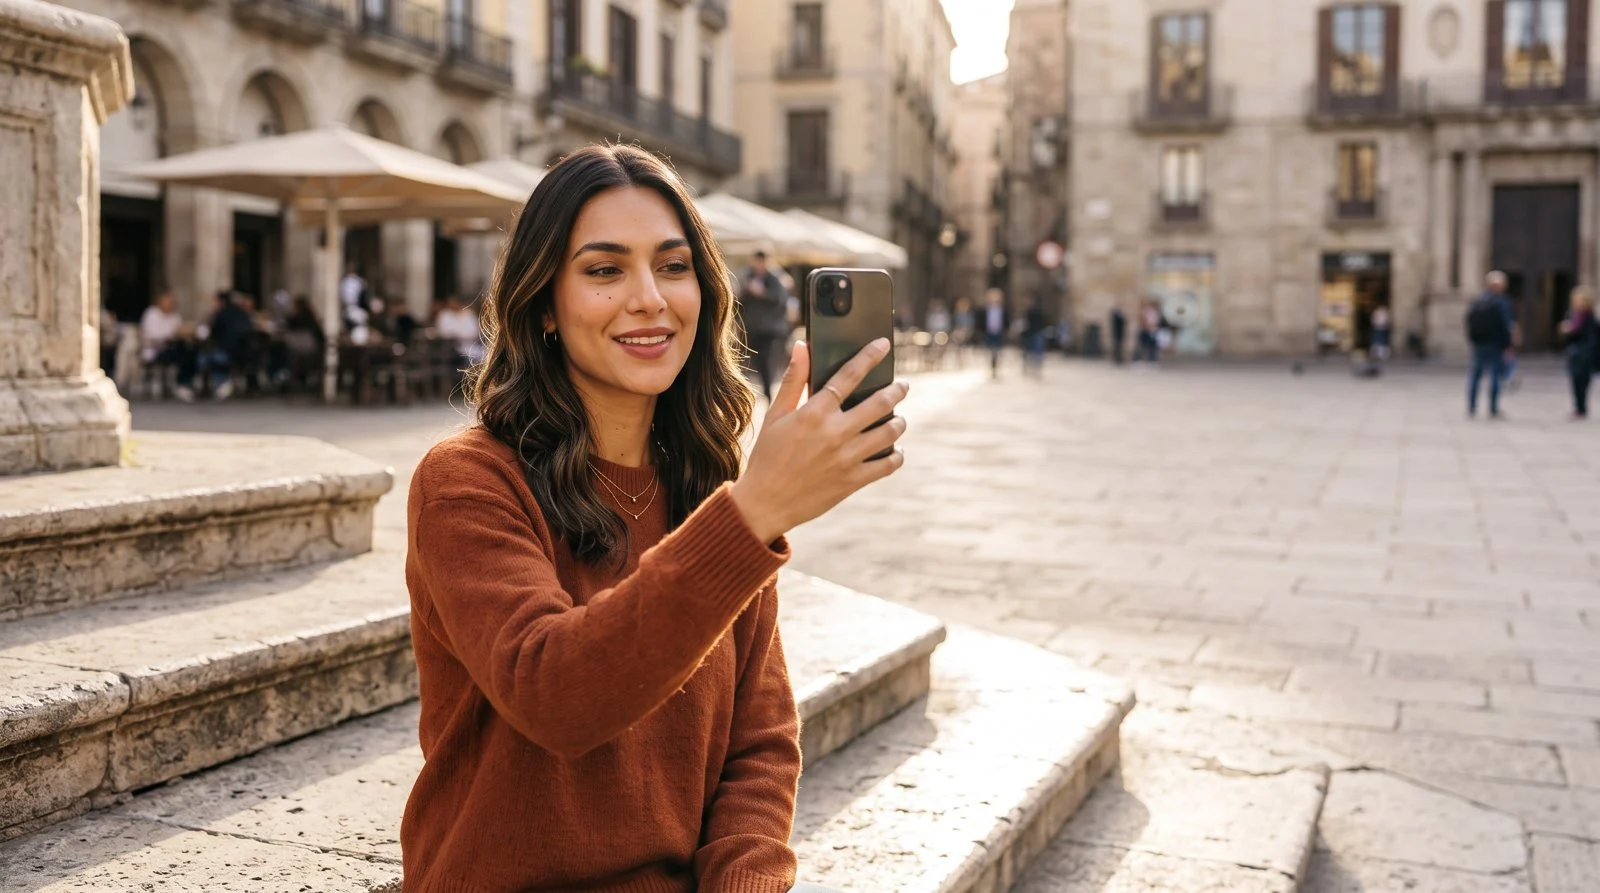
TL;DR
- KI-Instagram-Model-Generator ist im Kern eine dreistufige Pipeline: eine Figur erstellen, dieses Gesicht fixieren, damit es in jeder Aufnahme wiederkehrt, und dann die besten Standbilder in kurze Videos verwandeln. hiapi führt alle drei Stufen über eine asynchrone Schnittstelle
POST /v1/tasksaus. - Diese Anleitung nutzt den Referenzbild-Ansatz zur Identitätsfixierung – du sendest ein Basisporträt als
image_inputzurück und änderst nur die Szene. Das unterscheidet sich von der rein textbasierten Methode des „Charakter-Sheets“ aus Consistent Characters with Nano-Banana; jene nutzt man, wenn man noch kein Ausgangsbild hat, diese, wenn man ein festes Gesicht will. - Dieser Artikel wurde auf nano-banana-2 getestet: Ein Basisporträt verankerte drei völlig unterschiedliche Szenen – ein Pariser Café, einen städtischen Zebrastreifen und ein Rooftop-Gym – wobei Gesicht, Frisur, Hautton, goldene Ohrringe und die geschichtete Halskette in allen Szenen konsistent blieben.
- Die Videostufe ist echt, keine Simulation: Das Café-Standbild unten wurde mit
grok-imagine-1.5/image-to-videozu einem 5-Sekunden-Clip verarbeitet. Sie hebt die Tasse und nimmt einen Schluck; die Identität bleibt in der Bewegung erhalten. - Budget für den gesamten Blogbeitrag: rund $0,30 – vier 2K-Bilder auf nano-banana-2 zu je $0,057 ($0,228) plus eine 480p/5s-Reel zu $0,015/s ($0,075).
Was du tatsächlich baust
„Virtueller Influencer“, „KI-UGC-Model“, „KI-Instagram-Model-Generator“ – die Marketingnamen unterscheiden sich, aber die technische Umsetzung ist immer dieselbe dreistufige Abfolge:
- Figur – ein Basisporträt generieren (oder auswählen), das als kanonisches Gesicht deines Models dient.
- Identitätsfixierung – dieselbe Person in verschiedenen Outfits, Posen und Orten erscheinen lassen, damit der Feed wie ein einzelner Creator wirkt und nicht wie vierzig verschiedene Menschen.
- Bewegung – die wirkungsvollsten Standbilder in kurze, aufmerksamkeitsstarke Reels-/Shorts-Clips verwandeln.
Die Schwierigkeit liegt in Stufe 2. Alles Nachgelagerte – ein glaubwürdiges Feed-Raster, Produkt-Anproben, Brand-Posts – bricht in dem Moment zusammen, in dem das Gesicht zu driften beginnt. Auf hiapi gibt es zwei Methoden, es stabil zu halten.
Zwei Wege, ein Gesicht zu fixieren (und warum diese Anleitung den Referenzbild-Ansatz wählt)
| Methode | Wie die Identität verankert wird | Geeignet für |
|---|---|---|
| Charakter-Sheet (Text) | Ein dichter, wiederverwendbarer Prompt-Präfix, der Gesicht, Frisur und Garderobe beschreibt und an jedes Rendering angehängt wird. Kein Ausgangsbild. | Du erfindest eine Figur von Grund auf und möchtest sie mit versionierbarem Text definieren. |
| Referenzbild (diese Anleitung) | Ein Basisporträt wird als image_input zurückgesendet; der Prompt ändert nur die Szene. |
Du hast bereits ein akzeptiertes Gesicht (Key-Visual-Rendering, Marken-Maskottchen) und möchtest, dass dieses Gesicht überall erscheint. |
Die Charakter-Sheet-Methode wird in Consistent Characters with Nano-Banana vollständig beschrieben – inklusive Storyboards und E-Commerce-Lookbook-Beispielen. Diese Anleitung geht den anderen Weg: ein bestimmtes Porträt mit einem Referenzbild fixieren und es dann auf mehrere Szenen ausweiten und zum Video machen. Beide ergänzen sich; viele Teams schreiben einmal ein Sheet, generieren ein Key-Visual-Porträt und wechseln für den Rest des Shootings in den Referenzbild-Modus.
Schritt 1 – Die Basisfigur generieren
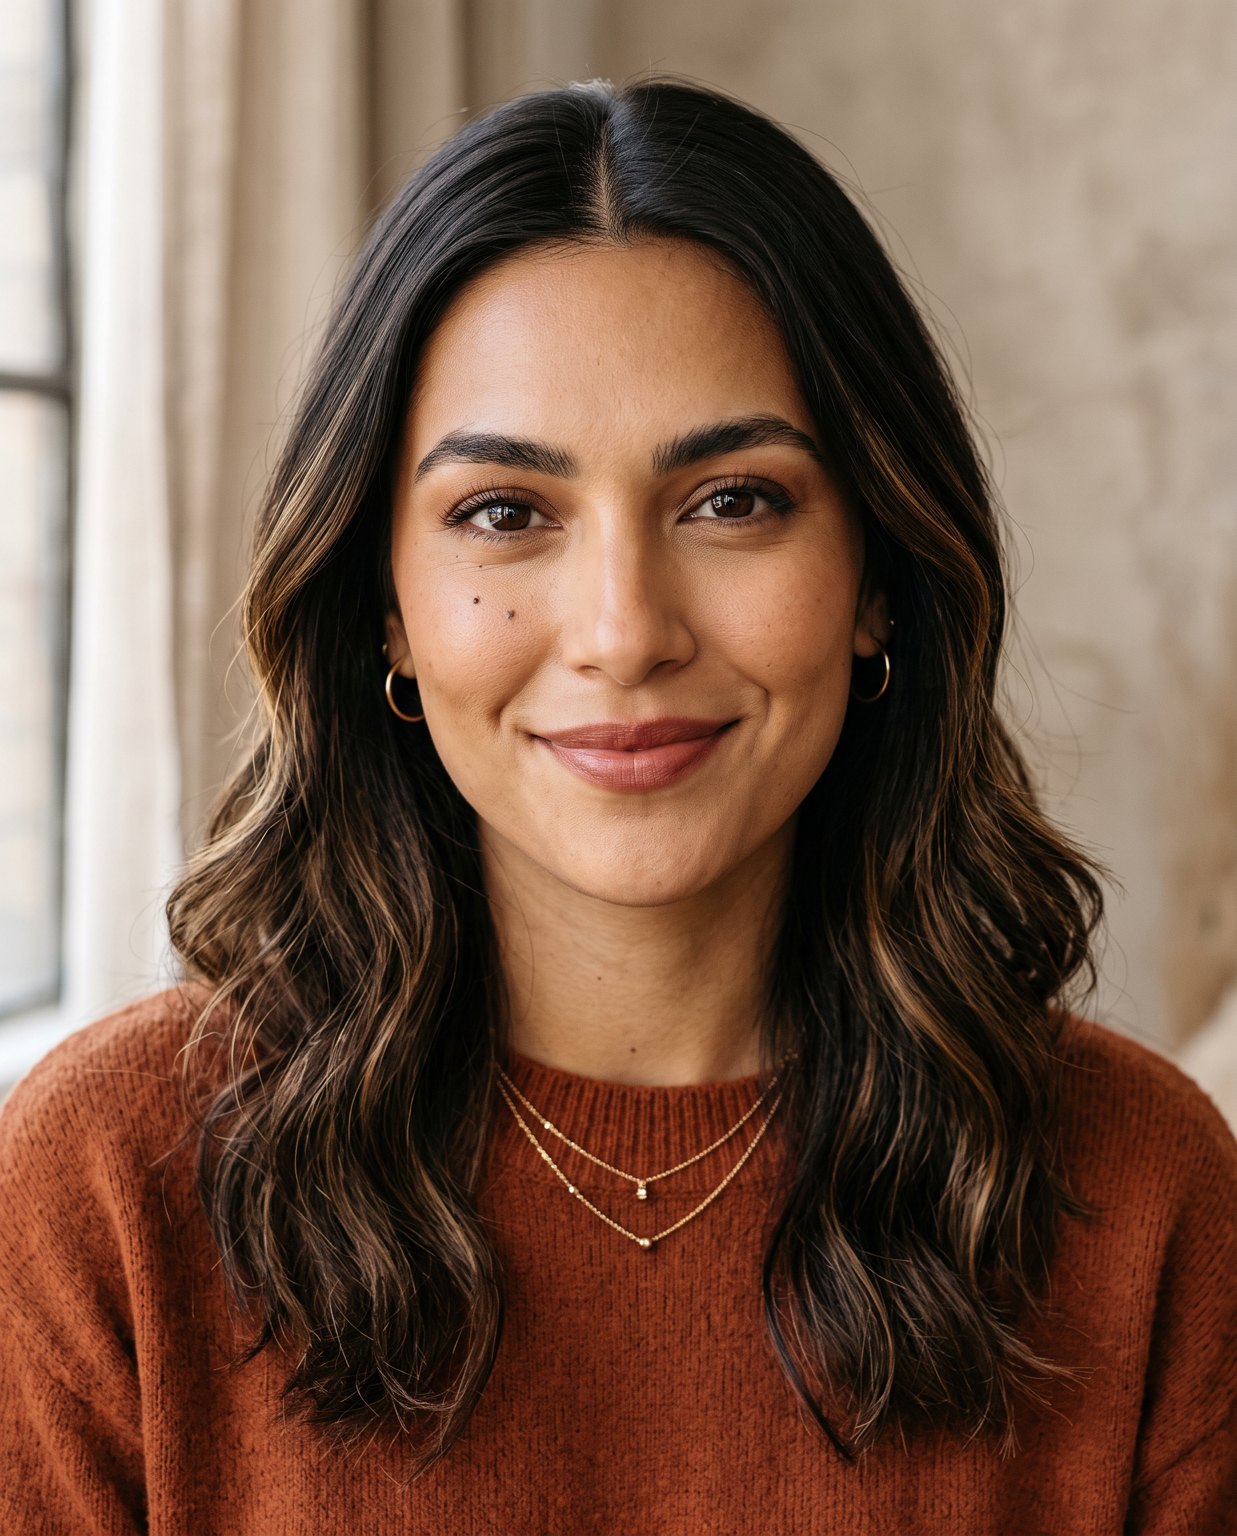
Beginne mit einem sauberen, gut ausgeleuchteten Porträt. Details sind hier dein Freund: Je konkreter die unveränderlichen Merkmale (ein Schönheitsfleck, ein Scheitel, ein Schmuckstück), desto leichter lassen sie sich fortführen.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks gibt eine taskId zurück; polle GET /v1/tasks/{taskId}, bis status gleich success ist, und lade dann output[0].url herunter. Diese URL ist temporär (mit expireAt), also speichere die Bytes sofort – verlinke sie nicht hot. Lade das Porträt an einen erreichbaren Ort hoch (dein eigenes CDN), denn der nächste Schritt braucht es als Eingabe-URL. nano-banana-2 kostet bei 1K / 2K / 4K jeweils $0,036 / $0,057 / $0,086; das Shooting hier verwendete 2K.
Schritt 2 – Identität über Szenen hinweg fixieren
Dies ist der entscheidende Schritt, der daraus einen Influencer macht und keine Galerie von Fremden. Sende das Basisporträt als image_input zurück und schreibe einen Prompt, der ausdrücklich diese Person beibehält und nur die neue Szene beschreibt.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
Das entscheidende Feld ist image_input – ein Array von Referenz-URLs. Unten wird dasselbe Basisporträt in drei unzusammenhängende Umgebungen gesetzt, wobei jedes Rendering an dieses eine Porträt verankert ist:
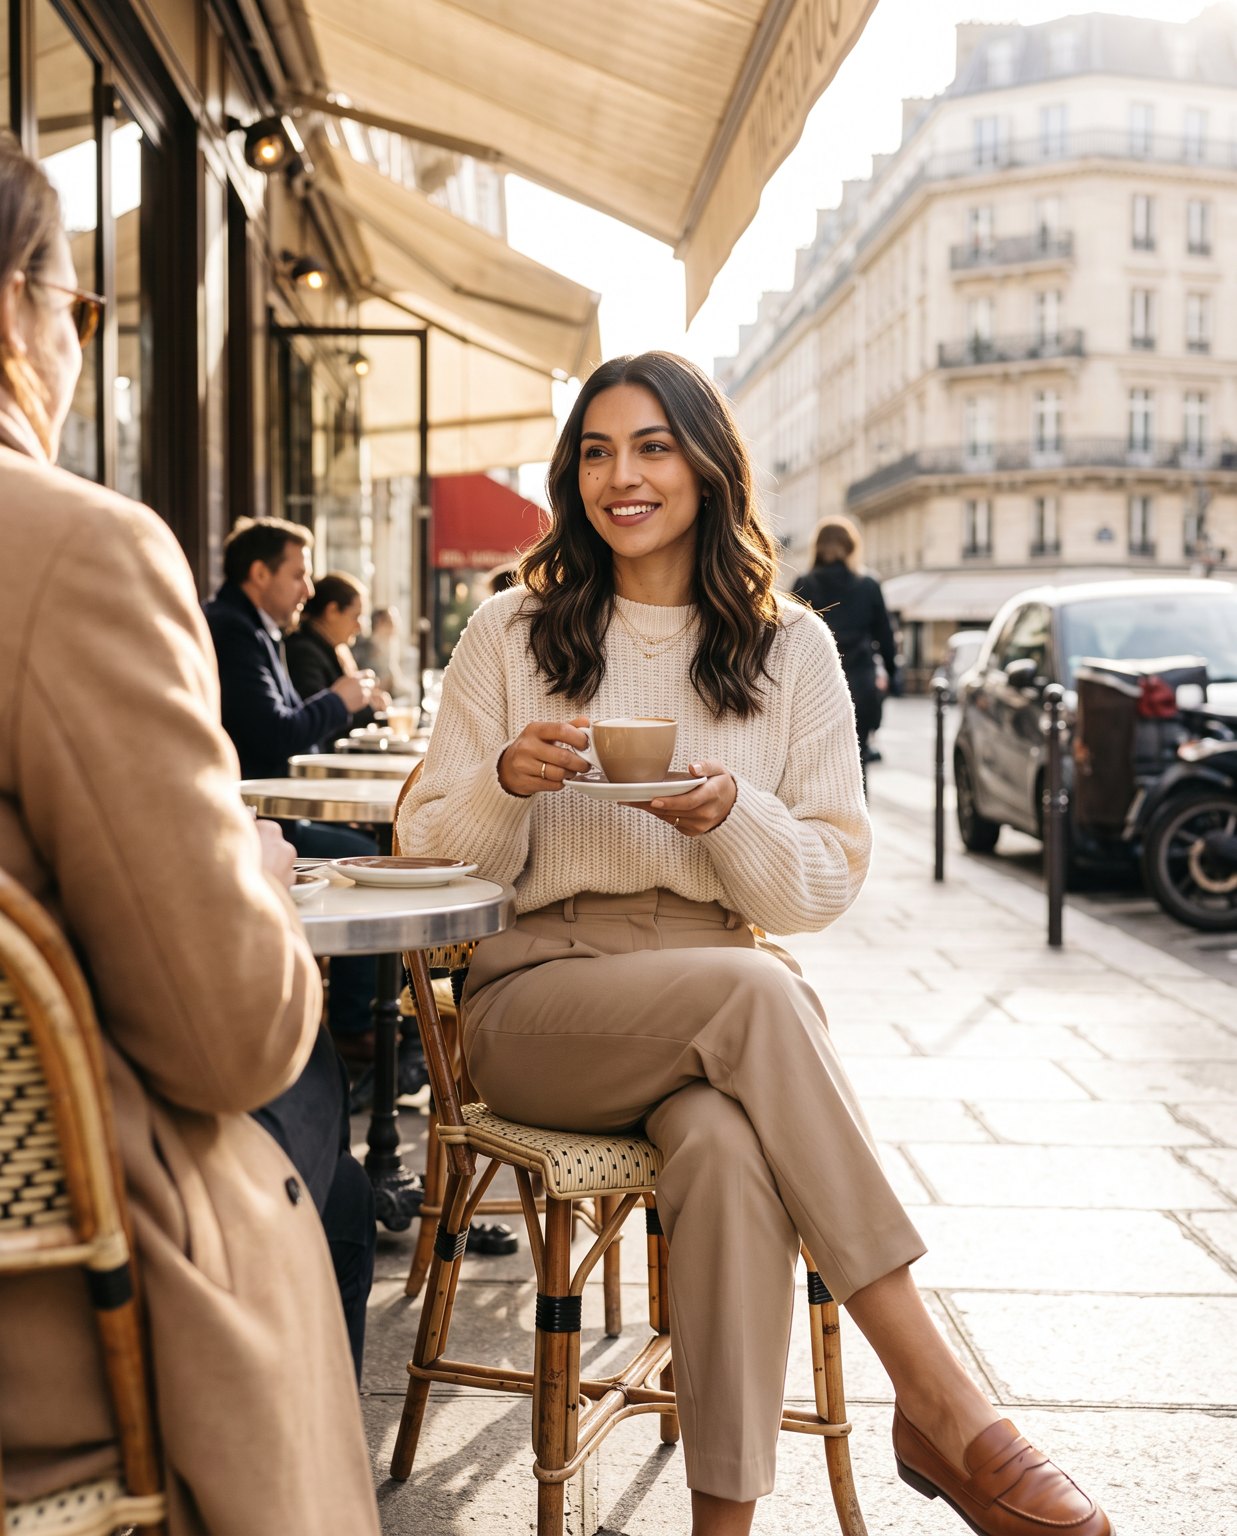
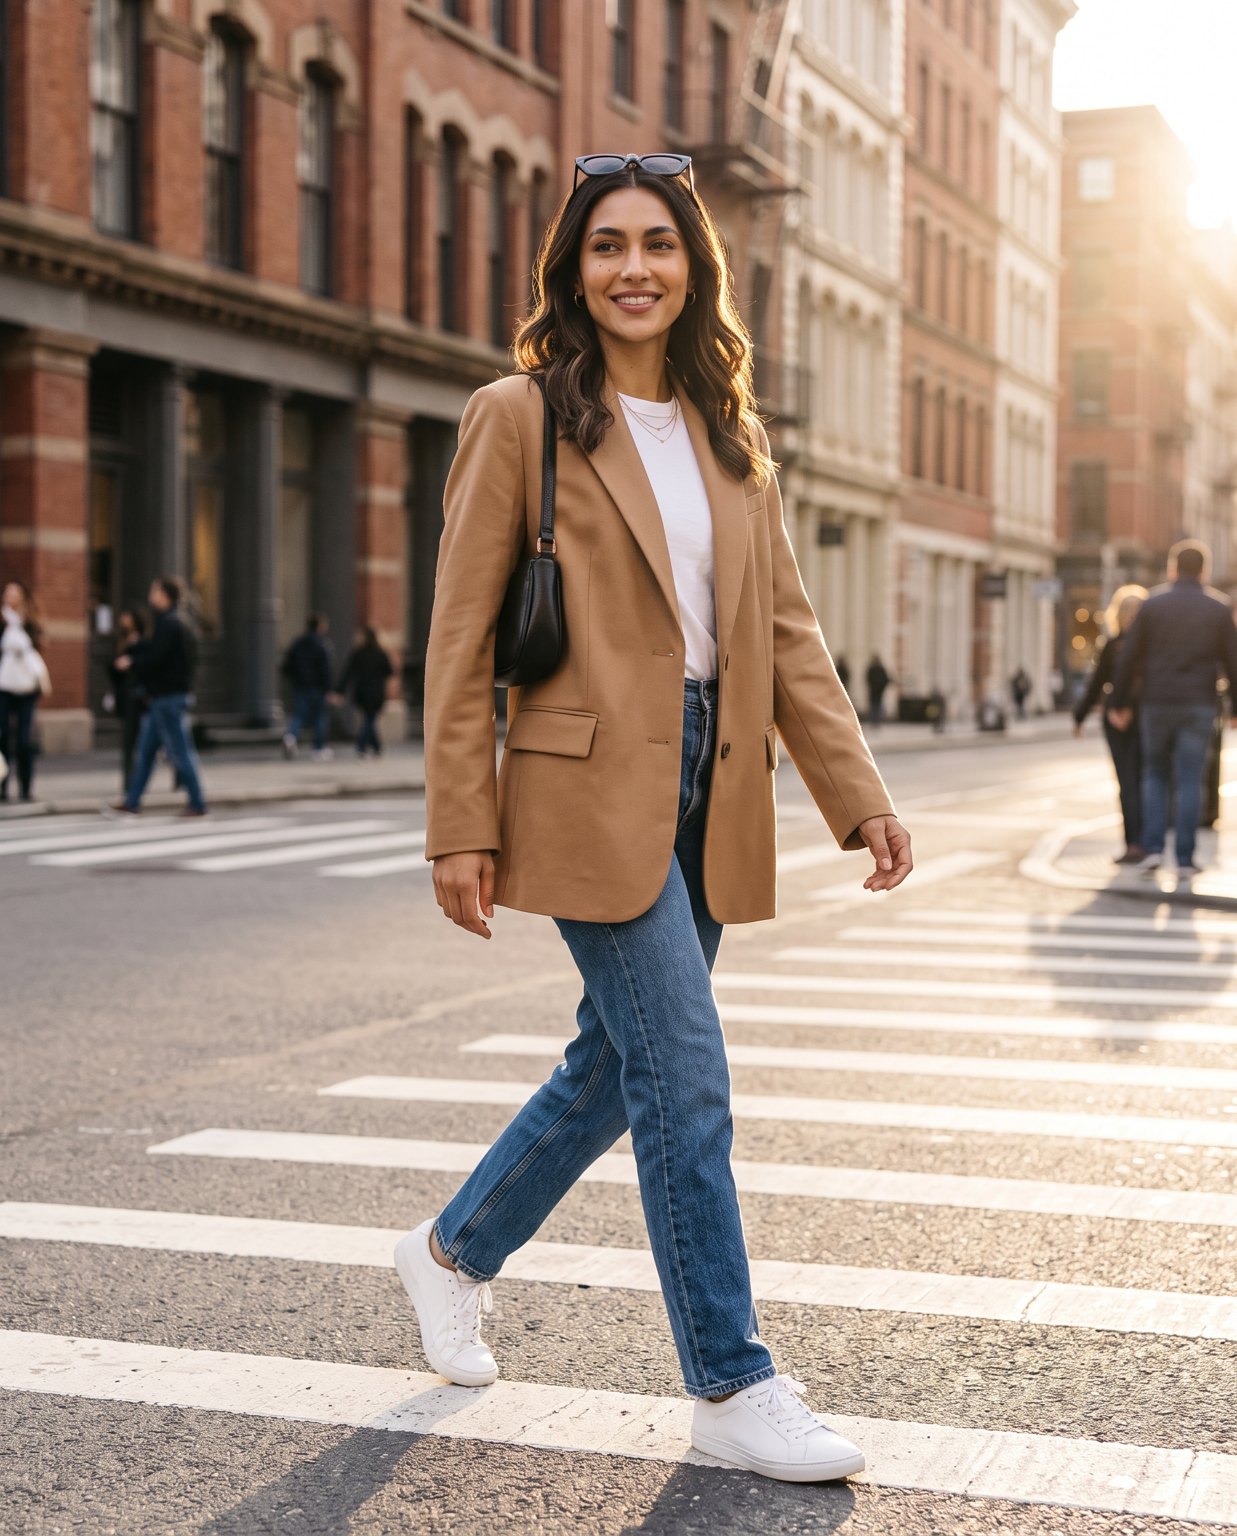
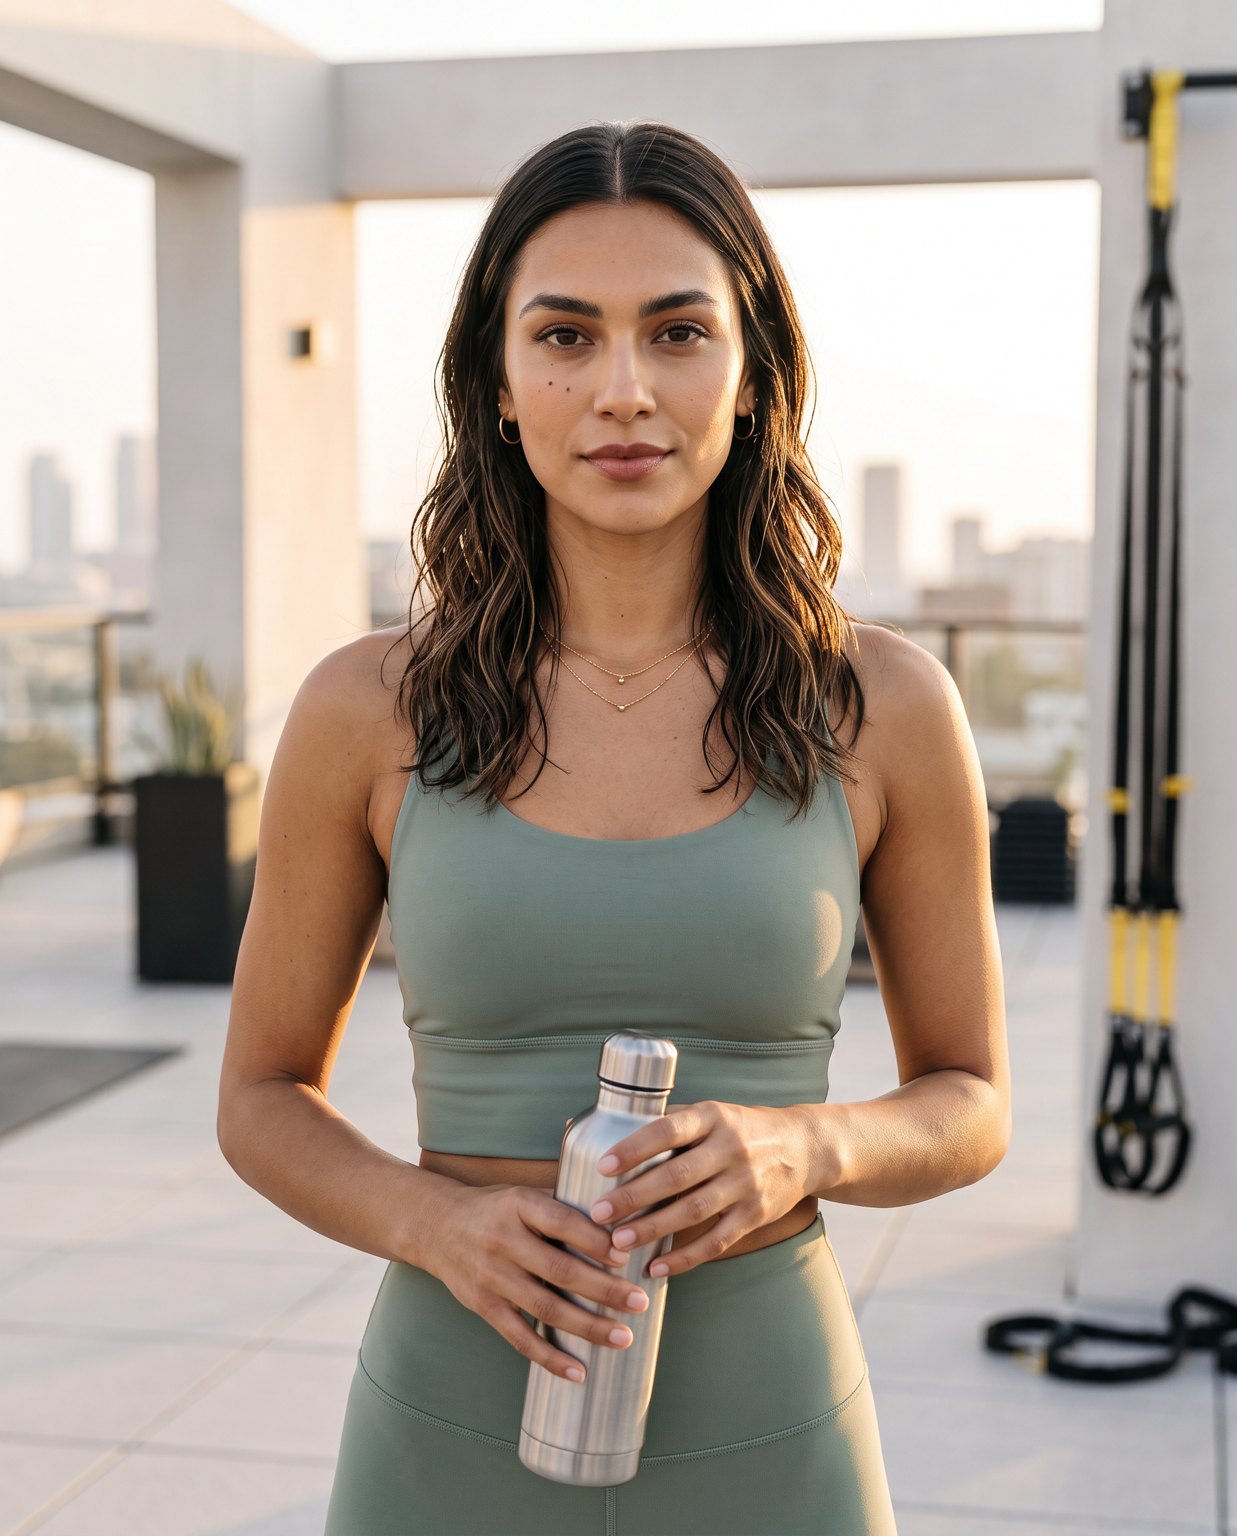
Was in diesem Lauf tatsächlich erhalten blieb: In den drei Renderings Café, Straße und Gym bleiben Gesichtsgeometrie, Hautton, die welligen Haare mit Karamell-Strähnen, die goldenen Ohrringe und die dünne geschichtete Halskette als dieselbe erkennbare Person erhalten. Einzige Einschränkung sind Mikrodetails – die genaue Position des Schönheitsflecks oder einer einzelnen Haarsträhne driftet zuerst. Die wirksame Korrektur besteht darin, jedes Rendering am einen ursprünglichen Porträt zu verankern statt zu verketten (Ausgabe von Szene A als Eingabe für Szene B). Verkettung lässt kleine Drifts akkumulieren; ein einzelner fixer Anker nicht.
Schritt 3 – Standbilder in eine Reel verwandeln
Der Feed braucht Bewegung. Nimm ein beliebiges fixiertes Standbild und schicke es an ein Bild-zu-Video-Modell. Der Clip unten ist das Café-Foto von oben, tatsächlich animiert mit grok-imagine-1.5/image-to-video:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Beachte das andere Eingabefeld: Videomodelle verwenden image_urls (plus duration in Sekunden) statt image_input. Der Testclip wurde in 480p, Hochformat, 5 Sekunden zurückgegeben – sie hebt wie angewiesen die Tasse und nimmt einen Schluck, und das Gesicht bleibt in der Bewegung dieselbe Person. Bei $0,015/s kostet diese Reel rund $0,075. Wenn du eine schärfere Ausgabe möchtest, kann dasselbe Standbild direkt an veo-3.1-lite, kling-3.0 oder hailuo-2.3 übergeben werden – siehe Tabelle unten.
Batch-Verarbeitung: Eine Referenz, mehrere Szenen
Der ganze Sinn eines virtuellen Models ist die Menge. Halte eine Liste von Szenen-Prompts und führe sie in einer Schleife gegen das eine Basisporträt aus:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Ersetze den Model-String, und du kannst dieselbe Schleife auf jedem Bildmodell ausführen, das Referenzbilder unterstützt, oder die fertigen Standbilder in die Videoschleife einspeisen.
Optionale Modelle für die Identitätsfixierungsstufe
Preise sind die aktuellen Preise pro Bild aus /api/pricing zum Zeitpunkt der Erstellung; prüfe sie vor großen Batches unbedingt erneut.
| Modell | Referenz-Eingabe | Preis (USD) | Anmerkungen |
|---|---|---|---|
| nano-banana-2 | image_input |
$0,036 / $0,057 / $0,086 (1K/2K/4K) | In diesem Artikel verwendet; starke Gesichtskontinuität, 4K-Unterstützung |
| nano-banana-pro | image_input |
$0,057 (1K und 2K) / $0,10 (4K) | Erweiterte Version derselben Serie |
gpt-image-2 /image-to-image@ext |
Bis zu 16 Referenzbilder | Ab $0,007 (niedrige Qualität, 1K) | Günstigster Multi-Referenz-Weg, 4K-Ausgabe |
flux-2 /image-to-image |
Multi-Referenz | $0,035 (1K) / $0,05 (2K) | Hochpräzise Multi-Referenz-Bearbeitung |
seedream-5.0-pro /image-to-image |
Multi-Referenz | $0,06 (1K) / $0,10 (2K) | Multi-Referenz in Flaggschiff-Qualität |
Durchstöbere den vollständigen Katalog im Modell-Marktplatz. Für ein einzelnes festes Gesicht reicht ein Referenzbild; der 16-Referenzbild-Weg von gpt-image-2 glänzt, wenn du Gesicht, Kleidung und Produkt in einem Rendering verschmelzen willst.
Optionale Modelle für die Videostufe
Die Abrechnungsmodelle unterscheiden sich – die meisten rechnen pro Sekunde ab, hailuo jedoch zu einem Pauschalpreis pro fester Clip-Länge. Beachte diesen Unterschied bei der Batch-Planung.
| Modell | Abrechnung | Beispielkosten | Anmerkungen |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
Pro Sekunde | $0,015/s (480p), $0,0282/s (720p) | In diesem Artikel verwendet; am günstigsten, 1–15 Sekunden |
veo-3.1-lite /image-to-video |
Pro Sekunde | $0,06/s (720p, ohne Audio) → $0,14/s (1080p) | Gutes Gleichgewicht zwischen Qualität und Kosten |
kling-3.0 /image-to-video |
Pro Sekunde | $0,10/s (720p) → $0,129/s (1080p); mit Audio teurer | Natives Audio, bis zu 4K |
hailuo-2.3-fast /image-to-video |
Pro Clip | $0,27 (6s) / $0,46 (10s) | Pauschalpreis nach festen Längenstufen |
wan2.7-video /image-to-video |
Pro Sekunde | $0,10/s (720P) / $0,167/s (1080P) | Vom ersten Frame gesteuert |
veo-3.1 /image-to-video |
Pro Sekunde | Mit Audio $0,57/s → $0,86/s (4K) | Filmreife Klasse; ein 5-Sekunden-Clip kostet rund $2,85, also Dauer begrenzen |
Somit kostet eine 5-Sekunden-Reel zwischen rund $0,075 mit grok-imagine-1.5 und rund $2,85 mit vollem veo-3.1 – ein Unterschied von Faktor 38. Prototypisiere zuerst in der günstigen Stufe und upgrade nur die Clips, die du wirklich veröffentlichst.
Konsistenz-Tricks, die wirklich funktionieren
- Ankern, nicht verketten. Sende das ursprüngliche Basisporträt in jedes Rendering. Die vorherige Ausgabe als nächste Eingabe zu verwenden lässt kleine Drifts akkumulieren, bis das Gesicht zu einem Cousin wird statt derselben Person.
- Schreibe unveränderliche Merkmale in den Prompt. „Derselbe Schönheitsfleck unter dem linken Auge, dieselben goldenen Ohrringe“ ist nützlicher als „dieselbe Frau“. Du sagst dem Modell, was es nicht ändern darf.
- Halte ein Seitenverhältnis pro Kanal. 4:5 für das Feed-Raster, 9:16 für Reels. Ein Wechsel mitten im Shooting erzwingt unangenehme Neuzuschnitte, die das Gesicht abschneiden können.
- Lege die Auflösung passend zur Modellstufe fest.
nano-banana-2akzeptiert1K/2K/4K; setze sie explizit, damit die Batch-Verarbeitung nicht stillschweigend Größen mischt. - Bewahre das stärkste Porträt als dauerhaftes Asset auf. Das ist dein „Casting“ – verwende es über Monate hinweg wieder, statt für jede Kampagne ein neues Gesicht zu generieren.
Kosten dieses Artikels
| Posten | Modell | Menge | Stückpreis | Zwischensumme |
|---|---|---|---|---|
| Basisporträt + 3 Szenenrenderings | nano-banana-2 (2K) | 4 | $0,057 | $0,228 |
| Café-Reel | grok-imagine-1.5 (480p, 5s) | 1 | $0,015/s | $0,075 |
| Gesamt | ca. $0,30 |
Ein vollständiges Raster mit 30 Posts plus ein paar Reels kostet nur einen niedrigen einstelligen Dollar-Betrag – das ist der eigentliche Grund, warum Teams Generatoren statt Shootings wählen.
FAQ
Ist das Gesicht jedes Mal garantiert identisch? Kein Modell garantiert ein pixelgenau identisches Gesicht, aber in diesem Test hielt die Referenzbild-Verankerung auf nano-banana-2 in drei sehr unterschiedlichen Szenen dieselbe erkennbare Person. Betrachte gelegentliche Ausreißer als Grund, ein paar mehr Bilder zu generieren und auszuwählen, nicht als Grund für ein neues Shooting.
Kann ich das Gesicht einer echten Person fixieren? Nur das Gesicht von Personen, an denen du die Rechte hast – du selbst, eine einwilligende Model oder ein gebuchter Markenbotschafter. Klone keine Fremden oder Prominenten.
Brauche ich Fine-Tuning oder LoRA? Nein. Der gesamte Workflow ist zero-training – ein Referenzbild plus ein Prompt. Genau deshalb bleiben die Kosten pro Bild im Cent-Bereich.
Mit welchem Modell sollte ich anfangen? Beginne bei der Identitätsfixierung mit nano-banana-2 und bei der Videostufe mit grok-imagine-1.5. Beide sind günstig genug, um frei zu iterieren; upgrade erst, wenn der Stil steht.
Jetzt loslegen
Generiere ein Porträt auf nano-banana-2, sende es als image_input an jede Szene zurück und animiere deinen Lieblingsframe mit einem Bild-zu-Video-Modell – alles über POST /v1/tasks mit einem einzigen Schlüssel. Die Quickstart-Dokumentation erklärt Authentifizierung und Polling, und auf der Preisseite kannst du jedes Bild- und Videomodell vergleichen, bevor du die Batch-Verarbeitung skalierst.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte