
Guide d'utilisation
Générateur de mannequin Instagram IA : créez des influenceurs virtuels cohérents sur hiapi
Verrouillez un même visage avec une image de référence, générez plusieurs scènes en lot, puis transformez-les en Reels — le tout via /v1/tasks de hiapi.
TL;DR
- Le générateur de mannequin Instagram IA est essentiellement un pipeline en trois étapes : créez un personnage, verrouillez ce visage pour qu'il réapparaisse dans chaque prise de vue, puis convertissez les meilleures images fixes en courtes vidéos. hiapi exécute les trois étapes via une seule interface asynchrone
POST /v1/tasks. - Ce guide utilise la voie de l'image de référence pour verrouiller l'identité — vous renvoyez un portrait de base comme
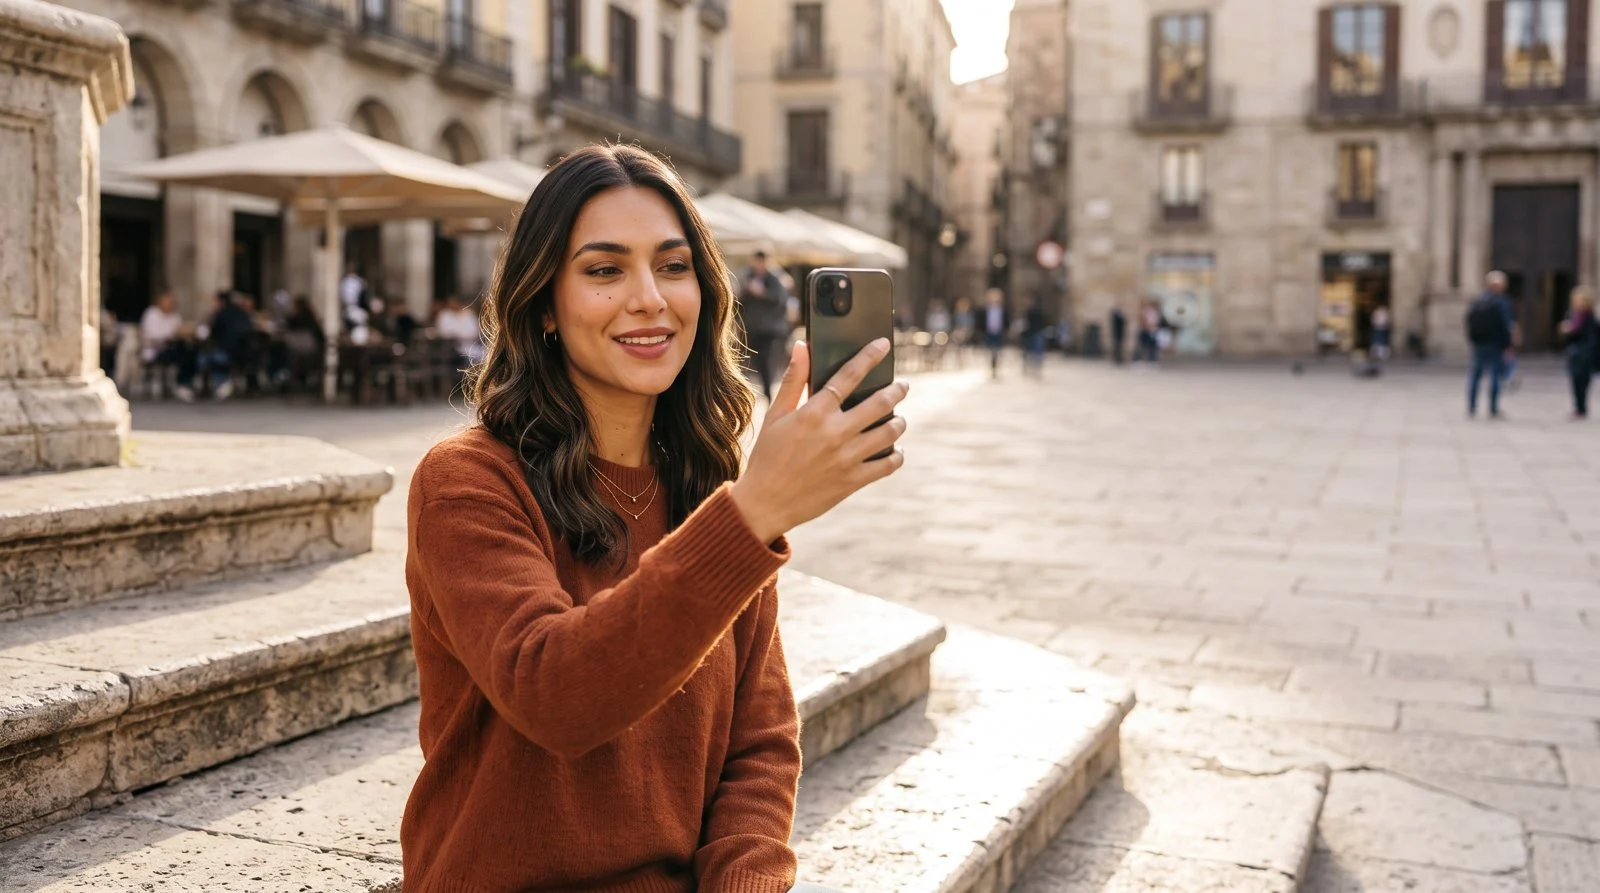
image_inputet ne changez que la scène. Cela diffère de la méthode purement textuelle du « kit de personnage » présentée dans Consistent Characters with Nano-Banana ; utilisez cette dernière quand vous n'avez pas encore d'image de départ, et celle-ci quand vous voulez fixer un visage. - Testé ici sur nano-banana-2 : un portrait de base a ancré trois scènes totalement différentes — un café parisien, un passage piéton urbain et une salle de sport sur le toit — avec le visage, la coiffure, le teint, les boucles d'oreilles dorées et les colliers superposés restés cohérents dans toutes les scènes.
- L'étape vidéo est réelle, pas une simulation : l'image fixe du café ci-dessous a été transformée en un court métrage de 5 secondes avec
grok-imagine-1.5/image-to-video. Elle lève sa tasse et boit une gorgée ; l'identité tient même en mouvement. - Budget total de cet article : environ 0,30 $ — quatre images 2K générées sur nano-banana-2 à 0,057 $ chacune (0,228 $), plus un Reel 480p/5s facturé 0,015 $/s (0,075 $).
Ce que vous construisez réellement
« Influenceur virtuel », « mannequin UGC IA », « générateur de mannequin Instagram IA » — les appellations marketing varient, mais l'implémentation technique repose toujours sur les mêmes trois étapes :
- Personnage — générez (ou choisissez) un portrait de base qui servira de visage canonique à votre mannequin.
- Verrouillage d'identité — faites apparaître la même personne dans diverses tenues, poses et lieux, pour que le fil ressemble à un seul créateur plutôt qu'à quarante personnes différentes.
- Animation — transformez l'image fixe la plus marquante en une courte vidéo Reels / Shorts qui fait s'arrêter le défilement.
La difficulté est à l'étape 2. Tout ce qui suit — une grille de fil crédible, l'essayage de produits, les publications de marque — s'effondre dès que le visage dérive. Sur hiapi, deux méthodes permettent de le stabiliser.
Deux méthodes pour verrouiller un visage (et pourquoi ce guide choisit la voie de l'image de référence)
| Méthode | Comment l'identité est ancrée | Quand l'utiliser |
|---|---|---|
| Kit de personnage (texte) | Un préfixe de prompt dense et réutilisable décrivant le visage, la coiffure et la garde-robe, concaténé à chaque rendu. Aucune image de départ. | Vous inventez un personnage de zéro et souhaitez le définir par un texte versionnable. |
| Image de référence (ce guide) | Renvoyez un portrait de base comme image_input ; le prompt ne change que la scène. |
Vous avez déjà un visage validé (un rendu key visual, une mascotte de marque) et voulez que ce visage apparaisse partout. |
La méthode du kit de personnage est décrite en détail dans Consistent Characters with Nano-Banana — avec storyboards et exemples de lookbooks e-commerce. Ce guide emprunte l'autre chemin : verrouiller un portrait précis à l'aide d'une image de référence, puis l'étendre à plusieurs scènes et le transformer en vidéo. Les deux sont complémentaires ; beaucoup d'équipes rédigent d'abord un kit une fois, génèrent un portrait key visual, puis passent en mode image de référence pour le reste du tournage.
Étape 1 — Générer le personnage de base
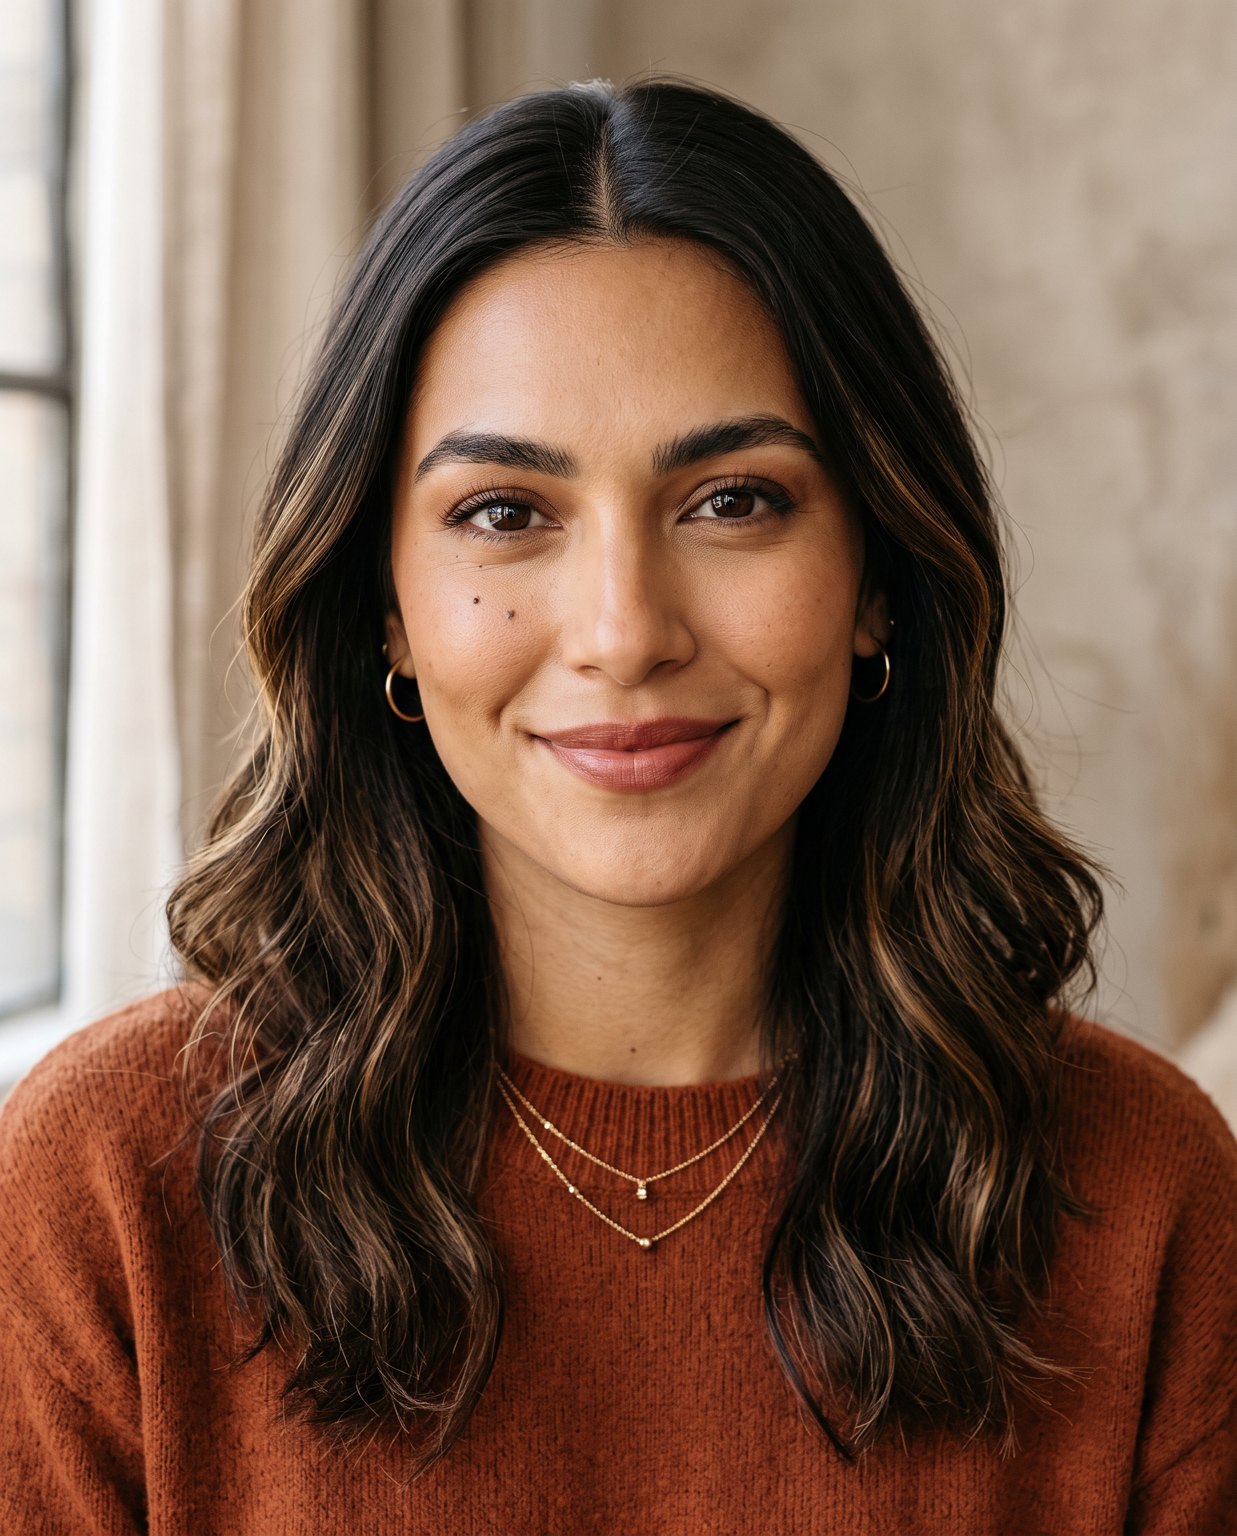
Partez d'un portrait net et bien éclairé. Le détail est votre allié ici : plus les traits invariants sont précis (un grain de beauté, une raie, un bijou), plus il sera facile de les perpétuer.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks renvoie un taskId ; interrogez GET /v1/tasks/{taskId} jusqu'à ce que status passe à success, puis téléchargez output[0].url. Cette URL est temporaire (elle porte un expireAt), donc sauvegardez les octets immédiatement — ne la liez pas en hotlink. Hébergez le portrait à un emplacement accessible (votre propre CDN), car l'étape suivante en a besoin comme URL d'entrée. nano-banana-2 est facturé 0,036 $ / 0,057 $ / 0,086 $ en 1K / 2K / 4K ; le tournage ici a utilisé le 2K.
Étape 2 — Verrouiller l'identité entre les scènes
C'est l'étape qui en fait une influenceuse et non une galerie d'inconnues. Renvoyez le portrait de base comme image_input, puis rédigez un prompt qui indique explicitement de conserver cette personne et ne décrit que la nouvelle scène.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
Le champ clé est image_input — un tableau d'URL de référence. Ci-dessous, le même portrait de base est placé dans trois environnements sans rapport, chaque rendu étant ancré à ce seul portrait :
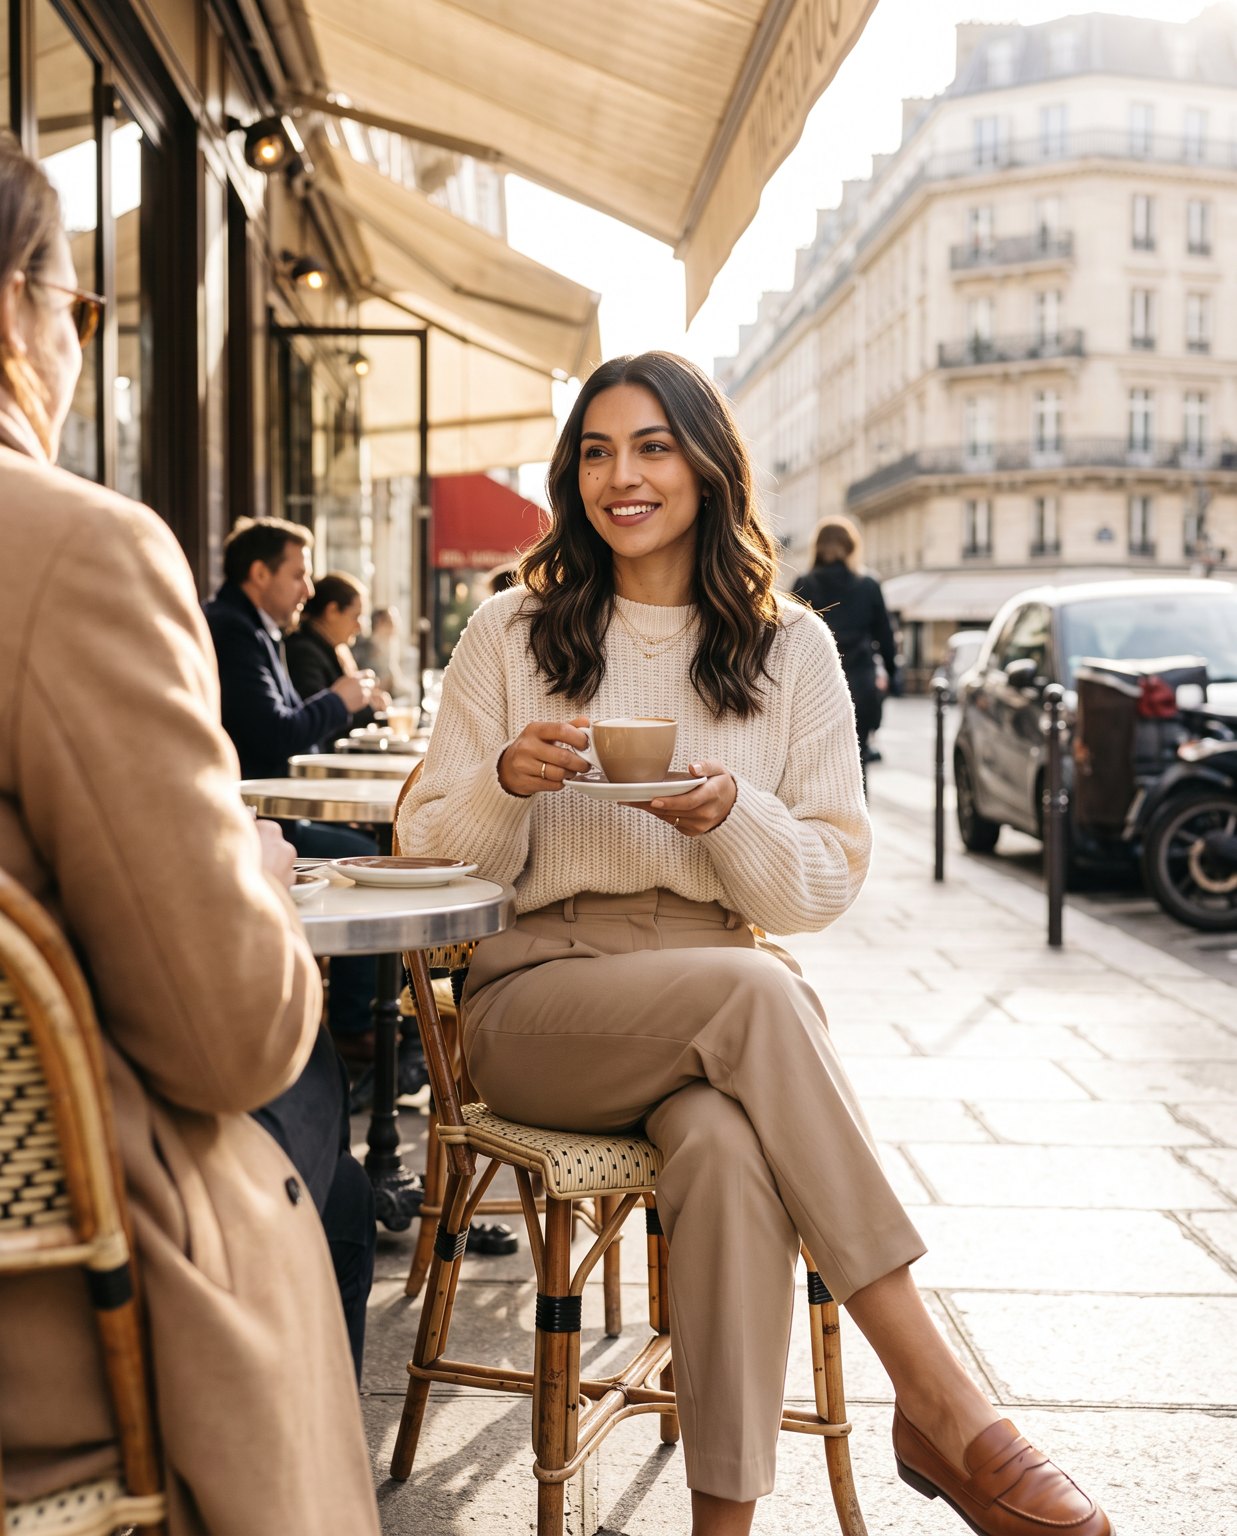
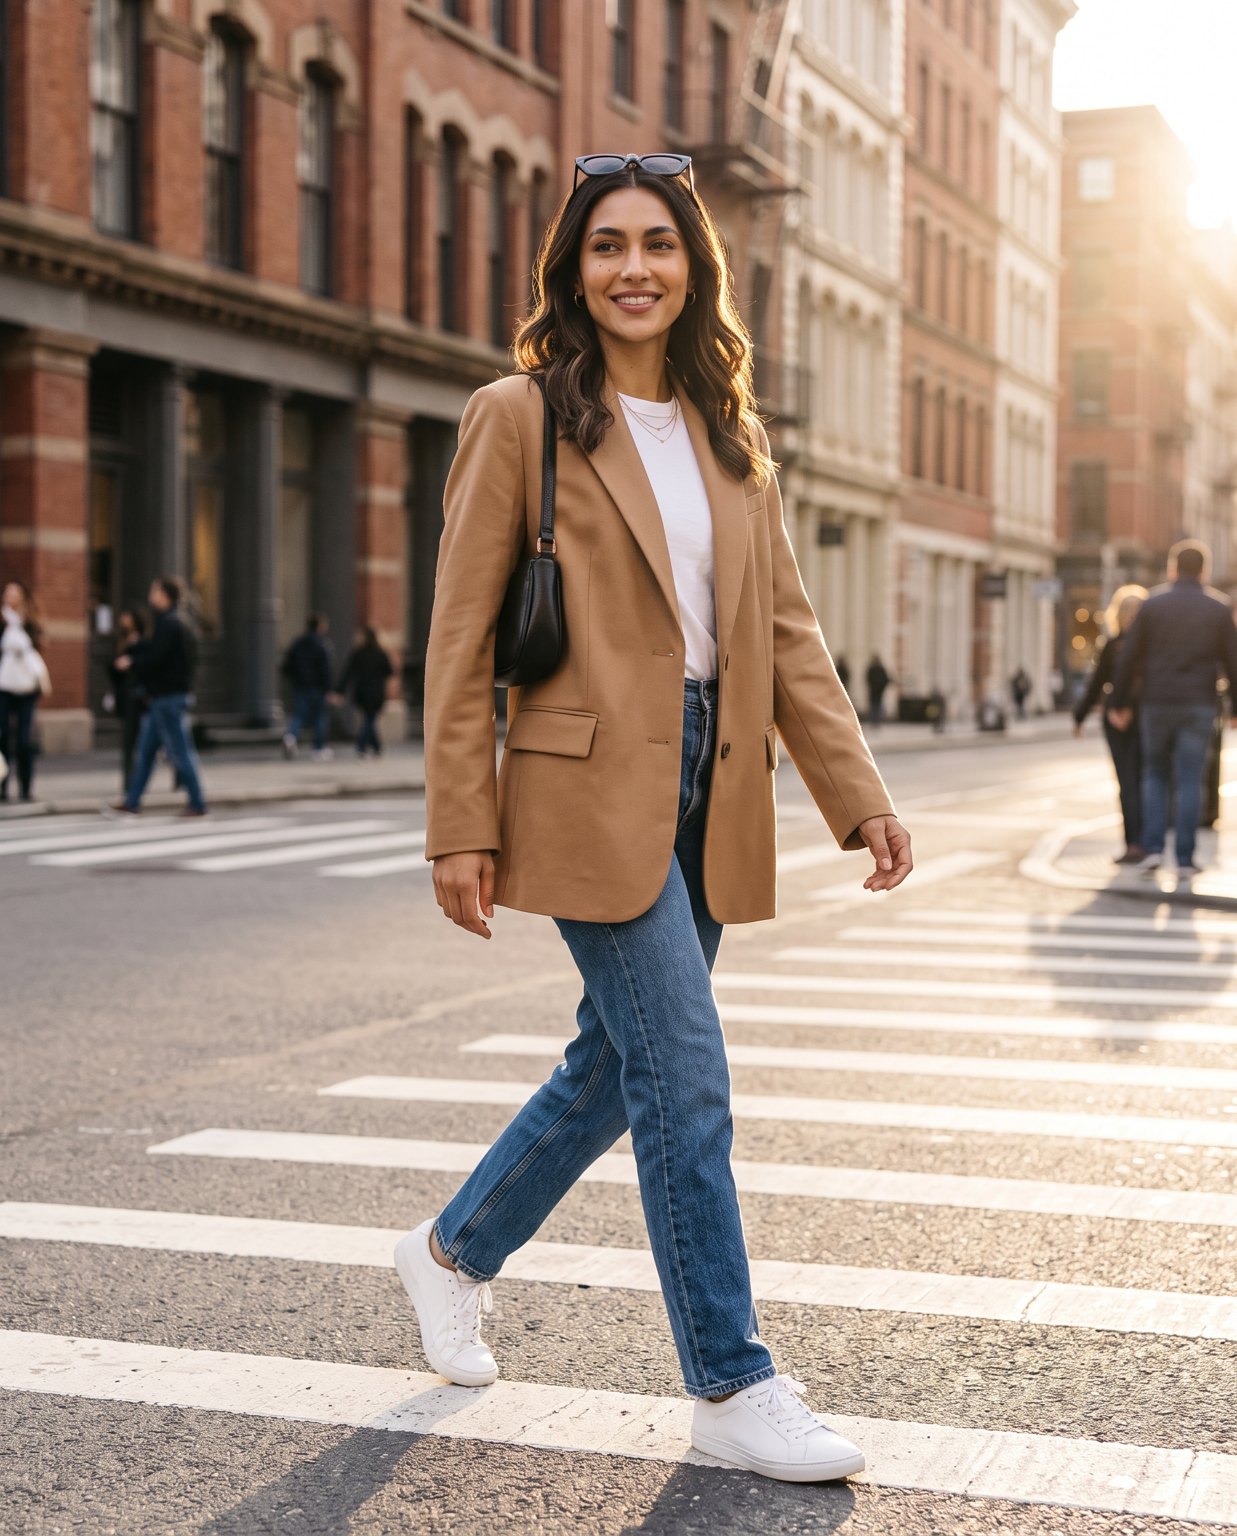
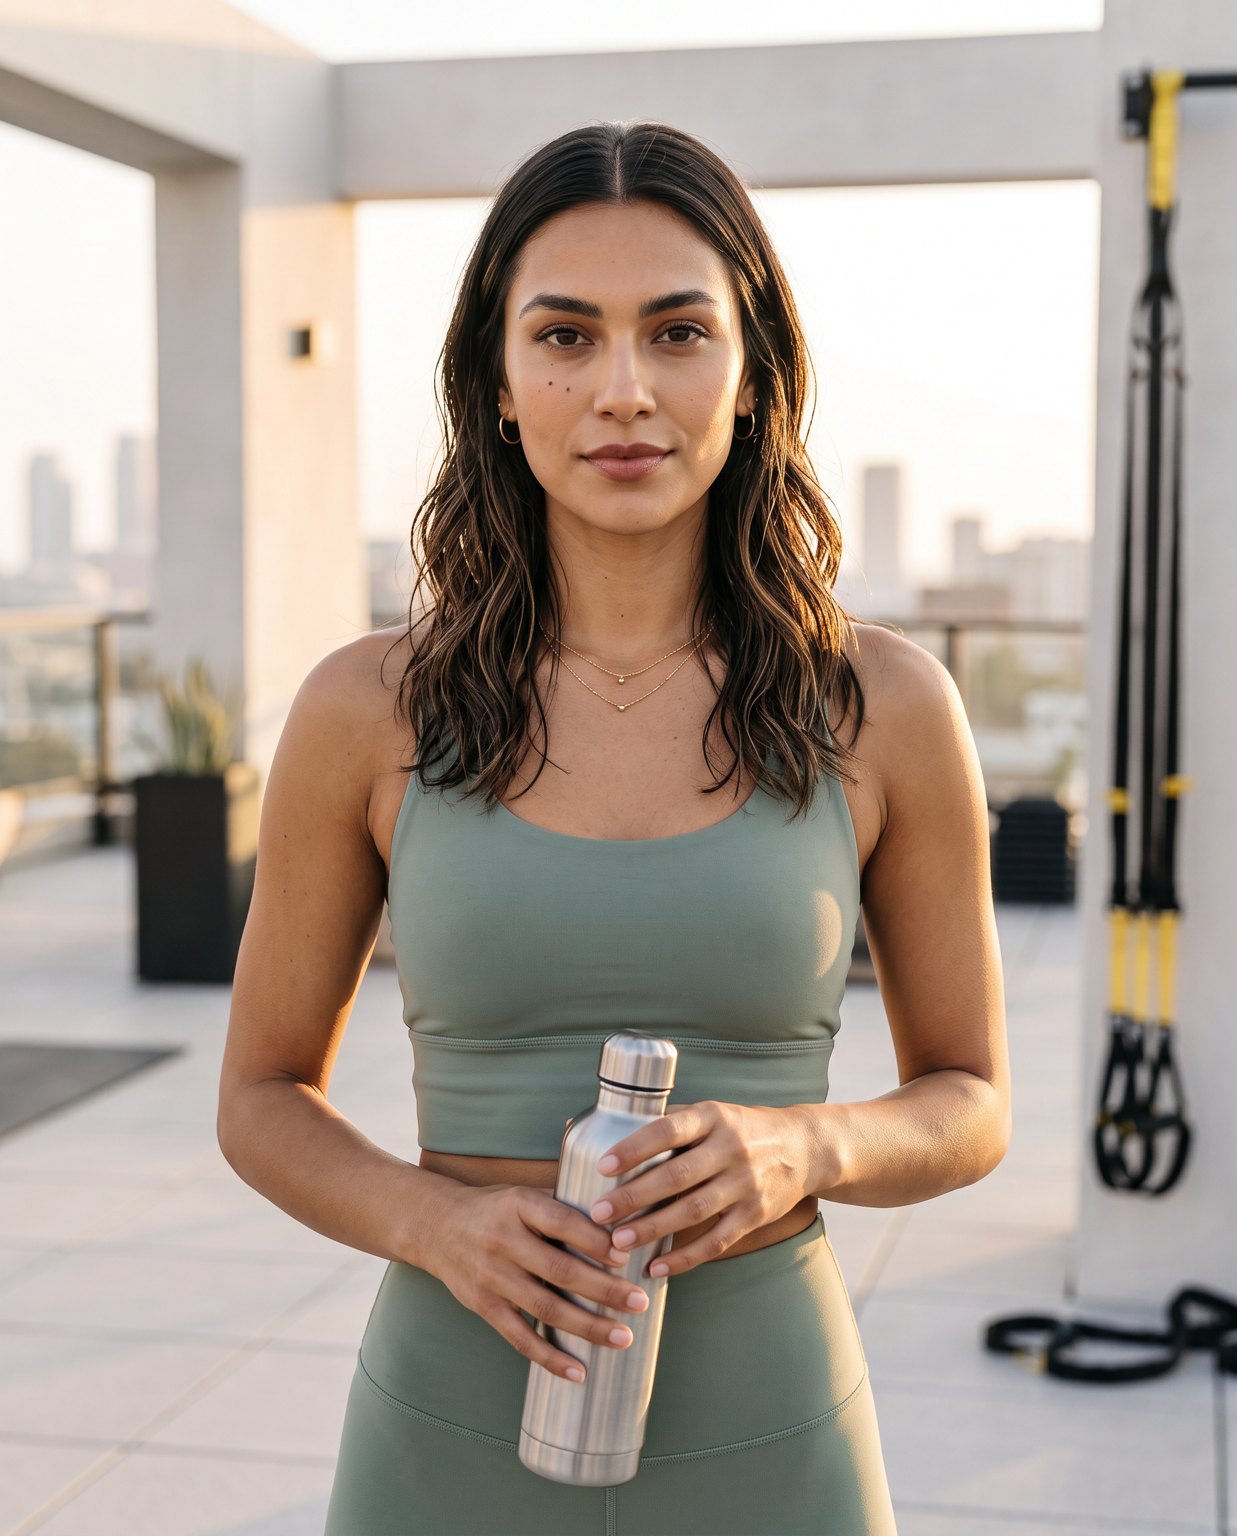
Ce qui a réellement été préservé lors de cette exécution : dans les trois rendus — café, rue et salle de sport — la géométrie du visage, le teint, les cheveux ondulés aux reflets caramel, les boucles d'oreilles dorées et le fin collier superposé restent ceux d'une même personne reconnaissable. La seule réserve concerne les micro-détails — la position exacte d'un grain de beauté ou d'une mèche est ce qui dérive en premier. La correction efficace consiste à ancrer chaque rendu au même portrait d'origine, et non à faire du chaînage (utiliser la sortie de la scène A comme entrée de la scène B). Le chaînage laisse les petites dérives s'accumuler ; un point d'ancrage fixe et unique non.
Étape 3 — Transformer les images fixes en Reel
Un fil a besoin de mouvement. Prenez n'importe quelle image fixe verrouillée, envoyez-la à un modèle image-vers-vidéo. Le court métrage ci-dessous est la photo du café ci-dessus, réellement animée avec grok-imagine-1.5/image-to-video :
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Remarquez les champs d'entrée différents ici : les modèles vidéo utilisent image_urls (plus duration en secondes) plutôt que image_input. Le clip de test est revenu en 480p, vertical, 5 secondes — elle lève sa tasse et boit une gorgée comme demandé, et son visage reste celui de la même personne en mouvement. À 0,015 $/s, ce Reel coûte environ 0,075 $. Si vous voulez une sortie plus nette, la même image fixe peut aller directement dans veo-3.1-lite, kling-3.0 ou hailuo-2.3 — voir le tableau ci-dessous.
Traitement en lot : une référence, plusieurs scènes
Tout l'intérêt d'un mannequin virtuel, c'est le volume. Gardez une liste de prompts de scènes et faites-la tourner en boucle sur un seul portrait de base :
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Changez la chaîne de modèle et vous pouvez exécuter la même boucle sur n'importe quel modèle d'image prenant en charge les images de référence, ou envoyer les images fixes terminées dans la boucle vidéo.
Modèles disponibles pour l'étape de verrouillage d'identité
Les prix sont les tarifs par image actuels de /api/pricing au moment de la rédaction ; revérifiez-les avant tout gros lot.
| Modèle | Entrée de référence | Prix (USD) | Remarques |
|---|---|---|---|
| nano-banana-2 | image_input |
0,036 $ / 0,057 $ / 0,086 $ (1K/2K/4K) | Utilisé dans cet article ; forte continuité du visage, prend en charge le 4K |
| nano-banana-pro | image_input |
0,057 $ (1K et 2K) / 0,10 $ (4K) | Version haut de gamme de la même série |
gpt-image-2 /image-to-image@ext |
Jusqu'à 16 images de référence | À partir de 0,007 $ (basse qualité, 1K) | La voie multi-référence la moins chère, sortie 4K |
flux-2 /image-to-image |
Multi-référence | 0,035 $ (1K) / 0,05 $ (2K) | Édition multi-référence haute fidélité |
seedream-5.0-pro /image-to-image |
Multi-référence | 0,06 $ (1K) / 0,10 $ (2K) | Multi-référence de qualité phare |
Parcourez la gamme complète sur la place de marché des modèles. Pour un visage fixe unique, une seule image de référence suffit ; la voie à 16 images de référence de gpt-image-2 brille quand vous voulez fusionner visage, vêtement et produit en un seul rendu.
Modèles disponibles pour l'étape vidéo
Les modèles de facturation diffèrent — la plupart facturent à la seconde, mais hailuo facture à l'unité pour une durée de clip fixe. Tenez compte de cette différence pour vos budgets en lot.
| Modèle | Mode de facturation | Exemple de coût | Remarques |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
À la seconde | 0,015 $/s (480p), 0,0282 $/s (720p) | Utilisé dans cet article ; le moins cher, 1–15 secondes |
veo-3.1-lite /image-to-video |
À la seconde | 0,06 $/s (720p, sans audio) → 0,14 $/s (1080p) | Bon équilibre qualité/coût |
kling-3.0 /image-to-video |
À la seconde | 0,10 $/s (720p) → 0,129 $/s (1080p) ; plus cher avec audio | Audio natif, jusqu'à 4K |
hailuo-2.3-fast /image-to-video |
Par clip | 0,27 $ (6s) / 0,46 $ (10s) | Tarif forfaitaire par palier de durée fixe |
wan2.7-video /image-to-video |
À la seconde | 0,10 $/s (720P) / 0,167 $/s (1080P) | Piloté par la première image |
veo-3.1 /image-to-video |
À la seconde | Avec audio 0,57 $/s → 0,86 $/s (4K) | Niveau cinéma ; un clip de 5 s coûte environ 2,85 $, limitez donc la durée |
Ainsi, un Reel de 5 secondes coûte d'environ 0,075 $ avec grok-imagine-1.5 à environ 2,85 $ avec le veo-3.1 complet — un écart de 38 fois. Prototypez d'abord sur les paliers bon marché et ne montez en gamme que pour les clips que vous publierez vraiment.
Les astuces de cohérence qui fonctionnent vraiment
- Ancrez, ne chaînez pas. Envoyez le portrait de base d'origine à chaque rendu. Utiliser la sortie précédente comme entrée suivante laisse les petites dérives s'accumuler jusqu'à ce que le visage devienne celui d'un cousin plutôt que de la même personne.
- Écrivez les traits invariants dans le prompt. « le même grain de beauté sous l'œil gauche, les mêmes boucles d'oreilles dorées » est plus utile que « la même femme ». Vous dites au modèle ce qu'il n'a pas le droit de changer.
- Gardez un seul ratio d'image par canal. 4:5 pour la grille du fil, 9:16 pour les Reels. Changer en cours de tournage impose des recadrages maladroits qui peuvent couper le visage.
- Verrouillez la résolution sur le palier du modèle.
nano-banana-2accepte1K/2K/4K; définissez-la explicitement pour que le traitement en lot ne mélange pas silencieusement les tailles. - Conservez votre meilleur portrait comme actif permanent. C'est votre « casting » — réutilisez-le pendant des mois, au lieu de régénérer un nouveau visage à chaque campagne.
Dépenses de cet article
| Poste | Modèle | Quantité | Prix unitaire | Sous-total |
|---|---|---|---|---|
| Portrait de base + 3 rendus de scènes | nano-banana-2 (2K) | 4 | 0,057 $ | 0,228 $ |
| Reel du café | grok-imagine-1.5 (480p, 5s) | 1 | 0,015 $/s | 0,075 $ |
| Total | environ 0,30 $ |
Une grille de publication complète de 30 posts plus quelques Reels pour seulement un ou deux dollars — voilà la vraie raison pour laquelle les équipes choisissent un générateur plutôt qu'un tournage.
FAQ
Le visage est-il garanti identique à chaque fois ? Aucun modèle ne garantit un visage identique au pixel près, mais dans ce test, l'ancrage par image de référence sur nano-banana-2 a conservé une même personne reconnaissable dans trois scènes très différentes. Considérez les éventuelles anomalies comme une raison de générer quelques variantes de plus et de faire une sélection, plutôt que de refaire un tournage.
Puis-je verrouiller le visage d'une personne réelle ? Uniquement pour des personnes dont vous détenez les droits — vous-même, un mannequin consentant ou un ambassadeur de marque sous contrat. Ne clonez pas des inconnus ni des célébrités.
Ai-je besoin d'un fine-tuning ou d'un LoRA ? Non. Tout le workflow est sans entraînement — une image de référence et un prompt. C'est précisément ce qui maintient le coût par image à quelques centimes.
Par quel modèle commencer ? Commencez le verrouillage d'identité avec nano-banana-2, et l'étape vidéo avec grok-imagine-1.5. Les deux sont assez bon marché pour itérer librement ; ne montez en gamme qu'une fois le style fixé.
Lancez-vous
Générez un portrait sur nano-banana-2, renvoyez-le comme image_input pour chaque scène, puis animez votre image préférée avec un modèle image-vers-vidéo — le tout avec une seule clé via POST /v1/tasks. La documentation de démarrage rapide couvre l'authentification et l'interrogation, et vous pouvez comparer chaque modèle d'image et de vidéo sur la page de tarification avant de passer à l'échelle en lot.
Articles similaires
Voir tous les articles →-

Guide d'utilisation
Guide de démarrage pour seedream-5.0-pro/image-to-image : capacités, tarification et points d'intégration
Limites de capacité, mode de facturation et pratiques d'intégration technique du modèle d'édition d'image de ByteDance
-

Guide d'utilisation
Guide de prise en main de la génération d'images par texte avec seedream-5.0-pro : limites de capacités, intégration API et maîtrise des coûts
Point de vue pratique pour les développeurs : des points clés des paramètres à l'estimation du coût de 0,05 $ par image
-

Guide d'utilisation
Guide de prise en main de Hailuo 2.3 Fast image-to-video : limites de capacités, tarification et intégration pratique
Points clés pour les développeurs : choisir et intégrer le modèle image-to-video de MiniMax