
Guía de uso
Generador de modelos de Instagram con IA: crea influencers virtuales con identidad coherente en hiapi
Fija un mismo rostro con una imagen de referencia, genera distintos escenarios en lote y conviértelos en Reels, todo a través de /v1/tasks de hiapi.
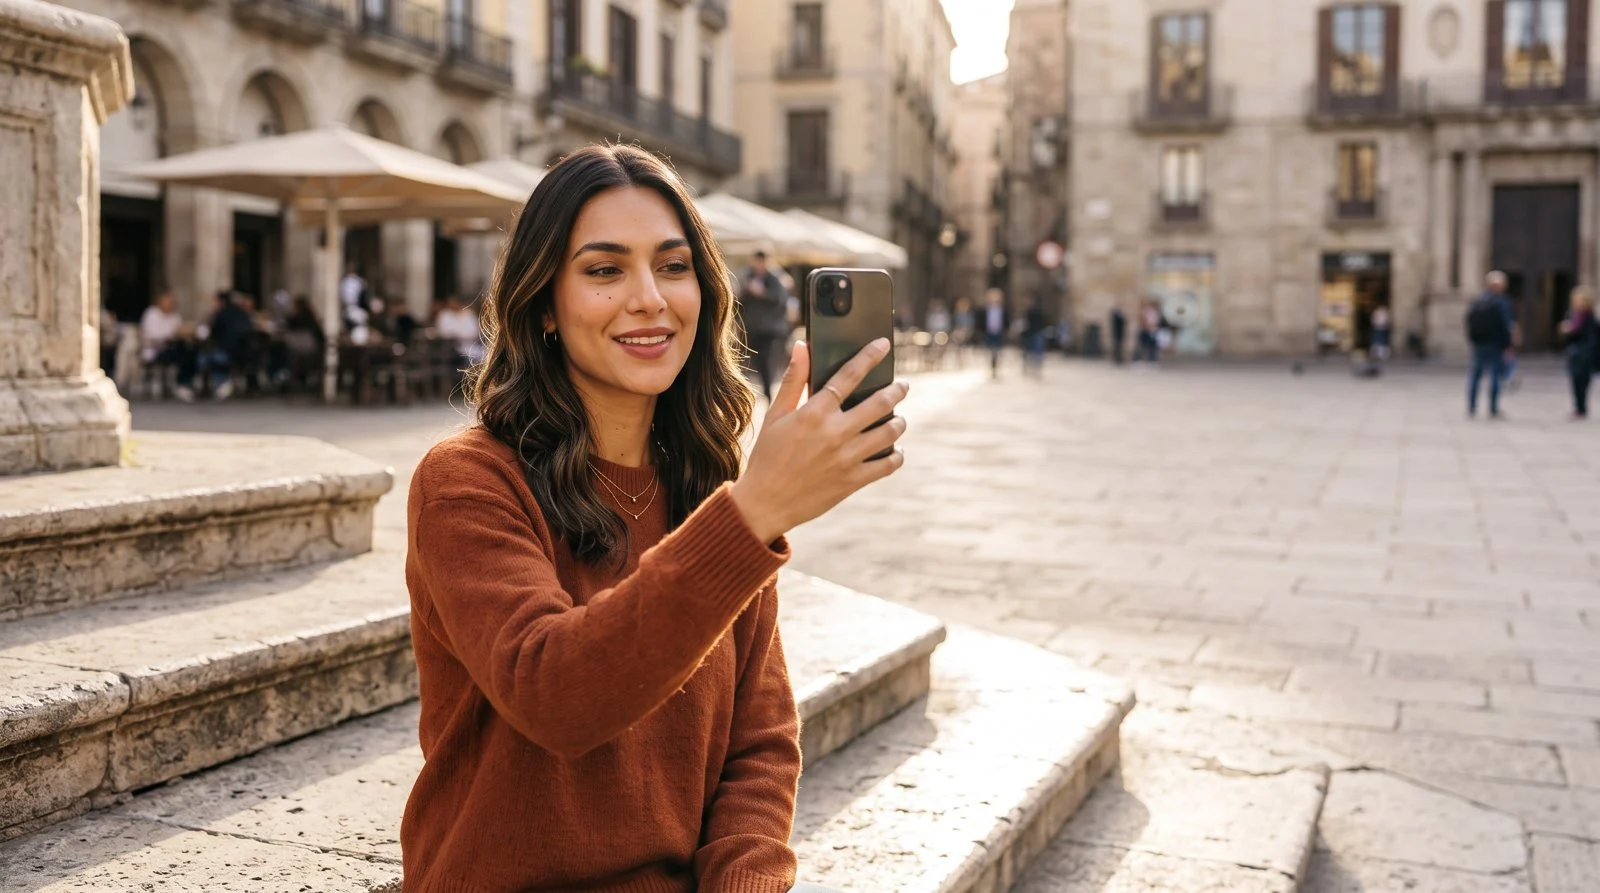
TL;DR
- Un generador de modelos de Instagram con IA es esencialmente una canalización de tres etapas: crear un personaje, fijar ese rostro para que se repita en cada toma y convertir los mejores fotogramas fijos en clips de vídeo cortos. hiapi ejecuta las tres etapas a través de una única interfaz asíncrona,
POST /v1/tasks. - Esta guía usa la ruta de la imagen de referencia para fijar la identidad: envías un retrato base como
image_inputy solo cambias el escenario. Es distinto del método de «hoja de personaje» puramente textual que se explica en Consistent Characters with Nano-Banana; usa aquel cuando todavía no tengas una imagen semilla, y este cuando quieras fijar un rostro concreto. - En este artículo se probó en nano-banana-2: un retrato base ancló tres escenarios completamente distintos —una cafetería parisina, un paso de peatones urbano y un gimnasio en la azotea— y el rostro, el peinado, el tono de piel, los pendientes dorados y el collar de capas se mantuvieron coherentes en todos ellos.
- La etapa de vídeo es real, no una maqueta: el fotograma fijo de la cafetería que aparece abajo se convirtió en un clip de 5 segundos con
grok-imagine-1.5/image-to-video. Ella levanta la taza y bebe un sorbo; la identidad se mantiene en movimiento. - Presupuesto total de esta entrada del blog: unos $0.30 — cuatro imágenes 2K en nano-banana-2 a $0.057 cada una ($0.228), más un Reel de 480p/5s facturado a $0.015/s ($0.075).
Qué estás construyendo realmente
«Influencer virtual», «modelo UGC de IA», «generador de modelos de Instagram con IA»: los nombres de marketing varían, pero la implementación técnica siempre tiene las mismas tres fases:
- Personaje: genera (o elige) un retrato base que sirva como rostro canónico de tu modelo.
- Fijación de identidad: haz que la misma persona aparezca con distintas prendas, poses y ubicaciones, para que el feed parezca el de un solo creador y no el de cuarenta personas diferentes.
- Movimiento: convierte los fotogramas fijos con más impacto en clips breves de Reels / Shorts que hagan detener el desplazamiento.
La dificultad está en la fase 2. Todo lo que viene después —una cuadrícula de feed creíble, pruebas de producto, publicaciones de marca— se derrumba en el momento en que el rostro se desvía. En hiapi hay dos formas de mantenerlo estable.
Dos formas de fijar un rostro (y por qué esta guía elige la ruta de la imagen de referencia)
| Método | Cómo se ancla la identidad | Cuándo usarlo |
|---|---|---|
| Hoja de personaje (texto) | Un prefijo de prompt denso y reutilizable que describe el rostro, el peinado y el vestuario, y se concatena en cada renderizado. Sin imagen semilla. | Inventas un personaje desde cero y quieres definirlo con texto versionable. |
| Imagen de referencia (esta guía) | Envías un retrato base como image_input; el prompt solo cambia el escenario. |
Ya tienes un rostro aprobado (un render principal, una mascota de marca) y quieres que ese rostro aparezca en todas partes. |
El método de la hoja de personaje se explica por completo en Consistent Characters with Nano-Banana, incluidos ejemplos de guiones gráficos y libros de estilo de comercio electrónico. Esta guía toma el otro camino: fijar un retrato concreto con una imagen de referencia y luego extenderlo a varios escenarios y producir vídeo. Ambos son complementarios; muchos equipos escriben una hoja de personaje una vez, generan un retrato principal y después cambian al modo de imagen de referencia para el resto del rodaje.
Paso 1: generar el personaje base
Empieza con un retrato limpio y bien iluminado. El detalle es tu aliado aquí: cuanto más específicos sean los rasgos invariables (un lunar, una raya del pelo, una joya), más fácil será continuarlos.
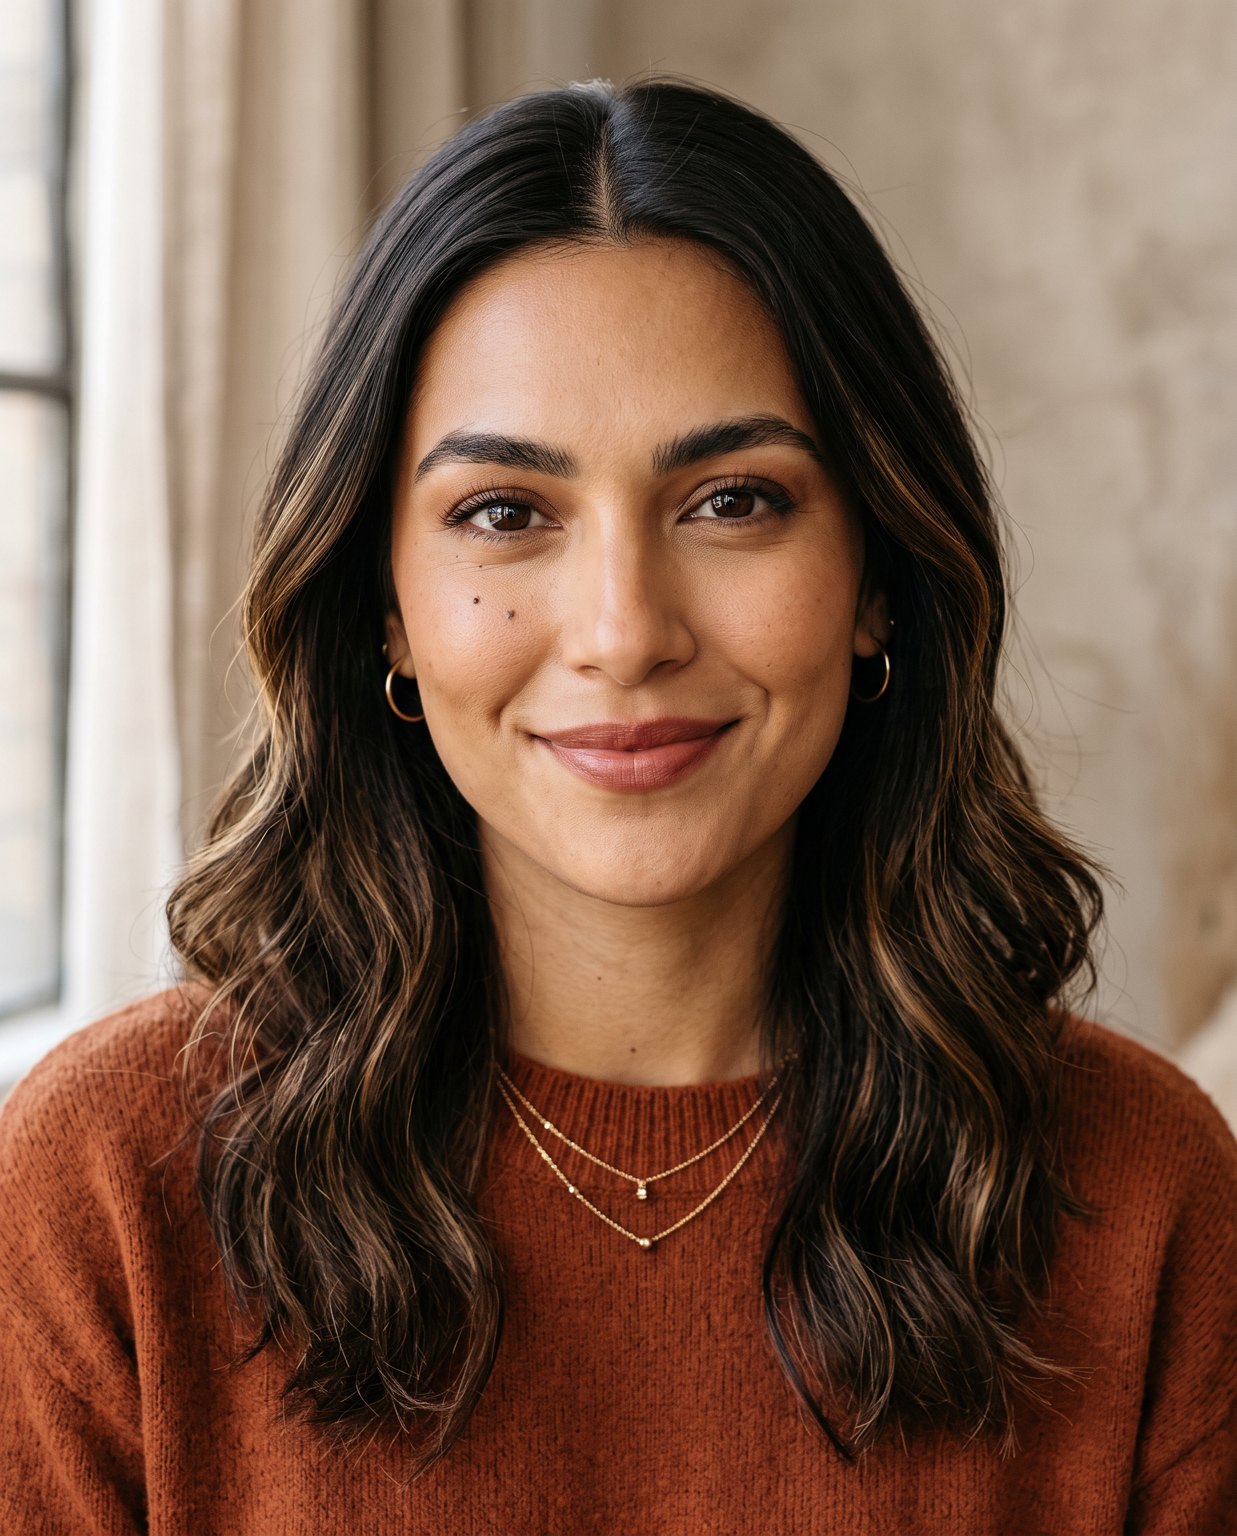
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks devuelve un taskId; consulta GET /v1/tasks/{taskId} hasta que status sea success y luego descarga output[0].url. Esa URL es temporal (tiene expireAt), así que guarda los bytes de inmediato: no la enlaces en caliente. Sube el retrato a una ubicación accesible (tu propio CDN), porque el siguiente paso lo necesita como URL de entrada. nano-banana-2 cuesta $0.036 / $0.057 / $0.086 en 1K / 2K / 4K respectivamente; la sesión de aquí usó 2K.
Paso 2: fijar la identidad entre escenarios
Este es el paso clave que lo convierte en una influencer y no en una galería de desconocidos. Envía el retrato base como image_input y escribe un prompt que diga explícitamente conserva a esta persona y que solo describa el nuevo escenario.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
El campo clave es image_input, un arreglo de URL de referencia. Abajo, el mismo retrato base se coloca en tres entornos no relacionados, y cada renderizado se ancla a ese único retrato:
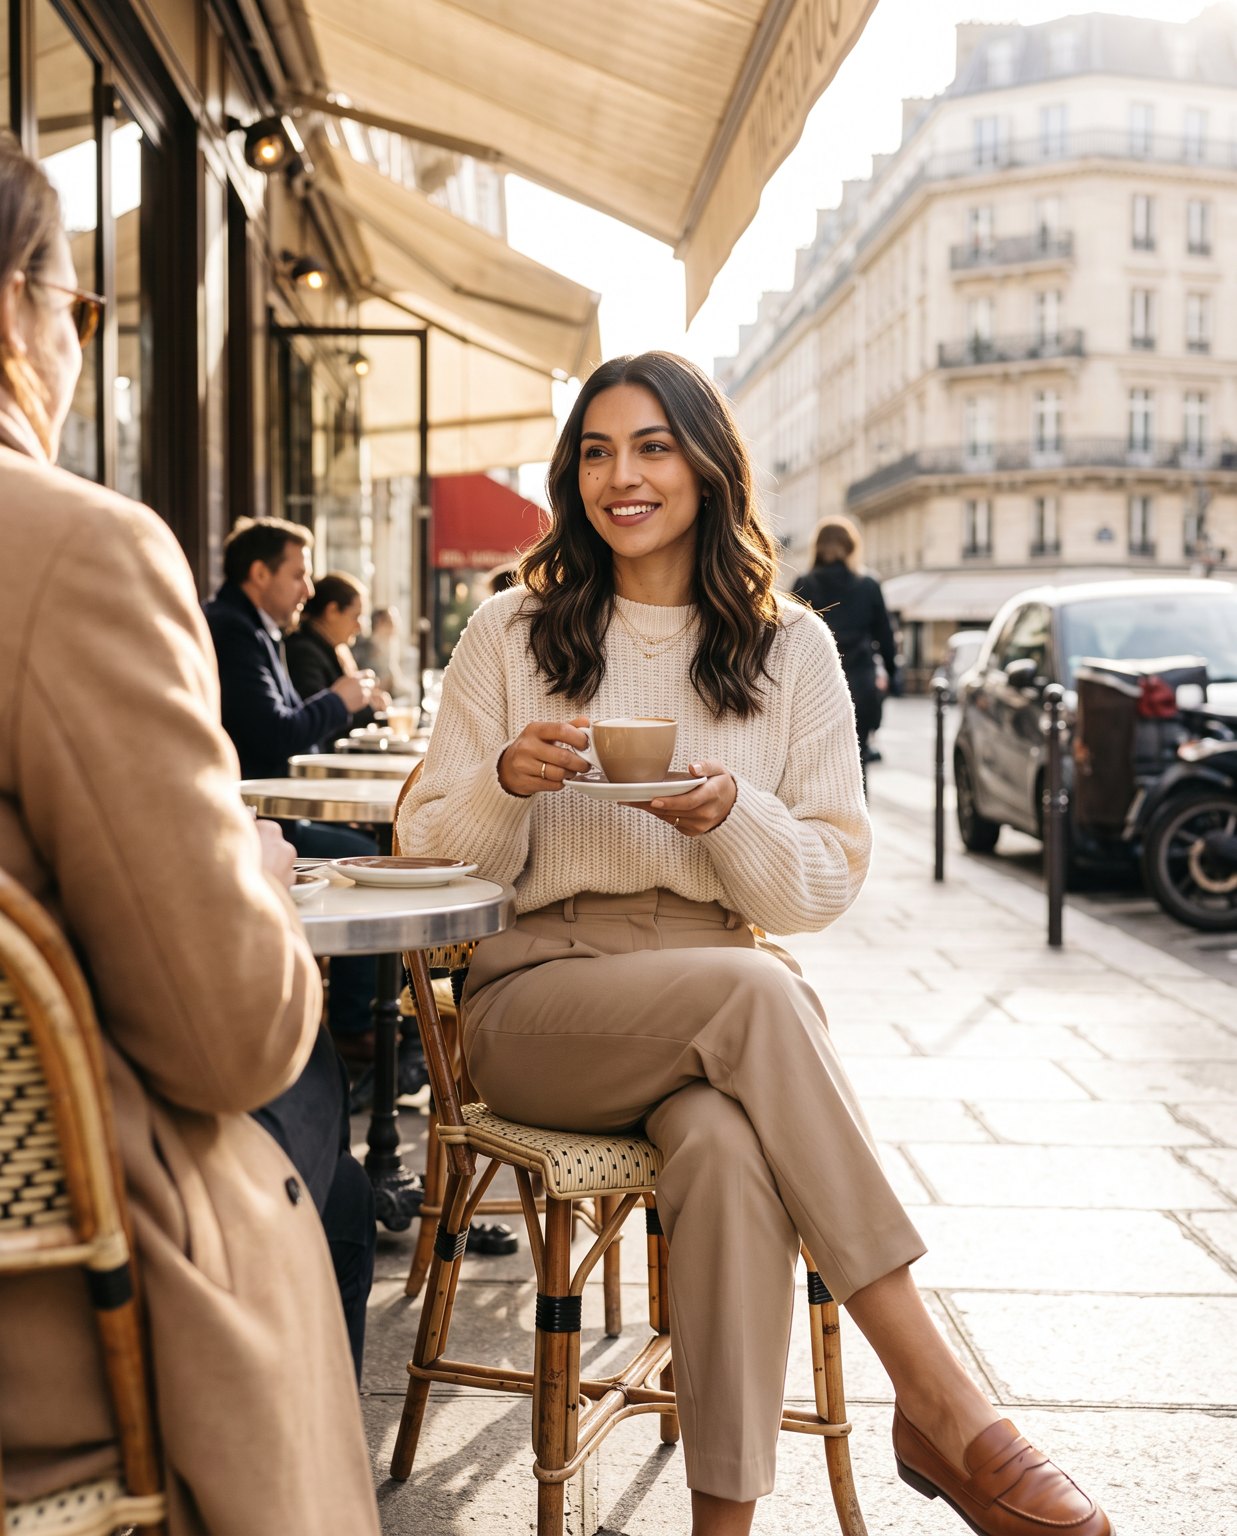
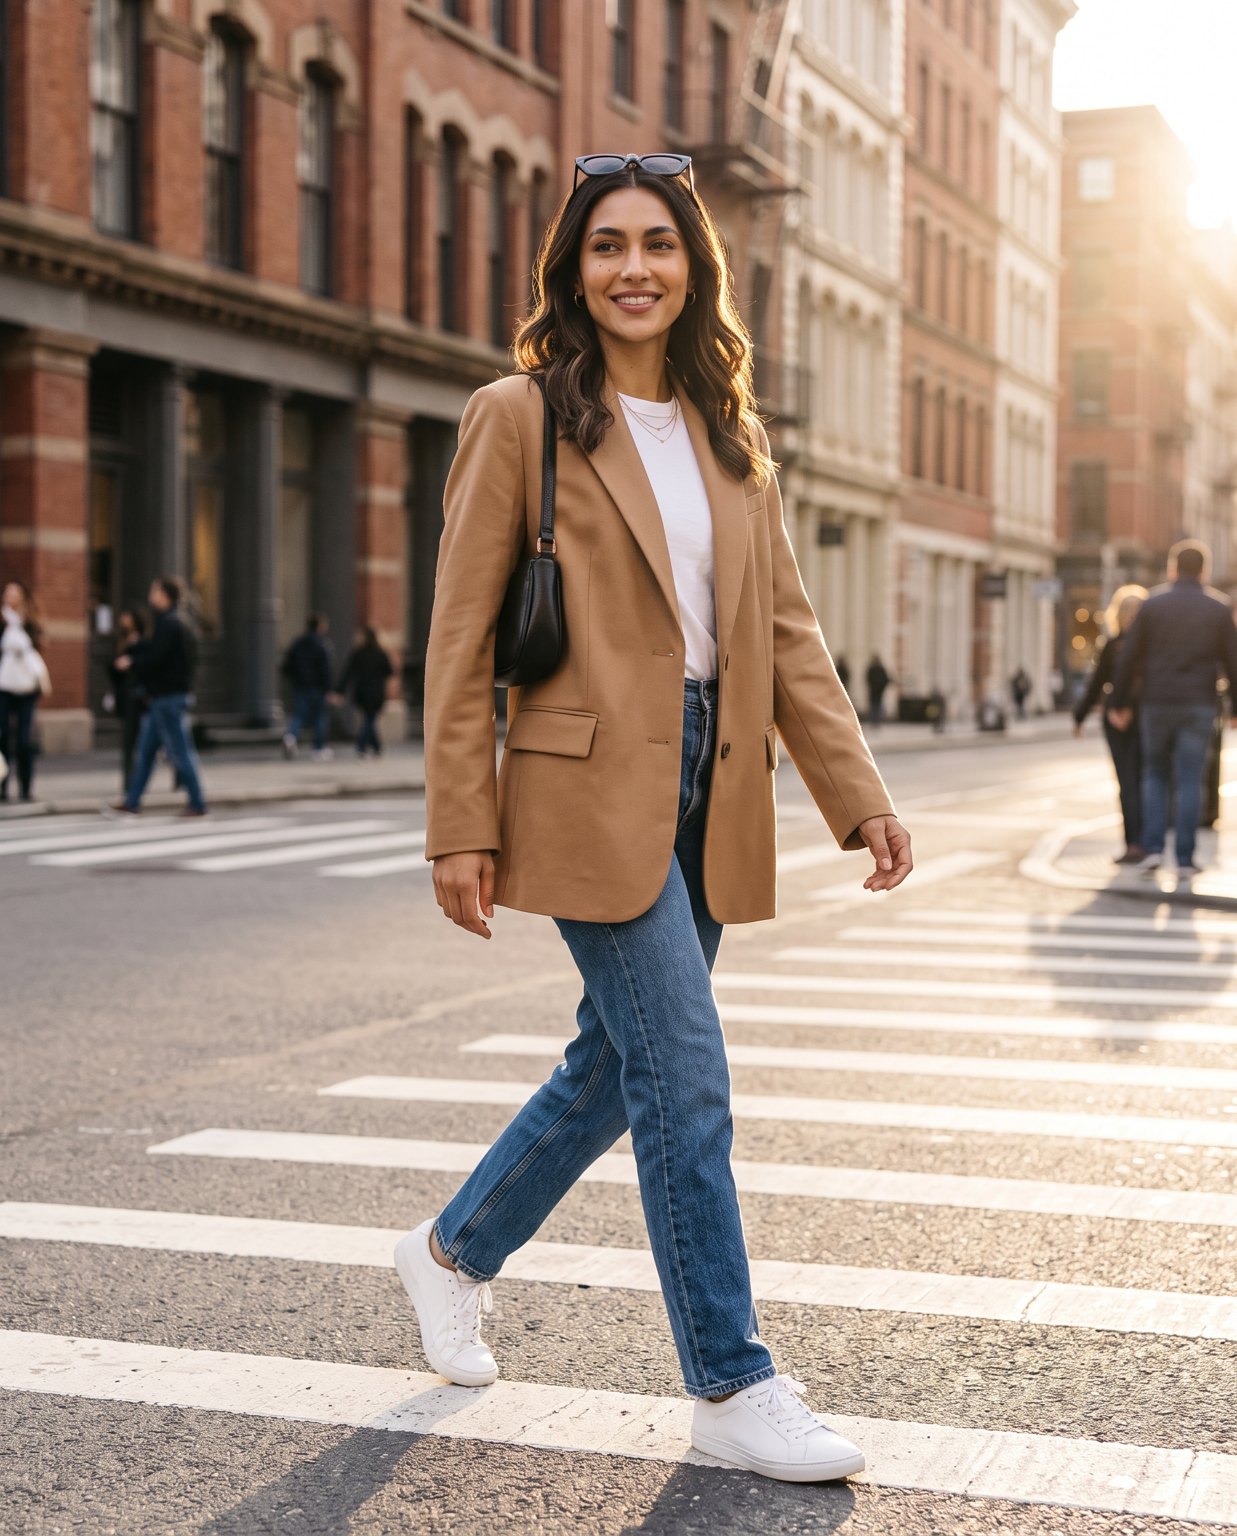
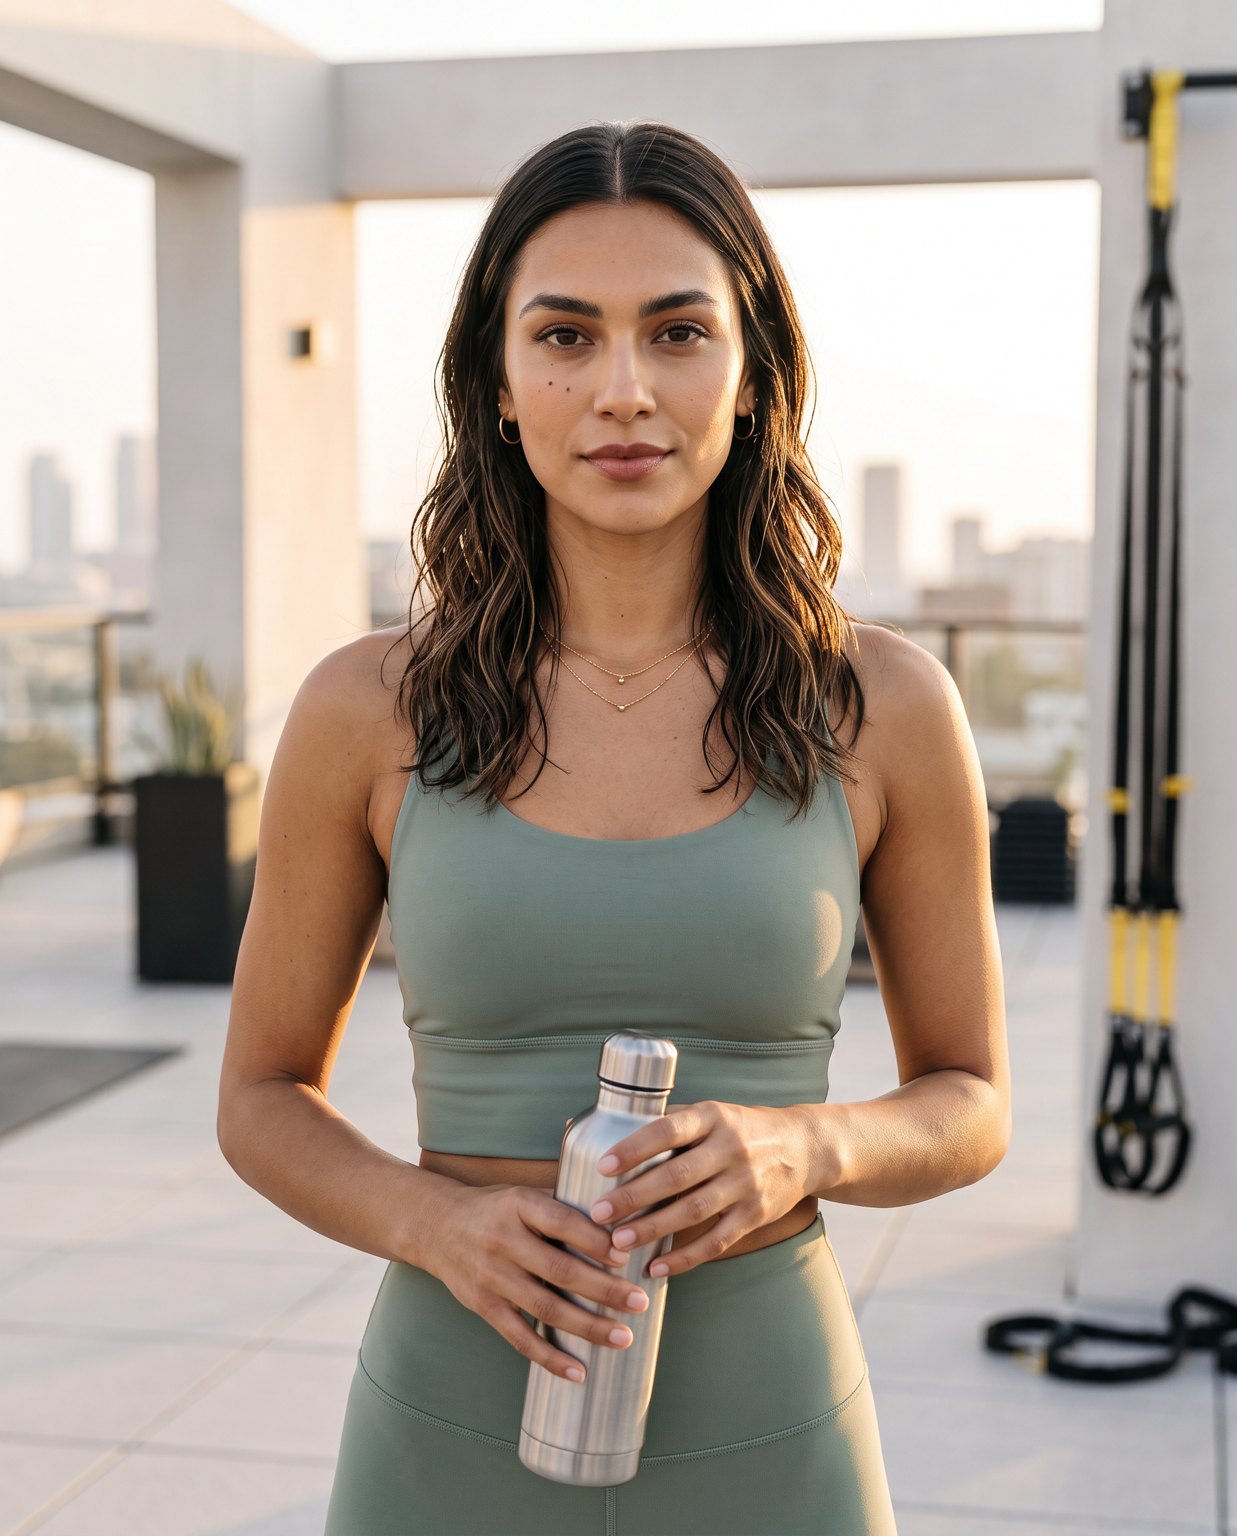
Lo que se mantuvo realmente en esta ejecución: en los tres renderizados —cafetería, calle y gimnasio— la geometría facial, el tono de piel, el cabello ondulado con reflejos caramelo, los pendientes dorados y el fino collar de capas siguen siendo la misma persona reconocible. La única advertencia son los microdetalles: la posición exacta de un lunar o de un mechón suelto es lo primero que se desvía. La corrección eficaz es anclar cada renderizado a ese retrato original, en lugar de encadenar (usar la salida del escenario A como entrada del escenario B). El encadenamiento hace que las pequeñas desviaciones se acumulen; un único ancla fija no.
Paso 3: convertir el fotograma fijo en un Reel
El feed necesita movimiento. Toma cualquier fotograma fijo ya fijado y envíalo a un modelo de imagen a vídeo. El clip de abajo es la foto de la cafetería de arriba, animada de verdad con grok-imagine-1.5/image-to-video:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Fíjate en que el campo de entrada es distinto: los modelos de vídeo usan image_urls (más duration en segundos) en lugar de image_input. El clip de prueba devolvió 480p, vertical, de 5 segundos: ella levanta la taza y bebe un sorbo como indica el prompt, y el rostro sigue siendo la misma persona en movimiento. A $0.015/s, este Reel cuesta unos $0.075. Si quieres una salida más nítida, el mismo fotograma fijo puede enviarse directamente a veo-3.1-lite, kling-3.0 o hailuo-2.3; consulta la tabla de abajo.
Procesamiento por lotes: una referencia, varios escenarios
Todo el sentido de una modelo virtual está en el volumen. Mantén una lista de prompts de escenario y recórrela contra un único retrato base:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Cambia la cadena del modelo y puedes ejecutar el mismo bucle en cualquier modelo de imagen que admita imágenes de referencia, o alimentar los fotogramas fijos ya listos al bucle de vídeo.
Modelos opcionales para la fase de fijación de identidad
Los precios son el precio actual por imagen de /api/pricing en el momento de escribir; vuelve a comprobarlos antes de un lote grande.
| Modelo | Entrada de referencia | Precio (USD) | Notas |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086 (1K/2K/4K) | El usado en este artículo; gran continuidad facial, admite 4K |
| nano-banana-pro | image_input |
$0.057 (1K y 2K) / $0.10 (4K) | Versión avanzada de la misma familia |
gpt-image-2 /image-to-image@ext |
Hasta 16 imágenes de referencia | Desde $0.007 (calidad baja, 1K) | La ruta multirreferencia más económica, salida 4K |
flux-2 /image-to-image |
Multirreferencia | $0.035 (1K) / $0.05 (2K) | Edición multirreferencia de alta fidelidad |
seedream-5.0-pro /image-to-image |
Multirreferencia | $0.06 (1K) / $0.10 (2K) | Multirreferencia con calidad insignia |
Explora la selección completa en el mercado de modelos. Para un único rostro fijo, una imagen de referencia basta; la ruta de 16 imágenes de referencia de gpt-image-2 destaca cuando quieres fusionar rostro, ropa y producto en un solo renderizado.
Modelos opcionales para la fase de vídeo
Los modelos de facturación son distintos: la mayoría cobra por segundo, pero hailuo cobra una tarifa plana por duración fija del clip. Ten en cuenta esta diferencia al presupuestar lotes.
| Modelo | Modo de facturación | Costo de ejemplo | Notas |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
Por segundo | $0.015/s (480p), $0.0282/s (720p) | El usado en este artículo; el más barato, 1–15 segundos |
veo-3.1-lite /image-to-video |
Por segundo | $0.06/s (720p, sin audio) → $0.14/s (1080p) | Buen equilibrio entre calidad y costo |
kling-3.0 /image-to-video |
Por segundo | $0.10/s (720p) → $0.129/s (1080p); más caro con audio | Audio nativo, hasta 4K |
hailuo-2.3-fast /image-to-video |
Por clip | $0.27 (6s) / $0.46 (10s) | Cobro plano por tramos de duración fija |
wan2.7-video /image-to-video |
Por segundo | $0.10/s (720P) / $0.167/s (1080P) | Impulsado por el primer fotograma |
veo-3.1 /image-to-video |
Por segundo | Con audio $0.57/s → $0.86/s (4K) | Gama cinematográfica; un clip de 5 segundos cuesta unos $2.85, así que limita la duración |
Por tanto, un Reel de 5 segundos cuesta desde unos $0.075 con grok-imagine-1.5 hasta unos $2.85 con veo-3.1 completo: una diferencia de 38 veces. Prototipa en el tramo barato y mejora solo los clips que realmente vayas a publicar.
Trucos de coherencia que de verdad funcionan
- Ancla, no encadenes. Envía el retrato base original a cada renderizado. Usar la salida anterior como entrada de la siguiente hace que las pequeñas desviaciones se acumulen hasta que el rostro se convierte en un primo, no en la misma persona.
- Escribe los rasgos invariables en el prompt. «El mismo lunar bajo el ojo izquierdo, los mismos pendientes dorados» es más útil que «la misma mujer». Le estás diciendo al modelo qué no tiene permitido cambiar.
- Mantén una sola relación de aspecto por canal. 4:5 para la cuadrícula del feed, 9:16 para Reels. Cambiarla a mitad de la sesión obliga a un recorte forzado que puede cortar el rostro.
- Fija la resolución al tramo del modelo.
nano-banana-2acepta1K/2K/4K; configúrala explícitamente para que el procesamiento por lotes no mezcle tamaños en silencio. - Conserva el retrato más fuerte como activo permanente. Es tu «casting»: reutilízalo durante meses en lugar de generar un rostro nuevo en cada campaña.
Costo de este artículo
| Concepto | Modelo | Cantidad | Precio unitario | Subtotal |
|---|---|---|---|---|
| Retrato base + 3 renderizados de escenario | nano-banana-2 (2K) | 4 | $0.057 | $0.228 |
| Reel de la cafetería | grok-imagine-1.5 (480p, 5s) | 1 | $0.015/s | $0.075 |
| Total | unos $0.30 |
Una cuadrícula completa de 30 publicaciones más varios Reels cuesta solo unos pocos dólares: esa es la verdadera razón por la que los equipos eligen un generador en lugar de una sesión de fotos.
FAQ
¿Se garantiza que el rostro sea exactamente el mismo cada vez? Ningún modelo garantiza un rostro idéntico píxel a píxel, pero en esta prueba el anclaje con imagen de referencia en nano-banana-2 mantuvo a la misma persona reconocible en tres escenarios muy distintos. Considera los casos atípicos ocasionales como motivo para generar unas cuantas imágenes más y seleccionar, no para volver a rodar.
¿Puedo fijar el rostro de una persona real? Solo de personas sobre las que tengas derechos: tú mismo, una modelo que haya dado su consentimiento o un embajador de marca contratado. No clona a desconocidos ni a celebridades.
¿Necesito ajuste fino o LoRA? No. Todo el flujo de trabajo es de entrenamiento cero: una imagen de referencia más un prompt. Esa es precisamente la razón por la que el costo por imagen se mantiene en unos pocos centavos.
¿Con qué modelo debería empezar? Empieza con nano-banana-2 para la fijación de identidad y con grok-imagine-1.5 para la fase de vídeo. Ambos son lo bastante baratos para iterar con libertad; mejora solo cuando el estilo esté decidido.
Empieza a construir
Genera un retrato en nano-banana-2, envíalo como image_input a cada escenario y anima con un modelo de imagen a vídeo el fotograma que más te guste, todo a través de POST /v1/tasks con una única clave. La documentación de inicio rápido explica la autenticación y el sondeo, y puedes comparar cada modelo de imagen y vídeo en la página de precios antes de ampliar el lote.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores