
Guia de uso
Gerador de modelos do Instagram com IA: crie influenciadoras virtuais com identidade consistente no hiapi
Use uma imagem de referência para fixar o mesmo rosto, gere em lote diferentes cenários e transforme tudo em Reels — tudo por meio do /v1/tasks do hiapi.
TL;DR
- O gerador de modelos do Instagram com IA é essencialmente um pipeline de três etapas: criar um personagem, fixar esse rosto para que ele se repita em cada cena e converter os melhores frames estáticos em vídeos curtos. O hiapi executa todas as três etapas por meio de uma única interface assíncrona,
POST /v1/tasks. - Este guia usa a abordagem de imagem de referência para fixar a identidade — você reenvia um retrato base como
image_inpute altera apenas o cenário. É diferente do método de "folha de personagem" puramente textual apresentado em Consistent Characters with Nano-Banana; use aquele quando você ainda não tem uma imagem semente, e use este quando quer fixar um rosto específico. - Este artigo testou na prática com nano-banana-2: um retrato base ancorou três cenários completamente diferentes — um café em Paris, uma faixa de pedestres urbana e uma academia no rooftop — e o rosto, o cabelo, o tom de pele, os brincos dourados e o colar em camadas permaneceram consistentes em todos os cenários.
- A etapa de vídeo é real, não uma simulação: o frame estático do café abaixo foi transformado em um clipe de 5 segundos com
grok-imagine-1.5/image-to-video. Ela levanta a xícara e dá um gole; a identidade se mantém em movimento. - Orçamento total deste artigo: cerca de US$ 0,30 — quatro imagens 2K no nano-banana-2, US$ 0,057 cada (US$ 0,228), mais um Reel 480p/5s cobrado a US$ 0,015/s (US$ 0,075).
O que você está realmente construindo
"Influenciadora virtual", "modelo de UGC com IA", "gerador de modelos do Instagram com IA" — os nomes de marketing variam, mas a implementação de engenharia segue sempre as mesmas três etapas:
- Personagem — gerar (ou escolher) um retrato base que sirva como o rosto canônico da sua modelo.
- Fixar a identidade — fazer a mesma pessoa aparecer em roupas, poses e locais diferentes, para que o feed pareça o de uma única criadora, e não de quarenta pessoas distintas.
- Movimento — transformar os frames estáticos de maior impacto em Reels / Shorts curtos que fazem o usuário parar de rolar.
A dificuldade está na etapa 2. Todo o restante — uma grade de feed crível, experimentações de produto, posts de marca — desmorona no momento em que o rosto começa a variar. No hiapi, há duas formas de estabilizá-lo.
Duas formas de fixar um rosto (e por que este guia escolhe a rota da imagem de referência)
| Método | Como a identidade é ancorada | Quando usar |
|---|---|---|
| Folha de personagem (texto) | Um prefixo de prompt denso e reutilizável que descreve rosto, cabelo e guarda-roupa, concatenado a cada renderização. Sem imagem semente. | Você está inventando um personagem do zero e quer defini-lo com texto versionável. |
| Imagem de referência (este guia) | Reenvie um retrato base como image_input; o prompt altera apenas o cenário. |
Você já tem um rosto aprovado (renderização principal, mascote da marca) e quer que esse rosto apareça em todos os lugares. |
O método da folha de personagem está totalmente documentado em Consistent Characters with Nano-Banana — incluindo storyboards e exemplos de lookbooks de e-commerce. Este guia segue outro caminho: fixar um retrato específico com uma imagem de referência e depois expandi-lo para vários cenários e transformá-lo em vídeo. Os dois são complementares; muitas equipes escrevem uma folha de personagem uma vez, geram um retrato principal e depois mudam para o modo de imagem de referência no restante das gravações.
Etapa 1 — Gerar o personagem base
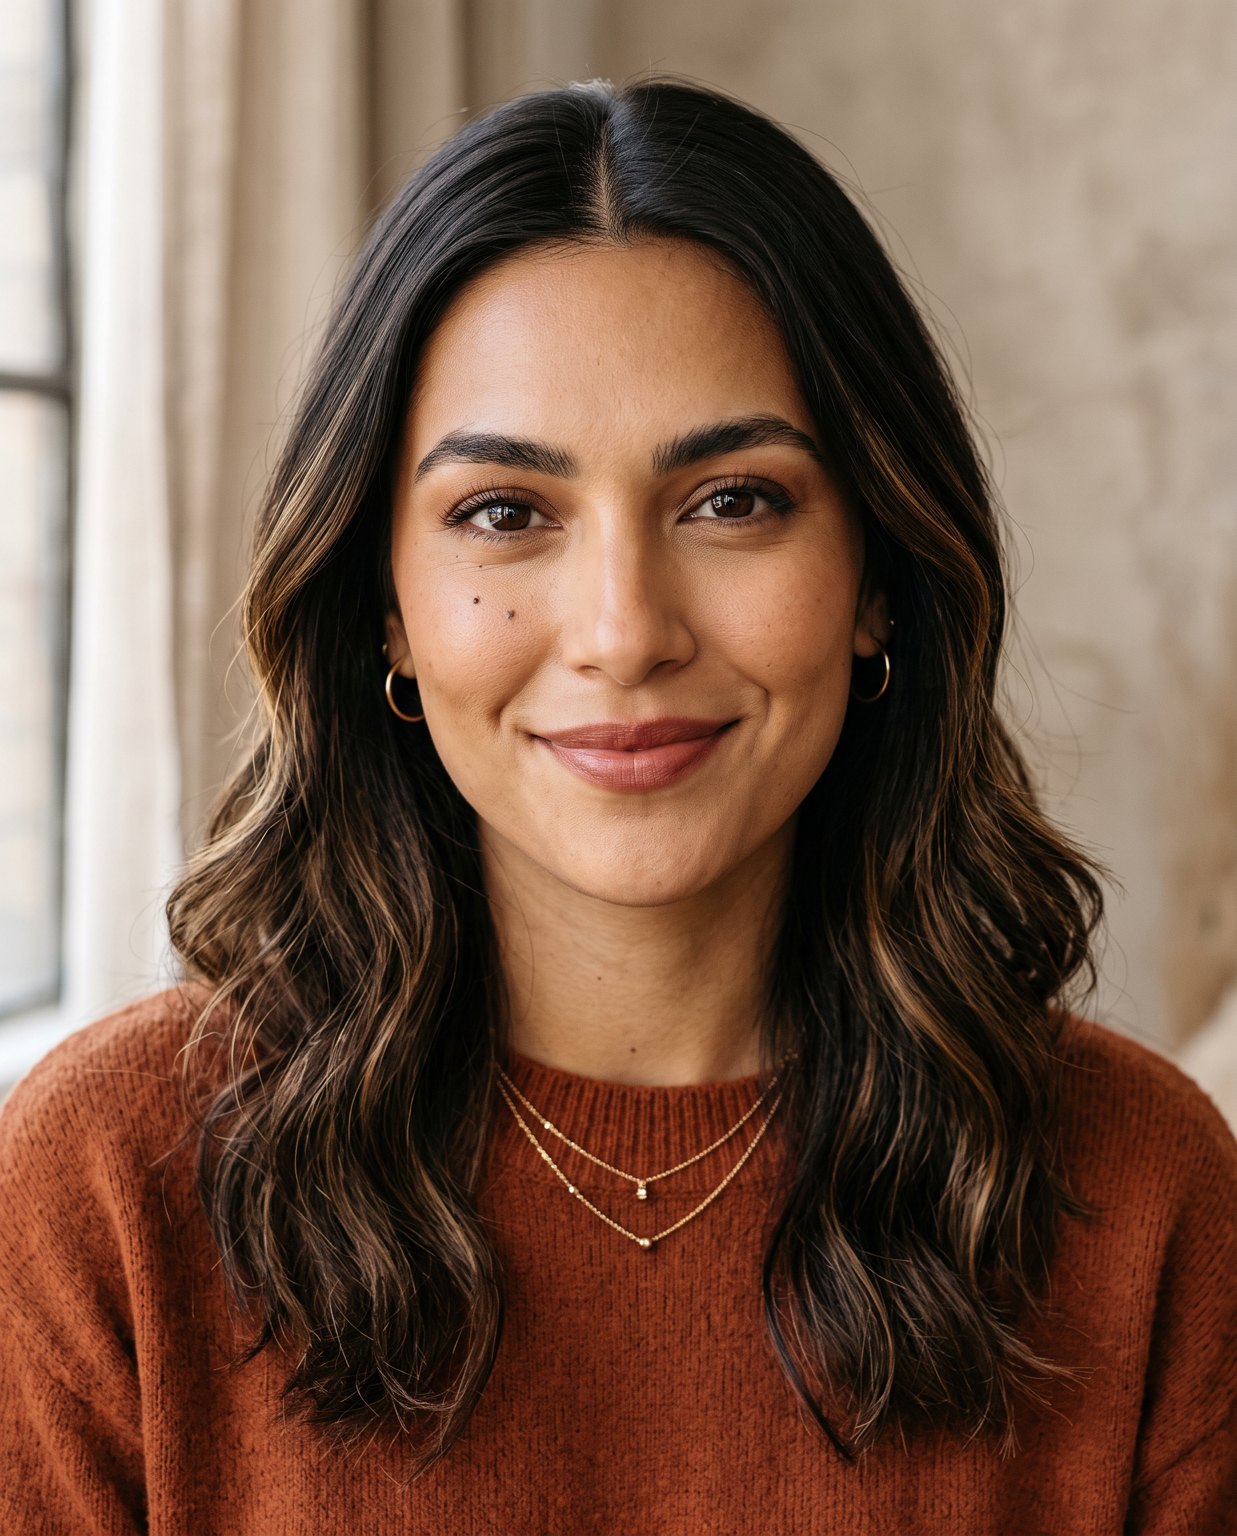
Comece com um retrato limpo e bem iluminado. Detalhes são seus aliados aqui: quanto mais específicas forem as características invariáveis (um sinal de beleza, uma risca no cabelo, uma joia), mais fácil será mantê-las.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks retorna um taskId; faça polling em GET /v1/tasks/{taskId} até que status seja success, então baixe output[0].url. Essa URL é temporária (tem expireAt), então salve os bytes imediatamente — não faça hotlink. Faça upload do retrato para um local acessível (seu próprio CDN), pois a próxima etapa precisa dele como URL de entrada. O nano-banana-2 custa US$ 0,036 / US$ 0,057 / US$ 0,086 em 1K / 2K / 4K, respectivamente; a gravação aqui usou 2K.
Etapa 2 — Fixar a identidade entre cenários
Este é o passo decisivo que a torna uma influenciadora em vez de uma galeria de estranhos. Reenvie o retrato base como image_input e escreva um prompt que declare explicitamente manter esta pessoa e descreva apenas o novo cenário.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
O campo essencial é image_input — um array de URLs de referência. Abaixo, o mesmo retrato base foi colocado em três ambientes não relacionados, com cada renderização ancorada nesse único retrato:
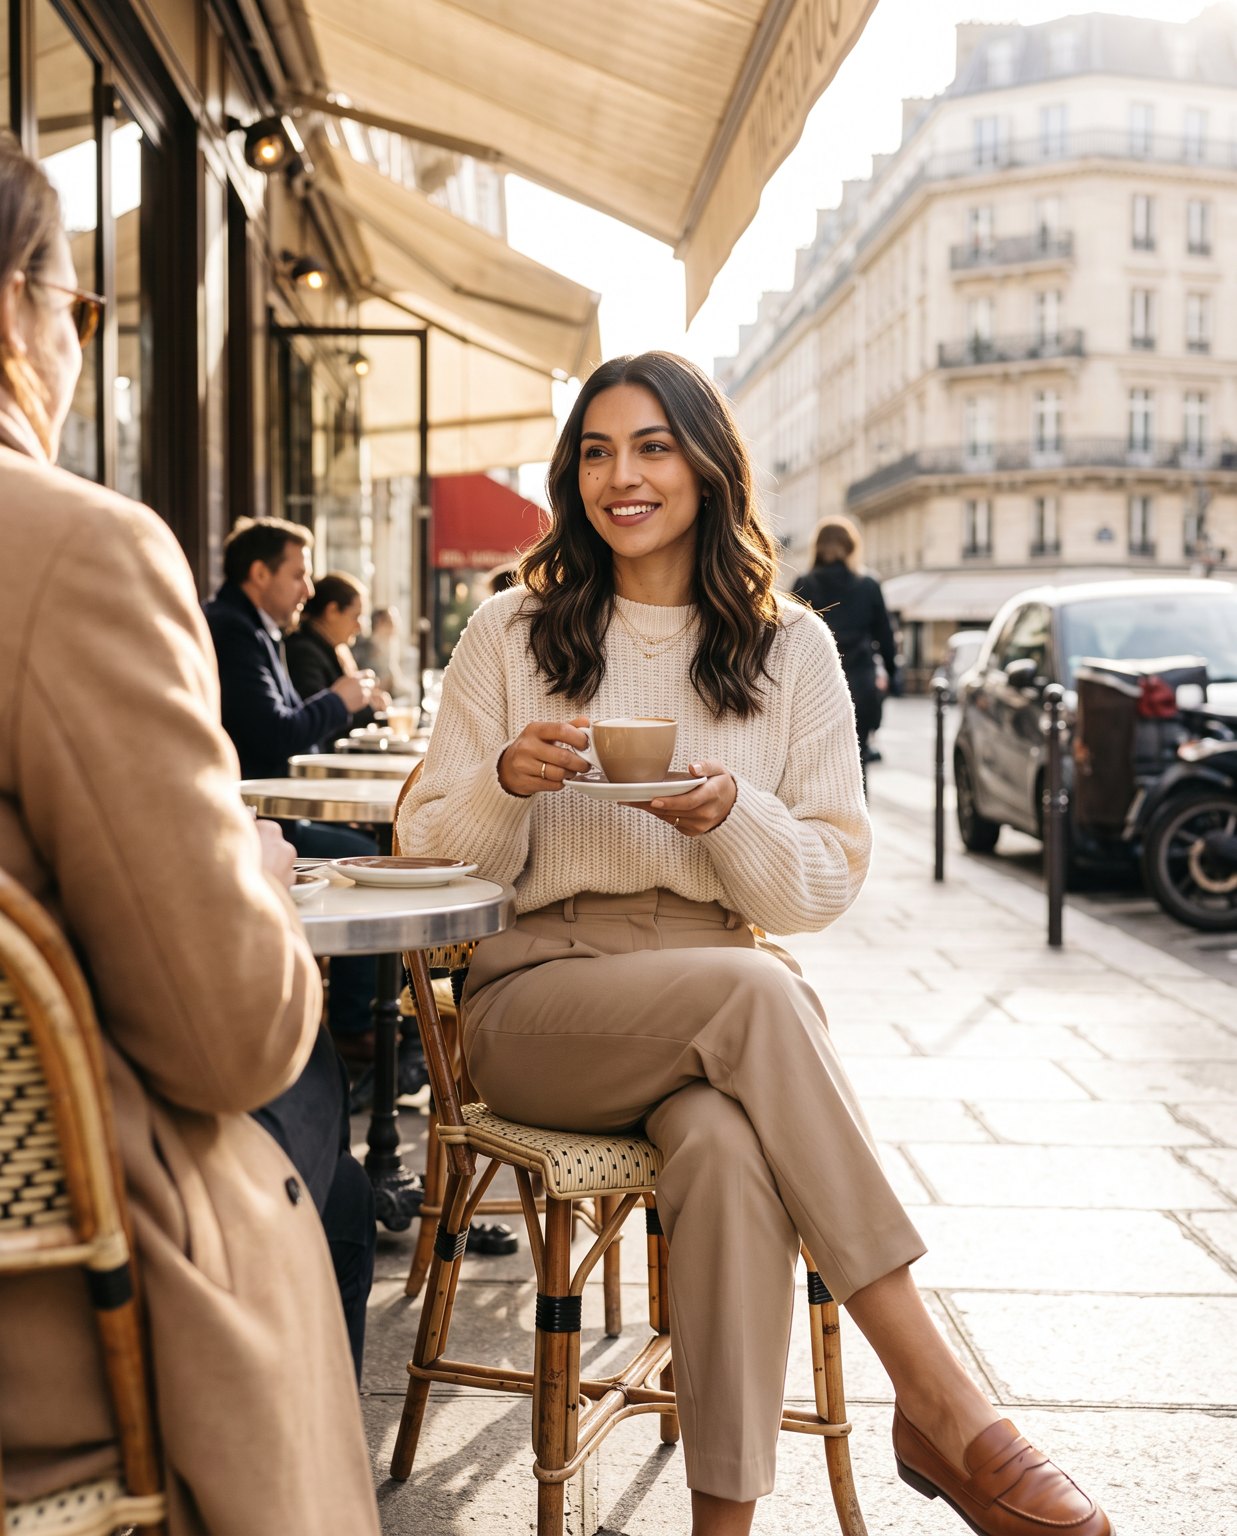
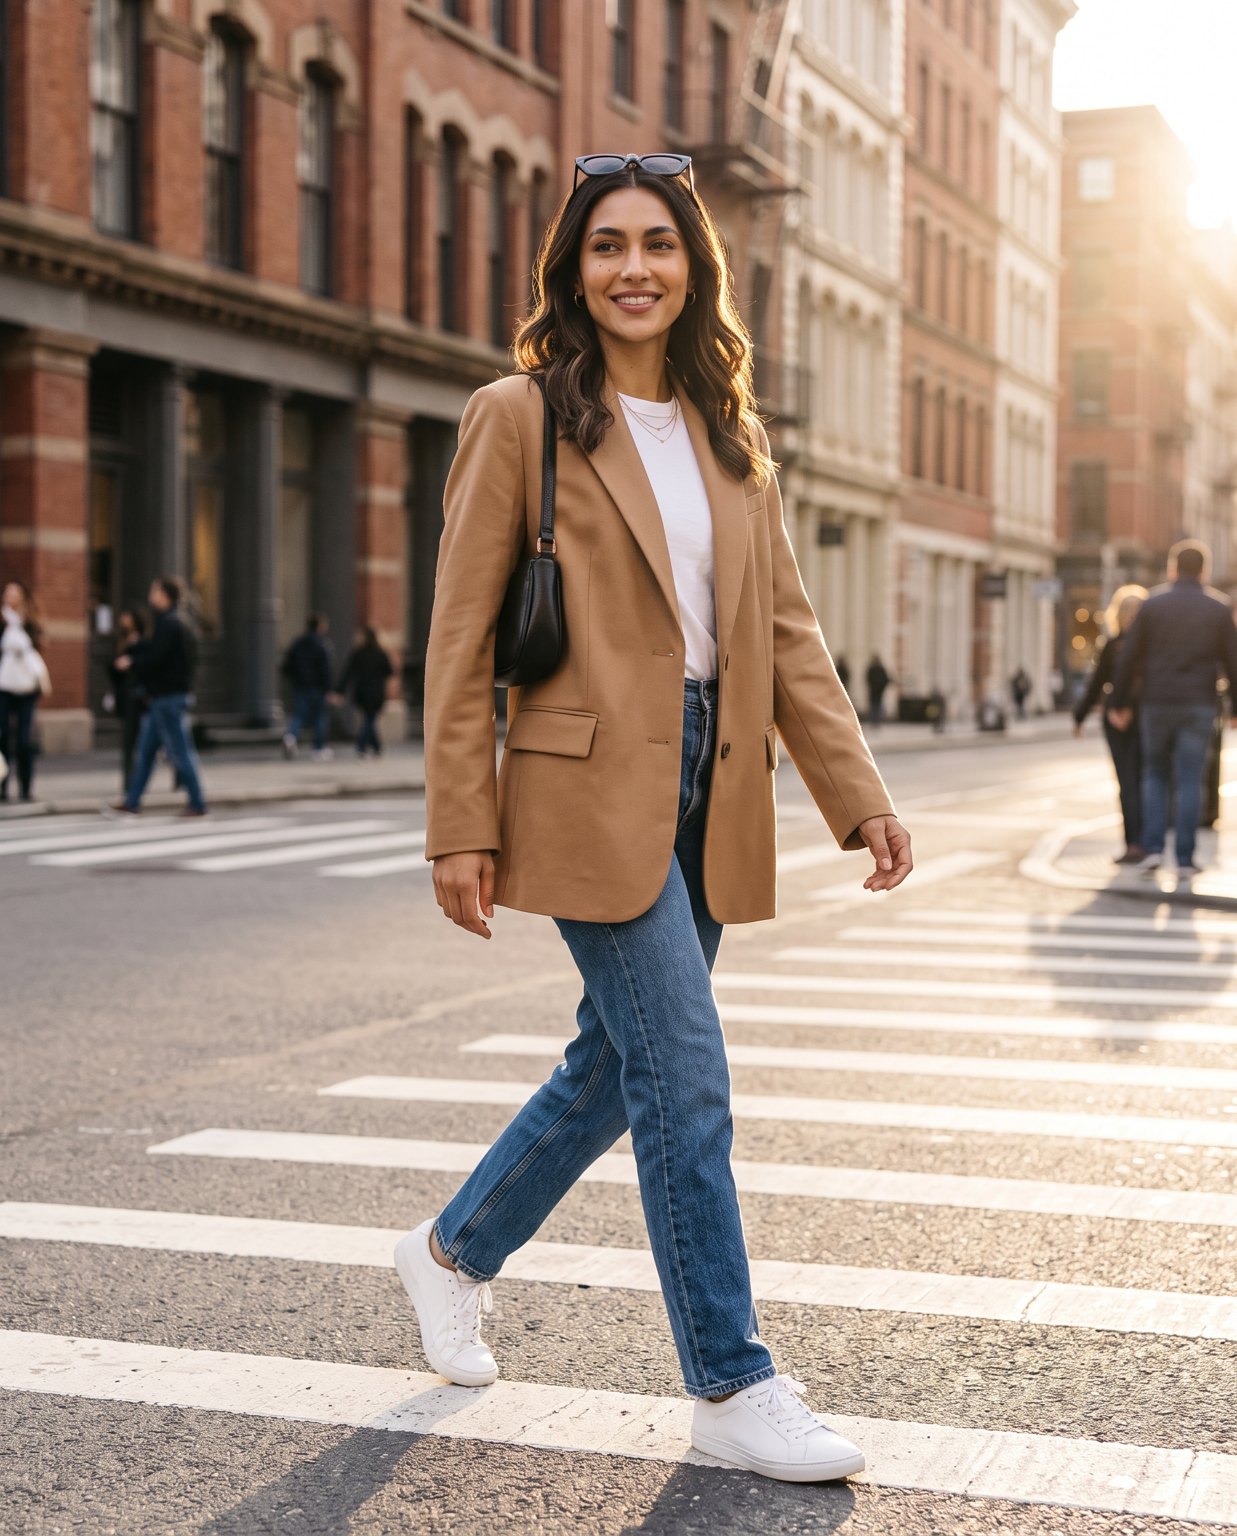
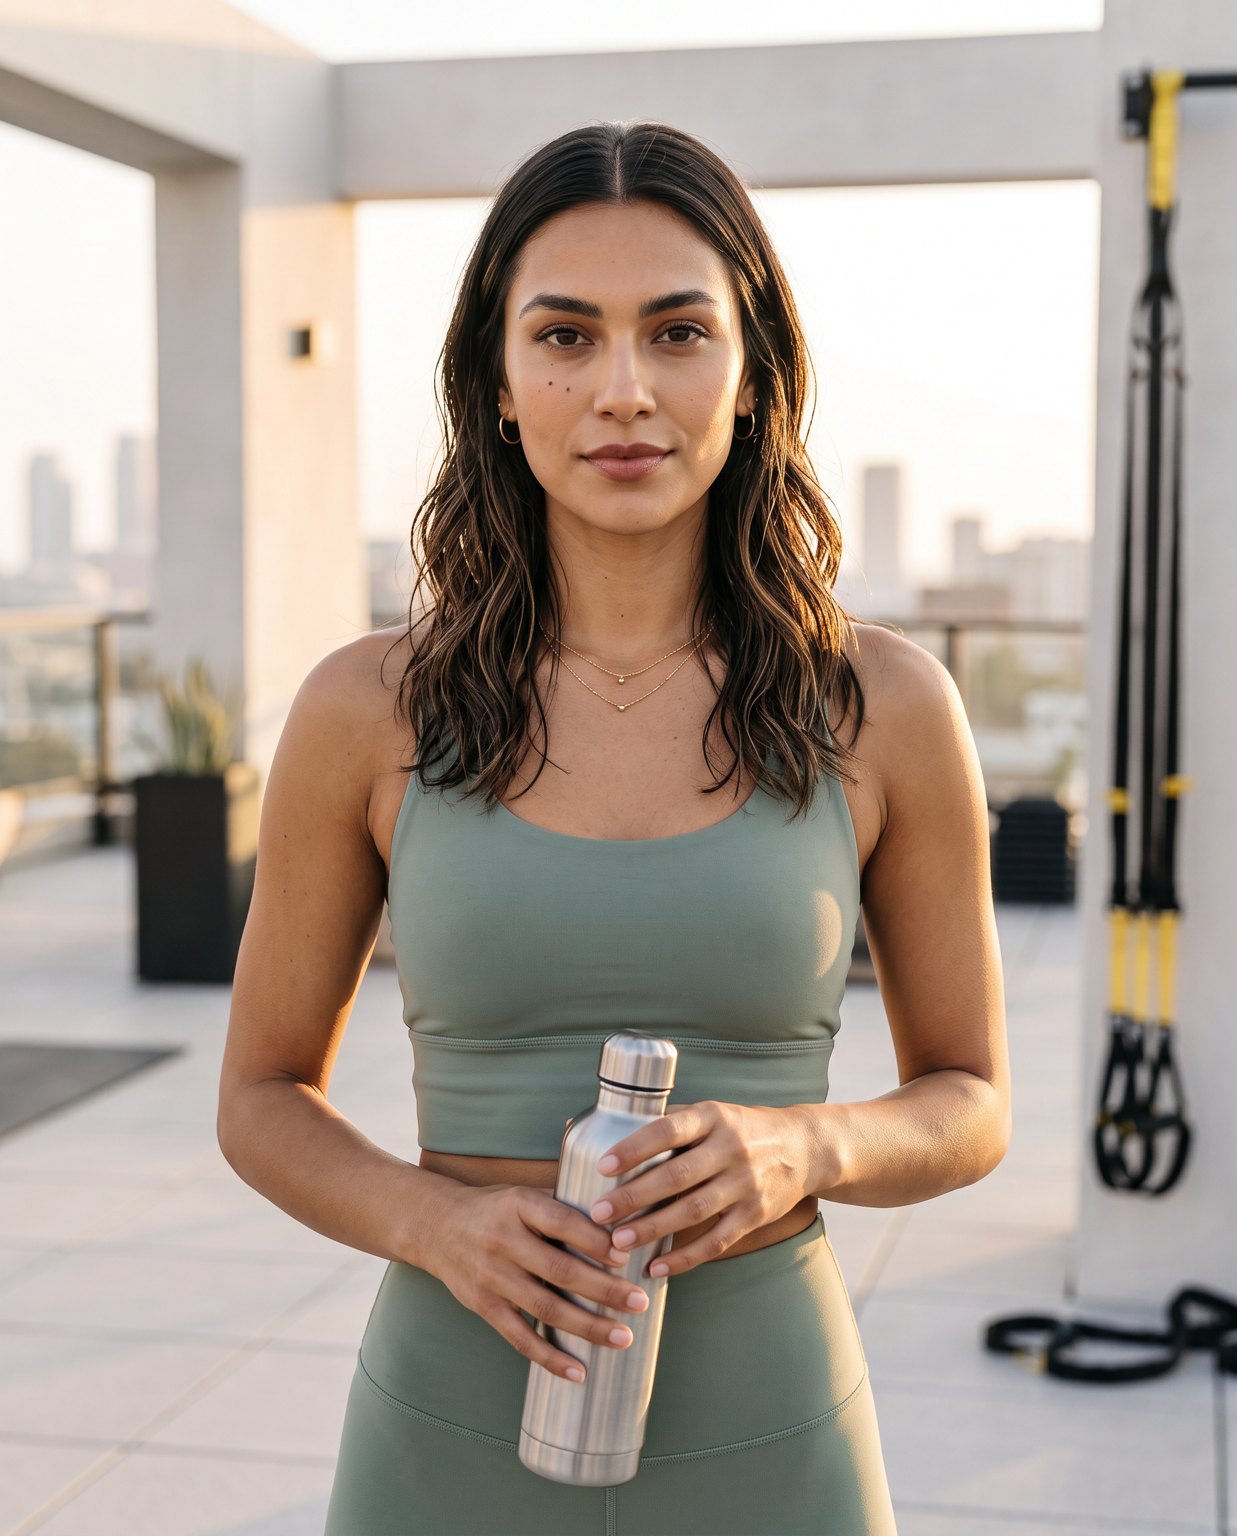
O que de fato se manteve nesta execução: nas três renderizações — café, rua e academia — a geometria facial, o tom de pele, o cabelo ondulado com mechas caramelo, os brincos dourados e o colar fino em camadas permaneceram os de uma mesma pessoa reconhecível. A única ressalva são microdetalhes — a posição exata de um sinal de beleza ou de um fio de cabelo solto é o que varia primeiro. A correção eficaz é ancorar toda renderização nesse retrato original, em vez de encadear (usar a saída do cenário A como entrada do cenário B). O encadeamento acumula pequenas variações; uma âncora fixa única não.
Etapa 3 — Transformar frames estáticos em um Reel
O feed precisa de movimento. Pegue qualquer frame estático fixado e envie para um modelo de imagem para vídeo. O clipe abaixo é a foto do café acima, animada de verdade com grok-imagine-1.5/image-to-video:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
Observe que o campo de entrada aqui é diferente: os modelos de vídeo usam image_urls (mais duration em segundos), não image_input. O clipe de teste retornou 480p, vertical, 5 segundos — ela levanta a xícara e dá um gole conforme o prompt, e o rosto continua sendo a mesma pessoa em movimento. A US$ 0,015/s, este Reel custou cerca de US$ 0,075. Se você quiser uma saída mais nítida, o mesmo frame estático pode ser enviado diretamente para veo-3.1-lite, kling-3.0 ou hailuo-2.3 — veja a tabela abaixo.
Processamento em lote: uma referência, vários cenários
Toda a razão de ser de uma modelo virtual é o volume. Mantenha uma lista de prompts de cenário e execute um loop sobre um único retrato base:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
Troque a string do modelo e você pode executar o mesmo loop em qualquer modelo de imagem com suporte a referência, ou enviar os frames estáticos concluídos para o loop de vídeo.
Modelos opcionais para a etapa de fixação de identidade
Os preços são os valores atuais por imagem em /api/pricing no momento da escrita; sempre reconfirme antes de grandes lotes.
| Modelo | Entrada de referência | Preço (USD) | Observações |
|---|---|---|---|
| nano-banana-2 | image_input |
US$ 0,036 / US$ 0,057 / US$ 0,086 (1K/2K/4K) | Usado neste artigo; forte continuidade facial, suporta 4K |
| nano-banana-pro | image_input |
US$ 0,057 (1K e 2K) / US$ 0,10 (4K) | Versão avançada da mesma família |
gpt-image-2 /image-to-image@ext |
Até 16 imagens de referência | A partir de US$ 0,007 (qualidade baixa, 1K) | A rota multi-referência mais barata, saída 4K |
flux-2 /image-to-image |
Multi-referência | US$ 0,035 (1K) / US$ 0,05 (2K) | Edição multi-referência de alta fidelidade |
seedream-5.0-pro /image-to-image |
Multi-referência | US$ 0,06 (1K) / US$ 0,10 (2K) | Multi-referência com qualidade de ponta |
Explore o lineup completo no mercado de modelos. Para um único rosto fixo, uma imagem de referência basta; a rota de 16 referências do gpt-image-2 brilha quando você quer combinar rosto, roupa e produto em uma única renderização.
Modelos opcionais para a etapa de vídeo
Os modelos de cobrança são diferentes — a maioria cobra por segundo, mas o hailuo cobra uma tarifa fixa por duração de clipe. Fique atento a essa diferença ao orçar em lote.
| Modelo | Modo de cobrança | Custo de exemplo | Observações |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
Por segundo | US$ 0,015/s (480p), US$ 0,0282/s (720p) | Usado neste artigo; o mais barato, 1–15 segundos |
veo-3.1-lite /image-to-video |
Por segundo | US$ 0,06/s (720p, sem áudio) → US$ 0,14/s (1080p) | Bom equilíbrio entre qualidade e custo |
kling-3.0 /image-to-video |
Por segundo | US$ 0,10/s (720p) → US$ 0,129/s (1080p); + custo de áudio é mais alto | Áudio nativo, até 4K |
hailuo-2.3-fast /image-to-video |
Por clipe | US$ 0,27 (6s) / US$ 0,46 (10s) | Cobrança fixa por faixa de duração |
wan2.7-video /image-to-video |
Por segundo | US$ 0,10/s (720P) / US$ 0,167/s (1080P) | Orientado pelo primeiro frame |
veo-3.1 /image-to-video |
Por segundo | Com áudio US$ 0,57/s → US$ 0,86/s (4K) | Nível cinematográfico; um clipe de 5 segundos custa cerca de US$ 2,85, então limite a duração |
Portanto, um Reel de 5 segundos custa desde cerca de US$ 0,075 com grok-imagine-1.5 até cerca de US$ 2,85 com o veo-3.1 completo — uma diferença de 38 vezes. Prototipe nas faixas mais baratas e faça upgrade apenas nos clipes que você realmente vai publicar.
Truques de consistência que realmente funcionam
- Ancore, não encadeie. Envie o retrato base original para cada renderização. Usar a saída anterior como entrada da próxima acumula pequenas variações até o rosto virar um primo, e não a mesma pessoa.
- Escreva as características invariáveis no prompt. "O mesmo sinal de beleza abaixo do olho esquerdo, os mesmos brincos dourados" é mais útil que "a mesma mulher". Você está dizendo ao modelo o que ele não tem permissão de alterar.
- Mantenha uma proporção por canal. 4:5 para a grade do feed, 9:16 para Reels. Trocar no meio da gravação força recortes estranhos que podem cortar o rosto.
- Fixe a resolução no nível do modelo. O
nano-banana-2aceita1K/2K/4K; defina explicitamente para o processamento em lote não misturar tamanhos silenciosamente. - Mantenha o retrato mais forte como ativo permanente. Esta é a sua "escala de elenco" — reutilize-a por meses em vez de gerar um novo rosto a cada campanha.
Custo deste artigo
| Item | Modelo | Quantidade | Preço unitário | Subtotal |
|---|---|---|---|---|
| Retrato base + 3 renderizações de cenário | nano-banana-2 (2K) | 4 | US$ 0,057 | US$ 0,228 |
| Reel do café | grok-imagine-1.5 (480p, 5s) | 1 | US$ 0,015/s | US$ 0,075 |
| Total | cerca de US$ 0,30 |
Uma grade completa de 30 posts mais alguns Reels custa apenas poucos dólares — esse é o verdadeiro motivo pelo qual as equipes escolhem um gerador em vez de uma produção fotográfica.
FAQ
O rosto é garantidamente idêntico todas as vezes? Nenhum modelo garante um rosto idêntico em nível de pixel, mas neste teste a ancoragem por imagem de referência no nano-banana-2 manteve a mesma pessoa reconhecível em três cenários muito diferentes. Trate eventuais anomalias como motivo para gerar algumas opções a mais e filtrar, não para regravar.
Posso fixar o rosto de uma pessoa real? Apenas de pessoas sobre as quais você tem direitos — você mesmo, modelos que consentiram ou embaixadores de marca contratados. Não clone estranhos ou celebridades.
Preciso de fine-tuning ou LoRA? Não. Todo o workflow é sem treinamento — uma imagem de referência e um prompt. É exatamente por isso que o custo por imagem fica na casa dos centavos.
Com qual modelo devo começar? Comece com o nano-banana-2 para a fixação de identidade e com o grok-imagine-1.5 para a etapa de vídeo. Ambos são baratos o suficiente para iterar à vontade; faça upgrade apenas depois de definir o estilo.
Comece a construir
Gere um retrato no nano-banana-2, reenvie-o como image_input para cada cenário e anime seu frame favorito com um modelo de imagem para vídeo — tudo via POST /v1/tasks com uma única chave. A documentação de início rápido cobre autenticação e polling, e você pode comparar cada modelo de imagem e vídeo na página de preços antes de escalar o processamento em lote.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores