
使用ガイド
AI Instagram モデル生成ツール:hiapi 上で一貫性のあるバーチャルインフルエンサーを作る
参照画像で同じ顔を固定し、異なるシーンをバッチ生成し、それを Reels に仕上げる——すべて hiapi の /v1/tasks で完結します。
TL;DR
- AI Instagram モデル生成ツールの本質は3段階のパイプラインです。キャラクターを作成し、その顔を固定してすべてのショットで再現させ、最良の静止画をショート動画に変換します。hiapi は1つの非同期インターフェース
POST /v1/tasksで全3段階を実行します。 - 本ガイドでは参照画像方式でアイデンティティを固定します——ベースとなるポートレートを
image_inputとして送り返し、シーンだけを変えます。これは Consistent Characters with Nano-Banana で紹介されている純テキストの「キャラクター設定集」方式とは異なります。シード画像がまだない場合はそちらを、特定の顔を固定したい場合はこちらを使います。 - 本記事では nano-banana-2 で実測しました。1枚のベースポートレートが3つのまったく異なるシーン——パリのカフェ、都会の横断歩道、屋上ジム——を固定し、顔・髪型・肌色・ゴールドのイヤリング・重ね付けネックレスがすべてのシーンで一貫していました。
- 動画段階は本物で、シミュレーション画像ではありません。下のカフェの静止画は
grok-imagine-1.5/image-to-videoで5秒の短編に仕上げました。彼女はカップを持ち上げて一口飲み、動きの中でもアイデンティティは保たれています。 - このブログ全体の予算:約 $0.30——nano-banana-2 で2K画像を4枚生成し、1枚あたり $0.057($0.228)、さらに480p/5s の Reel 1本を $0.015/s で課金($0.075)。
実際に構築するもの
「バーチャルインフルエンサー」「AI UGC モデル」「AI Instagram モデル生成ツール」——マーケティング上の呼び名はさまざまですが、エンジニアリングの実装は同じ3段階です:
- キャラクター——あなたのモデルの定番の顔となるベースポートレートを生成(または選定)します。
- アイデンティティ固定——同じ人物をさまざまな服装・ポーズ・場所に登場させ、フィードが40人の別人ではなく同じクリエイターに見えるようにします。
- モーション——最もインパクトのある静止画を、スクロールを止めさせる短い Reels / Shorts の短編に仕上げます。
難しいのは第2段階です。下流のすべて——信頼できるフィードグリッド、製品の試着、ブランド投稿——は、顔がずれた瞬間に崩壊します。hiapi ではこれを安定させる方法が2つあります。
顔を固定する2つの方法(そして本ガイドが参照画像方式を選ぶ理由)
| 方法 | アイデンティティの固定方法 | 適した場面 |
|---|---|---|
| キャラクター設定集(テキスト) | 顔・髪型・ワードローブを記述した、密度の高い再利用可能なプロンプト接頭辞を毎回のレンダリングに連結します。シード画像は使いません。 | ゼロからキャラクターを発明し、バージョン管理可能なテキストで定義したい場合。 |
| 参照画像(本ガイド) | ベースポートレートを image_input として送り返し、プロンプトではシーンだけを変えます。 |
すでに承認済みの顔(キービジュアルのレンダリング、ブランドマスコット)があり、その顔をどこにでも登場させたい場合。 |
キャラクター設定集方式は Consistent Characters with Nano-Banana で詳しく解説されています——絵コンテや EC のルックブックの例も含まれます。本ガイドは別の道を進みます。参照画像で特定のポートレートを固定し、それを複数シーンに展開して動画に仕上げます。両者は補完関係にあり、多くのチームはまず設定集を一度書いてキービジュアルのポートレートを生成し、残りの撮影では参照画像モードに切り替えます。
ステップ1——ベースキャラクターを生成する
清潔で十分な光の当たったポートレートから始めます。ここではディテールが味方になります。不変の特徴が具体的であるほど(ほくろ、分け目、ジュエリー)、引き継ぎやすくなります。
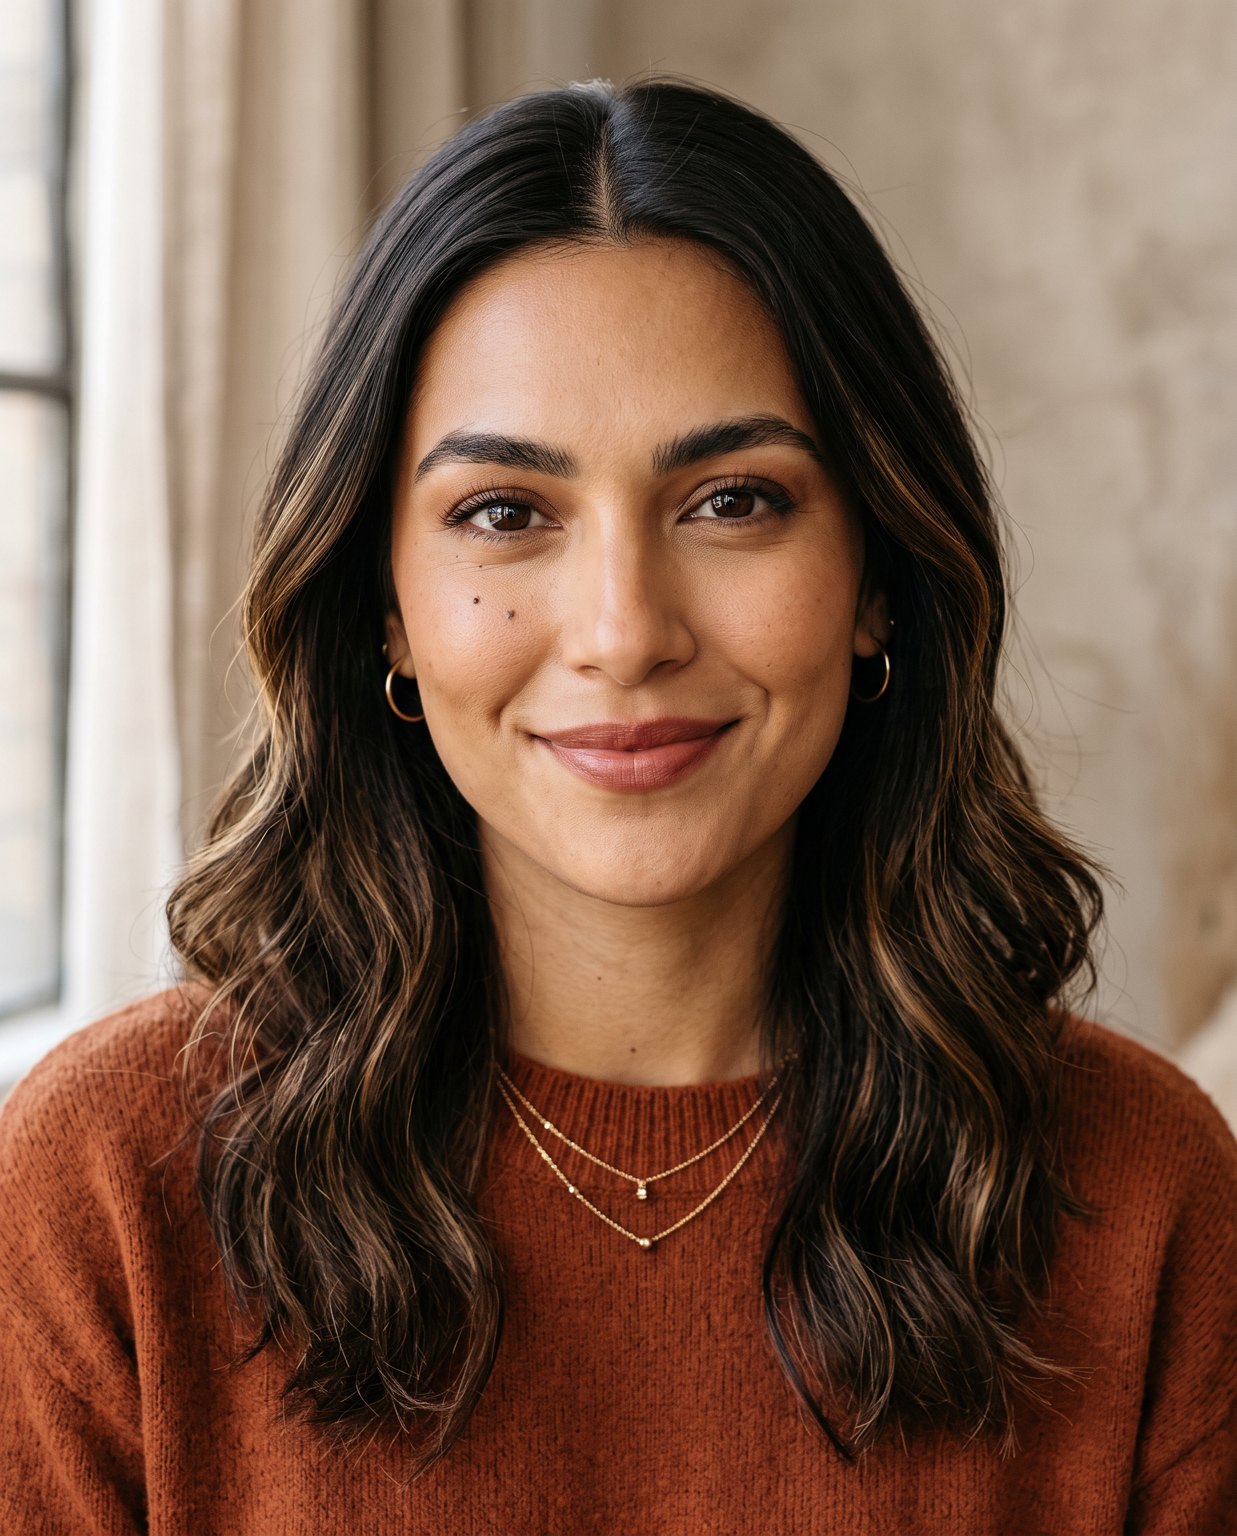
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks は taskId を返します。GET /v1/tasks/{taskId} をポーリングして status が success になるまで待ち、output[0].url をダウンロードします。この URL は一時的(expireAt 付き)なので、すぐにバイト列を保存してください——ホットリンクしないでください。次のステップで入力 URL として必要になるため、ポートレートをアクセス可能な場所(自前の CDN)にアップロードします。nano-banana-2 の料金は1K / 2K / 4K でそれぞれ $0.036 / $0.057 / $0.086 です。ここでの撮影では2Kを使用しました。
ステップ2——シーンをまたいでアイデンティティを固定する
これをインフルエンサーにし、見知らぬ人のギャラリーにしないための重要なステップです。ベースポートレートを image_input として送り返し、この人物を保つことを明示しつつ新しいシーンだけを記述するプロンプトを書きます。
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
重要なフィールドは image_input——参照 URL の配列です。以下は同じベースポートレートを3つの無関係な環境に配置したもので、各レンダリングはその1枚のポートレートに固定されています:
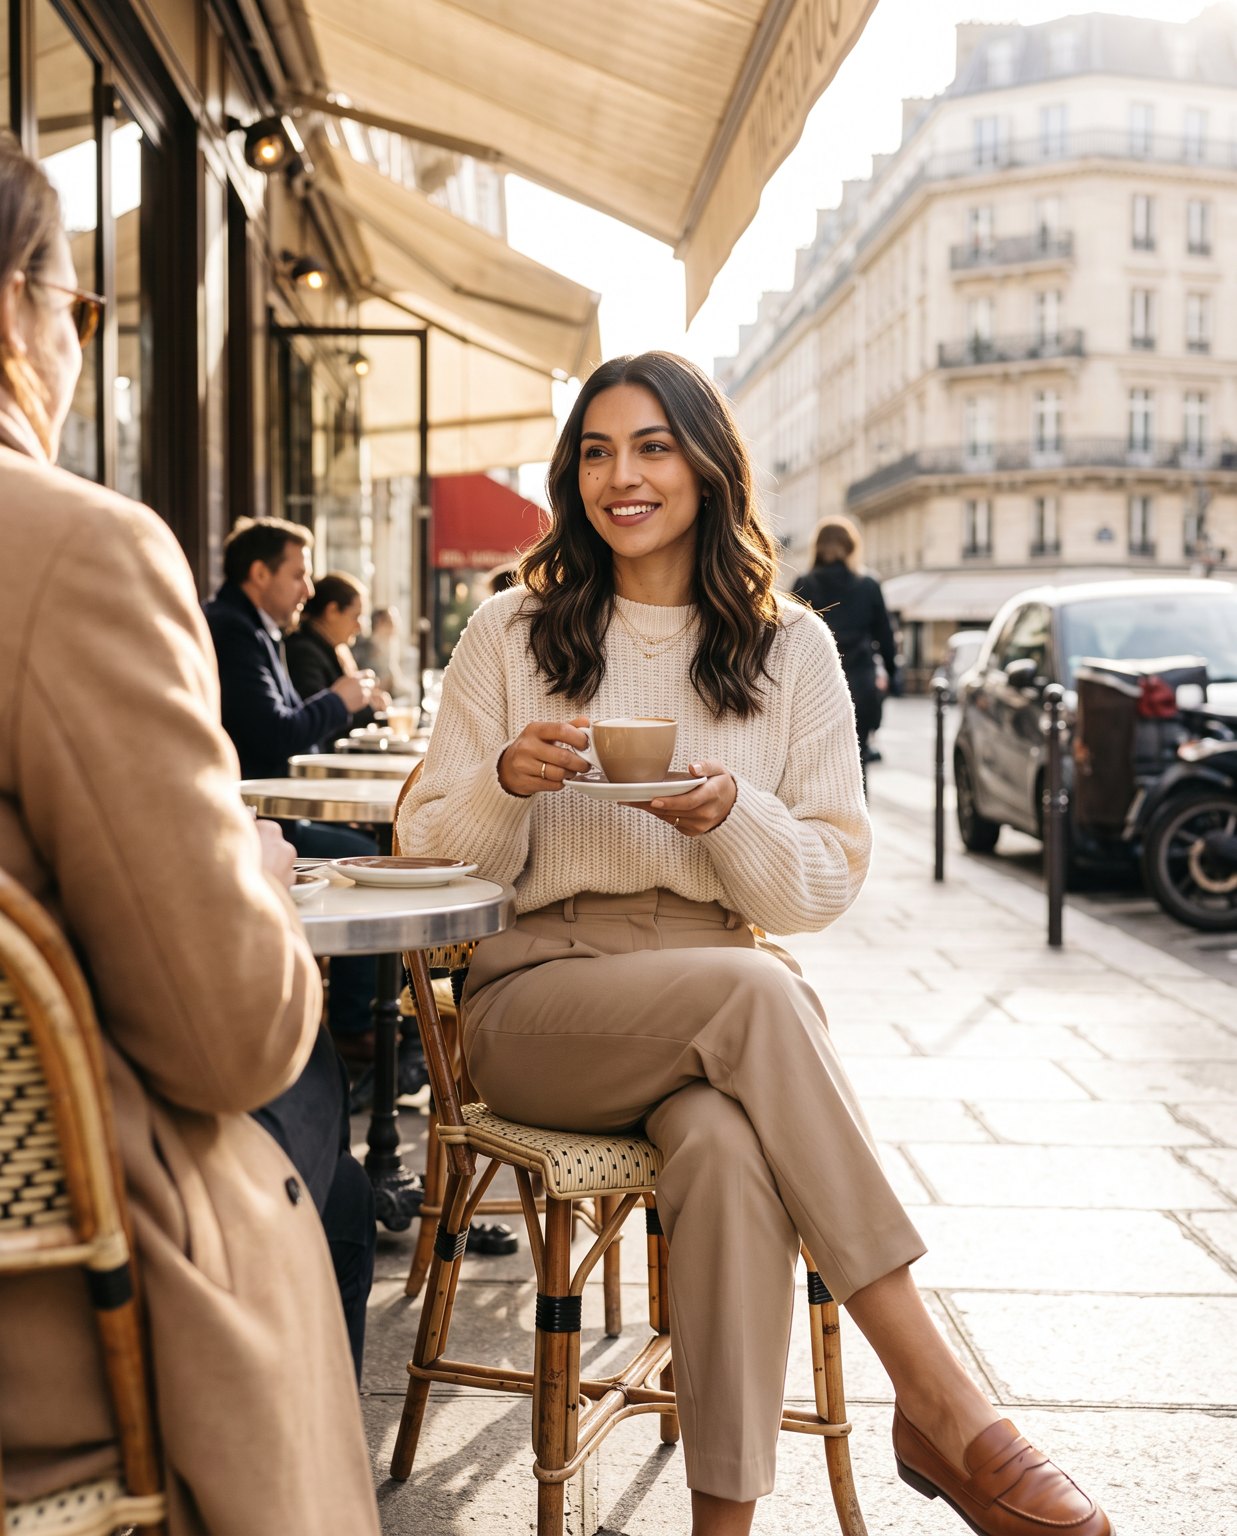
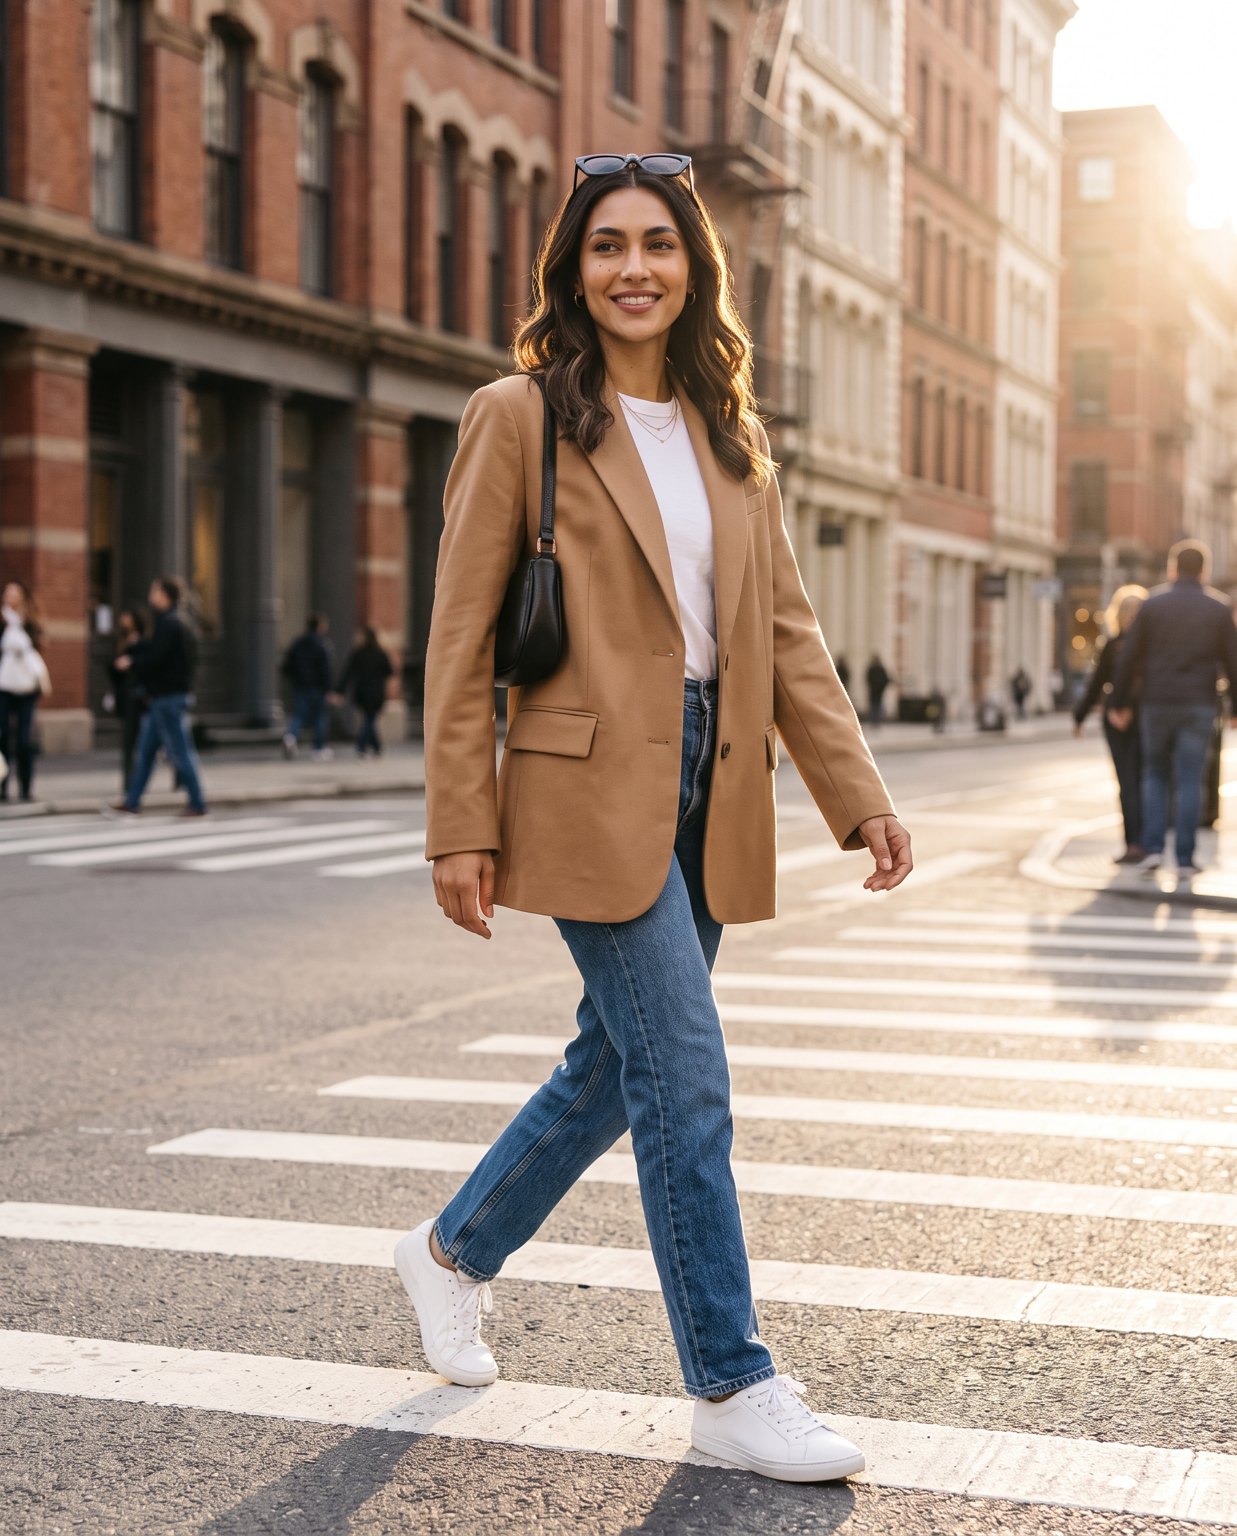
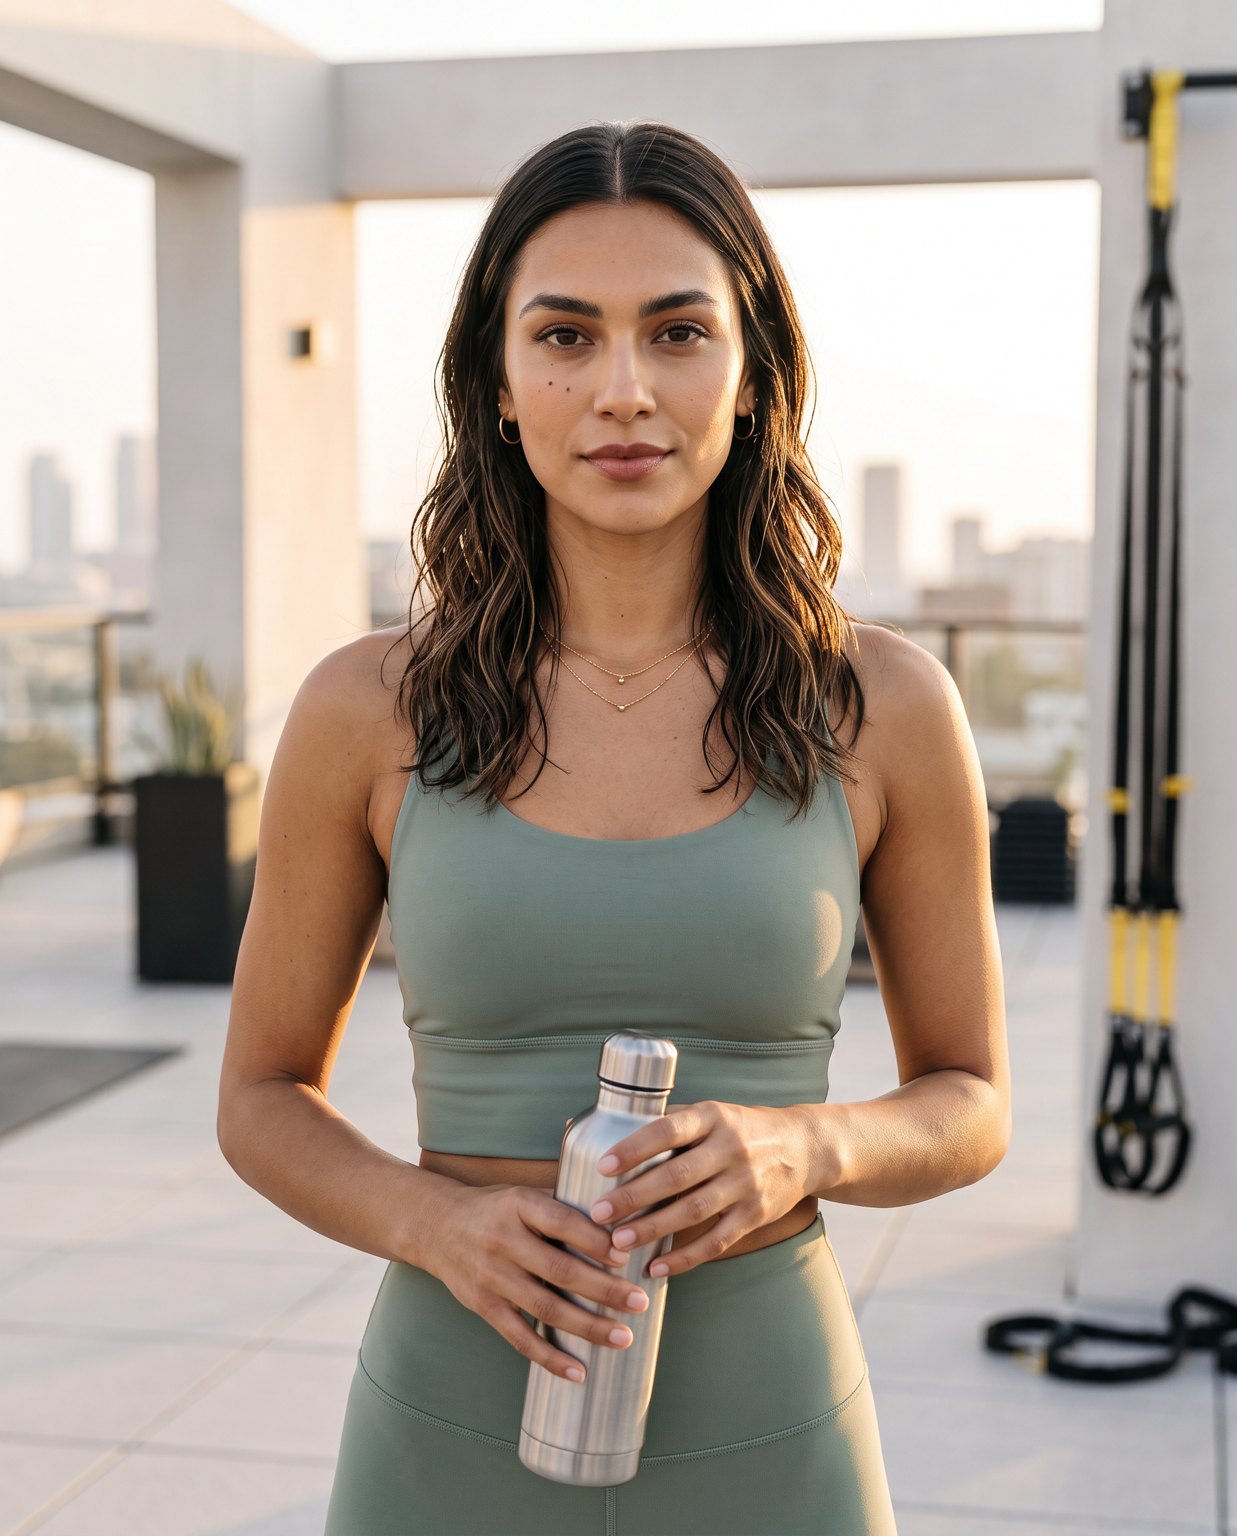
今回の実行で実際に保たれたもの:カフェ、街路、ジムの3つのレンダリングで、顔の骨格、肌色、キャラメルハイライト入りのウェーブヘア、ゴールドのイヤリング、細い重ね付けネックレスが同じ識別可能な人物として保たれました。唯一の注意点は微細なディテールです——ほくろや1本の後れ毛の正確な位置は最初にずれます。効果的な修正方法は、すべてのレンダリングをあの1枚の元ポートレートに固定することであり、連鎖的に渡すこと(シーンAの出力をシーンBの入力にする)ではありません。連鎖させると小さなずれが蓄積しますが、単一の固定アンカーなら蓄積しません。
ステップ3——静止画を Reel に変える
フィードには動きが必要です。固定済みの静止画を選び、画像→動画モデルに送ります。下の短編は上のカフェ写真を grok-imagine-1.5/image-to-video で実際にアニメーション化したものです:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
ここでは入力フィールドが異なることに注意してください。動画モデルは image_input ではなく image_urls(および秒単位の duration)を使います。テストクリップは480p、縦向き、5秒で返されました——彼女はプロンプト通りにカップを持ち上げて一口飲み、動きの中でも顔は同じ人物のままでした。$0.015/s で計算すると、この Reel は約 $0.075 かかりました。より鮮明な出力が必要なら、同じ静止画をそのまま veo-3.1-lite、kling-3.0、hailuo-2.3 に送れます——下の表を参照してください。
バッチ処理:1つの参照、複数のシーン
バーチャルモデルの真価は量にあります。シーンプロンプトのリストを保持し、1枚のベースポートレートに対してループ実行します:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
モデル文字列を差し替えれば、参照画像をサポートする任意の画像モデルで同じループを実行できますし、完成した静止画を動画ループに送ることもできます。
アイデンティティ固定段階のモデル候補
価格は執筆時点の /api/pricing における現在の1画像あたりの価格です。大量処理の前に必ず再確認してください。
| モデル | 参照入力 | 価格(USD) | 備考 |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086(1K/2K/4K) | 本記事で使用。顔の引き継ぎが強く、4K対応 |
| nano-banana-pro | image_input |
$0.057(1K と 2K)/ $0.10(4K) | 同シリーズの上位版 |
gpt-image-2 /image-to-image@ext |
最大16枚の参照画像 | 最安 $0.007(低品質、1K) | 最も安価なマルチ参照ルート、4K出力 |
flux-2 /image-to-image |
マルチ参照 | $0.035(1K)/ $0.05(2K) | 高忠実度のマルチ参照編集 |
seedream-5.0-pro /image-to-image |
マルチ参照 | $0.06(1K)/ $0.10(2K) | フラッグシップ品質のマルチ参照 |
ラインナップ全体は モデルマーケットプレイス でご覧ください。単一の固定顔なら参照画像1枚で十分です。gpt-image-2 の16枚参照ルートは、顔・服装・製品を1回のレンダリングで融合させたいときに真価を発揮します。
動画段階のモデル候補
課金方式が異なります——ほとんどは秒単位ですが、hailuo は固定クリップ長の定額で課金されます。バッチ予算を組む際はこの違いに注意してください。
| モデル | 課金方式 | コスト例 | 備考 |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
秒単位 | $0.015/s(480p)、$0.0282/s(720p) | 本記事で使用。最安、1〜15秒 |
veo-3.1-lite /image-to-video |
秒単位 | $0.06/s(720p、音声なし)→ $0.14/s(1080p) | 品質とコストのバランスが良好 |
kling-3.0 /image-to-video |
秒単位 | $0.10/s(720p)→ $0.129/s(1080p)、音声付きはさらに高額 | ネイティブ音声、最大4K |
hailuo-2.3-fast /image-to-video |
クリップ単位 | $0.27(6s)/ $0.46(10s) | 固定長の段階別定額課金 |
wan2.7-video /image-to-video |
秒単位 | $0.10/s(720P)/ $0.167/s(1080P) | 先頭フレーム駆動 |
veo-3.1 /image-to-video |
秒単位 | 音声込み $0.57/s → $0.86/s(4K) | 映画級のグレード。5秒クリップで約 $2.85 なので尺を制限すること |
したがって、5秒の Reel のコストは grok-imagine-1.5 の約 $0.075 からフル veo-3.1 の約 $2.85 まで幅があり、38倍の差になります。まず安価なグレードでプロトタイプを作り、実際に公開するクリップだけをアップグレードしてください。
実際に効く一貫性のコツ
- 固定せよ、連鎖させるな。元のベースポートレートを毎回のレンダリングに送ります。前回の出力を次回の入力にすると、顔がいとこのような別人になるまで小さなずれが蓄積します。
- 不変の特徴をプロンプトに書く。「左目の下の同じほくろ、同じゴールドのイヤリング」は「同じ女性」よりもはるかに有効です。モデルに変えてはいけないものを伝えているのです。
- チャネルごとに1つのアスペクト比を保つ。フィードグリッドは 4:5、Reels は 9:16。撮影の途中で切り替えると不格好な再クロップが強いられ、顔が切れることがあります。
- 解像度をモデルのグレードに固定する。
nano-banana-2は1K/2K/4Kを受け付けます。明示的に設定すれば、バッチ処理でサイズがこっそり混在しません。 - 最も強いポートレートを永久資産として残す。これがあなたの「キャスティング」です——キャンペーンごとに新しい顔を再生成するのではなく、数ヶ月にわたって再利用しましょう。
本記事のコスト
| 項目 | モデル | 数量 | 単価 | 小計 |
|---|---|---|---|---|
| ベースポートレート + 3シーンのレンダリング | nano-banana-2(2K) | 4 | $0.057 | $0.228 |
| カフェの Reel | grok-imagine-1.5(480p、5s) | 1 | $0.015/s | $0.075 |
| 合計 | 約 $0.30 |
30投稿の完全な公開グリッドと数本の Reel を合わせても、総額は1桁ドルの低い側に収まります——これこそチームが撮影ではなく生成ツールを選ぶ本当の理由です。
FAQ
毎回、顔が完全に同じになることは保証されますか? ピクセル単位で同じ顔を保証できるモデルはありませんが、今回のテストでは nano-banana-2 の参照画像固定が3つの非常に異なるシーンで同じ識別可能な人物を保ちました。たまに起きる異常は、撮り直しではなく、何枚か多めに生成して選別する理由と捉えてください。
実在の人物の顔を固定できますか? 権利を持つ人物のみです——自分自身、同意を得たモデル、または契約したブランドアンバサダー。見知らぬ人や有名人をクローンしないでください。
ファインチューニングや LoRA は必要ですか? 不要です。ワークフロー全体がゼロトレーニングです——参照画像1枚とプロンプト1つだけ。これが1画像あたりのコストを数セントに抑えている理由です。
どのモデルから始めるべきですか? アイデンティティ固定は nano-banana-2 から、動画段階は grok-imagine-1.5 から始めましょう。どちらも自由に反復できるほど安価です。スタイルが固まってからアップグレードしてください。
構築を始める
nano-banana-2 でポートレートを生成し、それを image_input として各シーンに送り返し、お気に入りのフレームを画像→動画モデルでアニメーション化します——すべて1つのキーで POST /v1/tasks を通じて完結します。クイックスタートドキュメント で認証とポーリングを解説していますので、バッチを拡張する前に 料金ページ で各画像・動画モデルを比較してください。


