
사용 가이드
AI Instagram 모델 생성기: hiapi에서 일관된 가상 인플루언서 만들기
참조 이미지로 같은 얼굴을 고정하고, 다양한 장면을 대량 생성한 뒤, 이를 Reels로 제작하세요—모두 hiapi의 /v1/tasks를 통해 이루어집니다.
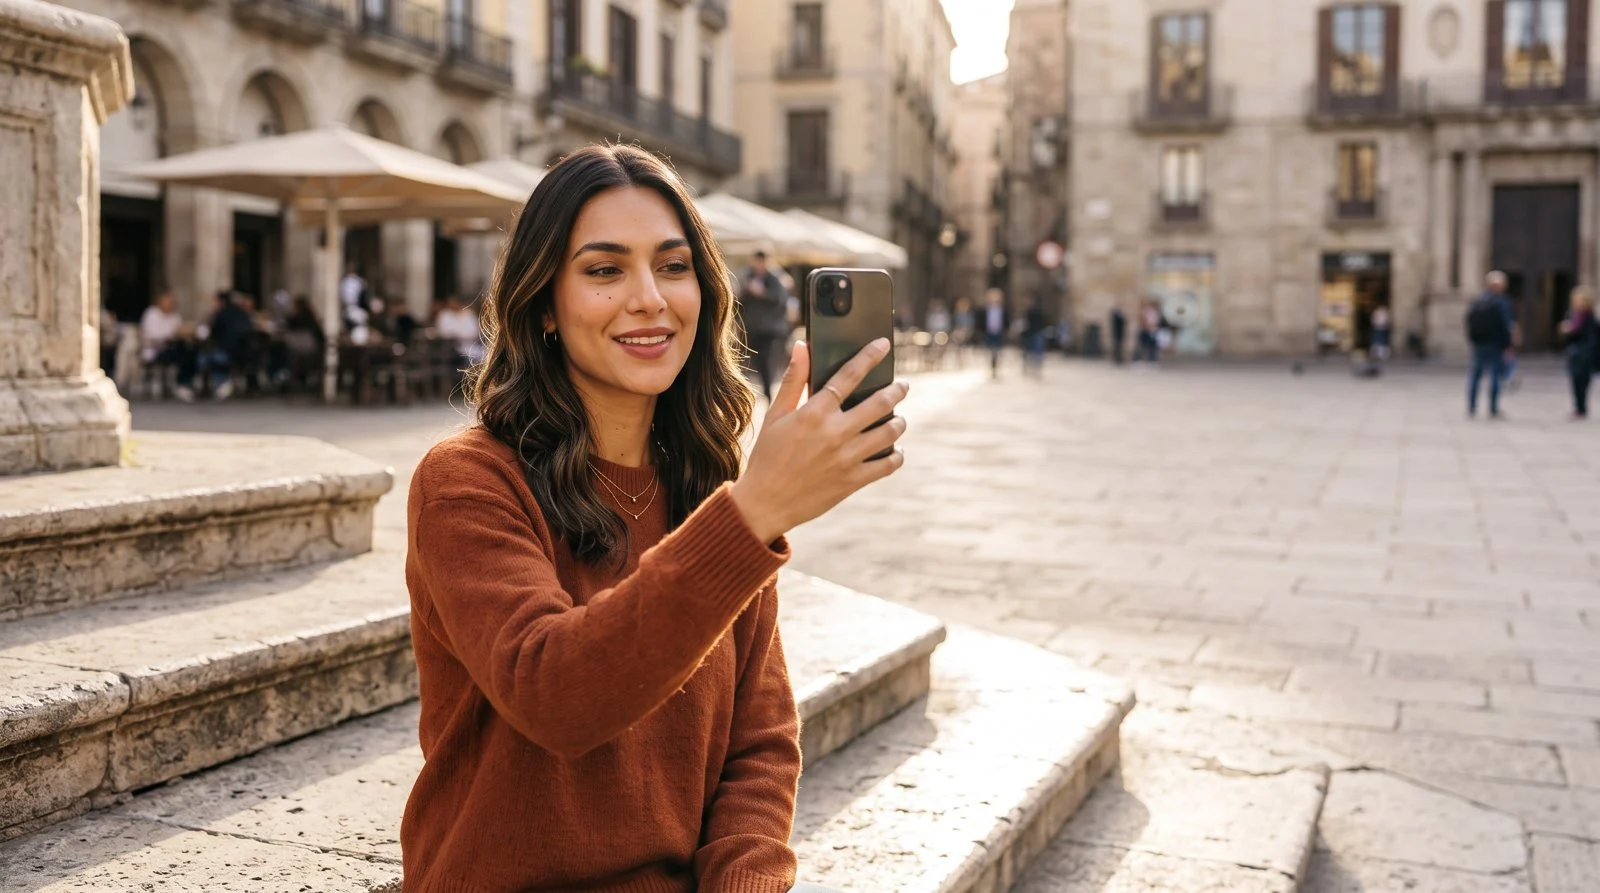
TL;DR
- AI Instagram 모델 생성기는 본질적으로 3단계 파이프라인입니다: 캐릭터를 생성하고, 그 얼굴을 고정하여 모든 샷에서 재현되게 하며, 최고의 정지 프레임을 짧은 영상으로 변환합니다. hiapi는 하나의 비동기 인터페이스
POST /v1/tasks를 통해 세 단계를 모두 실행합니다. - 이 가이드는 참조 이미지 경로로 신원을 고정합니다—기본 인물 사진을
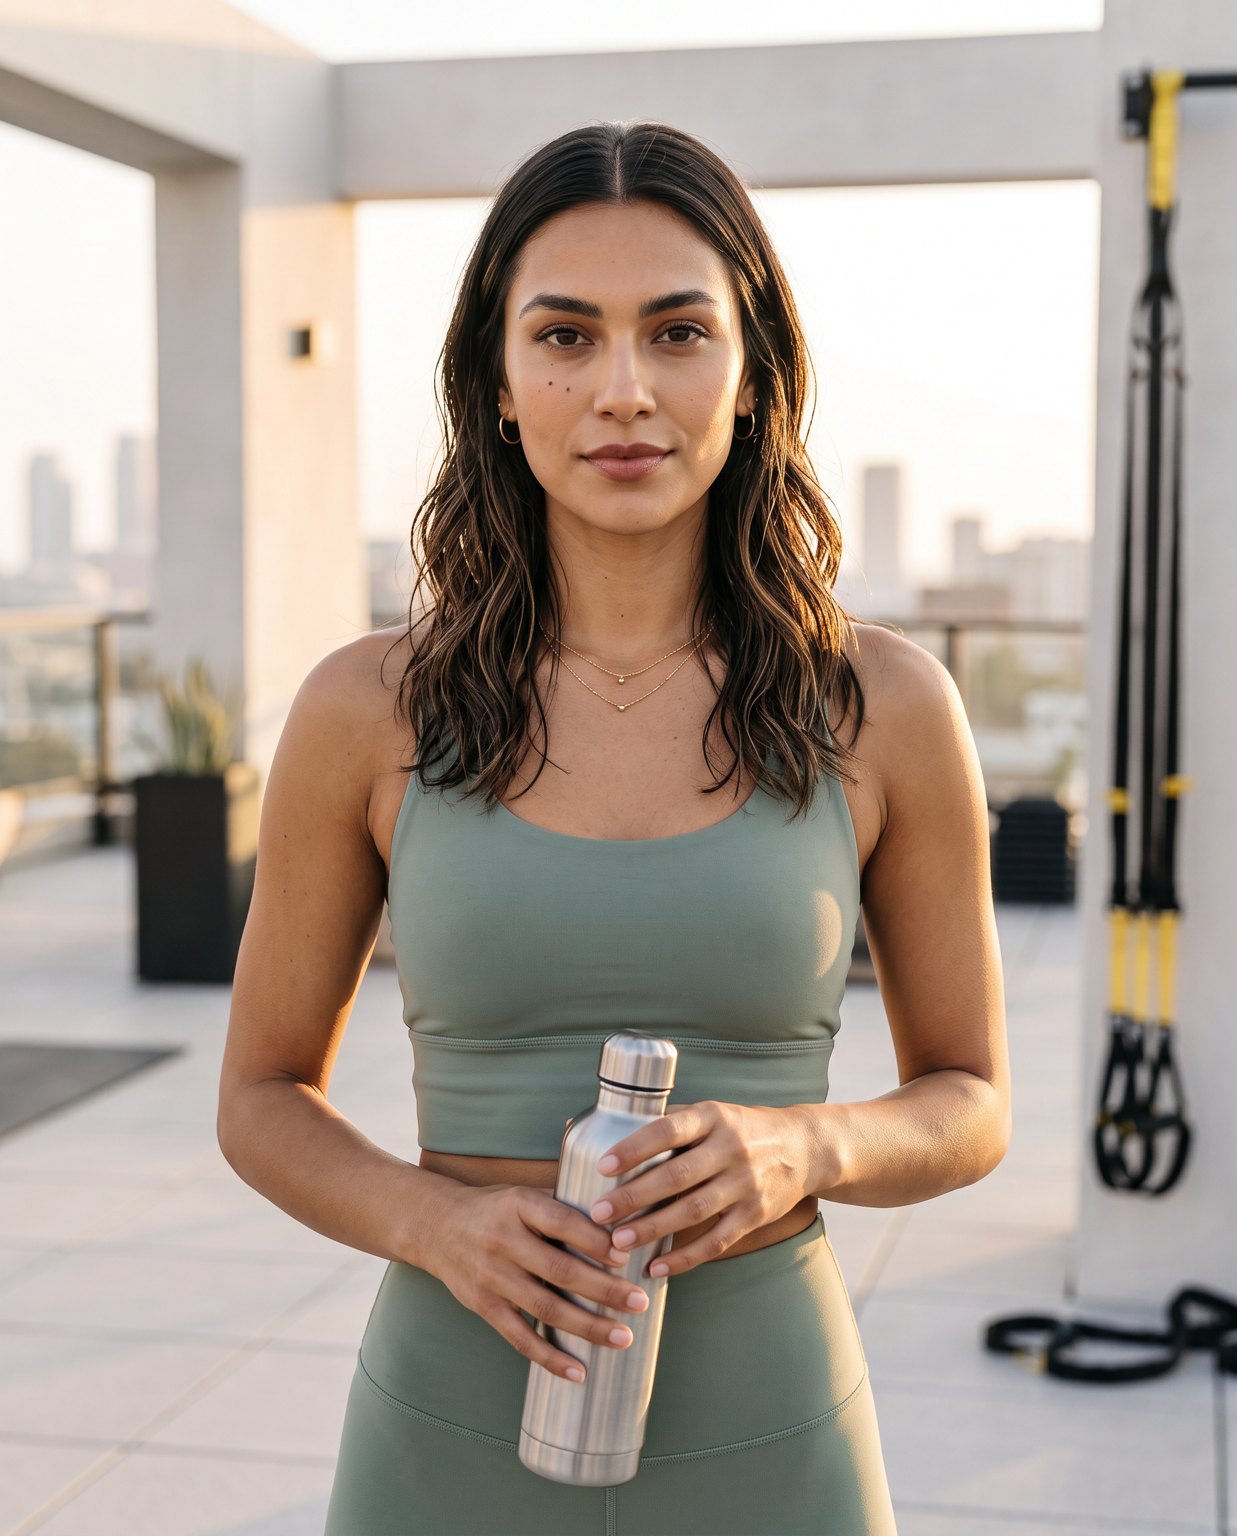
image_input으로 되돌려 보내고 장면만 변경합니다. 이는 Consistent Characters with Nano-Banana에서 소개한 순수 텍스트 「캐릭터 설정집」 방식과 다릅니다; 시드 이미지가 아직 없을 때는 그쪽을, 얼굴 하나를 고정하고 싶을 때는 이쪽을 사용하세요. - 본문은 nano-banana-2에서 실측했습니다: 기본 인물 사진 하나가 파리 카페, 도시 횡단보도, 루프탑 체육관이라는 세 가지 완전히 다른 장면을 고정했습니다—얼굴, 헤어스타일, 피부톤, 금색 이어링, 레이어드 목걸이가 모든 장면에서 일관되게 유지되었습니다.
- 영상 단계는 실제이며 모의 이미지가 아닙니다: 아래 카페 정지 프레임은
grok-imagine-1.5/image-to-video로 5초 단편으로 제작되었습니다. 그녀가 컵을 들어 한 모금 마셨고; 신원은 움직임 속에서도 유지됩니다. - 전체 블로그 예산: 약 $0.30—nano-banana-2에서 2K 이미지 4장, 장당 $0.057($0.228), 그리고 480p/5s Reel 하나를 $0.015/s로 청구($0.075).
실제로 구축하는 것
「가상 인플루언서」「AI UGC 모델」「AI Instagram 모델 생성기」—마케팅 명칭은 각양각색이지만, 엔지니어링 구현은 모두 동일한 세 단계입니다:
- 캐릭터—모델의 정전 얼굴이 될 기본 인물 사진을 생성(또는 선택)합니다.
- 신원 고정—동일 인물이 다양한 의상, 포즈, 장소에 등장하게 하여 피드가 마흔 명의 다른 사람이 아닌 같은 크리에이터처럼 보이게 합니다.
- 모션—가장 임팩트 있는 정지 프레임을 짧고 스크롤을 멈추게 하는 Reels / Shorts 단편으로 제작합니다.
어려운 점은 2단계입니다. 모든 하위 요소—신뢰할 수 있는 피드 그리드, 제품 착용샷, 브랜드 게시물—는 얼굴이 흔들리는 순간 무너집니다. hiapi에는 이를 안정시키는 두 가지 방법이 있습니다.
얼굴을 고정하는 두 가지 방법(그리고 이 가이드가 참조 이미지 경로를 선택한 이유)
| 방법 | 신원 고정 방식 | 적용 시나리오 |
|---|---|---|
| 캐릭터 설정집(텍스트) | 얼굴, 헤어스타일, 옷장을 묘사하는 밀도 높은 재사용 가능 프롬프트 접두사를 매 렌더링에 이어 붙입니다. 시드 이미지 없음. | 캐릭터를 처음부터 발명하고, 버전 관리가 가능한 텍스트로 정의하고 싶을 때. |
| 참조 이미지(이 가이드) | 기본 인물 사진을 image_input으로 되돌려 보내고; 프롬프트는 장면만 변경합니다. |
이미 승인된 얼굴(키 비주얼 렌더링, 브랜드 마스코트)이 있고 그 얼굴이 모든 곳에 나타나길 원할 때. |
캐릭터 설정집 방법은 Consistent Characters with Nano-Banana에서 전체 소개됩니다—스토리보드와 이커머스 스타일북 예시 포함. 이 가이드는 다른 길을 갑니다: 참조 이미지로 특정 인물 사진을 고정한 뒤 여러 장면으로 확장하고 영상으로 제작합니다. 두 방법은 상호 보완적이며; 많은 팀이 먼저 설정집을 한 번 작성하고 키 비주얼 인물 사진을 생성한 뒤, 촬영의 나머지 부분에서 참조 이미지 모드로 전환합니다.
1단계—기본 캐릭터 생성
깨끗하고 조명이 밝은 인물 사진으로 시작하세요. 디테일이 여기서는 아군입니다: 불변 특징이 구체적일수록(점 하나, 가르마 하나, 주얼리 하나) 이어가기 더 쉽습니다.
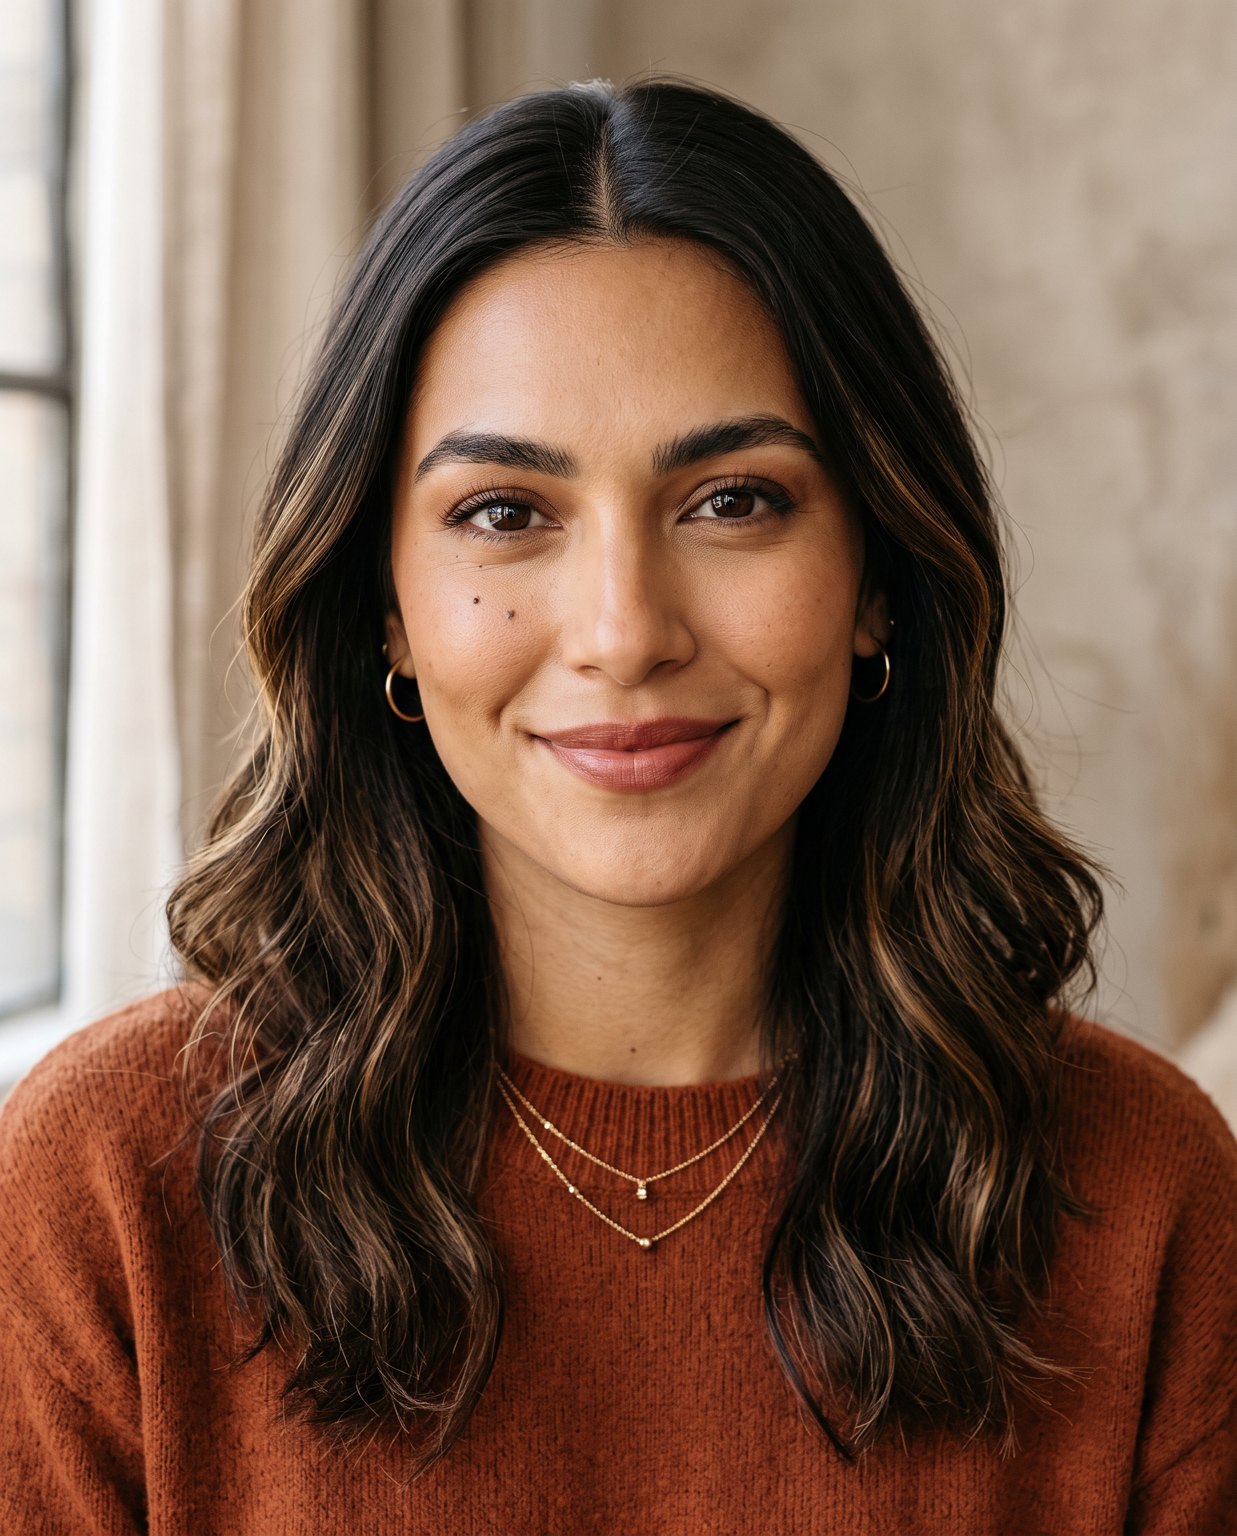
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Editorial portrait of a 25-year-old woman, warm olive skin, oval face, a small beauty mark just below her left eye, deep brown almond eyes, shoulder-length dark brown wavy hair with a center part and subtle caramel balayage, tiny gold hoop earrings, a thin layered gold necklace, natural bronze makeup, soft confident smile, 85mm f/1.8, soft window light, clean neutral background, true-to-life skin texture, 4k",
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
POST /v1/tasks는 taskId를 반환합니다; status가 success가 될 때까지 GET /v1/tasks/{taskId}를 폴링한 뒤 output[0].url을 다운로드하세요. 해당 URL은 임시이며(expireAt 포함), 즉시 바이트를 저장하세요—핫링크하지 마세요. 다음 단계에서 입력 URL로 필요하므로 인물 사진을 접근 가능한 위치(자체 CDN)에 업로드하세요. nano-banana-2는 1K / 2K / 4K에서 각각 $0.036 / $0.057 / $0.086로 가격이 책정됩니다; 여기 촬영은 2K를 사용했습니다.
2단계—장면 전반에 걸쳐 신원 고정
이것이 인플루언서로 만드는 결정적 단계이며, 낯선 사람 갤러리가 아닙니다. 기본 인물 사진을 image_input으로 되돌려 보내고, 이 사람을 유지함을 명확히 밝히며 새 장면만 묘사하는 프롬프트를 작성하세요.
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "nano-banana-2",
    "input": {
      "prompt": "Keep the exact same woman from the reference image: identical face and bone structure, the beauty mark below her left eye, same hair color and style, same gold hoop earrings and layered necklace. Full-body candid photo of her at a sunlit Parisian sidewalk cafe holding a cappuccino, cream knit sweater and beige trousers, warm morning light, shallow depth of field, photorealistic, 4k",
      "image_input": ["https://your-cdn.example.com/base-portrait.jpg"],
      "aspect_ratio": "4:5",
      "resolution": "2K"
    }
  }'
핵심 필드는 image_input—참조 URL 배열입니다. 아래는 동일한 기본 인물 사진을 세 가지 무관한 환경에 배치한 것으로, 각 렌더링이 그 한 장의 인물 사진에 고정됩니다:
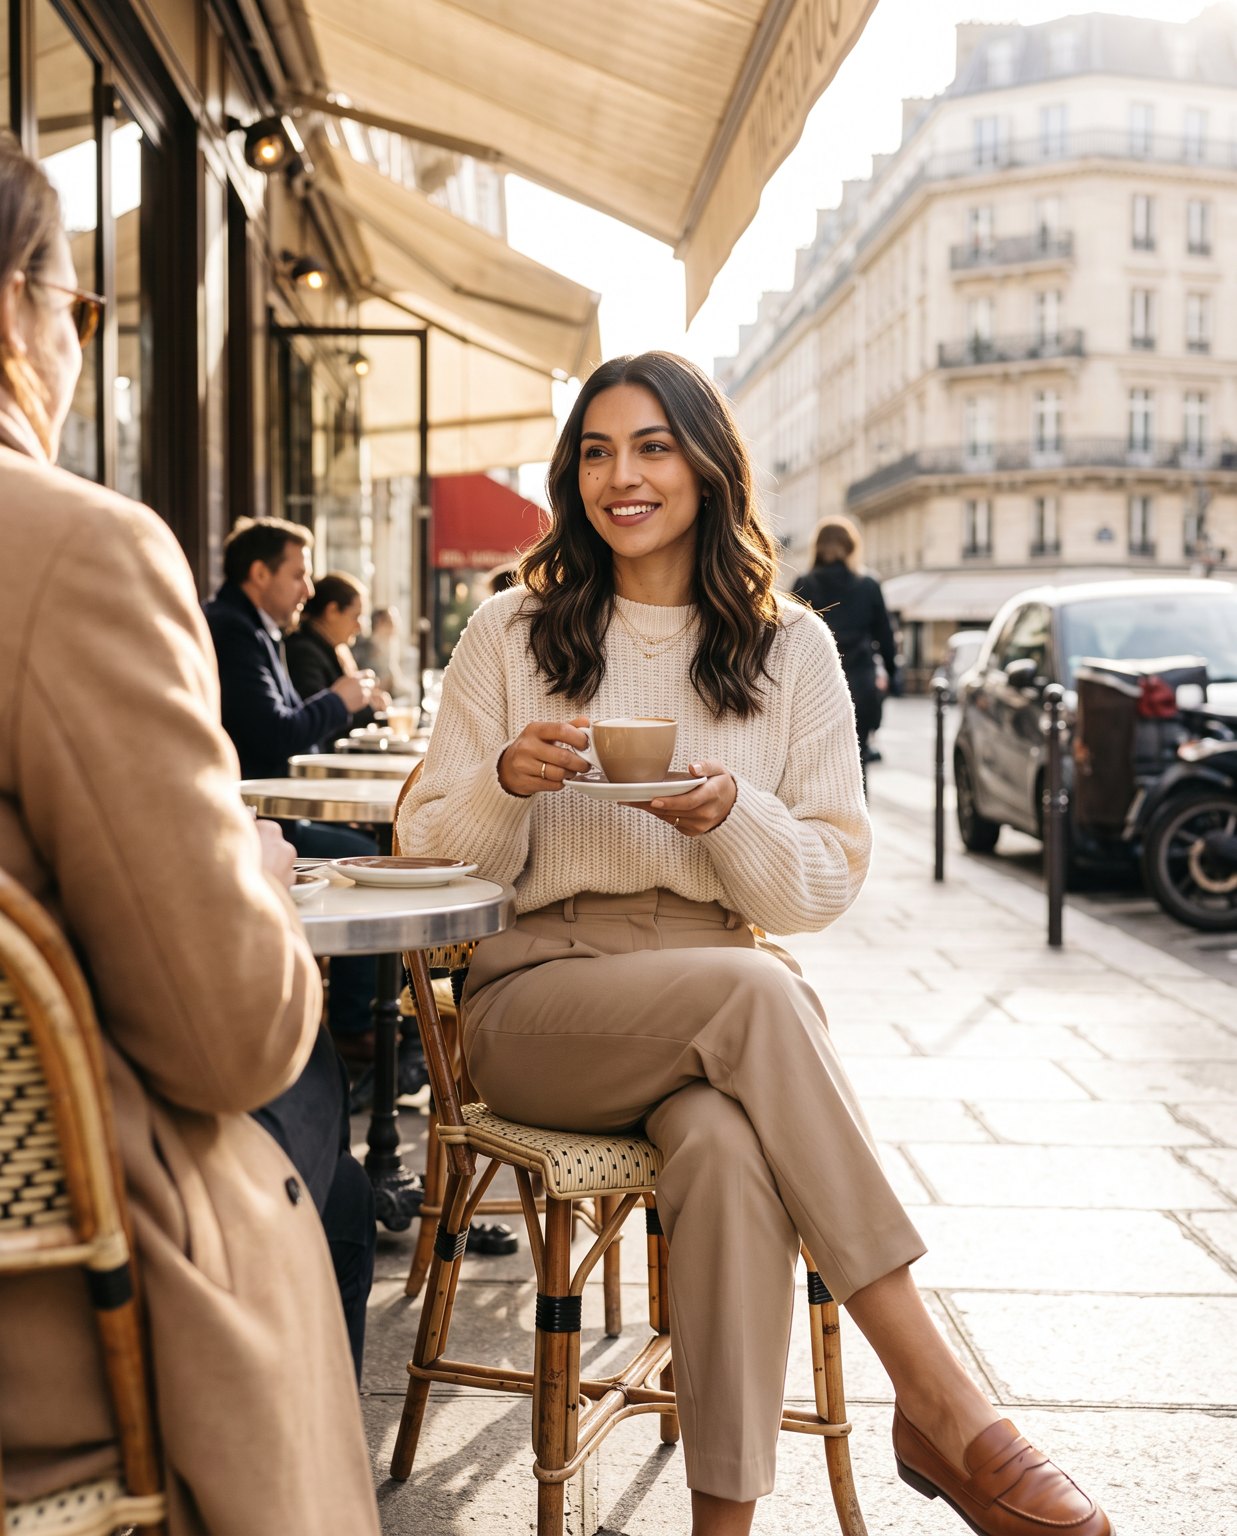
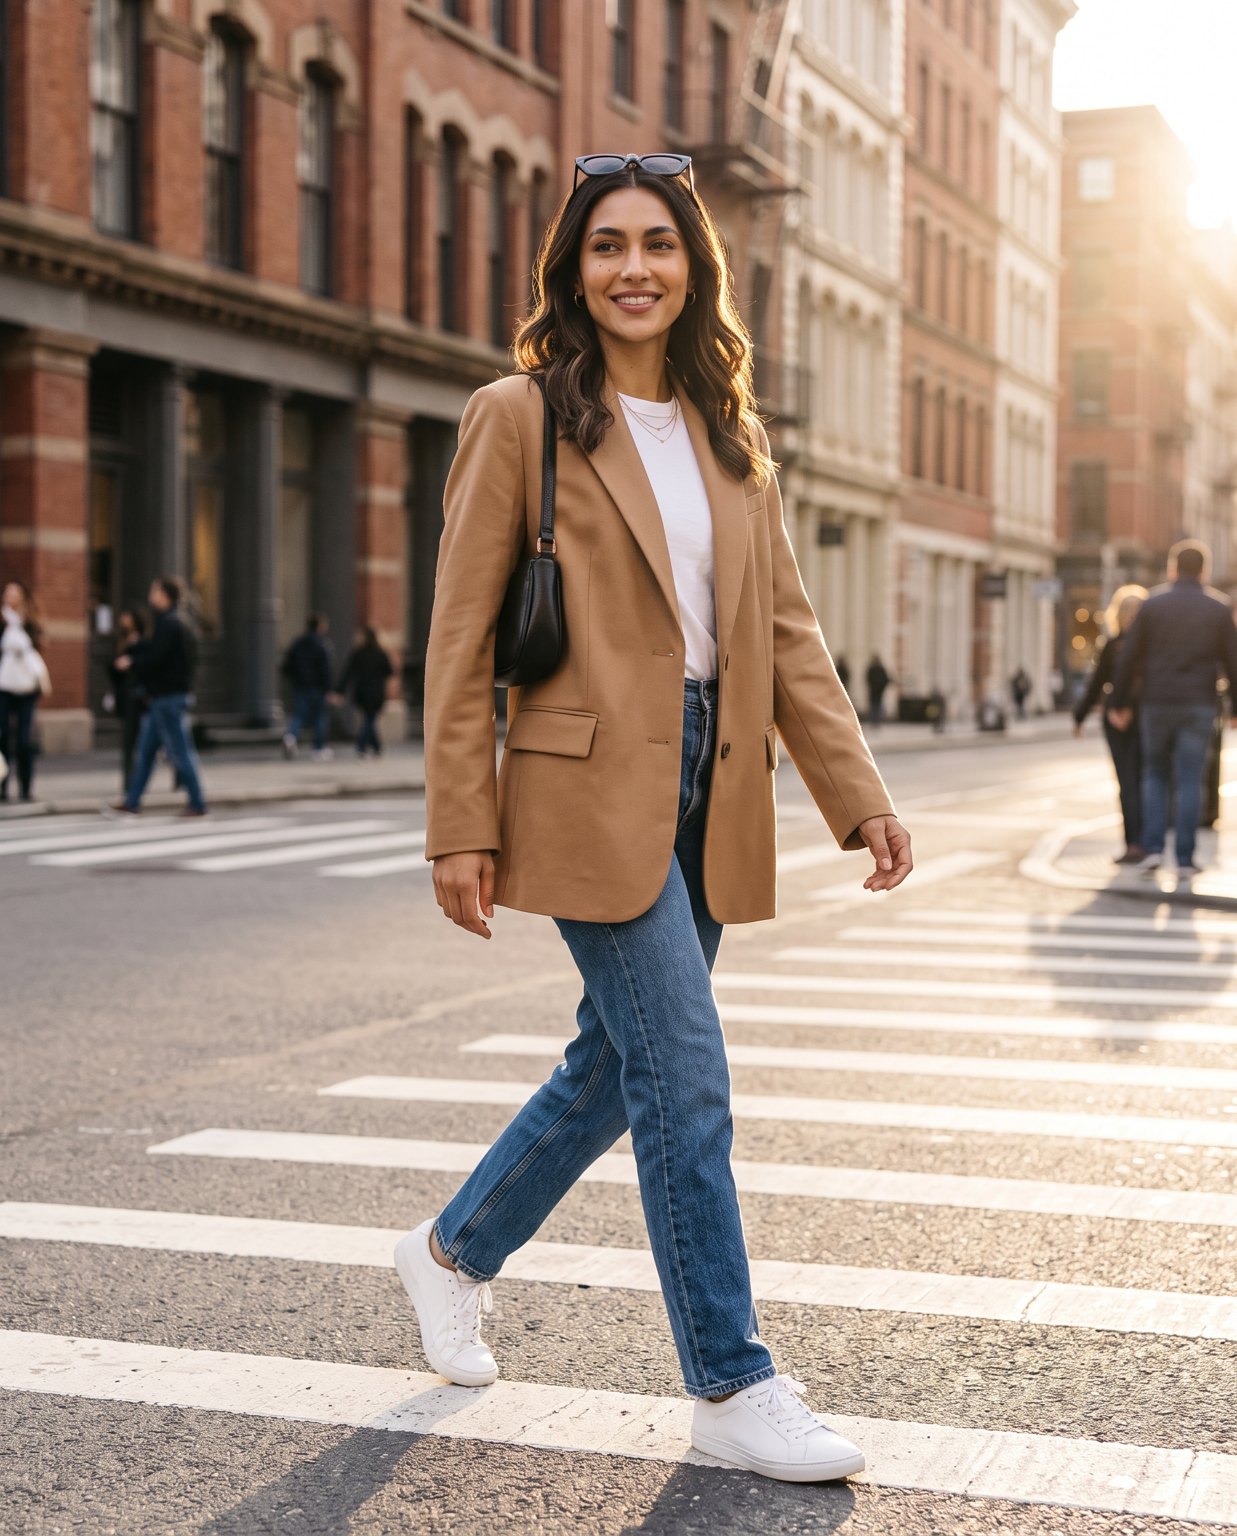
이번 실행에서 실제로 유지된 것: 카페, 거리, 체육관 세 렌더링 모두에서 얼굴 기하 구조, 피부톤, 캐러멜 발레아주가 들어간 웨이브 헤어, 금색 이어링, 얇은 레이어드 목걸이가 동일한 식별 가능한 사람으로 유지되었습니다. 유일한 주의점은 미세 디테일—점이나 잔머리 한 올의 정확한 위치가 가장 먼저 흔들립니다. 효과적인 수정 방법은 모든 렌더링을 그 원본 인물 사진에 고정하는 것이며, 체인 전달(장면 A의 출력을 장면 B의 입력으로 사용)이 아닙니다. 체인 전달은 작은 흔들림을 누적시키지만; 단일 고정 앵커는 그렇지 않습니다.
3단계—정지 프레임을 Reel로 변환
피드에는 움직임이 필요합니다. 고정된 정지 프레임을 아무거나 골라 이미지-투-비디오 모델에 보내세요. 아래 단편은 위의 카페 사진을 grok-imagine-1.5/image-to-video로 실제 제작한 애니메이션입니다:
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_TOKEN" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-imagine-1.5/image-to-video",
    "input": {
      "prompt": "The woman lifts her cappuccino and takes a gentle sip, then lowers it with a soft smile; steam rises faintly, her hair sways slightly, pedestrians stroll past in the soft-focus background. Subtle, natural, cinematic handheld motion.",
      "image_urls": ["https://your-cdn.example.com/02-cafe.jpg"],
      "duration": 5
    }
  }'
여기서 입력 필드가 다르다는 점에 주목하세요: 비디오 모델은 image_input 대신 image_urls(그리고 초 단위의 duration)를 사용합니다. 테스트 클립은 480p, 세로, 5초로 반환되었습니다—그녀는 프롬프트대로 컵을 들어 한 모금 마셨고, 얼굴은 움직임 속에서도 같은 사람입니다. $0.015/s로 계산하면 이 Reel은 약 $0.075입니다. 더 선명한 출력을 원한다면 같은 정지 프레임을 veo-3.1-lite, kling-3.0, hailuo-2.3에 직접 보낼 수 있습니다—아래 표 참조.
배치 처리: 하나의 참조, 여러 장면
가상 모델의 존재 이유는 수량입니다. 장면 프롬프트 목록을 유지하고 단일 기본 인물 사진에 대해 반복 실행하세요:
import os, json, time, subprocess

TOKEN = os.environ["HIAPI_TOKEN"]
BASE = "https://api.hiapi.ai/v1/tasks"
REFERENCE = "https://your-cdn.example.com/base-portrait.jpg"
ANCHOR = ("Keep the exact same woman from the reference image: identical face, "
          "beauty mark below the left eye, same hair, same gold hoops and necklace. ")

scenes = {
    "beach":   "Full-body photo on a golden-hour beach, linen dress, wind in her hair.",
    "office":  "Candid shot at a bright co-working desk, blazer, laptop, coffee.",
    "market":  "Walking through a flower market, tote bag, relaxed smile.",
}

def post(model, payload):
    r = subprocess.run(["curl","-s","-X","POST",BASE,
        "-H",f"Authorization: Bearer {TOKEN}","-H","Content-Type: application/json",
        "-d",json.dumps(payload)], capture_output=True, text=True)
    return json.loads(r.stdout)["data"]["taskId"]

def wait(task_id):
    while True:
        r = subprocess.run(["curl","-s",f"{BASE}/{task_id}",
            "-H",f"Authorization: Bearer {TOKEN}"], capture_output=True, text=True)
        t = json.loads(r.stdout)["data"]
        if t["status"] == "success": return t["output"][0]["url"]
        if t["status"] == "fail":    raise RuntimeError(t.get("error"))
        time.sleep(5)

for name, scene in scenes.items():
    tid = post("nano-banana-2", {"input": {
        "prompt": ANCHOR + scene,
        "image_input": [REFERENCE],
        "aspect_ratio": "4:5", "resolution": "2K",
    }, "model": "nano-banana-2"})
    print(name, "->", wait(tid))
모델 문자열을 바꾸면 참조 이미지를 지원하는 모든 이미지 모델에서 동일한 루프를 실행하거나, 완성된 정지 프레임을 비디오 루프에 보낼 수 있습니다.
신원 고정 단계 선택 가능 모델
가격은 작성 시점 /api/pricing의 현행 이미지당 가격입니다; 대량 처리 전 반드시 재확인하세요.
| 모델 | 참조 입력 | 가격(USD) | 비고 |
|---|---|---|---|
| nano-banana-2 | image_input |
$0.036 / $0.057 / $0.086(1K/2K/4K) | 본문 사용; 얼굴 연속성 강함, 4K 지원 |
| nano-banana-pro | image_input |
$0.057(1K 및 2K) / $0.10(4K) | 동일 시리즈의 상위 버전 |
gpt-image-2 /image-to-image@ext |
최대 16장 참조 이미지 | 최저 $0.007(저품질, 1K) | 가장 저렴한 다중 참조 경로, 4K 출력 |
flux-2 /image-to-image |
다중 참조 | $0.035(1K) / $0.05(2K) | 고충실도 다중 참조 편집 |
seedream-5.0-pro /image-to-image |
다중 참조 | $0.06(1K) / $0.10(2K) | 플래그십 품질 다중 참조 |
모델 마켓플레이스에서 전체 라인업을 둘러보세요. 단일 고정 얼굴에는 참조 이미지 한 장이면 충분합니다; gpt-image-2의 16 참조 이미지 경로는 얼굴, 의상, 제품을 한 렌더링에 융합하고 싶을 때 빛을 발합니다.
비디오 단계 선택 가능 모델
과금 방식이 다릅니다—대부분 초당 청구되지만 hailuo는 고정 클립 길이의 정액으로 청구됩니다. 배치 예산 책정 시 이 차이에 주의하세요.
| 모델 | 과금 방식 | 예시 비용 | 비고 |
|---|---|---|---|
grok-imagine-1.5 /image-to-video |
초당 | $0.015/s(480p), $0.0282/s(720p) | 본문 사용; 가장 저렴, 1–15초 |
veo-3.1-lite /image-to-video |
초당 | $0.06/s(720p, 오디오 없음) → $0.14/s(1080p) | 품질과 비용의 균형 양호 |
kling-3.0 /image-to-video |
초당 | $0.10/s(720p) → $0.129/s(1080p); +오디오는 더 비쌈 | 네이티브 오디오, 최대 4K |
hailuo-2.3-fast /image-to-video |
클립당 | $0.27(6s) / $0.46(10s) | 고정 길이 구간당 정액 청구 |
wan2.7-video /image-to-video |
초당 | $0.10/s(720P) / $0.167/s(1080P) | 첫 프레임 구동 |
veo-3.1 /image-to-video |
초당 | 오디오 포함 $0.57/s → $0.86/s(4K) | 시네마틱 등급; 5초 클립 약 $2.85, 따라서 길이 제한 |
따라서 5초 Reel 비용은 grok-imagine-1.5의 약 $0.075에서 풀 veo-3.1의 약 $2.85까지—38배 차이입니다. 저렴한 등급에서 프로토타이핑하고, 실제로 게시할 클립만 업그레이드하세요.
실제로 효과가 있는 일관성 팁
- 앵커링하고, 체인 전달하지 마세요. 원본 기본 인물 사진을 모든 렌더링에 보내세요. 이전 출력을 다음 입력으로 사용하면 미세 흔들림이 누적되어 얼굴이 같은 사람이 아닌 사촌이 됩니다.
- 프롬프트에 불변 특징을 적으세요. 「같은 여자」보다 「왼쪽 눈 아래 같은 점, 같은 금색 이어링」이 더 유용합니다. 모델에게 바꾸면 안 되는 것을 알려주는 것입니다.
- 채널당 하나의 화면 비율을 유지하세요. 피드 그리드에는 4:5, Reels에는 9:16. 촬영 중간에 전환하면 어색한 재크롭이 강제되어 얼굴이 잘릴 수 있습니다.
- 해상도를 모델 등급에 고정하세요.
nano-banana-2는1K/2K/4K를 허용합니다; 명시적으로 설정하여 배치 처리가 크기를 조용히 혼합하지 않게 하세요. - 가장 강한 인물 사진을 영구 자산으로 보관하세요. 이것이 당신의 「캐스팅」입니다—매 캠페인마다 새 얼굴을 재생성하는 대신 수개월간 재사용하세요.
본문 비용
| 항목 | 모델 | 수량 | 단가 | 소계 |
|---|---|---|---|---|
| 기본 인물 사진 + 3개 장면 렌더링 | nano-banana-2(2K) | 4 | $0.057 | $0.228 |
| 카페 Reel | grok-imagine-1.5(480p, 5s) | 1 | $0.015/s | $0.075 |
| 합계 | 약 $0.30 |
완전한 30개 게시물 그리드에 Reels 몇 개를 더해도 총비용은 한 자릿수 달러의 낮은 범위에 불과합니다—이것이 팀이 촬영 대신 생성기를 선택하는 진짜 이유입니다.
FAQ
매번 얼굴이 완전히 동일하게 보장되나요? 어떤 모델도 픽셀 단위로 동일한 얼굴을 보장하지 못하지만, 이번 테스트에서 nano-banana-2의 참조 이미지 앵커링은 매우 다른 세 장면에서 동일한 식별 가능한 사람을 유지했습니다. 간헐적 이상은 재촬영의 이유가 아니라 몇 장 더 생성해 선별하는 이유로 보세요.
실제 인물의 얼굴을 고정할 수 있나요? 권리가 있는 사람만 가능합니다—본인, 동의한 모델, 또는 계약한 브랜드 앰버서더. 낯선 사람이나 유명인을 복제하지 마세요.
파인튜닝이나 LoRA가 필요한가요? 아니요. 전체 워크플로는 제로 트레이닝입니다—참조 이미지 한 장과 프롬프트 한 단락. 이것이 이미지당 비용이 몇 센트에 머무는 이유입니다.
어떤 모델로 시작해야 하나요? 신원 고정은 nano-banana-2로, 비디오 단계는 grok-imagine-1.5로 시작하세요. 둘 다 자유롭게 반복할 수 있을 만큼 저렴합니다; 스타일이 확정된 후에만 업그레이드하세요.
시작하기
nano-banana-2에서 인물 사진을 생성하고, 이를 image_input으로 각 장면에 되돌려 보내며, 이미지-투-비디오 모델로 가장 좋아하는 프레임을 애니메이션화하세요—모두 하나의 키로 POST /v1/tasks를 통해 완료됩니다. 빠른 시작 문서에서 인증과 폴링을 다루며, 배치를 확장하기 전에 가격 페이지에서 이미지 및 비디오 모델별로 비교할 수 있습니다.
관련 글
모든 아티클 보기 →-

사용 가이드
seedream-5.0-pro/image-to-image 시작 가이드: 기능, 가격 및 연동 핵심 포인트
ByteDance 이미지 편집 모델의 기능 경계, 과금 방식 및 엔지니어링 연동 실무
-

사용 가이드
seedream-5.0-pro 텍스트-이미지 생성 입문 가이드: 능력 경계, API 연동 및 비용 관리
개발자를 위한 실무 관점: 파라미터 핵심부터 장당 $0.05 비용 추정까지
-

사용 가이드
Hailuo 2.3 Fast 이미지-투-비디오 입문 가이드: 성능 범위, 가격 및 연동 실무
개발자를 위한 MiniMax 이미지-투-비디오 모델 선택과 연동 핵심 포인트