
Руководство
GPT Image 2: многораундовое редактирование и стилистическая согласованность — возможности hiapi
Как совместно использовать gpt-image-2 и gpt-image-2-image-to-image для создания серий изображений с согласованными персонажами и точного редактирования — всего за $0.03 за вызов на hiapi.
Большинство постов в духе «GPT Image 2 просто потрясающий» показывают вам лишь один рендер. Это только лёгкая половина. Трудная половина — и та, что действительно важна, когда вы передаёте работу с изображениями в продукт — это второй рендер и третий: сохранение узнаваемости персонажа в серии изображений или переосмысление ключевого визуального актива без разрушения того, что изначально сделало его удачным.
gpt-image-2 на hiapi — это два модели, а не одна. Стандартный вариант текст-в-изображение рисует первый кадр; gpt-image-2/image-to-image берёт этот кадр в качестве референса для редактирования. Вместе, по $0.03 за вызов, они покрывают workflows, которые возникают в реальном производстве: серии с согласованными персонажами, точную замену сцен, переосмысление брендовых активов. В этой статье разбираются оба варианта с оригинальными промптами, реальными выходами и готовым к копированию кодом.
Два модели, один рабочий процесс
Оба варианта используют унифицированный асинхронный API задач hiapi — POST https://api.hiapi.ai/v1/tasks создаёт задачу генерации и возвращает ID задачи, GET /v1/tasks/:id возвращает URL готового изображения. Разница в том, что вы помещаете в объект input.
| Сценарий использования | Модель | Цена 1K | Цена 2K | Форма ввода |
|---|---|---|---|---|
| Генерация первого рендера из промпта | gpt-image-2 |
$0.03 | $0.04 | Только текст |
| Редактирование/переосмысление стиля референсного изображения | gpt-image-2/image-to-image |
$0.03 | $0.04 | Текст + 1–5 референсных изображений |
Приведённые цифры взяты напрямую со страницы актуальных цен на момент написания — эта страница является авторитетным источником. Стандартная версия gpt-image-2 использует кривую множителей (1K → 2K — 1,33×, 4K — 2×), поэтому вызов 1K стоит $0.03, а холст 4K — $0.06. Вариант изображение-в-изображение следует той же кривой. Никакой дополнительной «надбавки за редактирование» нет — оба модели стоят одинаково за вызов при одинаковом разрешении.
Это разделение важно, потому что оно меняет ваш подход к работе. Вы не платите за одну дорогую съёмку, чтобы купить «правильное изображение». Вы платите $0.03, чтобы приблизиться, а затем $0.03 (или дважды), чтобы достичь точности.
Возможность первая: стилистическая согласованность в серии
Паттерн, на котором ломается большинство workflows текст-в-изображение — это один и тот же субъект в разных сценах. Запустите один и тот же промпт дважды — получите двух несвязанных людей; запустите два промпта сцены с вольным описанием субъекта — получите двоюродных братьев.
gpt-image-2 справляется на удивление хорошо, когда вы делаете две вещи:
- Пишете character bible инлайн. Не «молодая женщина в очках». А конкретные признаки, за которые модель может зацепиться: цвет волос и длина и текстура, тон кожи и веснушки, очки и оправа, каждая деталь одежды, которая вам важна. Шесть-десять якорных признаков — идеальный диапазон.
- Дословно повторяете character bible в каждой сцене. Тот же порядок слов, те же модификаторы. Относитесь к описанию как к объекту JSON: сцена меняется, character bible остаётся байт-в-байт идентичным.
Вот один и тот же character bible, запущенный в двух разных сценах. В обоих вызовах character bible неизменен; различается только абзац сцены.
Character bible (дословно повторяется в обоих вызовах):
"Молодая женщина около тридцати, волнистые тёмно-каштановые
волосы до плеч, тёплая оливковая кожа, мягкие веснушки,
круглые очки в черепаховой оправе, кремовый шерстяной
водолазка, тонкая золотая цепочка, мшисто-зелёный
льняной блейзер на плечах"

Сцена A: мраморный столик в кафе у высокого северного окна,
белая чашка флэт-уайт с латте-артом, открытый блокнот
из тёмно-синей кожи, латунная перьевая ручка, латунная
люстра размыта на фоне, 35мм плёнка, малая глубина
резкости, 1:1.

Сцена B: терраса на средиземноморской крыше в золотой час,
терракотовые горшки с розмарином и свисающим плющом,
тот же блокнот из тёмно-синей кожи прижат к груди,
взгляд на тёплые крыши и море, 35мм плёнка, естественная
цветовая палитра, как в сцене A, малая глубина резкости, 1:1.
Два вызова, две сцены, один человек:
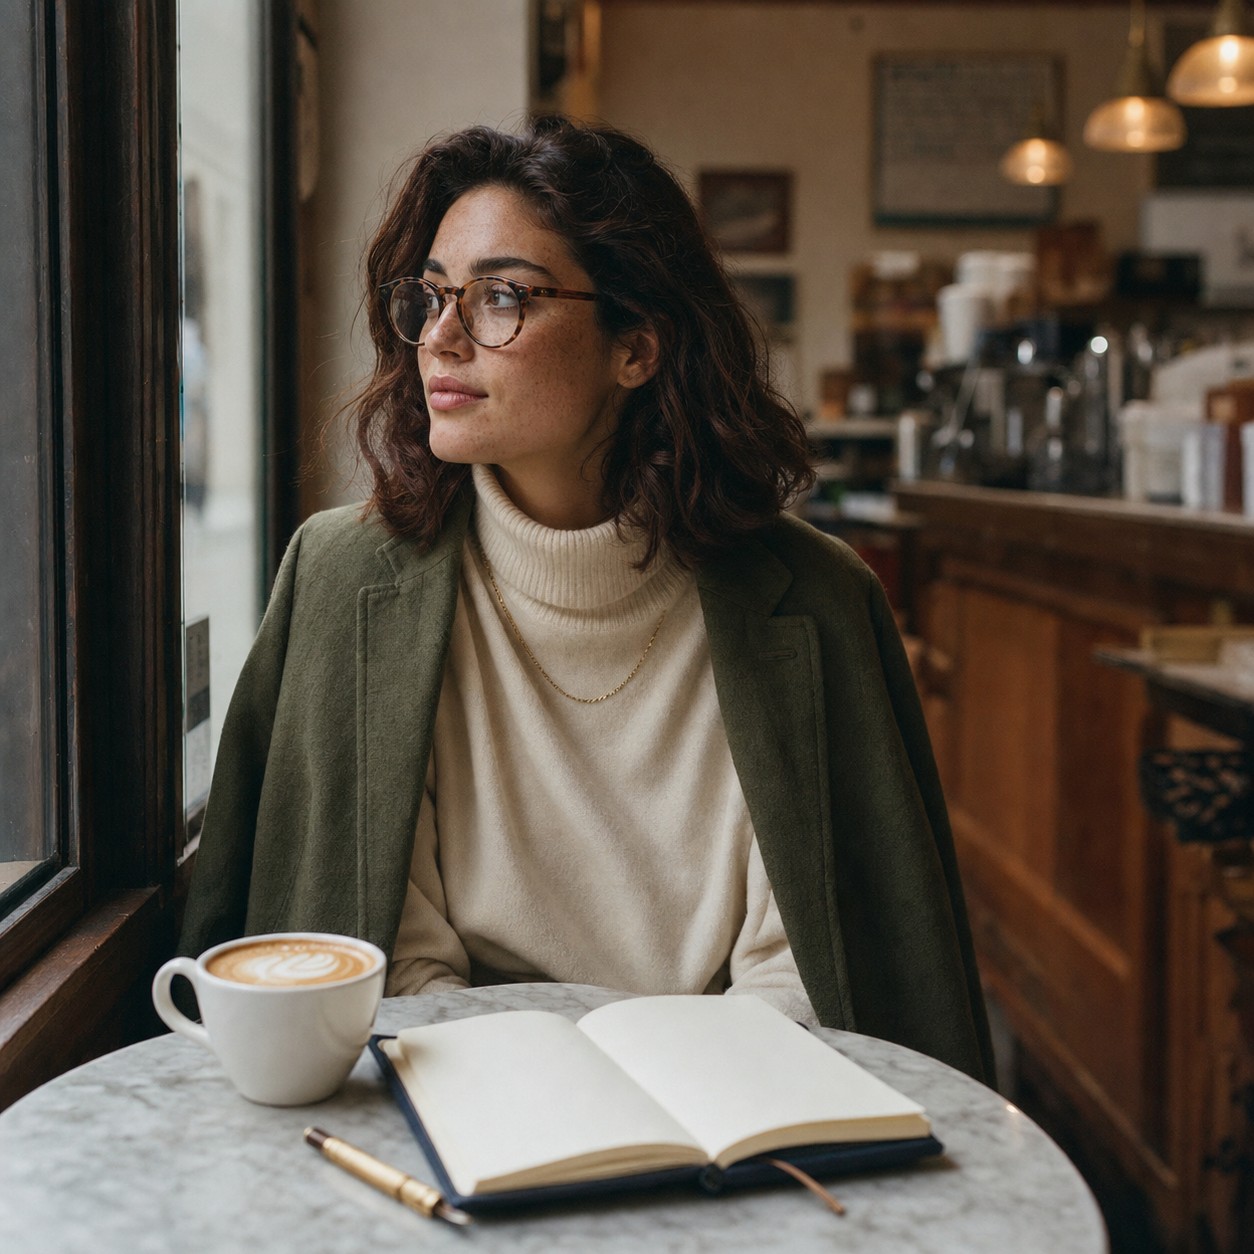
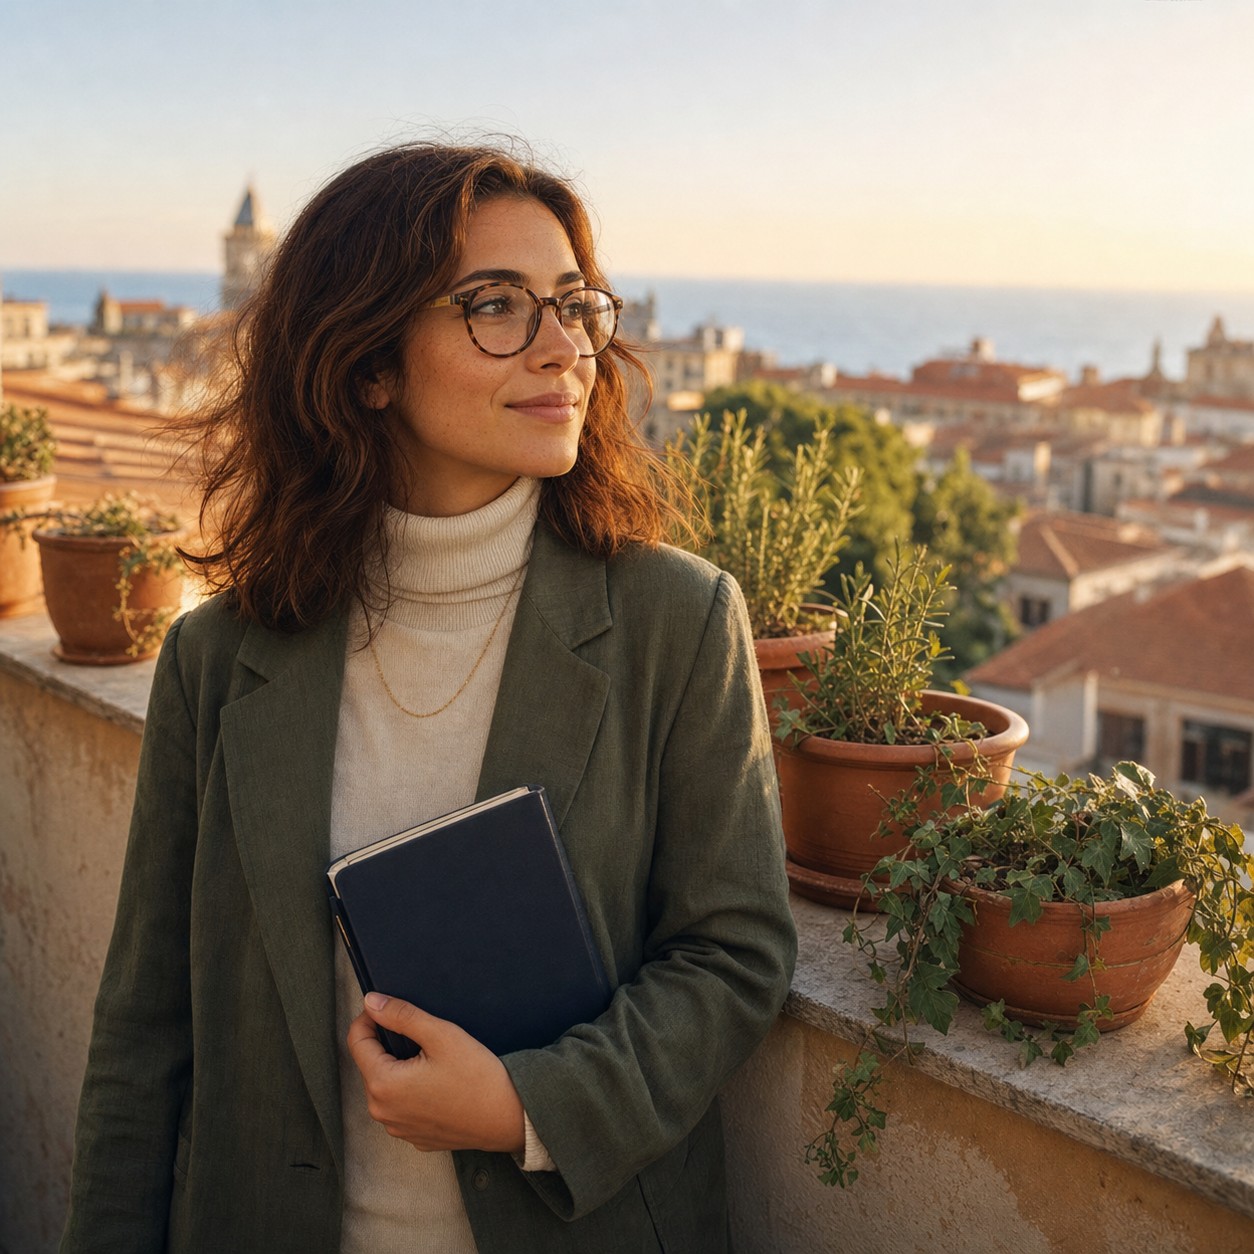
Форма лица, длина и цвет волос, очки, водолазка, блейзер, цепочка и даже блокнот — всё сохраняется. Освещение и цветовая гамма меняются вместе со сценой, как и должно быть; субъект остаётся.
Несколько практических замечаний при масштабном запуске этого паттерна:
- Привязывайте каждую часть тела тремя или более релевантными признаками. Только «волнистые тёмно-каштановые волосы» дрейфуют. «Волнистые тёмно-каштановые волосы до плеч» плюс «круглые очки в черепаховой оправе» двумя предложениями позже в качестве дополнительного якоря фиксируют лицо гораздо надёжнее. Модель рассматривает совместно встречающиеся признаки как более сильный сигнал идентичности, чем любой отдельный признак.
- Помещайте character bible в начало промпта. Описание сцены идёт после, а не до. Модель придаёт больше веса идентичности субъекта в ранних токенах.
- Завершайте каждую сцену одним и тем же повторяющимся стилевым модификатором («35мм плёнка, малая глубина резкости, 1:1»). Это фиксирует эстетику рендеринга, чтобы два вызова не выглядели как два разных фотографа.
Для коротких серий (три-двенадцать кадров одного персонажа) этот паттерн обычно достигает более 80% согласованности с первой попытки. Этого достаточно для мудбордов, иллюстраций к блогам, социальных серий, маркетинговых календарей. Для бренд-критичной работы, где каждый кадр должен совпадать, переходите к возможности второй.
Возможность вторая: многораундовое редактирование с референсными изображениями
Стилистическая согласованность через промпты приближает вас. Вариант изображение-в-изображение делает точным. Вы даёте ему референс (от одного до пяти изображений) и промпт с указанием, что изменить — он меняет это, остальное остаётся нетронутым.
Самое частое применение — замена сцены для брендовых активов: один и тот же продукт, тот же стул, тот же персонаж в разных окружениях, субъект сохраняется с точностью до пикселя, окружение перерисовывается вокруг него.
Референсное фото — скульптурное кресло из орехового дерева на бесшовном кремовом фоне, сгенерированное с помощью gpt-image-2:
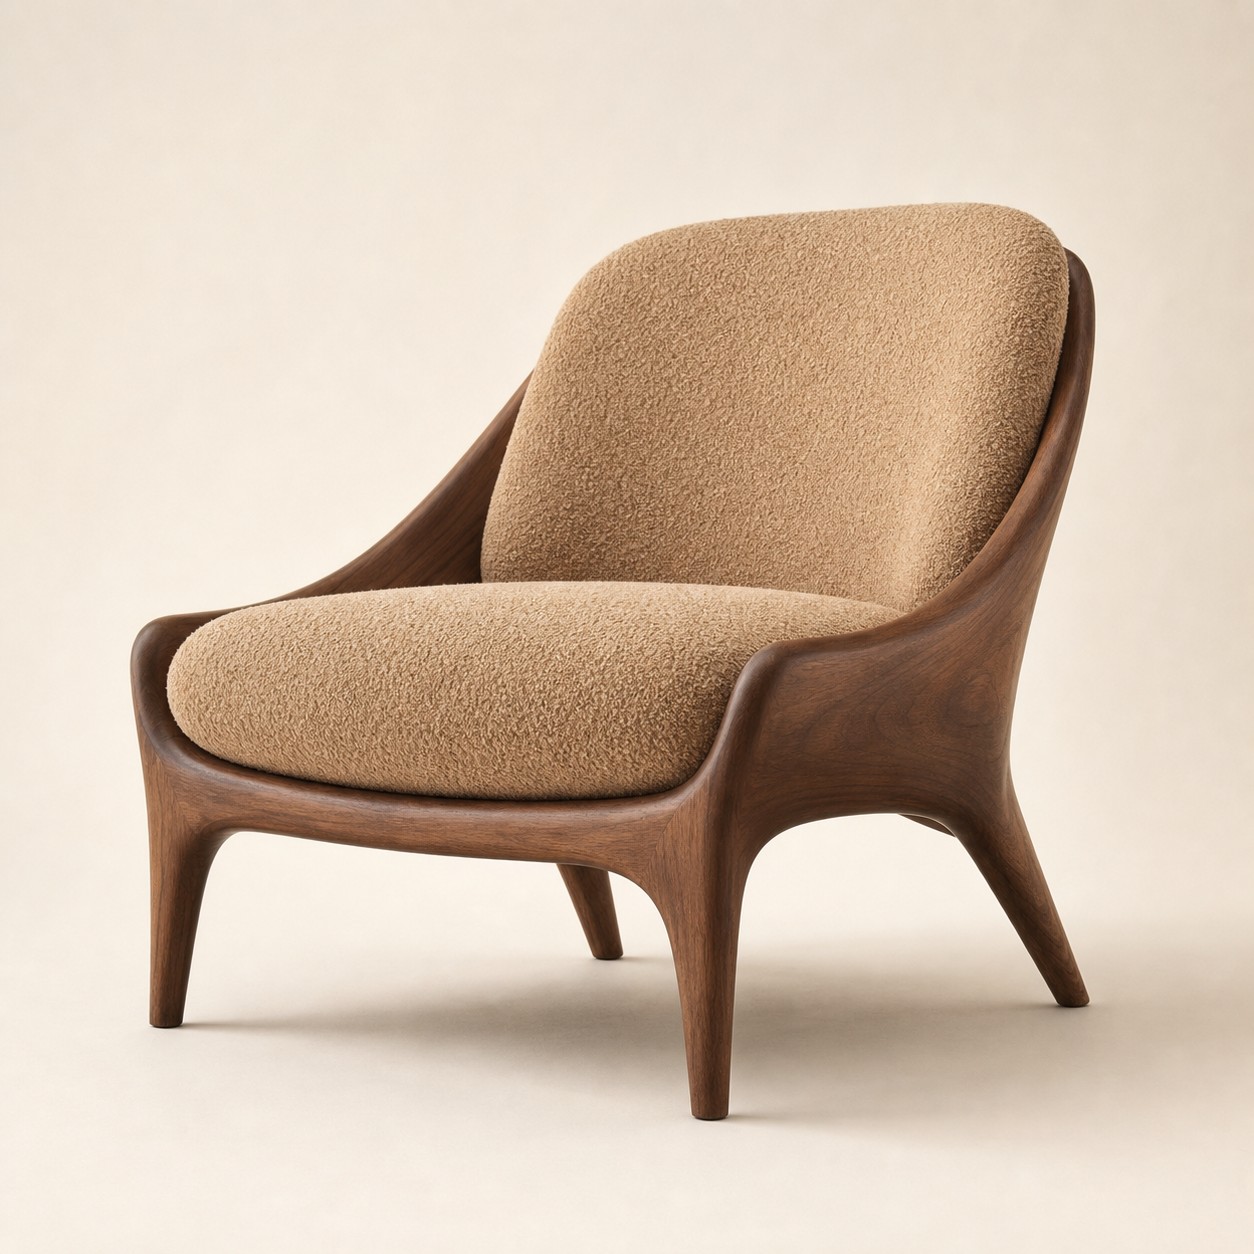
Теперь отправьте это точное изображение в gpt-image-2/image-to-image с промптом замены окружения:
Переосмысли это точное кресло в светлой редакционной
интерьерной сцене, не меняя само кресло: сохрани форму
орехового каркаса, подушку из верблюжьего букле, пропорции
ножек, точный силуэт с пиксельной точностью. Замени
бесшовный кремовый фон на тёплый солнечный уголок для
чтения: высокое арочное окно слева вверху, отбрасывающее
длинные послеполуденные тени на широкий дубовый пол,
маленький круглый приставной столик из тёмно-морильного
ясеня справа, керамическая ваза с тремя стеблями сухой
пшеницы на нём, сложенный плед из натурального льна на
подлокотнике кресла, винтажный ковёр в стиле бербер
в мягких кремовых и выцветших терракотовых тонах под
ним. Атмосфера — тёплый послеполуденный свет, слегка
дымчатый воздух, журнальная интерьерная фотография,
согласованная нейтральная палитра.
Результат — то же кресло, новая комната:
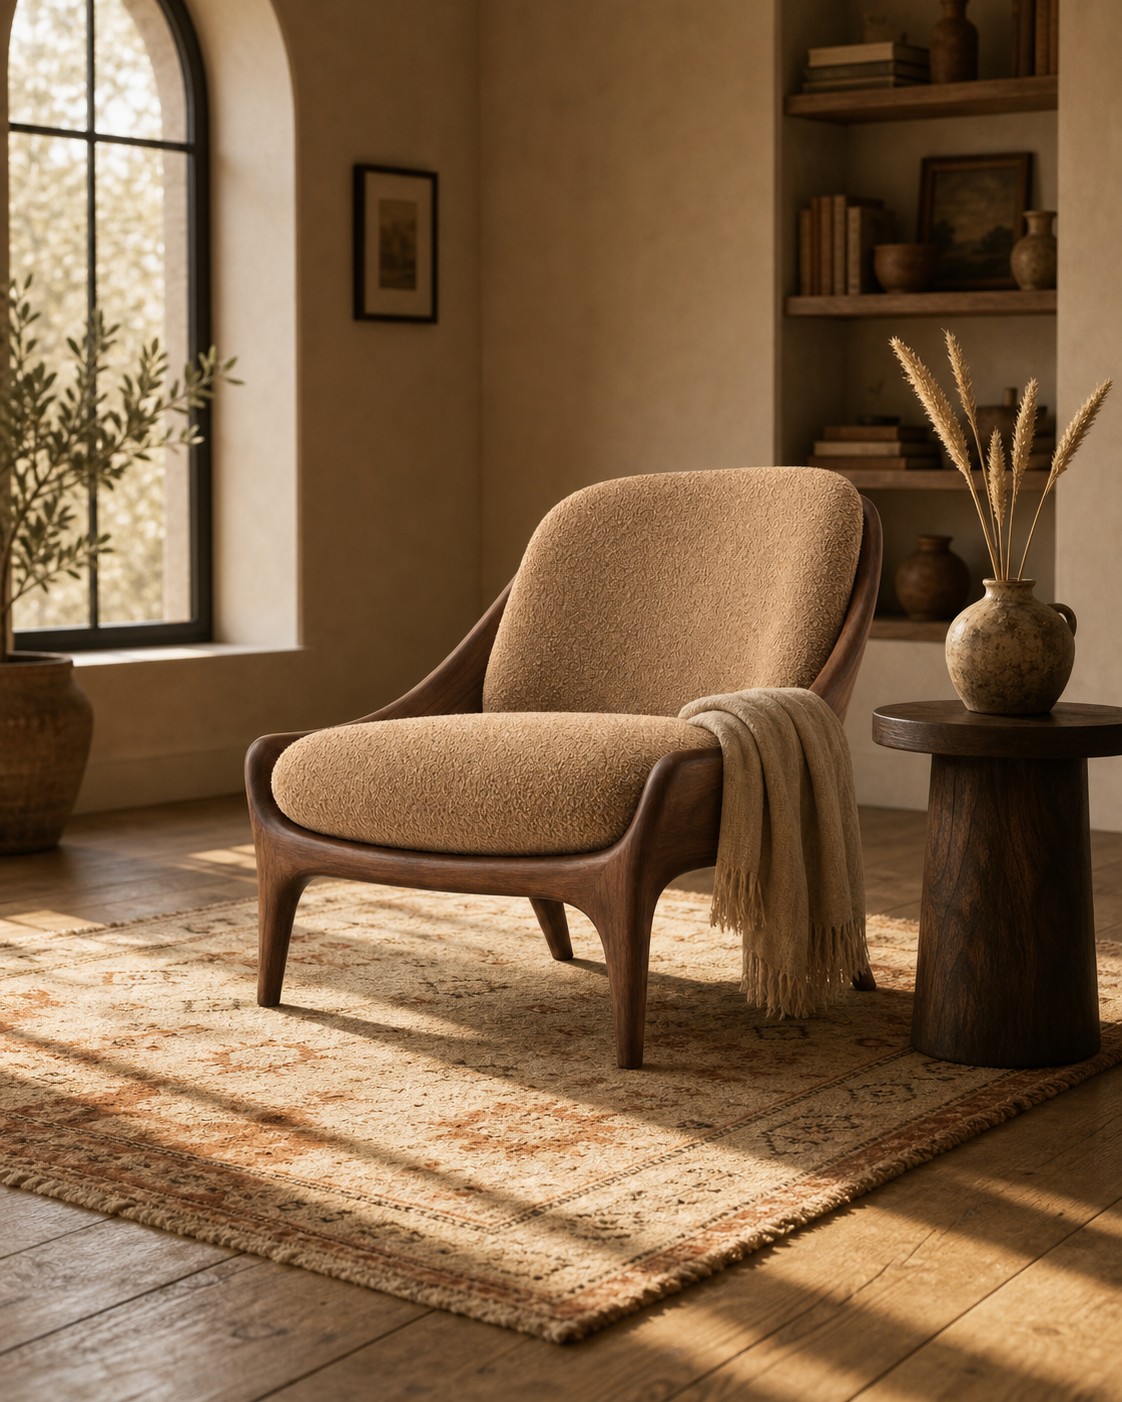
Форма каркаса, ткань подушки, цветовая гамма и геометрия ножек сохраняются чисто. Бесшовный фон исчез; вокруг этого контролируемого брендом элемента нарисовано полноценное окружение.
В чём вариант редактирования силён:
- Замена сцены. Втянуть изолированный субъект в окружение или переместить субъект из окружения в новое.
- Точные изменения свойств. «Смени ткань подушки на тёмно-синий бархат, всё остальное оставь идентичным» — работает гораздо лучше, чем повторный промптинг всей сцены с нуля.
- Тонкая настройка композиции. «Тот же стул, та же комната, камера на шаг назад и маленькая собака на пледе» — модель редактирует, а не перерисовывает.
- Переосмысление брендовых активов. Возьмите маркетинговый мудборд в качестве референса и добавьте промпт с запросом трёх согласованных вариантов — это лучше сохраняет тон, чем три независимых текстовых промпта.
В чём он не силён (используйте стандартный текст-в-изображение):
- Крупная переработка композиции. Если более 60% кадра нужно изменить, лучше начать с нового промпта.
- Замена персонажа. Если вы имеете в виду «тот же стул, но другой стул», это новый промпт, а не редактирование.
Код: два модели, end-to-end
Оба модели отвечают на POST /v1/tasks. Вызов текст-в-изображение отправляет промпт в input; вызов изображение-в-изображение добавляет массив input_urls с одним-пятью URL референсных изображений.
Текст-в-изображение (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # Character bible сначала — ранние токены несут идентичность.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # Сцена потом.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # Стилевой модификатор в конце — фиксирует вид серии.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Для холста 2K установите "resolution": "2K". Цена масштабируется на 1,33× согласно странице актуальных цен — форма вызова та же, $0.04 вместо $0.03.
Изображение-в-изображение (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
В одном вызове можно передать до пяти референсных изображений — добавляйте URL в массив input_urls. Модель рассматривает референсы как небольшой контекст стиля/идентичности, а затем вносит редактирование, указанное в промпте. Обратите внимание: референсы — это размещённые URL, а не инлайн base64 — если ваш референс на диске, сначала загрузите его в доступное место (объектное хранилище, ваш CDN) и передайте ссылку.
Несколько операционных заметок:
- Ожидайте 60–120 секунд end-to-end для 1K; для 2K дольше. Асинхронный процесс означает, что нет долго висящих HTTP-соединений, которые таймаутят — опрашивайте каждые несколько секунд или установите
callback.urlв вызове создания, чтобы hiapi отправил вам финальное состояние. - Не блокируйте обработчик запроса в ожидании генерации. API уже даёт вам ID задачи — сохраните
taskIdи позвольте поллеру или колбэку выполнить работу, а не держите serverless-вызов открытым. - Две комбинации параметров, которых следует избегать в варианте редактирования:
aspect_ratio: "auto"(или пропуск) поддерживается только с разрешением1K, а1:1нельзя сочетать с4K. - Используйте для референсных изображений то разрешение, которое хотите на выходе. Отправить референс 512×512 и запросить выход 2K можно, но модель зацепит меньше деталей. Для бренд-верного редактирования отправляйте референс в целевом размере выхода.
Когда что использовать (и что ещё предлагает hiapi)
gpt-image-2 и его брат изображение-в-изображение — правильный выбор по умолчанию, когда вам нужен рендеринг текста, согласованность персонажей или продуктов в небольшой серии, или точное редактирование брендовых активов. Это не единственные варианты изображений на hiapi, и выбор между ними важнее, чем кажется:
| Потребность | Модель | Причина |
|---|---|---|
| Черновик из промпта, исследование | gpt-image-2 ($0.03) |
Самый дешёвый в серии; паттерн character bible плюс сцена заводит далеко. |
| Точное редактирование / замена сцены / переосмысление бренда | gpt-image-2/image-to-image ($0.03) |
Та же цена, но с привязкой к референсу. Правильный выбор, когда любой выход должен соответствовать существующему активу. |
| Высокоточный маркетинговый холст 4K | gpt-image-2 4K ($0.06) |
Стандартный вариант предоставляет уровень 4K, чистый множитель 2× — самый дешёвый путь к большому холсту. |
| Продакшн-ключевой визуал, дорогая перегенерация | gpt-image-2-pro ($0.35) |
Уровень стабильности в той же серии, примерно 10× стандартной цены, для той небольшой доли работ, где один плохой рендер дороже десяти хороших. |
| Фотореалистичный портрет одного субъекта без редактирования | flux-1.1-pro ($0.05) |
FLUX 1.1 Pro на hiapi — специалист по реализму, когда вам не нужен рендеринг текста или многораундовое редактирование. |
| Редактирование, где важна скорость, согласованность персонажей в масштабе | Nano-Banana-2 ($0.085 at 1K) |
Вариант Gemini 3.1 Flash Image от Google — другие характеристики идентичности, похожие паттерны редактирования, более быстрый оборот ценой более высокой цены за вызов. |
Столбец цен в таблице выше взят со страницы актуальных цен платформы — обновите её перед тем, как ссылаться на цифры в ваших внутренних оценках.
Паттерн, который можно скопировать
Если у вас есть существующий конвейер, который вызывает gpt-image-2 один раз на запрос, самое дешёвое улучшение — ввести второй вызов:
def render(job):
    # 1) Черновик из промпта.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Если работа бренд-критична или требует замены сцены,
    #    редактируйте черновик, а не перепромптируйте.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # что изменить
            "input_urls": [draft.output_url],    # что сохранить
            "resolution": "1K",
        })

    return draft
Два вызова по $0.03 каждый — итого $0.06 — всё ещё дешевле одного вызова gpt-image-2-pro ($0.35), и для большинства работ второй вызов заменяет три-четыре раунда отбрасывания и повторного промптинга. Чем более бренд-верным должен быть выход, тем выгоднее этот расчёт.
Короткая версия
gpt-image-2 — движок черновиков. gpt-image-2/image-to-image — редактор. Вместе они покрывают workflows, которые не может покрыть однократная генерация изображений — серии персонажей, переосмысление брендовых активов, точные изменения свойств — без перехода на уровень Pro.
Два паттерна с наибольшей отдачей: (1) дословное повторное использование character bible в разных сценах для согласованности серии; (2) двухвызовный процесс «сначала рендер, потом редактирование» для любой работы, где выход должен выглядеть как продолжение существующего актива. Оба выполняются за $0.03 за вызов на эндпоинте /v1/tasks hiapi и доставляются в одинаковой форме полезной нагрузки задачи — одна worker-функция покрывает эту пару.
Проверьте актуальные цены, напишите character bible один раз и позвольте редактору сделать работу, которую не может сделать повторный промптинг.
Похожие статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата