
チュートリアル
GPT Image 2 のマルチターン編集とスタイル一貫性:hiapi 機能の旅
gpt-image-2 と gpt-image-2-image-to-image を組み合わせて、キャラクターの一貫したシリーズ画像と精密な編集を実現する方法——hiapi なら呼び出しごとにわずか $0.03。
ほとんどの「GPT Image 2 はすごい」という投稿は、1枚のレンダリング画像を見せるだけです。それは簡単な半分にすぎません。難しい半分——そして画像制作を製品に組み込む際に本当に重要な半分——は2枚目のレンダリングと3枚目です。つまり、あるキャラクターを一連の画像の中で識別可能なまま保つこと、あるいはキービジュアル資産を、それが最初に成功した理由を壊さずにリスタイルすることです。
hiapi 上の gpt-image-2 は1つのモデルではなく2つのモデルです。標準のテキスト→画像バリアントが最初のフレームを描画し、gpt-image-2/image-to-image がそのフレームを参照として受け取って編集します。両者を組み合わせ、呼び出しごとに $0.03 で、実運用で発生するワークフロー——キャラクター一貫のシリーズ画像、精密なシーン置換、ブランド資産のリスタイル——をカバーします。本記事では両方を順に解説し、オリジナルのプロンプト、実際の出力、コピーしてすぐ使えるコードを添えます。
2つのモデル、1つのワークフロー
どちらのバリアントも hiapi の統一非同期タスク API を使用します——POST https://api.hiapi.ai/v1/tasks が生成タスクを作成してタスク ID を返し、GET /v1/tasks/:id が完了後の画像 URL を返します。違いは input オブジェクトに何を入れるかです。
| ユースケース | モデル | 1K 価格 | 2K 価格 | 入力形態 |
|---|---|---|---|---|
| プロンプトから最初のレンダリング画像を生成 | gpt-image-2 |
$0.03 | $0.04 | テキストのみ |
| 参照画像の編集/スタイル再形成 | gpt-image-2/image-to-image |
$0.03 | $0.04 | テキスト + 参照画像1〜5枚 |
上記の数字は執筆時点のリアルタイム価格ページから直接取得したものです——このページが正となる情報源です。gpt-image-2 標準版は乗数カーブを使用し(1K → 2K が 1.33×、4K が 2×)、1K 呼び出しは $0.03、4K キャンバスは $0.06 です。画像→画像バリアントも同じカーブに従います。追加の「編集サーチャージ」はありません——両モデルは同じ解像度で呼び出しごとの価格が同じです。
この分割が重要なのは、仕事の考え方が変わるからです。高価な撮影1回で「正しい1枚」を買うのではありません。$0.03 で近づき、次に $0.03(あるいは2回)で正確に仕上げるのです。
機能1:シリーズをまたぐスタイル一貫性
ほとんどのテキスト→画像ワークフローが破綻するパターンは同一主体を異なるシーンに置くことです。同じプロンプトを2回実行すれば無関係な2人が出てきます。主体の記述が緩い2つのシーンプロンプトを実行すれば、いとこ同士のような結果になります。
gpt-image-2 は、次の2つを行うと驚くほどうまく処理します:
- キャラクター設定集をインラインで書く。 「眼鏡をかけた若い女性」ではなく、モデルが再びアンカーできる具体的な特徴——髪色と長さと質感、肌色とそばかす、眼鏡と眼鏡のフレーム、気にするすべての衣服。アンカー特徴は6〜10個が理想的な範囲です。
- 各シーンで設定集を一字一句そのまま再利用する。 同じ語順、同じ修飾語。記述を JSON オブジェクトのように扱います:シーンは差し替え、キャラクター設定集はバイト単位で完全に同一に保ちます。
以下は同じキャラクター設定集を2つの異なるシーンで実行したものです。2回の呼び出しで設定集は変えず、シーンの段落だけを変えています。
キャラクター設定集(2回の呼び出しで一字一句再利用):
"20代後半の若い女性、肩までのウェーブした濃い赤褐色の髪、
温かみのあるオリーブ色の肌、鼻筋に柔らかく散るそばかす、鼈甲色の
丸眼鏡、クリーム色のウールタートルネック、細い金のチェーン
ネックレス、苔色のリネンブレザーを肩に掛ける"

シーン A:高い北向きの窓のそばの大理石のカフェテーブル、ラテアートの
入った白いカプチーノカップ、開いた紺色のレザーノート、
背景にぼやけた真鍮のペンダントライト、35mm フィルム、
浅い被写界深度、1:1。

シーン B:ゴールデンアワーの地中海の屋上テラス、ローズマリーと
垂れ下がるアイビーを植えたテラコッタの鉢、同じ紺色のレザーノートを
胸に抱え、暖かな屋根と海を眺める、35mm フィルム、シーン A と
一致する自然な色調、浅い被写界深度、1:1。
2回の呼び出し、2つのシーン、同一人物:
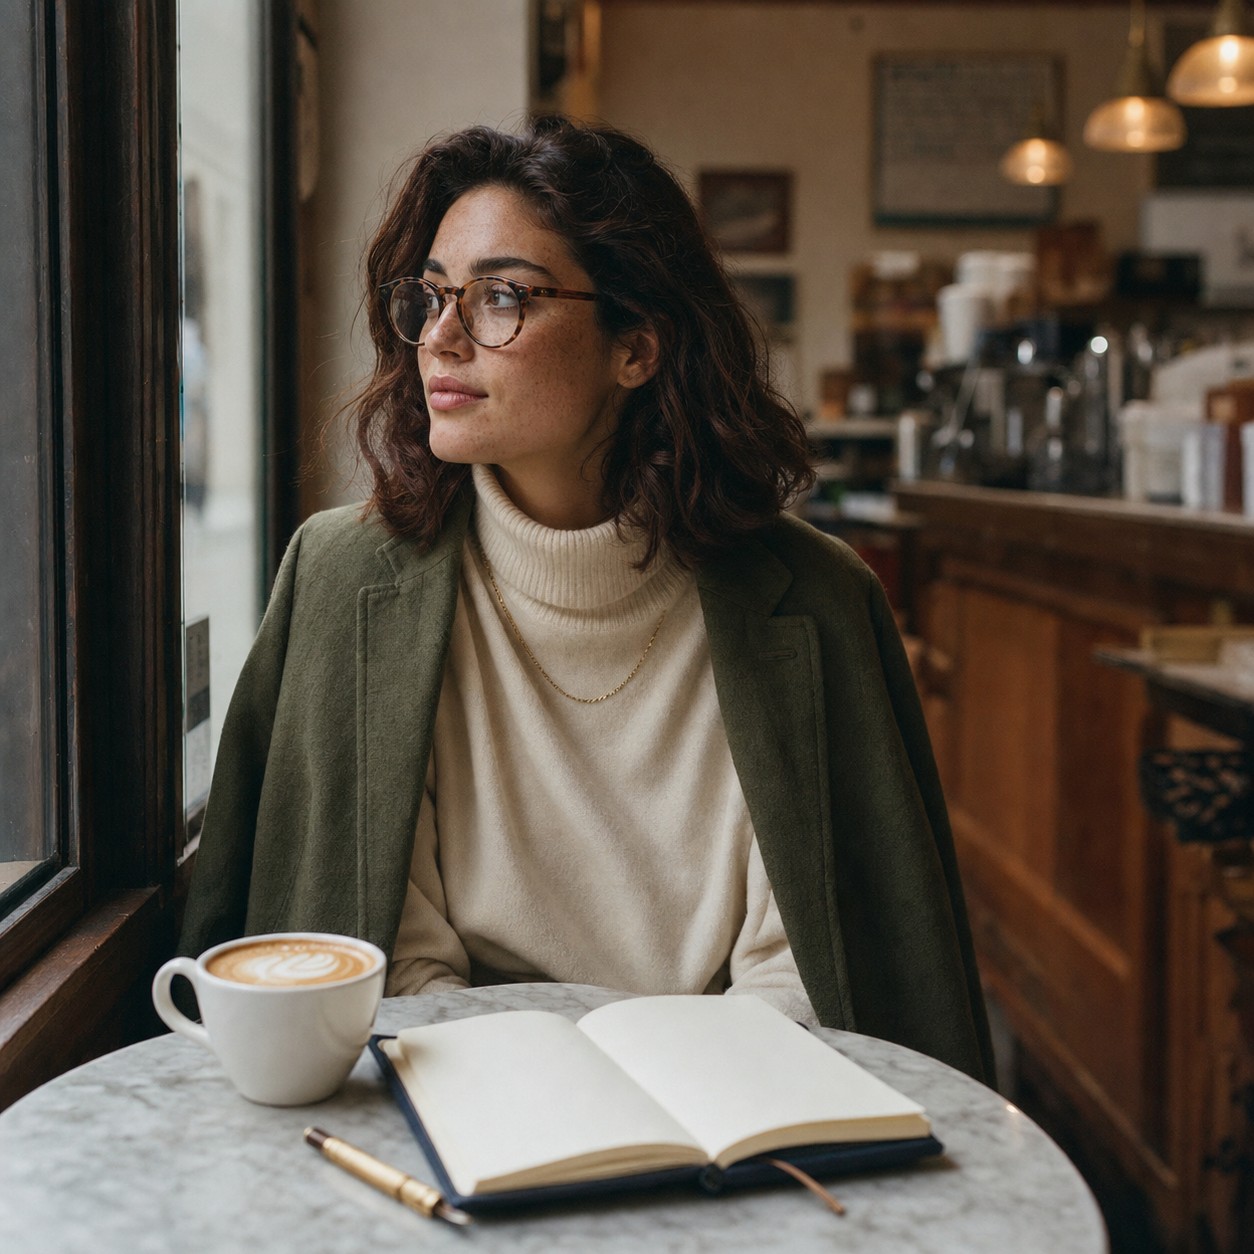
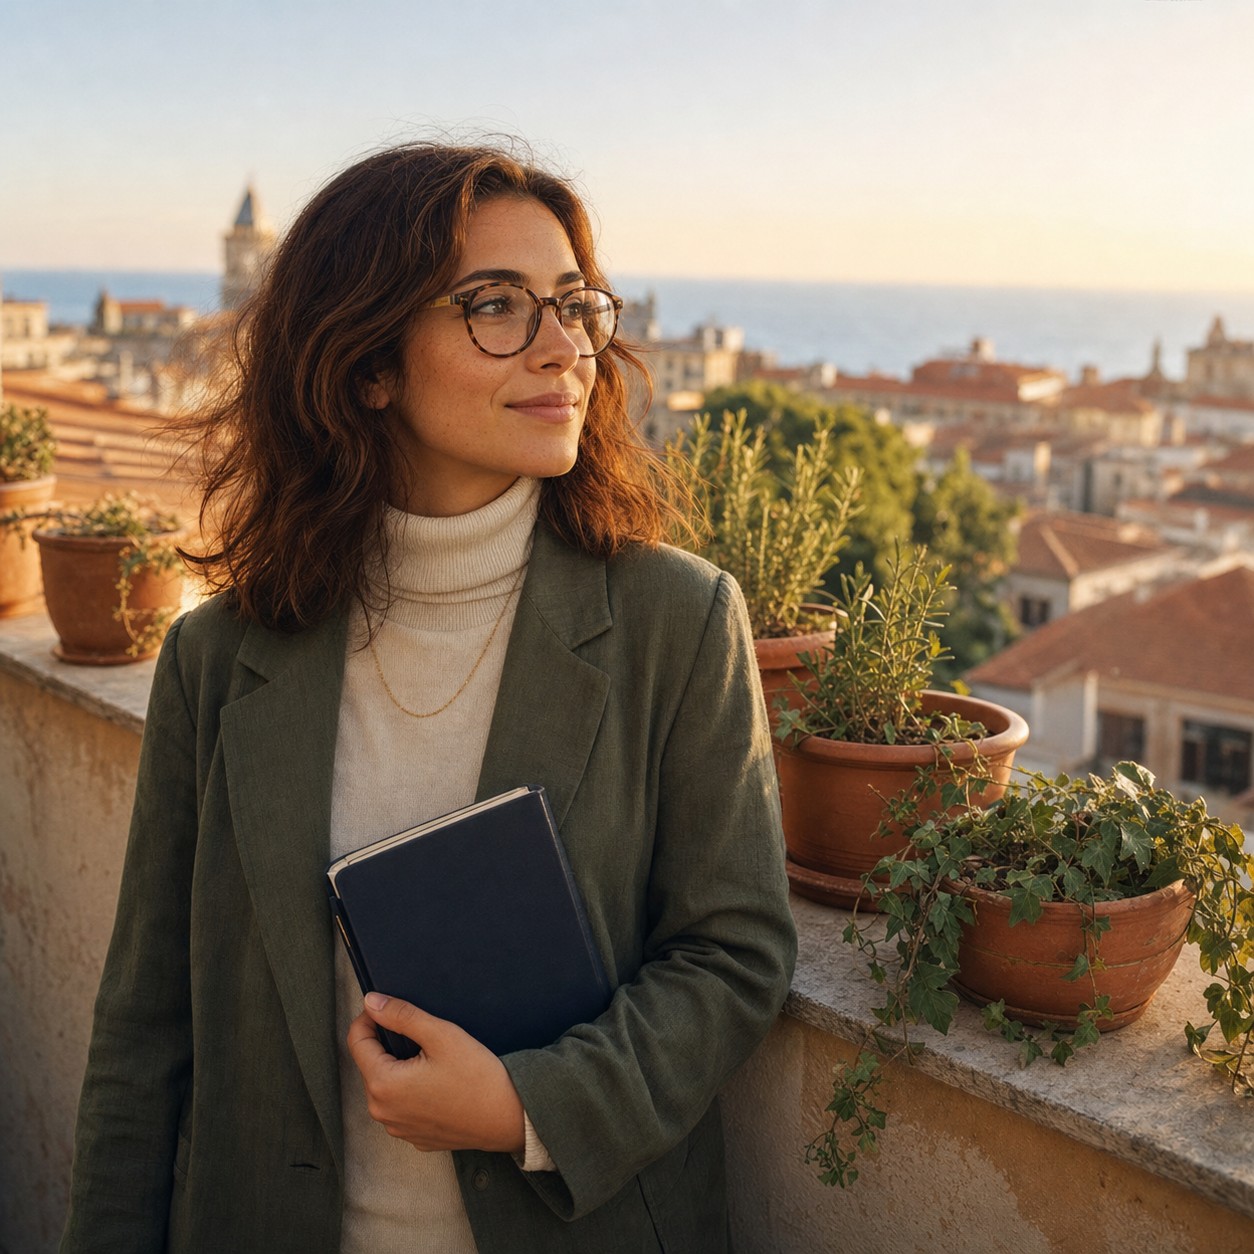
顔の形、髪の長さと色、眼鏡、タートルネック、ブレザー、ネックレス、さらにはノートまで——すべて引き継がれています。光と色調はシーンに応じて変化し、それは当然のことです。主体は変わりません。
このパターンを大規模に運用する際の実用メモ:
- 身体の各部位を3つ以上の関連特徴でアンカーする。 「ウェーブした濃い赤褐色の髪」だけではドリフトします。「肩までのウェーブした濃い赤褐色の髪」に加え、2つの節の後の「鼈甲色の丸眼鏡」を追加のアンカーにすると、顔がより強固に固定されます。モデルは共起する特徴を、単一の特徴よりも強い身元シグナルとして扱います。
- 設定集をプロンプトの先頭に置く。 シーン記述は後ろに置き、前に置きません。モデルは初期トークンの主体身元に高い重みを与えます。
- 各シーンを同じ繰り返しのスタイル修飾語で締める(「35mm フィルム、浅い被写界深度、1:1」)。これがレンダリングの美学を固定し、2回の呼び出しが2人の異なる写真家のように見えないようにします。
短いシリーズ(同一キャラクターの3〜12フレーム)では、このパターンは初回で通常80%以上の一貫性に達します。ムードボード、ブログ挿絵、ソーシャルシリーズ、マーケティングのスケジュールには十分です。すべてのフレームが一致しなければならないブランドクリティカルな作業では、機能2に進んでください。
機能2:参照画像を使ったマルチターン編集
プロンプトによるスタイル一貫性は近づくためのものです。画像→画像バリアントは正確に仕上げるためのものです。参照(1〜5枚の画像)と、何を変えるかを説明するプロンプトを渡すと、そこを変え、残りは動かしません。
最も一般的な使い方はブランド資産でのシーン置換です:同じ製品、同じ椅子、同じキャラクターを異なる環境に置き、主体はピクセル単位で忠実に保ち、環境はその周囲に描き直します。
参照写真——継ぎ目のないクリーム色の背景に置かれた彫刻的なウォールナット材のラウンジチェア、gpt-image-2 で生成:
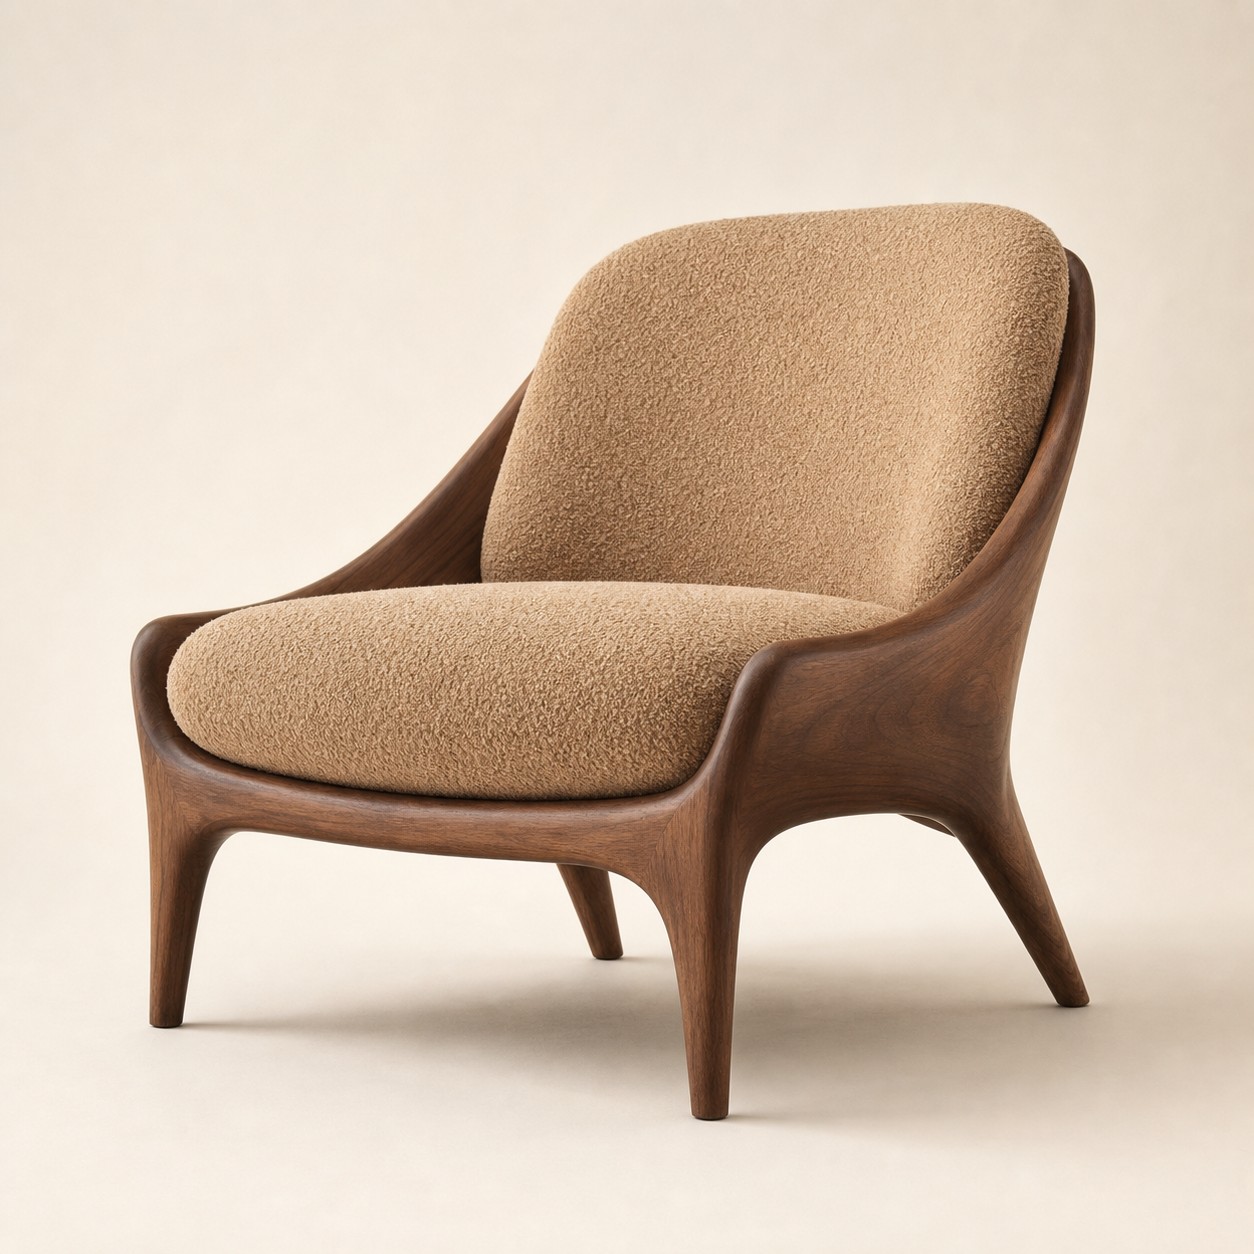
次にその正確な画像を gpt-image-2/image-to-image に送り、環境置換プロンプトを添えます:
この正確な椅子を、光あふれる編集風の環境シーンに
リスタイルしてください。ただし椅子自体は変えないこと:ウォールナットの
フレーム形状、キャメル色のブークレクッション、脚の比率、正確なシルエットを
ピクセル単位で忠実に同一に保つ。継ぎ目のないクリーム色の背景を、暖かく日当たりの良い読書
コーナーに置き換える:左上に高いアーチ窓、広いオーク材の床に
午後の遅い時間の長い影を落とす、右側に濃い
着色のアッシュ材の小さな丸いサイドテーブル、その上に乾いた小麦を
3本生けた陶器の花瓶、椅子の片方の肘掛けに折りたたんだ天然リネンの
ブランケット、下に柔らかなクリーム色と褪せたテラコッタ色の
ヴィンテージ風ベルベットラグ。暖かな午後の光の雰囲気、わずかに
もやのかかった空気、雑誌のインテリア写真、中立の色調に合わせる。
結果——同じ椅子、新しい部屋:
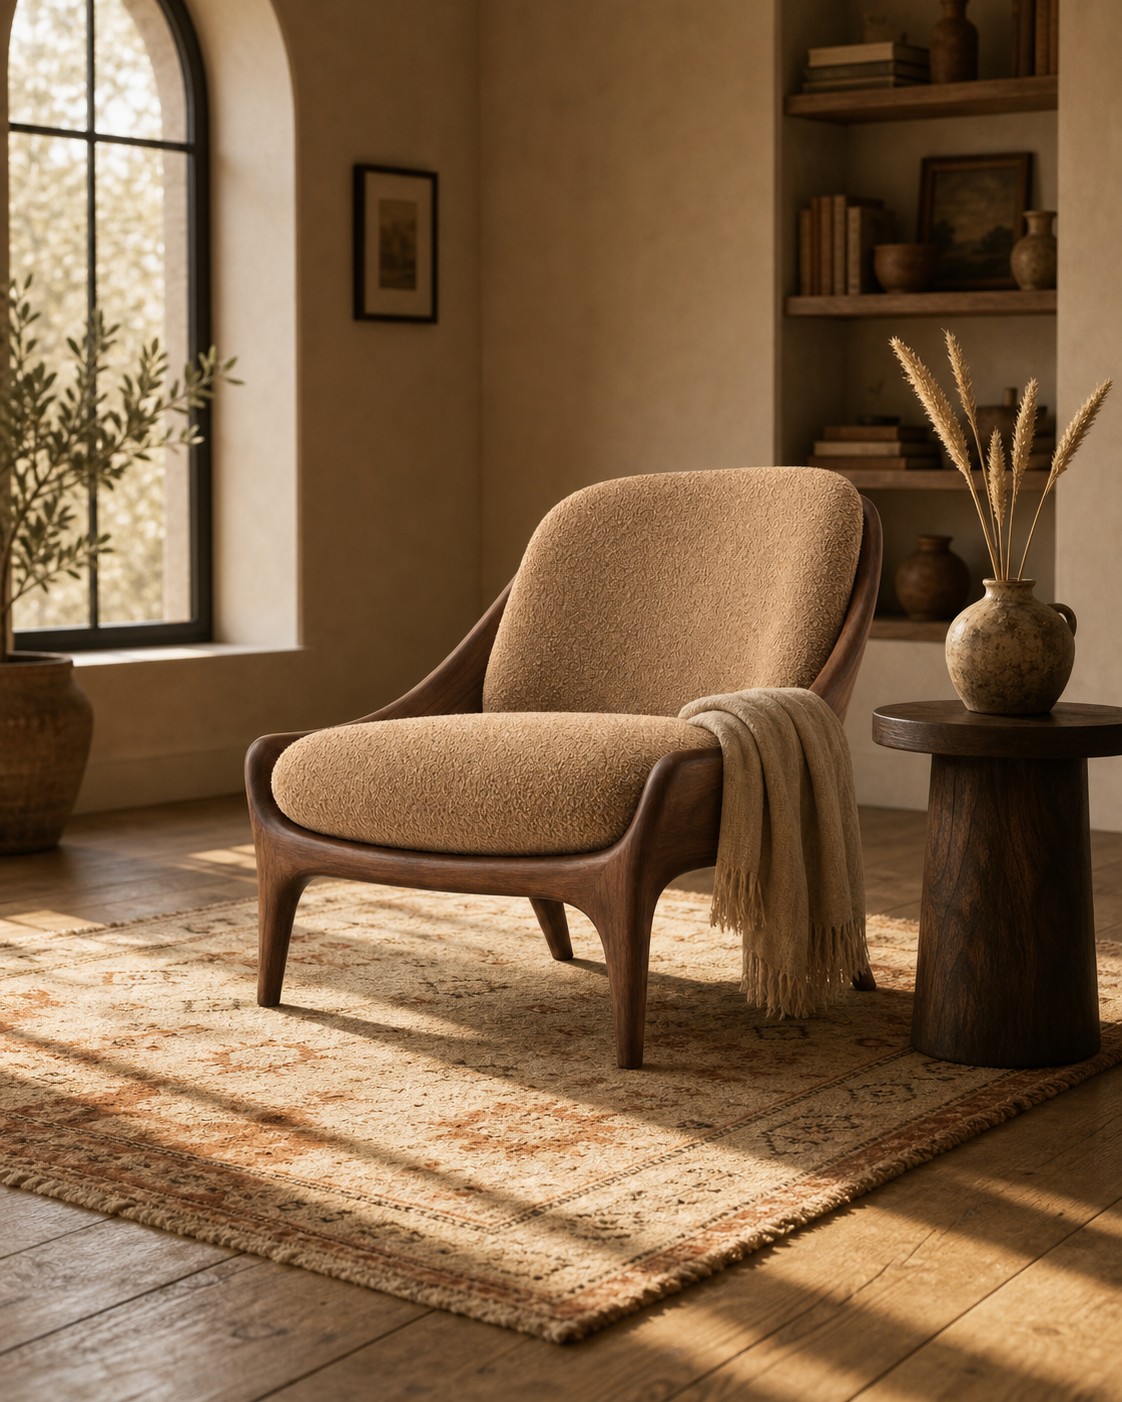
フレーム形状、クッションの生地、色調、脚の幾何学構造がきれいに引き継がれています。継ぎ目のない背景は消え、そのブランド管理された要素の周囲に完全な環境が描かれています。
編集バリアントが得意なこと:
- シーン置換。 孤立した主体を環境に引き入れる、または環境内の主体を新しい環境に移す。
- 精密な属性変更。 「クッションの生地を紺色のベルベットに変更し、それ以外はすべて同じに保つ」——シーン全体をゼロから再プロンプトするよりもはるかに良い結果になります。
- 構図の微調整。 「同じ椅子、同じ部屋、カメラを一歩下げ、ブランケットの上に小さな犬を追加」——モデルは再描画ではなく編集します。
- ブランド資産のリスタイル。 キャンペーンのムードボードを参照として、3つの一致するバリアントを求めるプロンプトを添えると、3つの独立したテキストプロンプトよりもトーンがよく保たれます。
苦手なこと(標準のテキスト→画像に切り替えるべき場合):
- 大幅な構図の書き換え。 画面の60%以上を変える必要があるなら、新しいプロンプトから始めるのが最善です。
- キャラクター置換。 「同じ椅子だが別の椅子」を意図するなら、それは編集ではなく新しいプロンプトです。
コード:2つのモデル、エンドツーエンド
両モデルとも POST /v1/tasks で応答します。テキスト→画像呼び出しは input にプロンプトを送信し、画像→画像呼び出しは1〜5枚の参照画像 URL を運ぶ input_urls 配列を追加します。
テキスト→画像(gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # キャラクター設定集を先頭に——初期トークンが身元を運ぶ。
            "20代後半の若い女性、肩までのウェーブした "
            "濃い赤褐色の髪、温かみのあるオリーブ色の肌、柔らかなそばかす、 "
            "鼈甲色の丸眼鏡、クリーム色のウールタートルネック、細い "
            "金のチェーン、苔色のリネンブレザー。 "
            # シーンは次に。
            "高い窓のそばの大理石のカフェテーブルに座り、白い陶器のカップに "
            "ラテ、開いた紺色のレザーノート。 "
            # スタイル修飾語は最後——シリーズの見た目を固定する。
            "35mm フィルム、暖かなカフェ内装、浅い被写界深度、1:1。"
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
2K キャンバスの場合は "resolution": "2K" を設定します。価格はリアルタイム価格ページに従い1.33×でスケールします——呼び出し形態は同じで、$0.03 ではなく $0.04 です。
画像→画像(gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "この正確な椅子を、暖かく日当たりの良い読書 "
            "コーナーにリスタイルしてください:左上にアーチ窓、オーク材の板張り床、乾いた小麦を "
            "生けた濃いアッシュ材のサイドテーブル、ベルベットラグ。ウォールナットの "
            "フレーム、ブークレクッション、シルエットを同一に保つこと。"
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
同じ呼び出しで最大5枚の参照画像を運べます——input_urls 配列にさらに URL を追加してください。モデルは参照を小さなスタイル/身元のコンテキストとして扱い、その後プロンプトで指定された編集を書き込みます。参照はホストされた URL であり、インライン base64 ではないことに注意してください——参照がディスク上にあるなら、まずアクセス可能な場所(オブジェクトストレージ、あなたの CDN)にアップロードし、リンクを渡してください。
いくつかの運用メモ:
- 1K はエンドツーエンドで60〜120秒を見込む;2K はより長くなります。非同期フローなので、長時間保持される HTTP 接続がタイムアウトすることはありません——数秒ごとにポーリングするか、作成呼び出しで
callback.urlを設定して hiapi が終了状態を POST するようにしてください。 - 生成を待つためにリクエストハンドラをブロックしない。 API はすでにタスク ID を返しています——
taskIdを永続化し、serverless 呼び出しを開いたままにするのではなく、ポーラーまたはコールバックに処理を完了させてください。 - 編集バリアントで避けるべき2つのパラメータ組み合わせ:
aspect_ratio: "auto"(または省略)は1K解像度のみに対応し、1:1は4Kと組み合わせられません。 - 参照画像は希望する出力解像度で。 512×512 の参照を送って 2K 出力を要求することは可能ですが、モデルがアンカーできる詳細は少なくなります。ブランドに忠実な編集では、参照を目標出力サイズで送ってください。
どちらをいつ使うか(そして hiapi が他に提供するもの)
テキストレンダリング、小規模シリーズをまたぐキャラクターや製品の一貫性、あるいはブランド資産への精密な編集が必要な場合、gpt-image-2 とその画像→画像兄弟は適切なデフォルトです。それらは hiapi 上の唯一の画像オプションではなく、両者の選択は見た目以上に重要です:
| 要件 | モデル | 理由 |
|---|---|---|
| プロンプトから初稿、探索 | gpt-image-2 ($0.03) |
シリーズ中最安;設定集+シーンパターンで十分遠くまで行ける。 |
| 精密編集 / シーン置換 / ブランドリスタイル | gpt-image-2/image-to-image ($0.03) |
同じ価格で参照にアンカーする。あらゆる出力が既存資産に一致しなければならない場合の正しい選択。 |
| 高忠実度 4K マーケティングキャンバス | gpt-image-2 4K ($0.06) |
標準バリアントが 4K ティアを公開、きれいな2×乗数——大きなキャンバスへの最安経路。 |
| 生産キービジュアル、再生成コストが高い | gpt-image-2-pro ($0.35) |
同シリーズの安定性ティア、標準価格の約10倍、1回の悪いレンダリングが10回の良いレンダリングより高くつく小さな一部の作業向け。 |
| 写真級の単一主体ポートレート、編集不要 | flux-1.1-pro ($0.05) |
hiapi 上の FLUX 1.1 Pro は写実の専門家、テキストレンダリングやマルチターン編集が不要な場合に。 |
| 速度重視の編集、大規模なキャラクター一貫性 | Nano-Banana-2 (1K で $0.085) |
Google の Gemini 3.1 Flash Image バリアント——異なる身元特徴、類似の編集パターン、より速いターンアラウンド、代償として呼び出しごとの価格が高め。 |
上表の価格列はプラットフォームのリアルタイム価格から取得しています——社内見積もりで数字を引用する前に更新してください。
そのまま流用できるパターン
既存のパイプラインがあり、リクエストごとに gpt-image-2 を1回呼んでいるなら、最も安いアップグレードは2回目の呼び出しを導入することです:
def render(job):
    # 1) プロンプトから初稿。
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) 作業がブランドクリティカル、またはシーン置換が必要なら、
    #    再プロンプトせずに初稿を編集する。
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # 何を変えるか
            "input_urls": [draft.output_url],    # 何を保つか
            "resolution": "1K",
        })

    return draft
2回の呼び出しで各 $0.03、合計 $0.06——それでも単一の gpt-image-2-pro 呼び出し($0.35)より安く、ほとんどの作業では2回目の呼び出しが3〜4回の破棄と再プロンプトを置き換えます。出力がブランドに忠実であるほど、この計算は有利になります。
短いまとめ
gpt-image-2 は初稿エンジンです。gpt-image-2/image-to-image はエディタです。組み合わせると、単発の画像生成ではカバーできないワークフロー——キャラクターシリーズ、ブランド資産のリスタイル、精密な属性変更——を Pro ティアにアップグレードせずにカバーします。
最も見返りの大きい2つのパターンは:(1) シリーズ一貫性のためにキャラクター設定集をシーンをまたいで一字一句再利用する;(2) 出力が既存資産の延長に見えなければならない作業では、まずレンダリングしてから編集する2回呼び出しフローを採用する。どちらも hiapi の /v1/tasks エンドポイントで呼び出しごとに $0.03 で完了し、同じタスクペイロード形態で届きます——1つの worker 関数がこのペアをカバーします。
リアルタイム価格を確認し、設定集を一度書き、再プロンプトではできない仕事をエディタに完了させてください。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする