
教程
GPT Image 2 多轮编辑与风格一致性:hiapi 能力之旅
如何结合使用 gpt-image-2 与 gpt-image-2-image-to-image,打造角色一致的系列图与精准编辑——在 hiapi 上每次调用仅 $0.03。
大多数“GPT Image 2 太惊艳了”的帖子只给你看单张渲染图。那只是简单的一半。困难的一半——也是真正要紧的一半,当你把图像工作交付到产品中时——是第二张渲染图和第三张:让一个角色在一系列图中保持可辨识,或者对一张主视觉资产重新造型,同时不破坏它最初成功的原因。
hiapi 上的 gpt-image-2 是两个模型,而非一个。标准的文生图变体绘制第一帧;gpt-image-2/image-to-image 将该帧作为参考拿回来进行编辑。二者结合使用,每次调用 $0.03,覆盖了实际生产中出现的 workflows:角色一致的系列图、精准的场景替换、品牌资产重塑造。本文逐一讲解两者,附带原创提示词、真实输出和可直接复制的代码。
两个模型,一个工作流
两个变体都使用 hiapi 的统一异步任务 API——POST https://api.hiapi.ai/v1/tasks 创建生成任务并返回任务 ID,GET /v1/tasks/:id 返回完成后的图片 URL。区别在于你在 input 对象中放入什么。
| 使用场景 | 模型 | 1K 价格 | 2K 价格 | 输入形态 |
|---|---|---|---|---|
| 从提示词生成首张渲染图 | gpt-image-2 |
$0.03 | $0.04 | 仅文本 |
| 编辑/重塑参考图风格 | gpt-image-2/image-to-image |
$0.03 | $0.04 | 文本 + 1–5 张参考图 |
以上数字直接来自撰写时的实时价格页面——该页面是权威来源。gpt-image-2 标准版使用乘数曲线(1K → 2K 为 1.33×,4K 为 2×),因此 1K 调用花费 $0.03,4K 画布花费 $0.06。图生图变体遵循相同曲线。没有额外的“编辑附加费”——两个模型在相同分辨率下每次调用价格相同。
这种拆分很重要,因为它改变了你对一项工作的思考方式。你不是花一次昂贵的拍摄来买“正确的那张图”。你是花 $0.03 达到接近,然后花 $0.03(或两次)达到精确。
能力一:跨系列风格一致性
大多数文生图工作流崩溃的模式是同一主体在不同的场景中。运行同一提示词两次,你会得到两个不相关的人;运行两个对主体描述宽松的场景提示词,你会得到表亲。
当你做两件事时,gpt-image-2 处理得令人惊讶地好:
- 内联写一份角色设定集。 不是“一个戴眼镜的年轻女性。”而是模型可以重新锚定的具体特征:发色和长度和质感,肤色和雀斑,眼镜和眼镜款式,你在意的每一件衣物。六到十个锚定特征是理想区间。
- 在每个场景中逐字复用设定集。 相同的词序,相同的修饰词。把描述当作 JSON 对象:场景换进来,角色设定集保持字节完全一致。
以下是同一角色设定集在两个不同场景中运行。两个调用中设定集不变;只有场景段落不同。
角色设定集(在两次调用中逐字复用):
"一位二十多岁后期的年轻女性,齐肩波浪深赤褐色头发,
温暖的橄榄色皮肤,鼻梁上散布柔和雀斑,玳瑁色
圆框眼镜,奶油色羊毛高领衫,细金链项链,苔绿色
亚麻西装外套搭在肩上"

场景 A:高北窗旁的大理石咖啡馆桌,白色平白杯带
拉花,海军蓝皮革笔记本打开,黄铜钢笔,背景中黄铜吊灯
模糊,35mm 胶片,浅景深,1:1。

场景 B:黄金时刻的地中海屋顶露台,陶土花盆种着
迷迭香和垂挂常春藤,把同一本海军蓝皮革笔记本抱在
胸前,望向温暖的屋顶和大海,35mm 胶片,与场景 A 匹配
的自然色调,浅景深,1:1。
两次调用,两个场景,同一个人:
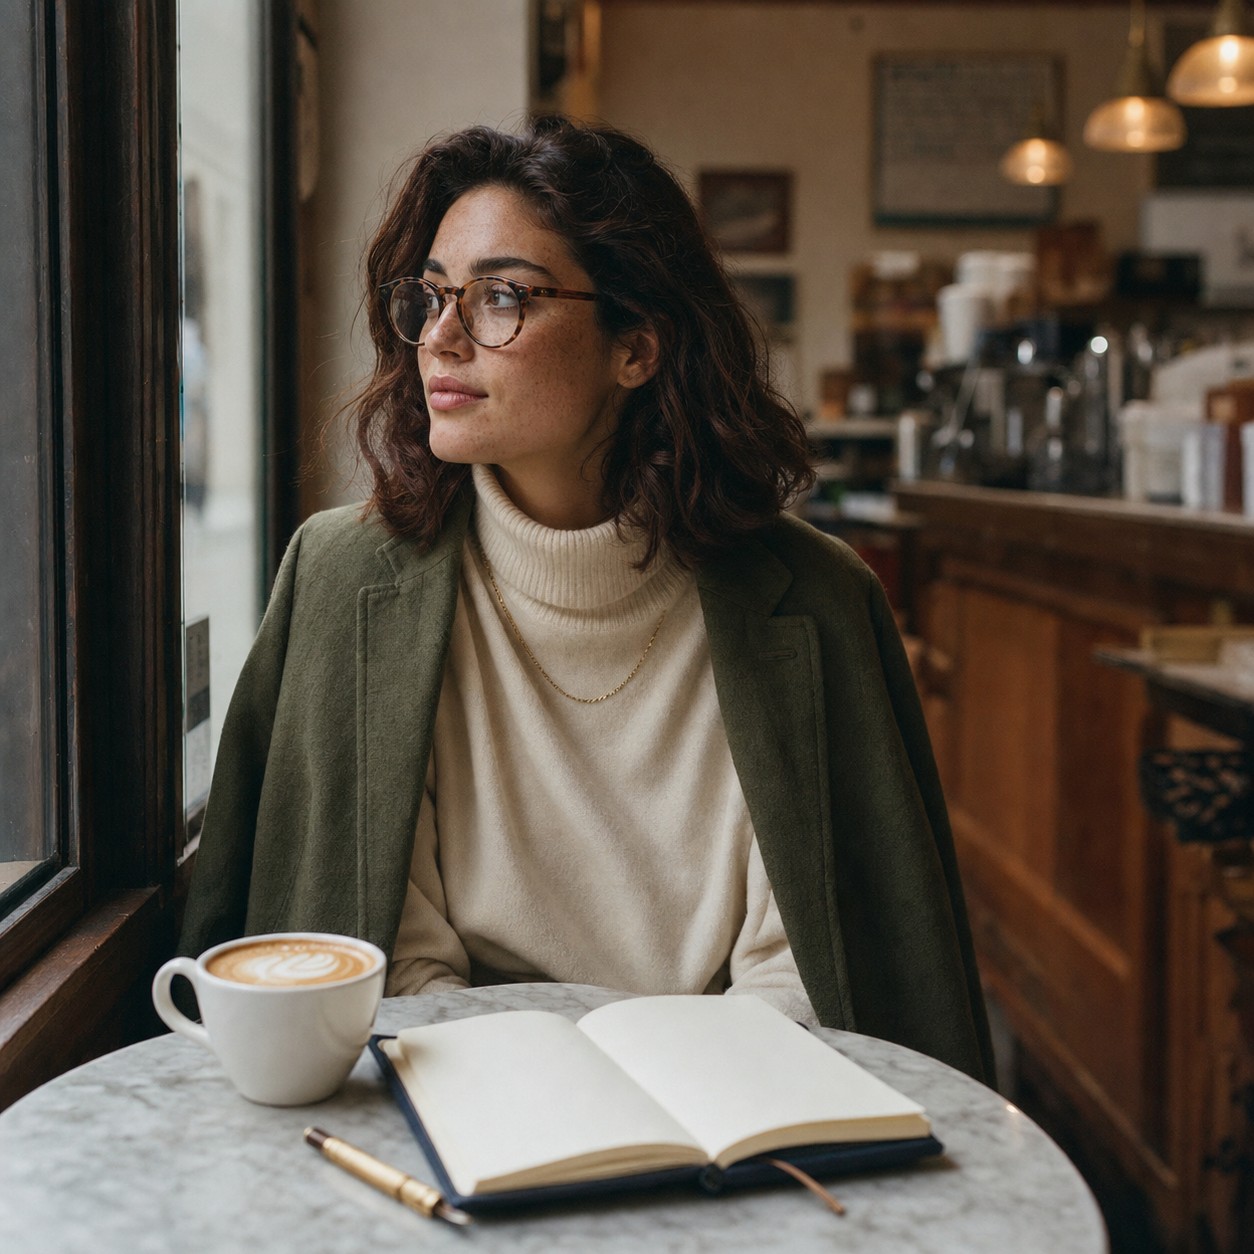
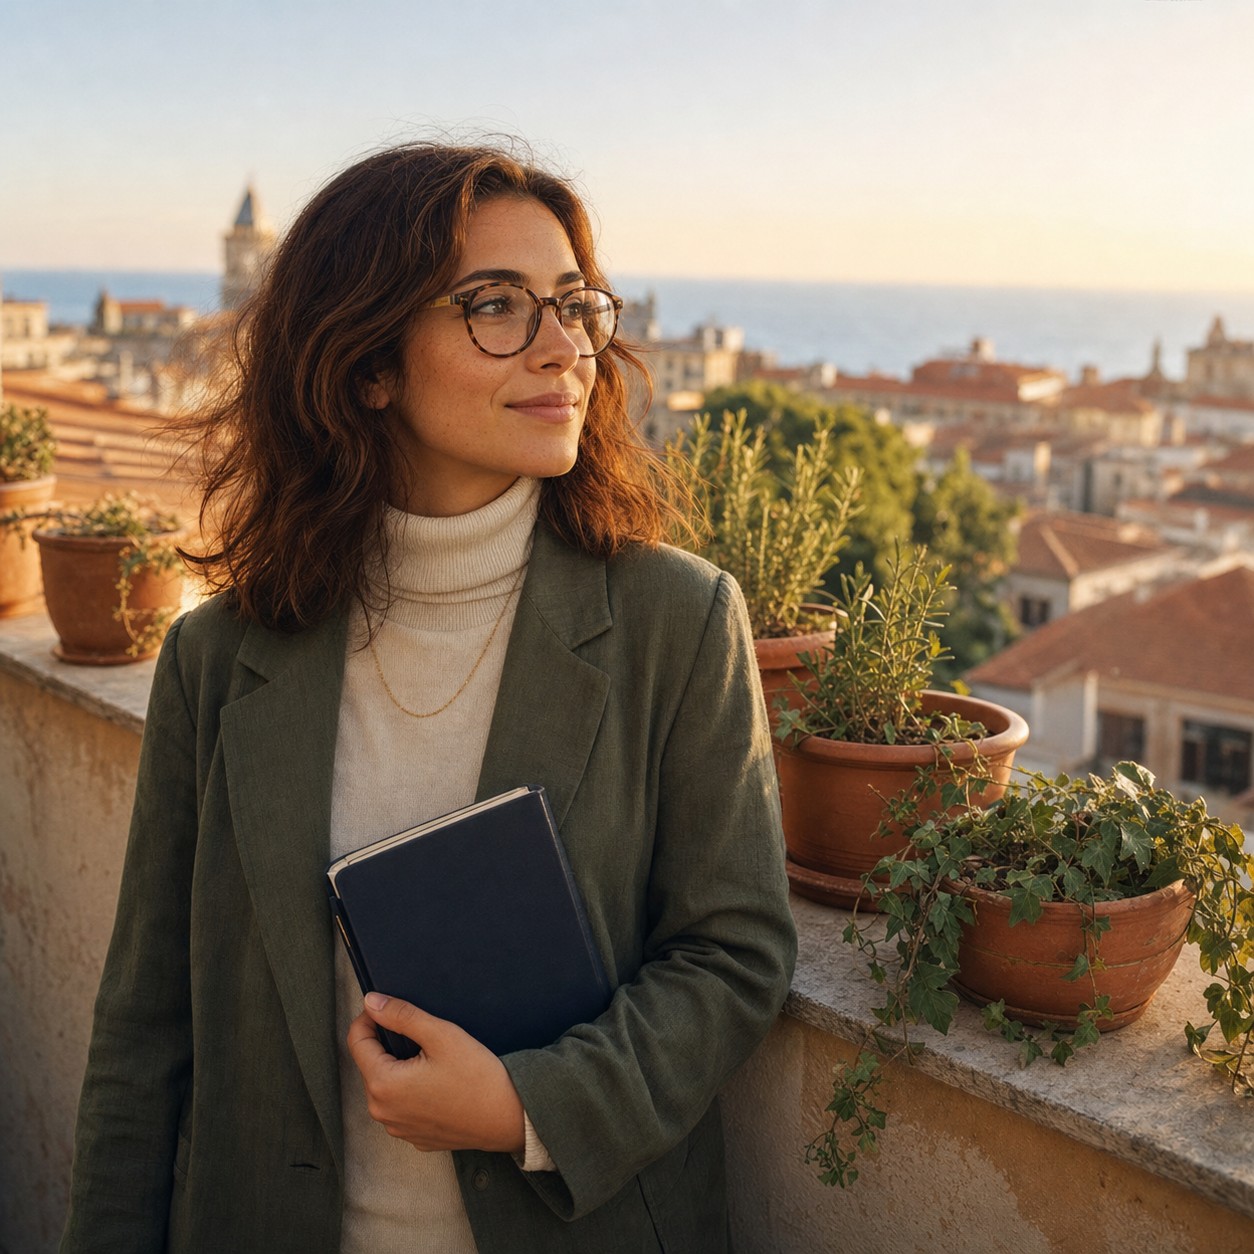
脸型、发长和颜色、眼镜、高领衫、西装外套、项链,甚至笔记本——全都延续下来。光线和色调随场景变化,理应如此;主体不变。
在大规模运行此模式时的一些实用笔记:
- 每个身体部位用三个或更多相关特征锚定。 仅“波浪深赤褐色头发”会漂移。“齐肩波浪深赤褐色头发”加上两个从句后的“玳瑁色圆框眼镜”作为额外锚点,能更牢固地锁定面部。模型将共现特征视为比任何单一特征更强的身份信号。
- 把设定集放在提示词顶部。 场景描述放在后面,而非前面。模型对早期 token 的主体身份权重更高。
- 每个场景以同一个重复的风格修饰词结尾(“35mm 胶片,浅景深,1:1”)。这固定了渲染美学,使两次调用不会看起来像两个不同的摄影师。
对于短系列(同一角色的三到十二帧),此模式首次尝试通常能达到 80% 以上的一致性。这对于情绪板、博客插图、社交系列、营销档期已经足够好。对于每一帧都必须匹配的品牌关键工作,跳到能力二。
能力二:带参考图的多轮编辑
通过提示词实现风格一致性让你接近。图生图变体让你精确。你给它一个参考(一到五张图)和一段说明要改什么的提示词——它改那里,其余不动。
最常见的用法是品牌资产上的场景替换:同一产品、同一把椅子、同一角色在不同环境中,主体像素级忠实保留,环境围绕它重绘。
参考照——一把雕塑感胡桃木休闲椅,置于无缝奶油色背景上,用 gpt-image-2 生成:
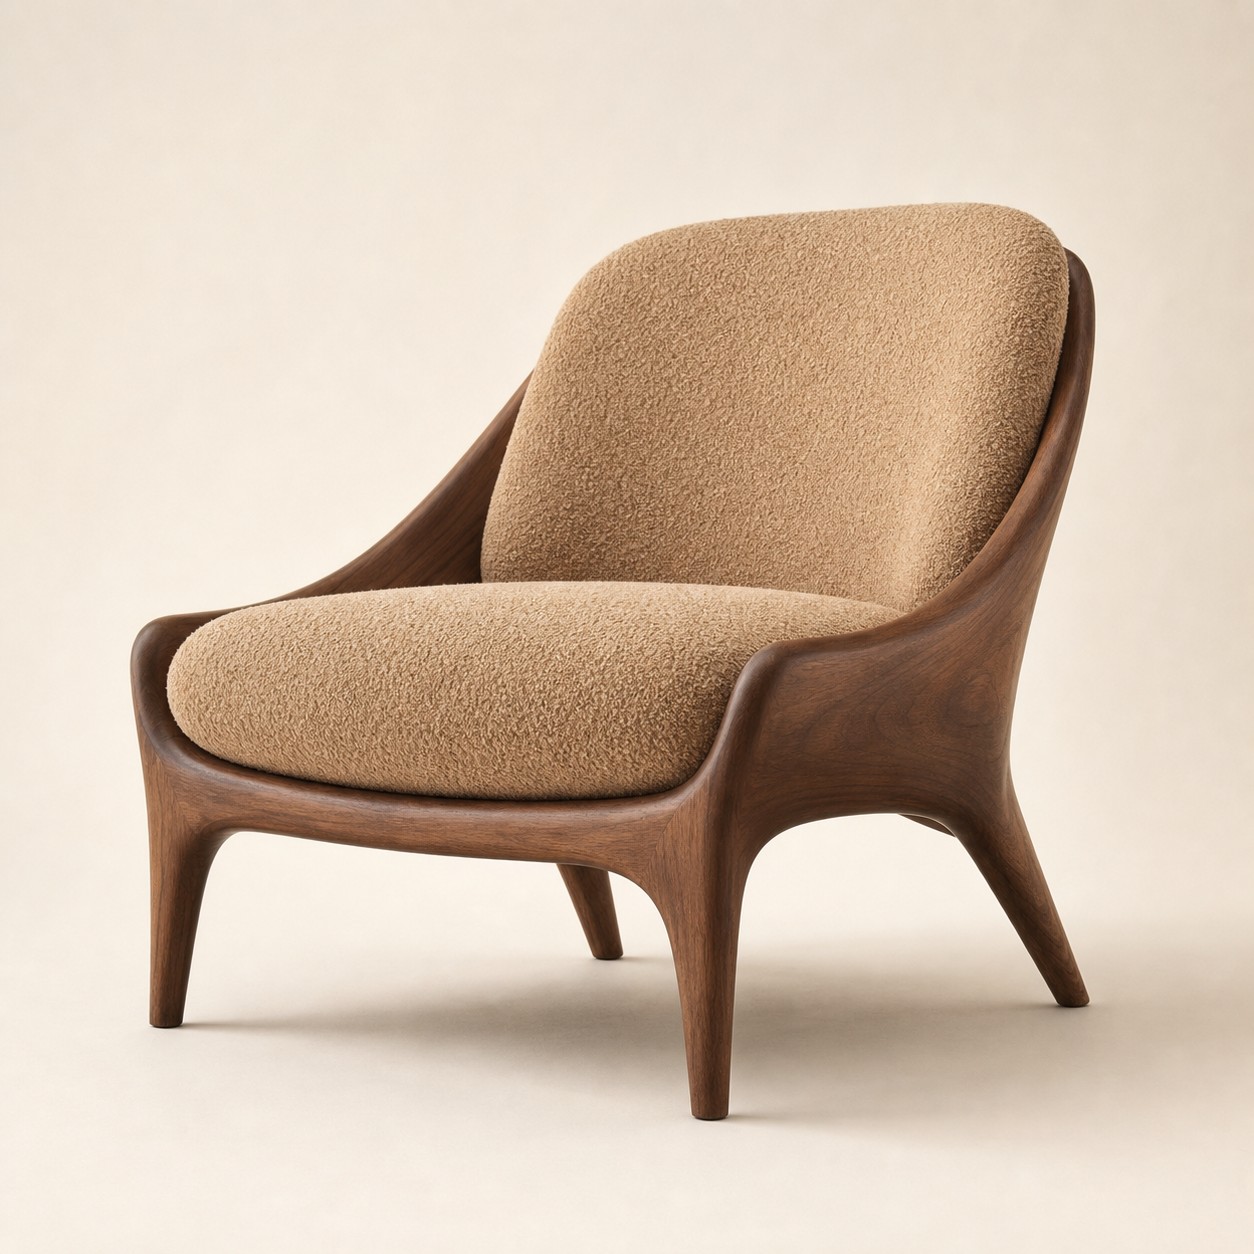
现在将那张确切的图像发送给 gpt-image-2/image-to-image,附上环境替换提示词:
将这把确切的椅子重塑进一个光线丰富的编辑式环境场景,
而不改变椅子本身:保持胡桃木框架形状、驼色
圈绒坐垫、腿的比例、确切的轮廓像素级忠实
相同。将无缝奶油色背景替换为温暖阳光充足的阅读
角落:左上方一扇高大的拱形窗,在宽大的橡木地板
上投下长长的午后晚些时候的阴影,右侧一张深色
染色白蜡木小圆边桌,桌上一个陶瓷花瓶插着三枝
干小麦,椅子一侧扶手上搭着一条折叠的天然亚麻毯,
下方铺着一块柔和奶油色与褪色陶土色的
复古柏柏尔风格地毯。氛围温暖的午后光线,略带
薄雾的空气,杂志室内摄影,匹配中性色调。
结果——同一把椅子,新房间:
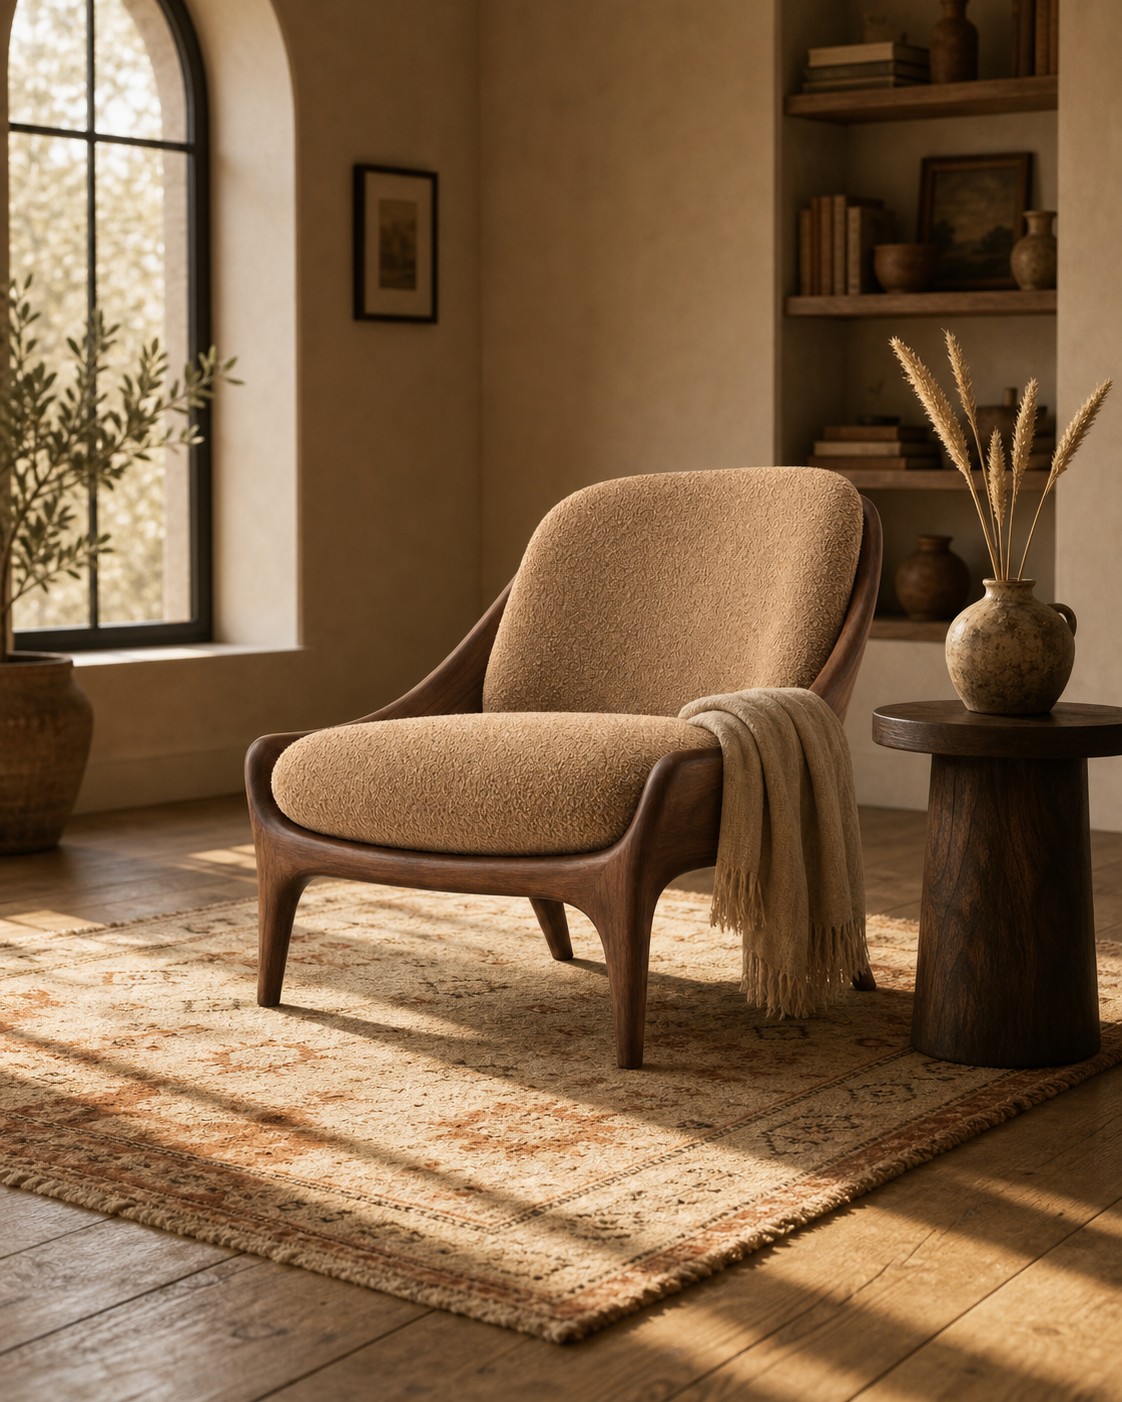
框架形状、坐垫面料、色调和腿的几何结构干净地延续。无缝背景不见了;围绕那个品牌控制元素绘制了一个完整环境。
编辑变体擅长什么:
- 场景替换。 将孤立主体拉入环境,或将环境主体移到新环境。
- 精准属性更改。 “将坐垫面料改为海军蓝天鹅绒,其余一切保持相同”——比从头重新提示整个场景效果好得多。
- 构图微调。 “同一把椅子,同一房间,相机后退一步并在毯子上加一只小狗”——模型编辑而非重绘。
- 品牌资产重塑。 将一张活动情绪板作为参考,加上要求三个匹配变体的提示词,比三个独立的文本提示词更好地保持基调。
它不擅长什么(改用标准文生图):
- 重大构图重写。 如果画面 60% 以上需要改变,最好从新提示词开始。
- 角色替换。 如果你的意思是“同一把椅子但不同的椅子”,那是新提示词,不是编辑。
代码:两个模型,端到端
两个模型都在 POST /v1/tasks 应答。文生图调用在 input 中发送提示词;图生图调用添加一个 input_urls 数组,携带一到五个参考图 URL。
文生图(gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # 角色设定集在前——早期 token 携带身份。
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # 场景其次。
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # 风格修饰词最后——固定系列的外观。
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
对于 2K 画布,设置 "resolution": "2K"。定价按实时价格页面以 1.33× 缩放——调用形态相同,$0.04 而非 $0.03。
图生图(gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
同一调用中最多可携带五张参考图——向 input_urls 数组追加更多 URL。模型将参考视为一个小型的风格/身份上下文,然后写入提示词中指定的编辑。注意参考是托管的 URL,而非内联 base64——如果你的参考在磁盘上,先将其上传到可访问的位置(对象存储、你的 CDN)并传递链接。
几条操作笔记:
- 1K 端到端预计 60–120 秒;2K 更长。异步流程意味着没有长时间保持的 HTTP 连接会超时——每隔几秒轮询,或在创建调用中设置
callback.url让 hiapi POST 你终态。 - 不要阻塞请求处理器等待生成。 API 已经给你一个任务 ID——持久化
taskId,让轮询器或回调完成工作,而不是保持 serverless 调用打开。 - 编辑变体要避免的两种参数组合:
aspect_ratio: "auto"(或省略)仅支持1K分辨率,且1:1不能与4K配对。 - 参考图用你想要的输出分辨率。 发送 512×512 参考并要求 2K 输出可行,但模型锚定的细节更少。对于品牌忠实的编辑,以目标输出尺寸发送参考。
何时用哪个(以及 hiapi 还提供什么)
当你需要文本渲染、跨小系列的角色或产品一致性,或对品牌资产进行精准编辑时,gpt-image-2 及其图生图兄弟是合适的默认选择。它们不是 hiapi 上唯一的图像选项,它们之间的选择比看起来更重要:
| 需求 | 模型 | 原因 |
|---|---|---|
| 从提示词出初稿,探索 | gpt-image-2 ($0.03) |
系列中最便宜;设定集加场景模式能带你走很远。 |
| 精准编辑 / 场景替换 / 品牌重塑 | gpt-image-2/image-to-image ($0.03) |
相同价格,但锚定参考。任何输出必须匹配现有资产时都是正确选择。 |
| 高保真 4K 营销画布 | gpt-image-2 4K ($0.06) |
标准变体暴露 4K 层级,干净的 2× 乘数——通往大画布的最便宜路径。 |
| 生产主视觉,重新生成成本高 | gpt-image-2-pro ($0.35) |
同系列中的稳定性层级,约 10× 标准价格,用于一次糟糕渲染比十次好渲染更贵的那一小部分工作。 |
| 照片级单主体肖像,无需编辑 | flux-1.1-pro ($0.05) |
hiapi 上的 FLUX 1.1 Pro 是写实专家,当你不需要文本渲染或多轮编辑时。 |
| 速度关键的编辑,大规模角色一致性 | Nano-Banana-2 ($0.085 at 1K) |
Google 的 Gemini 3.1 Flash Image 变体——不同的身份特征,类似的编辑模式,更快周转,代价是更高的每次调用价格。 |
上表中的价格列来自平台的实时价格——在你自己的内部估算中引用数字前刷新它。
一个可以照搬的模式
如果你有一个现有流水线,每个请求调用一次 gpt-image-2,最便宜的升级是引入第二次调用:
def render(job):
    # 1) 从提示词出初稿。
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) 如果工作品牌关键或需要场景替换,
    #    编辑初稿而不是重新提示。
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # 要改什么
            "input_urls": [draft.output_url],    # 要保留什么
            "resolution": "1K",
        })

    return draft
两次调用每次 $0.03,总计 $0.06——仍然比单次 gpt-image-2-pro 调用($0.35)便宜,且对大多数工作,第二次调用替代了三到四轮丢弃并重新提示。输出越需要品牌忠实,这笔账越划算。
简短版本
gpt-image-2 是初稿引擎。gpt-image-2/image-to-image 是编辑器。结合使用,它们覆盖了单次调用图像生成无法覆盖的 workflows——角色系列、品牌资产重塑、精准属性更改——而无需升级到 Pro 层级。
回报最大的两个模式是:(1) 跨场景逐字复用角色设定集以实现系列一致性;(2) 任何输出必须看起来像现有资产延伸的工作,采用先渲染后编辑的两次调用流程。两者在 hiapi 的 /v1/tasks 端点上每次调用 $0.03 即可完成,且都以相同的任务载荷形态交付——一个 worker 函数覆盖这一对。
确认实时价格,写一次设定集,让编辑器完成重新提示无法完成的工作。


