
Tutorial
GPT Image 2 Mehrrunden-Bearbeitung und Stilkonsistenz: Eine Reise durch die Fähigkeiten von hiapi
Wie Sie gpt-image-2 und gpt-image-2-image-to-image kombinieren, um charakterkonsistente Bildserien und präzise Bearbeitungen zu erstellen – für nur $0.03 pro Aufruf auf hiapi.
Die meisten Beiträge der Art „GPT Image 2 ist der Wahnsinn" zeigen Ihnen nur ein einzelnes Rendering. Das ist die leichte Hälfte. Die schwere Hälfte – und die, die wirklich zählt, wenn Sie Bildarbeit in ein Produkt ausliefern – ist das zweite Rendering und das dritte: eine Figur über eine Bildserie hinweg erkennbar zu halten oder ein Key-Visual-Asset neu zu gestalten, ohne das zu zerstören, was es ursprünglich erfolgreich gemacht hat.
gpt-image-2 auf hiapi sind zwei Modelle, nicht eines. Die Standard-Text-zu-Bild-Variante zeichnet das erste Frame; gpt-image-2/image-to-image nimmt dieses Frame als Referenz zurück und bearbeitet es. Zusammen decken sie – bei $0.03 pro Aufruf – die Workflows ab, die in der echten Produktion auftreten: charakterkonsistente Serien, präziser Szenenaustausch, Neugestaltung von Marken-Assets. Dieser Artikel behandelt beide nacheinander, mit originellen Prompts, echten Ausgaben und direkt kopierbarem Code.
Zwei Modelle, ein Workflow
Beide Varianten nutzen die einheitliche asynchrone Task-API von hiapi – POST https://api.hiapi.ai/v1/tasks erstellt einen Generierungs-Task und gibt eine Task-ID zurück, GET /v1/tasks/:id liefert nach Abschluss die Bild-URL. Der Unterschied liegt darin, was Sie in das input-Objekt geben.
| Anwendungsfall | Modell | 1K-Preis | 2K-Preis | Eingabeform |
|---|---|---|---|---|
| Erstes Rendering aus Prompt generieren | gpt-image-2 |
$0.03 | $0.04 | Nur Text |
| Referenzbild bearbeiten / Stil neu gestalten | gpt-image-2/image-to-image |
$0.03 | $0.04 | Text + 1–5 Referenzbilder |
Die obigen Zahlen stammen direkt von der Live-Preisseite zum Zeitpunkt der Erstellung – diese Seite ist die maßgebliche Quelle. Die Standardversion von gpt-image-2 verwendet eine Multiplikatorkurve (1K → 2K ist 1,33×, 4K ist 2×), sodass ein 1K-Aufruf $0.03 kostet und eine 4K-Leinwand $0.06. Die Image-to-Image-Variante folgt derselben Kurve. Es gibt keinen zusätzlichen „Bearbeitungszuschlag" – beide Modelle kosten bei gleicher Auflösung pro Aufruf dasselbe.
Diese Aufteilung ist wichtig, weil sie ändert, wie Sie über eine Aufgabe denken. Sie kaufen nicht mit einem teuren Shooting „das richtige Bild". Sie geben $0.03 aus, um nah heranzukommen, und dann $0.03 (oder zweimal), um exakt zu werden.
Fähigkeit eins: Stilkonsistenz über eine Serie hinweg
Das Muster, an dem die meisten Text-zu-Bild-Workflows scheitern, ist dieselbe Person in verschiedenen Szenen. Führen Sie denselben Prompt zweimal aus, erhalten Sie zwei unabhängige Personen; führen Sie zwei Szenen-Prompts mit lockerer Beschreibung der Person aus, erhalten Sie Cousinen.
gpt-image-2 meistert das überraschend gut, wenn Sie zwei Dinge tun:
- Schreiben Sie ein Charakter-Sheet inline. Nicht „eine junge Frau mit Brille". Sondern konkrete Merkmale, an denen das Modell sich neu verankern kann: Haarfarbe und Länge und Textur, Hautton und Sommersprossen, Brille und Brillenstil, jedes Kleidungsstück, das Ihnen wichtig ist. Sechs bis zehn Ankerpunkte sind der ideale Bereich.
- Verwenden Sie das Sheet in jeder Szene wörtlich wieder. Gleiche Wortreihenfolge, gleiche Modifikatoren. Behandeln Sie die Beschreibung wie ein JSON-Objekt: Die Szene wird ausgetauscht, das Charakter-Sheet bleibt bytegenau identisch.
Hier ist dasselbe Charakter-Sheet in zwei verschiedenen Szenen. Das Sheet ist in beiden Aufrufen unverändert; nur der Szenenabsatz unterscheidet sich.
Charakter-Sheet (in beiden Aufrufen wörtlich wiederverwendet):
"eine junge Frau Ende zwanzig, schulterlange wellige dunkelkastanienbraune
Haare, warmer olivfarbener Hautton, sanfte Sommersprossen auf der
Nasenbrücke, runde Schildpatt-Brille, cremefarbener Wollrollkragenpullover,
feine Goldkette, moosgrüner Leinenblazer über der Schulter"

Szene A: Marmor-Cafétisch an einem hohen Nordfenster, weiße Flat-White-
Tasse mit Latte Art, aufgeschlagenes marineblaues Leder-Notizbuch,
Messing-Füllfederhalter, Messing-Pendelleuchte unscharf im Hintergrund,
35-mm-Film, geringe Schärfentiefe, 1:1.

Szene B: mediterrane Dachterrasse zur goldenen Stunde, Terrakottatöpfe mit
Rosmarin und hängendem Efeu, dasselbe marineblaue Leder-Notizbuch an
die Brust gedrückt, Blick über warme Dächer und das Meer, 35-mm-Film,
natürliche Farbtöne passend zu Szene A, geringe Schärfentiefe, 1:1.
Zwei Aufrufe, zwei Szenen, dieselbe Person:
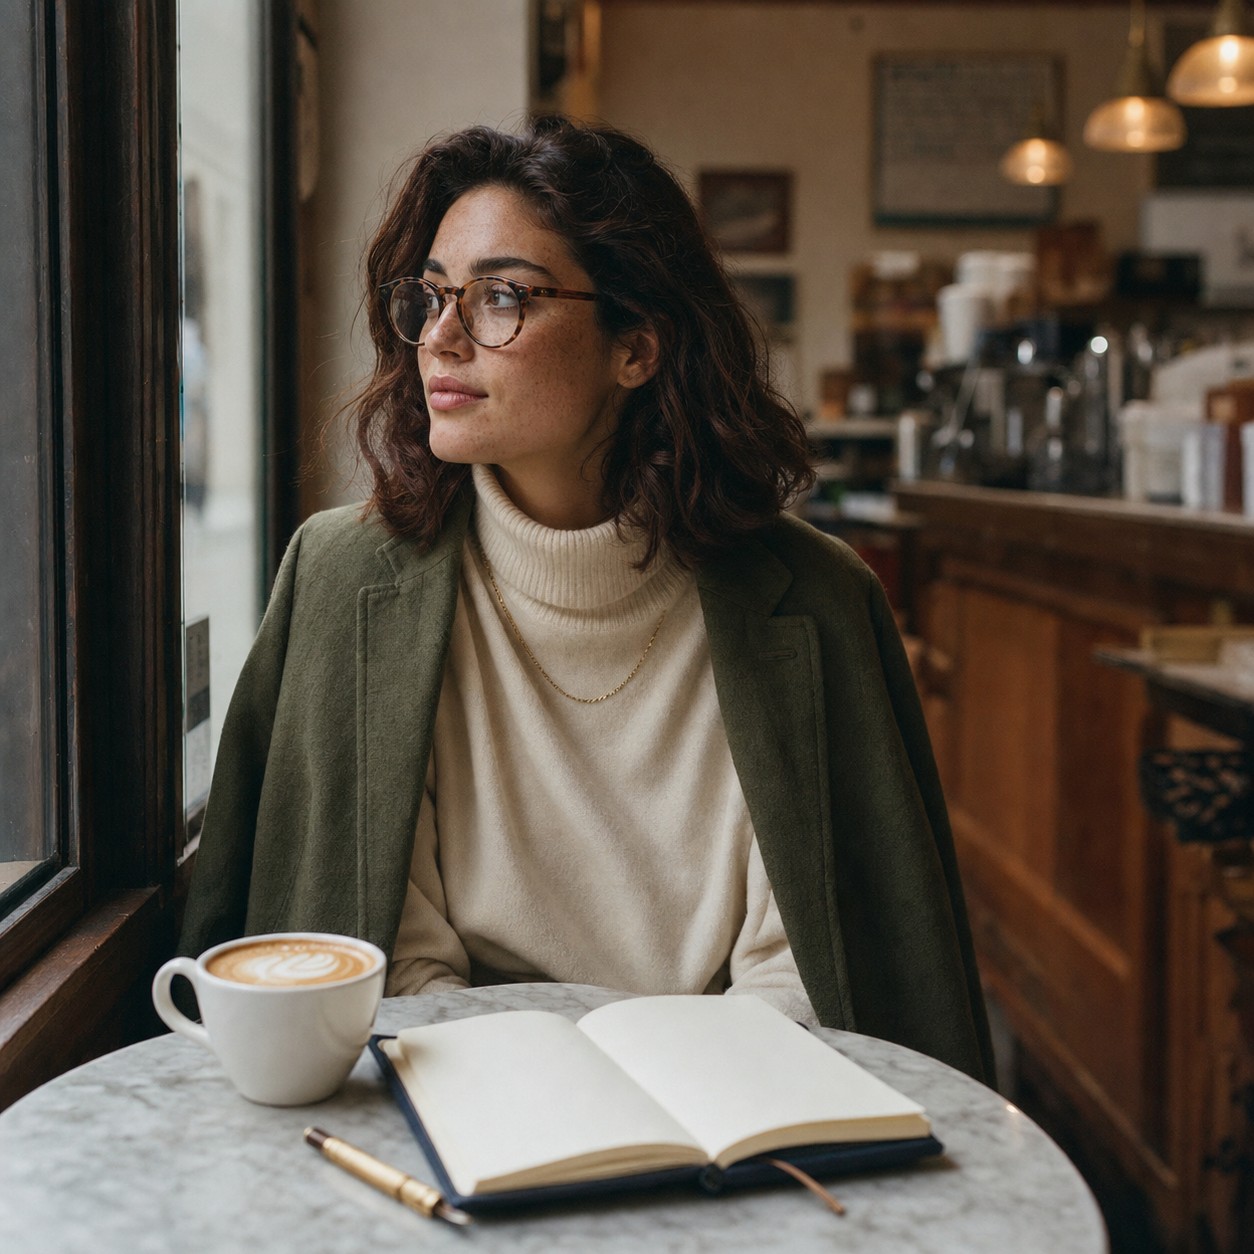
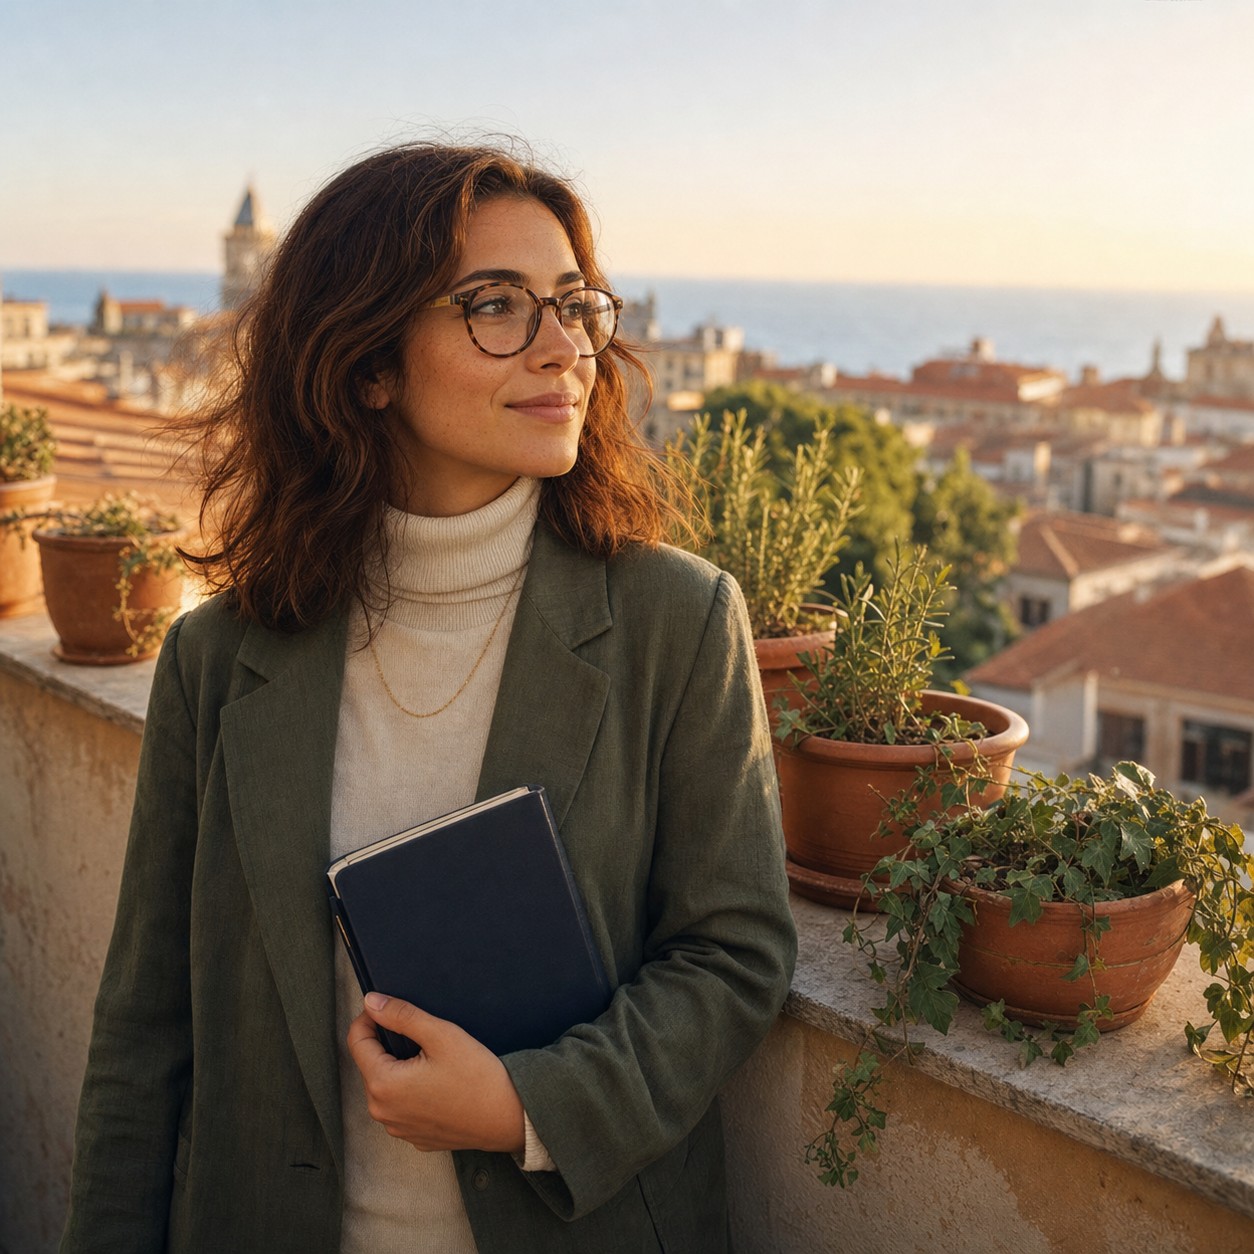
Gesichtsform, Haarlänge und -farbe, Brille, Rollkragenpullover, Blazer, Kette und sogar das Notizbuch – alles bleibt erhalten. Licht und Farbton ändern sich je nach Szene, wie es sein sollte; die Person bleibt gleich.
Einige praktische Hinweise beim Ausführen dieses Musters in großem Maßstab:
- Verankern Sie jeden Körperbereich mit drei oder mehr zusammenhängenden Merkmalen. „wellige dunkelkastanienbraune Haare" allein driftet. „schulterlange wellige dunkelkastanienbraune Haare" plus „runde Schildpatt-Brille" zwei Sätze später als zusätzlicher Anker fixiert das Gesicht stärker. Das Modell behandelt ko-auftretende Merkmale als stärkeres Identitätssignal als jedes einzelne Merkmal.
- Setzen Sie das Sheet an den Anfang des Prompts. Die Szenenbeschreibung folgt danach, nicht davor. Das Modell gewichtet die Identität der Person in frühen Tokens stärker.
- Beenden Sie jede Szene mit demselben wiederholten Stil-Modifikator („35-mm-Film, geringe Schärfentiefe, 1:1"). Das fixiert die Rendering-Ästhetik, sodass die beiden Aufrufe nicht wie zwei verschiedene Fotografen wirken.
Für kurze Serien (drei bis zwölf Frames derselben Figur) erreicht dieses Muster beim ersten Versuch typischerweise über 80 % Konsistenz. Das ist gut genug für Moodboards, Blog-Illustrationen, Social-Serien und Marketing-Kampagnen. Für markenkritische Arbeiten, bei denen jedes Frame passen muss, springen Sie zu Fähigkeit zwei.
Fähigkeit zwei: Mehrrunden-Bearbeitung mit Referenzbildern
Stilkonsistenz über Prompts bringt Sie nah heran. Die Image-to-Image-Variante macht es exakt. Sie geben ihr eine Referenz (ein bis fünf Bilder) und einen Prompt, der beschreibt, was geändert werden soll – sie ändert dort und lässt den Rest unverändert.
Der häufigste Anwendungsfall ist Szenenaustausch bei Marken-Assets: dasselbe Produkt, derselbe Stuhl, dieselbe Figur in verschiedenen Umgebungen, wobei das Subjekt pixelgenau erhalten bleibt und die Umgebung um es herum neu gezeichnet wird.
Das Referenzfoto – ein skulpturaler Loungesessel aus Walnussholz auf nahtlosem cremefarbenem Hintergrund, generiert mit gpt-image-2:
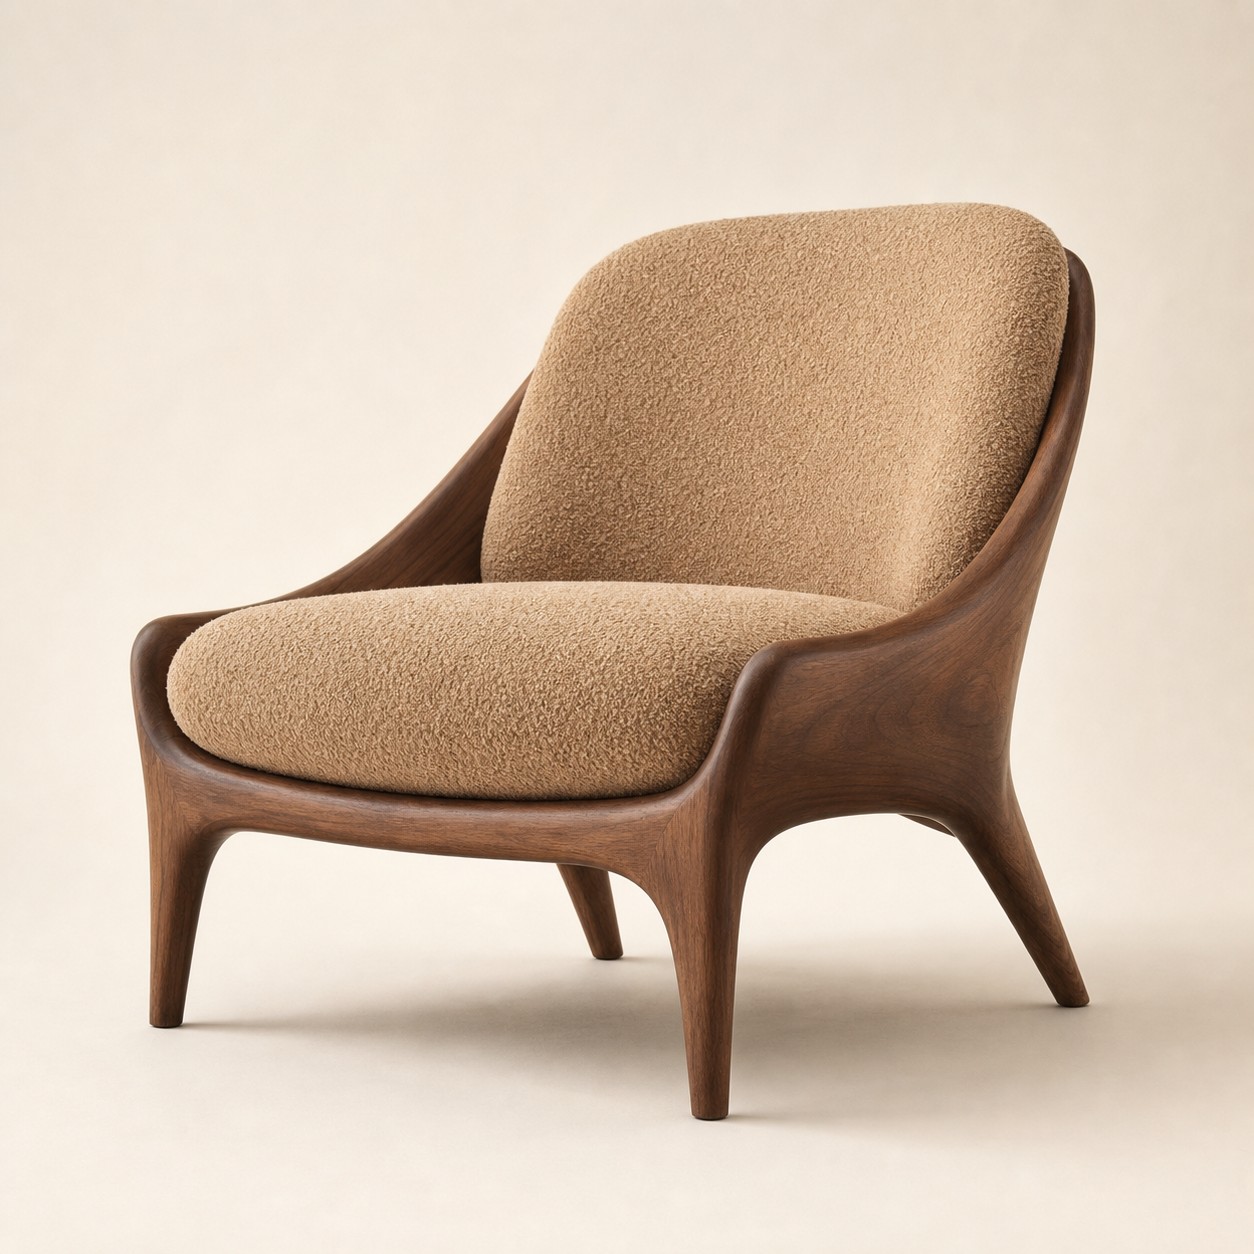
Senden Sie nun genau dieses Bild an gpt-image-2/image-to-image mit dem Umgebungsaustausch-Prompt:
Gestalte genau diesen Stuhl in eine lichtdurchflutete editoriale
Umgebungsszene um, ohne den Stuhl selbst zu verändern: Bewahre die
Form des Walnussrahmens, das kamelfarbene Bouclé-Kissen, die
Proportionen der Beine und die exakte Silhouette pixelgenau
identisch. Ersetze den nahtlosen cremefarbenen Hintergrund durch
eine warme, sonnige Leseecke: ein hohes Bogenfenster oben links,
das lange Spätnachmittagsschatten auf einen breiten Eichen-
Dielenboden wirft, rechts ein kleiner runder Beistelltisch aus
dunkel gebeizter Esche, darauf eine Keramikvase mit drei
getrockneten Weizenhalmen, eine gefaltete Decke aus naturbelassenem
Leinen über einer Armlehne des Stuhls, darunter ein Vintage-
Teppich im Berber-Stil in sanftem Creme und verblasstem Terrakotta.
Warmes Nachmittagslicht, leicht dunstige Luft, Magazin-
Innenraumfotografie, passende neutrale Farbtöne.
Das Ergebnis – derselbe Stuhl, neuer Raum:
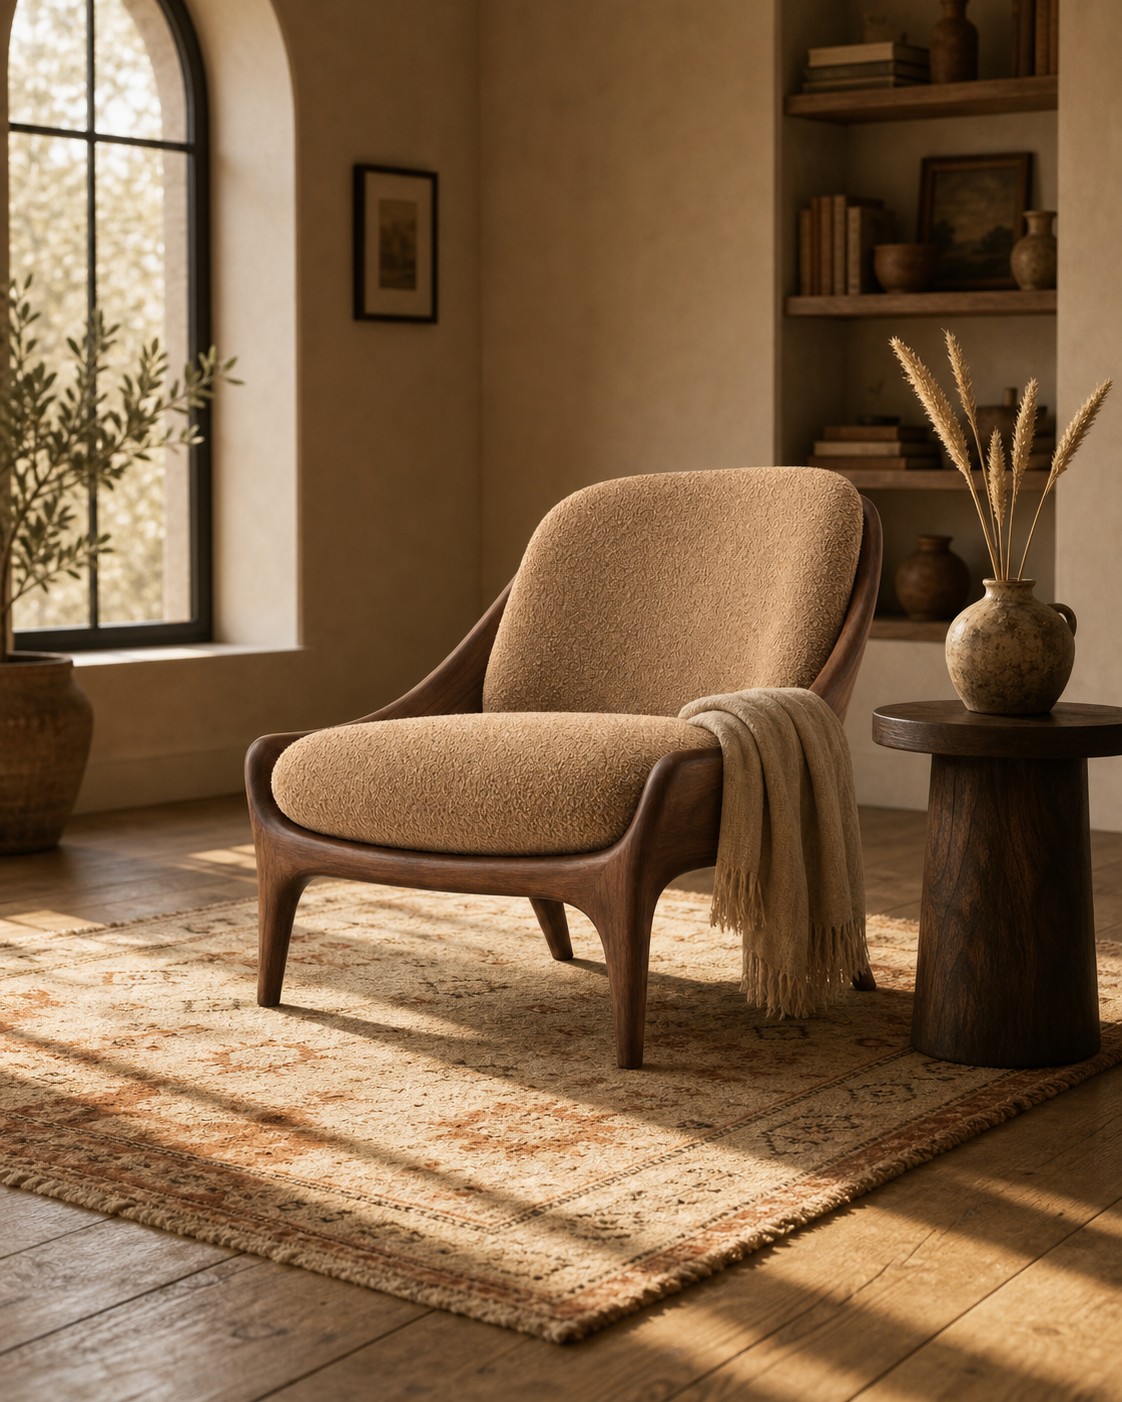
Rahmenform, Kissenstoff, Farbton und Beingeometrie bleiben sauber erhalten. Der nahtlose Hintergrund ist verschwunden; um dieses markenkontrollierte Element herum wurde eine vollständige Umgebung gezeichnet.
Was die Bearbeitungsvariante gut kann:
- Szenenaustausch. Ein isoliertes Subjekt in eine Umgebung ziehen oder ein Subjekt aus einer Umgebung in eine neue versetzen.
- Präzise Attributänderungen. „Ändere den Kissenstoff zu marineblauem Samt, alles andere bleibt gleich" – funktioniert viel besser, als die gesamte Szene von Grund auf neu zu prompten.
- Feinjustierung der Komposition. „Derselbe Stuhl, derselbe Raum, Kamera einen Schritt zurück und ein kleiner Hund auf der Decke" – das Modell bearbeitet statt neu zu zeichnen.
- Neugestaltung von Marken-Assets. Ein Kampagnen-Moodboard als Referenz plus ein Prompt für drei passende Varianten bewahrt den Ton besser als drei unabhängige Text-Prompts.
Was es nicht gut kann (verwenden Sie stattdessen Standard-Text-zu-Bild):
- Umfassende Neukomposition. Wenn mehr als 60 % des Bildes geändert werden müssen, ist es besser, mit einem neuen Prompt zu beginnen.
- Figurenaustausch. Wenn Sie „derselbe Stuhl, aber ein anderer Stuhl" meinen, ist das ein neuer Prompt, keine Bearbeitung.
Code: zwei Modelle, Ende-zu-Ende
Beide Modelle antworten auf POST /v1/tasks. Der Text-zu-Bild-Aufruf sendet den Prompt in input; der Image-to-Image-Aufruf fügt ein input_urls-Array hinzu, das ein bis fünf Referenzbild-URLs trägt.
Text-zu-Bild (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # Charakter-Sheet zuerst – frühe Tokens tragen die Identität.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # Szene als Nächstes.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # Stil-Modifikator zuletzt – fixiert das Aussehen der Serie.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Für eine 2K-Leinwand setzen Sie "resolution": "2K". Die Preisgestaltung skaliert gemäß Live-Preisseite mit 1,33× – gleiche Aufrufform, $0.04 statt $0.03.
Image-to-Image (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Sie können bis zu fünf Referenzbilder im selben Aufruf tragen – fügen Sie einfach weitere URLs zum input_urls-Array hinzu. Das Modell behandelt die Referenzen als kleinen Stil-/Identitätskontext und schreibt dann die im Prompt angegebene Bearbeitung. Beachten Sie, dass Referenzen gehostete URLs sind, kein Inline-Base64 – wenn Ihre Referenz auf der Festplatte liegt, laden Sie sie zuerst an einen erreichbaren Ort hoch (Objektspeicher, Ihr CDN) und übergeben Sie den Link.
Einige Betriebshinweise:
- Rechnen Sie mit 60–120 Sekunden Ende-zu-Ende bei 1K; 2K dauert länger. Der asynchrone Ablauf bedeutet, dass keine lang offen gehaltene HTTP-Verbindung in einen Timeout läuft – fragen Sie alle paar Sekunden ab oder setzen Sie
callback.urlim Erstellungsaufruf, damit hiapi Ihnen den Endzustand per POST übermittelt. - Blockieren Sie den Request-Handler nicht, während Sie auf die Generierung warten. Die API gibt Ihnen bereits eine Task-ID – persistieren Sie die
taskIdund lassen Sie einen Poller oder Callback die Arbeit erledigen, statt den Serverless-Aufruf offen zu halten. - Zwei Parameterkombinationen, die Sie bei der Bearbeitungsvariante vermeiden sollten:
aspect_ratio: "auto"(oder Weglassen) wird nur mit der Auflösung1Kunterstützt, und1:1lässt sich nicht mit4Kkombinieren. - Verwenden Sie Referenzbilder in der gewünschten Ausgabeauflösung. Es funktioniert, eine 512×512-Referenz zu senden und 2K-Ausgabe anzufordern, aber das Modell hat dann weniger Details zum Verankern. Für markengetreue Bearbeitungen senden Sie die Referenz in der Ziel-Ausgabegröße.
Wann Sie welches verwenden (und was hiapi sonst noch bietet)
Wenn Sie Textrendering, konsistente Figuren oder Produkte über eine kleine Serie hinweg oder präzise Bearbeitungen von Marken-Assets benötigen, sind gpt-image-2 und sein Image-to-Image-Bruder die passende Standardwahl. Sie sind nicht die einzigen Bildoptionen auf hiapi, und die Wahl zwischen ihnen ist wichtiger, als es scheint:
| Anforderung | Modell | Warum |
|---|---|---|
| Erster Entwurf aus Prompt, Exploration | gpt-image-2 ($0.03) |
Günstigstes der Serie; das Muster aus Charakter-Sheet plus Szene bringt Sie weit. |
| Präzise Bearbeitung / Szenenaustausch / Marken-Neugestaltung | gpt-image-2/image-to-image ($0.03) |
Gleicher Preis, aber mit Referenzverankerung. Die richtige Wahl, wann immer eine Ausgabe zu einem bestehenden Asset passen muss. |
| Hochauflösende 4K-Marketing-Leinwand | gpt-image-2 4K ($0.06) |
Die Standardvariante bietet die 4K-Stufe, sauberer 2×-Multiplikator – der günstigste Weg zur großen Leinwand. |
| Produktions-Key-Visual, hohe Regenerierungskosten | gpt-image-2-pro ($0.35) |
Die Stabilitätsstufe derselben Serie, etwa 10× Standardpreis, für den kleinen Anteil an Arbeit, bei dem ein schlechtes Rendering teurer ist als zehn gute. |
| Fotorealistisches Einzelporträt ohne Bearbeitung | flux-1.1-pro ($0.05) |
FLUX 1.1 Pro auf hiapi ist der Realismus-Spezialist, wenn Sie kein Textrendering oder keine Mehrrunden-Bearbeitung benötigen. |
| Geschwindigkeitskritische Bearbeitung, Figurenkonsistenz in großem Maßstab | Nano-Banana-2 ($0.085 bei 1K) |
Googles Gemini-3.1-Flash-Image-Variante – andere Identitätsmerkmale, ähnliches Bearbeitungsmuster, schnellere Durchlaufzeit, um den Preis eines höheren Preises pro Aufruf. |
Die Preisspalten in der obigen Tabelle stammen von der Live-Preisseite der Plattform – aktualisieren Sie sie, bevor Sie Zahlen in Ihren eigenen internen Kalkulationen zitieren.
Ein Muster, das Sie übernehmen können
Wenn Sie eine bestehende Pipeline haben, die pro Anfrage einmal gpt-image-2 aufruft, ist das günstigste Upgrade, einen zweiten Aufruf einzuführen:
def render(job):
    # 1) Ersten Entwurf aus Prompt erstellen.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Wenn die Arbeit markenkritisch ist oder einen Szenenaustausch
    #    benötigt, den Entwurf bearbeiten statt neu zu prompten.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # was geändert werden soll
            "input_urls": [draft.output_url],    # was erhalten bleiben soll
            "resolution": "1K",
        })

    return draft
Zwei Aufrufe zu je $0.03, insgesamt $0.06 – immer noch günstiger als ein einzelner Aufruf von gpt-image-2-pro ($0.35), und für die meisten Arbeiten ersetzt der zweite Aufruf drei bis vier Runden aus Verwerfen und erneutem Prompten. Je markengetreuer die Ausgabe sein muss, desto besser geht die Rechnung auf.
Die Kurzfassung
gpt-image-2 ist die Entwurfs-Engine. gpt-image-2/image-to-image ist der Editor. Zusammen decken sie Workflows ab, die Einzelaufruf-Bildgenerierung nicht abdeckt – Figurenserien, Neugestaltung von Marken-Assets, präzise Attributänderungen – ohne auf die Pro-Stufe aufsteigen zu müssen.
Die beiden Muster mit dem größten Nutzen sind: (1) das Charakter-Sheet szenenübergreifend wörtlich wiederverwenden für Serienkonsistenz; (2) für alle Arbeiten, bei denen die Ausgabe wie eine Erweiterung eines bestehenden Assets aussehen muss, den zweistufigen Ablauf aus erst rendern, dann bearbeiten verwenden. Beides gelingt am /v1/tasks-Endpunkt von hiapi für $0.03 pro Aufruf, und beides liefert dieselbe Task-Payload-Form – eine Worker-Funktion deckt das Paar ab.
Prüfen Sie den Live-Preis, schreiben Sie das Sheet einmal und lassen Sie den Editor die Arbeit erledigen, die erneutes Prompten nicht schafft.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses