
튜토리얼
GPT Image 2 다중 턴 편집과 스타일 일관성: hiapi 기능 여정
gpt-image-2와 gpt-image-2-image-to-image를 결합해 일관된 캐릭터 시리즈 이미지와 정밀 편집을 만드는 방법 — hiapi에서 호출당 단 $0.03.
대부분의 “GPT Image 2 정말 놀랍다”는 글은 단일 렌더링 이미지 하나만 보여줍니다. 그것은 쉬운 절반일 뿐입니다. 어려운 절반 — 그리고 이미지 작업을 제품에 넘길 때 진짜 중요한 절반 — 은 두 번째 렌더링과 세 번째 렌더링입니다: 캐릭터를 일련의 이미지에서 식별 가능하게 유지하거나, 한 장의 키 비주얼 자산을 처음 성공하게 만든 이유를 훼손하지 않으면서 재스타일링하는 일 말이죠.
hiapi의 gpt-image-2는 하나가 아니라 두 개의 모델입니다. 표준 텍스트→이미지 변형이 첫 프레임을 그리고, gpt-image-2/image-to-image가 그 프레임을 참조로 받아 편집합니다. 둘을 결합하면 호출당 $0.03으로 실제 프로덕션에서 나타나는 workflows — 캐릭터 일관성 시리즈, 정밀한 장면 교체, 브랜드 자산 재스타일링 — 를 커버합니다. 이 글은 두 모델을 하나씩 설명하며, 독창적 프롬프트, 실제 출력, 바로 복사할 수 있는 코드를 함께 제공합니다.
두 모델, 하나의 워크플로
두 변형 모두 hiapi의 통합 비동기 작업 API를 사용합니다 — POST https://api.hiapi.ai/v1/tasks가 생성 작업을 만들고 작업 ID를 반환하며, GET /v1/tasks/:id가 완료된 이미지 URL을 반환합니다. 차이는 input 객체에 무엇을 넣느냐입니다.
| 사용 사례 | 모델 | 1K 가격 | 2K 가격 | 입력 형태 |
|---|---|---|---|---|
| 프롬프트에서 첫 렌더링 생성 | gpt-image-2 |
$0.03 | $0.04 | 텍스트만 |
| 참조 이미지 편집/스타일 재구성 | gpt-image-2/image-to-image |
$0.03 | $0.04 | 텍스트 + 참조 이미지 1–5장 |
위 숫자는 작성 시점의 실시간 가격 페이지에서 직접 가져온 것입니다 — 해당 페이지가 권위 있는 출처입니다. gpt-image-2 표준 버전은 배수 곡선을 사용합니다(1K → 2K는 1.33×, 4K는 2×). 따라서 1K 호출은 $0.03, 4K 캔버스는 $0.06입니다. 이미지→이미지 변형도 같은 곡선을 따릅니다. 추가 “편집 할증”은 없습니다 — 두 모델은 같은 해상도에서 호출당 가격이 같습니다.
이 분리가 중요한 이유는 작업을 바라보는 방식이 달라지기 때문입니다. “정확한 그 이미지”를 얻기 위해 비싼 촬영 한 번에 돈을 쓰는 것이 아닙니다. $0.03으로 근접한 결과를 얻고, $0.03(또는 두 번)으로 정확한 결과를 얻습니다.
기능 1: 시리즈 전반의 스타일 일관성
대부분의 텍스트→이미지 워크플로가 무너지는 패턴은 같은 주체가 서로 다른 장면에 놓이는 경우입니다. 같은 프롬프트를 두 번 실행하면 서로 무관한 두 사람이 나오고, 주체 묘사가 느슨한 두 장면 프롬프트를 실행하면 사촌 같은 사람이 나옵니다.
gpt-image-2는 두 가지를 하면 놀랍도록 잘 처리합니다:
- 캐릭터 시트를 인라인으로 작성합니다. “안경을 쓴 젊은 여성”이 아니라, 모델이 다시 고정할 수 있는 구체적 특징들입니다: 머리색과 길이와 질감, 피부색과 주근깨, 안경과 안경 스타일, 신경 쓰는 모든 의류 항목. 여섯에서 열 개의 고정 특징이 이상적인 구간입니다.
- 모든 장면에서 시트를 그대로 재사용합니다. 같은 단어 순서, 같은 수식어. 묘사를 JSON 객체처럼 다루세요: 장면은 바뀌고, 캐릭터 시트는 바이트 단위로 완전히 동일하게 유지됩니다.
다음은 같은 캐릭터 시트를 두 개의 다른 장면에서 실행한 것입니다. 두 호출에서 시트는 동일하고, 장면 문단만 다릅니다.
캐릭터 시트(두 호출에서 그대로 재사용):
"20대 후반의 젊은 여성, 어깨 길이의 물결치는 짙은 적갈색 머리,
따뜻한 올리브 피부, 콧등에 흩어진 부드러운 주근깨, 거북등무늬
둥근 안경, 크림색 울 터틀넥, 가는 금 체인 목걸이, 이끼색
린넨 블레이저를 어깨에 걸침"

장면 A: 높은 북향 창가 옆 대리석 카페 테이블, 라떼 아트가 있는
흰 플랫 화이트 컵, 펼쳐진 네이비 가죽 노트북, 배경에 흐릿하게
보이는 황동 펜던트 조명, 35mm 필름, 얕은 심도, 1:1.

장면 B: 골든아워의 지중해 옥상 테라스, 로즈마리와 늘어지는
아이비가 심어진 테라코타 화분, 같은 네이비 가죽 노트북을 가슴에
안고 따뜻한 지붕과 바다를 바라봄, 35mm 필름, 장면 A와 일치하는
자연스러운 색조, 얕은 심도, 1:1.
두 번의 호출, 두 개의 장면, 같은 사람:
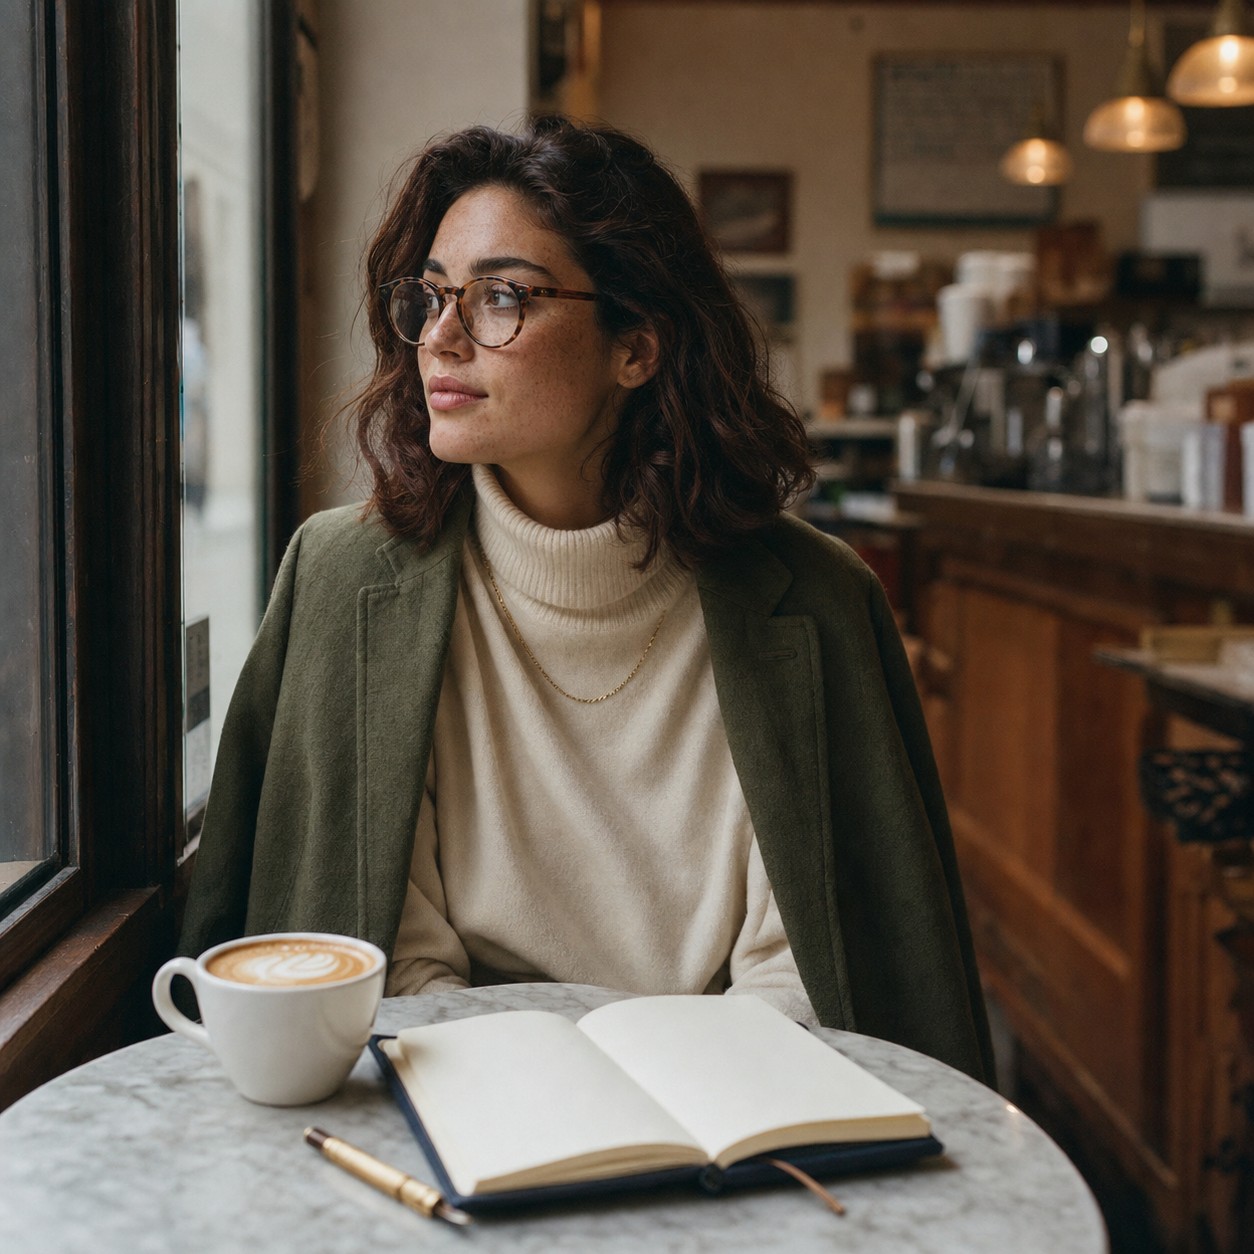
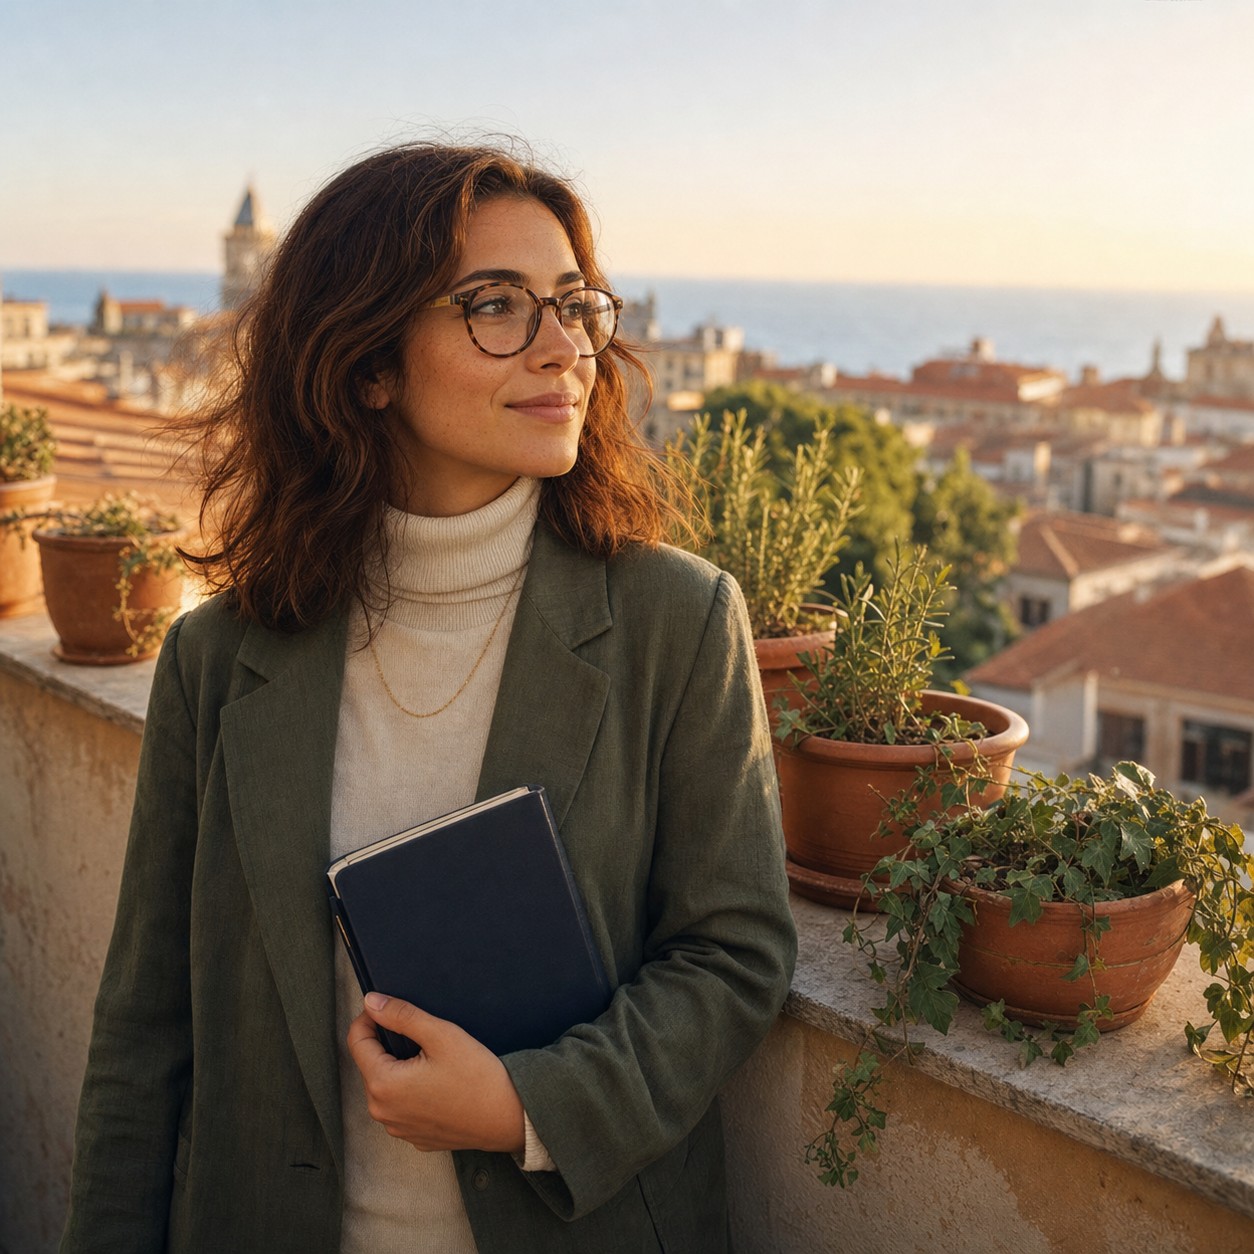
얼굴형, 머리 길이와 색, 안경, 터틀넥, 블레이저, 목걸이, 심지어 노트북까지 — 모두 이어집니다. 조명과 색조는 장면에 따라 바뀌며, 그래야 마땅합니다; 주체는 변하지 않습니다.
이 패턴을 대규모로 실행할 때의 실용적 메모:
- 신체 부위마다 세 개 이상의 관련 특징으로 고정하세요. “물결치는 짙은 적갈색 머리”만으로는 흔들립니다. “어깨 길이의 물결치는 짙은 적갈색 머리”에 두 절 뒤의 “거북등무늬 둥근 안경”을 추가 고정점으로 더하면 얼굴을 더 단단히 잠급니다. 모델은 동시 출현 특징을 어떤 단일 특징보다 더 강한 정체성 신호로 취급합니다.
- 시트를 프롬프트 맨 위에 두세요. 장면 묘사는 뒤에, 앞이 아니라. 모델은 초기 토큰의 주체 정체성에 더 높은 가중치를 둡니다.
- 각 장면을 같은 반복 스타일 수식어로 끝내세요(“35mm 필름, 얕은 심도, 1:1”). 이것이 렌더링 미학을 고정해, 두 호출이 서로 다른 두 사진작가처럼 보이지 않게 합니다.
짧은 시리즈(같은 캐릭터의 3~12프레임)의 경우 이 패턴은 첫 시도에서 보통 80% 이상의 일관성에 도달합니다. 무드보드, 블로그 삽화, 소셜 시리즈, 마케팅 캘린더에는 충분히 좋습니다. 모든 프레임이 반드시 일치해야 하는 브랜드 핵심 작업은 기능 2로 넘어가세요.
기능 2: 참조 이미지를 활용한 다중 턴 편집
프롬프트를 통한 스타일 일관성은 근접하게 해줍니다. 이미지→이미지 변형은 정확하게 해줍니다. 참조(1~5장)와 무엇을 바꿀지 설명하는 프롬프트를 주면 — 그곳만 바꾸고 나머지는 그대로 둡니다.
가장 흔한 용도는 브랜드 자산의 장면 교체입니다: 같은 제품, 같은 의자, 같은 캐릭터를 다른 환경에 두되, 주체는 픽셀 단위로 충실히 보존하고 환경은 그 주위에 다시 그립니다.
참조 사진 — 조형적인 호두나무 라운지 체어를 매끄러운 크림색 배경에 배치한 이미지를 gpt-image-2로 생성:
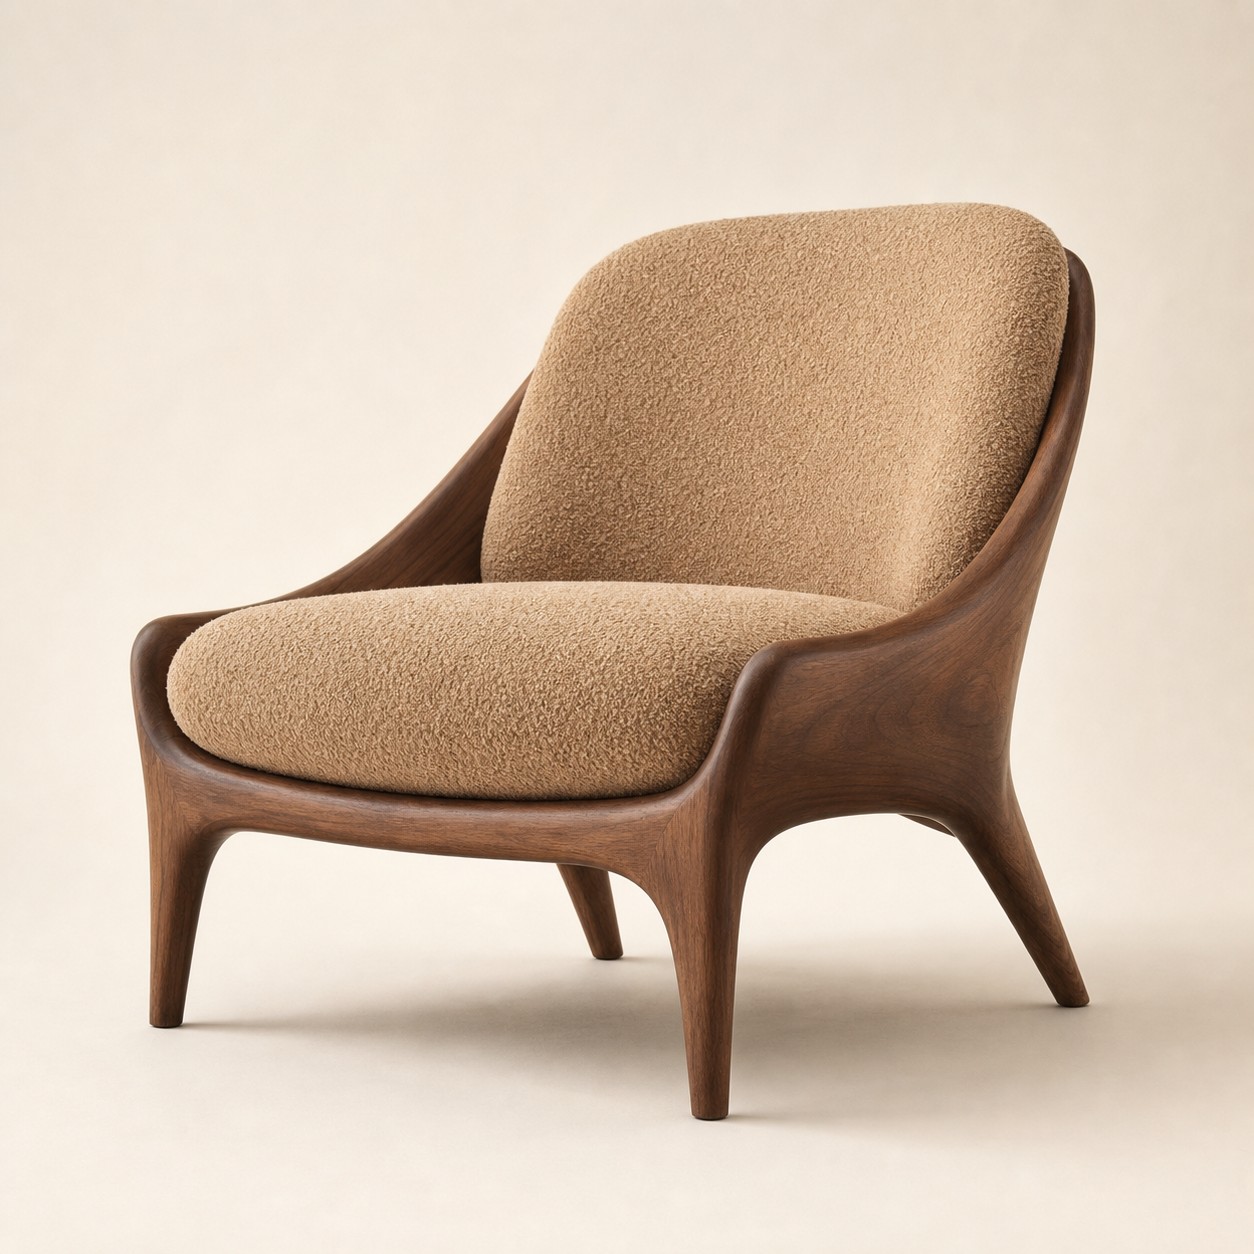
이제 그 정확한 이미지를 gpt-image-2/image-to-image로 보내며 환경 교체 프롬프트를 붙입니다:
이 정확한 의자를 빛이 풍부한 편집형 인테리어 장면으로
재스타일링하되 의자 자체는 바꾸지 마세요: 호두나무 프레임 모양,
캐멀 색 보클 쿠션, 다리 비율, 정확한 윤곽을 픽셀 단위로 충실히
동일하게 유지하세요. 매끄러운 크림색 배경을 따뜻하고 햇살 가득한
독서 코너로 교체하세요: 왼쪽 위 높은 아치형 창, 넓은 오크 마루에
길게 드리운 늦은 오후 그림자, 오른쪽 짙게 염색한 물푸레나무
작은 원형 사이드 테이블, 그 위에 마른 밀 세 줄기를 꽂은 도자기
화병, 의자 한쪽 팔걸이에 걸친 접힌 천연 리넨 담요, 아래에는
부드러운 크림색과 바랜 테라코타 색의 빈티지 베르베르 스타일
러그. 따뜻한 오후 광선 분위기, 살짝 안개 낀 공기, 잡지 인테리어
사진, 중립적 색조와 매칭.
결과 — 같은 의자, 새로운 방:
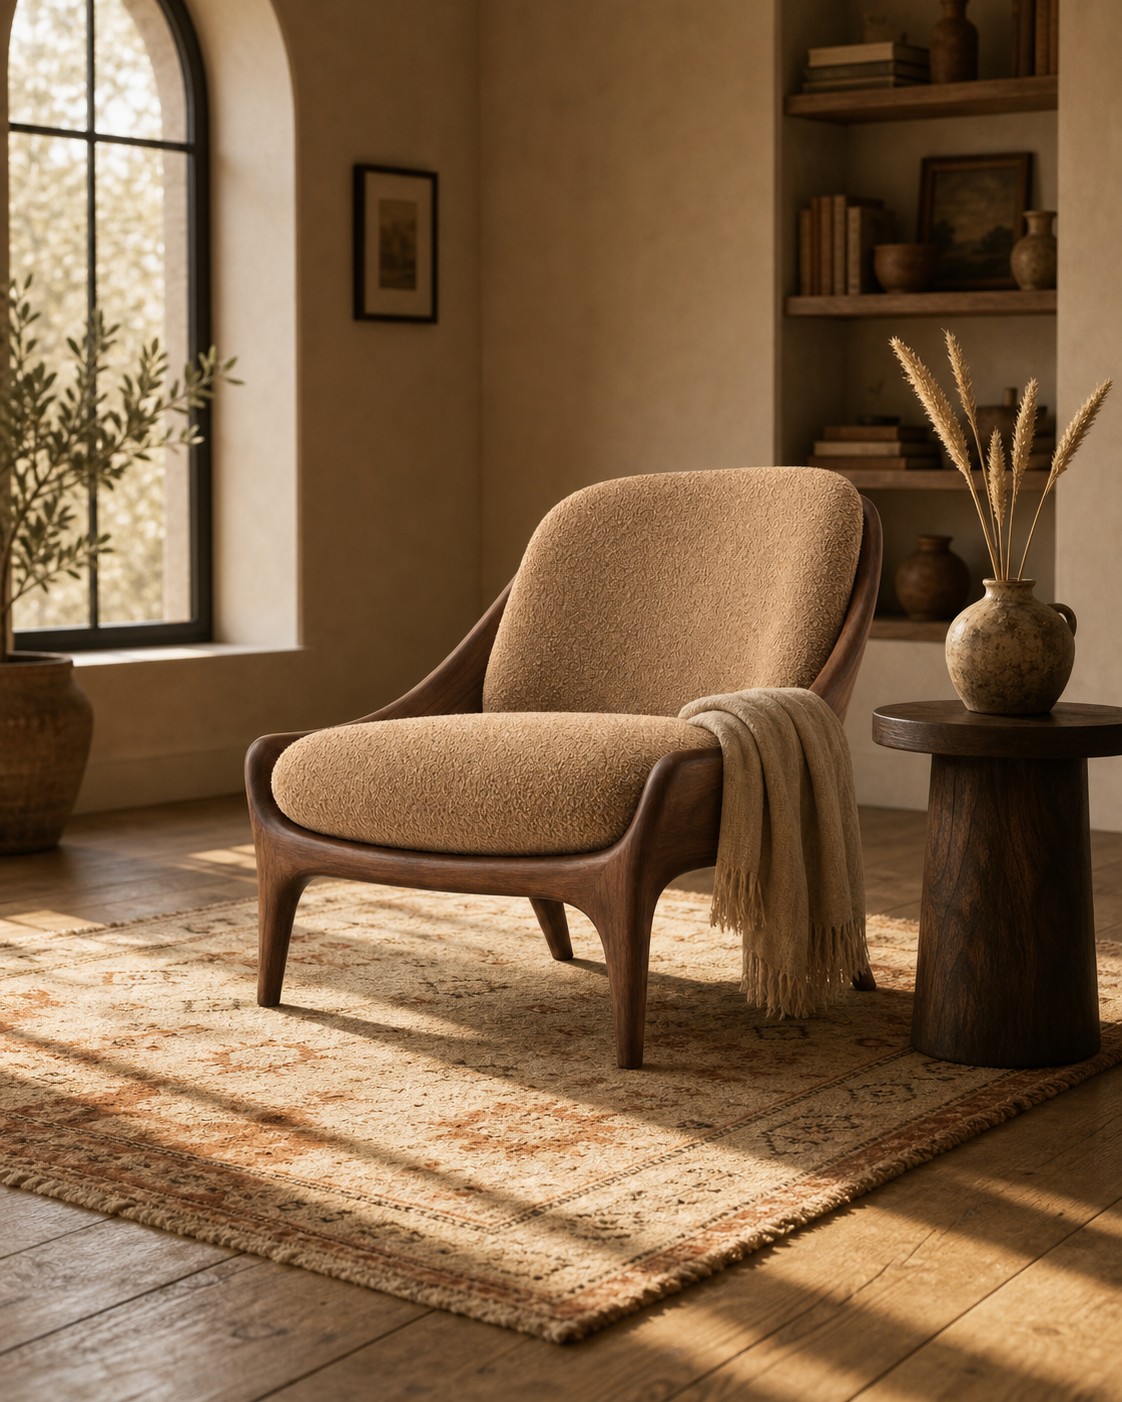
프레임 모양, 쿠션 원단, 색조, 다리 기하 구조가 깔끔하게 이어집니다. 매끄러운 배경은 사라지고, 그 브랜드 통제 요소 주위로 완전한 환경이 그려졌습니다.
편집 변형이 잘하는 것:
- 장면 교체. 고립된 주체를 환경으로 끌어오거나, 환경 속 주체를 새 환경으로 옮기기.
- 정밀 속성 변경. “쿠션 원단을 네이비 블루 벨벳으로 바꾸고 나머지는 모두 동일하게 유지” — 전체 장면을 처음부터 다시 프롬프트하는 것보다 훨씬 잘 작동합니다.
- 구도 미세 조정. “같은 의자, 같은 방, 카메라를 한 걸음 뒤로 물리고 담요 위에 작은 강아지 추가” — 모델은 다시 그리는 대신 편집합니다.
- 브랜드 자산 재스타일링. 한 장의 캠페인 무드보드를 참조로 삼고 세 개의 매칭 변형을 요구하는 프롬프트를 더하면, 세 개의 독립 텍스트 프롬프트보다 톤을 더 잘 유지합니다.
잘하지 못하는 것(표준 텍스트→이미지로 전환):
- 중대한 구도 재작성. 화면의 60% 이상을 바꿔야 한다면 새 프롬프트로 시작하는 편이 낫습니다.
- 캐릭터 교체. “같은 의자지만 다른 의자”를 의미한다면 그것은 편집이 아니라 새 프롬프트입니다.
코드: 두 모델, 엔드투엔드
두 모델 모두 POST /v1/tasks에서 응답합니다. 텍스트→이미지 호출은 input에 프롬프트를 보냅니다; 이미지→이미지 호출은 1~5개의 참조 이미지 URL을 담는 input_urls 배열을 추가합니다.
텍스트→이미지(gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # 캐릭터 시트 먼저 — 초기 토큰이 정체성을 담당.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # 장면은 그다음.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # 스타일 수식어는 마지막 — 시리즈의 모습을 고정.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
2K 캔버스의 경우 "resolution": "2K"로 설정하세요. 가격은 실시간 가격 페이지에 따라 1.33×로 조정됩니다 — 호출 형태는 같고, $0.03 대신 $0.04입니다.
이미지→이미지(gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
한 번의 호출에 최대 다섯 장의 참조 이미지를 담을 수 있습니다 — input_urls 배열에 URL을 더 추가하세요. 모델은 참조를 작은 스타일/정체성 컨텍스트로 취급한 뒤 프롬프트에 지정된 편집을 수행합니다. 참조는 호스팅된 URL이며 인라인 base64가 아니라는 점에 유의하세요 — 참조가 디스크에 있다면 먼저 접근 가능한 위치(객체 스토리지, 당신의 CDN)에 업로드하고 링크를 전달하세요.
몇 가지 운영 메모:
- 1K는 엔드투엔드로 60–120초 예상; 2K는 더 깁니다. 비동기 흐름 덕분에 오래 유지된 HTTP 연결이 타임아웃될 일이 없습니다 — 몇 초마다 폴링하거나, 생성 호출에
callback.url을 설정해 hiapi가 종료 상태를 POST하게 하세요. - 요청 핸들러를 생성 대기에 블로킹하지 마세요. API는 이미 작업 ID를 줍니다 —
taskId를 영속화하고, serverless 호출을 열어두는 대신 폴러나 콜백이 작업을 완료하게 하세요. - 편집 변형에서 피해야 할 두 파라미터 조합:
aspect_ratio: "auto"(또는 생략)는1K해상도만 지원하며,1:1은4K와 함께 쓸 수 없습니다. - 참조 이미지는 원하는 출력 해상도로. 512×512 참조를 보내고 2K 출력을 요구해도 되지만, 모델이 고정할 디테일이 더 적습니다. 브랜드에 충실한 편집이라면 참조를 목표 출력 크기로 보내세요.
언제 무엇을 쓸까(그리고 hiapi가 제공하는 다른 것들)
텍스트 렌더링, 소규모 시리즈의 캐릭터나 제품 일관성, 또는 브랜드 자산의 정밀 편집이 필요할 때 gpt-image-2와 그 이미지→이미지 형제는 적절한 기본 선택입니다. hiapi의 유일한 이미지 옵션은 아니며, 둘 사이의 선택은 보기보다 중요합니다:
| 요구 | 모델 | 이유 |
|---|---|---|
| 프롬프트에서 초안 생성, 탐색 | gpt-image-2 ($0.03) |
시리즈 중 가장 저렴; 시트+장면 패턴이 멀리 데려다 줍니다. |
| 정밀 편집 / 장면 교체 / 브랜드 재스타일링 | gpt-image-2/image-to-image ($0.03) |
같은 가격이지만 참조를 고정. 출력이 기존 자산과 일치해야 할 때 항상 올바른 선택. |
| 고충실도 4K 마케팅 캔버스 | gpt-image-2 4K ($0.06) |
표준 변형이 4K 계층을 노출, 깔끔한 2× 배수 — 큰 캔버스로 가는 가장 저렴한 경로. |
| 재생성 비용이 높은 프로덕션 키 비주얼 | gpt-image-2-pro ($0.35) |
같은 시리즈의 안정성 계층, 표준 가격의 약 10×, 한 번의 나쁜 렌더링이 열 번의 좋은 렌더링보다 비싼 작업의 작은 부분에 사용. |
| 편집 필요 없는 사진 같은 단일 주체 인물 | flux-1.1-pro ($0.05) |
hiapi의 FLUX 1.1 Pro는 텍스트 렌더링이나 다중 턴 편집이 필요 없을 때의 사실성 전문가. |
| 속도가 중요한 편집, 대규모 캐릭터 일관성 | Nano-Banana-2 (1K에서 $0.085) |
Google의 Gemini 3.1 Flash Image 변형 — 다른 정체성 특성, 유사한 편집 패턴, 더 빠른 처리, 대신 호출당 더 비싼 가격. |
위 표의 가격 열은 플랫폼의 실시간 가격에서 가져온 것입니다 — 자체 내부 추정에 숫자를 인용하기 전에 새로 고치세요.
그대로 복사할 수 있는 패턴
요청마다 gpt-image-2를 한 번 호출하는 기존 파이프라인이 있다면, 가장 저렴한 업그레이드는 두 번째 호출을 도입하는 것입니다:
def render(job):
    # 1) 프롬프트에서 초안 생성.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) 작업이 브랜드 핵심이거나 장면 교체가 필요하면,
    #    다시 프롬프트하지 말고 초안을 편집.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # 무엇을 바꿀지
            "input_urls": [draft.output_url],    # 무엇을 유지할지
            "resolution": "1K",
        })

    return draft
두 번 호출로 각각 $0.03, 총 $0.06 — 여전히 단일 gpt-image-2-pro 호출($0.35)보다 저렴하며, 대부분의 작업에서 두 번째 호출이 세 번에서 네 번의 폐기 후 재프롬프트를 대체합니다. 출력이 브랜드에 충실해야 할수록 이 계산은 더 유리해집니다.
짧은 버전
gpt-image-2는 초안 엔진입니다. gpt-image-2/image-to-image는 편집기입니다. 결합하면 단일 호출 이미지 생성이 커버하지 못하는 workflows — 캐릭터 시리즈, 브랜드 자산 재스타일링, 정밀 속성 변경 — 를 Pro 계층으로 업그레이드하지 않고도 커버합니다.
가장 큰 보상을 주는 두 패턴은: (1) 시리즈 일관성을 위해 장면 전반에서 캐릭터 시트를 그대로 재사용하는 것; (2) 출력이 기존 자산의 연장처럼 보여야 하는 모든 작업에서 렌더링 후 편집하는 두 번 호출 흐름입니다. 둘 다 hiapi의 /v1/tasks 엔드포인트에서 호출당 $0.03으로 완료되며, 둘 다 같은 작업 페이로드 형태로 전달됩니다 — 하나의 worker 함수가 이 쌍을 커버합니다.
실시간 가격을 확인하고, 시트를 한 번 작성하고, 편집기가 재프롬프트로는 할 수 없는 일을 하게 하세요.
관련 글
모든 아티클 보기 →-

튜토리얼
HiAPI API로 hailuo-2.3-fast/image-to-video 호출하는 방법: curl과 Python 실전
빠르고 저렴한 이미지-투-비디오 등급의 첫 실행 요청 — 모델 ID부터 MP4 다운로드까지
-

튜토리얼
HiAPI API로 hailuo-2.3/text-to-video를 호출하는 방법: curl, Python 및 실행 가능한 요청 예시
-

튜토리얼
HiAPI에서 Kandinsky 6.0 Pro 텍스트-투-비디오 사용하기: curl 및 Python 튜토리얼
요청 우선 실전 데모: 프롬프트에서 비디오 클립까지의 호출 구성, 요청 제출, 완료 상태 폴링 및 결과 다운로드