
Tutorial
GPT Image 2 edición multiturno y consistencia de estilo: un recorrido por las capacidades de hiapi
Cómo combinar gpt-image-2 y gpt-image-2-image-to-image para crear series de imágenes con personajes consistentes y ediciones precisas, por solo $0.03 por llamada en hiapi.
La mayoría de las publicaciones del tipo «GPT Image 2 es impresionante» solo te muestran un único render. Eso es apenas la mitad fácil. La mitad difícil —y la que de verdad importa cuando llevas el trabajo de imágenes a un producto— es el segundo render y el tercero: lograr que un personaje siga siendo reconocible en toda una serie de imágenes, o reestilizar un activo principal sin romper aquello que lo hizo funcionar en primer lugar.
gpt-image-2 en hiapi son dos modelos, no uno. La variante estándar de texto a imagen pinta el primer fotograma; gpt-image-2/image-to-image recupera ese fotograma como referencia para editarlo. Usados juntos, a $0.03 por llamada, cubren los flujos de trabajo que aparecen en la producción real: series con personajes consistentes, sustitución precisa de escenarios, reestilización de activos de marca. Este artículo explica ambos uno por uno, con prompts originales, resultados reales y código listo para copiar.
Dos modelos, un flujo de trabajo
Ambas variantes usan la API unificada de tareas asíncronas de hiapi: POST https://api.hiapi.ai/v1/tasks crea una tarea de generación y devuelve un ID de tarea, y GET /v1/tasks/:id devuelve la URL de la imagen terminada. La diferencia está en lo que pones dentro del objeto input.
| Escenario de uso | Modelo | Precio 1K | Precio 2K | Forma de entrada |
|---|---|---|---|---|
| Generar el primer render a partir de un prompt | gpt-image-2 |
$0.03 | $0.04 | Solo texto |
| Editar/reestilizar una imagen de referencia | gpt-image-2/image-to-image |
$0.03 | $0.04 | Texto + 1–5 imágenes de referencia |
Las cifras anteriores provienen directamente de la página de precios en vivo en el momento de escribir esto; esa página es la fuente autorizada. gpt-image-2 estándar usa una curva de multiplicadores (1K → 2K es 1.33×, 4K es 2×), así que una llamada a 1K cuesta $0.03 y un lienzo 4K cuesta $0.06. La variante de imagen a imagen sigue la misma curva. No hay un «recargo por edición» adicional: ambos modelos cuestan lo mismo por llamada a la misma resolución.
Esta división importa porque cambia la forma en que piensas un trabajo. No gastas en una sesión cara para comprar «la imagen correcta». Gastas $0.03 para acercarte y luego $0.03 (o dos veces) para llegar a la precisión.
Capacidad uno: consistencia de estilo en una serie
El patrón en el que fallan la mayoría de los flujos de trabajo de texto a imagen es el mismo sujeto en escenarios distintos. Ejecuta el mismo prompt dos veces y obtendrás a dos personas no relacionadas; ejecuta dos prompts de escena con descripciones laxas del sujeto y obtendrás primos.
gpt-image-2 lo maneja sorprendentemente bien cuando haces dos cosas:
- Escribe en línea una hoja de personaje. No «una mujer joven con gafas». Sino rasgos concretos a los que el modelo pueda volver a anclarse: el color del pelo y el largo y la textura, el tono de piel y las pecas, las gafas y el estilo de las gafas, cada prenda que te importe. De seis a diez rasgos de anclaje es el rango ideal.
- Reutiliza la hoja de personaje palabra por palabra en cada escena. El mismo orden de palabras, los mismos modificadores. Trata la descripción como un objeto JSON: la escena cambia, la hoja de personaje permanece idéntica byte a byte.
A continuación, la misma hoja de personaje ejecutada en dos escenarios distintos. La hoja de personaje no cambia entre las dos llamadas; solo cambia el párrafo de la escena.
Hoja de personaje (reutilizada palabra por palabra en ambas llamadas):
"Una mujer joven de veintitantos años tardíos, cabello castaño rojizo oscuro
ondulado a la altura de los hombros, piel cálida de tono oliva, pecas suaves
distribuidas sobre el puente de la nariz, gafas redondas de concha
tortuga, jersey de cuello alto de lana color crema, cadena fina de oro,
blazer de lino verde musgo sobre los hombros"

Escena A: mesa de mármol de cafetería junto a una ventana alta orientada al norte, taza blanca de flat white con
latte art, cuaderno de piel azul marino abierto, pluma estilográfica de latón, lámpara colgante de latón desenfocada
al fondo, película 35mm, profundidad de campo reducida, 1:1.

Escena B: terraza mediterránea en la hora dorada, macetas de terracota con
romero y hiedra colgante, sosteniendo el mismo cuaderno de piel azul marino contra
el pecho, mirando hacia los tejados cálidos y el mar, película 35mm, tonos naturales
que combinan con la Escena A, profundidad de campo reducida, 1:1.
Dos llamadas, dos escenarios, la misma persona:
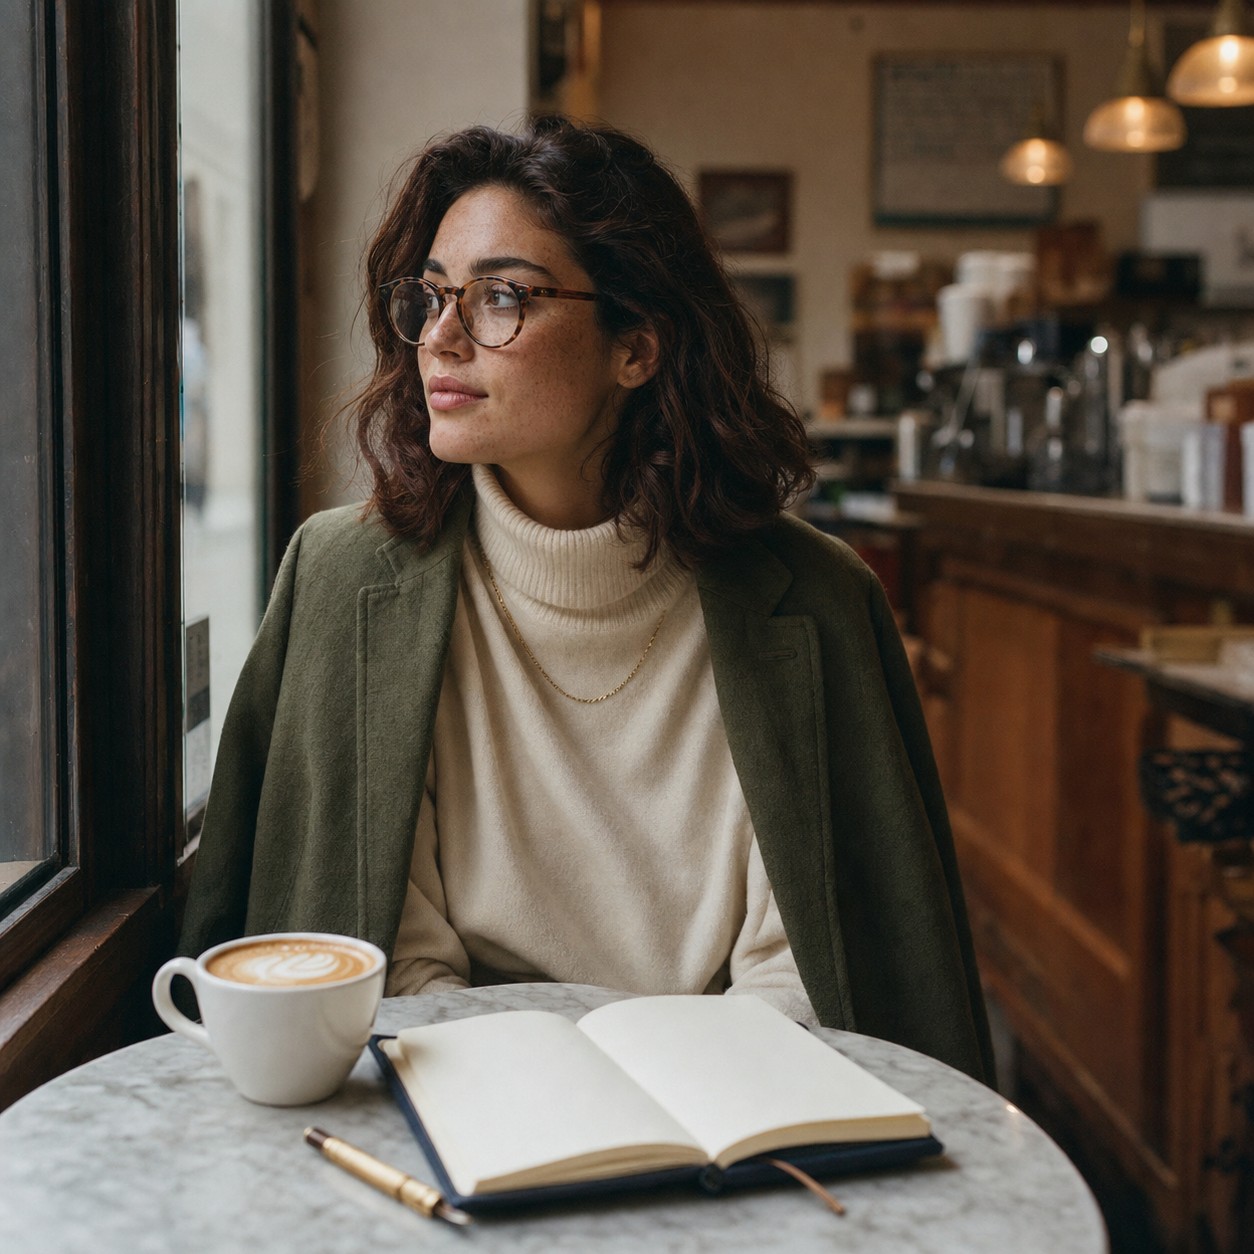
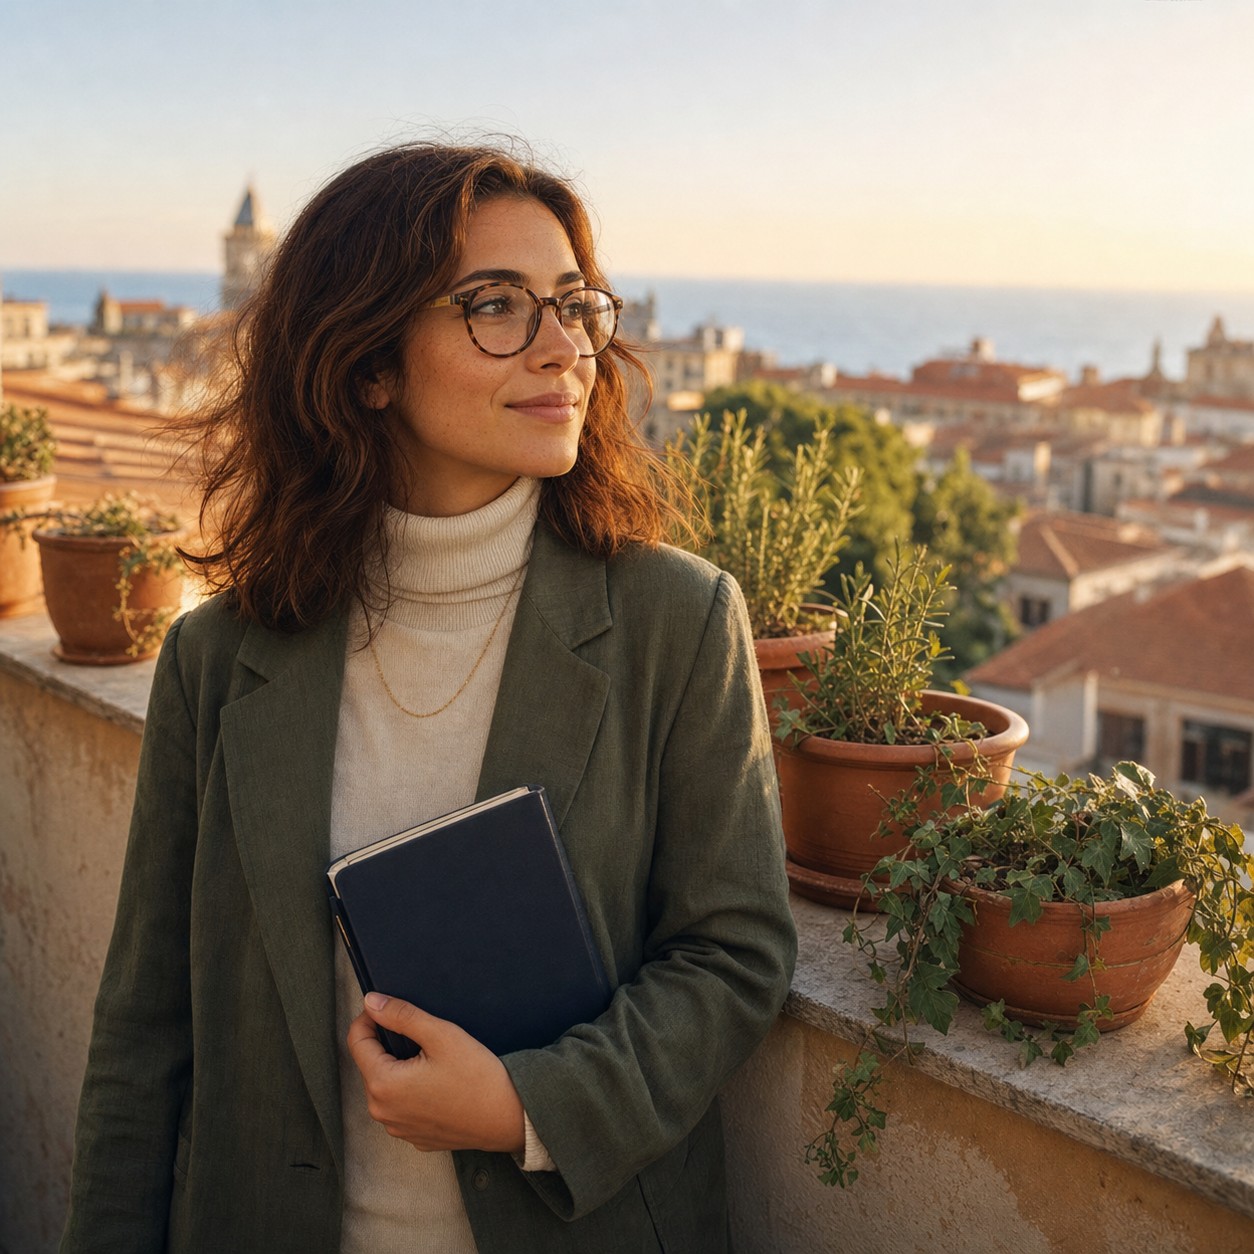
La forma de la cara, el largo y el color del pelo, las gafas, el cuello alto, el blazer, el collar e incluso el cuaderno: todo se mantiene. La luz y los tonos cambian con el escenario, como debe ser; el sujeto no cambia.
Algunas notas prácticas al ejecutar este patrón a escala:
- Ancla cada parte del cuerpo con tres o más rasgos relacionados. Solo «cabello castaño rojizo oscuro ondulado» se desplaza. «Cabello castaño rojizo oscuro ondulado a la altura de los hombros» más «gafas redondas de concha de tortuga» dos cláusulas después como anclas adicionales fijan el rostro con más firmeza. El modelo trata los rasgos coocurrentes como una señal de identidad más fuerte que cualquier rasgo aislado.
- Coloca la hoja de personaje al principio del prompt. La descripción de la escena va después, no antes. El modelo da más peso a la identidad del sujeto en los tokens iniciales.
- Termina cada escena con el mismo modificador de estilo repetido («película 35mm, profundidad de campo reducida, 1:1»). Esto fija la estética del render para que las dos llamadas no parezcan de dos fotógrafos distintos.
Para series cortas (de tres a doce fotogramas del mismo personaje), este patrón suele alcanzar más del 80 % de consistencia al primer intento. Es suficientemente bueno para moodboards, ilustraciones de blog, series para redes sociales y calendarios de marketing. Para trabajos críticos de marca en los que cada fotograma debe coincidir, pasa a la capacidad dos.
Capacidad dos: edición multiturno con imágenes de referencia
La consistencia de estilo mediante prompts te acerca. La variante de imagen a imagen te da precisión. Le das una referencia (de una a cinco imágenes) y un prompt que indica qué cambiar; ella cambia ahí y deja el resto intacto.
El uso más común es la sustitución de escenario sobre activos de marca: el mismo producto, la misma silla, el mismo personaje en entornos distintos, con el sujeto conservado con fidelidad a nivel de píxel y el entorno redibujado a su alrededor.
Imagen de referencia: una butaca escultórica de nogal, sobre un fondo crema sin costuras, generada con gpt-image-2:
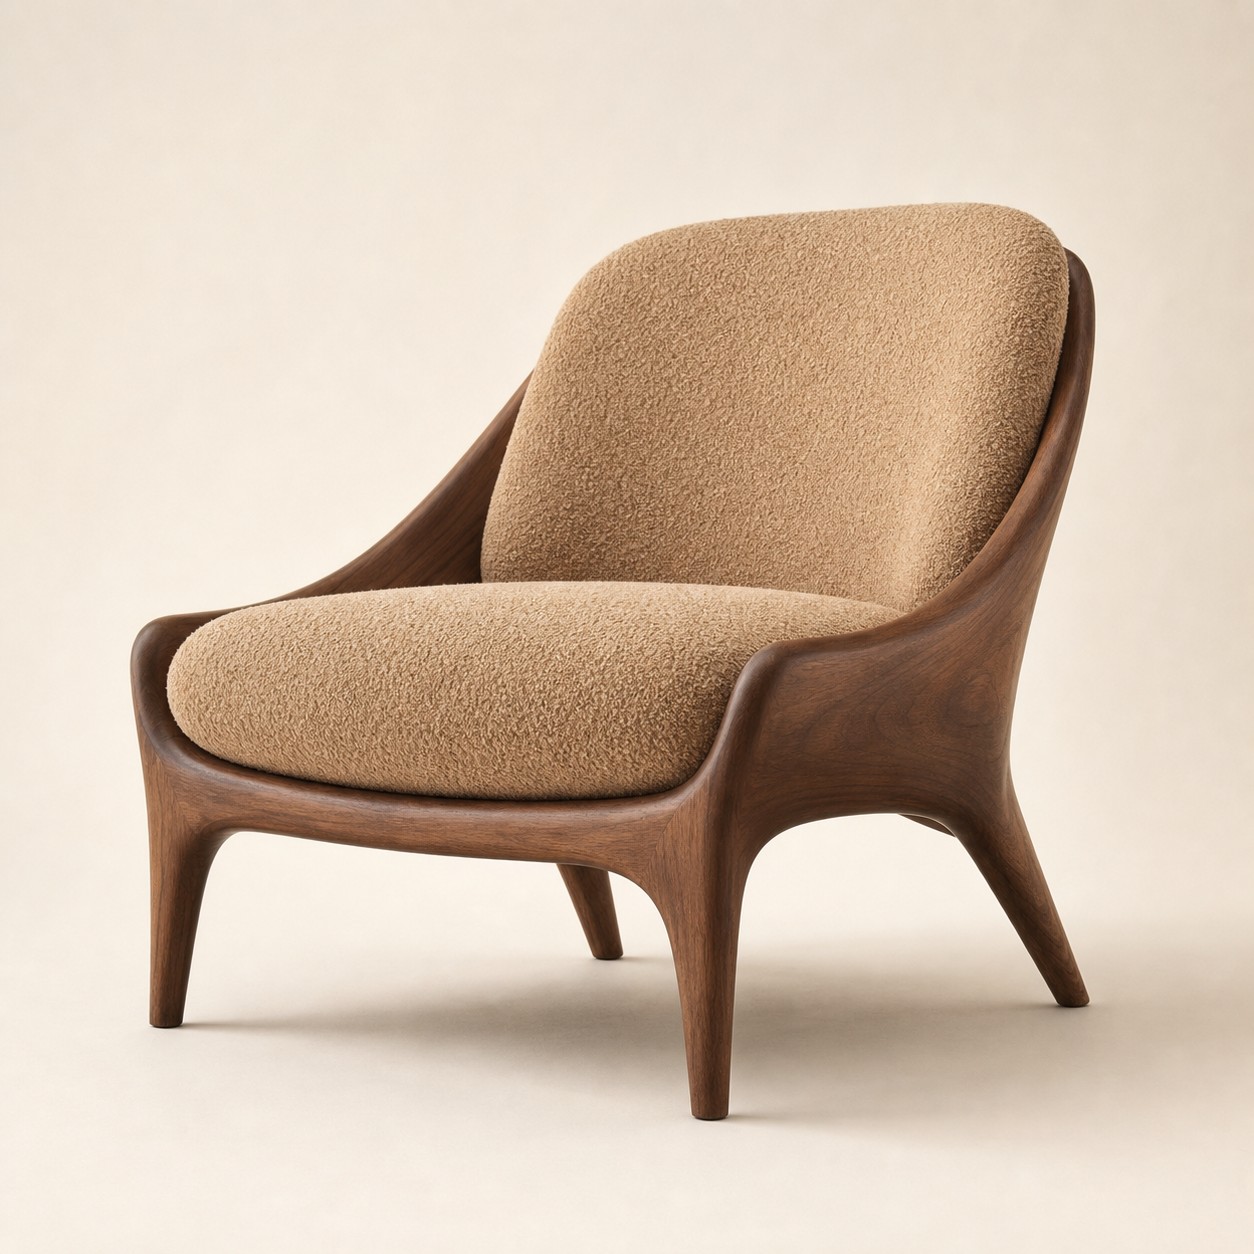
Ahora envía esa imagen exacta a gpt-image-2/image-to-image con un prompt de sustitución de entorno:
Reestiliza esta butaca exacta en una escena de interior editorial
llena de luz, sin cambiar la butaca en sí: mantén la forma del armazón
de nogal, el cojín de bouclé camel, las proporciones de las patas y la silueta exacta con fidelidad
a nivel de píxel. Sustituye el fondo crema sin costuras por un rincón de lectura cálido y
soleado: una ventana arqueada alta arriba a la izquierda que proyecta largas
sombras de media tarde sobre un amplio suelo de roble, a la derecha una pequeña mesa auxiliar
de fresno teñido oscuro con un jarrón de cerámica con tres tallos de
trigo seco, una manta de lino natural doblada sobre un brazo de la butaca,
y bajo ella una alfombra de estilo bereber vintage en tonos crema suave y terracota
desvaído. Ambiente de luz cálida de tarde, aire ligeramente
brumoso, fotografía de interiores de revista, tonos neutros a juego.
Resultado: la misma butaca, una habitación nueva:
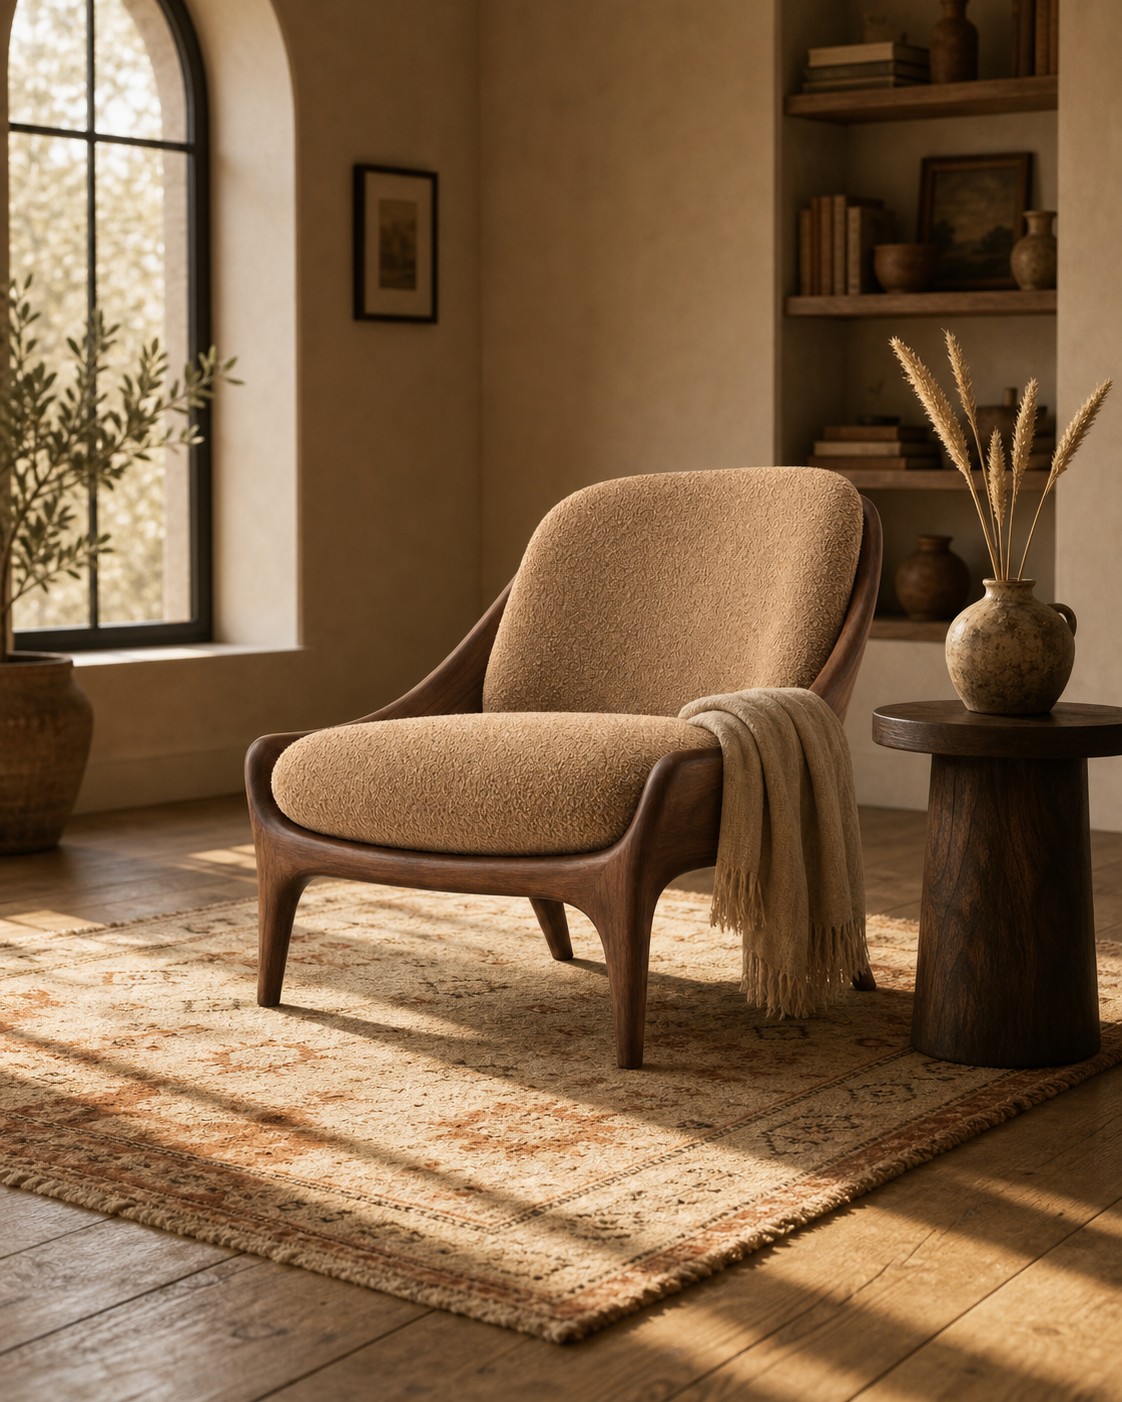
La forma del armazón, la tela del cojín, los tonos y la geometría de las patas se mantienen limpiamente. El fondo sin costuras desaparece; alrededor de ese elemento controlado de la marca se dibuja un entorno completo.
En qué destaca la variante de edición:
- Sustitución de escenario. Llevar un sujeto aislado a un entorno, o mover un sujeto de un entorno a uno nuevo.
- Cambios precisos de atributos. «Cambia la tela del cojín a terciopelo azul marino y mantén todo lo demás igual» funciona mucho mejor que volver a escribir el prompt de toda la escena desde cero.
- Ajustes finos de composición. «La misma butaca, la misma habitación, la cámara un paso atrás y un perrito sobre la manta»: el modelo edita en lugar de redibujar.
- Reestilización de activos de marca. Usar un moodboard de campaña como referencia y añadir un prompt que pida tres variantes a juego conserva mejor el tono que tres prompts de texto independientes.
En qué no destaca (usa texto a imagen estándar en su lugar):
- Reescrituras importantes de composición. Si más del 60 % del encuadre debe cambiar, es mejor empezar con un prompt nuevo.
- Sustitución de personaje. Si lo que quieres decir es «la misma butaca pero otra butaca», eso es un prompt nuevo, no una edición.
Código: dos modelos, de principio a fin
Ambos modelos responden en POST /v1/tasks. La llamada de texto a imagen envía el prompt en input; la llamada de imagen a imagen añade un array input_urls que lleva de una a cinco URL de imágenes de referencia.
Texto a imagen (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # La hoja de personaje va primero: los tokens iniciales llevan la identidad.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # La escena va después.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # El modificador de estilo va al final: fija el aspecto de la serie.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Para un lienzo 2K, configura "resolution": "2K". El precio escala 1.33× según la página de precios en vivo: la misma forma de llamada, $0.04 en lugar de $0.03.
Imagen a imagen (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Puedes llevar hasta cinco imágenes de referencia en la misma llamada: añade más URL al array input_urls. El modelo trata las referencias como un pequeño contexto de estilo/identidad y luego escribe la edición especificada en el prompt. Ten en cuenta que las referencias son URL alojadas, no base64 en línea: si tu referencia está en disco, súbela primero a una ubicación accesible (almacenamiento de objetos, tu CDN) y pasa el enlace.
Algunas notas operativas:
- Calcula de 60 a 120 segundos de extremo a extremo a 1K; a 2K, más. El flujo asíncrono significa que ninguna conexión HTTP de larga duración llegará al tiempo de espera: sondea cada pocos segundos, o configura
callback.urlen la llamada de creación para que hiapi haga un POST a tu estado terminal. - No bloquees el manejador de la petición esperando la generación. La API ya te da un ID de tarea: persiste el
taskIdy deja que el sondeador o el callback haga el trabajo, en lugar de mantener abierta la invocación serverless. - Dos combinaciones de parámetros que evitar en la variante de edición:
aspect_ratio: "auto"(u omitirlo) solo admite resolución1K, y1:1no se puede combinar con4K. - Usa imágenes de referencia a la resolución de salida que quieras. Enviar una referencia de 512×512 y pedir una salida 2K funciona, pero el modelo ancla menos detalle. Para ediciones fieles a la marca, envía la referencia al tamaño de salida objetivo.
Cuándo usar cada uno (y qué más ofrece hiapi)
Cuando necesitas renderizado de texto, consistencia de personaje o producto en una serie corta, o ediciones precisas sobre activos de marca, gpt-image-2 y su hermano de imagen a imagen son la opción predeterminada adecuada. No son las únicas opciones de imagen en hiapi, y elegir entre ellas importa más de lo que parece:
| Necesidad | Modelo | Motivo |
|---|---|---|
| Borrador inicial a partir de un prompt, exploración | gpt-image-2 ($0.03) |
El más barato de la serie; el patrón de hoja de personaje más escena te lleva muy lejos. |
| Edición precisa / sustitución de escenario / reestilización de marca | gpt-image-2/image-to-image ($0.03) |
Mismo precio, pero anclado a una referencia. Es la opción correcta siempre que la salida deba coincidir con un activo existente. |
| Lienzo de marketing 4K de alta fidelidad | gpt-image-2 4K ($0.06) |
La variante estándar expone el nivel 4K, con un multiplicador limpio de 2×: el camino más barato a un lienzo grande. |
| Imagen principal de producción, donde regenerar es caro | gpt-image-2-pro ($0.35) |
El nivel de estabilidad de la misma serie, a unos 10× el precio estándar, para ese pequeño porcentaje de trabajos en los que un mal render cuesta más que diez buenos. |
| Retrato fotorrealista de un solo sujeto, sin edición | flux-1.1-pro ($0.05) |
FLUX 1.1 Pro en hiapi es el especialista en realismo, para cuando no necesitas renderizado de texto ni edición multiturno. |
| Edición donde la velocidad es crítica, consistencia de personaje a gran escala | Nano-Banana-2 ($0.085 a 1K) |
La variante Gemini 3.1 Flash Image de Google: rasgos de identidad distintos, patrones de edición similares, entrega más rápida, a cambio de un precio por llamada más alto. |
La columna de precios de la tabla anterior proviene de los precios en vivo de la plataforma: actualízala antes de citar cifras en tus propias estimaciones internas.
Un patrón que puedes copiar tal cual
Si tienes un pipeline existente que llama a gpt-image-2 una vez por petición, la mejora más barata es introducir una segunda llamada:
def render(job):
    # 1) Borrador inicial a partir del prompt.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Si el trabajo es crítico para la marca o necesita sustitución de escenario,
    #    edita el borrador en lugar de volver a escribir el prompt.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # qué cambiar
            "input_urls": [draft.output_url],    # qué conservar
            "resolution": "1K",
        })

    return draft
Dos llamadas a $0.03 cada una, $0.06 en total: sigue siendo más barato que una sola llamada a gpt-image-2-pro ($0.35), y para la mayoría de los trabajos la segunda llamada sustituye a tres o cuatro rondas de descartar y volver a escribir el prompt. Cuanto más fiel a la marca deba ser la salida, mejor sale la cuenta.
La versión breve
gpt-image-2 es el motor de borradores. gpt-image-2/image-to-image es el editor. Juntos cubren flujos de trabajo que la generación de imágenes en una sola llamada no puede cubrir: series de personajes, reestilización de activos de marca, cambios precisos de atributos, sin necesidad de subir al nivel Pro.
Los dos patrones con mayor retorno son: (1) reutilizar palabra por palabra la hoja de personaje entre escenas para lograr consistencia de serie; y (2) para cualquier trabajo en el que la salida deba parecer una extensión de un activo existente, el flujo de dos llamadas de renderizar primero y editar después. Ambos se consiguen en el endpoint /v1/tasks de hiapi a $0.03 por llamada, y ambos se entregan con la misma forma de carga de tarea: una sola función worker cubre esta pareja.
Confirma los precios en vivo, escribe la hoja de personaje una vez y deja que el editor haga el trabajo que volver a escribir el prompt no puede hacer.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado