
Tutorial
Edição multi-turno e consistência de estilo do GPT Image 2: uma jornada pelas capacidades do hiapi
Como combinar gpt-image-2 e gpt-image-2-image-to-image para criar séries de imagens com personagens consistentes e edições precisas — por apenas $0.03 por chamada no hiapi.
A maioria dos posts do tipo "o GPT Image 2 é incrível" só mostra uma única renderização. Isso é apenas metade da história. A metade difícil — e a que realmente importa quando você entrega trabalho de imagem em um produto — é a segunda renderização e a terceira: manter um personagem reconhecível em uma série de imagens, ou reformular um ativo principal sem destruir o que o fez funcionar em primeiro lugar.
O gpt-image-2 no hiapi são dois modelos, não um. A variante padrão de texto para imagem desenha o primeiro quadro; o gpt-image-2/image-to-image recebe esse quadro de volta como referência para edição. Usados juntos, a $0.03 por chamada, eles cobrem os workflows que surgem na produção real: séries de imagens com personagens consistentes, substituição precisa de cenas e reformulação de ativos de marca. Este artigo aborda os dois, com prompts originais, saídas reais e código pronto para copiar.
Dois modelos, um workflow
Ambas as variantes usam a API unificada de tarefas assíncronas do hiapi — POST https://api.hiapi.ai/v1/tasks cria uma tarefa de geração e retorna um ID de tarefa, e GET /v1/tasks/:id retorna a URL da imagem concluída. A diferença está no que você coloca no objeto input.
| Caso de uso | Modelo | Preço 1K | Preço 2K | Formato de entrada |
|---|---|---|---|---|
| Gerar a primeira renderização a partir de um prompt | gpt-image-2 |
$0.03 | $0.04 | Apenas texto |
| Editar/reformular o estilo de uma imagem de referência | gpt-image-2/image-to-image |
$0.03 | $0.04 | Texto + 1–5 imagens de referência |
Os números acima vêm diretamente da página de preços ao vivo no momento da escrita — essa página é a fonte autoritativa. O gpt-image-2 padrão usa uma curva de multiplicador (1K → 2K é 1.33×, 4K é 2×), então uma chamada 1K custa $0.03 e um canvas 4K custa $0.06. A variante imagem-para-imagem segue a mesma curva. Não há "taxa extra de edição" — ambos os modelos custam o mesmo por chamada na mesma resolução.
Essa divisão importa porque muda como você pensa sobre um trabalho. Você não gasta uma sessão caríssima para comprar "a imagem certa". Você gasta $0.03 para chegar perto e depois $0.03 (ou duas) para chegar ao exato.
Capacidade um: consistência de estilo entre séries
O padrão em que a maioria dos workflows de texto-para-imagem desmorona é o mesmo sujeito em cenas diferentes. Execute o mesmo prompt duas vezes e você terá duas pessoas não relacionadas; execute dois prompts de cena com descrições vagas do sujeito e você terá primos.
O gpt-image-2 lida surpreendentemente bem com isso quando você faz duas coisas:
- Escreva uma ficha de personagem inline. Não "uma jovem usando óculos". Em vez disso, características específicas nas quais o modelo pode se reancorar: cor do cabelo e comprimento e textura, tom de pele e sardas, óculos e estilo dos óculos, cada peça de roupa que importa para você. Seis a dez características de ancoragem é a faixa ideal.
- Reutilize a ficha de personagem literalmente em cada cena. A mesma ordem de palavras, os mesmos modificadores. Trate a descrição como um objeto JSON: a cena muda, a ficha de personagem permanece idêntica byte a byte.
Abaixo, a mesma ficha de personagem executada em duas cenas diferentes. A ficha permanece inalterada nas duas chamadas; apenas o parágrafo da cena difere.
Ficha de personagem (reutilizada literalmente nas duas chamadas):
"uma jovem no final dos vinte anos, cabelo ondulado castanho-avermelhado escuro na altura dos ombros,
pele oliva quente, sardas suaves no nariz, óculos redondos de tartaruga,
blusa de gola alta de lã creme, corrente fina de ouro, blazer de linho verde-musgo
sobre os ombros"

Cena A: mesa de mármore de café perto de uma janela alta ao norte, xícara branca de flat white com
latte art, caderno de couro azul-marinho aberto, caneta-tinteiro de latão, lustre de latão ao fundo
desfocado, filme 35mm, profundidade de campo rasa, 1:1.

Cena B: terraço mediterrâneo ao pôr do sol, vasos de terracota com
romero e hera pendente, segurando o mesmo caderno de couro azul-marinho contra o
peito, olhando para telhados quentes e o mar, filme 35mm, tons naturais compatíveis com a cena A,
profundidade de campo rasa, 1:1.
Duas chamadas, duas cenas, a mesma pessoa:
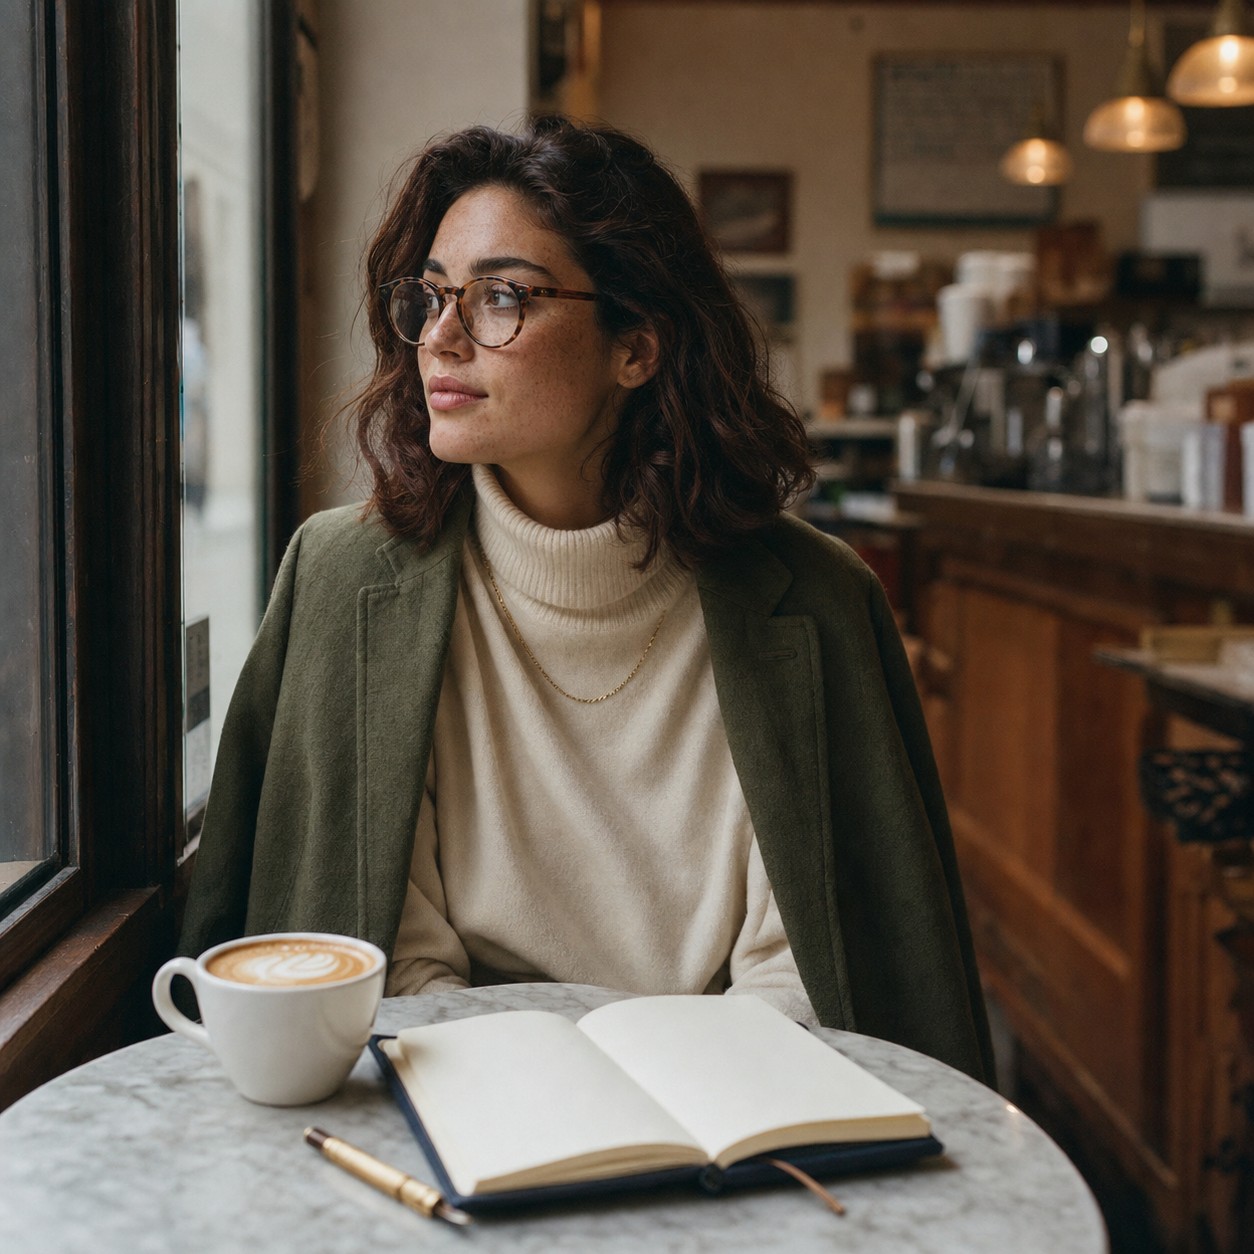
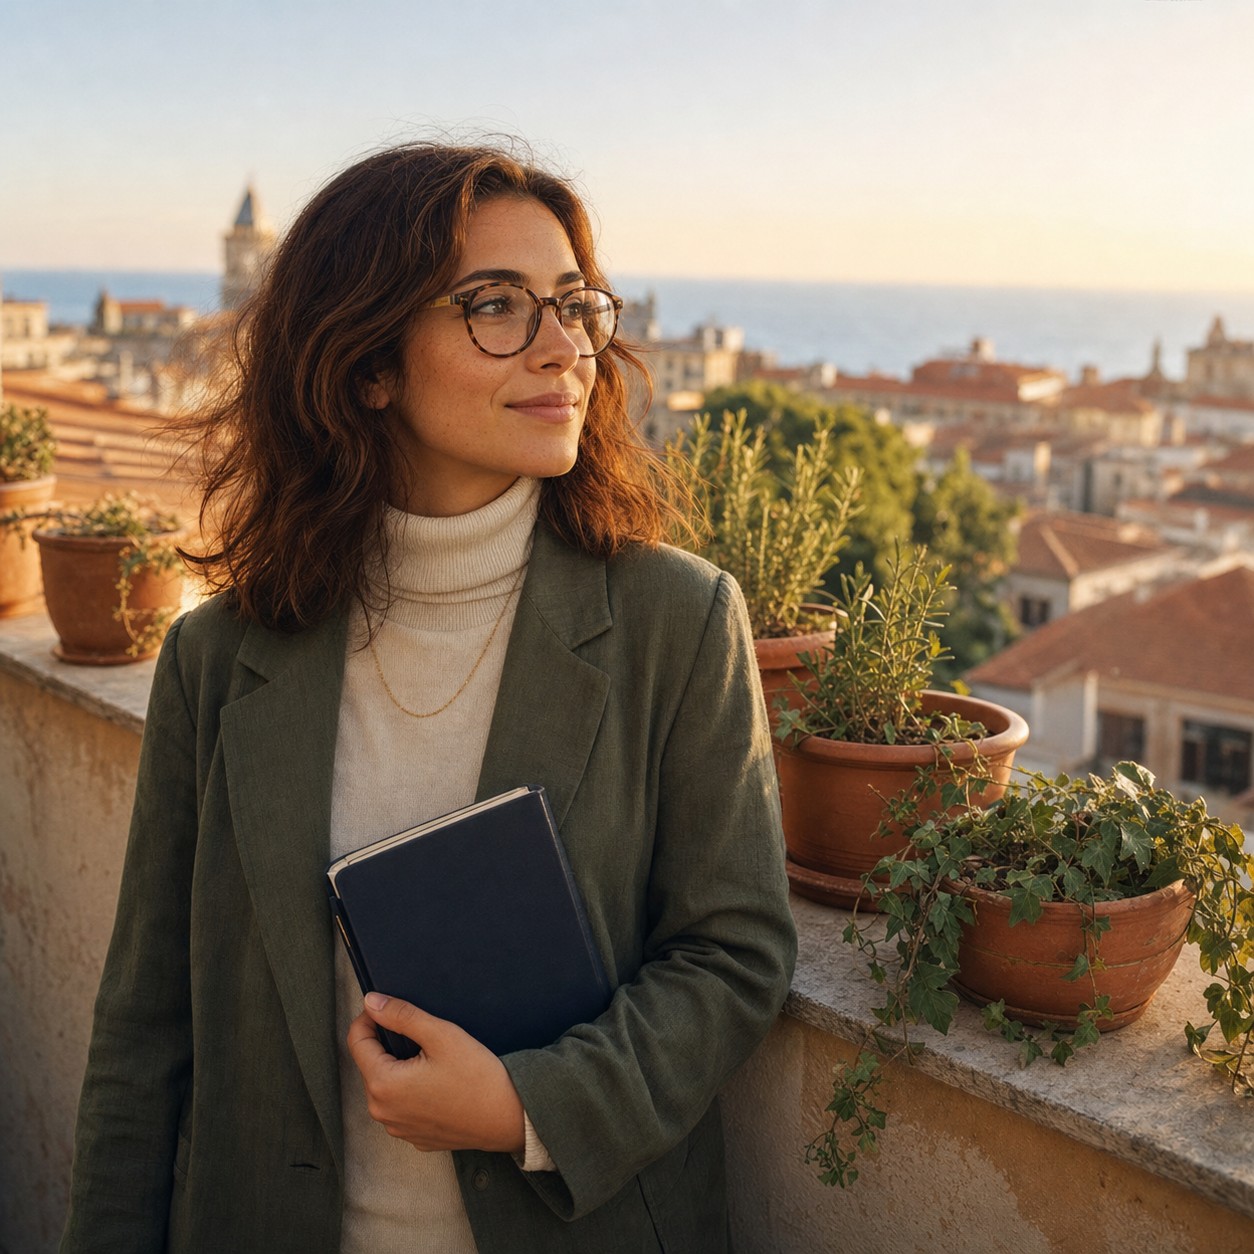
Formato do rosto, comprimento e cor do cabelo, óculos, gola alta, blazer, colar e até o caderno — tudo se mantém. A luz e os tons mudam com a cena, como deveriam; o sujeito não muda.
Algumas notas práticas ao executar esse padrão em escala:
- Ancore cada parte do corpo com três ou mais características relacionadas. Apenas "cabelo ondulado castanho-avermelhado escuro" deriva. "Cabelo ondulado castanho-avermelhado escuro na altura dos ombros" mais "óculos redondos de tartaruga" como âncora extra duas orações depois trava o rosto com mais firmeza. O modelo trata características coocorrentes como um sinal de identidade mais forte do que qualquer característica isolada.
- Coloque a ficha de personagem no topo do prompt. A descrição da cena vem depois, não antes. O modelo dá mais peso à identidade do sujeito nos tokens iniciais.
- Termine cada cena com o mesmo modificador de estilo repetido ("filme 35mm, profundidade de campo rasa, 1:1"). Isso fixa a estética da renderização e evita que duas chamadas pareçam dois fotógrafos diferentes.
Para séries curtas (três a doze quadros do mesmo personagem), esse padrão geralmente atinge mais de 80% de consistência na primeira tentativa. Isso é bom o suficiente para moodboards, ilustrações de blog, séries sociais e cronogramas de marketing. Para trabalhos críticos de marca em que cada quadro precisa coincidir, passe para a capacidade dois.
Capacidade dois: edição multi-turno com imagens de referência
A consistência de estilo via prompt leva você perto. A variante imagem-para-imagem leva você ao exato. Você fornece uma referência (uma a cinco imagens) e um prompt dizendo o que mudar — ela muda ali e deixa o resto intacto.
O uso mais comum é a substituição de cena em ativos de marca: o mesmo produto, a mesma cadeira, o mesmo personagem em ambientes diferentes, com o sujeito preservado fielmente pixel a pixel e o ambiente redesenhado ao redor dele.
Foto de referência — uma poltrona escultural de nogueira, sobre um fundo creme sem emendas, gerada com gpt-image-2:
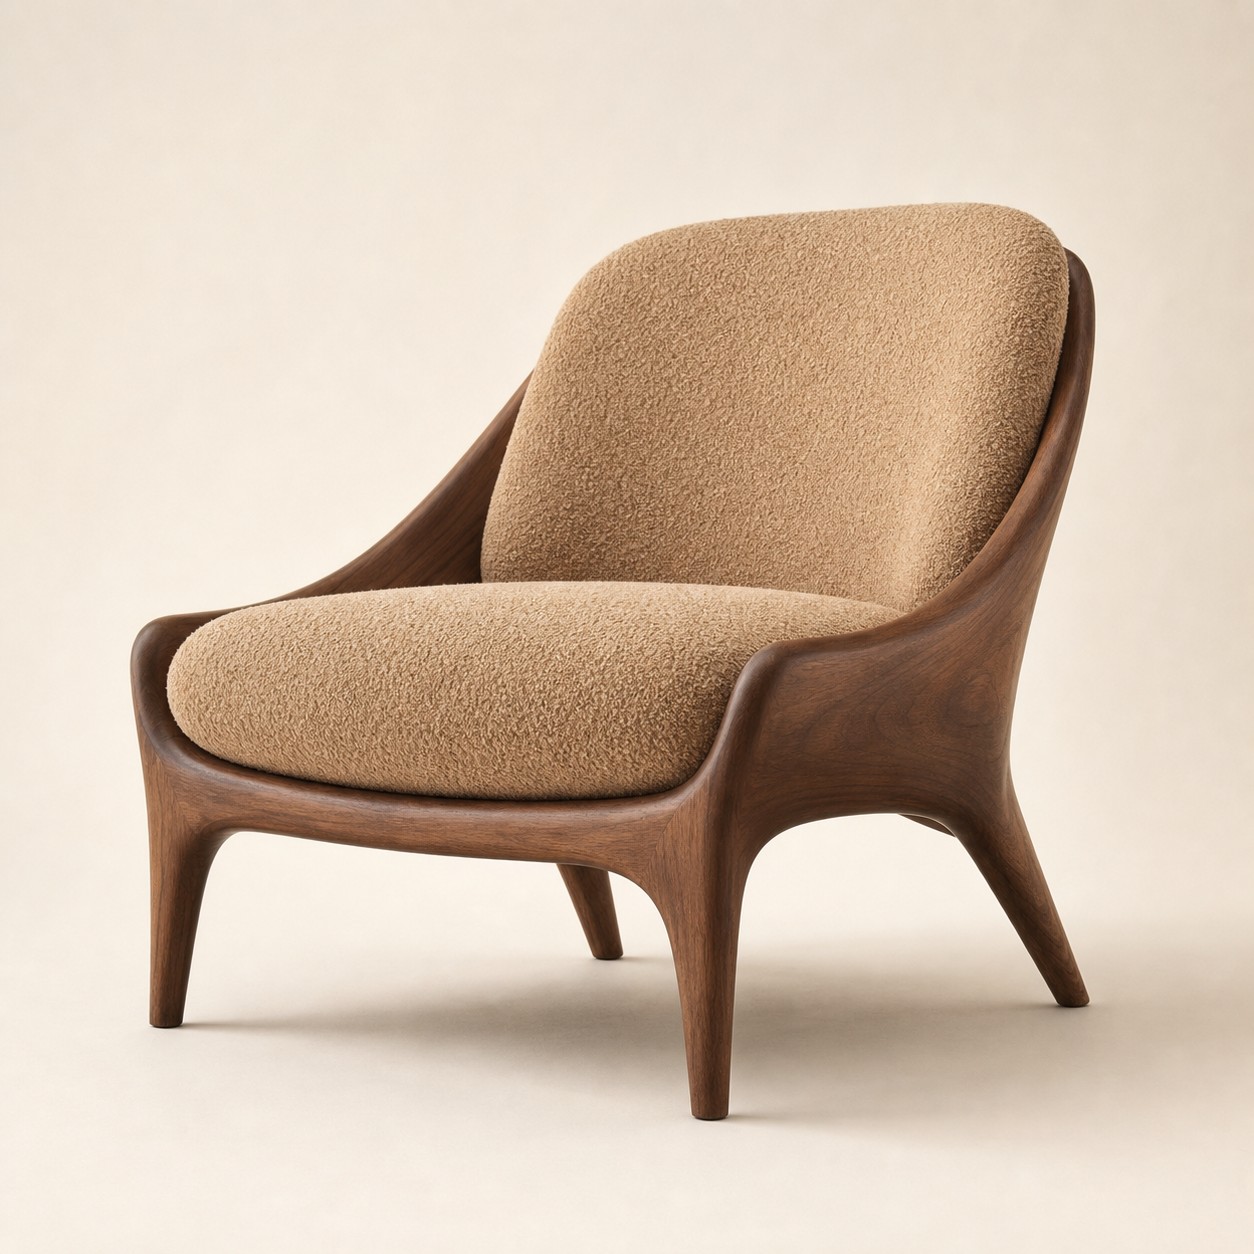
Agora envie essa imagem exata para o gpt-image-2/image-to-image com um prompt de substituição de ambiente:
Reformule esta cadeira exata em uma cena editorial rica em luz,
sem alterar a cadeira em si: mantenha a forma da estrutura de nogueira, o assento
de bouclé camel, as proporções das pernas, a silhueta exata fiel
pixel a pixel. Substitua o fundo creme sem emendas por um canto de leitura
quente e ensolarado: uma janela alta em arco no canto superior esquerdo, projetando longas
sombras do meio da tarde em um piso amplo de tábuas de carvalho, uma pequena mesa lateral
lateral de freixo tingido escuro à direita, com um vaso de cerâmica contendo três hastes
de trigo seco, uma manta de linho natural dobrada sobre o braço
de um lado da cadeira, e sob ela um tapete macio
de estilo berbere em tons creme suave e terracota desbotado. Luz quente da tarde, ar levemente
enevoado, fotografia de interiores de revista, tons neutros compatíveis.
Resultado — a mesma cadeira, um novo ambiente:
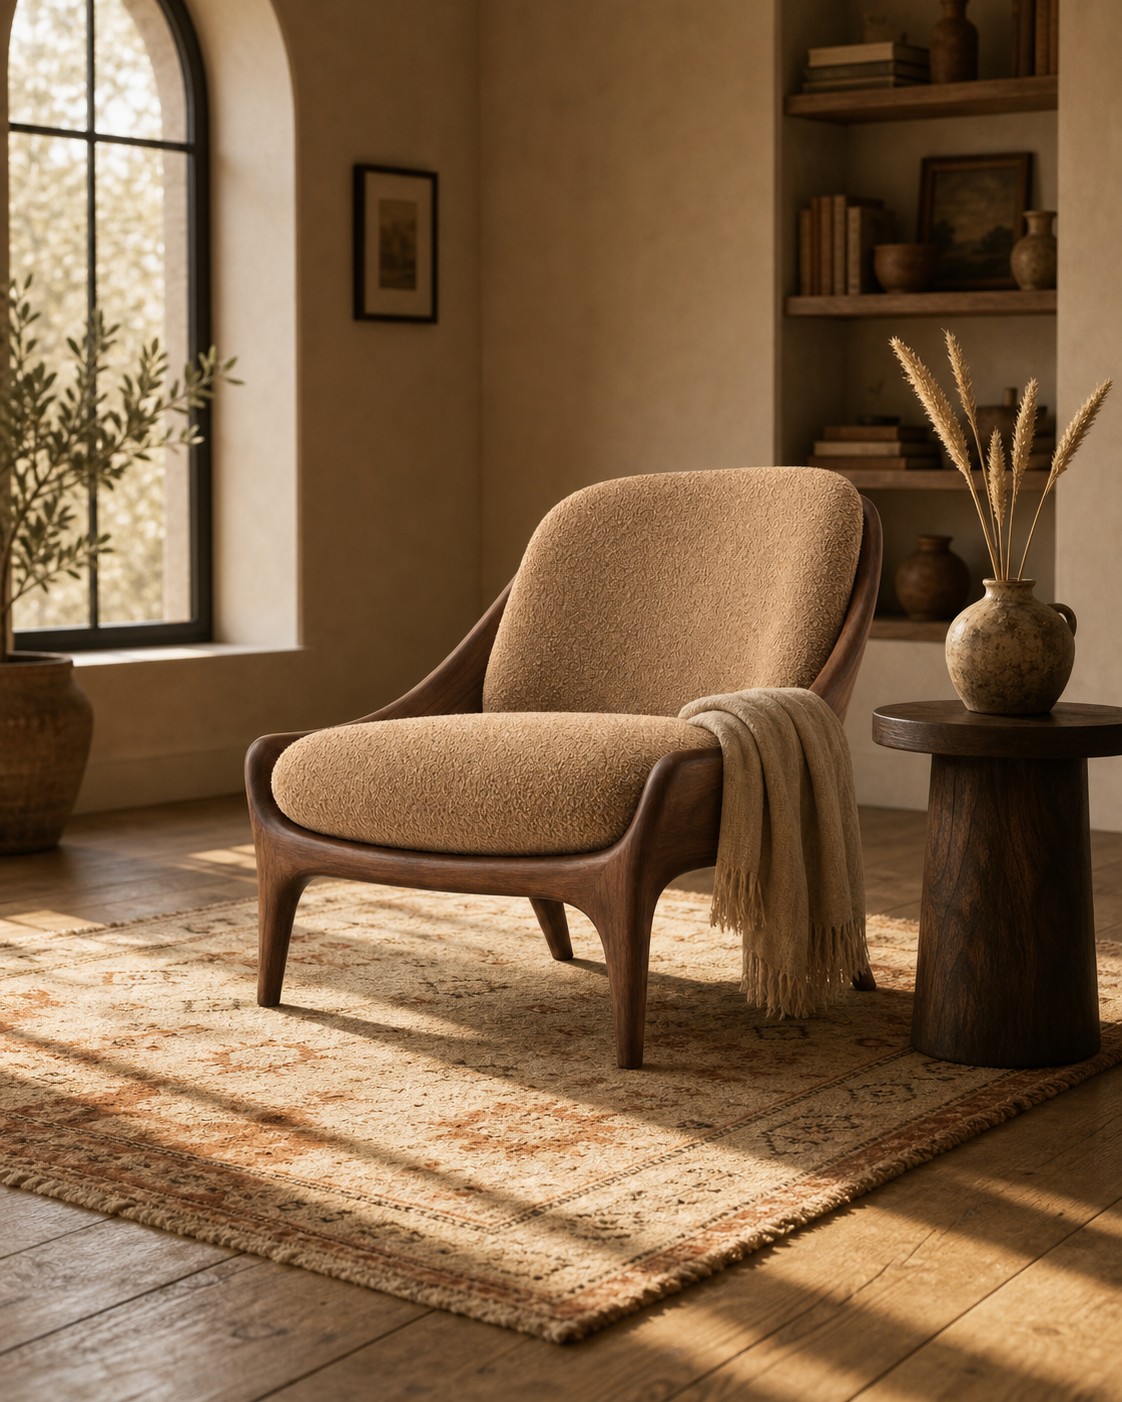
A forma da estrutura, o tecido do assento, os tons e a geometria das pernas continuam de forma limpa. O fundo sem emendas desapareceu; um ambiente completo foi desenhado ao redor daquele elemento controlado pela marca.
No que a variante de edição se destaca:
- Substituição de cena. Trazer um sujeito isolado para um ambiente, ou mover um sujeito ambientado para um novo ambiente.
- Alterações precisas de atributos. "Mude o tecido do assento para veludo azul-marinho, mantenha tudo o resto igual" — funciona muito melhor do que repromptar a cena inteira do zero.
- Ajustes finos de composição. "A mesma cadeira, o mesmo ambiente, câmera um passo atrás e um cachorrinho na manta" — o modelo edita em vez de redesenhar.
- Reformulação de ativos de marca. Usar um moodboard de campanha como referência com um prompt pedindo três variantes compatíveis preserva o tom melhor do que três prompts de texto independentes.
No que não se destaca (use texto-para-imagem padrão em vez disso):
- Reescrita significativa de composição. Se mais de 60% do quadro precisa mudar, é melhor começar com um novo prompt.
- Substituição de personagem. Se você quer dizer "a mesma cadeira, mas uma cadeira diferente", isso é um novo prompt, não uma edição.
Código: dois modelos, de ponta a ponta
Ambos os modelos respondem em POST /v1/tasks. A chamada de texto-para-imagem envia o prompt em input; a chamada imagem-para-imagem adiciona um array input_urls com uma a cinco URLs de imagens de referência.
Texto-para-imagem (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # A ficha de personagem vem primeiro — os tokens iniciais carregam a identidade.
            "Uma jovem no final dos vinte anos, cabelo ondulado castanho-avermelhado "
            "escuro na altura dos ombros, pele oliva quente, sardas suaves, "
            "óculos redondos de tartaruga, gola alta de lã creme, corrente "
            "fina de ouro, blazer de linho verde-musgo. "
            # A cena vem depois.
            "Ela está sentada em uma mesa de mármore de café perto de uma janela alta, latte "
            "em uma xícara de cerâmica branca, caderno de couro azul-marinho aberto. "
            # Os modificadores de estilo vêm por último — eles fixam a aparência da série.
            "filme 35mm, interior de café quente, profundidade de campo rasa, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Para um canvas 2K, defina "resolution": "2K". O preço escala em 1.33× conforme a página de preços ao vivo — mesma forma de chamada, $0.04 em vez de $0.03.
Imagem-para-imagem (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Reformule esta cadeira exata em um canto de leitura quente e ensolarado: "
            "janela em arco no canto superior esquerdo, piso de tábuas de carvalho, mesa lateral "
            "de freixo escuro com trigo seco, tapete berbere. Mantenha a "
            "estrutura de nogueira, o assento de bouclé e a silhueta IDÊNTICOS."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Você pode incluir até cinco imagens de referência na mesma chamada — adicione mais URLs ao array input_urls. O modelo trata as referências como um pequeno contexto de estilo/identidade e, em seguida, aplica a edição especificada no prompt. Observe que as referências são URLs hospedadas, não base64 inline — se sua referência está no disco, primeiro faça upload para um local acessível (armazenamento de objetos, seu CDN) e passe o link.
Algumas notas operacionais:
- Espere 60–120 segundos de ponta a ponta em 1K; 2K leva mais. O fluxo assíncrono significa que nenhuma conexão HTTP de longa duração vai expirar — faça polling a cada poucos segundos ou defina
callback.urlna chamada de criação para o hiapi fazer POST do estado final. - Não bloqueie o handler da requisição esperando a geração. A API já te dá um ID de tarefa — persista o
taskIde deixe o poller ou o callback fazer o trabalho, em vez de manter a invocação serverless aberta. - Duas combinações de parâmetros a evitar na variante de edição:
aspect_ratio: "auto"(ou omitido) só é compatível com resolução1K, e1:1não pode ser combinado com4K. - Use a resolução de saída desejada para as imagens de referência. Enviar uma referência 512×512 e pedir saída 2K funciona, mas o modelo ancora menos detalhe. Para edições fiéis à marca, envie referências no tamanho de saída alvo.
Quando usar qual (e o que mais o hiapi oferece)
Quando você precisa de renderização de texto, consistência de personagem ou produto em séries curtas, ou edições precisas em ativos de marca, o gpt-image-2 e sua variante imagem-para-imagem são a escolha padrão. Eles não são as únicas opções de imagem no hiapi, e a escolha entre eles importa mais do que parece:
| Necessidade | Modelo | Por quê |
|---|---|---|
| Primeiro rascunho a partir do prompt, exploração | gpt-image-2 ($0.03) |
O mais barato da série; o padrão de ficha de personagem mais cena leva você longe. |
| Edição precisa / substituição de cena / reformulação de marca | gpt-image-2/image-to-image ($0.03) |
Mesmo preço, mas ancorado a uma referência. A escolha certa sempre que a saída precisa coincidir com um ativo existente. |
| Canvas de marketing 4K de alta fidelidade | gpt-image-2 4K ($0.06) |
A variante padrão expõe o nível 4K, multiplicador limpo de 2× — o caminho mais barato para um canvas grande. |
| Key visual de produção, onde regenerar é caro | gpt-image-2-pro ($0.35) |
O nível de estabilidade da mesma série, cerca de 10× o preço padrão, para aquela pequena fração de trabalhos em que uma renderização ruim custa mais do que dez boas. |
| Retrato fotorrealista de um único sujeito, sem edição | flux-1.1-pro ($0.05) |
O FLUX 1.1 Pro no hiapi é o especialista em realismo, quando você não precisa de renderização de texto ou edição multi-turno. |
| Edições com foco em velocidade, consistência de personagem em escala | Nano-Banana-2 ($0.085 em 1K) |
A variante Gemini 3.1 Flash Image do Google — características de identidade diferentes, padrões de edição semelhantes, resposta mais rápida, ao custo de um preço por chamada mais alto. |
A coluna de preços na tabela acima vem dos preços ao vivo da plataforma — atualize-a antes de citar números nas suas próprias estimativas internas.
Um padrão que você pode copiar
Se você tem um pipeline existente que chama gpt-image-2 uma vez por requisição, a atualização mais barata é introduzir uma segunda chamada:
def render(job):
    # 1) Primeiro rascunho a partir do prompt.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Se o trabalho é crítico para a marca ou precisa de uma substituição de cena,
    #    edite o rascunho em vez de repromptar.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # o que mudar
            "input_urls": [draft.output_url],    # o que manter
            "resolution": "1K",
        })

    return draft
Duas chamadas a $0.03 cada, totalizando $0.06 — ainda mais barato do que uma única chamada gpt-image-2-pro ($0.35), e para a maioria dos trabalhos a segunda chamada substitui três a quatro rodadas de descartar e repromptar. Quanto mais a saída precisa ser fiel à marca, mais essa conta compensa.
A versão curta
O gpt-image-2 é o motor de rascunho. O gpt-image-2/image-to-image é o editor. Juntos, eles cobrem workflows que a geração de imagem em chamada única não cobre — séries de personagens, reformulação de ativos de marca, alterações precisas de atributos — sem precisar subir para o nível Pro.
Os dois padrões com maior retorno são: (1) reutilizar literalmente a ficha de personagem entre cenas para consistência de série; (2) qualquer trabalho em que a saída precise parecer uma extensão de um ativo existente, usando o fluxo de duas chamadas de renderizar e depois editar. Ambos são feitos a $0.03 por chamada no endpoint /v1/tasks do hiapi, e ambos entregam o mesmo formato de payload de tarefa — uma função worker cobre esse par.
Confira os preços ao vivo, escreva a ficha de personagem uma vez e deixe o editor fazer o trabalho que o reprompt não consegue fazer.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado