
Tutoriel
GPT Image 2 : édition multi-tours et cohérence de style — le parcours des capacités hiapi
Comment combiner gpt-image-2 et gpt-image-2-image-to-image pour créer des séries d'images à personnage cohérent et des éditions précises — pour seulement 0,03 $ par appel sur hiapi.
La plupart des posts « GPT Image 2 est incroyable » ne vous montrent qu'un seul rendu. C'est la moitié facile. La moitié difficile — celle qui compte vraiment quand vous intégrez le travail d'image dans un produit — c'est le deuxième rendu et le troisième : garder un personnage reconnaissable à travers une série d'images, ou restyler un visuel clé sans détruire ce qui le rendait réussi au départ.
Sur hiapi, gpt-image-2 désigne deux modèles, pas un. La variante standard texte-vers-image peint la première frame ; gpt-image-2/image-to-image reprend cette frame comme référence pour l'éditer. Combinés, à 0,03 $ par appel, ils couvrent les workflows qui apparaissent en production réelle : séries d'images à personnage cohérent, remplacement de scène précis, restyling d'actifs de marque. Cet article passe les deux en revue, avec des prompts originaux, des sorties réelles et du code directement copiable.
Deux modèles, un workflow
Les deux variantes utilisent l'API de tâches asynchrones unifiée de hiapi — POST https://api.hiapi.ai/v1/tasks crée une tâche de génération et renvoie un ID de tâche, GET /v1/tasks/:id renvoie l'URL de l'image une fois terminée. La différence réside dans ce que vous placez dans l'objet input.
| Cas d'usage | Modèle | Prix 1K | Prix 2K | Forme d'entrée |
|---|---|---|---|---|
| Générer le premier rendu à partir d'un prompt | gpt-image-2 |
0,03 $ | 0,04 $ | Texte uniquement |
| Éditer/restyler une image de référence | gpt-image-2/image-to-image |
0,03 $ | 0,04 $ | Texte + 1 à 5 images de référence |
Les chiffres ci-dessus proviennent directement de la page de tarifs en temps réel au moment de la rédaction — cette page fait foi. gpt-image-2 standard utilise une courbe multiplicatrice (1K → 2K à 1,33×, 4K à 2×), donc un appel 1K coûte 0,03 $ et un canevas 4K coûte 0,06 $. La variante image-vers-image suit la même courbe. Aucun « supplément d'édition » — les deux modèles coûtent le même prix par appel à résolution égale.
Cette séparation est importante car elle change votre façon d'aborder un travail. Vous ne payez pas une séance coûteuse pour acheter « la bonne image ». Vous payez 0,03 $ pour approcher, puis 0,03 $ (ou deux fois) pour atteindre l'exactitude.
Capacité 1 : cohérence de style sur une série
Le mode qui fait échouer la plupart des workflows texte-vers-image, c'est le même sujet dans des scènes différentes. Lancez deux fois le même prompt, vous obtenez deux personnes sans lien ; lancez deux prompts de scène au sujet décrit de façon lâche, vous obtenez des cousins.
gpt-image-2 s'en sort étonnamment bien quand vous faites deux choses :
- Rédiger une fiche de personnage inline. Pas « une jeune femme à lunettes ». Mais des traits concrets auxquels le modèle peut se raccrocher : couleur et longueur et texture des cheveux, carnation et taches de rousseur, lunettes et style de lunettes, chaque vêtement qui vous importe. Six à dix traits d'ancrage constituent la plage idéale.
- Réutiliser la fiche mot pour mot dans chaque scène. Même ordre des mots, mêmes qualificatifs. Traitez la description comme un objet JSON : la scène change, la fiche de personnage reste identique octet pour octet.
Voici la même fiche de personnage lancée dans deux scènes différentes. La fiche ne change pas entre les deux appels ; seul le paragraphe de scène diffère.
Fiche de personnage (réutilisée mot pour mot dans les deux appels) :
"une jeune femme à la fin de la vingtaine, cheveux mi-longs ondulés
d'un auburn foncé, peau olive chaude, taches de rousseur douces
sur le nez, lunettes rondes en écaille, col roulé en laine crème,
fine chaîne dorée, blazer en lin vert mousse posé sur les épaules"

Scène A : table de café en marbre près d'une grande fenêtre
orientée nord, tasse plate blanche avec latte art, carnet en
cuir bleu marine ouvert, stylo plume en laiton, suspensions
en laiton floues en arrière-plan, film 35mm, faible profondeur
de champ, 1:1.

Scène B : terrasse de toit méditerranéenne à l'heure dorée, pots
en terre cuite avec romarin et lierre retombant, le même carnet
en cuir bleu marine tenu contre la poitrine, regard vers les toits
chauds et la mer, film 35mm, tonalité naturelle assortie à la
scène A, faible profondeur de champ, 1:1.
Deux appels, deux scènes, la même personne :
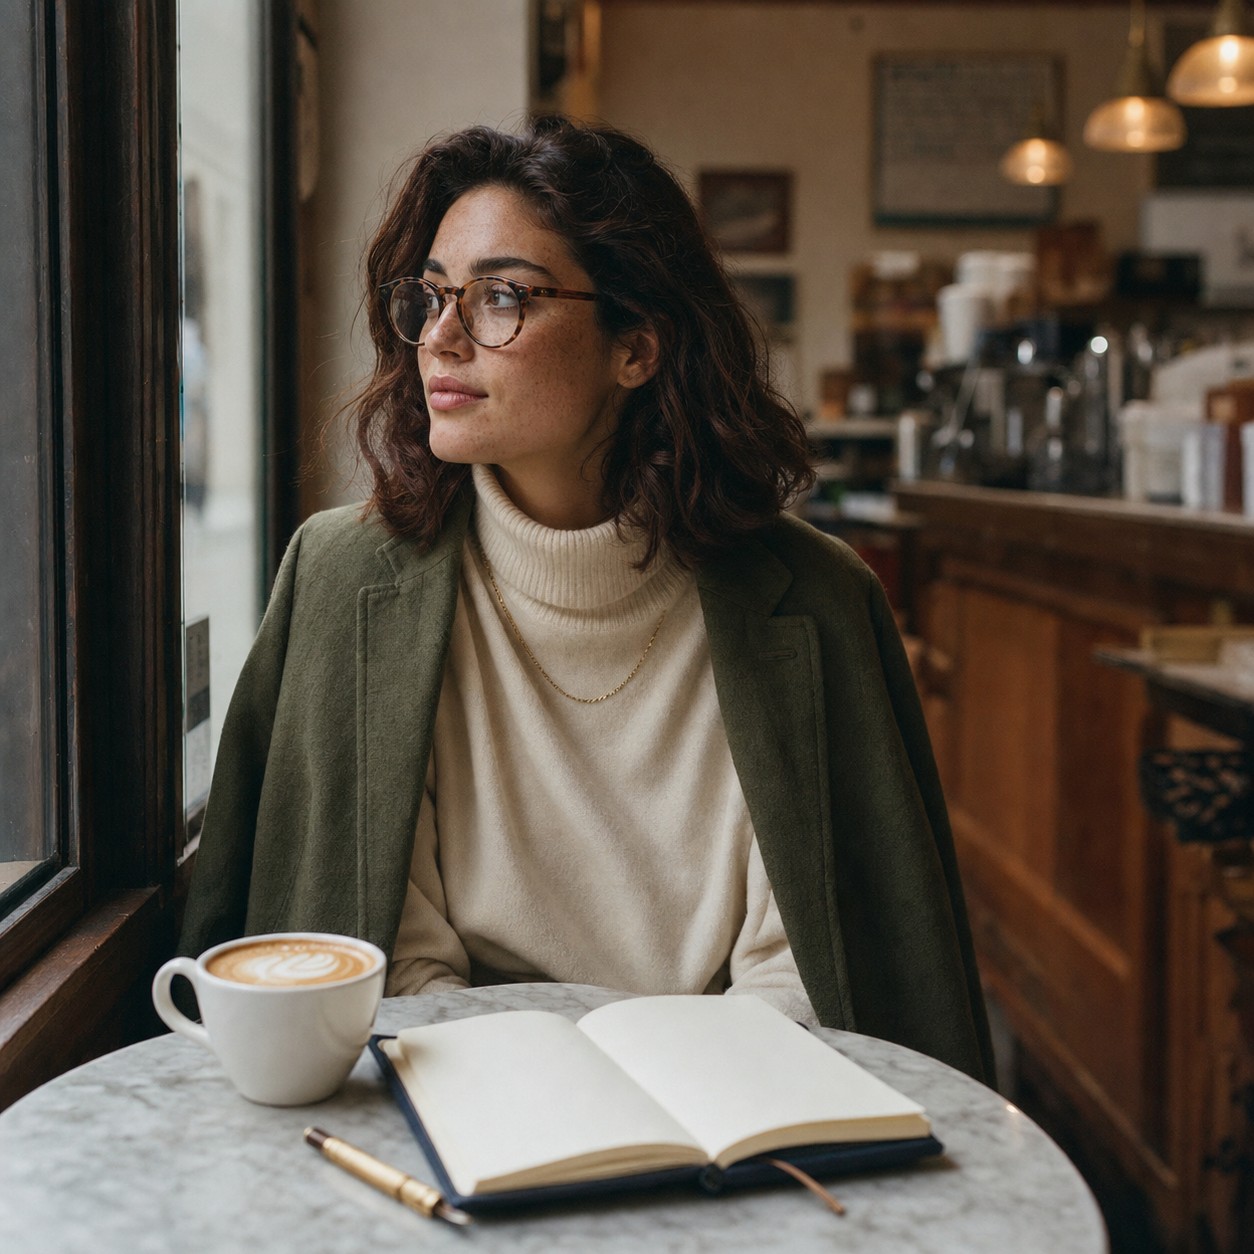
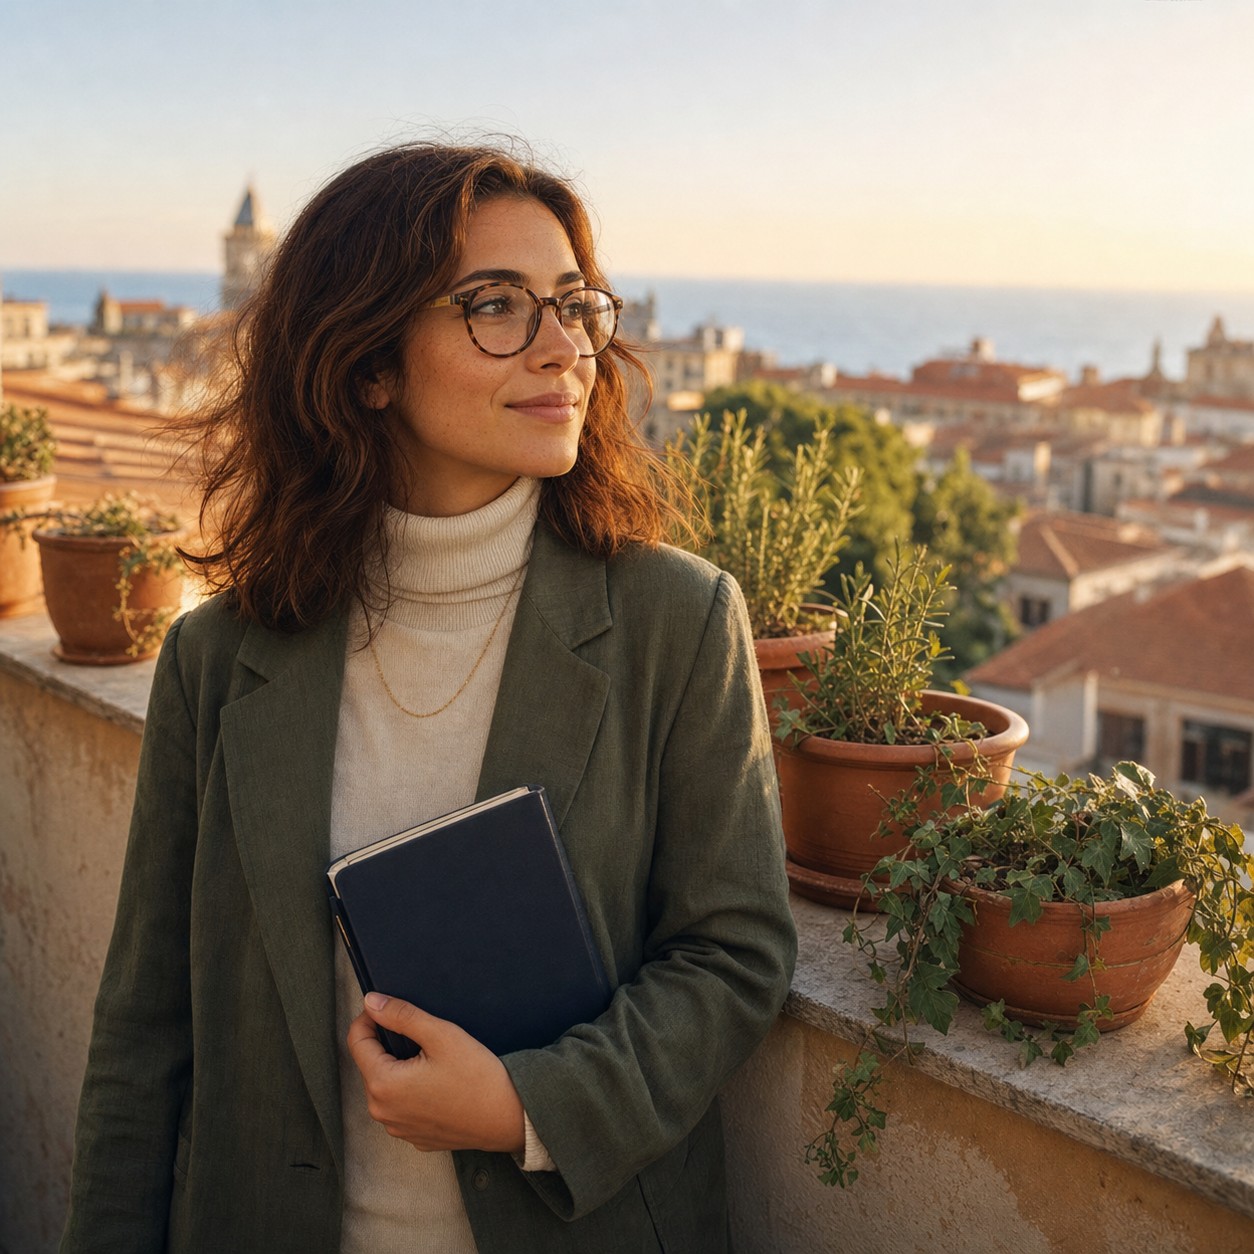
Forme du visage, longueur et couleur des cheveux, lunettes, col roulé, blazer, collier, et même le carnet — tout se maintient. La lumière et la tonalité changent avec la scène, comme il se doit ; le sujet ne change pas.
Quelques notes pratiques pour faire tourner ce mode à grande échelle :
- Ancrez chaque partie du corps avec trois traits corrélés ou plus. « cheveux ondulés d'un auburn foncé » seul dérive. « cheveux mi-longs ondulés d'un auburn foncé » plus « lunettes rondes en écaille » deux propositions plus loin comme ancrage supplémentaire verrouille le visage plus fermement. Le modèle traite les traits co-occurrents comme un signal d'identité plus fort que n'importe quel trait isolé.
- Placez la fiche en haut du prompt. La description de scène vient après, pas avant. Le modèle accorde plus de poids à l'identité du sujet dans les premiers tokens.
- Terminez chaque scène par le même qualificatif de style répété (« film 35mm, faible profondeur de champ, 1:1 »). Cela fixe l'esthétique du rendu pour que les deux appels ne ressemblent pas à deux photographes différents.
Pour une courte série (trois à douze frames du même personnage), ce mode atteint généralement plus de 80 % de cohérence au premier essai. C'est assez bon pour des moodboards, des illustrations de blog, des séries sociales, des calendriers marketing. Pour un travail critique de marque où chaque frame doit correspondre, passez à la capacité 2.
Capacité 2 : édition multi-tours avec images de référence
La cohérence de style par prompt vous rapproche. La variante image-vers-image vous rend précis. Vous lui donnez une référence (une à cinq images) et un prompt décrivant quoi changer — elle change cela, le reste ne bouge pas.
L'usage le plus courant est le remplacement de scène sur un actif de marque : le même produit, la même chaise, le même personnage dans des environnements différents, le sujet préservé au pixel près, l'environnement redessiné autour de lui.
Photo de référence — un fauteuil lounge sculptural en noyer, posé sur un fond crème sans couture, généré avec gpt-image-2 :
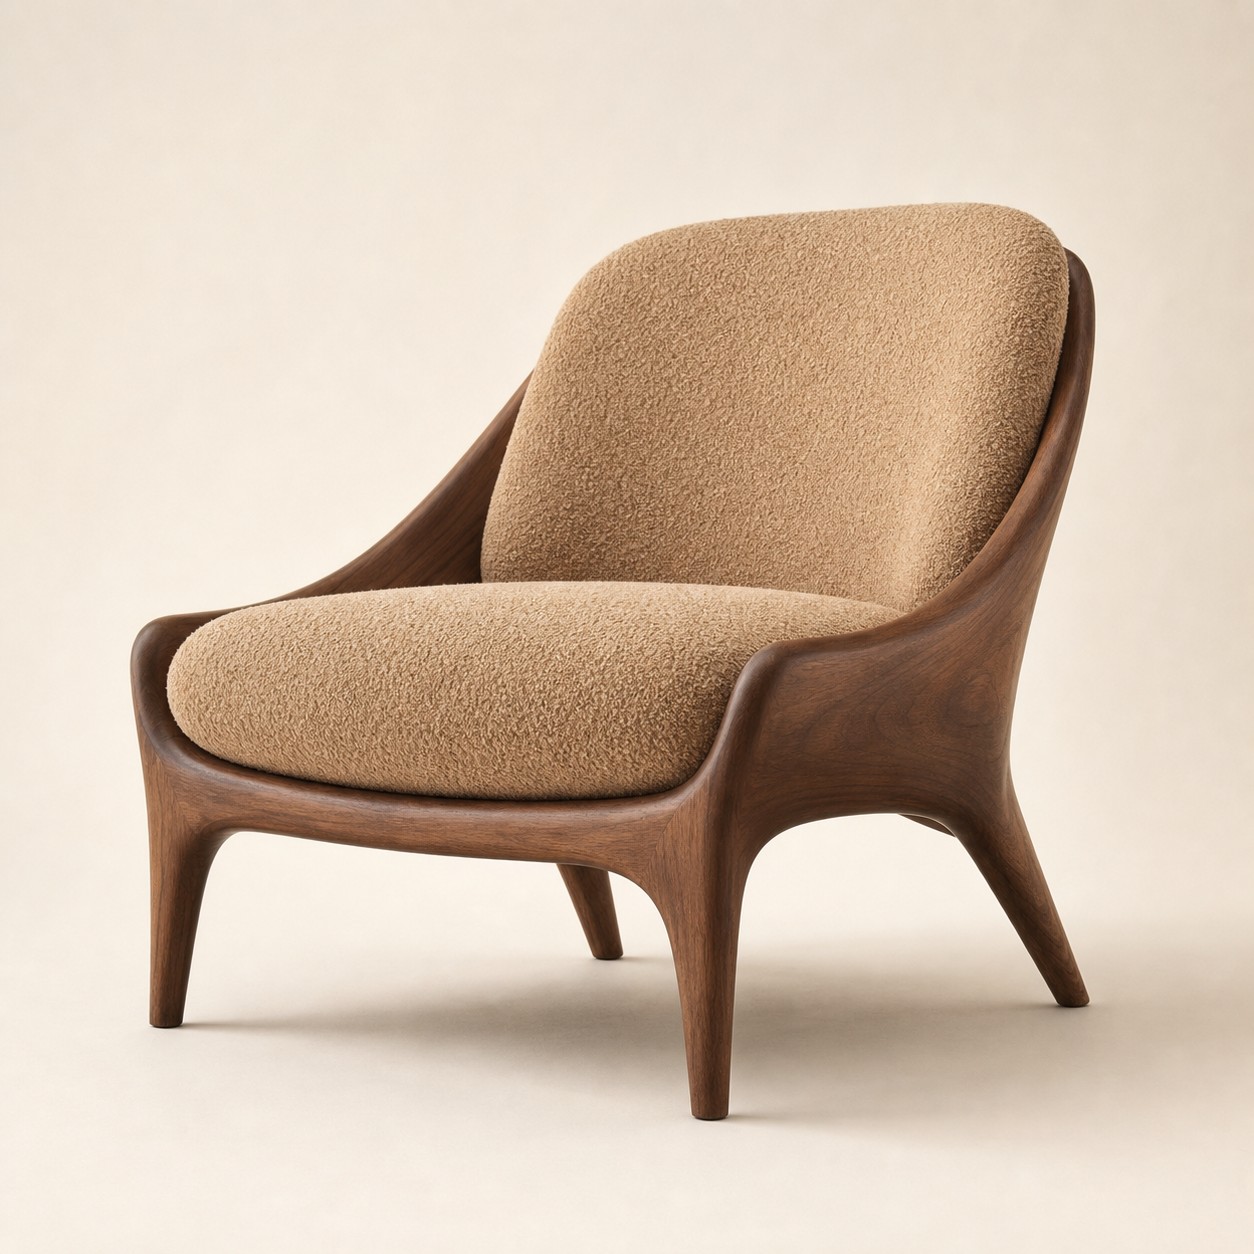
Envoyez maintenant cette image exacte à gpt-image-2/image-to-image avec un prompt de remplacement d'environnement :
Restyle cette chaise exacte dans un décor éditorial lumineux
sans modifier la chaise elle-même : garde la forme du cadre
en noyer, le coussin en bouclette camel, les proportions des
pieds, la silhouette exacte fidèle au pixel près. Remplace le
fond crème sans couture par un coin lecture chaleureux et
ensoleillé : une grande fenêtre arquée en haut à gauche projetant
de longues ombres de fin d'après-midi sur un large plancher en
chêne, à droite une petite table d'appoint ronde en frêne teinté
foncé, sur laquelle un vase en céramique tient trois brins de blé
séché, un plaid en lin naturel plié sur un accoudoir de la chaise,
et en dessous un tapis vintage d'inspiration berbère aux tons
crème doux et terre cuite délavée. Ambiance lumière chaude
d'après-midi, air légèrement brumeux, photographie d'intérieur
de magazine, palette neutre assortie.
Résultat — la même chaise, une nouvelle pièce :
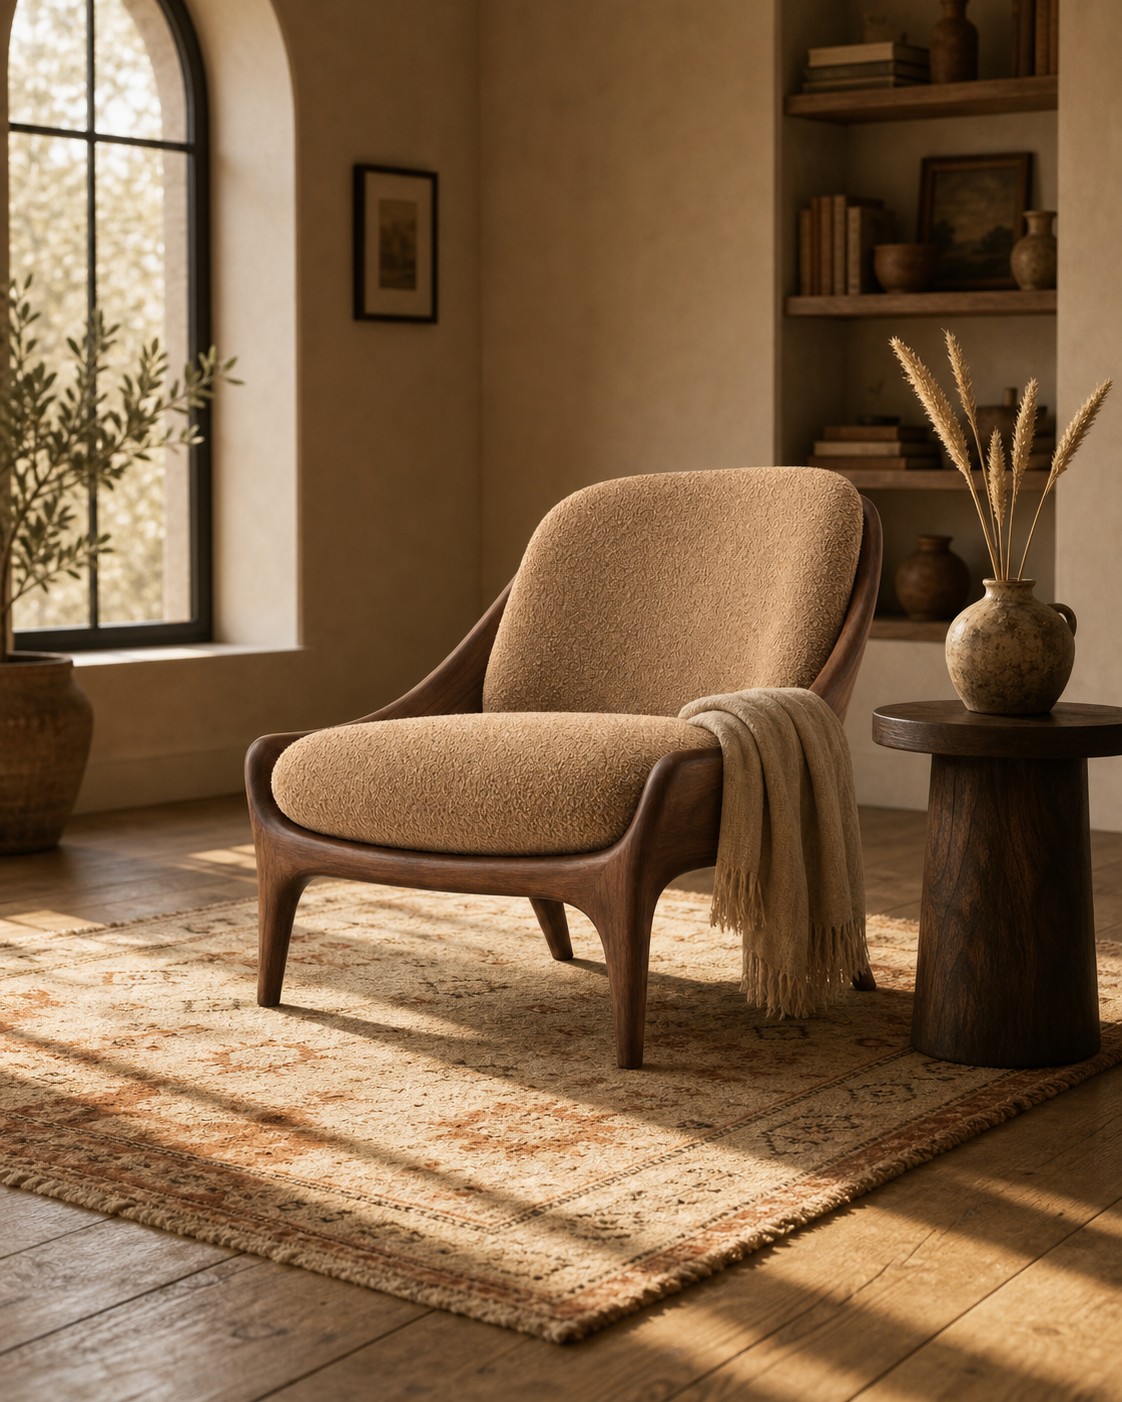
La forme du cadre, le tissu du coussin, la tonalité et la géométrie des pieds se maintiennent proprement. Le fond sans couture a disparu ; un environnement complet a été peint autour de cet élément contrôlé de la marque.
Ce que la variante d'édition excelle à faire :
- Remplacement de scène. Tirer un sujet isolé dans un environnement, ou déplacer un sujet d'environnement vers un nouvel environnement.
- Changements d'attributs précis. « Change le tissu du coussin en velours bleu marine, tout le reste identique » — bien plus efficace que de re-prompter toute la scène depuis zéro.
- Ajustements de composition. « La même chaise, la même pièce, recule la caméra d'un pas et ajoute un petit chien sur le plaid » — le modèle édite plutôt que de redessiner.
- Restyling d'actifs de marque. Prendre un moodboard de campagne comme référence avec un prompt demandant trois variantes assorties maintient mieux le ton que trois prompts texte indépendants.
Ce qu'elle n'excelle pas à faire (revenez au texte-vers-image standard) :
- Réécriture majeure de composition. Si plus de 60 % de l'image doit changer, mieux vaut repartir d'un nouveau prompt.
- Remplacement de personnage. Si vous voulez dire « la même chaise mais une chaise différente », c'est un nouveau prompt, pas une édition.
Code : les deux modèles, de bout en bout
Les deux modèles répondent sur POST /v1/tasks. L'appel texte-vers-image envoie le prompt dans input ; l'appel image-vers-image ajoute un tableau input_urls portant une à cinq URL d'images de référence.
Texte-vers-image (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # Fiche de personnage d'abord — les premiers tokens portent l'identité.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # Scène ensuite.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # Qualificatif de style en dernier — fixe l'apparence de la série.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Pour un canevas 2K, réglez "resolution": "2K". La tarification s'échelonne selon la page de tarifs en temps réel à 1,33× — même forme d'appel, 0,04 $ au lieu de 0,03 $.
Image-vers-image (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Jusqu'à cinq images de référence peuvent être portées dans le même appel — ajoutez d'autres URL au tableau input_urls. Le modèle traite les références comme un petit contexte de style/identité, puis écrit l'édition spécifiée dans le prompt. Notez que les références sont des URL hébergées, pas du base64 inline — si votre référence est sur disque, chargez-la d'abord vers un emplacement accessible (stockage objet, votre CDN) et passez le lien.
Quelques notes d'exploitation :
- Comptez 60 à 120 s de bout en bout en 1K ; plus long en 2K. Le flux asynchrone signifie qu'aucune connexion HTTP maintenue longtemps n'expire — interrogez toutes les quelques secondes, ou réglez
callback.urldans l'appel de création pour que hiapi vous POSTe l'état final. - Ne bloquez pas votre gestionnaire de requêtes en attendant la génération. L'API vous donne déjà un ID de tâche — persistez le
taskId, laissez un poller ou un callback faire le travail au lieu de garder un appel serverless ouvert. - Deux combinaisons de paramètres à éviter sur la variante d'édition :
aspect_ratio: "auto"(ou omis) n'est pris en charge qu'en résolution1K, et1:1ne peut pas être associé à4K. - Utilisez la résolution de sortie souhaitée pour l'image de référence. Envoyer une référence 512×512 et demander une sortie 2K fonctionne, mais le modèle ancre moins de détails. Pour une édition fidèle à la marque, envoyez la référence à la taille de sortie cible.
Quand utiliser lequel (et ce que hiapi propose d'autre)
Quand vous avez besoin de rendu de texte, de cohérence de personnage ou de produit sur une petite série, ou d'éditions précises sur des actifs de marque, gpt-image-2 et son frère image-vers-image sont le choix par défaut approprié. Ce ne sont pas les seules options d'image sur hiapi, et le choix entre elles compte plus qu'il n'y paraît :
| Besoin | Modèle | Pourquoi |
|---|---|---|
| Premier jet depuis un prompt, exploration | gpt-image-2 (0,03 $) |
Le moins cher de la série ; le mode fiche + scène vous mène loin. |
| Édition précise / remplacement de scène / restyling de marque | gpt-image-2/image-to-image (0,03 $) |
Même prix, mais ancré sur référence. Le bon choix dès qu'une sortie doit correspondre à un actif existant. |
| Canevas marketing 4K haute fidélité | gpt-image-2 4K (0,06 $) |
La variante standard expose le palier 4K, multiplicateur propre de 2× — le chemin le moins cher vers un grand canevas. |
| Visuel clé de production, coût de régénération élevé | gpt-image-2-pro (0,35 $) |
Le palier de stabilité de la même série, environ 10× le prix standard, pour cette petite fraction de travaux où un mauvais rendu coûte plus cher que dix bons. |
| Portrait photoréaliste d'un seul sujet, sans édition | flux-1.1-pro (0,05 $) |
FLUX 1.1 Pro sur hiapi est le spécialiste du réalisme, quand vous n'avez pas besoin de rendu de texte ni d'édition multi-tours. |
| Éditions critiques en vitesse, cohérence de personnage à grande échelle | Nano-Banana-2 (0,085 $ en 1K) |
La variante Gemini 3.1 Flash Image de Google — signature d'identité différente, schéma d'édition similaire, rotation plus rapide, au prix d'un coût par appel plus élevé. |
La colonne des prix du tableau ci-dessus provient de la page de tarifs en temps réel de la plateforme — rafraîchissez-la avant de citer des chiffres dans vos propres estimations internes.
Un modèle à copier tel quel
Si vous avez un pipeline existant qui appelle gpt-image-2 une fois par requête, l'amélioration la moins chère consiste à introduire un second appel :
def render(job):
    # 1) Premier jet depuis le prompt.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Si le travail est critique pour la marque ou nécessite un
    #    remplacement de scène, éditez le premier jet plutôt que
    #    de re-prompter.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # ce qui doit changer
            "input_urls": [draft.output_url],    # ce qui doit être préservé
            "resolution": "1K",
        })

    return draft
Deux appels à 0,03 $ chacun, soit 0,06 $ au total — toujours moins cher qu'un seul appel gpt-image-2-pro (0,35 $), et pour la plupart des travaux, le second appel remplace trois ou quatre cycles de jet et re-prompt. Plus une sortie doit être fidèle à la marque, plus ce calcul est avantageux.
Version courte
gpt-image-2 est le moteur de premier jet. gpt-image-2/image-to-image est l'éditeur. Combinés, ils couvrent des workflows qu'une génération d'image à appel unique ne peut couvrir — séries de personnages, restyling d'actifs de marque, changements d'attributs précis — sans passer au palier Pro.
Les deux modes les plus rentables sont : (1) réutiliser mot pour mot une fiche de personnage à travers les scènes pour la cohérence de série ; (2) le flux en deux appels rendu puis édition pour tout travail dont la sortie doit ressembler à une extension d'un actif existant. Les deux s'exécutent à 0,03 $ par appel sur le point de terminaison /v1/tasks de hiapi, et les deux livrent la même forme de charge utile de tâche — une seule fonction worker couvre la paire.
Vérifiez les tarifs en temps réel, rédigez une fiche une fois, et laissez l'éditeur faire le travail que le re-prompt ne peut pas faire.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat