
Tutoriale
GPT Image 2 modifica multi-turno e coerenza di stile: il viaggio nelle capacità di hiapi
Come combinare gpt-image-2 e gpt-image-2-image-to-image per creare serie di immagini con personaggi coerenti e modifiche precise — su hiapi a soli $0.03 per chiamata.
La maggior parte dei post del tipo "GPT Image 2 è incredibile" ti mostra solo un singolo render. Quella è solo la metà facile. La metà difficile — e quella che conta davvero quando porti il lavoro sulle immagini in un prodotto — è il secondo render e il terzo: mantenere un personaggio riconoscibile lungo una serie di immagini, oppure restilizzare un asset hero senza rompere ciò che lo rendeva efficace in primo luogo.
gpt-image-2 su hiapi sono due modelli, non uno. La variante standard text-to-image disegna il primo fotogramma; gpt-image-2/image-to-image riprende quel fotogramma come riferimento per modificarlo. Usati insieme, a $0.03 per chiamata, coprono i workflow che emergono nella produzione reale: serie con personaggi coerenti, sostituzione precisa di scene, restyling di asset di brand. Questo articolo li illustra uno per uno, con prompt originali, output reali e codice pronto da copiare.
Due modelli, un workflow
Entrambe le varianti usano l'API asincrona unificata delle attività di hiapi — POST https://api.hiapi.ai/v1/tasks crea la generazione e restituisce un ID attività, GET /v1/tasks/:id restituisce l'URL dell'immagine al completamento. La differenza sta in cosa inserisci nell'oggetto input.
| Caso d'uso | Modello | Prezzo 1K | Prezzo 2K | Forma dell'input |
|---|---|---|---|---|
| Generare il primo render dal prompt | gpt-image-2 |
$0.03 | $0.04 | Solo testo |
| Modificare/restilizzare l'immagine di riferimento | gpt-image-2/image-to-image |
$0.03 | $0.04 | Testo + da 1 a 5 immagini di riferimento |
I numeri sopra provengono direttamente dalla pagina dei prezzi live al momento della scrittura — quella pagina è la fonte autorevole. La versione standard di gpt-image-2 usa una curva a moltiplicatore (1K → 2K è 1,33×, 4K è 2×), quindi una chiamata 1K costa $0.03 e una tela 4K costa $0.06. La variante image-to-image segue la stessa curva. Non c'è alcun "supplemento di modifica": entrambi i modelli costano lo stesso per chiamata alla stessa risoluzione.
Questa separazione è importante perché cambia il modo in cui pensi a un lavoro. Non spendi una sessione costosa per comprare "l'immagine giusta". Spendai $0.03 per avvicinarti, poi $0.03 (o due) per arrivare al preciso.
Capacità uno: coerenza di stile lungo una serie
Il modello che fa crollare la maggior parte dei workflow text-to-image è lo stesso soggetto in scene diverse. Esegui lo stesso prompt due volte e ottieni due persone non correlate; esegui due prompt di scena con una descrizione vaga del soggetto e ottieni dei cugini.
gpt-image-2 se la cava sorprendentemente bene quando fai due cose:
- Scrivi una scheda personaggio inline. Non "una giovane donna con gli occhiali". Ma caratteristiche concrete a cui il modello può riancorarsi: colore e lunghezza e consistenza dei capelli, tonalità della pelle e lentiggini, occhiali e stile della montatura, ogni capo di abbigliamento che ti interessa. Da sei a dieci caratteristiche di ancoraggio sono l'intervallo ideale.
- Riusa la scheda personaggio alla lettera in ogni scena. Stesso ordine delle parole, stessi modificatori. Tratta la descrizione come un oggetto JSON: la scena cambia, la scheda personaggio resta identica byte per byte.
Qui la stessa scheda personaggio eseguita in due scene diverse. La scheda è invariata in entrambe le chiamate; cambia solo il paragrafo della scena.
Scheda personaggio (riusata alla lettera in entrambe le chiamate):
"Una giovane donna sulla tarda ventina, capelli mossi castano-ramato
scuro alle spalle, pelle olivastra calda, lentiggini delicate sul naso,
occhiali rotondi tartarugati, dolcevita in lana color crema, sottile
catena d'oro, blazer in lino verde muschio appoggiato sulle spalle"

Scena A: tavolo di marmo di un caffè vicino a una grande finestra a nord, tazza bianca piatta con
latte art, taccuino in pelle blu navy aperto, penna stilografica in ottone, lampada a sospensione in ottone sfocata
sullo sfondo, pellicola 35mm, profondità di campo ridotta, 1:1.

Scena B: terrazza sul tetto nel Mediterraneo all'ora d'oro, vasi in terracotta con
rosmarino ed edera ricadente, lo stesso taccuino in pelle blu navy stretto al
petto, sguardo verso i tetti caldi e il mare, pellicola 35mm, tonalità naturali
abbinate alla Scena A, profondità di campo ridotta, 1:1.
Due chiamate, due scene, la stessa persona:
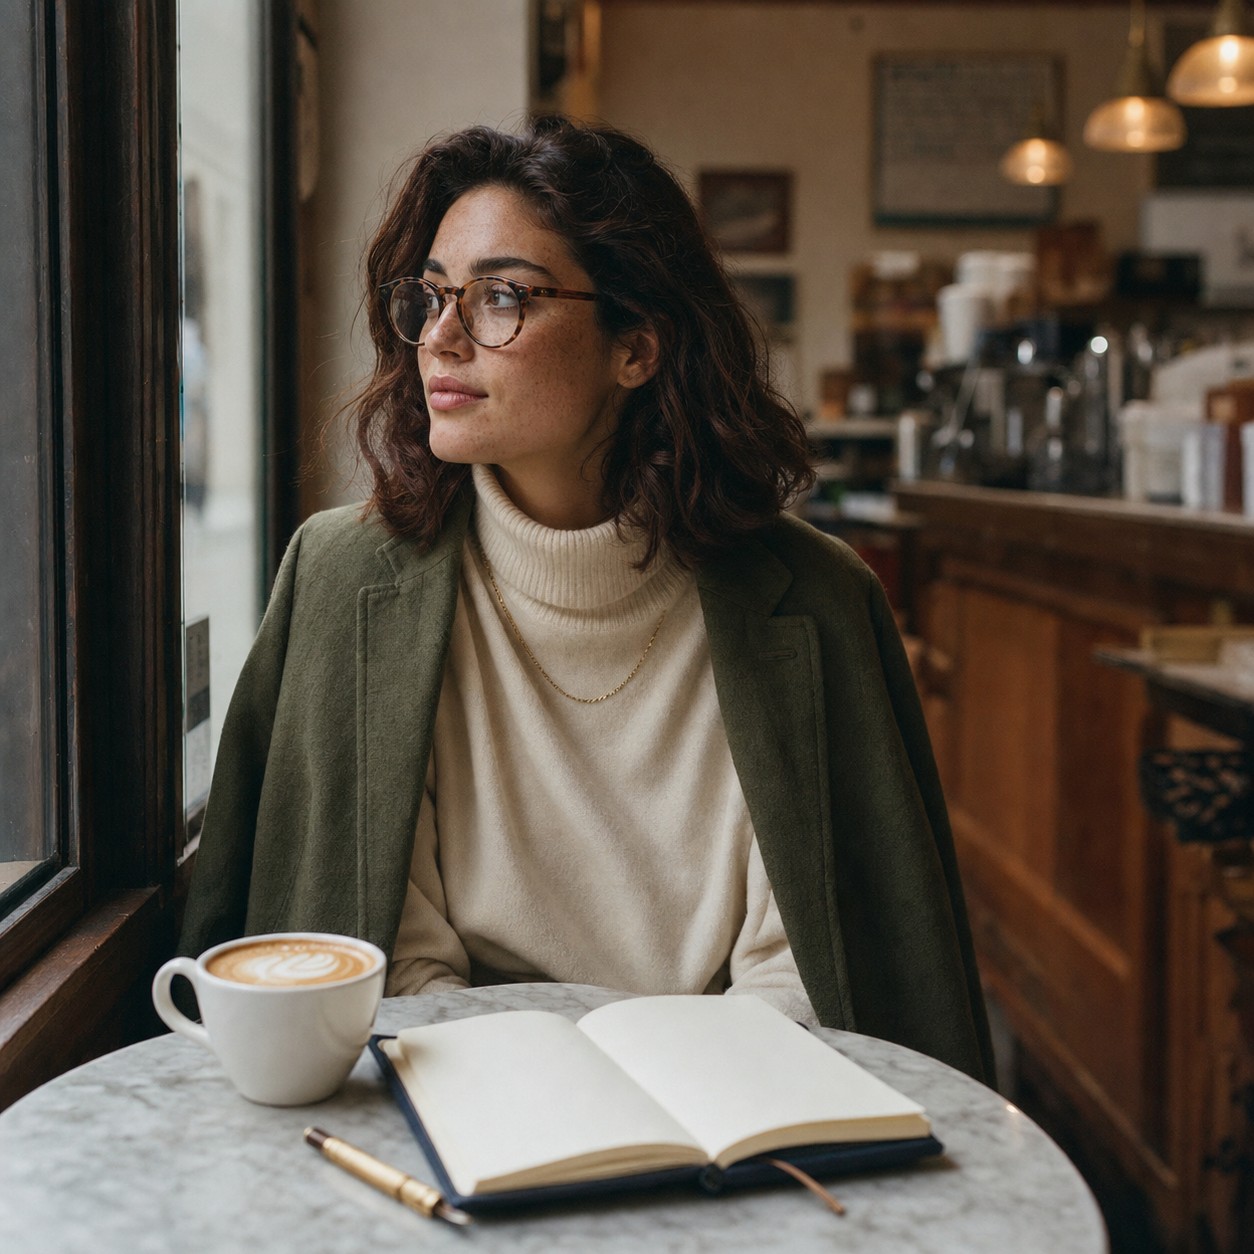
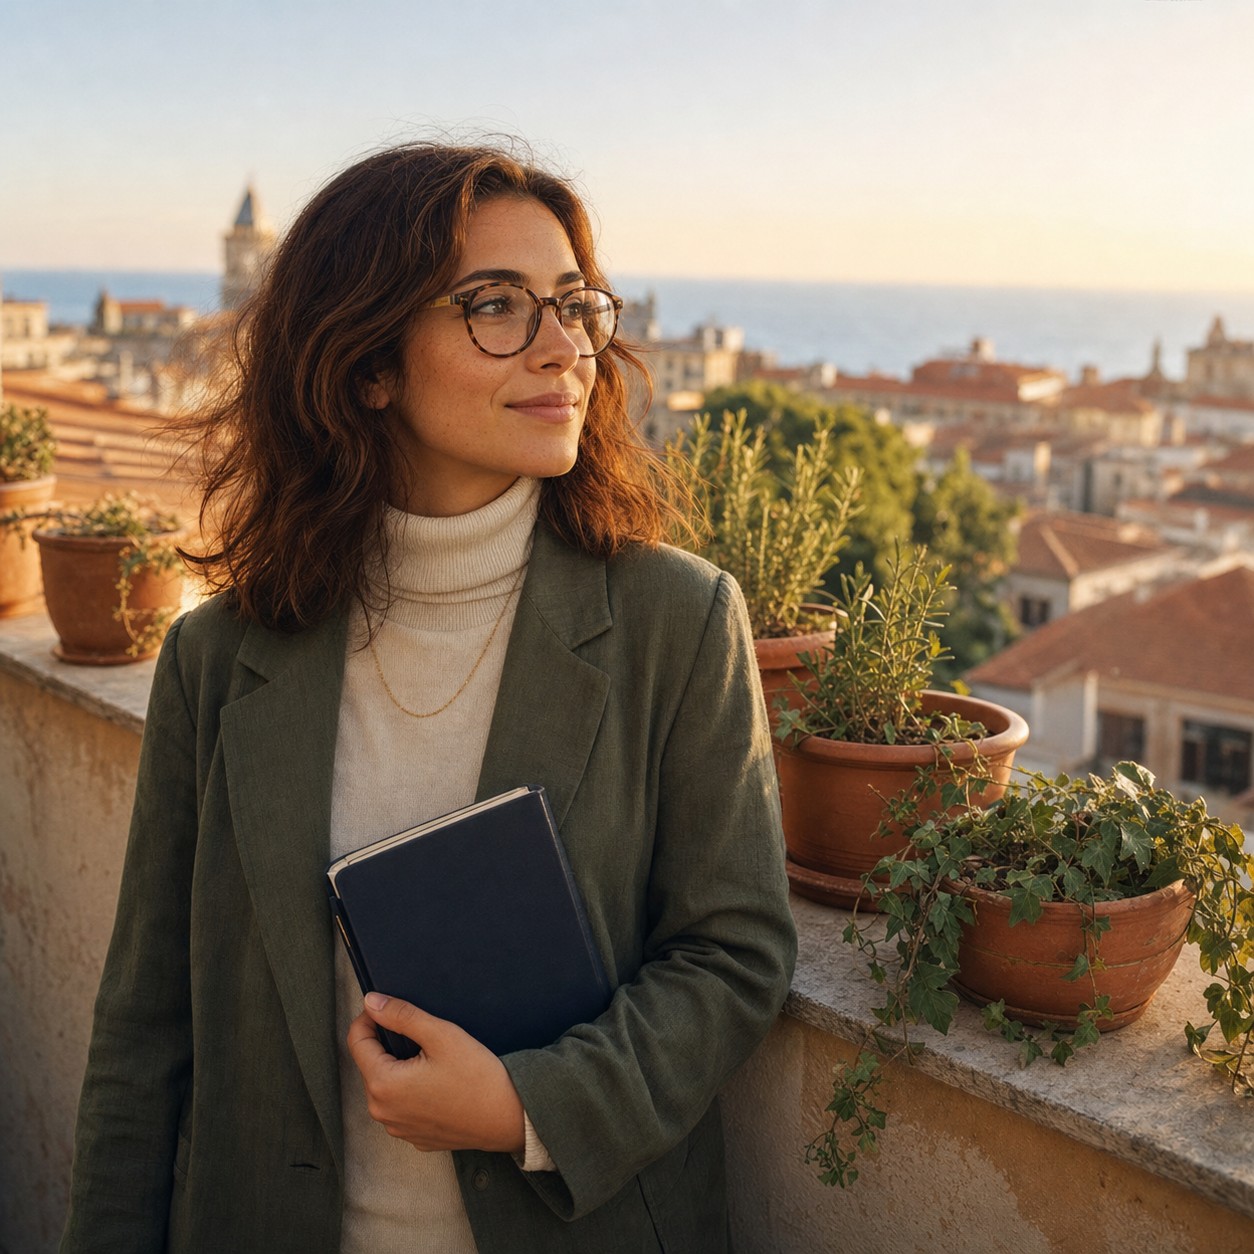
Forma del viso, lunghezza e colore dei capelli, occhiali, dolcevita, blazer, collana e persino il taccuino — tutto continua. Luce e tonalità cambiano con la scena, come dovrebbe essere; il soggetto no.
Alcune note pratiche per eseguire questo pattern su larga scala:
- Ancora ogni parte del corpo con tre o più caratteristiche correlate. Solo "capelli mossi castano-ramato scuro" va alla deriva. "Capelli mossi castano-ramato scuro alle spalle" più "occhiali rotondi tartarugati" due proposizioni dopo come ancoraggio aggiuntivo bloccano il volto più saldamente. Il modello tratta le caratteristiche co-occorrenti come un segnale di identità più forte di qualsiasi singola caratteristica.
- Metti la scheda personaggio in cima al prompt. La descrizione della scena va dopo, non prima. Il modello dà più peso all'identità del soggetto nei token iniziali.
- Termina ogni scena con lo stesso modificatore di stile ripetuto ("pellicola 35mm, profondità di campo ridotta, 1:1"). Questo fissa l'estetica del render e fa sì che le due chiamate non sembrino di due fotografi diversi.
Per serie brevi (da tre a dodici fotogrammi dello stesso personaggio), questo pattern raggiunge di solito oltre l'80% di coerenza al primo tentativo. È abbastanza buono per moodboard, illustrazioni per blog, serie social, campagne di marketing. Per lavori critici per il brand in cui ogni fotogramma deve corrispondere, passa alla capacità due.
Capacità due: modifica multi-turno con immagini di riferimento
La coerenza di stile tramite prompt ti avvicina. La variante image-to-image ti rende preciso. Gli dai un riferimento (da una a cinque immagini) e un prompt che descrive cosa cambiare — cambia quello, e lascia il resto com'è.
L'uso più comune è la sostituzione di scena su asset di brand: stesso prodotto, stessa sedia, stesso personaggio in ambienti diversi, con il soggetto preservato fedelmente al pixel e l'ambiente ridipinto attorno.
Immagine di riferimento — una poltrona scultorea in noce, su sfondo uniforme color crema, generata con gpt-image-2:
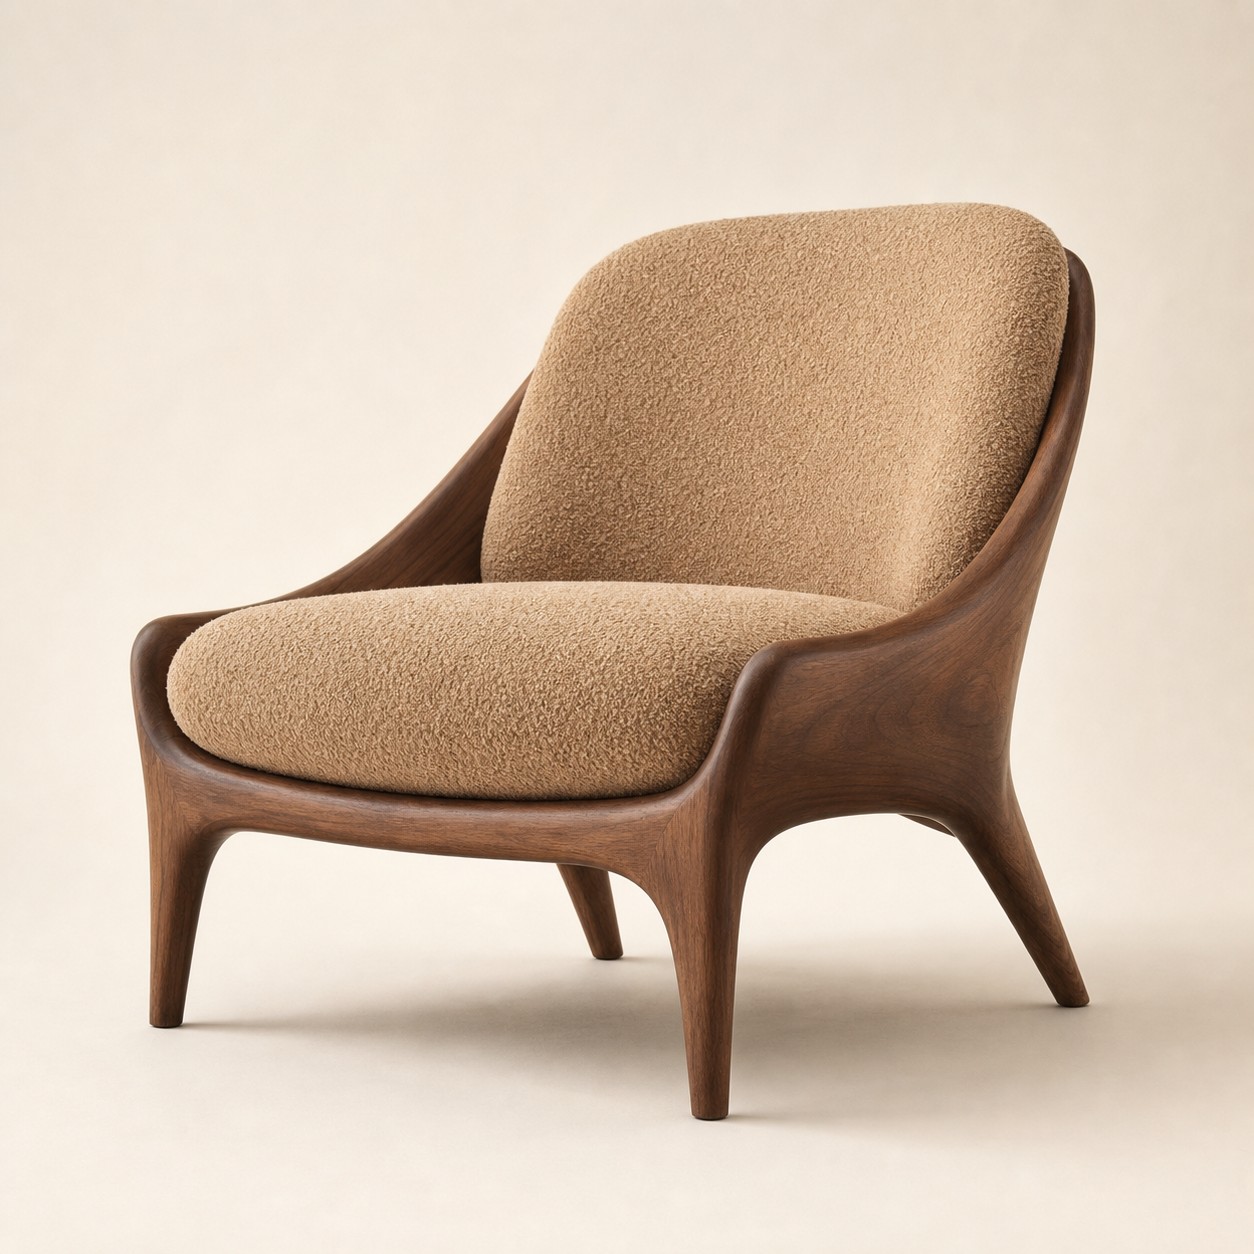
Ora invia esattamente quell'immagine a gpt-image-2/image-to-image con un prompt di sostituzione dell'ambiente:
Restilizza questa esatta poltrona in una scena d'interni editoriale ricca di luce,
senza cambiare la poltrona stessa: mantieni la forma della struttura in noce, il cuscino
in bouclé color cammello, le proporzioni delle gambe, la silhouette esatta fedele al pixel
identica. Sostituisci lo sfondo uniforme color crema con un angolo lettura caldo e
soleggiato: in alto a sinistra una grande finestra ad arco che proietta lunghe ombre
pomeridiane sul pavimento in ampie assi di quercia, a destra un piccolo tavolino rotondo
in frassino tinto scuro, sul tavolo un vaso in ceramica con tre spighe di grano
essiccato, una coperta in lino naturale piegata appoggiata su un bracciolo della
poltrona, sotto un tappeto vintage in stile berbero dai toni crema tenue e terracotta
sbiadita. Atmosfera di luce pomeridiana calda, aria leggermente
velata, fotografia d'interni da rivista, tonalità neutre abbinate.
Risultato — la stessa poltrona, una nuova stanza:
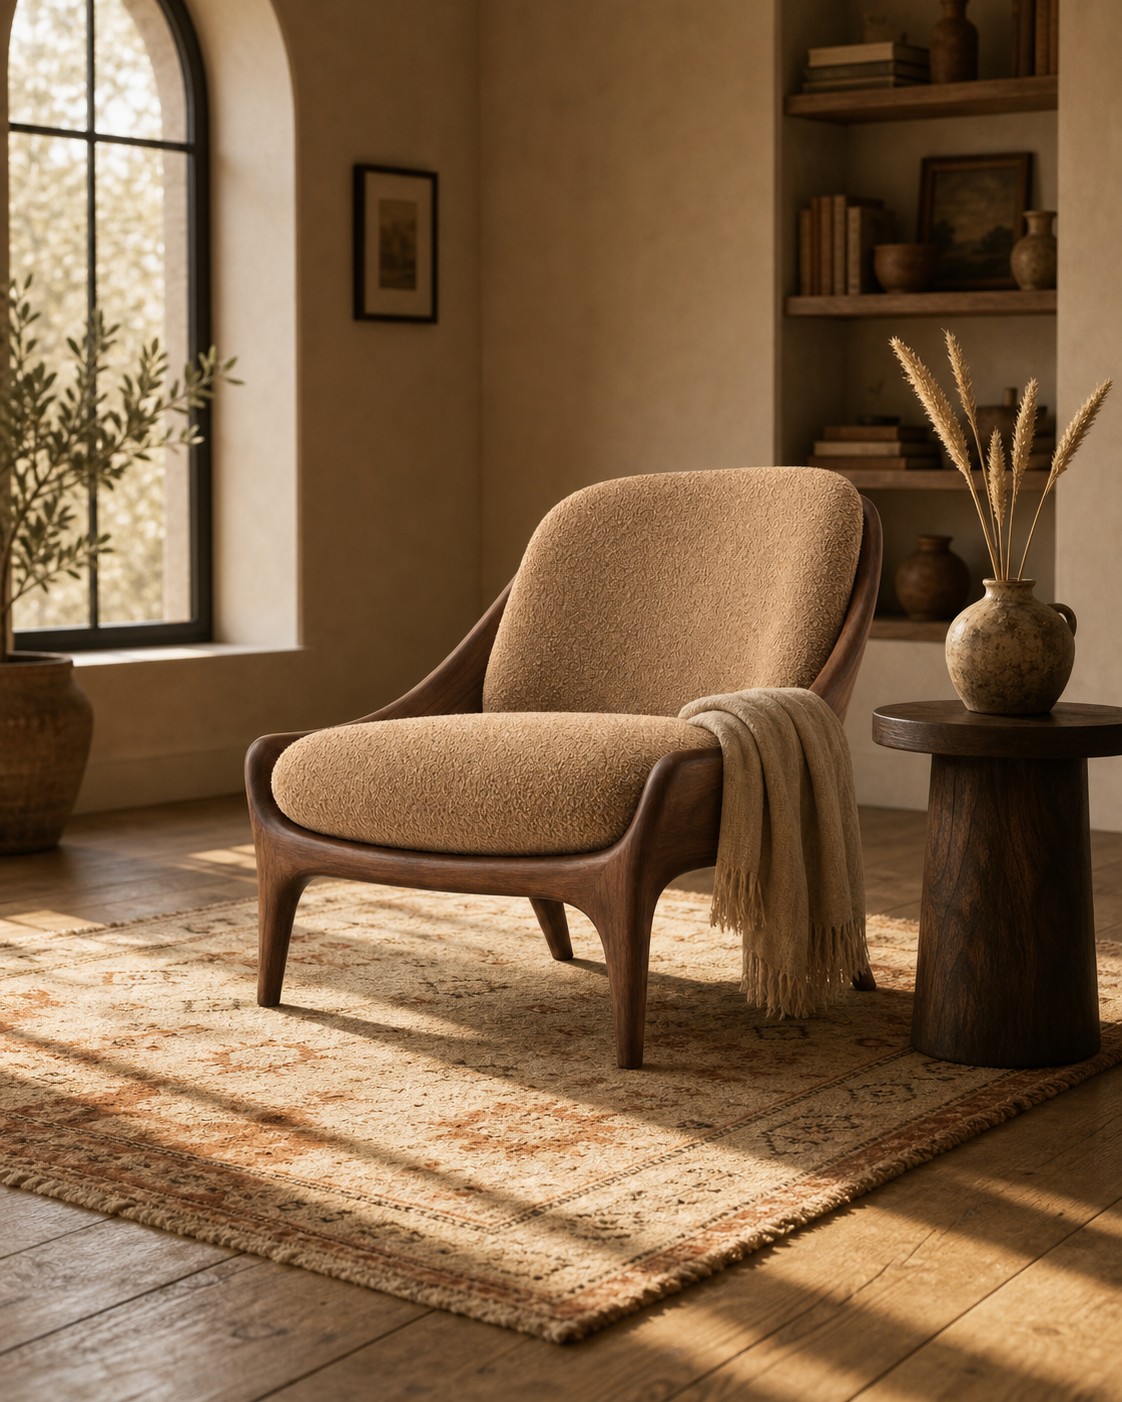
La forma della struttura, il tessuto del cuscino, la tonalità e la geometria delle gambe continuano in modo pulito. Lo sfondo uniforme è sparito; attorno a quell'elemento controllato dal brand è stato disegnato un ambiente completo.
In cosa eccelle la variante di modifica:
- Sostituzione di scena. Portare un soggetto isolato in un ambiente, o spostare un soggetto ambientato in un nuovo ambiente.
- Modifiche precise di attributi. "Cambia il tessuto del cuscino in velluto blu navy, tutto il resto identico" — funziona molto meglio che ri-promptare l'intera scena da zero.
- Ritocchi di composizione. "Stessa poltrona, stessa stanza, arretra la camera di un passo e aggiungi un cagnolino sulla coperta" — il modello modifica invece di ridisegnare.
- Restyling di asset di brand. Prendere una moodboard di campagna come riferimento e aggiungere un prompt che chiede tre varianti abbinate mantiene il tono meglio di tre prompt testuali indipendenti.
In cosa non eccelle (usa invece il text-to-image standard):
- Riscritture pesanti della composizione. Se oltre il 60% dell'inquadratura deve cambiare, è meglio partire da un nuovo prompt.
- Sostituzione del personaggio. Se intendi "la stessa poltrona ma una poltrona diversa", è un nuovo prompt, non una modifica.
Codice: due modelli, end-to-end
Entrambi i modelli rispondono su POST /v1/tasks. La chiamata text-to-image invia il prompt in input; la chiamata image-to-image aggiunge un array input_urls che trasporta da una a cinque URL di immagini di riferimento.
Text-to-image (gpt-image-2)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image",
    "input": {
        "prompt": (
            # Scheda personaggio per prima — i token iniziali portano l'identità.
            "A young woman in her late twenties, shoulder-length wavy "
            "dark-auburn hair, warm olive skin, soft freckles, "
            "tortoiseshell round glasses, cream wool turtleneck, thin "
            "gold chain, moss-green linen blazer. "
            # Scena per seconda.
            "She sits at a marble cafe table by a tall window, latte "
            "in a white ceramic cup, navy leather notebook open. "
            # Modificatore di stile per ultimo — fissa l'aspetto della serie.
            "35mm film, warm cafe interior, shallow depth of field, 1:1."
        ),
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-a.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Per una tela 2K, imposta "resolution": "2K". Il prezzo scala a 1,33× secondo la pagina dei prezzi live — la forma della chiamata è identica, $0.04 invece di $0.03.
Image-to-image (gpt-image-2/image-to-image)
import time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {HIAPI_TOKEN}"}

resp = requests.post(API, headers=HEADERS, json={
    "model": "gpt-image-2/image-to-image",
    "input": {
        "prompt": (
            "Restyle this exact chair into a warm sunlit reading "
            "nook: arched window upper left, oak plank floor, dark "
            "ash side table with dried wheat, Berber rug. Keep the "
            "walnut frame, boucle cushion, and silhouette IDENTICAL."
        ),
        "input_urls": ["https://your-cdn.example.com/chair-reference.png"],
        "aspect_ratio": "1:1",
        "resolution": "1K",
    },
}).json()
task_id = resp["data"]["taskId"]

while True:
    task = requests.get(f"{API}/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] in ("success", "fail"):
        break
    time.sleep(5)

open("scene-edited.png", "wb").write(
    requests.get(task["output"][0]["url"]).content)
Puoi trasportare fino a cinque immagini di riferimento nella stessa chiamata — aggiungi altri URL all'array input_urls. Il modello tratta i riferimenti come un piccolo contesto di stile/identità, poi applica la modifica specificata nel prompt. Nota che i riferimenti sono URL ospitati, non base64 inline — se il tuo riferimento è su disco, caricalo prima in una posizione accessibile (object storage, il tuo CDN) e passa il link.
Alcune note operative:
- Prevedi 60–120 secondi end-to-end a 1K; di più a 2K. Il flusso asincrono significa che nessuna connessione HTTP a lunga durata va in timeout — esegui il polling ogni pochi secondi, oppure imposta
callback.urlnella chiamata di creazione per far sì che hiapi faccia un POST allo stato finale. - Non bloccare l'handler della richiesta in attesa della generazione. L'API ti ha già dato un ID attività — rendi persistente il
taskIde lascia che un poller o una callback faccia il lavoro, invece di tenere aperta una chiamata serverless. - Due combinazioni di parametri da evitare nella variante di modifica:
aspect_ratio: "auto"(o omesso) è supportato solo con risoluzione1K, e1:1non può essere abbinato a4K. - Usa i riferimenti alla risoluzione di output che desideri. Inviare un riferimento 512×512 e richiedere un output 2K funziona, ma il modello ancora meno dettagli. Per modifiche fedeli al brand, invia i riferimenti alla dimensione di output target.
Quando usare quale (e cos'altro offre hiapi)
gpt-image-2 e il suo fratello image-to-image sono la scelta predefinita giusta quando hai bisogno di rendering del testo, coerenza di personaggio o prodotto su piccole serie, o modifiche precise di asset di brand. Non sono le uniche opzioni di immagine su hiapi, e la scelta tra loro conta più di quanto sembri:
| Esigenza | Modello | Motivo |
|---|---|---|
| Bozza iniziale da prompt, esplorazione | gpt-image-2 ($0.03) |
Il più economico della serie; il pattern scheda personaggio più scena ti porta lontano. |
| Modifica precisa / sostituzione di scena / restyling di brand | gpt-image-2/image-to-image ($0.03) |
Stesso prezzo, ma con ancoraggio al riferimento. La scelta giusta ogni volta che un output deve corrispondere a un asset esistente. |
| Tela marketing 4K ad alta fedeltà | gpt-image-2 4K ($0.06) |
La variante standard espone il livello 4K, moltiplicatore 2× pulito — il percorso più economico verso una tela grande. |
| Key visual di produzione, costoso da rigenerare | gpt-image-2-pro ($0.35) |
Il livello di stabilità della stessa serie, circa 10× il prezzo standard, per quella piccola parte di lavoro in cui un render sbagliato costa più di dieci render buoni. |
| Ritratto fotorealistico a soggetto singolo, senza modifiche | flux-1.1-pro ($0.05) |
FLUX 1.1 Pro su hiapi è lo specialista del realismo, quando non hai bisogno di rendering del testo o di modifiche multi-turno. |
| Modifiche in cui la velocità è critica, coerenza di personaggio su larga scala | Nano-Banana-2 ($0.085 a 1K) |
La variante Gemini 3.1 Flash Image di Google — caratteristiche di identità diverse, pattern di modifica simili, turnaround più rapido, al costo di un prezzo per chiamata più alto. |
La colonna dei prezzi nella tabella sopra proviene dalla pagina dei prezzi live della piattaforma — aggiornala prima di citare i numeri nelle tue stime interne.
Un pattern da copiare
Se hai una pipeline esistente che chiama gpt-image-2 una volta per richiesta, l'upgrade più economico è introdurre una seconda chiamata:
def render(job):
    # 1) Bozza iniziale dal prompt.
    draft = run_task("gpt-image-2/text-to-image", input={
        "prompt": job.prompt,
        "aspect_ratio": "1:1",
        "resolution": "1K",
    })

    # 2) Se il lavoro è critico per il brand o richiede sostituzione di scena,
    #    modifica la bozza invece di ri-promptare.
    if job.needs_edit:
        return run_task("gpt-image-2/image-to-image", input={
            "prompt": job.edit_instruction,      # cosa cambiare
            "input_urls": [draft.output_url],    # cosa preservare
            "resolution": "1K",
        })

    return draft
Due chiamate da $0.03 l'una, $0.06 in totale — comunque meno di una singola chiamata a gpt-image-2-pro ($0.35), e per la maggior parte dei lavori la seconda chiamata sostituisce tre o quattro cicli di scarto e ri-prompt. Più l'output deve essere fedele al brand, più questo calcolo conviene.
La versione breve
gpt-image-2 è il motore della bozza. gpt-image-2/image-to-image è l'editor. Usati insieme, coprono i workflow che la generazione di immagini a chiamata singola non riesce a coprire — serie di personaggi, restyling di asset di brand, modifiche precise di attributi — senza dover passare al livello Pro.
I due pattern con il miglior ritorno sono: (1) riusare alla lettera la scheda personaggio tra le scene per la coerenza di serie; (2) il flusso a due chiamate prima render poi modifica per qualsiasi lavoro in cui l'output debba sembrare un'estensione di un asset esistente. Entrambi si realizzano a $0.03 per chiamata sull'endpoint /v1/tasks di hiapi, e entrambi consegnano la stessa forma di payload dell'attività — una sola funzione worker copre la coppia.
Verifica i prezzi live, scrivi la scheda personaggio una volta, e lascia che l'editor faccia il lavoro che il ri-prompt non riesce a fare.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato