
Benutzerhandbuch
Qwen Image 3.0 Pro Image-to-Image-Prompts: direkt kopierbare Rezepte und echte Ergebnisse
Drei originelle Prompt- und Ausgabe-Rezepte für Produkt-, Innenraum- und Porträtbearbeitung – strukturell vollständig erhalten.
Zusammenfassung
- qwen-image-3.0-pro/image-to-image akzeptiert 1–3 Referenzbilder sowie einen Text-Prompt und bewahrt Strukturen (Produktumrisse, Raumaufteilung, Gesichter) besser als wiederholtes Neuziehen bei der reinen Text-zu-Bild-Generierung.
- Die drei folgenden, direkt kopierbaren Rezepte decken die drei Bearbeitungsbedürfnisse ab, die tatsächlich häufig gestellt werden: Produktfotos neu ausleuchten/neu inszenieren, Innenräume renovieren, ohne die Wände zu verschieben sowie Porträts neu stylen, während die Person erkennbar bleibt.
- Jeder Prompt hier wurde von uns selbst verfasst und tatsächlich ausgeführt – echte Vorher-Nachher-Vergleiche, keine Stock-Beispiele.
- Der Preis ist einheitlich und vorhersehbar: 1K pro Bild $0.0497, 2K pro Bild $0.0993, zusätzlich $0.004 pro übergebenem Referenzbild (1–3 Bilder erlaubt). Eine 1K-Bearbeitung mit einem Referenzbild wie unten kostet $0.0537.
- Das Modell verankert Geometrie und Identitätsmerkmale in deinem Referenzbild – es ist ein Editor, kein Neu-Erfinder. Wenn du möchtest, dass das Modell eine völlig neue Szene von Grund auf erschafft, verwende stattdessen qwen-image-3.0-pro/text-to-image.
Warum Image-to-Image und Text-to-Image unterschiedliche Werkzeuge sind
Text-to-Image liefert bei jedem Durchlauf ein neues Bild – selbst bei identischem Prompt ändert sich die Komposition. Für die Erkundung ist das in Ordnung, aber sobald du bereits ein Bild hast, das dir gefällt, und nur eine Stelle darin ändern möchtest – die Beleuchtung, die Raumgestaltung oder das Outfit derselben Person –, ist es das falsche Werkzeug.
Genau dafür ist Image-to-Image da. Du sendest ein vorhandenes Bild (bis zu drei) zusammen mit einem Prompt, der die Änderung beschreibt, an qwen-image-3.0-pro/image-to-image, und es bearbeitet das Bild in Richtung dieses Prompts, während es die Struktur des Referenzbilds verankert – die Produktumrisse bleiben gleich, die Wände und Fenster des Raums bleiben gleich, das Gesicht der Person bleibt gleich.
Wir haben drei konkrete Fehlermuster getestet, die bei Bildbearbeitungsmodellen häufig auftreten: verzerrte Produktproportionen, verschobene Wände beim Austausch von Möbeln und Gesichter, die sich unbemerkt in eine andere Person verwandeln. Das Folgende beschreibt, was tatsächlich passiert ist – mit echten Prompts und echten Ergebnissen.
Die drei Rezepte
Rezept 1: Produktfotos neu ausleuchten und neu inszenieren, ohne das Produkt zu verformen
Produktfotografie ist einer der fehleranfälligsten Image-to-Image-Anwendungsfälle – wenn sich bei einem Produktlistenfoto die Zifferblattproportionen zwischen der „Studio“- und der „Lifestyle“-Version verändern, fällt das Kunden sofort auf. Der Test hier lautet: Kann das Modell Beleuchtung und Hintergrund ändern, während das Produkt selbst unverändert bleibt?
Vorher – ein flach und gleichmäßig ausgeleuchtetes Studiofoto einer Armbanduhr auf weißem Hintergrund:
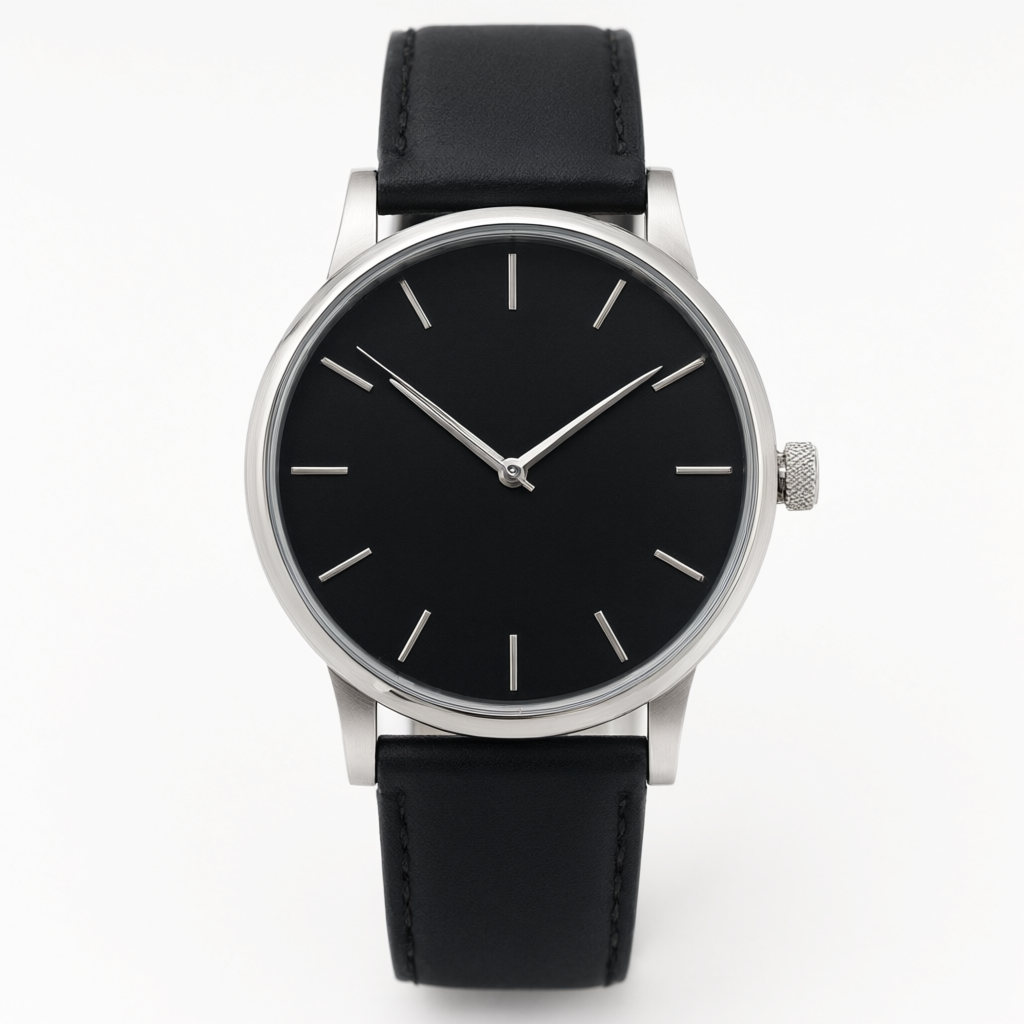
Quell-Prompt (Text-to-Image, nur als Referenz – dies ist das Ausgangsbild, keine Bearbeitung):
Studio product photography of a men's stainless steel wristwatch with a
navy blue dial, placed on a pure white seamless background. Even, flat
softbox lighting, no shadows, no reflections beyond a subtle catchlight
on the crystal. Straight-on angle, watch face centered, minimal styling,
e-commerce catalog style.
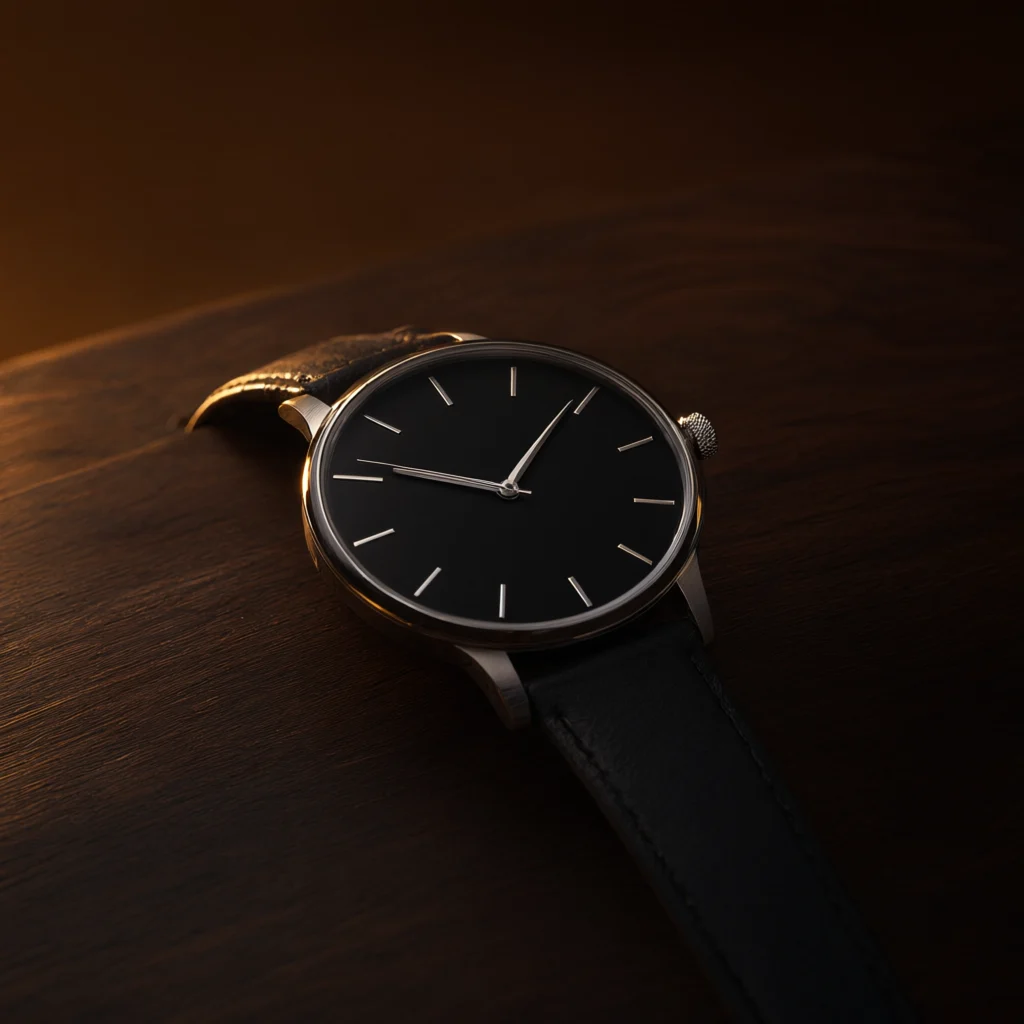
Nachher – dieselbe Armbanduhr, neu ausgeleuchtet als warme Lifestyle-Produktaufnahme und auf eine Walnussholz-Oberfläche versetzt:
Image-to-Image-Prompt (direkt kopierbar, image_urls: [<das obige Studiofoto>]):
Keep this exact watch — same case shape, same dial layout, same hands and
markers, do not redesign it. Move it onto a warm walnut wood surface,
shot at a slight 3/4 angle instead of straight-on. Change the lighting to
warm late-afternoon window light coming from the left, with a soft
natural shadow falling to the right. Add a subtle out-of-focus background
suggesting a cozy interior. This is a lifestyle e-commerce photo, not a
studio catalog shot — keep it photorealistic.
Erhalten geblieben: Gehäuseform, Zifferblattaufteilung, Zeigerstellung und Indizes sind unverändert – es ist offensichtlich dieselbe Armbanduhr, nur unter anderer Beleuchtung auf einer anderen Oberfläche. Das ist der Maßstab dafür, ob sich Produktfotos für echte Produktlisten bearbeiten lassen.
Rezept 2: Einen Raum neu einrichten, ohne die Architektur zu verschieben
Innenraum-Restyling ist der Layout-Erhaltungstest: Die Position von Fenstern, Türen und Wänden muss nach der Bearbeitung erhalten bleiben, sonst wirkt das „Nachher“-Foto wie ein anderer Raum statt wie derselbe Raum, neu eingerichtet.
Vorher – ein karger, minimalistischer Wohnraum:
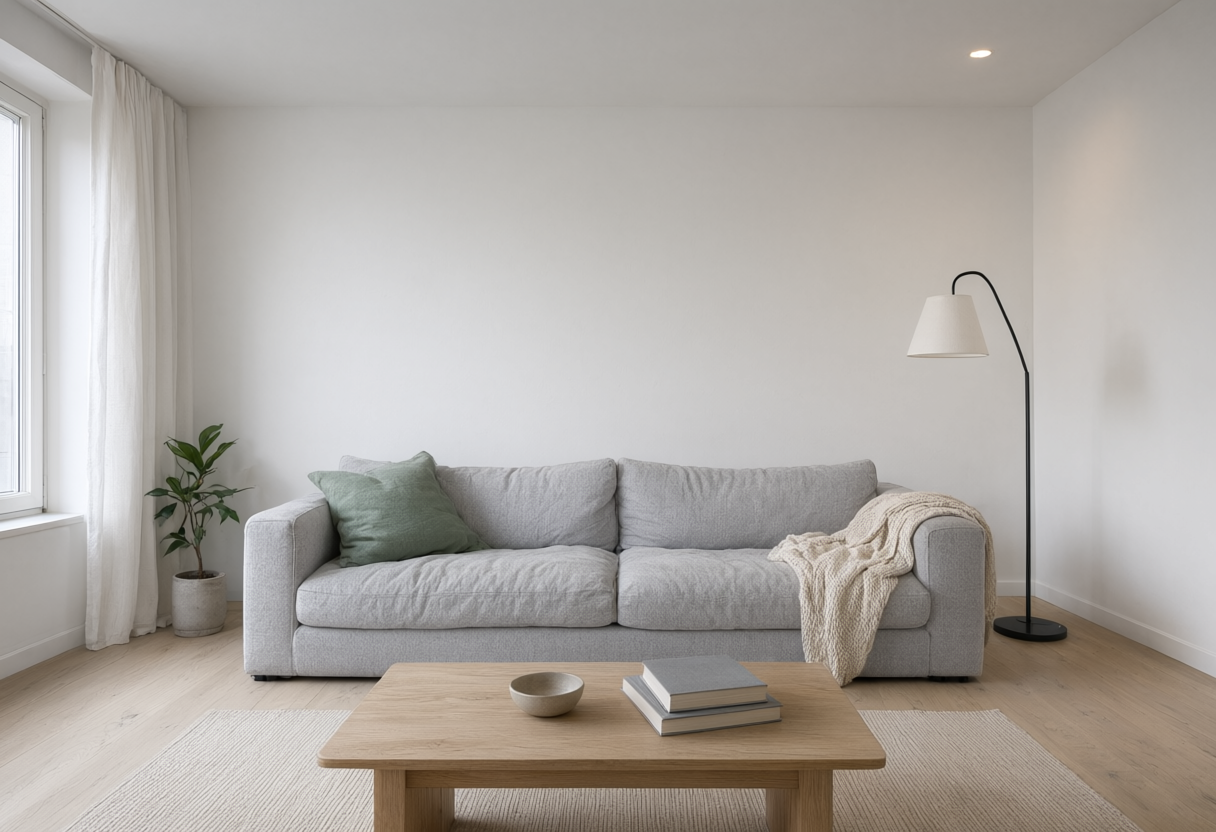
Quell-Prompt (Text-to-Image, nur als Referenz):
A minimalist living room interior, white walls, one large window on the
left wall with natural daylight, light wood flooring, a single gray sofa
and a small side table, mostly empty space, architectural photography
style, wide angle.
Nachher – derselbe Raum, neu gestaltet mit Mid-Century-Modern-Möbeln und wärmerer Farbpalette, Fenster- und Wandpositionen unverändert:
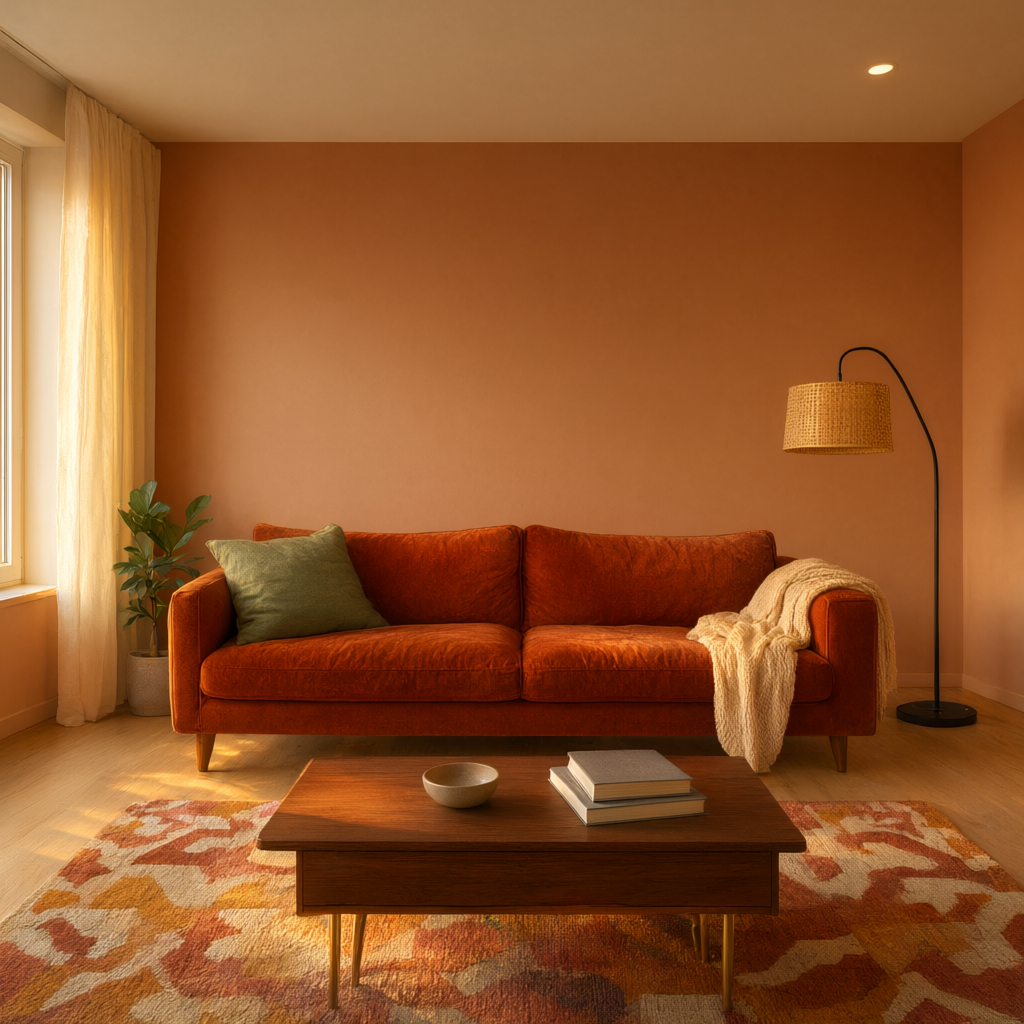
Image-to-Image-Prompt (image_urls: [<der obige minimalistische Raum>]):
Keep the exact room layout — same wall positions, same window on the
left in the same place, same floor. Redecorate it in a mid-century
modern style: replace the gray sofa with a walnut-legged sofa in burnt
orange fabric, add a round wood coffee table, a patterned area rug, and
warm brass floor lamp. Change the wall color to a warm terracotta.
Keep the window, the daylight direction, and the room's proportions
exactly as they are — only the furnishings and color palette change.
Erhalten geblieben: Das Fenster sitzt noch an derselben Wand, an derselben Stelle, und das Licht kommt aus derselben Richtung. Der Raum wirkt wie „derselbe Raum, neu eingerichtet“ und nicht wie ein neuer Raum, der zufällig dieselbe Farbpalette teilt – genau das macht solche Bearbeitungen für Immobilien-Homestaging oder Innenraum-Visualisierungen wirklich wertvoll.
Rezept 3: Ein Porträt neu stylen, während die Person erkennbar bleibt
Identitätserhalt ist der schwierigste der drei Fälle: Für das menschliche Auge sind feine Driftbewegungen eines Gesichts leichter zu erkennen als bei einem Raum oder einem Produkt. Dieses Rezept verwendet einen vollständig KI-generierten synthetischen Kopf (keine reale Person), sodass wir die Technik ohne Persönlichkeitsrechts- oder Einwilligungsprobleme zeigen können.
Vorher – ein synthetischer Kopf in einem schlichten grauen Hoodie vor neutralem Hintergrund:
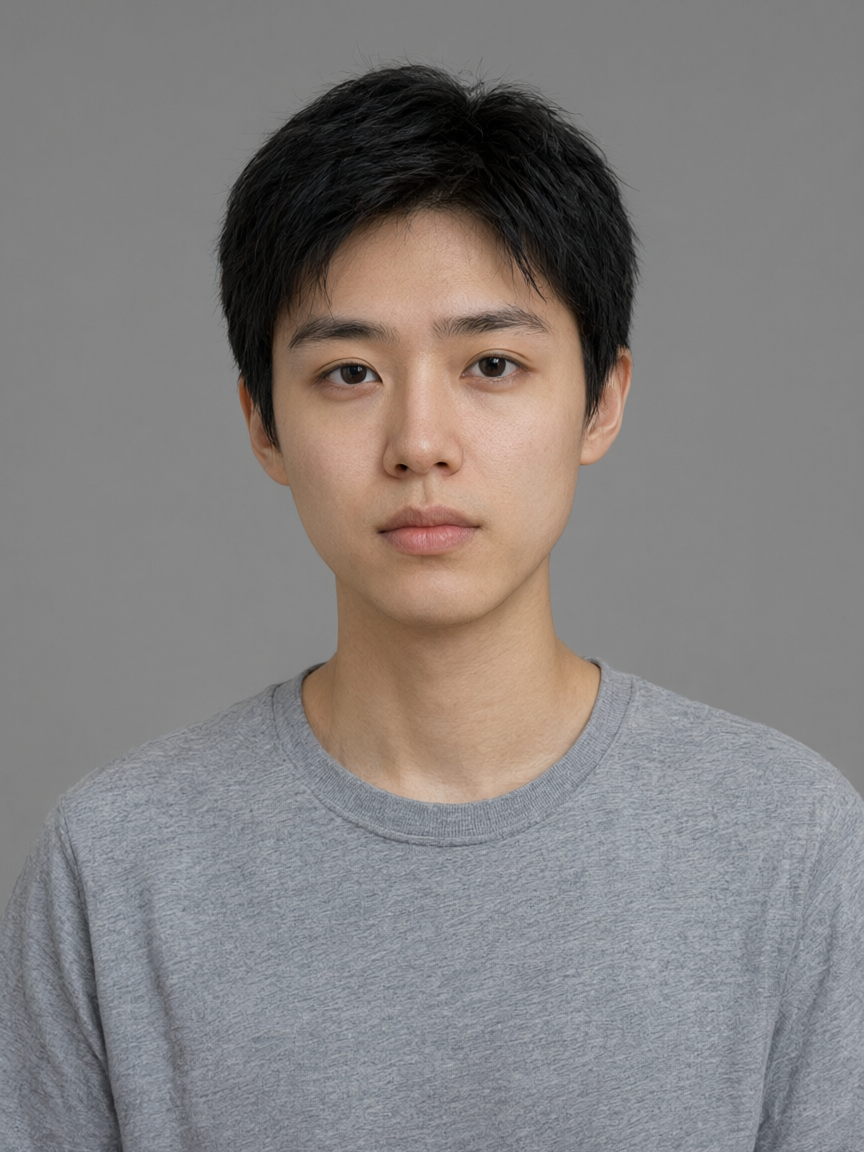
Quell-Prompt (Text-to-Image, synthetisches Motiv, nur als Referenz):
Photorealistic headshot portrait of a young adult with short dark hair,
neutral friendly expression, wearing a plain gray hoodie, soft even
studio lighting, plain light gray background, front-facing, shoulders
visible, high detail skin texture, professional photography.
Nachher – dasselbe Gesicht und dieselbe Pose, neu gestylt als professionelles Magazin-Porträt in Blazer vor einem unscharfen Bürohintergrund:
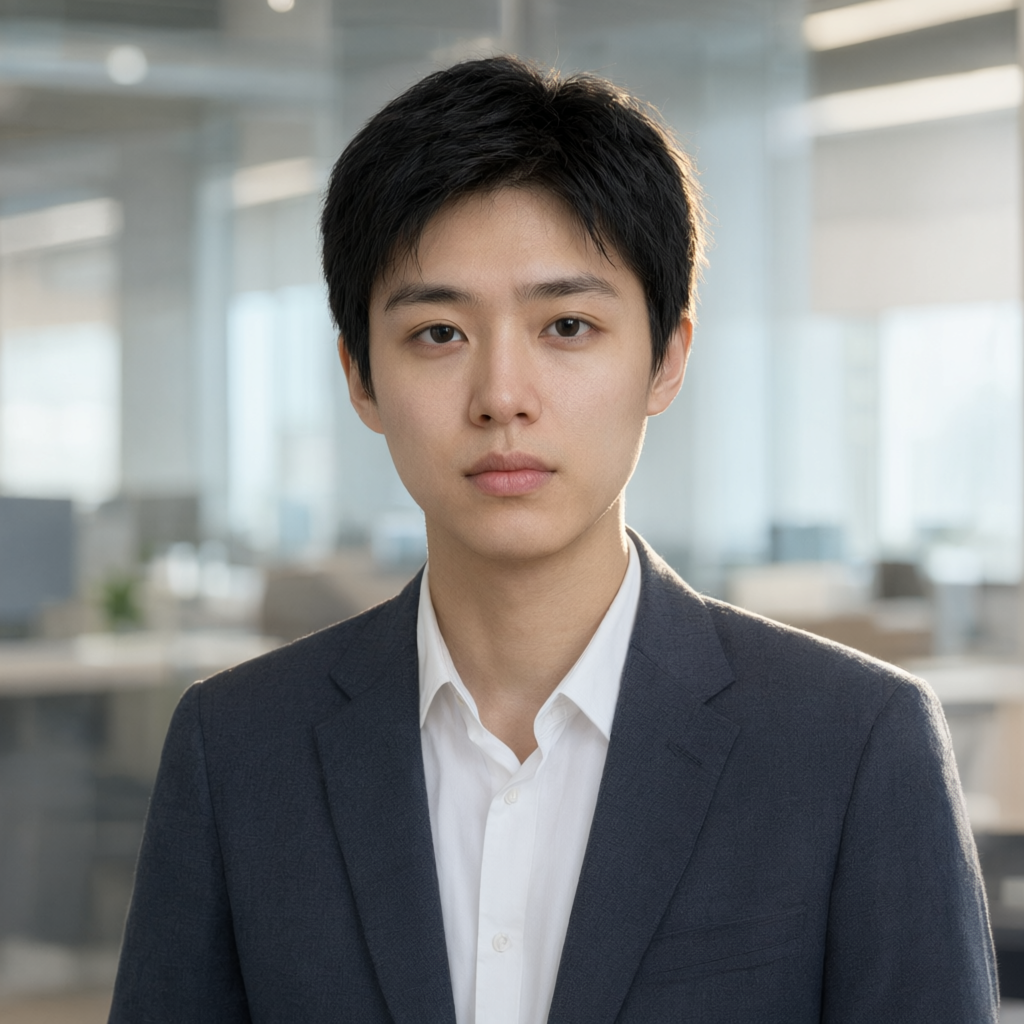
Image-to-Image-Prompt (image_urls: [<der obige Kopf>]):
Keep this exact person — same face, same facial features, same hairstyle,
same head angle and expression, do not change who this is. Change their
outfit to a tailored navy blazer over a white collared shirt. Change the
background to a softly blurred modern office interior. Add gentle rim
lighting from behind to give it an editorial magazine portrait mood.
Photorealistic, shallow depth of field.
Erhalten geblieben: Gesicht, Frisur und Kopfhaltung sind noch dieselbe Person wie im Quellbild – die Bearbeitung veränderte Kleidung, Hintergrund und Lichtstimmung, zeichnete das Gesicht aber nicht neu. Das ist der Unterschied zwischen einem Bild-Editor und einem Bildgenerator, der zufällig ähnlich aussieht.
Preise und Anfragestruktur
Alle drei oben beschriebenen Bearbeitungen verwenden dieselbe Anfragestruktur – ein Referenzbild, 1K-Auflösung:
curl https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-image-3.0-pro/image-to-image",
    "input": {
      "prompt": "Keep this exact watch — same case shape, same dial layout...",
      "image_urls": ["https://your-image-host.example/watch-source.jpg"],
      "resolution": "1K"
    }
  }'
Dies liefert eine Task-ID zurück; frage GET /v1/tasks/{id} ab, bis status den Wert success hat, und lade das Bild anschließend von output[0].url herunter (Links laufen ab, speichere sie sofort).
Preise zum Zeitpunkt dieses Artikels (prüfe vor größeren Budgets die Preisseite von hiapi, da sich Preise ändern können):
| Auflösung | Preis pro Bild |
|---|---|
| 1K | $0.0497 |
| 2K | $0.0993 |
Darüber hinaus erhöht jedes Referenzbild, das du in image_urls übergibst (1 bis 3 erlaubt), den Preis um $0.004. Die drei oben beschriebenen Bearbeitungen verwenden jeweils genau ein 1K-Referenzbild, sodass jede $0.0497 + $0.004 = $0.0537 kostet.
Falls du zwischen den Auflösungen schwankst: 1K reicht für Web und Social Media; wenn die Ausgabe für Druck oder große Key-Visual-Banner verwendet wird (wo Skalierungsartefakte sichtbar werden), lohnt es sich, für 2K pro Bild $0.05 mehr zu zahlen.
Häufig gestellte Fragen
Kann ich mehrere Referenzbilder gleichzeitig verwenden?
Ja – image_urls akzeptiert 1 bis 3 Bilder. Die drei oben beschriebenen Rezepte verwenden jeweils ein einziges Referenzbild, was für den Modus „dieses eine Bild bearbeiten“ ausreicht. Mehrere Referenzbilder sind nützlich, wenn du möchtest, dass das Modell Elemente aus mehreren Quellbildern in einer einzigen Bearbeitung zusammenführt.
Kann es Bilder verarbeiten, die nicht vom Modell selbst generiert wurden?
Ja – image_urls verlangt nicht, dass das Referenzbild von Qwen Image stammt. Jede erreichbare Bild-URL kann als „Vorher“-Bild dienen; die Rezepte oben verwenden zufällig Quellbilder von Qwen Image 3.0 Pro, allein damit sich die gesamten Vorher-Nachher-Vergleiche in diesem Artikel innerhalb derselben Modellfamilie reproduzieren lassen.
Was, wenn ich ein völlig neues Bild statt einer Bearbeitung möchte? Verwende stattdessen qwen-image-3.0-pro/text-to-image – dieselbe Preisstufe, kein Referenzbild nötig. Wenn du deine API-Integration zum ersten Mal einrichtest, geht unser qwen-image-3.0-pro API-Leitfaden tiefer auf die Anfragestruktur mit curl und Python ein.
Warum verwendet das Porträt-Rezept ein synthetisches Gesicht statt eines echten Fotos? Um den Identitätserhalt ohne jegliche Persönlichkeitsrechts- oder Einwilligungsprobleme zu demonstrieren. Die Technik – zuerst beschreiben, was unverändert bleiben soll, dann die Änderung – funktioniert bei echten Fotos genauso gut.
Wichtigste Erkenntnisse
- Jeder Image-to-Image-Prompt nennt zuerst, was gleich bleiben soll (Form, Layout, Identität), und beschreibt dann, was sich ändern soll – das ist das wirksamste Mittel, um die Struktur über die gesamte Bearbeitung hinweg zu erhalten.
qwen-image-3.0-pro/image-to-imageakzeptiert 1–3 Referenzbilder zu je $0.004, zuzüglich des einheitlichen Grundpreises pro Bild von $0.0497 (1K) / $0.0993 (2K).- Es ist ein Bearbeitungswerkzeug, kein Neu-Zieh-Werkzeug – wenn du eine völlig neue Komposition statt einer Änderung an einer bestehenden möchtest, verwende qwen-image-3.0-pro/text-to-image.
Bereit, diese Prompts mit deinen eigenen Bildern auszuprobieren? Hole dir einen API-Schlüssel und führe deine erste Bearbeitung im hiapi-Kontrollpanel aus – derselbe /v1/tasks-Endpunkt, der oben verwendet wurde, funktioniert direkt mit deinen eigenen Referenzbildern.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
seedream-5.0-pro/image-to-image Erste-Schritte-Leitfaden: Fähigkeiten, Preise und Integrationspunkte
Fähigkeitsgrenzen, Abrechnungsmodell und Engineering-Integration des Bildbearbeitungsmodells von ByteDance
-

Benutzerhandbuch
seedream-5.0-pro Text-zu-Bild Einstiegsleitfaden: Fähigkeitsgrenzen, API-Integration und Kostenkontrolle
Praxisorientierte Perspektive für Entwickler: von den wichtigsten Parametern bis zur Kostenschätzung von $0,05 pro Bild
-

Benutzerhandbuch
Hailuo 2.3 Fast Bild-zu-Video-Anleitung: Grenzen der Leistungsfähigkeit, Preisgestaltung und Integration in die Praxis
MiniMax Bild-zu-Video-Modell für Entwickler: Auswahlkriterien und Integrationspunkte