
使用ガイド
ElevenLabs Text to Dialogue 使用ガイド:dialogue 配列で2人の対話音声を送信する
2人の台本分割から1行ごとの音声リクエストまで、現在の HiAPI 契約に沿って送信・検収する
このページの内容
まず、必要なのが対話合成であって単発の読み上げではないことを確認する
素材が2人(または複数話者)の対話台本である場合、最も安易な方法は各セリフを個別に合成し、順番に結合することです。この方式の問題は納品段階になって初めて現れます。各セリフが独立した音声になるため、発話間の間(ポーズ)、話速のつながり、声質の一貫性を結合層でもう一度補う必要があります。話者が増えるほど、結合順序や声質の不一致が主なバグの発生源になります。
elevenlabs/text-to-dialogue の位置づけは1回のリクエストで対話全体を表現することです。台本全体を dialogue 配列に分割して送信すると、モデルが同じ生成の中で複数音声の対話を完結させ、出力は1本の完全な音声になります。「複数回の単発合成+結合」と比べて、話者マッピングと行順をリクエストボディに収めるため、検収時には1つの結果を確認するだけで済みます。
したがって、まず次の判断を行います。
- 内容が同一話者の連続読み上げであれば、テキスト読み上げを使えばよく、
dialogue配列は不要です。 - 内容が2人以上の話者が交代する対話であり、全体の聴感を統一したい場合は、本インターフェースの
dialogue配列を使用します。 - 内容が対話だが総文字数が上限を大きく超える場合は、意味に基づいて区切り、分割して送信する必要があり、セリフ単位の合成に戻すべきではありません。
2番目の種類に該当すると判断したら、次に配列そのものの構造を把握します。
dialogue 配列の構造:各行の text と voice
HiAPI の契約において、elevenlabs/text-to-dialogue の入力の中核は必須フィールドが1つだけです。dialogue です。これは配列で、最低1項目必要であり、各要素は1行の対話を表し、2つの必須サブフィールドを含みます。
text:その行のセリフのテキスト。文字列で、最低1文字必要です。voice:その行で使用する音声。文字列で、プリセット音声名またはvoice_idを指定でき、デフォルトはEkK5I93UQWFDigLMpZcXです。
どちらのフィールドも必須です。デフォルト音声を使いたいだけでも、voice を明示的に記述してリクエストボディを自己説明的にすることをおすすめします。最小限の2人対話リクエストの形式は次のとおりです。
{
  "dialogue": [
    { "text": "そちらの進捗はいかがですか?", "voice": "EkK5I93UQWFDigLMpZcX" },
    { "text": "今週中に初版をお出しできます。", "voice": "Z3R5wn05IrDiVCyEkUrK" },
    { "text": "わかりました。では先に検収チェックリストをお送りします。", "voice": "EkK5I93UQWFDigLMpZcX" }
  ]
}
配列の順序がそのまま対話順であることに注意してください。インターフェースには「話者」という追加フィールドはなく、話者は完全に voice で区別されます。これは接続作業全体の中で最も事前に設計すべき点です。
2人の台本を1行ずつの項目に分割する
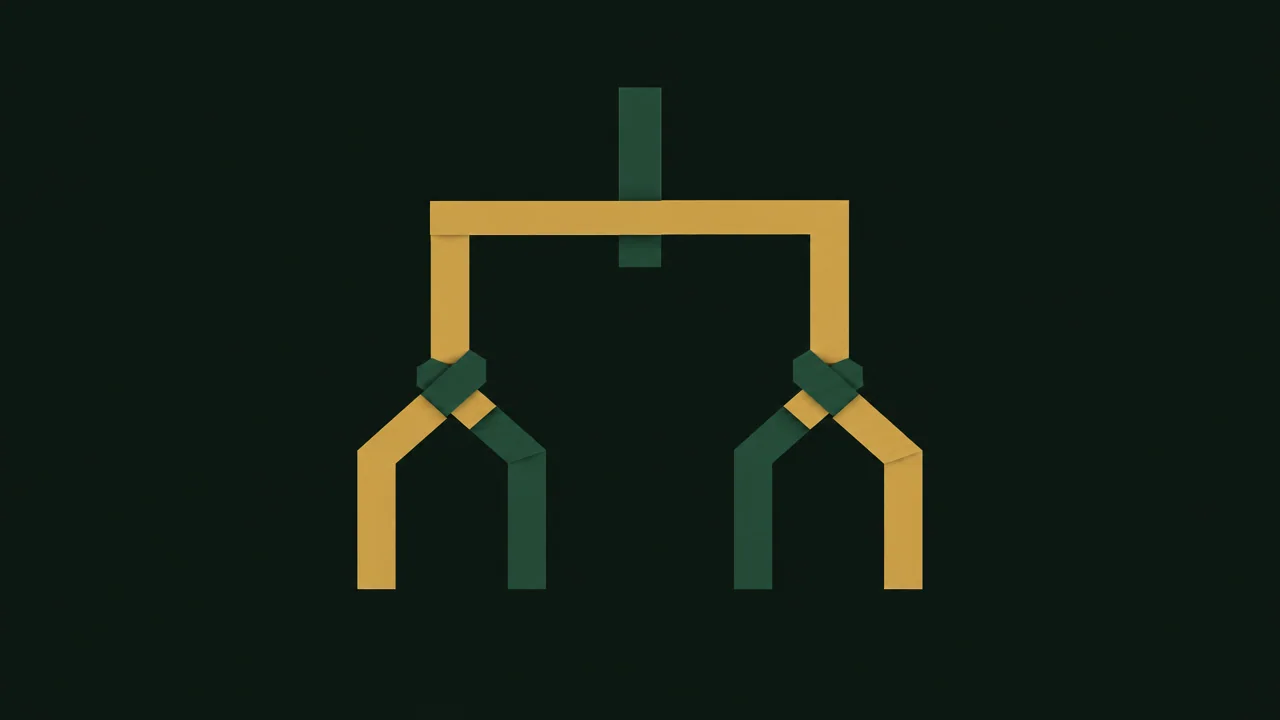
台本テキストから dialogue 配列へは、固定のパイプラインで処理することをおすすめします。手書きの JSON によるミスを避けられます。
ステップ1:行ごとに分割し話者を注釈する
台本を「話者+セリフ」のペア構造に整理し、1行1項目にします。2人の話者のセリフを同じ text に結合しないでください。1つの要素には1つの voice しか紐づけられないため、結合すると話者を区別できなくなります。ナレーションや括弧内のト書きはセリフではないため、別途除外し、text に詰め込まないでください。
ステップ2:テキストをクレンジングする
1件ずつ確認します。前後の空白を除去し、句読点と改行を統一し、空行を削除します。text の最短長は1文字の制約があり、空文字列は即座にバリデーション失敗を引き起こします。ある行が「うん」「はい」のような相づちだけの場合はそのまま残して構いませんが、クレンジング後に空文字列になる場合は、その行を削除するかどうかをコンテンツ側と確認してください。
ステップ3:話者マッピングを定義し配列を生成する
各話者ラベルを一意の音声にマッピングし、行順に要素を生成します。疑似コードはおおよそ次のとおりです。
speaker_voice = {
    "A": "EkK5I93UQWFDigLMpZcX",
    "B": "Z3R5wn05IrDiVCyEkUrK",
}

dialogue = [
    {"text": line.text, "voice": speaker_voice[line.speaker]}
    for line in script
]
よくある落とし穴
- 同じ話者が2か所で異なる音声を使うと、聴感が明らかに分断されます。
voiceの記述漏れにより全体がデフォルト音声にフォールバックし、2人の対話が「一人二役」になります。- 配列の順序がソートや重複排除のロジックで崩され、対話の意味が断裂します。
生成後はまず先頭の数要素を出力して人力で確認し、その後に文字数予算の段階へ進みます。
音声マッピングの固定:同じ話者には1つの voice だけを使う
voice を「固定」すべきなのは、それが音声そのものを決めるだけでなく、「誰が話しているか」という意味も担っているからです。同じ話者が対話全体の中で2つの異なる voice 値を持つと、聴き手は話者が変わったと認識します。逆に、2人の話者が同じ voice に衝突すると、対話の区別が失われます。
実践的には、各行のセリフに文字列リテラルを散らばせるのではなく、コード内に話者から音声への定数マッピング表を維持することをおすすめします。
const VOICE = {
  host: "EkK5I93UQWFDigLMpZcX",
  guest: "Z3R5wn05IrDiVCyEkUrK",
};
すべての行はこの表からのみ値を取得するため、台本の改行や並べ替えによって一貫性が壊れることはありません。voice はプリセット音声名または voice_id をサポートします。チーム独自の音声命名体系が既にある場合は、設定層で一度変換し、リクエスト時にはインターフェースが認める値に統一してください。契約には音声の列挙が示されているため、送信前に列挙で一度バリデーションすれば、スペルミスのような単純な問題を防げます。列挙外の値が黙ってデフォルト値として扱われることはありません。
もう1つ見落とされがちな点は段落をまたぐ安定性です。総文字数が上限を超え、複数回のリクエストに分割する必要がある場合、音声マッピング表はそのまま再利用し、新しいリクエストで音声を選び直さないでください。そうしないと、同じ話者が段落ごとに異なって聞こえます。
文字数予算とリクエスト分割
インターフェースには量に関する厳格な制約が1つあります。dialogue 配列内のすべての text フィールドの文字数の合計は5000を超えてはなりません。配列内の全テキストの合計であり、1行の長さでも要素数でもないことに注意してください。中国語、英語、句読点は通常すべて文字としてカウントされるため、見積もり時は最も広い基準で余裕を確保するのが安全です。
カウントロジックは配列生成後、リクエスト送信前に記述します。
total = sum(len(item["text"]) for item in dialogue)
assert total <= 5000
上限を超える場合、正しい方法は意味の境界で分割して複数のサブ対話とし、それぞれ送信してそれぞれ音声を取得し、業務の必要に応じて組み合わせることです。セリフを切り詰めたり削除したりしてはいけません。分割時には次の3点に注意してください。
- 分割点はシーン切り替えや話題転換の箇所を選び、一問一答を2回のリクエストに分けないようにする。
- 各サブフラグメントは個別にカウントし、同様に5000を超えないようにする。
- 分割後の各フラグメントで配列を再構築する際、元の行順と話者音声マッピングを維持する。
内容自体が長い対話である場合は、コンテンツ側で「幕」や「章」ごとに組織し、各幕が自然に予算内に収まるようにすると、一時的な分割による聴感の断絶を減らせます。
オプションパラメータ:stability と language_code
dialogue 以外に、インターフェースには2つのオプションパラメータがあり、取捨選択はコンテンツの種類によって決まります。
stability
stability は数値パラメータで、0、0.5、1を取ることができ、デフォルトは0.5です。意味は音声の安定性です。
- 値が小さいほど感情が豊かで変化が多くなり、感情の起伏がある対話やドラマ系のコンテンツに適しています。
- 値が大きいほど出力が安定して一貫し、ブランド告知やカスタマーサポートのトークスクリプトなど、統一した聴感が求められる場面に適しています。
- デフォルトの0.5は両者の中間の妥協点です。
これはリクエスト全体レベルのパラメータであり、行ごとに設定するものではないことに注意してください。同じ対話の中で話者の感情差が大きい場合は、妥協値を1つ受け入れるか、段落を分割する際に異なるフラグメントで異なる stability を使用するかのどちらかです。
language_code
language_code は ISO 形式の言語コードで、デフォルトは空文字列です。空のままにすると言語を自動検出することを意味します。コンテンツの言語が明確で、検出の偏りを避けたい場合は、明示的に指定する方が確実です。たとえば中国語のコンテンツには zh を設定します。契約には完全な言語コードの列挙が示されているため、送信前に一度バリデーションを行い、サポートされない値の投入を避けてください。
どちらのパラメータも必須ではありません。コンテンツに特別な要件がなければ、これらを省略してデフォルトの動作を使用してまったく問題ありません。
送信と検収:タスク形式の契約に沿って確認する
このインターフェースはタスク形式で送信します。入力を送信し、タスク結果を取得し、その結果を中心に検収を行います。これは2つのことを意味します。
第一に、入力契約は自分でバリデーションする必要があります。リクエスト送信前に項目ごとに確認します。dialogue が配列で少なくとも1項目あること。各項目に空でない text と voice が同時に存在すること。すべての text の文字数合計が5000を超えないこと。stability が0/0.5/1のみであること。language_code が列挙に含まれるか空であること。これらのチェックをクライアント側に置くことで、無効な送信を大幅に減らせます。
第二に、契約で宣言されていない動作を仮定しないこと。インターフェースドキュメントは自動リトライ、冪等キー、失敗補償を約束していないため、「同じリクエストを繰り返し送信する」ことでフォールバックしてはいけません。各送信は独立したタスクとして扱うべきです。エンジニアリング上安全な方法は次のとおりです。
- 送信前に今回のリクエストの入力サマリ(配列の項目数、文字数合計、音声マッピングのバージョン)を記録し、事後の比較に備える。
- 結果を取得したら、まず音声が利用可能で、長さが妥当で、話者が区別できることを確認してから下流に配布する。
- 再実行が必要な場合は、検証済みでない古いリクエストボディを再利用するのではなく、完全な入力バリデーションをもう一度通す。
検収の重点は「結果が期待どおりかどうか」であり、サーバー側の内部プロセスを推測することではありません。HiAPI では、elevenlabs/text-to-dialogue モデルページ から現在の契約を確認してから作業を始められます。
リリース前のセルフチェックリスト
次の一連のチェックを送信前の自動フローとして固定すれば、ほとんどの失敗原因をカバーできます。
dialogueが配列で、要素数が1以上である。- 各要素が
textとvoiceの両方を含み、どちらも空文字列でない。 - 各
voiceが契約の列挙に含まれ、同じ話者には全体で同じ値のみを使用している。 - 配列の順序が台本の行順と一致し、ソートや重複排除のロジックが介在していない。
- すべての
textの文字数合計が5000以下で、超過分は意味に基づいて分割済みである。 - 明示的に設定する場合、
stability∈ {0, 0.5, 1}、language_code∈ 列挙または空である。 - 入力サマリ(項目数、文字数、マッピングのバージョン)が記録され、検収時の比較が容易である。
チェックリスト以外にも経験則があります。まず短いサンプルでエンドツーエンドを通し、その後で台本全体に拡大することです。話者マッピングと文字数予算という2種類の問題は、数十行のサンプルで露呈するため、コンテンツ全体を送信してから初めて気づく必要はありません。


