
使用ガイド
GLM 5.3 構造化抽出の実践:すべての JSON フィールドに原文根拠を持たせる
JSON オブジェクトモードでフィールド抽出を行い、欠損値・引用・業務検証で誤りをデータベース投入前に食い止める

このページの内容
構造化出力に「原文根拠」が必要な理由
JSON オブジェクトモード(response_format: {"type": "json_object"})が解決するのは「出力形式が JSON オブジェクトかどうか」という問題であり、「今回のリクエストが必ず成功し、内容が必ず完全で、パースが必ず例外を投げない」ということではありません。リクエストは失敗する可能性があり、モデルは回答を拒否する可能性があり、出力は長さ制限で切り詰められる可能性があり、ストリーミング転送は中断する可能性があり、返却内容が不完全だったり壊れていたりする可能性もあります。クライアントはこれらの状況および json.loads のパース例外を処理しなければなりません。まずレスポンスが正常に完了し、内容が完全であることを確認してから、パースに進む必要があります。パースできても使えるとは限りません。形式が正しいことは事実が正しいことを意味しません。フィールドの値が原文から抽出されたものか、モデルがついでに補完してしまったのか、あるフィールドが「原文に書かれていない」のか「原文に空で書かれている」のかは、形式制約の範囲外です。
フィールドテンプレートをプロンプトに書き込むことは、本質的にモデルに「記入用テンプレート」を渡すことであり、「証拠リスト」を渡すことではありません。フィールドに原文の裏付けがない場合、モデルはもっともらしい値を出しがちです。これは抽出タスクにおいて最も危険な失敗パターンです。なぜならエラーを報告せず、静かに下流データを汚染するだけだからです。
したがって本記事の抽出契約は三つの部分から構成されます。フィールドと型の定義、各値に付随する原文引用、そして明示的な欠損値のモデリングです。この三つを合わせることで、「この文はどこから来たのか」を事後の推測ではなく出力の一部にします。
抽出契約の設計:フィールド、型、null 許容の約束
契約はフィールド一覧から始まります。タスクが求人・協業の説明文から構造化情報を抽出することだと仮定し、まず対象フィールドを固定します:
title:文字列、必須budget:数値、null 許容deadline:文字列(ISO 日付)、null 許容contact:文字列、null 許容skills:文字列配列、空配列可
重要なのは「null 許容」が「省略可能」ではないことです。すべてのフィールドは出力に必ず出現し、不明な場合は明示的に null または空配列を指定し、キーの省略は許しません。キーを省略すると、下流は「モデルが空と判断した」のか「モデルがそのフィールドをまったく処理していない」のかを区別できなくなります。
型も機械的に判定できる粒度まで厳密にします。budget は数値のみを受け付け、"応相談" のような文字列は受け付けません。deadline は YYYY-MM-DD 形式と約束します。skills は文字列配列でなければならず、カンマで連結した単一文字列でごまかすことは許しません。型が具体的であるほど、後述の検証層が問題を食い止められます。
以下はプロンプトに書き込むフィールド説明であり、リクエストパラメータではありません。リクエストパラメータは JSON オブジェクトモードを有効にする役割だけを担います。
JSON オブジェクトを出力し、以下のキーを必ず含めてください(それ以外は含めない):
- title: string
- budget: number | null
- deadline: string (YYYY-MM-DD) | null
- contact: string | null
- skills: string[]
すべてのキーが必須です。原文から確定できない場合は null(配列は空配列)を設定し、推測しないでください。
各フィールドに引用断片を持たせる
値だけを与えて出所を与えないことは、追跡能力を放棄するのと同じです。方法は、抽出対象の各フィールドを値と引用が同時に出るペア構造に変えることです。
{
  "title": {"value": "データ分析インターン", "evidence": "データ分析インターンを2名募集"},
  "budget": {"value": 300, "evidence": "日給300元"},
  "deadline": {"value": null, "evidence": null},
  "contact": {"value": "hr@example.com", "evidence": "履歴書は hr@example.com まで"},
  "skills": [
    {"value": "SQL", "evidence": "SQL に精通していること"},
    {"value": "Python", "evidence": "Python ができる方優遇"}
  ]
}
いくつか要点があります。第一に、evidence は原文の連続した断片を要求し、モデルによる言い換えや要約ではありません。言い換えは引用の照合価値を失わせます。第二に、値が null のとき evidence も null でなければなりません。この制約自体がある程度の捏造を抑えられます。モデルが値をでっち上げた場合、通常は対応する原文断片を作れず、形式的に自己矛盾するからです。第三に、配列フィールドは要素ごとに引用を与え、配列全体に一つの引用を与えません。そうしないと一つの誤った要素がグループ全体の信頼性を汚染します。第四に、引用断片はできるだけ短くし、その値を支える最小限のテキストだけをカバーして、後の文字列包含照合を容易にします。
これにより出力のサイズは大きくなりますが、その代わりに、データベースに入るどのレコードも「このフィールドは原文のどの文に基づくか」に答えられるようになります。
欠損値と不確実性の明示的な処理
抽出タスクでモデルが最も犯しやすい誤りは抽出ミスではなく「補完」です。契約レベルで三つの状況を分けてモデリングする必要があります。
欠損。 原文にまったく関連情報がなく、フィールドは null です。この意味は「値が空文字列」と区別しなければなりません。空文字列は抽出された値であり、null は抽出できなかったことを表します。上流で約束を明確にすれば、下流はスキップするか警告するかを決められます。
曖昧。 原文に関連する表現はあるが確定するには不十分です。例えば「給与は応相談」とだけ書かれている場合、budget は null とすべきであり、同時にプロンプトで明確にします。定性的な記述を数値に変換しないこと、「応相談」を 0 にマッピングしないこと。
複数候補。 原文に連絡先が二つ、または日付が二つ現れるが、契約は単一値しか受け付けません。この場合、フィールド構造で候補リストをサポートするか、プロンプトで優先順位(例:最初に現れたものを取る)を規定するかが選べます。どちらを選んでも契約に書き込まなければなりません。そうしないとモデルの取捨選択の方針が毎回異なる可能性があり、結果を安定して再現できません。
さらにフォールバックを一つ加えます。モデルがどのフィールドにも分類できない重要情報を列挙する unresolved 配列を出力できるようにします。これは無理にどこかのフィールドに押し込むよりはるかに安全で、モデルの失敗パターンを観察する入り口も残せます。
データベース投入前の三層業務検証
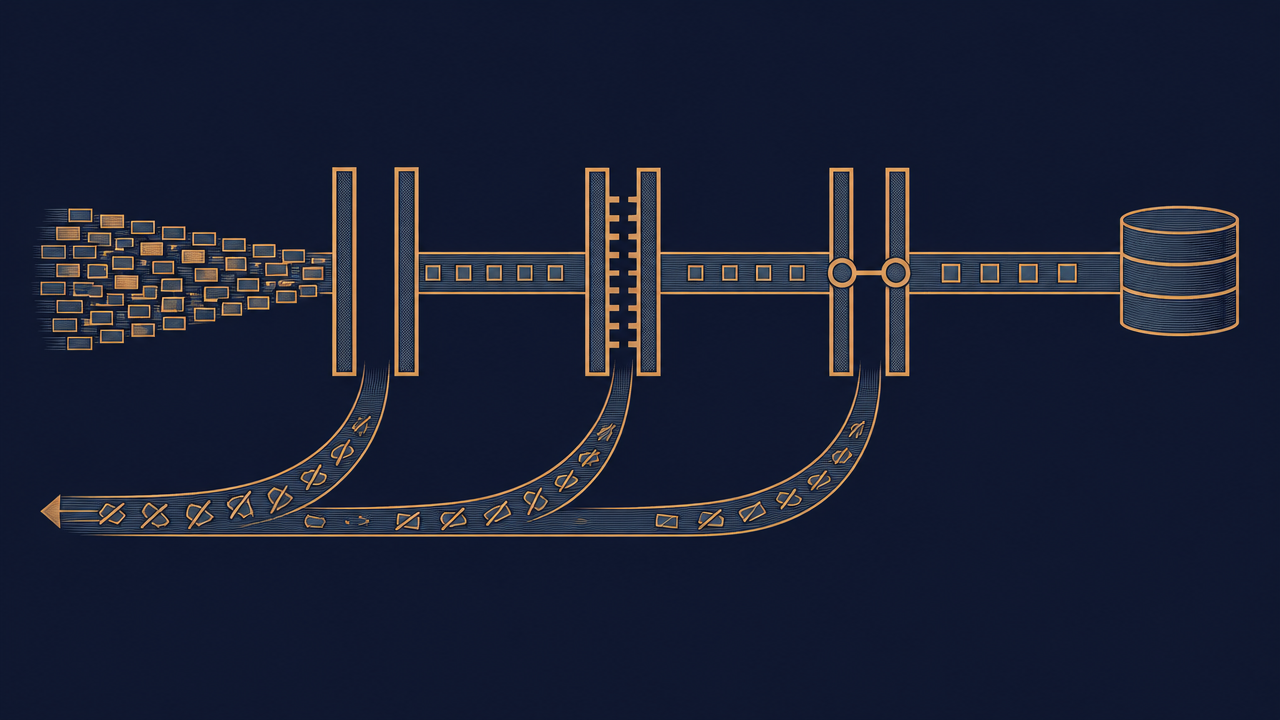
JSON オブジェクトモードは出力形式を制約するだけで、パースは依然として失敗する可能性があります。検証は順番に実行します。まずレスポンスの完全性を確認し、次にクライアント側の構造検証と業務検証を行い、最後に証拠の照合を行います。前の層を通らなければ次の層には進みません。
パース前に確認する:リクエストが正常に返されたか、回答拒否が発生していないか、終了理由が長さによる切り詰めを示していないか、ストリーミングレスポンスが正常に終了したか、内容が空でないか。レスポンスが正常に完了し内容が完全であることを確認してから json.loads を実行します。パース例外は直接失敗処理に入り、途中までの内容を後続の検証に送りません。パース成功後に、以下の三層検証に入ります。
第一層:型と構造
キーが揃っているか、型が一致しているか、deadline が日付形式を満たしているか、budget が有限の数値か。この層は通常のコードで十分であり、コストが低く、遮断率が最も高いです。
第二層:列挙と値域
業務上ありえない値を弾きます:金額が負、日付が今日より前、skills に空文字列や重複項目がある、文字列長がフィールド上限を超えている。フィールド自体に統制語彙(例:業界、職級)がある場合は、ここでホワイトリスト照合を行い、同義語正規化の場所を確保します。
第三層:フィールド間の整合性
単一フィールドが合法でも、レコード全体が成立するとは限りません。典型的なチェックには次が含まれます:budget が非 null のとき deadline も非 null か(多くの業務シナリオで両者は連動する)、contact が skills の示す職種タイプと矛盾しないか、同一バッチ内で同じ title のレコードのフィールド分布が異常に集中していないか。この層は業務セマンティクスに最も近く、テストを書く必要が最も高い層です。
evidence に対する機械的な検証も忘れないでください:値が非 null のとき、evidence は非 null でなければならず、入力原文中で文字列包含または曖昧一致によってヒットできるべきです。ヒットしない場合は必ずしも直接破棄する必要はありませんが、少なくとも低信頼マークを付けて人手キューに入れるべきです。
検証失敗を次のプロンプトに変える
検証失敗後、最悪の方法はそのままリクエストを再送し、今回は正しく抽出されることを期待することです。より良いのは失敗理由を構造化してフィードバックすることです:
前回の出力は検証に通りませんでした:
- deadline の値 "できるだけ早く" が YYYY-MM-DD 形式に一致しません
- skills[2] の evidence が原文中で見つかりません
上記の問題のみを修正し、他のフィールドは変更せずに、完全な JSON を再出力してください。
三つの細部に注意する価値があります。一つ目は、エラーメッセージが具体的なフィールドパスを指し、モデルが全体をやり直すのではなく局所的に修正できるようにすること。二つ目は、「他のフィールドは変更しない」と明確に要求すること。そうしないと新しい誤りを導入しやすく、一つ直すと一つ壊れる振動が起こります。三つ目は、リトライ上限(例:二回)を設定し、上限を超えたら無限ループではなく人手キューに落とすこと。無限リトライは遅延を長引かせるだけでなく、コストも押し上げます。
同じ種類の誤りがリトライで繰り返し現れるなら、それは通常モデルの問題ではなく、契約の書き方が曖昧なのです。その場合はプロンプトを追加し続けるのではなく、フィールド定義と例に戻って見直すべきです。
呼び出し方法と本記事の範囲
HiAPI では、glm-5.3 は OpenAI Chat Completions 互換プロトコルで呼び出し、JSON オブジェクトモードを有効にする方法はリクエストで response_format をオブジェクト型に設定することです。具体的なパラメータとフィールド名はモデルページのインターフェース説明に準じてください。機能マーカー jsonObject=true はモデルが JSON オブジェクトモードをサポートすることを示すものであり、インターフェースが JSON Schema レスポンスモードをサポートすることを示すものではなく、サーバー側が Schema に従って検証することに依存できるという意味でもありません。本記事のフィールド構造、型、業務制約はいずれもクライアント側でパース後にローカル検証します。抽出ロジック、引用フィールド、検証層はすべてあなた自身のサーバー側に書き、モデルは契約に従ってテキストを産出するだけです。
本記事は契約設計と検証フローのみを扱い、課金数値や性能の約束には触れません。リアルタイムの価格とクォータはサイトの価格パネルに準じてください。フィールド定義、引用検証、リトライ戦略の三つをやり終えて初めて、「形式合法」から「セマンティクス利用可能」へと進めます。形式が正しいことは事実が正しいことを意味せず、seed を固定しても完全な再現は保証されず、リトライ戦略には依然として上限と人手キューの併用が必要です。


