
使用ガイド
Kimi K3 レスポンス処理の実践:完全な JSON、ストリーミング中断、リトライの境界

このページの内容
まず 2 つのレスポンス経路を区別する
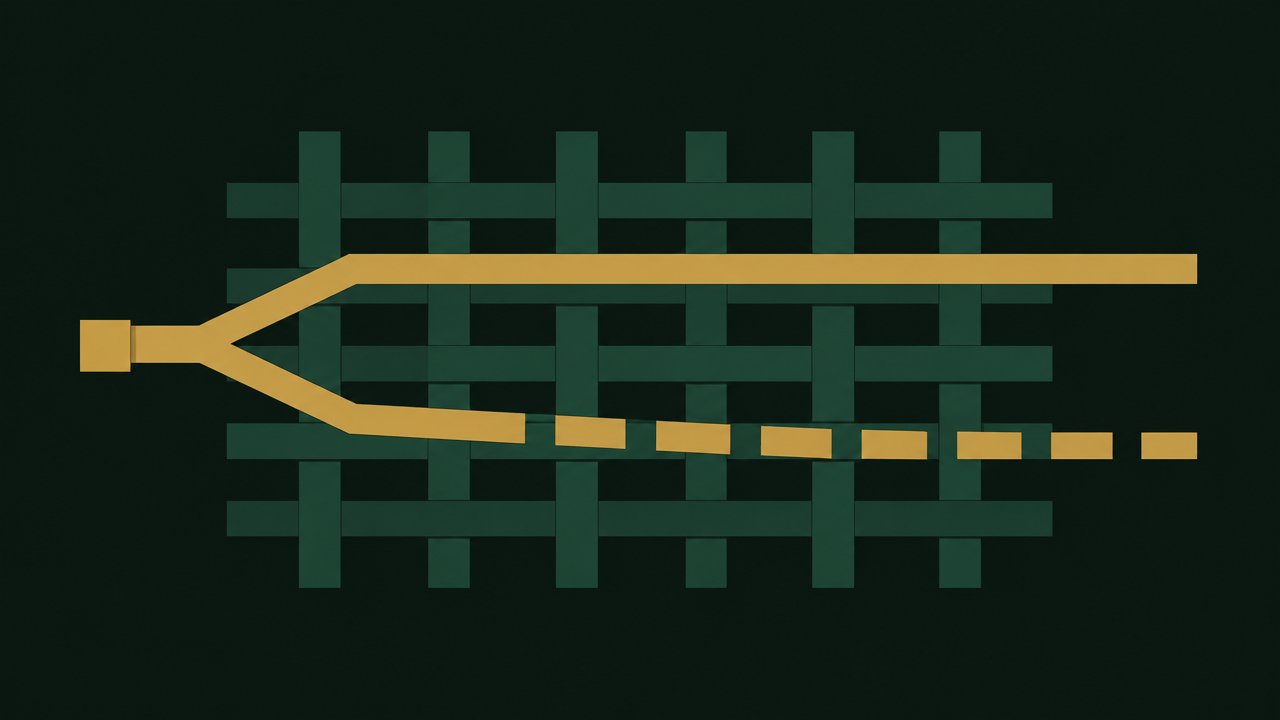
同じ Kimi K3 インターフェースでも、受け取るものは 2 種類のまったく異なる可能性があります。1 回の完全な JSON レスポンスか、順序どおりに到着する一連のストリーミングデータチャンクです。前者は「一問一答」型のドキュメント配送、後者は「生成しながら逐次プッシュ」する増分シーケンスです。レスポンス処理のバグの多くは、パースの書き間違いではなく、最初に自分がどちらの経路に立っているのかを把握できていないことが原因です。
2 つの経路は同一のリクエストプロトコル(openai_chat_completions、契約バージョン 2)を共有し、違いは消費方法に集中しています。
- 非ストリーミング:リクエストが返ると完全なレスポンス本体を受け取り、本文・推論内容・使用量がすべて含まれているので、一度に読み切れば済みます。
- ストリーミング:レスポンスはオプションモードで開始され、サーバーが継続的に chunk をプッシュし、最終的に SSE の
[DONE]マーカーでストリームを終了します。途中で数十から数百のチャンクを受け取ることもあれば、途中で切断されることもあります。[DONE]はストリームの終了を示すだけで、内容の完全性を意味しません。
まずこの点を確認してこそ、以降のすべての議論が意味を持ちます。業務の処理経路に 2 種類の呼び出しが併存する場合(たとえばバックグラウンドのバッチ処理とフロントエンドの対話が同じラッパーを共有する場合)、「コールバックがあるかどうか」のような暗黙的な判断で区別するのではなく、クライアント側で経路を明示的に標識することを推奨します。そうしないとリファクタリング時にデシリアライズ失敗という地雷を埋め込むことになります。
簡単な判断ルール:ユーザーに 1 文字ずつ表示する必要がある場合、または出力が長くなる可能性がある場合はストリーミングを使います。構造化された結果を一度に取得し、その後 DB への保存や二次加工が必要な場合は非ストリーミングを使います。2 つの経路のパースコードは分けて書き、共有するのはリクエスト構築とエラーマッピングの部分だけにすべきです。
完全な JSON を解析する:本文、推論内容、構造化フィールド
非ストリーミングレスポンスは OpenAI Chat Completions のレスポンス本体フォーマットに従いますが、見落とされがちな点が 1 つあります。本文と推論内容は別々のフィールドであるということです。
本文は標準のメッセージ内容の位置にあり、Kimi K3 の推論プロセスは reasoning_content フィールドで提供されます。つまり、パース層では少なくとも次の 3 つを行う必要があります。
- メッセージ内容からユーザー向けの最終回答を取得する。
reasoning_contentが存在するか判断し、存在する場合はログに記録するか、ユーザーに表示するか、そのまま破棄するかを決める。usageを別途保存し、課金とクォータ計算に使用する。
reasoning_content を本文として表示するのはよくある事故です。これはデバッグと説明可能性のためのシナリオ向けであり、そのまま製品の文面やカスタマーサポートの返信に入れると、口調も内容も不適切になります。正しい方法は、これに独立した消費経路を与えることです。たとえばデバッグログに書き出す、あるいは「推論プロセスを表示」のようなオプション入口に流すなどです。
構造化出力の使い方
この契約は response_format パラメータと jsonObject 構造化出力機能をサポートします。モデルに JSON オブジェクトを返させることで、脆弱な正規表現による抽出を 1 層省けます。ただし、明確にすべき前提が 2 つあります。jsonObject 機能は JSON Schema モードのサポートを意味しません。また、構造化出力は「必ず成功する」保証でもありません。
JSON の解析は、レスポンスが正常に完了し内容が完全である場合にのみ試みます。解析後も次の 3 種類の失敗を処理する必要があります。
- 解析失敗:返された内容が有効な JSON でない、またはフィールドが欠落している、型が一致しない。この場合、元の文字列をそのまま上流の業務に投げるのではなく、フォールバック分岐に入れるべきです。
- スキーマ検証失敗:JSON の構文は有効だが、宣言した構造に適合しない。
jsonObjectは JSON Schema レベルの制約を保証しないため、業務側でフィールド・型・必須項目を自前で検証する必要があります。 - 切り詰め:出力長がそのモデルの出力トークン上限(131072)に達すると、
finish_reasonがlengthになり、JSON が途中で終了する可能性があります。lengthを JSON の完全な成功として扱ってはいけません。不完全な JSON パーサーはエラーを出しますが、より危険なのは「ぎりぎり解析成功」してしまい、半分のオブジェクトのまま業務ロジックを続行してしまうことです。
JSON 構文の正当性だけに依存するのではなく、解析後に業務フィールドの完全性とエビデンスの検証を 1 段追加することを推奨します。コンテキストウィンドウは 1000000 なので、長文ドキュメントのシナリオでは入力はボトルネックになりませんが、出力の切り詰めは依然として現実に存在する境界です。
ストリーミング読み取り:[DONE]、finish_reason、使用量
ストリーミングモードでは、サーバーが chunk を順番にプッシュし、SSE のネットワーク終了マーカーは [DONE] です。この一文は平淡に聞こえますが、しばしば誤読されます。[DONE] はこのストリームが終了したことを示すだけで、生成が成功したことも内容が完全であることも示しません。
終態を判断するには、各 chunk 内の choices[].finish_reason を見ます。現在のフロントエンドは finish_reason が非空であることで終態を識別します。[DONE] を受信していても、finish_reason が欠けていれば中断とみなすべきです。ストリーム内の error フレームは、このリクエストの失敗を示します。
ストリームはいくつかの状態で終了する可能性があります。
- 正常完了:
finish_reasonが成功終態であり、その後[DONE]を受信する。累積内容は完全な結果とみなせます。 - 長さ切り詰め:
finish_reason=lengthであり、出力が長さ上限により切り詰められ、内容が不完全な可能性がある。JSON の完全な成功としては扱えません。 - その他の非成功理由:コンテンツフィルタなど。個別に処理する必要があり、正常完了として扱えません。
- 途中切断:接続クローズ、タイムアウト、またはストリーム内の
errorフレーム受信。この場合、部分的な内容しかなく、失敗または未完了としてマークすべきです。
最後のケースは「受け取ったものだけで済ませる」と書かれがちです。チャット表示としては許容できるかもしれません(ユーザーは半端な文を見て再送できます)が、DB 保存、課金、下流アクションのトリガーとしては誤ったデータになります。「成功終態の finish_reason を受信したか」を完全性の判断基準とし、[DONE] だけを見てはいけません。
使用量はストリーム終了後に集計する
ストリーミングモードでは、usage が finish_reason の後の choices:[] フレームに現れることがあります。クライアントはストリーム全体を読み切ってから使用量を集計すべきです。[DONE] 自体が usage を運ぶことは保証されません。
これにより 2 つの直接的なコーディング制約が生じます。
- 最初の chunk で課金やクォータの決済を行わない。 その時点では最終出力がどれだけ長いかも分からず、使用量フィールドも取得できません。
- 途中の chunk で使用量を累加せず、
[DONE]を使用量の運搬先として扱わない。 途中の chunk には信頼できる使用量データがなく、どんな「推定」も最終値とずれます。
正しい順序は、ストリーミング中はテキストと状態の累積だけを担当し、ストリームを読み切った後で choices:[] フレームから使用量を集計して 1 回の決済を完了することです。ストリームが途中で切断され、すでにユーザーに内容を表示している場合、この呼び出しの使用量状態は未知です。「未完了」の状態フラグを用意し、デフォルトで 0 や推定値で記帳してはいけません。
また、内部メタデータとネットワークフィールドを区別する必要があります。response.stream.terminal=done、response.usage.delivery=final_chunk のようなものはプラットフォーム内部のメタデータタグであり、SSE のネットワークフィールドでも、クライアントがマッチすべき終了文字列でもありません。クライアントは [DONE]、finish_reason、error フレーム、および usage フィールド自体にのみ依存すべきです。
もう 1 つの実践的な詳細:テキストを累積するときは文字列を繰り返し連結するのではなく、リストに追加してから join します。長い出力では性能差が顕著です。
なぜ POST のリトライは無料の冪等ではないのか
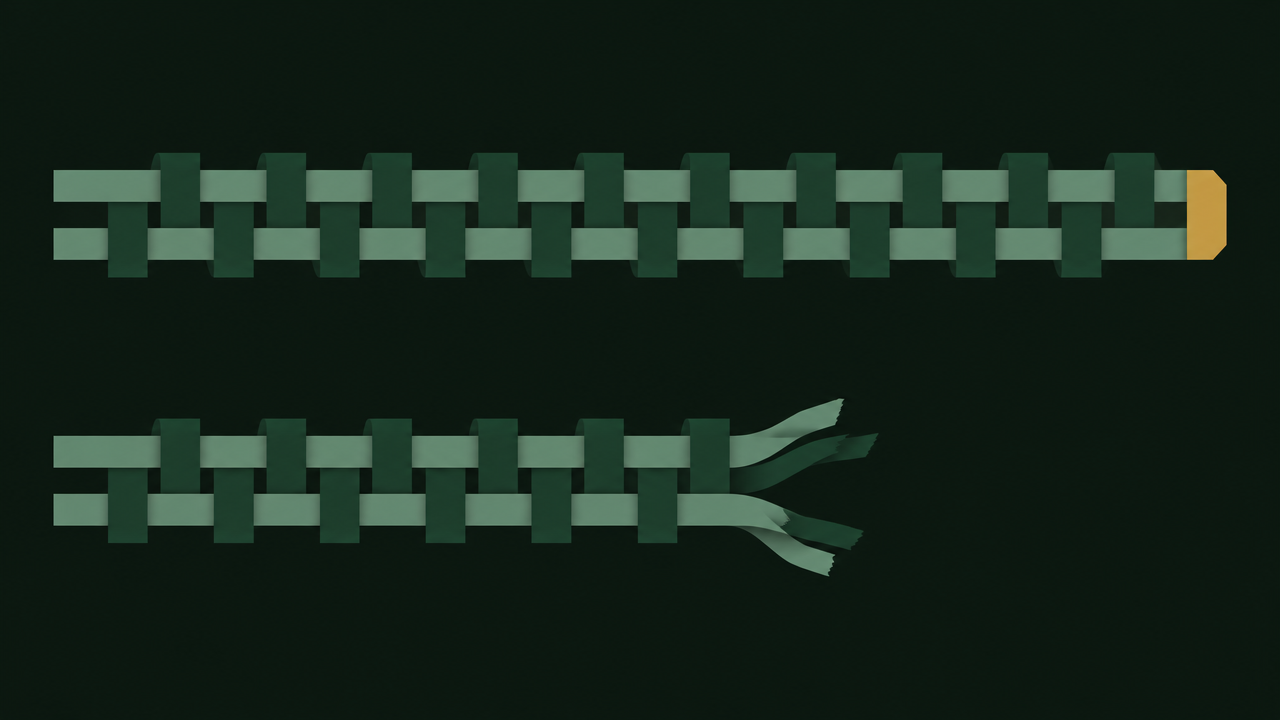
多くのリトライロジックはこう書かれます。リクエストがタイムアウト例外を投げたら、それを捕捉し、しばらく待ってから再送する。本記事では対話補完のような POST 生成操作のセマンティクスのみを扱います。この種のリトライは重複課金と重複副作用を引き起こす可能性があり、無料の冪等として扱えません。
理由は単純です。タイムアウトはクライアントの判断であり、サーバーの約束ではないからです。こちら側でタイマーが鳴ったとき、リクエストはすでに完全にサーバーに到達し、推論を開始し、あるいは完了して課金まで済んでいる可能性があり、単にレスポンスが戻る途中で失われただけかもしれません。クライアントは例外の種類だけでは次の 2 つの状況を区別できません。
- リクエストがサーバーに到達しておらず、リトライしても 2 回目の実行は発生しない。
- リクエストが受理され効果を生じている場合、リトライは 2 回目の呼び出しになる。
対話補完の「効果」には通常、トークン消費と課金、およびレスポンスに基づいて業務側でトリガーするアクション(DB 書き込み、フォーム送信、メッセージ送信)が含まれます。結果が不確定な POST を再送することは、これらの副作用を 2 回行うことに等しいです。これは理論上のリスクではありません。ネットワークの揺らぎ、ゲートウェイのタイムアウト、中間機器による接続リセットは、いずれもこの種の曖昧な状態を確実に生み出します。
さらに厄介なのは、完全な 5xx レスポンス、タイムアウト、切断、または JSON 解析失敗のいずれも、リクエストが生成されなかった、課金されなかった、副作用がなかったことを証明できないことです。目にするエラーは、クライアントが今回利用可能な結果を取得できなかったことだけを示します。
したがって、リトライの正しい前提は「エラーが起きた」ではなく「今回のリクエストが確実に実行されなかった」です。リトライコードを書く前に、まずこの問いに答えてください。答えられないなら自動再送はしないでください。
リトライの境界を定める:どの状況なら再送できるか
リトライを等級表にまとめるほうが、統一的な for retry in range(3) を書くより信頼できます。以下はエラータイプ別の処理戦略です。
実行されていないことが明確で、リトライ可能
- 接続確立の失敗(DNS 失敗、接続拒否):リクエストがサーバーに到達していないことは明らかで、明確に未送信に属し、リトライしても 2 回目の実行は発生しません。
- レート制限レスポンス(429 など):API ドキュメントまたはレスポンスのセマンティクスが実行前に拒否されたことを明確に保証している場合にのみ、そのセマンティクスに従ってバックオフしてリトライします。429 やその他のステータスコードだけから未実行や未課金を推測してはいけません。バックオフにはランダムジッターを付け、複数クライアントの同期リトライを避けます。
- API が明確に提供し、サーバーが実際に使用する重複排除メカニズム:API ドキュメントが明確に説明し、サーバーが実際にそれに基づいて重複排除している場合にのみ、そのセマンティクスに従ってリトライできます。クライアントが独自生成したリクエスト識別子は追跡にのみ使用し、特定のヘッダーやフィールドが冪等効果を持つと仮定してはいけません。
結果が不明で、明示的な処理が必要
- タイムアウト:これは最も危険なカテゴリです。タイムアウトはリクエストが実行されなかったことを証明できず、再送すると新たな課金対象の生成を生む可能性があります。クライアント独自生成のリクエスト識別子は追跡にのみ使用できます。サーバーが重複排除メカニズムを明確にサポートし実際に使用している場合にのみ、重複推論と重複課金を防げる可能性があります。業務側の重複排除はせいぜい下流アクションの重複を防ぐだけで、モデルの再生成と課金を止めることはできません。サーバー側の重複排除セマンティクスを確認できない場合は、自動再送をせず、ユーザーへのエラー報告または手動・非同期の補償フローに切り替えてください。
- 完全な 5xx レスポンス:レスポンス本体が完全に読めても、未生成・未課金・副作用なしを証明できません。明確に未実行である場合、または API ドキュメントがサーバーが重複排除識別子に基づいて実際に重複排除すると明確に説明している場合にのみリトライできます。それ以外は結果不明として処理します。
- レスポンス解析失敗:JSON 解析失敗とスキーマ検証失敗を含みます。リクエストはすでに成功し課金済みの可能性があり、解析失敗は未生成を証明できません。リトライは重複課金と重複副作用を引き起こす可能性があるため、結果不明として明示的にマークし記録し、事後の使用量照合に備えることを推奨します。
- ストリーミング途中の切断、またはストリーム内
errorフレームの受信:すでにプッシュされた内容を新しい結果と連結してはいけません。再送はまったく新しい生成として扱われます。
自動リトライしない
- リクエストパラメータエラー(4xx のうちパラメータ系エラー):何度リトライしても結果は同じで、エラーを増幅するだけです。
- コンテンツモデレーション系の拒否:再送しても結論は変わりません。
- 「すでに有効になったか」を確定できず、サーバー側の重複排除セマンティクスもないあらゆる状況。
境界をコードに書き込む
固定すべきエンジニアリング制約が 2 つあります。リトライ回数に上限を設ける(通常 1〜2 回で十分)、かつ明確に未送信であるか、API ドキュメントが実行前の拒否を明確に保証している場合にのみ有効にすること。各リトライでリクエスト識別子、エラータイプ、所要時間を記録すること。「何回リトライしたか」は使用量の請求とトラブルシューティングの経路を直接左右するからです。ストリーミングリクエストのリトライには追加の注意が必要です。接続が途中で切断された後に再送すると、まったく新しい課金対象の生成が発生し、すでにプッシュされた内容を新しい結果と連結できません。
まだ選定段階なら、まず Kimi K3 のモデルページ で契約の詳細を確認してから、リトライ戦略の粒度を決めてください。
実装チェックリスト
これまでのルールをレビュー時に 1 項目ずつ照合できるチェックリストにまとめます。
- クライアントはストリーミングと非ストリーミングの 2 つの消費経路を暗黙的な判断ではなく明示的に区別しているか?
- 非ストリーミング解析で本文と
reasoning_contentを分けて処理し、reasoning_contentがユーザー可視の文面に直接入らないようにしているか? usageを別途保存し、業務レコードと関連付けられるようにしているか?- 構造化出力をレスポンスが正常完了し内容が完全な場合にのみ解析し、解析失敗、スキーマ検証失敗、業務・エビデンス検証失敗、および
finish_reason=lengthに対して独立したフォールバックを用意しているか? - ストリーミング読み取りで
finish_reasonが非空であることで終態を識別し、[DONE]だけを待っていないか? [DONE]をストリーム終了マーカーとしてのみ扱い、finish_reasonが欠けている場合は中断としてマークしているか?- 使用量をストリーム読み切り後に
choices:[]フレームから集計し、[DONE]が usage を運ぶと仮定していないか? - ストリーム内の
errorフレームを正常終了ではなく失敗として識別しているか? - リトライをエラータイプ別に等級化し、明確に未送信であるか、API ドキュメントが実行前の拒否を明確に保証している場合にのみ有効にしているか?
- タイムアウト、切断、完全な 5xx、または JSON 解析失敗を「結果不明」として明示的に処理し、リトライの安全性を安易に約束していないか?
- リトライ回数に上限があり、各リトライに使用量照合に使えるログがあるか?
- ストリーミング中断後の再送を続き書きではなく新しい生成として扱っているか?
このチェックリストを一度にすべて満たす必要はありませんが、各項目は実際に発生するオンライン問題に対応しています。まず finish_reason の終態判断基準とリトライ境界の 2 項目に取り組むと、最も直接的な効果が得られます。
関連記事
すべての記事を見る →-

使用ガイド
Nano Banana ベーシック版テキストtoイメージガイド:アスペクト比、余白、プロンプトの使い方
タスク API の aspect_ratio と prompt フィールドを使い、バナーとソーシャルカード向けに構図が明確な画像を生成する
-

使用ガイド
GLM 5.3 構造化抽出の実践:すべての JSON フィールドに原文根拠を持たせる
JSON オブジェクトモードでフィールド抽出を行い、欠損値・引用・業務検証で誤りをデータベース投入前に食い止める
-

使用ガイド
MiniMax Music 3 ショートソング制作ガイド:歌詞・セクションタグ・編曲ブリーフをどう分けて書くか
現在の契約における2つの必須入力を基準に、再現可能なショートソングリクエストを設計する