
使用ガイド
HiAPI API で heygen-avatar-iv を使ったショート動画を生成する:開発者ガイド
デジタルヒューマンと音声入力、台本のテンポ、アスペクト比と尺、そしてバッチ生成——実行可能な HiAPI リクエスト付き
このページの内容
ショート動画に heygen-avatar-iv を選ぶ理由
ショート動画は、製品リリース、バージョンアップのお知らせ、ドキュメント解説、ソーシャルメディア向けの短編などで、既定の配信チャネルになっています。ほとんどのエンジニアリングチームにとってボトルネックは編集ではなく、スタジオを予約したり出演者と素材をやり取りしたりすることなく、人物が出演して口頭で語る素材を安定して制作できるかどうかです。
そこを埋めるのがデジタルヒューマン動画生成です。視覚的な外見と音声・ボイスのソースを指定すると、モデルはそのデジタルヒューマンが台本を読み上げるレンダリング済みのクリップを返します。heygen-avatar-iv は HiAPI のカタログでこのワークフロー向けのエンドポイントです。縦向き優先の短いクリップで、プレゼンターがカメラをまっすぐ見て話します。
このモデルが適しているのは次のような場面です。
- 大量に制作する必要がある。 同じお知らせの10言語版、あるいはリリースごとに毎日1本のクリップ。これは単発の撮影ではなくループ処理です。
- 内容が台本で決まる。 メッセージがテキストの中にあるなら、デジタルヒューマンのプレゼンターで十分です。
- 再現性が欲しい。 1回のリクエストが1ファイルになります。差分を取り、バージョン管理し、再実行できます。収録セッションとは違います。
- すでに API を呼んでいる。 HTTP 呼び出し1回で既存のパイプラインに組み込めます。独立した UI を持つ新しいツールを持ち込む必要はありません。
即興的で大げさなジェスチャーのパフォーマンスや、特定の人物がその場にいること自体が価値になる場面には向きません。heygen-avatar-iv はレンダラーとして扱ってください。同じ入力から同じ種類の出力が得られるべきであり、だからこそスクリプト化できるのです。
このガイドの残りは、単発のテスト呼び出しからバッチループまでを扱い、そのまま適応できる実行可能な curl と Python を含みます。モデルの詳細とパラメータはheygen-avatar-iv モデルページを参照してください。
heygen-avatar-iv リクエストの構成
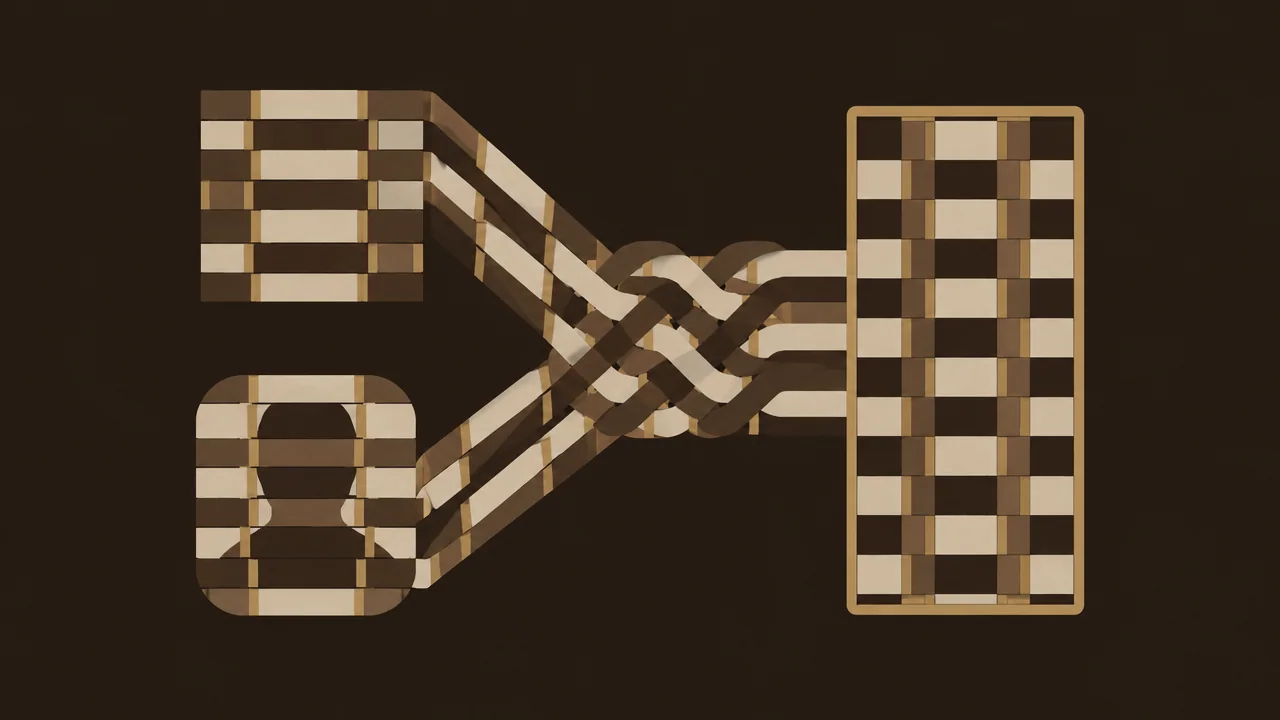
生成コードを書く前に、リクエストを2つの独立した入力グループとしてモデル化します。初期のバグのほとんどは両者を混同することから生じます。
グループ1:視覚的な外見
これは誰が出演するかです。プレゼンターの顔、構図、全体的な見た目を決めるデジタルヒューマンの選択です。1つのキャンペーンの中ではこのグループを固定します。同じ製品について5本のクリップを作るなら、同じ外見ブロックを共有し、シリーズが同一のプレゼンターに見えるようにします。
グループ2:音声とボイス
これは何をどう話すかです。リクエストによって、音声ソースは台本を読み上げるボイスの選択になることも、提供した音声トラックになることもあります。このグループはクリップごとに変わります。新しい台本、新しいテンポ、ローカライズのための新しいボイスなどです。
呼び出しへのマッピング
HiAPI のリクエストは2つのグループを同じペイロードに入れて生成エンドポイントに送ります。概念としては次のとおりです。
request
├── avatar / identity block   → シリーズ内で固定
└── audio / voice block       → クリップごとに変化
        └── 台本テキストまたは音声ソース
この分割から2つの実用的なルールが導かれます。
- 音声グループはパラメータ化し、外見グループは固定する。 コードでは外見をモジュールレベルの定数として保持し、台本とボイスを関数の引数として渡します。これによりシリーズの視覚的統一が構造的に保証されます。
- デバッグ時は一度に1グループだけ変える。 クリップの見た目がおかしいなら外見だけを差し替えます。聞こえ方がおかしいなら音声グループだけを差し替えます。有料のレンダリング呼び出しで2変数を同時にデバッグするのは割に合いません。
また、音声グループがテキスト駆動か音声トラック駆動かを早い段階で決めてください。この選択が次の節のテンポを決めるからです。提供した音声トラックはタイミングを決め、生成された音声は台本に従います。
正確なフィールド名、受け付けられる値、既定値はモデルページに記載されています。一度読んで、リテラルをコードのあちこちに散らかすのではなく、設定オブジェクトにまとめて固定してください。
curl で最初の呼び出しを行う
短いクリップから始めます。この呼び出しの目的は出力品質ではなく、自動化に進む前に認証情報、ペイロード形状、ダウンロード経路をエンドツーエンドで検証することです。
キーは環境変数に設定し、シェル履歴に平文で残らないようにします。
export HIAPI_API_KEY="your_key_here"
次に最小限のリクエストを送ります。デジタルヒューマンの選択と短い台本を自分のものに置き換えてください。
curl -X POST "https://api.hiapi.ai/v1/generate" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "avatar": "<avatar_identifier>",
      "script": "これはデジタルヒューマンパイプラインの30秒テストです。この文が画面で読めれば、リクエスト形状は正しい。",
      "voice": "<voice_identifier>",
      "aspect_ratio": "9:16",
      "duration": 30
    }
  }'
順番に確認します。
- 認証。 ここで認証情報のエラーが出たら停止します。下流のことはすべて意味がありません。
- ペイロード検証。 スキーマエラーは問題のあるフィールドを示します。一度に1フィールドずつ直します。
- ジョブの受理。 呼び出しが成功すると job または task の参照が返ります。必ずしも完成ファイルではありません。生成は非同期なので、その識別子を記録します。
- 結果の取得。 モデルページのレスポンス契約に従い、返された参照でステータスをポーリングするか結果 URL を取得します。
- 再生。 クリップをダウンロードして視聴します。構図、向き、読み上げ内容が台本と一致することを確認します。
この curl コマンドを下書きファイルに保存し、実際の識別子を入れておきます。これが対照実験になります。Python 版で問題が起きたら、もう一度 curl を実行して、問題がコード側か入力側かを証明できます。
Python に移行して再現可能な生成を行う
curl 呼び出しが成功したら、それを関数にまとめます。目的は抽象化のための抽象化ではなく、すべてのパラメータを明示的な引数にし、クリップが呼び出し箇所だけで完全に記述されるようにすることです。
import os
import requests

API_URL = "https://api.hiapi.ai/v1/generate"
API_KEY = os.environ["HIAPI_API_KEY"]

# シリーズ内で固定
AVATAR = "<avatar_identifier>"


def generate_clip(script: str, voice: str, aspect_ratio: str = "9:16",
                  duration: int = 30) -> dict:
    payload = {
        "model": "heygen-avatar-iv",
        "input": {
            "avatar": AVATAR,
            "script": script,
            "voice": voice,
            "aspect_ratio": aspect_ratio,
            "duration": duration,
        },
    }
    resp = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    return resp.json()


if __name__ == "__main__":
    job = generate_clip(
        script="これはデジタルヒューマンパイプラインの30秒テストです。",
        voice="<voice_identifier>",
    )
    print(job)
後々役立つ設計上のポイント:
- 既定値は最もよく使うクリップを反映する。 出力のほとんどが縦向きの短いクリップなら、それを既定にし、めったに上書きしない。
- 外見はモジュールレベルに置く。 デジタルヒューマンの選択が1か所にだけ存在し、ブランド変更は1行の修正で済む。
- レスポンス全体を返す。 すぐに URL を抜き出して job オブジェクトを捨てない。識別子はログとリトライに必要になる。
- HTTP エラー時は例外を送出する。 バッチループでのサイレント失敗はクラッシュより悪い。
- 非同期ステップを明示的に扱う。 生成関数の内部で sleep するのではなく、小さな
poll(job_id)ヘルパーを追加する。
レスポンス処理ロジックはモデルページに記録された契約に固定してください。job ステータスと結果取得のフィールド名は、あなたの仮定と最もずれやすい部分です。
ナレーション台本を書き、テンポを制御する
デジタルヒューマン動画は音声優先です。紙の上では問題なく読める台本も、読み上げると長すぎることがよくあります。生成後に切り詰めるということは、切り捨てる文章にレンダリング費用を払うことになります。
まず長さで書き、それから削る
API を呼ぶ前に尺を見積もります。快適な話速は毎分130〜160語程度で、視聴者が追いつく必要のある技術的な内容では低い側を使います。したがって30秒のクリップには約65〜80語、60秒のクリップには約130〜160語が必要です。この予算で下書きし、タイマーを使って声に出して読み、それから削ります。削る必要があるなら、単語ではなく文ごと削ってください。文単位の削除ならテンポが保たれます。
耳のために書く
- 短い文。 1文に1つの主張。従属節は理解度が落ちる場所です。
- 視覚にしか頼らない参照は避ける。 「以下に示すとおり」はスライドがなければ通用しません。
- 要点を前に置く。 ショート動画の視聴者は最初の数秒で判断します。主張は最初の文に置いてください。
- TTS が読み間違えるものを書き出す。 略語、バージョン文字列、大文字小文字が特殊な製品名は、発音されるべき形で書いてください。
タイムラインでテンポを制御する
台本を目標尺に合わせて時間ブロックに配分します。
0–5s    フック:主張または問題
5–20s   本文:仕組みを2〜3文で
20–28s  ディテール:残す価値のある数字か例を1つ
28–30s  締め:単一の行動喚起
このブロック構造はレビュー成果物としても機能します。レビュアーは何も再レンダリングせずに特定のブロックを却下できます。各クリップの台本を独立したファイルに置き、レンダリングするコードと一緒にバージョン管理すれば、次の節のバッチループは完全に再現可能になります。
アスペクト比、尺、出力の設定
最初のレンダリング前に、対象プラットフォームに合わせて向きと長さを決めます。完成したクリップを別の向きで再レンダリングするのは純粋な無駄であり、長すぎるクリップを再編集するということは音声も再生成することを意味します。
アスペクト比
- 9:16 縦向き —— ショート動画フィードの既定:shorts、reels、stories、モバイル優先の配信枠。構図はこれを優先して設計し、可能なら縦向きマスターから他の比率を切り出してください。
- 16:9 横向き —— 埋め込みプレーヤー、ランディングページ、ドキュメント動画、プレゼン用途。
- 1:1 正方形 —— 正方形を好むフィード配信枠。二次的な派生版として適しています。
キャンペーンで2つの向きが必要なら、同じ台本を2回レンダリングするのではなく、別の台本を使う2つの別タスクとして扱ってください。30秒の縦向きに合うセリフは、より短い正方形の編集では間延びしがちです。
尺
前の節の台本予算に合わせて尺を設定し、その逆はしないでください。実際の読み上げ長に合う尺を渡してください。埋め草や文中での打ち切りがあるクリップは壊れて見えます。プラットフォームごとの目標を設定に置くと調整しやすくなります。
TARGETS = {
    "vertical": {"aspect_ratio": "9:16", "duration": 30},
    "horizontal": {"aspect_ratio": "16:9", "duration": 45},
}
出力
一時的な結果 URL に頼らず、完成したクリップを自分でダウンロードして保存してください。単純な命名規則 {clip_id}-{orientation}-{version}.mp4 で派生版を追跡可能にし、古いファイルを一目で分かるようにします。job 識別子をファイルと一緒に記録すれば、どのクリップも正確なリクエストまでたどれます。
課金はリクエストした生成に対して行われ、尺とクリップ数に基づきます。したがってレンダリング前に台本を絞り込むことが、最も安価な最適化です。現在の料金は料金パネルを参照してください。
複数クリップのバッチ生成
動く関数ができれば、バッチ処理はタスクリストのループです。重要なのは、各タスクが1つのクリップの完全な記述になっていることです。
JOBS = [
    {"id": "launch-vertical", "script_file": "scripts/launch.txt",
     "voice": "<voice_a>", "aspect_ratio": "9:16", "duration": 30},
    {"id": "launch-square", "script_file": "scripts/launch_sq.txt",
     "voice": "<voice_a>", "aspect_ratio": "1:1", "duration": 20},
    {"id": "changelog-vertical", "script_file": "scripts/changelog.txt",
     "voice": "<voice_b>", "aspect_ratio": "9:16", "duration": 30},
]

results = []
for job in JOBS:
    with open(job["script_file"]) as f:
        script = f.read().strip()
    print(f"submitting {job['id']} ({len(script.split())} words)")
    resp = generate_clip(
        script=script,
        voice=job["voice"],
        aspect_ratio=job["aspect_ratio"],
        duration=job["duration"],
    )
    results.append({"id": job["id"], "job": resp})
採用する価値のあるパターン:
- 台本は文字列リテラルではなくファイルとして。 レビューでき、差分が取れ、異なる向き間で再利用できます。
- 語数のログ。 各タスクの語数を出力すれば、尺を超過しそうな台本をレンダリング費用をかける前に見つけられます。
- 安定した job id。 出力ファイル名とログで使えば、20回の実行のうち失敗したクリップを特定できます。
- ソフトに失敗し、後で報告する。 各送信を try/except で包み、失敗を収集して続行します。1つの悪い台本でバッチ全体を中止すべきではありません。
- レート制限と並行性を守る。 直列実行から始め、直列実行が安定してから初めて上限付きのワーカースレッドプールを追加します。
- 結果リストを永続化する。 job id を JSON ファイルに書き出せば、部分的に完了したバッチを最初からやり直さずに再開できます。
よくある失敗ポイントとチェック
これらは最初に表面化する問題です。どれにも安価な切り分けチェックがあります。
入力フォーマットの誤り
スキーマエラーは最もよくある初回の失敗です。チェック: 同じ識別子で元の curl コマンドを実行します。curl は成功して Python が失敗するなら、バグはシリアライズにあります。多くの場合、整数の duration に文字列を渡した、あるいは台本ファイルの末尾に余分な改行があるといった型の不一致です。
音声と台本の不一致
音声が画面で意図した内容と違うことを言っている、あるいはクリップが無音なら、音声グループが誤っています。チェック: リクエストがテキスト駆動か音声トラック駆動かを確認し、対応するフィールドを渡していることを確認します。音声トラックと台本フィールドの両方を提供するのは典型的な無音の衝突です。どちらを優先するかを決め、もう一方を削除してください。
向きの誤りや黒帯
クリップに黒帯や意図しないフレームが付いて返ってきます。チェック: aspect_ratio が実際にペイロードに届いているか検証します。関数の既定値が、渡したつもりの値を黙って上書きしている可能性があります。送信前に組み立てたペイロードをログ出力してください。
尺の不一致
クリップが文中で切れる、または間延びします。チェック: 台本の語数と尺の予算を比較します。目標自体が誤っていない限り、尺ではなく台本を直してください。
シリーズ内での外見のずれ
同じキャンペーン内のクリップが別のプレゼンターのように見えます。チェック: デジタルヒューマン識別子がタスクごとの設定ではなく単一の定数から来ていることを確認します。
出力の切り詰めや欠落
job は成功したのにファイルが不完全です。チェック: ダウンロード前に job が終端の成功状態に達していることを確認し、URL を推測するのではなくモデルページの取得契約に従っていることを確認します。
一般的なルール:テストクリップ1本、curl リクエスト1回、変数は一度に1つ。heygen-avatar-iv モデルで短い縦向きレンダリングを1回行い、エンドツーエンドで検証してから、ループを拡張してください。


