
使用ガイド
Vidu Q3 Mix リファレンス動画生成入門ガイド:能力の境界、API パラメータと課金の要点
開発者向けの統合判断と実践の視点
このページの内容
このモデルは何を解決するのか
動画生成モデルの入力形態は、あなたが「制御権」を握れるかどうかを決めます。テキストから動画(text-to-video)はプロンプトを1つ与えるだけで、映像の展開はモデルが自由に表現します。画像から動画(image-to-video)は最初のフレームを1枚与え、モデルがそれを「動かす」役割を担います。そして reference-to-video(リファレンス動画生成) は第三の道を進みます。参照素材を提供すると、モデルはそれを最初のフレームとして扱うのではなく、生成過程で継続的に参照するのです。
vidu-q3-mix/reference-to-video の位置づけは、まさにこの分岐上にあります。次のようなニーズに適しています:
- キャラクターや主体をカットをまたいで一貫させたい:既存の動画素材はないが、主体の外観を代表する参照画像が1枚または複数あり、完成映像の中で主体が「やはりそれに見える」ことを望む場合。
- スタイルと雰囲気を固定したい:参照素材が光線、質感、構図の傾向を担い、完成映像がその視覚言語を踏襲することで、テキスト記述だけに頼るより制御しやすくなります。
- 静的アセットから動的コンテンツを作る:EC 商品、IP キャラクター、コンセプトデザイン画など、既存の画像アセットをショート動画に変換する場合。
言い換えれば、あなたの要望が「記述に合った映像を適当に作ってほしい」であれば、テキストから動画の方が直接的です。要望が「この映像は私が提供したものに似ていなければならない」であれば、リファレンス動画生成こそ適切なツールです。選定時にはまず自分に問いかけてください:保持しなければならない視覚的アンカーはあるか?あるなら、これを使いましょう。
HiAPI.ai 上では、このモデルは他の動画モデルと同じ呼び出しコンテキストを共有しており、専用の接続ロジックを別途構築する必要はありません。モデルを切り替える際に主に変わるのは能力パラメータであり、エンジニアリング構造ではありません。
画像から動画との決定的な違い
画像から動画の入力画像は「起点」であり、リファレンス動画生成の入力は「制約」です。前者はモデルに引き継ぐべき画面を与え、後者はモデルに遵守すべき特徴のセットを与えます。これを理解すれば、以降の素材準備やパラメータチューニングに関するすべての判断が自然に導かれます。
能力の境界と不適切なシナリオ
モデルの能力範囲を明確に描くことは、それが何をサポートするかを覚えるよりも重要です。reference-to-video という能力定義に基づき、以下の境界を明確にできます:
カバーする範囲
- 参照素材を視覚的根拠として動画を生成:参照画像の特徴が生成過程に導入されます。
- 主体の一貫性とスタイルの継続:複数セグメントの生成において比較的安定した外観表現を維持します。
- プロンプトと組み合わせて内容の展開を制御:参照素材が「似ているかどうか」を担い、プロンプトが「何をするか」を担います。
カバーしない範囲
- テキストから動画の代替品ではない:参照素材がない場合、プロンプトを極端に長く書いて参照画像を「模擬」すべきではありません。これはツールの誤用であり、効果もコストも割に合いません。
- 厳密なフレーム単位の複製ツールではない:リファレンス動画生成は参照画像を正確にアニメーション化することではなく、参照画像のすべてのピクセルに責任を負うことを期待してはいけません。「この画像がそのまま動き出さなければならない」という要望であれば、画像から動画の方が近いです。
- 無制限の長さを約束しない:1回の生成の長さ上限は、インターフェースとプラットフォームパネルで利用可能なパラメータに準拠します。「好きなだけ長く生成できる」という前提で製品フローを設計しないでください。
- ポストプロダクションを代替しない:字幕、編集、複数セグメントの結合、音声トラックの合成は依然としてあなたのパイプラインの責務です。
選定で最も陥りやすい誤用
最も典型的な誤用は、リファレンス動画生成を「より安価な画像から動画」と見なすことです。両者の入力セマンティクスは異なり、产出の期待も異なります:最初のフレームを厳密に揃える必要がある場合にリファレンス動画生成を使うと、「似ているが異なる」結果が得られがちで、繰り返しリトライするほどコストが膨らみます。逆に、複数カット間で主体を安定させたい場合に画像から動画でセグメントごとに画像を供給すると、かえって外観のドリフトが発生しやすくなります。
判断ルールは一文に簡略化できます:起点が欲しいなら画像から動画、制約が欲しいならリファレンス動画生成。
API パラメータと呼び出しフローの要点
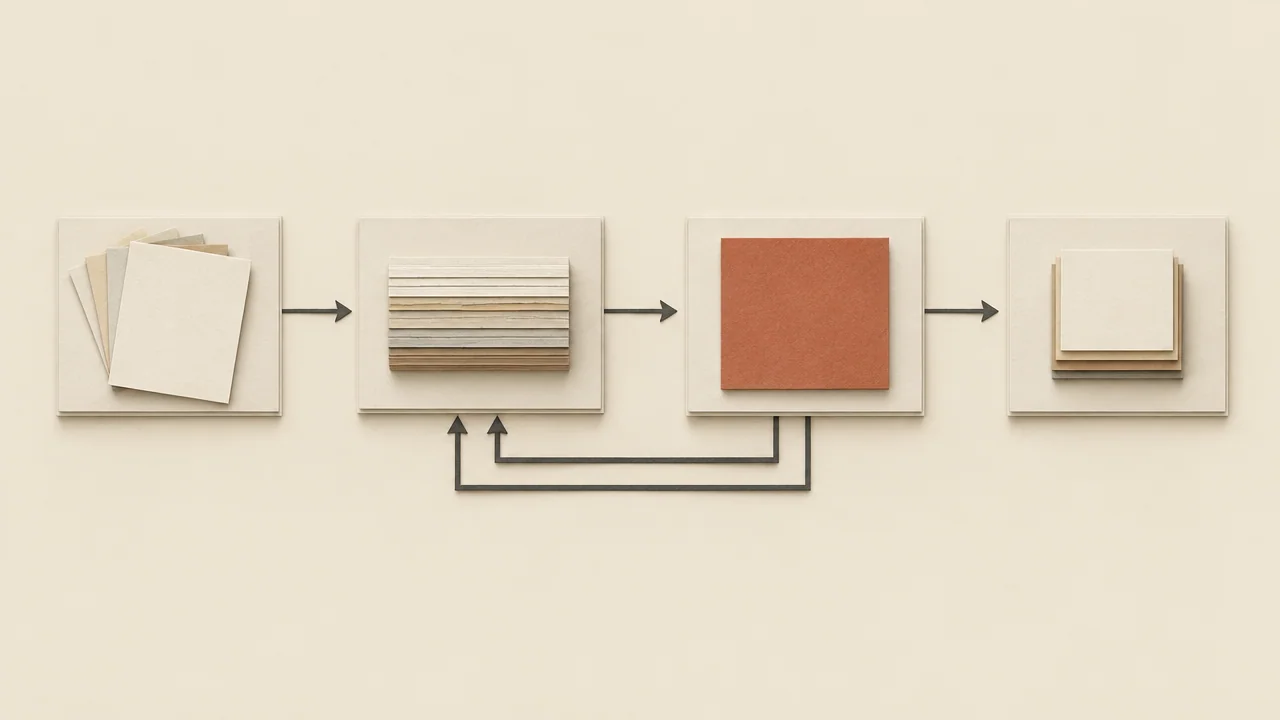
この種のモデルを統合する際のエンジニアリングの複雑さは、主に「リクエスト送信」ではなく「入力の準備」と「フローの組織化」にあります。全体のチェーンは4段階に分解できます:
1. 参照素材の準備
呼び出しを開始する前に、参照素材を正規化します:サイズと比率を統一し、ウォーターマークや余分な背景要素を除去し、主体が鮮明で光照が一貫していることを確保します。このステップをしっかり行ってこそ、その後のパラメータ微調整が意味を持ちます。
2. リクエストの構築
典型的な呼び出しでは、リクエストに3種類の情報を組織する必要があります:
- 能力識別子:
vidu-q3-mix/reference-to-videoの使用を指定し、リクエストを正しい能力分岐に導きます。 - 参照素材:参照画像の位置またはアップロードハンドル。具体的なフィールド名と受け入れ形式はインターフェースドキュメントに準拠します。
- 生成記述:プロンプト。参照画像に既にある外観を繰り返し記述するのではなく、動作、カメラワーク、リズム、雰囲気を記述します。
具体的なフィールド名、必須項目、値の範囲は HiAPI.ai のインターフェースドキュメントとモデル詳細ページに準拠してください。本記事ではフィールドを捏造しません。統合時はドキュメントに従って組み立ててください。
3. 生成タスク
動画生成は本質的に非同期です:リクエストを送信するとタスク識別子が返され、モデル側の推論完了には時間がかかります。サーバー側では「送信」と「結果取得」を分離し、タスク識別子でポーリングまたはコールバックを受信する必要があります。同期リクエストで待機してはいけません。
4. 結果取得とリトライ
結果を取得したら、まず可用性チェック(ファイルが正常にデコードできるか、長さが期待通りか)を行い、その後リトライするかどうかを決定します。リトライ分岐には上限を設け、各失敗の原因を記録します。これはコスト見積もりに極めて重要です。
プロンプトの書き方
リファレンス動画生成のプロンプトでは、「参照画像以外の情報」に重点を置くべきです:画面内の主体が何をするか、カメラがどう動くか、環境がどう変化するか。参照画像に既にあるものを繰り返し記述するのに分量を費やすのは、よくある無駄です。記述が具体的で、実行可能な画面指示に近いほど、生成結果は安定します。
$0.1865/秒でコストを見積もる
このモデルの課金基準は出力動画の秒数に基づく課金で、単価は1秒あたり $0.1865 です。これを理解すれば、コスト見積もりは簡単な掛け算の問題になります。
1本あたりのコスト式
1本あたりのコスト = 出力の長さ(秒) × $0.1865
5秒の完成映像のコストは 5 × 0.1865、10秒なら 10 × 0.1865 です。長さが倍になればコストも線形に倍になります。段階もなく、「一度に生成する方がお得」という隠れた割引もありません。そのため、長さの予算は最初から製品設計に組み込む必要があります。
リトライを含めて計算する
実際のコストは決して「1本の動画の価格」ではありません。生成には不確実性があり、失敗や不満足に対するリトライ予算を確保する必要があります:
予想総コスト = 1本あたりのコスト × 期待試行回数
期待試行回数 ≈ 1 + リトライ率
例えば、8秒の生成タスクが平均1回のリトライで使用可能な結果を得る場合、実際のコストは 8 × 0.1865 × 2 であり、8 × 0.1865 ではありません。リトライ率が高いチームはコストが倍増します。これは多くの導入者がスケール後に初めて気づく隠れたコストです。
予算管理の3つの抓手
- まず短く、後に長く:デバッグ段階では最短の長さでプロンプトと素材が揃っているかを検証し、有効性を確認してから長くします。短い動画の試行錯誤コストははるかに低いです。
- リトライ上限を設定:各タスクに最大試行回数を設け、超過したら人手介入または素材変更とし、自動リトライが予算を食い尽くすのを防ぎます。
- 毎回の呼び出しを記録:長さ、リトライの有無、失敗原因を記録・報告します。このデータがなければ、予算超過がプロンプトの問題か素材の問題かを判断できません。
リアルタイムの価格と課金の詳細は HiAPI.ai サイトの価格パネルに準拠します。本記事では見積もり方法のみを扱います。
参照素材の準備とチューニングの考え方
リファレンス動画生成のチェーンでは、素材の品質が完成映像に与える影響は、通常パラメータの微調整よりも大きいです。理由は:パラメータはモデルの「傾向」を調整しますが、素材はモデルの「根拠」を決定するからです。根拠が不明確であれば、どれほど良い傾向も実現しません。
どんな参照素材が良い素材か
- 主体が明確:視聴者が0.5秒でこの画像の中で「保持すべきもの」を認識できること。背景の雑多なものや主体の占有比率が小さいことは、参照効果を弱めます。
- 特徴が安定:同じ主体が異なる参照画像間で外観が一貫しているべきです。複数の参照画像自体が矛盾している(色、形態、材質が合わない)場合、モデルは各バージョンの間で揺れるしかありません。
- 光照と角度が合理的:極端な光照、深刻な歪みのある角度はモデルに誤った視覚的手がかりを与えます。
- クリーン:ウォーターマーク、ステッカー、余分なテキストを除去します。これらの要素は主体の特徴として一緒に引き継がれる可能性があります。
チューニングの優先順位
結果が理想的でない場合、いきなりパラメータを調整するのではなく、この順序で調査することをお勧めします:
- まず素材を変える:参照画像をより鮮明で単一主体のバージョンに変えることが、最速の改善手段であることが多いです。
- 次にプロンプトを変える:動作と環境を明確にし、参照画像と重複する記述を削除します。
- 最後にパラメータを動かす:最初の2ステップが安定してから微調整を検討し、一度に1つの変数のみを変更して原因を特定しやすくします。
複数参照画像の一貫性
複数の参照素材を提供する場合、それらが「同じ主体」であることを必ず確保してください。異なる個体や異なるスタイルの画像を混ぜることは、結果のドリフトの最も一般的な原因の1つです。1枚少なく与える方が、矛盾する1枚を与えるより良いです。
素材ベースラインの構築
コア主体に対して固定の参照素材セットを構築し、その後のすべての生成のベースラインとすることをお勧めします。毎回の生成をこのベースラインから始め、プロンプトだけを変えることで、「素材の問題」と「記述の問題」をきれいに区別でき、複数セグメントの動画間のスタイルも統一しやすくなります。
よくある失敗とトラブルシューティングの方向性
統合段階のほとんどの問題は、いくつかの固定パターンに分類できます。以下の順序で調査すれば、通常は盲目的なリトライより迅速です。
1. リクエストが拒否される、またはパラメータエラーが返される
まず能力識別子が正しく書かれているか、必須の参照素材フィールドが揃っているか、素材形式がインターフェースに受け入れられるかを確認します。フィールド名はドキュメントに準拠し、経験で推測しないでください。
2. タスクが長時間結果を返さない
動画生成は非同期タスクです。同期リクエストで待機するのではなく、タスク識別子で結果を取得していることをまず確認してください。本当にタイムアウトする場合は、素材のサイズが過大でないか確認します。
3. 結果が参照素材に「似ていない」
これは最も頻度の高い問題です。調査順序は:素材は鮮明か → 矛盾する参照画像を与えていないか → プロンプトが参照画像と衝突する内容を記述していないか。ほとんどの場合、モデルが悪いのではなく、素材が不十分です。
4. 主体が複数セグメント間でドリフトする
原因は通常、各セグメントで異なる参照素材を使用しているか、各セグメントのプロンプトで主体の記述が前後で一致していないことです。固定のベースライン素材と統一された主体記述により、显著に改善できます。
5. 画面の動作が期待と異なる
プロンプトに明確な動作とカメラ指示が欠けていると、モデルは独自に表現するしかありません。「何をするか、どう動くか、カメラはどこか」を明確に書いてください。
6. コストが予想を超える
呼び出しログを振り返ります:長さを長く設定したのか、リトライ率が高いのか?前者は製品側の長さ戦略を調整し、後者は素材とプロンプトに戻って原因を探します。
トラブルシューティングの基本原則
一度に1つの変数のみを変更し、ログを保持する。 素材とプロンプトを同時に変更すると、結果が良くなってもどちらが効いたか分からず、次回同じ問題に遭遇したときにまた最初から試すことになります。
統合前のチェックリストと次のステップ
本格的なスケール前に、以下のチェックリストに従って項目ごとに検証し、リスクを小流量段階で食い止めることをお勧めします。
ローンチ前チェックリスト
- 能力が合致している:あなたのシナリオが本当にリファレンス動画生成を必要とし、テキストから動画や画像から動画ではないことを確認します。
- 素材ベースラインが準備済み:コア主体に固定のクリーンな参照素材セットがあること。
- プロンプトのテンプレート化:動作、カメラ、環境の記述に再利用可能な構造があり、毎回即興でないこと。
- 非同期チェーンが開通:送信、ポーリングまたはコールバック、結果検証、失敗リトライの4段階すべてにコードがあり、負荷テスト済みであること。
- リトライに上限がある:自動リトライに最大回数を設定し、超過時は人手キューに入れること。
- コストにダッシュボードがある:呼び出し記録から長さとリトライ回数を集計し、実際の支出をいつでも計算できること。
- 長さ戦略が明確:製品側で生成可能な長さに制約があり、ユーザーが勝手に長くしてコストが制御不能になるのを防ぐこと。
小流量からスケールへ
推奨されるパスは:まず手動で構築したリクエストでエンドツーエンドを動作させ、素材とプロンプトの有効性を検証する。次に最短の長さで小バッチ試行を行い、リトライ率と可用率を統計する。指標が安定したことを確認したら、段階的に並列度と長さを拡大する。各ステップでロールバック能力を保持します。
主要指標
スケール段階で本当に注視すべきは、初回可用率と平均試行回数です。前者はユーザー体験を決定し、後者は直接コストを決定します。この2つの指標が安定してから、長さと並列度の拡張が語れます。
まだ始めていない場合は、まず HiAPI.ai で vidu-q3-mix/reference-to-video のモデル詳細とリアルタイム価格を確認してから、最初の動画をどれだけの長さで生成するかを決定してください。


