
튜토리얼
GPT-6.1 Terra API 연동 가이드: curl, Python 및 OpenAI SDK
Responses와 Chat Completions 두 가지 연동 방법, 추론 단계, 이미지 인식, 엄격한 JSON, 도구 호출, 캐시의 요청 작성법과 흔한 오류.

TL;DR
- GPT-6.1 Terra(
gpt-6.1-terra)는 OpenAI가 2026년 10월 26일에 출시한 중급 모델로, 이미지를 읽고 도구를 호출하며 JSON schema에 따라 엄격하게 출력할 수 있습니다. HiAPI에 출시되어 모델 페이지 열기에서 온라인으로 체험할 수 있으며, 가입 즉시 최대 2,000 크레딧($1)을 받을 수 있습니다. - 가격: 백만 토큰당 입력 $0.25, 출력 $1.25. 짧은 응답 한 번(약 90 입력, 80 출력 토큰)은 약 $0.0001입니다.
- 가장 빠른 호출 방법:
POST https://api.hiapi.ai/v1/responses,input에 배열 전달,stream: true,store: false.
GPT-6.1 Terra가 할 수 있는 일
- 6개 추론 단계: none, low, medium(기본), high, xhigh, max. 배치 작업은 추론을 아예 끌 수 있습니다(none).
- 이미지 인식: 텍스트와 이미지를 같은 메시지에 넣으면 텍스트를 출력합니다.
- 엄격한 JSON: JSON schema를 주면 반환되는 필드와 타입이 schema에 정확히 맞습니다.
- 도구 호출: 모델이 어떤 함수를 호출할지, 어떤 인자를 전달할지 결정하고, 실행 후 결과를 돌려주면 최종 답변을 작성합니다.
컨텍스트 1.05M 토큰(단일 입력 최대 922K), 최대 출력 128K, 지식 컷오프 2026년 6월.
아래 상품 이미지에 등록 정보 schema를 함께 주자 Terra가 10초 만에 이런 JSON을 반환했습니다:
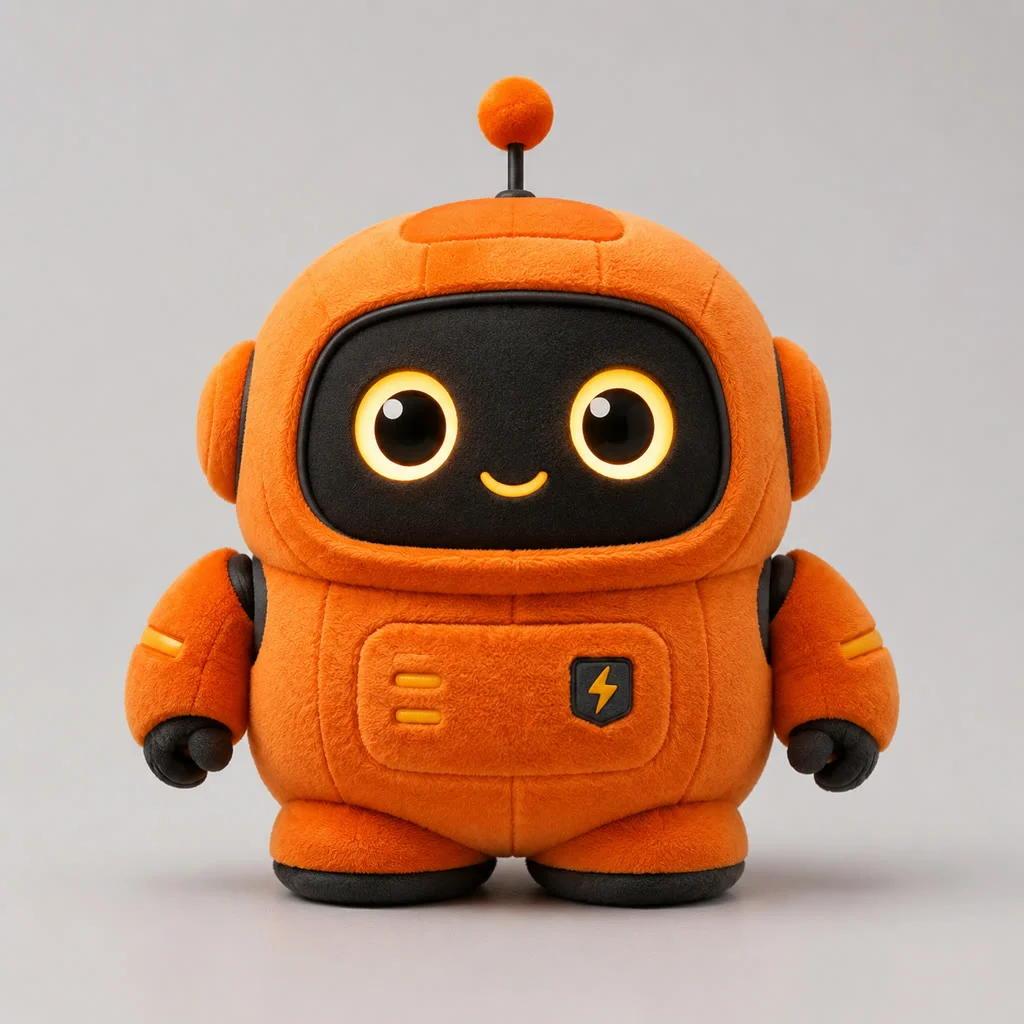
{"product_name":"주황색 로봇 봉제 인형","category":"봉제 장난감","material":null,"main_color":"주황색","selling_points":["로봇 디자인으로 외관이 귀여움","주황색 본체에 검은 디테일, 눈에 띄는 배색","둥글고 입체적인 형태로 장식품이나 반려 인형으로 적합"],"target_buyer":null}
gpt-6.1-terra, medium, 438 입력 / 163 출력 토큰, $0.0003. 프롬프트에서 "알 수 없는 필드는 null로 채우라"고 요구했기 때문에 재질과 대상 구매자는 null로 반환되었습니다.
두 API 중 선택
| Responses(기본) | Chat Completions | |
|---|---|---|
| 주소 | POST /v1/responses |
POST /v1/chat/completions |
| 스트리밍 | 반드시 stream: true |
스트리밍, 비스트리밍 모두 가능 |
| 추론 단계 필드 | reasoning.effort |
reasoning_effort |
| 엄격 JSON 필드 | text.format |
response_format |
| 적합 | 신규 프로젝트, 이미지 인식과 도구 호출 필요 시 | 기존 OpenAI Chat 코드에서 base URL만 교체 |
두 API 모두 https://api.hiapi.ai와 동일한 HiAPI key를 사용합니다.
두 가지 시작 방법
브라우저(코딩 불필요)
- GPT-6.1 Terra 모델 페이지를 열고 로그인합니다.
- Playground에서 추론 단계를 선택하고 질문을 입력하거나 이미지를 붙여넣습니다.
- 답변이 스트리밍으로 표시되며, 완료 후 토큰 사용량, 소요 시간, 예상 비용이 표시됩니다.
API
- 콘솔의 API Keys 페이지에서 key를 생성하고 환경 변수
HIAPI_API_KEY에 저장합니다. - 아래 curl을 복사해 첫 호출을 성공시킵니다.
- Python으로 전환하여 이벤트 타입별로 스트리밍 결과를 읽습니다.
curl: 첫 호출
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "멱등성이 무엇인지 세 문장으로 설명해 줘."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
반환되는 것은 SSE 스트림이며, 이벤트 순서는 다음과 같습니다:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta(여러 번)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
본문은 response.output_text.delta의 delta에 있고, 토큰 사용량은 마지막 response.completed의 response.usage에 있습니다. 스트림에 다른 이벤트 타입이 나타날 수 있으므로 type으로 분기하고 모르는 것은 건너뛰면 됩니다.
Python: 스트리밍 읽기
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "멱등성이 무엇인지 세 문장으로 설명해 줘."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # 바이트 단위로 읽고 직접 UTF-8로 디코딩
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
흔히 빠지는 함정 두 가지:
iter_lines(decode_unicode=True)를 쓰지 마세요.response.completed행은 종종 8KB를 넘는데, requests는 인코딩을 모를 때 latin-1로 디코딩하므로 중국어가 깨집니다. 바이트 단위로 읽고 UTF-8로 디코딩하세요.- 실패도 HTTP 200으로 옵니다. 생성 실패 시 스트림에는
response.failed가 오고 usage는 비어 있으며 과금되지 않습니다. 별도로 판별한 뒤 재시도해야 합니다.
Chat Completions: 기존 코드 그대로 교체
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "멱등성이 무엇인지 세 문장으로 설명해 줘."}],
    "reasoning_effort": "low"
  }'
OpenAI 공식 Python SDK를 사용한다면 base_url과 key만 바꾸면 됩니다:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "멱등성이 무엇인지 세 문장으로 설명해 줘."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
비스트리밍은 전체 choices[0].message.content를 바로 반환합니다. "stream": true를 추가하면 표준 chunk 스트림이 되며 data: [DONE]으로 끝납니다. 동일한 고객 응대 프롬프트로 비스트리밍은 33초 만에 전체 답변을 받았고, 스트리밍은 2.5초에 첫 글자가 나오고 4.5초에 끝났습니다. 사용자 대상 시나리오에서는 스트리밍을 사용하세요.
추론 단계
Responses는 "reasoning": {"effort": "none"}, Chat은 "reasoning_effort": "none"으로 작성합니다. 기본은 medium. 동일한 요구사항 분해 프롬프트로 medium은 1회 $0.002–0.004, max는 1회 $0.012–0.014입니다. 단계별 토큰과 소요 시간은 GPT-6.1 Terra API 가격을 참고하세요.
이미지 인식
같은 메시지의 content에 input_image 항목을 추가하고, 이미지는 공개 HTTPS 주소를 사용합니다:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "이미지의 주체와 눈에 띄는 디테일 두 가지를 설명해 줘."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
엄격한 JSON
요청 본문에 text.format을 추가합니다(Chat은 response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
strict 모드에서는 모든 속성을 required에 작성해야 하며, null이 가능한 필드는 ["string", "null"]로 지정합니다. 반환되는 본문은 바로 json.loads할 수 있는 JSON입니다.
도구 호출: 2라운드
첫 라운드에서 요청에 tools를 포함합니다:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
"주문 HX-20481은 어디쯤인가요?"라고 물으면 모델은 본문을 쓰지 않고 function_call만 반환합니다. name은 get_order_status, arguments는 {"order_id":"HX-20481"}이며 call_id도 함께 옵니다.
두 번째 라운드에서는 input에 원래 사용자 메시지, 이전 라운드에서 반환된 function_call, 그리고 함수 실행 결과를 순서대로 넣습니다:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
모델은 이를 바탕으로 "주문 HX-20481은 배송 중이며, SF Express가 운송 중입니다… 예상 도착일: 2026년 10월 30일"이라고 답합니다. 두 라운드 합계 약 $0.00016. 반환 시 fc_로 시작하는 id가 아니라 call_id를 사용하세요.
캐시 적중
body에 prompt_cache_key를, 요청 헤더에 같은 값의 session_id를 전달하고, 프롬프트 앞부분을 글자 그대로 유지합니다:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
약 3,290 토큰의 고객 응대 매뉴얼을 앞부분으로 두고 4개 질문을 연속으로 했을 때, 4번째에서 3,072개의 캐시 토큰이 적중하여 비용이 약 $0.001에서 $0.00013으로 떨어졌습니다. 적중량은 usage의 input_tokens_details.cached_tokens에서 확인합니다.
파라미터 표(Responses)
| 필드 | 필수 | 값 | 설명 |
|---|---|---|---|
model |
예 | gpt-6.1-terra |
|
input |
예 | 배열 | 메시지 항목, 문자열을 전달하면 400 반환 |
stream |
예 | true |
false 전달 시 400 반환 |
store |
아니오 | false |
대화 기록은 클라이언트가 저장하고 매 라운드 재전송 |
reasoning.effort |
아니오 | none / low / medium / high / xhigh / max | 기본 medium |
text.format |
아니오 | json_schema | 엄격한 JSON |
tools, tool_choice |
아니오 | 함수 정의 | 도구 호출 |
prompt_cache_key |
아니오 | 문자열 | 요청 헤더 session_id와 함께 캐시 적중 |
instructions |
아니오 | 문자열 | 답변 요구사항 |
temperature, top_p는 조정할 수 없고 답변 길이 상한도 설정할 수 없습니다. 길이를 제어하려면 프롬프트에 작성하세요.
만나게 될 오류
| 원인 | 상태 코드 | 반환 |
|---|---|---|
단계 오기(예: "turbo") |
400 | reasoning.effort: is outside allowed values |
stream에 false 전달 |
400 | stream: must be true |
input 미전달 |
400 | input: is required |
| 알 수 없는 필드 추가 | 400 | request.zz: unregistered public parameter |
| 모델 이름 오기 | 400 | model_not_found, request ID 포함 |
| 생성 실패 | 200 | 스트림에 response.failed, error.code는 generation_service_unstable, 과금 없음, 재시도하면 됨 |
파라미터 오류는 제출 시점에 400이 반환되며 생성되지 않고 비용도 부과되지 않습니다.
출시 전 주의사항
- 타임아웃을 길게 설정: 추론 단계가 높고 답변이 긴 요청은 4분 이상 걸린 경우가 있었습니다. 클라이언트 타임아웃은 최소 10분으로 설정하세요.
- 실패 시 재시도:
response.failed와 네트워크 중단은 모두 "몇 초 기다린 후 재시도"로 처리하고 최대 2–3회 재시도하세요. - 입력을 272K 이내로 제어: 초과하면 요청 전체가 장문 컨텍스트 가격으로 적용되어 비용이 거의 두 배가 됩니다.
- 긴 접두사는 캐시 사용: 시스템 프롬프트, 지식베이스 같은 고정 앞부분에는
prompt_cache_key와session_id를 설정하세요.
자주 묻는 질문
OpenAI 공식 SDK를 사용할 수 있나요?
네. Chat Completions의 요청과 반환 형식이 OpenAI와 동일하며, base URL을 https://api.hiapi.ai/v1로, key를 HiAPI key로 바꾸면 됩니다.
멀티턴 대화는 어떻게 하나요?
store는 반드시 false여야 하며 서버는 대화를 저장하지 않습니다. 매 라운드 필요한 기록 메시지를 input에 함께 넣어 다시 전송하고, 재전송되는 부분은 입력으로 과금되며 캐시를 활용하면 절반 이상 절약할 수 있습니다.
어떤 입력을 지원하나요?
텍스트와 이미지를 지원하며 출력은 텍스트입니다. 모델 페이지 Playground에서는 한 번에 최대 4장의 이미지를 전송할 수 있고 각 장은 10 MB를 넘을 수 없습니다.
GPT-6.1 Sol과 어떻게 선택하나요?
Terra 가격은 Sol의 절반이며 none 단계가 하나 더 있습니다. 저희 테스트에서는 Sol이 더 빠르게 응답했습니다. 동일 문제 비교는 GPT-6.1 Terra vs GPT-6.1 Sol을 참고하세요.
바로 사용할 수 있는 시나리오 프롬프트는 GPT-6.1 Terra 프롬프트 모음을 참고하세요. 위 curl을 복사해 질문을 자신의 것으로 바꾸어 첫 호출을 성공시키고, 코딩이 싫다면 모델 페이지를 열어 바로 체험하세요.
관련 글
모든 아티클 보기 →-

튜토리얼
Recraft Creative Upscale 사례: 풍경과 수채화 업스케일
통나무집, 호수, 수채화 마을의 텍스처 변화를 살펴보고 전체 결과와 미리보기를 구분하며 재화 디테일을 점검하세요.
-
튜토리얼
OpenAI API 키 무효: 401, 환경 변수 및 프로젝트 설정 점검
OpenAI 401, 403, 429를 구분하고 환경 변수, 조직 및 프로젝트 설정을 점검하며 읽기 전용 요청으로 자격 증명을 검증하세요.
-

튜토리얼
Kling 4.0 프롬프트 모음: 6가지 장면에서 바로 복사해 영상 만들기
이커머스 제품, 음식, 여행 풍경, 일상 장면, 소리가 있는 빈 풍경, 이미지→영상까지, 각 장면마다 실제 결과물과 전체 프롬프트, 원클릭 자동 입력 링크가 있습니다.