
Tutoriel
Guide d'intégration de l'API GPT-6.1 Terra : curl, Python et OpenAI SDK
Deux méthodes d'intégration, Responses et Chat Completions : niveaux de raisonnement, lecture d'images, JSON strict, appels d'outils, écriture des requêtes avec cache, et erreurs courantes.

TL;DR
- GPT-6.1 Terra (
gpt-6.1-terra) est le modèle de milieu de gamme publié par OpenAI le 26 octobre 2026 : il lit les images, appelle des outils et produit une sortie strictement conforme à un schéma JSON. Il est disponible sur HiAPI ; ouvrez la page du modèle pour l'essayer en ligne. À l'inscription, recevez jusqu'à 2 000 crédits (1 $). - Tarifs : 0,25 $ par million de tokens en entrée, 1,25 $ en sortie. Une courte réponse (environ 90 tokens d'entrée, 80 de sortie) coûte environ 0,0001 $.
- La méthode la plus rapide :
POST https://api.hiapi.ai/v1/responses, avecinputsous forme de tableau,stream: true,store: false.
Ce que GPT-6.1 Terra sait faire
- 6 niveaux de raisonnement : none, low, medium (par défaut), high, xhigh, max. Pour les tâches par lots, on peut désactiver complètement le raisonnement (none).
- Lecture d'images : texte et image dans un même message, sortie en texte.
- JSON strict : fournissez un schéma JSON, les champs et types retournés respectent exactement le schéma.
- Appels d'outils : le modèle décide quelle fonction appeler et avec quels paramètres ; vous exécutez, lui renvoyez le résultat, et il rédige la réponse finale.
Contexte de 1,05 M de tokens (jusqu'à 922 K par entrée), sortie maximale de 128 K, connaissances à jour jusqu'à juin 2026.
Avec l'image de produit ci-dessous et un schéma d'information de mise en vente, Terra a renvoyé ce JSON en 10 secondes :
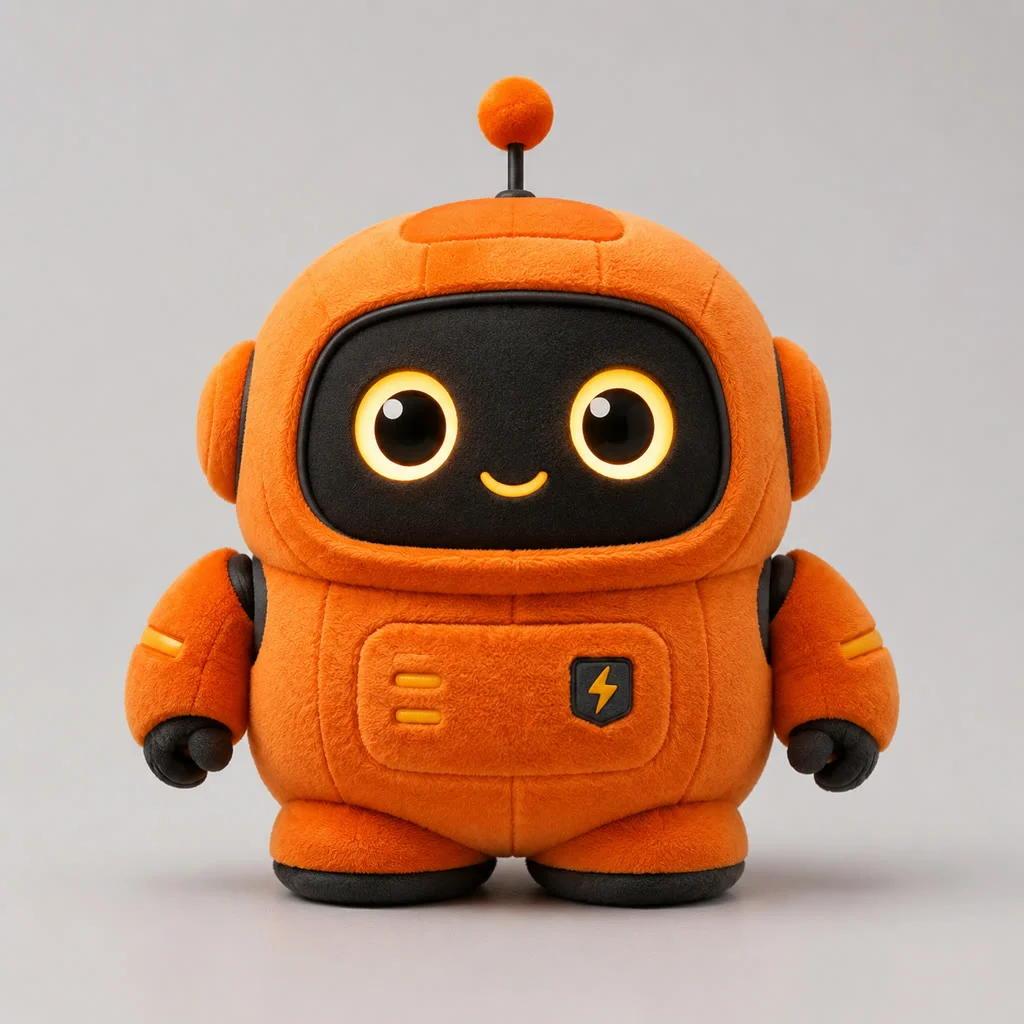
{"product_name":"Peluche robot orange","category":"Peluche","material":null,"main_color":"Orange","selling_points":["Design en forme de robot, apparence mignonne","Corps orange avec détails noirs, couleurs accrocheuses","Forme ronde et volumineuse, idéale comme objet décoratif ou peluche de compagnie"],"target_buyer":null}
gpt-6.1-terra, medium, 438 tokens d'entrée / 163 de sortie, 0,0003 $. Le prompt demandait de mettre null pour les champs non identifiables, c'est pourquoi le matériau et le public cible valent null.
Quel endpoint choisir
| Responses (par défaut) | Chat Completions | |
|---|---|---|
| Adresse | POST /v1/responses |
POST /v1/chat/completions |
| Streaming | stream: true obligatoire |
Streaming ou non-streaming, au choix |
| Champ de niveau de raisonnement | reasoning.effort |
reasoning_effort |
| Champ JSON strict | text.format |
response_format |
| Idéal pour | Nouveaux projets, lecture d'images et appels d'outils | Code OpenAI Chat existant, en changeant juste l'URL de base |
Les deux endpoints utilisent https://api.hiapi.ai et la même clé HiAPI.
Deux parcours de prise en main
Navigateur (sans coder)
- Ouvrez la page du modèle GPT-6.1 Terra et connectez-vous.
- Dans le Playground, choisissez le niveau de raisonnement, saisissez une question ou collez une image.
- La réponse s'affiche en streaming ; à la fin, les tokens utilisés, la durée et le coût estimé sont affichés.
API
- Créez une clé sur la page API Keys de la console et stockez-la dans la variable d'environnement
HIAPI_API_KEY. - Copiez le curl ci-dessous pour réussir votre premier appel.
- Passez à Python pour lire les résultats en streaming selon le type d'événement.
curl : premier appel
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Explique en trois phrases ce qu'est l'idempotence."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
La réponse est un flux SSE, avec les événements dans cet ordre :
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (plusieurs fois)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
Le texte se trouve dans le delta de response.output_text.delta, et l'usage des tokens dans response.usage du dernier response.completed. D'autres types d'événements peuvent apparaître dans le flux : dispatchez selon type et ignorez ceux que vous ne connaissez pas.
Python : lecture en streaming
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Explique en trois phrases ce qu'est l'idempotence."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # lire en octets, décoder soi-même en UTF-8
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Deux pièges fréquents :
- N'utilisez pas
iter_lines(decode_unicode=True). La ligneresponse.completeddépasse souvent 8 Ko ; sans connaître l'encodage, requests décode en latin-1 et le chinois devient illisible. Lisez en octets, puis décodez en UTF-8. - Un échec renvoie quand même HTTP 200. En cas d'échec de génération, le flux contient
response.failed, l'usage est vide et rien n'est facturé. Testez ce cas séparément, puis réessayez.
Chat Completions : remplacer directement dans le code existant
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Explique en trois phrases ce qu'est l'idempotence."}],
    "reasoning_effort": "low"
  }'
Avec le SDK Python officiel d'OpenAI, changez seulement base_url et la clé :
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Explique en trois phrases ce qu'est l'idempotence."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
En non-streaming, vous recevez directement le choices[0].message.content complet. Ajoutez "stream": true pour obtenir le flux de chunks standard, terminé par data: [DONE]. Avec le même prompt de réponse client, le non-streaming met 33 secondes pour obtenir la réponse complète ; le streaming donne le premier mot en 2,5 secondes et se termine en 4,5 secondes. Privilégiez le streaming pour les interfaces utilisateur.
Niveaux de raisonnement
Dans Responses, écrivez "reasoning": {"effort": "none"} ; dans Chat, "reasoning_effort": "none". Par défaut, medium. Avec le même prompt de décomposition d'un besoin, medium coûte 0,002–0,004 $ par appel, max 0,012–0,014 $. Les tokens et durées de chaque niveau sont détaillés dans Tarifs de l'API GPT-6.1 Terra.
Lecture d'images
Ajoutez un élément input_image dans le content du même message, avec l'image à une adresse HTTPS publique :
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Décris le sujet de l'image et deux détails visibles."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
JSON strict
Ajoutez text.format dans le corps de la requête (avec Chat, utilisez response_format) :
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
En mode strict, chaque propriété doit figurer dans required ; pour un champ pouvant être vide, utilisez ["string", "null"]. Le corps renvoyé est un JSON directement exploitable avec json.loads.
Appels d'outils : deux tours
Au premier tour, incluez tools dans la requête :
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
Demandez « Où en est la commande HX-20481 ? » : le modèle ne rédige pas de texte, il renvoie uniquement un function_call dont name vaut get_order_status, arguments vaut {"order_id":"HX-20481"}, avec en plus un call_id.
Au second tour, placez dans input, dans l'ordre : le message utilisateur d'origine, le function_call renvoyé au tour précédent, puis le résultat de l'exécution de votre fonction :
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
Le modèle répond alors : « La commande HX-20481 est en cours d'acheminement, transportée par SF Express… Livraison prévue : 30 octobre 2026 ». Les deux tours coûtent environ 0,00016 $. Pour le retour, utilisez call_id, et non l'id commençant par fc_.
Profiter du cache
Passez prompt_cache_key dans le corps et un session_id de même valeur dans les en-têtes, en gardant le début du prompt strictement identique :
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Nous avons utilisé un manuel de support client d'environ 3 290 tokens en préfixe et posé 4 questions d'affilée ; au 4e appel, 3 072 tokens en cache ont été réutilisés, faisant passer le coût d'environ 0,001 $ à 0,00013 $. Le nombre de tokens en cache est indiqué dans input_tokens_details.cached_tokens de l'usage.
Tableau des paramètres (Responses)
| Champ | Obligatoire | Valeurs | Description |
|---|---|---|---|
model |
Oui | gpt-6.1-terra |
|
input |
Oui | Tableau | Éléments de message ; une chaîne renvoie 400 |
stream |
Oui | true |
false renvoie 400 |
store |
Non | false |
L'historique est conservé côté client et rejoué à chaque tour |
reasoning.effort |
Non | none / low / medium / high / xhigh / max | medium par défaut |
text.format |
Non | json_schema | JSON strict |
tools, tool_choice |
Non | Définition de fonction | Appels d'outils |
prompt_cache_key |
Non | Chaîne | À combiner avec l'en-tête session_id pour le cache |
instructions |
Non | Chaîne | Consignes de réponse |
temperature et top_p ne sont pas réglables, et la longueur maximale de réponse non plus ; pour contrôler la longueur, indiquez-la dans le prompt.
Erreurs que vous rencontrerez
| Cause | Code de statut | Retour |
|---|---|---|
Niveau mal écrit (ex. "turbo") |
400 | reasoning.effort: is outside allowed values |
stream à false |
400 | stream: must be true |
input absent |
400 | input: is required |
| Champ inconnu en trop | 400 | request.zz: unregistered public parameter |
| Nom de modèle mal écrit | 400 | model_not_found, avec request ID |
| Échec de génération | 200 | response.failed dans le flux, error.code vaut generation_service_unstable, pas de facturation, réessayez |
Une erreur de paramètre renvoie 400 dès la soumission : aucune génération, aucun frais.
À vérifier avant la mise en production
- Réglez un timeout plus long : avec un niveau de raisonnement élevé et une longue réponse, nous avons vu des requêtes durer plus de 4 minutes. Réglez le timeout client à au moins 10 minutes.
- Réessayez en cas d'échec : traitez
response.failedet les coupures réseau par « attendre quelques secondes puis réessayer », 2 à 3 fois maximum. - Gardez l'entrée sous 272 K : au-delà, toute la requête est facturée au tarif long contexte, ce qui double presque le coût.
- Utilisez le cache pour les longs préfixes : pour les débuts fixes comme le prompt système ou la base de connaissances, configurez
prompt_cache_keyetsession_id.
Questions fréquentes
Peut-on utiliser le SDK officiel OpenAI ?
Oui. Le format des requêtes et réponses de Chat Completions est identique à celui d'OpenAI ; remplacez l'URL de base par https://api.hiapi.ai/v1 et la clé par votre clé HiAPI.
Comment gérer une conversation multi-tours ?
store doit être false : le serveur ne conserve pas la conversation. À chaque tour, renvoyez dans input l'historique nécessaire avec le nouveau message ; la partie rejouée est facturée en entrée, et le cache permet d'économiser la majeure partie.
Quelles entrées sont prises en charge ?
Texte et images, avec une sortie texte. Dans le Playground de la page du modèle, on peut envoyer jusqu'à 4 images à la fois, de 10 Mo maximum chacune.
Comment choisir entre GPT-6.1 Terra et GPT-6.1 Sol ?
Terra coûte la moitié du prix de Sol et propose un niveau none supplémentaire ; dans nos tests, Sol répond plus vite. Comparaison sur les mêmes questions : GPT-6.1 Terra vs GPT-6.1 Sol.
Pour des prompts de scénarios prêts à l'emploi, voir Recueil de prompts GPT-6.1 Terra. Copiez le curl ci-dessus, remplacez la question par la vôtre et réussissez votre premier appel ; si vous ne voulez pas coder, ouvrez la page du modèle pour l'essayer directement.
Articles similaires
Voir tous les articles →-

Tutoriel
Cas pratiques Recraft Creative Upscale : agrandissement de paysages et d'aquarelles
Examinez les variations de texture de la cabane, du lac et de la petite ville à l'aquarelle, distinguez le résultat complet de l'aperçu et vérifiez les détails redessinés.
-
Tutoriel
Clé API OpenAI invalide : dépannage des erreurs 401, des variables d'environnement et de la configuration du projet
Distinguez les erreurs 401, 403 et 429 d'OpenAI, vérifiez les variables d'environnement ainsi que les paramètres d'organisation et de projet, puis validez les identifiants avec une requête en lecture seule.
-

Tutoriel
Guide complet des prompts Kling 4.0 : 6 scènes à copier-coller pour générer des vidéos
Produit e-commerce, cuisine, paysage de voyage, scène de vie, plan vide avec son et image vers vidéo : chaque scène a son rendu réel, son prompt complet et un lien de préremplissage en un clic.