
Tutorial
Guia de acesso à API do GPT-6.1 Terra: curl, Python e OpenAI SDK
Duas formas de integração, Responses e Chat Completions; como escrever requisições com níveis de raciocínio, leitura de imagens, JSON estrito, chamadas de ferramentas e cache, além dos erros mais comuns.

TL;DR
- O GPT-6.1 Terra (
gpt-6.1-terra) é o modelo de médio porte lançado pela OpenAI em 26 de outubro de 2026; ele lê imagens, chama ferramentas e gera saída estrita conforme JSON schema. Já está disponível no HiAPI: abra a página do modelo para testar online. Ao se cadastrar, você ganha até 2.000 créditos (US$ 1). - Preço: US$ 0,25 por milhão de tokens de entrada e US$ 1,25 por milhão de tokens de saída. Uma resposta curta (cerca de 90 tokens de entrada e 80 de saída) custa aproximadamente US$ 0,0001.
- O jeito mais rápido de chamar:
POST https://api.hiapi.ai/v1/responses, passando um array eminput, comstream: trueestore: false.
O que o GPT-6.1 Terra faz
- 6 níveis de raciocínio: none, low, medium (padrão), high, xhigh e max. Para tarefas em lote, dá para desligar o raciocínio (none).
- Leitura de imagens: texto e imagem na mesma mensagem, com saída em texto.
- JSON estrito: basta fornecer um JSON schema; os campos e tipos retornados seguem exatamente o schema.
- Chamadas de ferramentas: o modelo decide qual função chamar e com quais parâmetros; você executa, devolve o resultado e ele escreve a resposta final.
Contexto de 1,05M tokens (entrada máxima de 922K por chamada), saída máxima de 128K e conhecimento até junho de 2026.
Com a imagem de produto abaixo e um schema de informações de anúncio, o Terra retornou este JSON em 10 segundos:
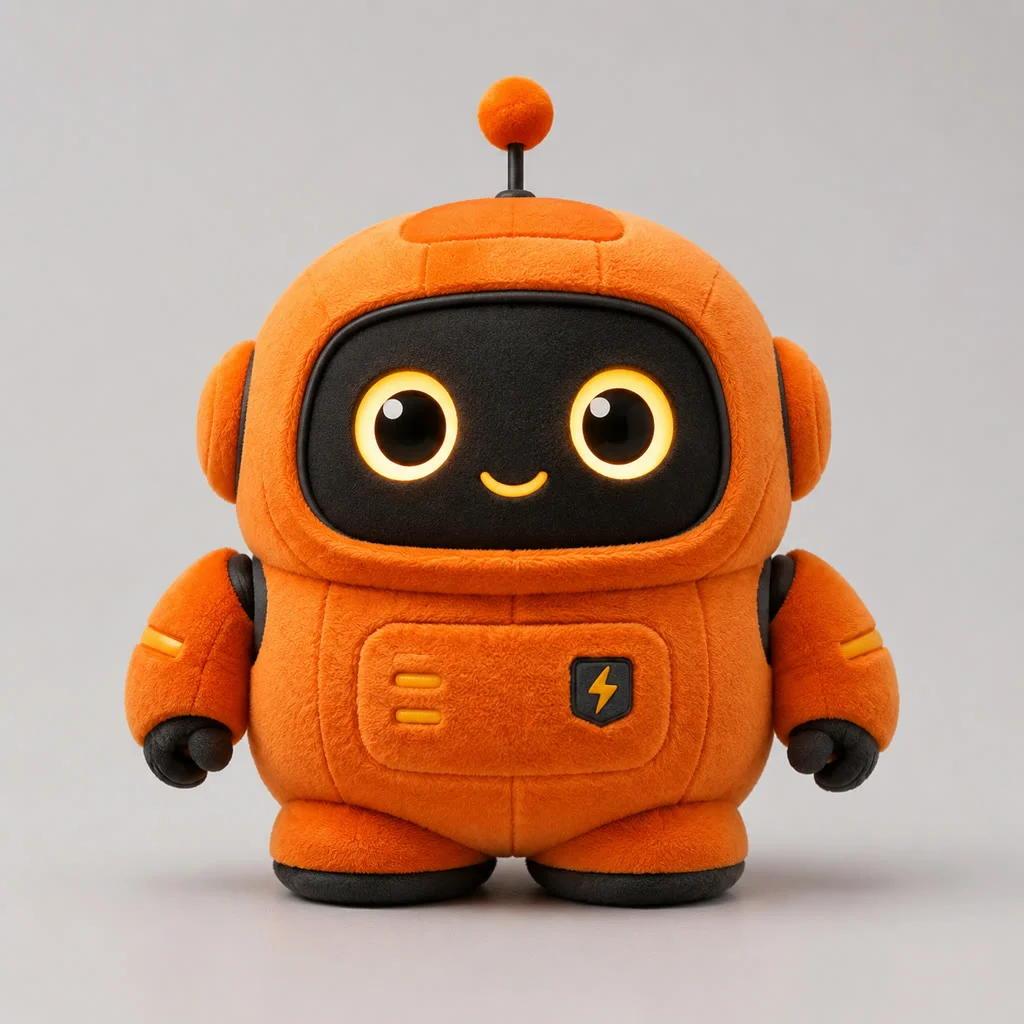
{"product_name":"Boneco de pelúcia robô laranja","category":"Pelúcia","material":null,"main_color":"Laranja","selling_points":["Design em formato de robô, aparência fofa","Corpo laranja com detalhes pretos, combinação de cores chamativa","Formato arredondado e tridimensional, ideal como objeto de decoração ou pelúcia de companhia"],"target_buyer":null}
gpt-6.1-terra, medium, 438 tokens de entrada / 163 de saída, US$ 0,0003. O prompt pedia “preencha com null os campos que não der para identificar”, por isso material e público-alvo retornaram null.
Como escolher entre as duas interfaces
| Responses (padrão) | Chat Completions | |
|---|---|---|
| Endereço | POST /v1/responses |
POST /v1/chat/completions |
| Streaming | Obrigatório stream: true |
Streaming ou não streaming |
| Campo de nível de raciocínio | reasoning.effort |
reasoning_effort |
| Campo de JSON estrito | text.format |
response_format |
| Indicado para | Projetos novos, com leitura de imagens e chamadas de ferramentas | Código OpenAI Chat existente, trocando apenas a base URL |
As duas interfaces usam https://api.hiapi.ai e a mesma HiAPI key.
Dois caminhos para começar
Navegador (sem escrever código)
- Abra a página do modelo GPT-6.1 Terra e faça login.
- No Playground, escolha o nível de raciocínio e digite a pergunta ou cole uma imagem.
- A resposta aparece em streaming; ao final, são exibidos o uso de tokens, o tempo e o custo estimado.
API
- Crie uma key na página API Keys do console e salve na variável de ambiente
HIAPI_API_KEY. - Copie o curl abaixo e faça a primeira chamada funcionar.
- Passe para Python e leia o resultado em streaming por tipo de evento.
curl: primeira chamada
curl -N https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "input": [
      {"type": "message", "role": "user",
       "content": [{"type": "input_text", "text": "Explique em três frases o que é idempotência."}]}
    ],
    "stream": true,
    "store": false,
    "reasoning": {"effort": "low"}
  }'
A resposta é um fluxo SSE, com os eventos na ordem:
response.created → response.in_progress → response.output_item.added
→ response.content_part.added → response.output_text.delta (várias vezes)
→ response.output_text.done → response.content_part.done
→ response.output_item.done → response.completed
O texto fica em delta de response.output_text.delta, e o uso de tokens fica em response.usage do último response.completed. Podem aparecer outros tipos de evento no fluxo; distribua por type e ignore os desconhecidos.
Python: leitura em streaming
import json, os, requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

body = {
    "model": "gpt-6.1-terra",
    "input": [{"type": "message", "role": "user",
               "content": [{"type": "input_text", "text": "Explique em três frases o que é idempotência."}]}],
    "stream": True,
    "store": False,
    "reasoning": {"effort": "low"},
}

usage = None
with requests.post(API, headers=HEADERS, json=body, stream=True, timeout=600) as r:
    r.raise_for_status()
    for line in r.iter_lines():  # ler por bytes e decodificar você mesmo com UTF-8
        if not line.startswith(b"data:"):
            continue
        event = json.loads(line[5:].decode("utf-8"))
        kind = event.get("type")
        if kind == "response.output_text.delta":
            print(event["delta"], end="", flush=True)
        elif kind == "response.completed":
            usage = event["response"]["usage"]
        elif kind in ("response.failed", "response.incomplete"):
            raise RuntimeError(event["response"].get("error") or event["response"].get("incomplete_details"))

print("\n", usage)
Dois erros comuns:
- Não use
iter_lines(decode_unicode=True). A linha deresponse.completedcostuma passar de 8KB; sem saber a codificação, o requests decodifica como latin-1 e o chinês vira caracteres corrompidos. Leia por bytes e depois decodifique com UTF-8. - Falhas também retornam HTTP 200. Quando a geração falha, chega
response.failedno fluxo, com usage vazio e sem cobrança. Trate esse caso separadamente e tente de novo.
Chat Completions: troca direta do código existente
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.1-terra",
    "messages": [{"role": "user", "content": "Explique em três frases o que é idempotência."}],
    "reasoning_effort": "low"
  }'
Com o SDK oficial Python da OpenAI, basta trocar base_url e a key:
import os
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=os.environ["HIAPI_API_KEY"])
resp = client.chat.completions.create(
    model="gpt-6.1-terra",
    messages=[{"role": "user", "content": "Explique em três frases o que é idempotência."}],
    reasoning_effort="low",
)
print(resp.choices[0].message.content)
Sem streaming, retorna diretamente o choices[0].message.content completo. Adicionando "stream": true, vira um fluxo de chunks padrão, terminando com data: [DONE]. Com o mesmo prompt de resposta de atendimento, sem streaming levou 33 segundos para obter a resposta completa; com streaming, o primeiro caractere saiu em 2,5 segundos e terminou em 4,5 segundos. Em cenários voltados ao usuário, use streaming.
Níveis de raciocínio
No Responses, escreva "reasoning": {"effort": "none"}; no Chat, escreva "reasoning_effort": "none". O padrão é medium. Com o mesmo prompt de decomposição de requisitos, medium custa cerca de US$ 0,002–0,004 por chamada, e max custa cerca de US$ 0,012–0,014. Tokens e tempo de cada nível estão em Preços da API do GPT-6.1 Terra.
Leitura de imagens
Adicione um item input_image no content da mesma mensagem, com a imagem em um endereço HTTPS público:
{"type": "message", "role": "user", "content": [
  {"type": "input_text", "text": "Descreva o assunto da imagem e dois detalhes visíveis."},
  {"type": "input_image", "image_url": "https://static.hiapi.ai/example/subject-1.jpg", "detail": "low"}
]}
JSON estrito
Adicione text.format no corpo da requisição (no Chat, use response_format):
"text": {"format": {
  "type": "json_schema", "name": "listing", "strict": true,
  "schema": {
    "type": "object", "additionalProperties": false,
    "required": ["product_name", "main_color", "material"],
    "properties": {
      "product_name": {"type": "string"},
      "main_color": {"type": "string"},
      "material": {"type": ["string", "null"]}
    }
  }
}}
No modo strict, todas as propriedades precisam estar em required; campos que podem ser nulos usam ["string", "null"]. O corpo retornado é um JSON pronto para json.loads.
Chamadas de ferramentas: dois turnos
No primeiro turno, inclua tools na requisição:
"tools": [{"type": "function", "name": "get_order_status",
  "description": "Look up shipping status by order ID",
  "parameters": {"type": "object", "additionalProperties": false,
    "required": ["order_id"], "properties": {"order_id": {"type": "string"}}},
  "strict": true}]
Pergunte “Onde está o pedido HX-20481?”. O modelo não escreve texto: retorna apenas um function_call, com name igual a get_order_status, arguments igual a {"order_id":"HX-20481"} e também um call_id.
No segundo turno, coloque em input, em ordem: a mensagem original do usuário, o function_call retornado no turno anterior e o resultado da execução da sua função:
{"type": "function_call_output", "call_id": "call_…", "output": "{\"status\":\"in_transit\",\"carrier\":\"SF Express\",\"eta\":\"2026-10-30\"}"}
Com isso, o modelo responde: “O pedido HX-20481 está em trânsito, transportado pela SF Express… Previsão de entrega: 30 de outubro de 2026”. Os dois turnos juntos custam cerca de US$ 0,00016. Ao devolver, use o call_id, não o id que começa com fc_.
Acerto de cache
Passe prompt_cache_key no body e session_id com o mesmo valor no cabeçalho, mantendo o início do prompt literalmente inalterado:
-H "session_id: shop-faq-v1" \
-d '{"model": "gpt-6.1-terra", "prompt_cache_key": "shop-faq-v1", ...}'
Usamos um manual de atendimento de cerca de 3.290 tokens como início e fizemos 4 perguntas seguidas; na 4ª vez, 3.072 tokens de cache foram acertados, e o custo dessa chamada caiu de cerca de US$ 0,001 para US$ 0,00013. Para ver quanto foi acertado, consulte input_tokens_details.cached_tokens em usage.
Tabela de parâmetros (Responses)
| Campo | Obrigatório | Valores | Descrição |
|---|---|---|---|
model |
Sim | gpt-6.1-terra |
|
input |
Sim | Array | Itens de mensagem; passar string retorna 400 |
stream |
Sim | true |
Passar false retorna 400 |
store |
Não | false |
O histórico da conversa é mantido pelo cliente e reenviado a cada turno |
reasoning.effort |
Não | none / low / medium / high / xhigh / max | Padrão medium |
text.format |
Não | json_schema | JSON estrito |
tools, tool_choice |
Não | Definição de função | Chamada de ferramentas |
prompt_cache_key |
Não | String | Junto com o cabeçalho session_id, acerta o cache |
instructions |
Não | String | Requisitos de resposta |
temperature e top_p não são ajustáveis, e o limite de comprimento da resposta também não pode ser definido; se precisar controlar o tamanho, escreva no prompt.
Erros que você vai encontrar
| Causa | Código de status | Retorno |
|---|---|---|
Nível inválido (ex.: "turbo") |
400 | reasoning.effort: is outside allowed values |
stream com false |
400 | stream: must be true |
input não enviado |
400 | input: is required |
| Campo desconhecido incluído | 400 | request.zz: unregistered public parameter |
| Nome do modelo incorreto | 400 | model_not_found, com request ID |
| Falha na geração | 200 | No fluxo vem response.failed, com error.code igual a generation_service_unstable; não há cobrança, basta tentar de novo |
Erros de parâmetro retornam 400 no momento do envio, sem gerar resposta e sem cobrança.
Atenção antes de ir para produção
- Configure um timeout maior: em requisições com nível de raciocínio alto e respostas longas, já vimos casos que levaram mais de 4 minutos para terminar. Defina o timeout do cliente em pelo menos 10 minutos.
- Tente de novo em caso de falha: trate
response.failede quedas de rede como “esperar alguns segundos e tentar de novo”, com no máximo 2–3 tentativas. - Mantenha a entrada abaixo de 272K: acima disso, a chamada inteira passa a ser cobrada como contexto longo e o custo quase dobra.
- Use cache para prefixos longos: para inícios fixos como prompts de sistema e bases de conhecimento, configure
prompt_cache_keyesession_id.
Perguntas frequentes
Dá para usar o SDK oficial da OpenAI?
Sim. O formato de requisição e retorno do Chat Completions é igual ao da OpenAI; basta mudar a base URL para https://api.hiapi.ai/v1 e trocar a key pela HiAPI key.
Como fazer conversas de múltiplos turnos?
store precisa ser false, pois o servidor não armazena a conversa. A cada turno, envie novamente em input as mensagens históricas necessárias; a parte reenviada é cobrada como entrada, e com cache é possível economizar boa parte.
Quais entradas são suportadas?
Texto e imagem, com saída em texto. No Playground da página do modelo, é possível enviar até 4 imagens por vez, cada uma com no máximo 10 MB.
Como escolher entre ele e o GPT-6.1 Sol?
O Terra custa metade do Sol e tem um nível a mais, o none; nos nossos testes, o Sol respondeu mais rápido. Veja a comparação com as mesmas perguntas em GPT-6.1 Terra vs GPT-6.1 Sol.
Prompts prontos por cenário estão em Coletânea de prompts do GPT-6.1 Terra. Copie o curl acima, troque a pergunta pela sua e faça a primeira chamada funcionar; se não quiser escrever código, abra a página do modelo e teste diretamente.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Casos do Recraft Creative Upscale: upscale de paisagens e aquarela
Veja as mudanças de textura na cabana, no lago e na cidade em aquarela, diferencie o resultado completo da prévia e verifique os detalhes redesenhados.
-
Tutorial
Chave de API da OpenAI inválida: diagnóstico de 401, variáveis de ambiente e configuração de projeto
Diferencie 401, 403 e 429 da OpenAI, verifique variáveis de ambiente e configurações de organização e projeto, e valide as credenciais com uma requisição somente leitura.
-

Tutorial
Coleção de prompts do Kling 4.0: 6 cenas para copiar e gerar vídeos diretamente
Produto de e-commerce, comida, paisagem de viagem, cena cotidiana, plano vazio com som e imagem para vídeo: cada cena traz um vídeo real, o prompt completo e um link de preenchimento com um clique.